Kurs
Einführung in die Claude-Modelle
3 Std.
14.6K
Vor ein paar Wochen habe ich claude-mem in all meinen Projekten installiert. Seitdem hat es 6.814 Beobachtungen aus 259 Sessions erfasst, über zehn verschiedene Codebasen hinweg – alles in einer 39 MB großen SQLite-Datei auf meinem Laptop.
Vorher startete jede Claude-Code-Session bei null. Ich öffnete eine neue Session und verbrachte die ersten zehn Minuten damit, die Projektstruktur erneut zu erklären. Der Authentifizierungs-Bug, den wir tags zuvor gemeinsam gefixt hatten? Davon wusste Claude nichts. Es las Dateien erneut ein, die es bereits analysiert hatte, und kam wieder zu denselben falschen Annahmen, die wir schon korrigiert hatten.
claude-mem ist ein Claude-Code-Plugin, das dieses Problem löst, indem es festhält, was in einer Session passiert, und es künftigen Sessions wieder zur Verfügung stellt.
In diesem Artikel zeige ich dir, wie es unter der Haube funktioniert, wie du es ohne typische Stolperfallen installierst, wie du es auf dein Budget abstimmst und was du vor dem Einsatz in der Produktion wissen solltest.
claude-mem ist ein Claude-Code-Plugin, das:
~/.claude-mem/claude-mem.db speichertEs läuft als Plugin, nicht als MCP-Server.
Dieser Unterschied ist wichtig: Plugins feuern automatisch bei Lifecycle-Events wie Session-Start und jedem Tool-Call, während MCP-Server untätig bleiben, bis Claude sie aufruft.
Bei einem MCP-Ansatz erfolgt der Abruf nur, wenn Claude aktiv danach fragt. claude-mem erfasst und injiziert ohne dass Claude sich dafür entscheiden muss.
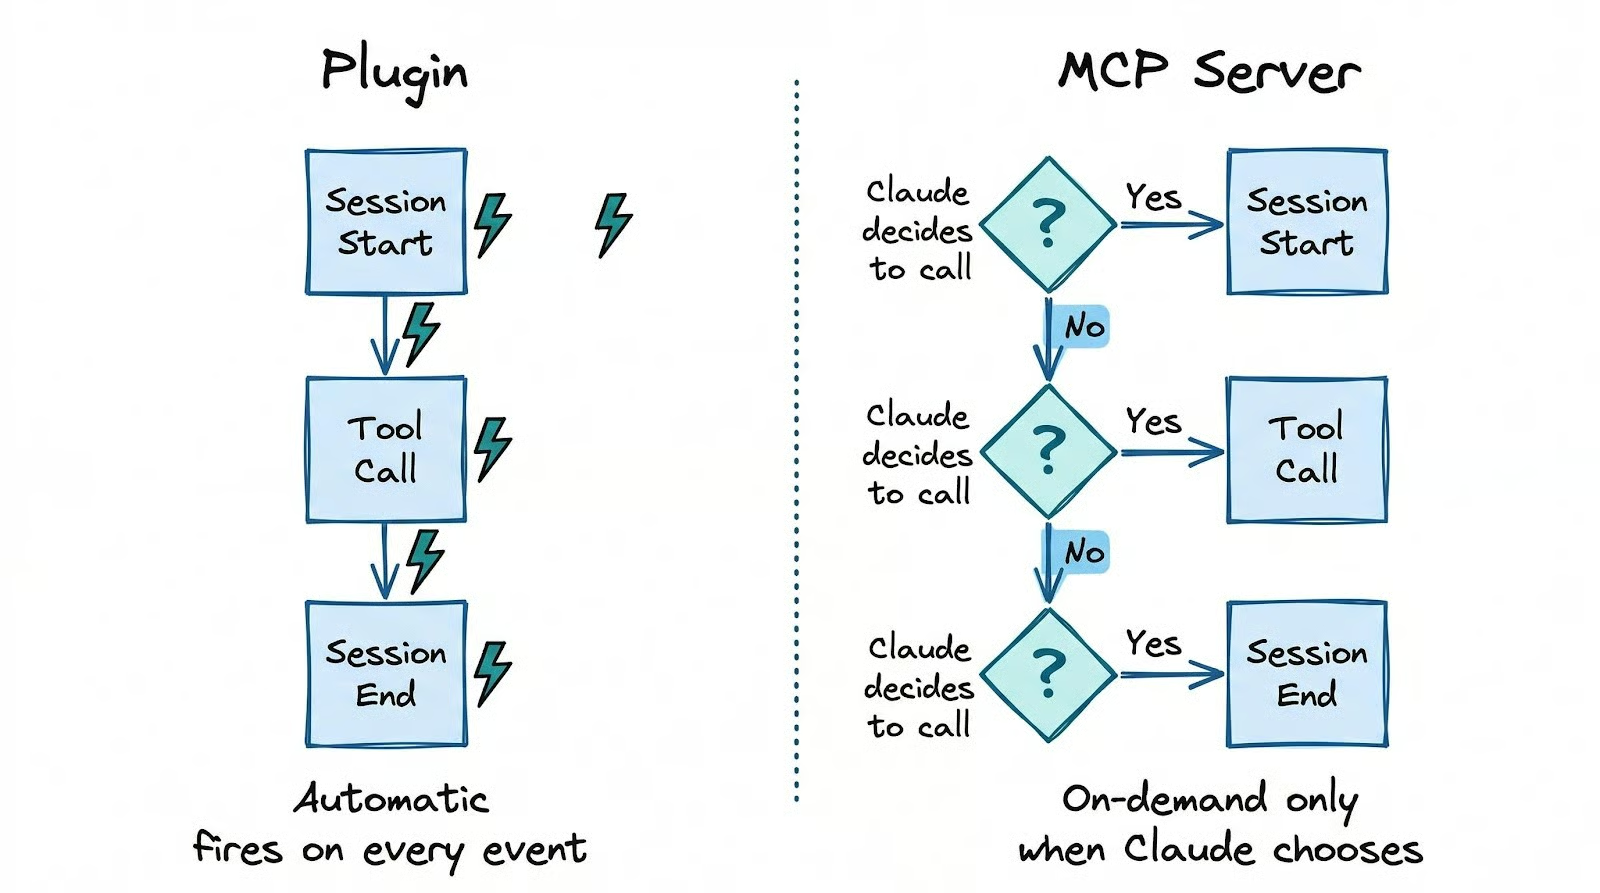
Alles bleibt auf deinem Rechner, und die Komprimierung läuft über deine bestehende Claude-Code-Authentifizierung – es braucht keinen separaten API-Schlüssel und kein zusätzliches Konto.
Die Inbetriebnahme erfordert zwei Befehle in einer Claude-Code-Session:
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
Starte danach Claude Code neu.
Der häufigste Fehler ist stattdessen npm install -g claude-mem auszuführen, was nur die SDK-Bibliothek installiert. Hooks werden nicht registriert, der Worker startet nicht und nichts funktioniert.
Der Weg über den Plugin-Marktplatz ist der einzige, der dir das komplette Setup liefert. Die einzige harte Voraussetzung ist Node.js 18+. Alles andere (Bun, uv, SQLite) wird beim ersten Start automatisch installiert.
Um zu überprüfen, ob die Installation wirklich funktioniert hat, prüfe drei Dinge. Erstens sollte curl http://localhost:37777/api/health {"status":"ok"} zurückgeben. Falls nicht, ist der Hintergrund-Worker nicht gestartet. Meist liegt es an einer Node.js-Version unter 18.
Zweitens, prüfe, ob ~/.claude/hooks.json Einträge für claude-mem enthält. Wenn die Datei claude-mem nicht unter PostToolUse und SessionStart auflistet, wurden die Hooks nicht registriert, und es wird nichts erfasst – unabhängig davon, ob der Worker läuft.
Drittens, öffne http://localhost:37777 im Browser, um den Web-Viewer zu sehen – er zeigt dir in Echtzeit, wie Beobachtungen einlaufen, während du arbeitest.
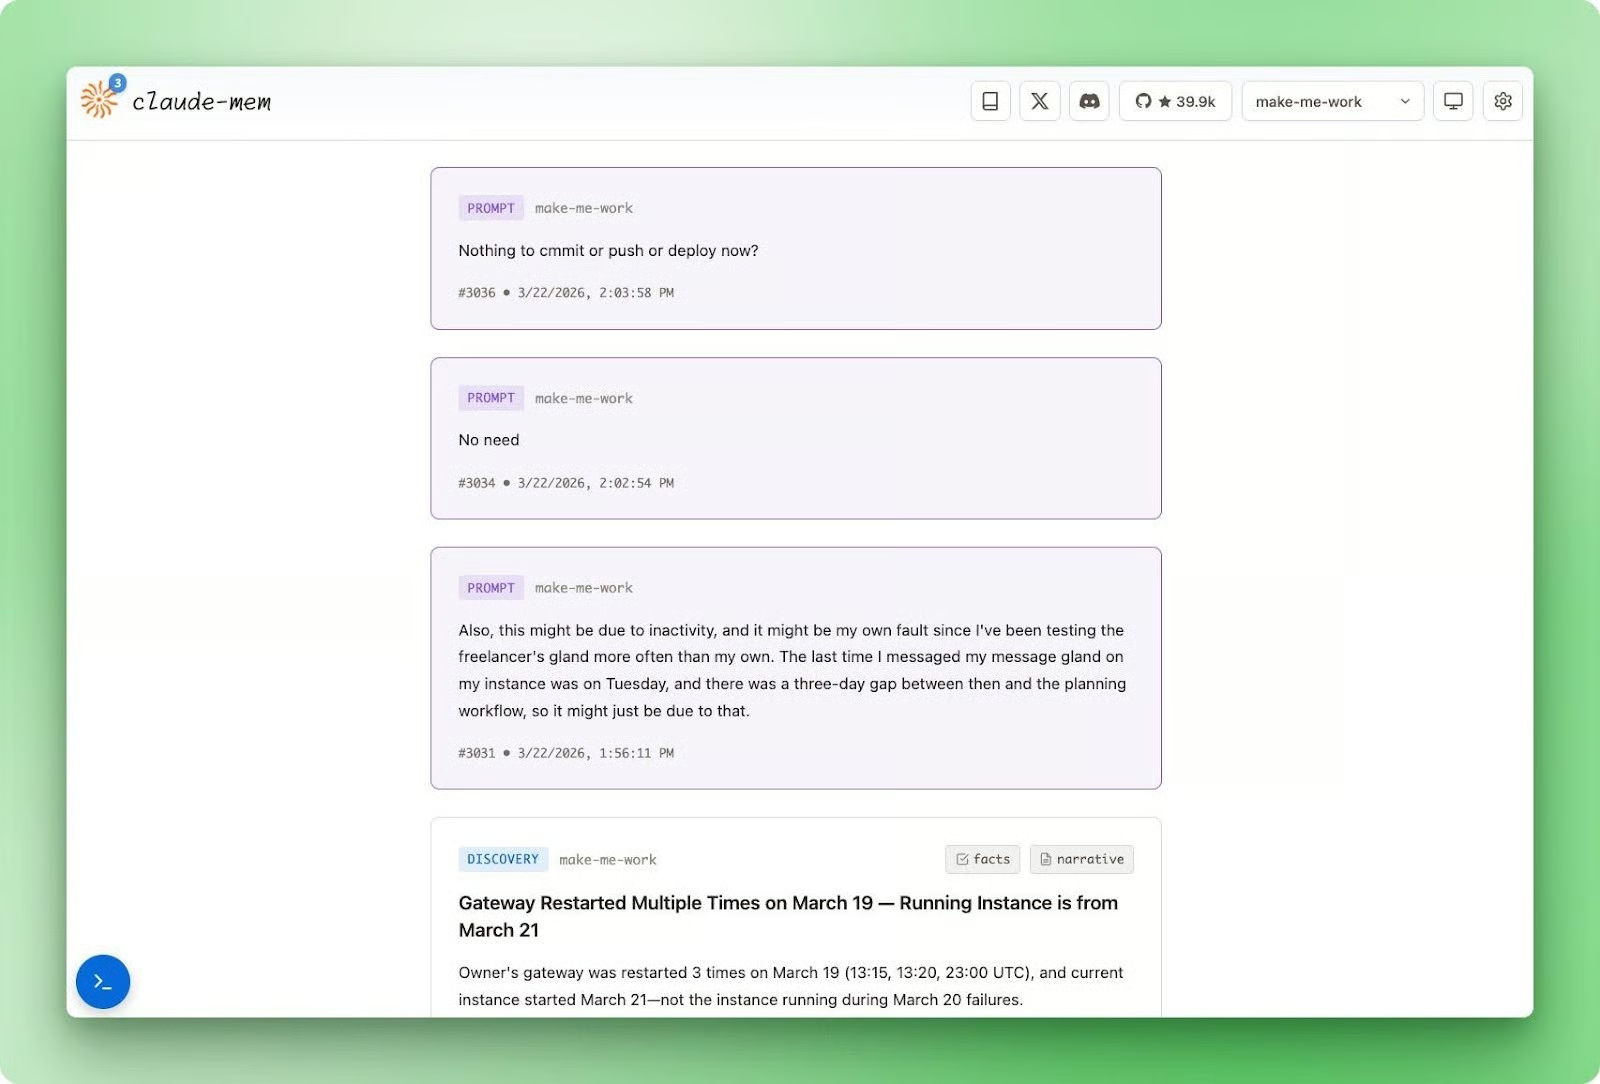
In der ersten Session wird beim SessionStart kein Kontext injiziert, weil die Datenbank leer ist. Aber ab dem ersten Tool-Call sammeln sich Beobachtungen.
Ab der zweiten Session hat claude-mem dann eine Session-Zusammenfassung und einen Stapel Beobachtungen zum Injizieren.
Der kurze Verifizierungs-Check erspart dir, erst nach drei Sessions zu merken, dass nie etwas erfasst wurde. Der Web-Viewer ist das verlässlichste Signal: Wenn nach einem Tool-Call Beobachtungen auftauchen, ist alles korrekt verdrahtet.
Nach der Installation läuft claude-mem leise im Hintergrund über fünf Lifecycle-Hooks. Zu verstehen, was jeder davon macht, erklärt das Verhalten des Tools.
Die fünf Hooks folgen dem natürlichen Zeitablauf einer Session:
SessionStart fragt die Datenbank ab und injiziert einen komprimierten Index der letzten Arbeiten in dein KontextfensterUserPromptSubmit protokolliert die Session und speichert deinen PromptPostToolUse feuert nach jedem Tool-Call und sendet die Roh-Ausgabe zur Komprimierung an einen Hintergrund-WorkerStop erzeugt eine Session-Zusammenfassung, wenn du pausierst oder inaktiv bistSessionEnd markiert die Session als abgeschlossen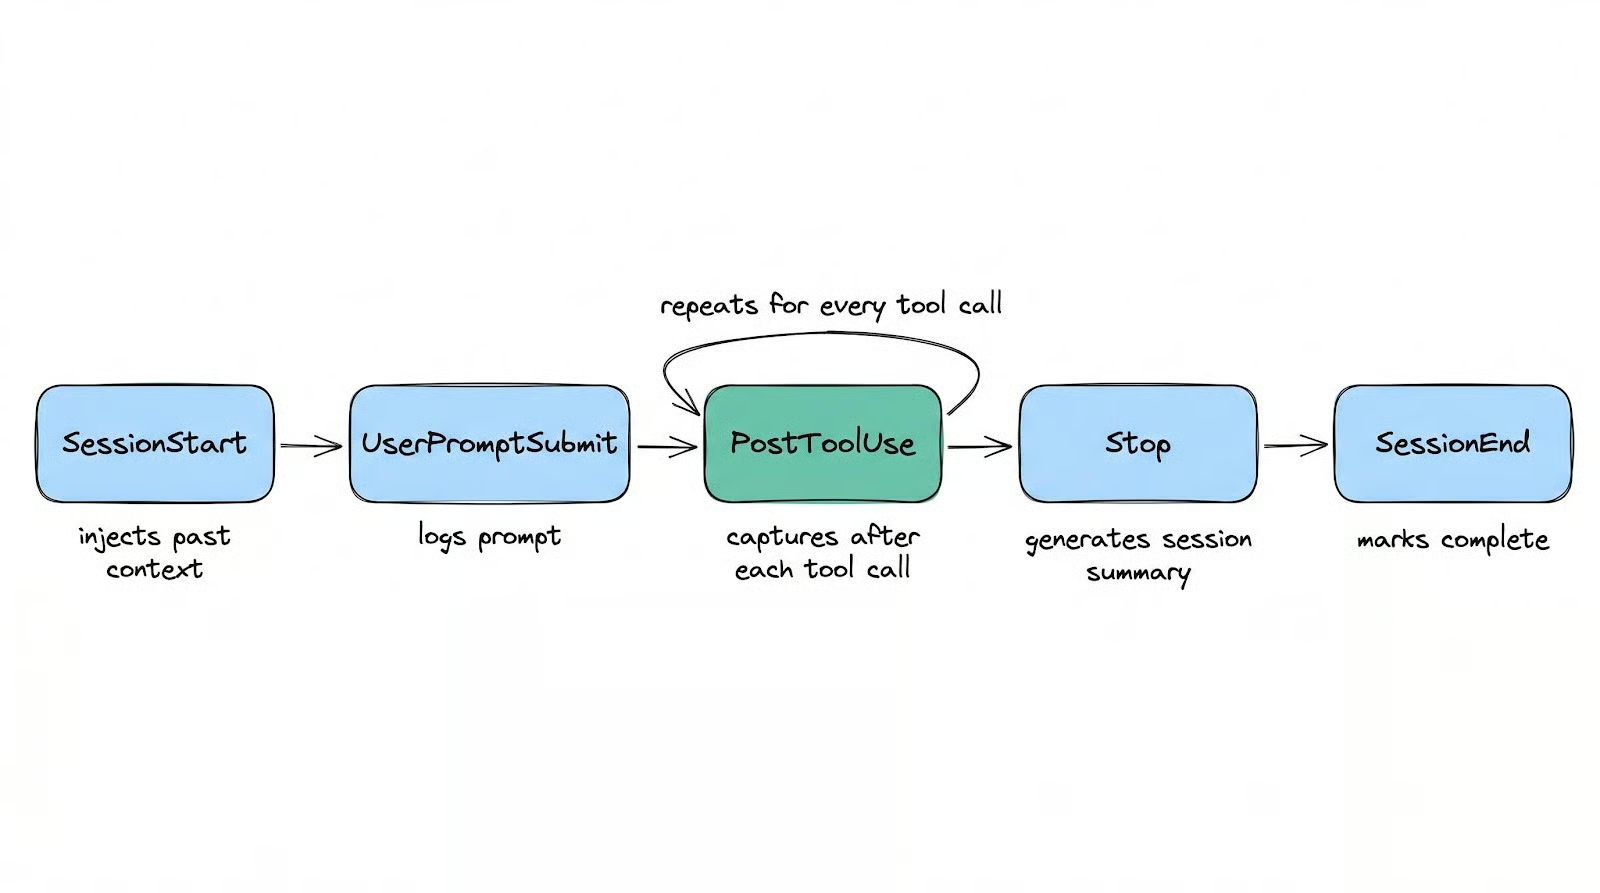
SessionStart baut diesen injizierten Index aus Session-Zusammenfassungen, Beobachtungstiteln nach Typ gruppiert, und Zeitstempeln: eine durchsuchbare Karte der jüngsten Arbeiten, auf die Claude während der Session jederzeit zugreifen kann – ohne dein Zutun.
PostToolUse feuert nach jedem Tool-Call. Es sendet die Roh-Ausgabe per nicht-blockierendem HTTP-POST (durchschnittlich 8 ms) an einen Hintergrund-Worker, der sie mit dem Claude Agent SDK zu einer strukturierten Beobachtung komprimiert.
So sieht diese Struktur aus:
|
Feld |
Inhalt |
|
|
Eines von |
|
|
Eine prägnante, durchsuchbare Zeile |
|
|
Ein Array einzelner Fakten (~50 Token, günstig zu laden) |
|
|
Eine erklärende Prosa (~155–500 Token, nur bei Bedarf geladen) |
|
|
Semantische Tags wie how-it-works, problem-solution, gotcha, trade-off |
Die Erfassung pro Tool-Call unterscheidet claude-mem von Tools, die erst am Session-Ende mit einem einzelnen KI-Call zusammenfassen.
Wenn deine Session mitten im Refactor abstürzt, verlieren solche Tools alles seit der letzten abgeschlossenen Session. claude-mem hat jede Beobachtung bis zum letzten Tool-Call.
Der Stop-Hook erzeugt etwas anderes: eine Session-Zusammenfassung mit Feldern wie request, investigated, learned, completed und next_steps. Damit erhält Claude eine Übersicht, ohne jede einzelne Beobachtung laden zu müssen.
Tausende Beobachtungen zu speichern ist das eine. Die richtigen in ein Kontextfenster zu laden, ohne Token zu verbrennen, ist etwas anderes.
Der naive Ansatz kippt historischen Kontext in den Prompt. Die Doku von claude-mem liefert Zahlen dazu: Ein typischer naiver Load schickt 35.000 Token ins Kontextfenster, von denen etwa 2.000 relevant sind. Das sind 6% Signalrate.
Ein dreistufiges Abrufsystem hebt das auf über 80%, indem Claude den Kontext schrittweise über claude-mem lädt:
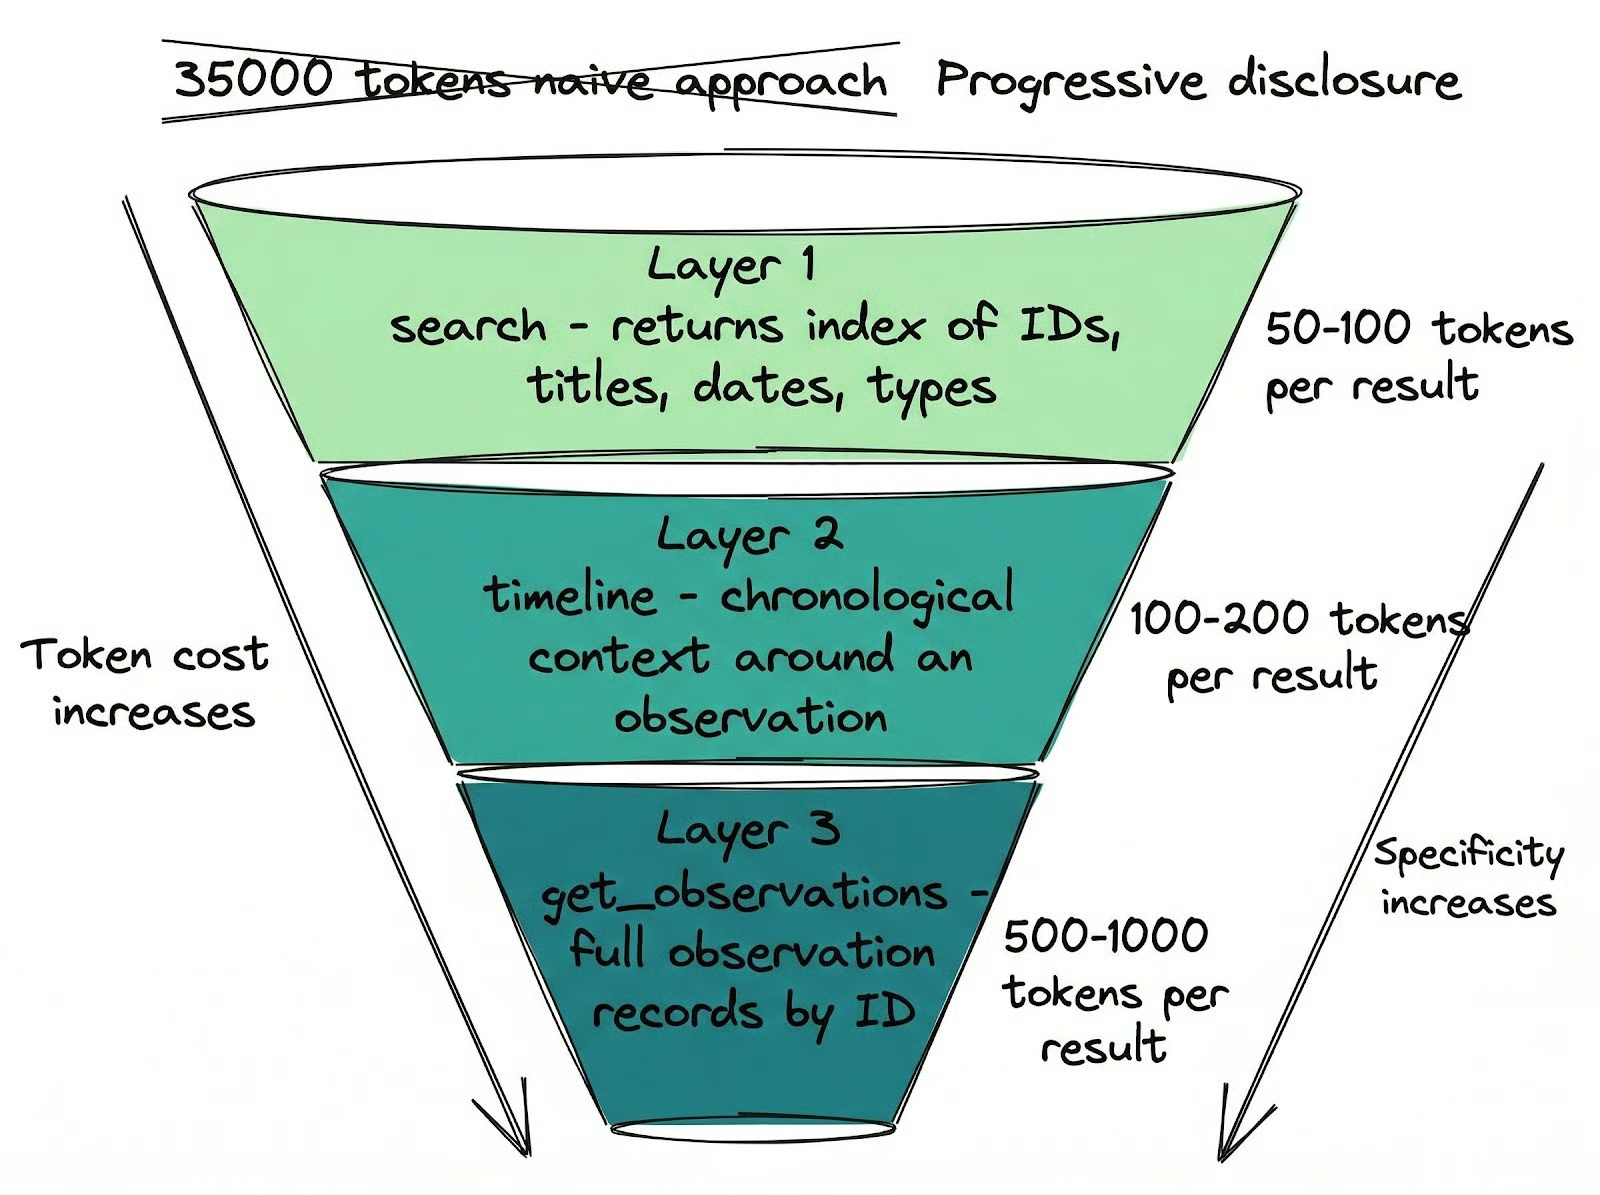
get_observations holt vollständige Beobachtungsdatensätze per ID in Batches. Kosten: 500–1.000 Token pro Ergebnis. Zieh nur, was du wirklich brauchst.Diese Abrufdisziplin setzt sich nicht von selbst durch.
claude-mem registriert ein MCP-Tool mit dem Namen __IMPORTANT, dessen einziger Zweck ist, Claude an dieses dreistufige Muster zu erinnern.
Ohne dieses Tool überspringt Claude die günstigen Ebenen und lädt alles in voller Detailtiefe – und konterkariert damit die gesamte Architektur. Dass ein benanntes Tool nötig ist, um Abrufdisziplin zu erzwingen, zeigt realistisch, wie das System um Claudes tatsächliches Verhalten herum konstruiert werden musste.
Diese Abruf-Tools kommen nicht nur zum Session-Start zum Einsatz.
Während der Session, wenn du Claude etwas zur vergangenen Arbeit fragst, durchsucht es den Speicher direkt.
Du kannst es bitten, deine Arbeitsmuster über Sessions hinweg zu analysieren, Details zu finden, die du vergessen hast ("Wo habe ich den API-Key gespeichert?", "Wie haben wir den Auth-Flow umgesetzt?"), oder bei einem Projekt weiterzumachen, das du seit Wochen nicht angerührt hast.
Wenn du mehrere Codebasen und Sessions jonglierst, entgleiten Details deinem eigenen Gedächtnis schneller als gedacht. claude-mem füllt diese Lücke, indem es Claude Zugriff auf alles gibt, was passiert ist – auch auf Dinge, die du selbst längst vergessen hast.
Nach drei Wochen sind 61% meiner Beobachtungen als discovery getaggt. Claude erfasst vor allem, was es über eine Codebasis lernt – nicht nur die Änderungen, die es vornimmt.
Über 259 Sessions hinweg habe ich 1.729 Session-Zusammenfassungen, durchschnittlich etwa 6–7 pro Session. Diese Session-übergreifende Kontinuität ist nur möglich, weil die Erfassung kontinuierlich läuft – nicht nur am Ende.
Das ist der Unterschied zwischen "eine Session zusammenfassen" und "sich wirklich erinnern".
Alle Einstellungen von claude-mem findest du im Web-UI unter http://localhost:37777 im Tab Settings. Alternativ kannst du Umgebungsvariablen setzen oder ~/.claude-mem/settings.json direkt bearbeiten.
Die erste wichtige Einstellung ist CLAUDE_MEM_MODEL – sie steuert, welches Modell die Komprimierung übernimmt. Der Standard ist haiku, bereits die günstigste Option in Claudes Modellpalette.
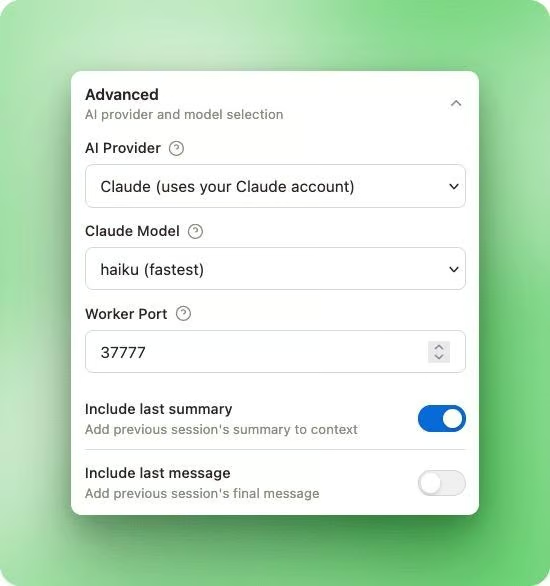
Mit CLAUDE_MEM_PROVIDER kannst du den Komprimierungs-Provider komplett wechseln. Er akzeptiert claude, gemini oder openrouter.
Wenn du die Komprimierung auf Gemini Flash Lite oder ein kostenloses OpenRouter-Modell wie xiaomi/mimo-v2-flash:free laufen lässt, sinken die Zusatzkosten auf null – oberhalb deines bestehenden Claude-Code-Abos.
Ich nutze haiku mit 30 Beobachtungen pro Session. Bei rund 400 Input-Token und 150 Output-Token pro Komprimierungs-Call sind das etwa 16.500 Token pro Session. Zu haiku-Konditionen kostet ein Monat intensiver Nutzung deutlich unter einem Dollar.
Nach drei Wochen über zehn Projekte hinweg war die Komprimierungsqualität kein Thema.
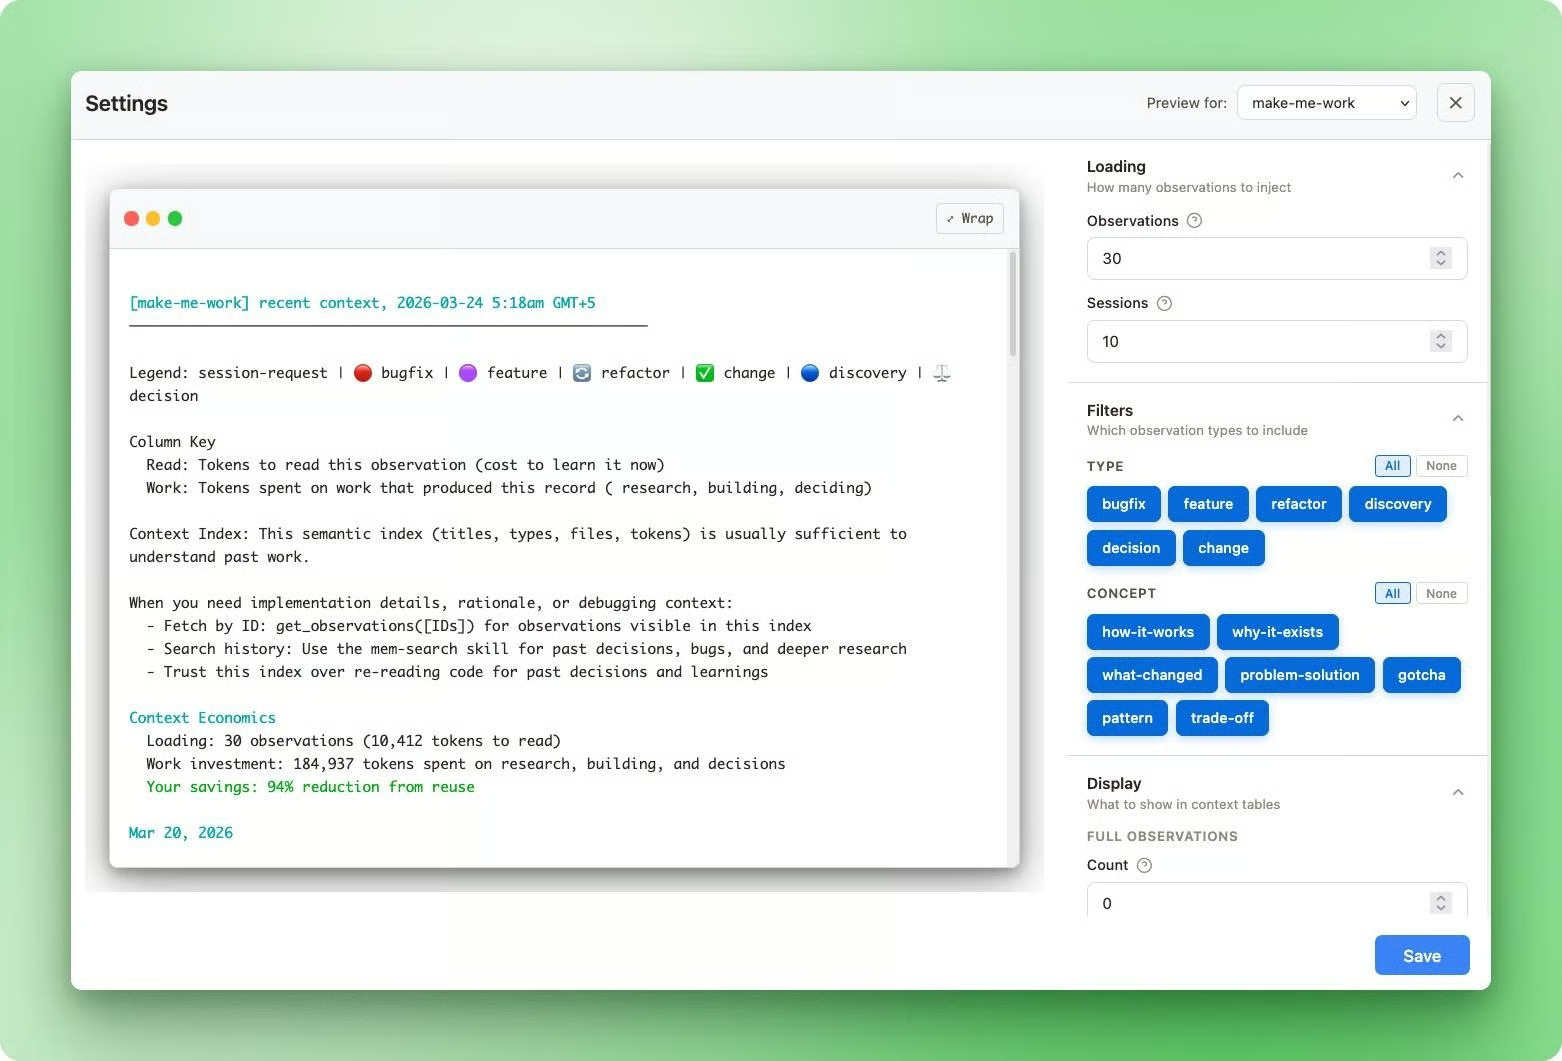
Zwei Einstellungen steuern, wie viel Kontext beim Session-Start geladen wird:
CLAUDE_MEM_CONTEXT_OBSERVATIONS: Gesamtzahl der beim SessionStart injizierten Beobachtungen (Standard 50, Bereich 1–200)CLAUDE_MEM_CONTEXT_FULL_COUNT: Anzahl davon, die mit vollständigem narrative-Feld in Detailtiefe angezeigt werden (Standard 5, Bereich 0–20)Der Rest zeigt nur Titel, Typ und Datum. Die Kontextinjektion ist immer auf das Projektverzeichnis begrenzt, in dem du arbeitest – Beobachtungen aus anderen Projekten blähen deinen Kontext nicht auf.
Im Web-UI kannst du exakt sehen, was injiziert wird, und diese Werte projektweise anpassen.
Eine Sache, die du einkalkulieren solltest: In der ersten Woche in einem neuen Projekt füllt sich dein Kontextfenster möglicherweise schneller als gewohnt.
Ich war in dieser Anfangsphase kurz davor, claude-mem zu deinstallieren, weil Sessions früher am Kontextlimit waren als zuvor.
Tatsächlich lernte claude-mem das Projekt von Grund auf, zeichnete viele neue Beobachtungen auf – und injizierte sie dann alle beim Session-Start.
Nach etwa einer Woche sank die Zahl der neuen Entdeckungen, weil Claude die Codebasis bereits kartiert hatte – und die Sessions dauerten länger als vor der Installation des Plugins.
Wenn dich dieser anfängliche Overhead trifft, senke CLAUDE_MEM_CONTEXT_OBSERVATIONS vorübergehend – und erhöhe es wieder, sobald die Lernphase vorbei ist.
CLAUDE_MEM_SKIP_TOOLS ermöglicht es dir, bestimmte Tools von der Erfassung auszuschließen.
Standardmäßig werden ohnehin laute Tools wie TodoWrite, AskUserQuestion und BashTool übersprungen. Du wirst das nur anfassen müssen, wenn ein Custom-Tool Ausgaben erzeugt, die du nicht speichern willst. Es ist eine kommagetrennte Liste – das Hinzufügen ist also unkompliziert.
Wenn du mit API-Keys oder Zugangsdaten arbeitest, kapsle sie in <private>-Tags in deinen Prompts ein, um diesen Inhalt von der Speicherung auszunehmen.
claude-mem entfernt alles innerhalb dieser Tags, bevor eine Beobachtung erstellt wird.
Dateiinhalte werden nicht proaktiv gescannt – Umgebungsvariablen, die von der Platte geladen werden, sind also nicht gefährdet. Alles, was du direkt in einen Prompt einfügst, schon. Der <private>-Ansatz ist opt-in: Du musst aktiv daran denken.
Claude Code bringt bereits Speicherfunktionen mit, aber keine davon erfasst Kontext automatisch.
CLAUDE.md-Dateien sind statisches Markdown, das beim Session-Start geladen wird – gut für Projektregeln und Präferenzen, aber ab ca. 200 Zeilen sinkt die Befolgung. Keine Suche, kein Abruf. Du schreibst einmal Anweisungen und hoffst, dass Claude sie beachtet.
Auto Memory, seit Claude Code v2.1.59, überlässt Claude selbst die Entscheidung, was zwischen Sessions gespeichert wird. Es legt unstrukturierte Notizen unter ~/.claude/projects/<project>/memory/ ab und lädt beim Start die ersten 200 Zeilen einer MEMORY.md.
In der Praxis deckt sich das Gespeicherte nicht immer mit dem, was du dir wünschst – und es gibt keine Möglichkeit, es nachträglich zu durchsuchen oder zu filtern. Am Ende hast du eine Textdatei mit Entscheidungen, die Claude vielleicht beachtet – oder nicht.
Der Befehl /compact rundet die integrierten Optionen ab, indem er deine Unterhaltung zusammenfasst, um Kontextplatz zu sparen. CLAUDE.md-Dateien bleiben bestehen, weil sie von der Platte neu eingelesen werden – alles andere verschwindet: Gesprächsanweisungen, Mid-Session-Kontext, alles, was du gesagt, aber nirgends notiert hast.
claude-mem schließt die Lücke, die keines davon füllt: automatische, kontinuierliche Erfassung mit strukturierter Komprimierung und tokenbewusstem Abruf. Es ist auch nicht das einzige Plugin in diesem Bereich.
|
Tool |
Architektur |
Speicher |
Suche |
Erfassungszeitpunkt |
Preis |
Über Geräte hinweg |
Team-Speicher |
|
Claude built-in |
Nativ |
Lokales Markdown |
Keine |
Manuell |
Kostenlos |
Über Git-Sync |
Über gemeinsame CLAUDE.md |
|
claude-mem |
Plugin (Hooks) |
Lokales SQLite + FTS5 |
FTS5-Keywordsuche |
Pro Tool-Call |
Kostenlos |
Nein |
Nein |
|
memsearch |
Plugin (Hooks + Skill) |
Lokales Markdown + Milvus |
Hybride Dense + BM25 |
Session-Ende |
Kostenlos |
Nein |
Nein |
|
supermemory |
Plugin (Hooks + Cloud) |
Cloud |
Semantisch + zeitlich |
Session-Ende |
Kostenpflichtig |
Ja |
Ja |
|
mem0 (self-hosted) |
MCP-Server |
Lokales Qdrant + Ollama |
Semantischer Vektor |
Session-Ende |
Kostenlos |
Nein |
Nein |
memsearch ist die nächstliegende kostenlose Alternative, wenn du Markdown-Dateien statt einer Datenbank möchtest und keinen Hintergrundprozess laufen lassen willst. Der Abruf läuft in einem isolierten Subagenten, sodass Suchergebnisse nie dein Haupt-Kontextfenster verunreinigen. Nutze es, wenn du ein einfacheres Setup bevorzugst und keine Erfassung pro Tool-Call brauchst.
supermemory ist die richtige Wahl, wenn du geräteübergreifende Synchronisation und gemeinsamen Team-Speicher brauchst – erfordert allerdings ein Abo.
Der selbstgehostete mem0-Stack fährt einen ganz anderen Ansatz: Qdrant und Neo4j für Graph-basiertes Entity-Tracking, keine Zusatzkosten, aber ein schwereres Setup – lohnt sich nur, wenn du diese Infrastruktur ohnehin betreibst.
claude-mem sitzt in der Mitte. Voll lokal, kostenlos, Erfassung pro Tool-Call mit strukturierter Komprimierung. Der Trade-off: ein Hintergrund-Worker-Prozess auf Port 37777 und ein paar raue Kanten, die noch nicht glattgezogen sind.
Die Sicherheitslage ist die größte Sorge.
Ein Community-Audit im Februar 2026 stufte das Risiko als HOCH ein – die Issues sind weiterhin offen.
Die HTTP-API auf Port 37777 hat keine Authentifizierung: Jeder Prozess auf deiner Maschine kann alle gespeicherten Beobachtungen lesen, deine Einstellungen (inklusive etwaiger API-Keys im Klartext) einsehen und beliebige Erinnerungen in die Datenbank injizieren.
Die Standard-Host-Bindung war 0.0.0.0 statt 127.0.0.1 – auf Cloud-VMs oder Maschinen ohne Firewall ist die API damit im Netzwerk exponiert.
Die Tools smart_unfold und smart_outline haben außerdem eine Path-Traversal-Schwachstelle ohne Verzeichnisgrenzen-Prüfung.
Nutze das nur auf einer persönlichen Dev-Maschine.
Auch bei der Zuverlässigkeit gibt es ein paar scharfe Kanten.
Die ChromaDB-Integration hat ein bekanntes Subprozess-Leck: Ein Nutzer fand 184 verwaiste Prozesse in 19 Stunden – rund 16 GB RAM-Verbrauch.
Ursache war ein korruptes ONNX-Modell, das endlose Retry-Schleifen auslöste. Bleib stattdessen bei FTS5 (der integrierten Volltextsuche von SQLite) – sie funktioniert ohne ChromaDB und war in meiner Erfahrung stabil.
Auf macOS mit Apple Silicon kann der Worker-Kaltstart die hart codierten 5 Sekunden überschreiten, wenn ChromaDB aktiviert ist – dadurch schlägt der SessionStart-Hook fehl. FTS5-only-Setups sind nicht betroffen. Außerdem gibt es einen aktiven Bug, bei dem die MCP-Tools search und timeline leere Parameterschemata haben – Claude kann ihnen also keine Queries übergeben. get_observations funktioniert einwandfrei.
Für die lokale Entwicklung auf einer persönlichen Maschine sind das keine Showstopper. Aber du solltest es wissen, bevor du etwas installierst, das Zugriff auf deine gesamte Session-Historie hat.
Nach drei Wochen fällt mir vor allem auf, was ich nicht mehr tue: Ich erkläre nicht jedes Mal die Projektstruktur neu. Ich laufe nicht erneut eine Debugging-Spur ab, die wir schon gegangen sind. Claude kommt mit Kontext an – und wir machen da weiter, wo wir aufgehört haben.
Die Architektur macht das möglich – auf eine Weise, die einfachere Ansätze nicht leisten. Nur am Session-Ende zu erfassen heißt, bei einem Crash alles zu verlieren. Historie ohne Abrufebenen zu dumpen heißt, Token für Rauschen auszugeben. Die Designentscheidungen hier sind bewusst – und wer sie kennt, kann das Tool feinjustieren, statt es nur zu vertrauen.
Die oben genannten Sicherheitslücken sind real und weiterhin offen. Das lohnt sich auf einer persönlichen Dev-Maschine. Auf einer Cloud-VM oder gemeinsam genutzten Maschine ist es das nicht – bis die Issues gefixt sind. Für lokale Solo-Entwicklung sind die Trade-offs gut handhabbar.
Wenn du tiefer einsteigen willst, ist DataCamps Introduction to Claude ein guter Einstieg, um zu verstehen, wie Claude Code funktioniert – bevor du Plugins obendrauf packst.
Top-DataCamp-Kurse
Kurs
Kurs
Kurs
Blog
Nathaniel Taylor-Leach
4 Min.
Blog
Tutorial
Stephen Gruppetta
12 Min.
Tutorial
Kurtis Pykes
15 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Javier Canales Luna
11 Min.