Kursus
Pengantar Model Claude
3 jam
14.6K
Beberapa minggu lalu, saya memasang claude-mem di semua proyek saya. Sejak itu, ia telah menangkap 6.814 observasi di 259 sesi, mencakup sepuluh codebase berbeda, semuanya tersimpan dalam berkas SQLite 39 MB di laptop saya.
Sebelumnya, setiap sesi Claude Code selalu dimulai dari nol. Saya membuka sesi baru dan menghabiskan sepuluh menit pertama untuk menjelaskan ulang struktur proyek. Bug autentikasi yang kami perbaiki bersama sehari sebelumnya? Claude tidak tahu. Ia akan membaca ulang berkas yang sudah dianalisisnya, lalu berakhir pada asumsi salah yang sudah kami koreksi.
claude-mem adalah plugin Claude Code yang memperbaiki masalah ini dengan menangkap apa yang terjadi selama sesi dan menyediakannya untuk sesi-sesi berikutnya.
Pada artikel ini, saya akan membahas cara kerjanya di balik layar, cara memasangnya tanpa terjebak kesalahan umum, cara menyetelnya sesuai anggaran Anda, dan hal-hal yang perlu Anda ketahui sebelum menjalankannya di produksi.
claude-mem adalah plugin Claude Code yang:
~/.claude-mem/claude-mem.dbIni berjalan sebagai plugin, bukan sebagai server MCP.
Pembedaan ini penting: plugin berjalan otomatis pada peristiwa siklus hidup seperti awal sesi dan setiap pemanggilan alat, sementara server MCP tetap idle sampai Claude memutuskan untuk memanggilnya.
Dengan pendekatan berbasis MCP, pengambilan kembali hanya terjadi ketika Claude berpikir untuk memintanya. claude-mem menangkap dan menyuntikkan tanpa harus menunggu Claude memilih untuk melakukannya.
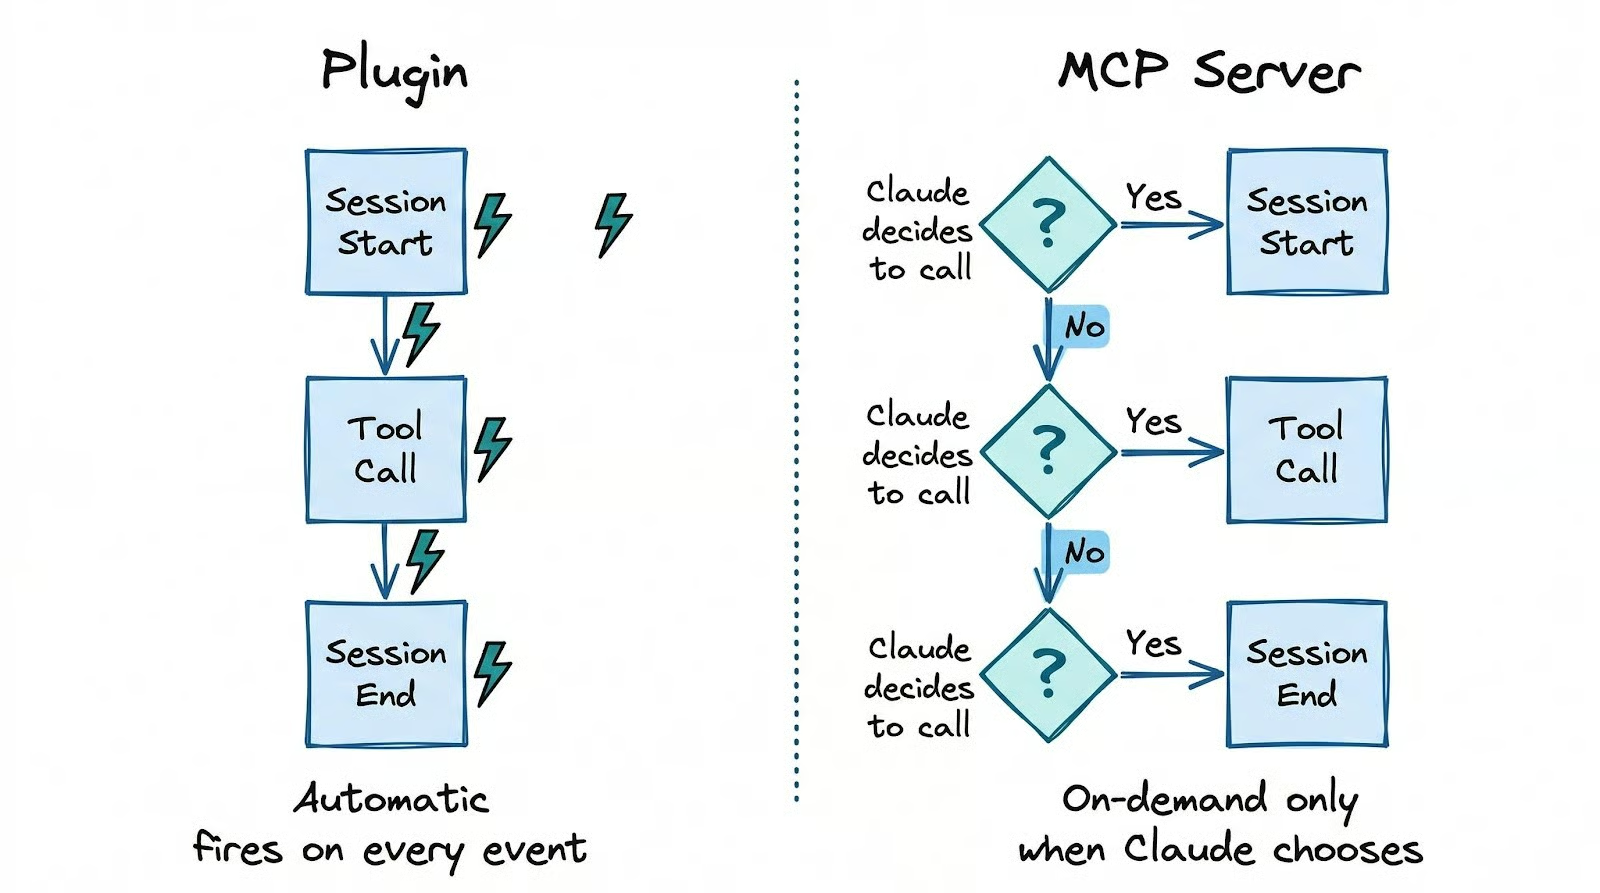
Semua tetap berada di mesin Anda, dan kompresi berjalan dengan autentikasi Claude Code yang sudah ada, jadi tidak perlu kunci API atau akun terpisah.
Menjalankannya cukup dengan dua perintah di dalam sesi Claude Code:
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
Mulai ulang Claude Code setelah itu.
Kesalahan umum adalah menjalankan npm install -g claude-mem, yang hanya memasang pustaka SDK. Hook tidak terdaftar, worker tidak pernah berjalan, dan tidak ada yang berfungsi.
Jalur marketplace plugin adalah satu-satunya yang memberi Anda setelan lengkap. Satu-satunya prasyarat keras adalah Node.js 18+. Selebihnya (Bun, uv, SQLite) terpasang otomatis saat pertama kali dijalankan.
Untuk memverifikasi pemasangan benar-benar berhasil, cek tiga hal. Pertama, curl http://localhost:37777/api/health harus mengembalikan {"status":"ok"}. Jika gagal, worker latar belakang tidak mulai. Penyebab paling umum adalah versi Node.js di bawah 18.
Kedua, periksa bahwa ~/.claude/hooks.json memuat entri claude-mem. Jika berkas tersebut tidak mencantumkan claude-mem di bawah PostToolUse dan SessionStart, hook tidak terdaftar, dan penangkapan tidak akan berjalan meski worker hidup.
Ketiga, buka http://localhost:37777 di peramban untuk melihat penampil web yang menunjukkan aliran observasi secara real-time saat Anda bekerja.
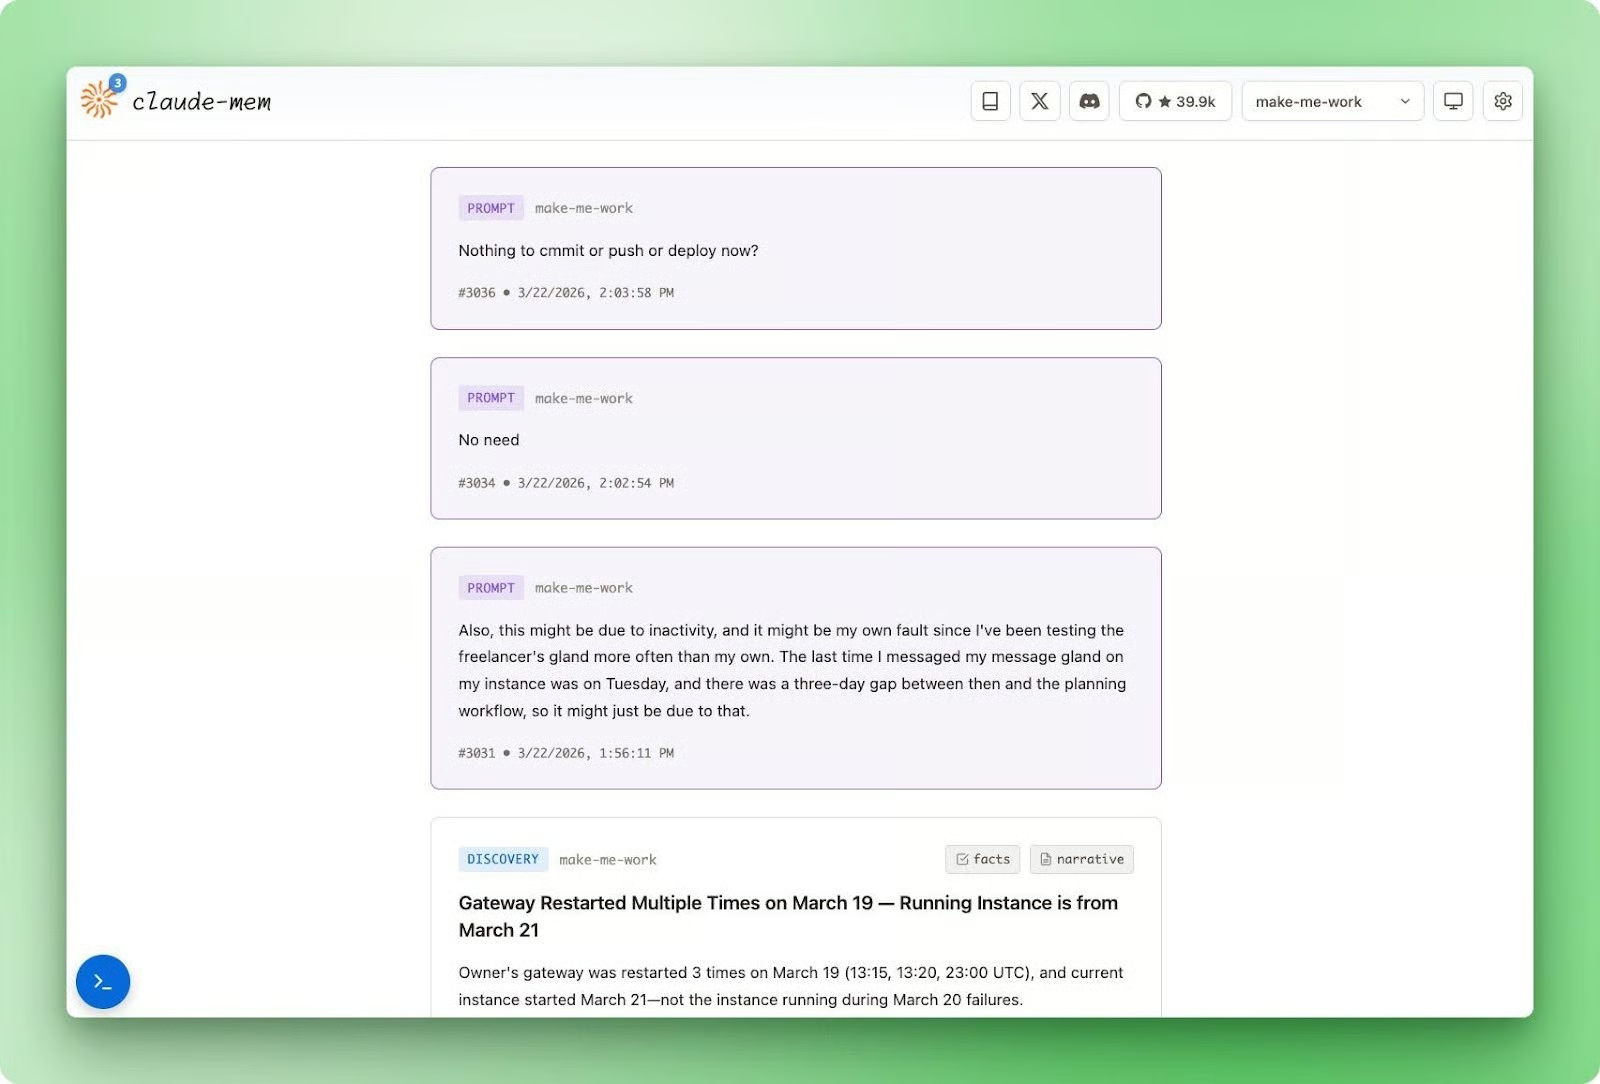
Sesi pertama tidak menghasilkan konteks tersuntik di SessionStart karena basis data kosong, tetapi observasi mulai terkumpul sejak pemanggilan alat pertama.
Pada sesi kedua, claude-mem akan memiliki ringkasan sesi dan sekumpulan observasi untuk disuntikkan.
Menjalankan daftar periksa verifikasi lebih dulu menyelamatkan Anda dari penemuan tiga sesi kemudian bahwa tidak ada yang pernah ditangkap. Penampil web adalah sinyal paling andal: jika Anda melihat observasi muncul setelah pemanggilan alat, semuanya tersambung dengan benar.
Setelah dipasang, claude-mem berjalan diam-diam di latar belakang melalui lima hook siklus hidup. Memahami fungsi tiap hook menjelaskan mengapa alat berperilaku seperti itu.
Kelima hook dipetakan ke linimasa alami sebuah sesi:
SessionStart melakukan kueri ke basis data dan menyuntikkan indeks terkompresi dari pekerjaan terbaru ke jendela konteks AndaUserPromptSubmit mencatat sesi dan menyimpan prompt AndaPostToolUse berjalan setelah setiap pemanggilan alat dan mengirim keluaran mentah ke worker latar belakang untuk dikompresiStop menghasilkan ringkasan tingkat sesi saat Anda jeda atau idleSessionEnd menandai sesi selesai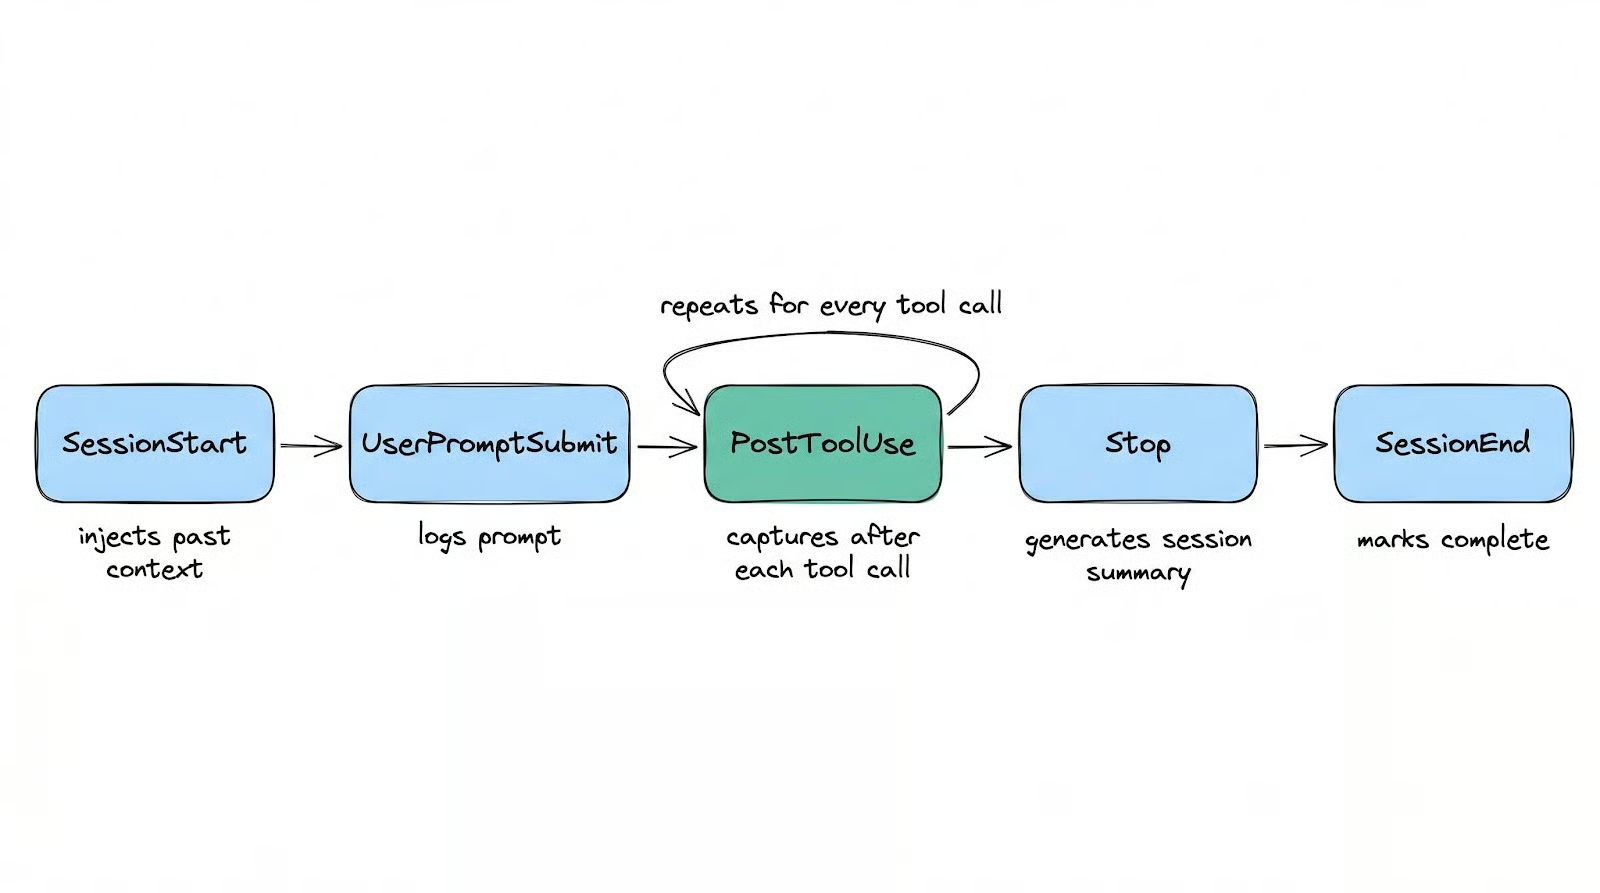
SessionStart membangun indeks tersuntik dari ringkasan sesi, judul observasi yang dikelompokkan menurut tipe, dan stempel waktu: peta yang dapat dicari tentang pekerjaan terbaru yang dapat dirujuk Claude sepanjang sesi tanpa Anda melakukan apa pun.
PostToolUse berjalan setelah setiap pemanggilan alat. Ia mengirim keluaran mentah ke worker latar belakang melalui HTTP POST non-blocking (rata-rata 8 ms), dan worker mengompresnya menjadi observasi terstruktur menggunakan Claude Agent SDK.
Strukturnya terlihat seperti ini:
|
Field |
What it contains |
|
|
Salah satu dari |
|
|
String yang ringkas dan mudah dicari |
|
|
Array fakta-fakta diskret (~50 token, murah untuk dimuat) |
|
|
Penjelasan prosa (~155-500 token, hanya dimuat sesuai kebutuhan) |
|
|
Tag semantik seperti how-it-works, problem-solution, gotcha, trade-off |
Penangkapan per panggilan inilah yang membedakan claude-mem dari alat yang merangkum di akhir sesi dengan satu panggilan AI.
Jika sesi Anda crash di tengah refactor, alat seperti itu kehilangan semua yang terjadi sejak sesi terakhir selesai. claude-mem memiliki setiap observasi hingga pemanggilan alat terakhir.
Hook Stop menghasilkan sesuatu yang berbeda: ringkasan tingkat sesi dengan field seperti request, investigated, learned, completed, dan next_steps. Ini memberi Claude peta tingkat tinggi tentang apa yang terjadi tanpa memuat setiap observasi individual.
Menyimpan ribuan observasi adalah satu hal. Memuat yang tepat ke jendela konteks tanpa membakar token adalah masalah lain.
Pendekatan naif adalah menuangkan konteks historis ke dalam prompt. Dokumentasi claude-mem memberi angka: muatan naif tipikal mengirim 35.000 token ke jendela konteks, di mana sekitar 2.000 yang benar-benar relevan. Itu tingkat sinyal 6%.
Sistem pengambilan tiga lapis mendorongnya di atas 80% dengan membiarkan Claude memuat konteks secara progresif melalui claude-mem:
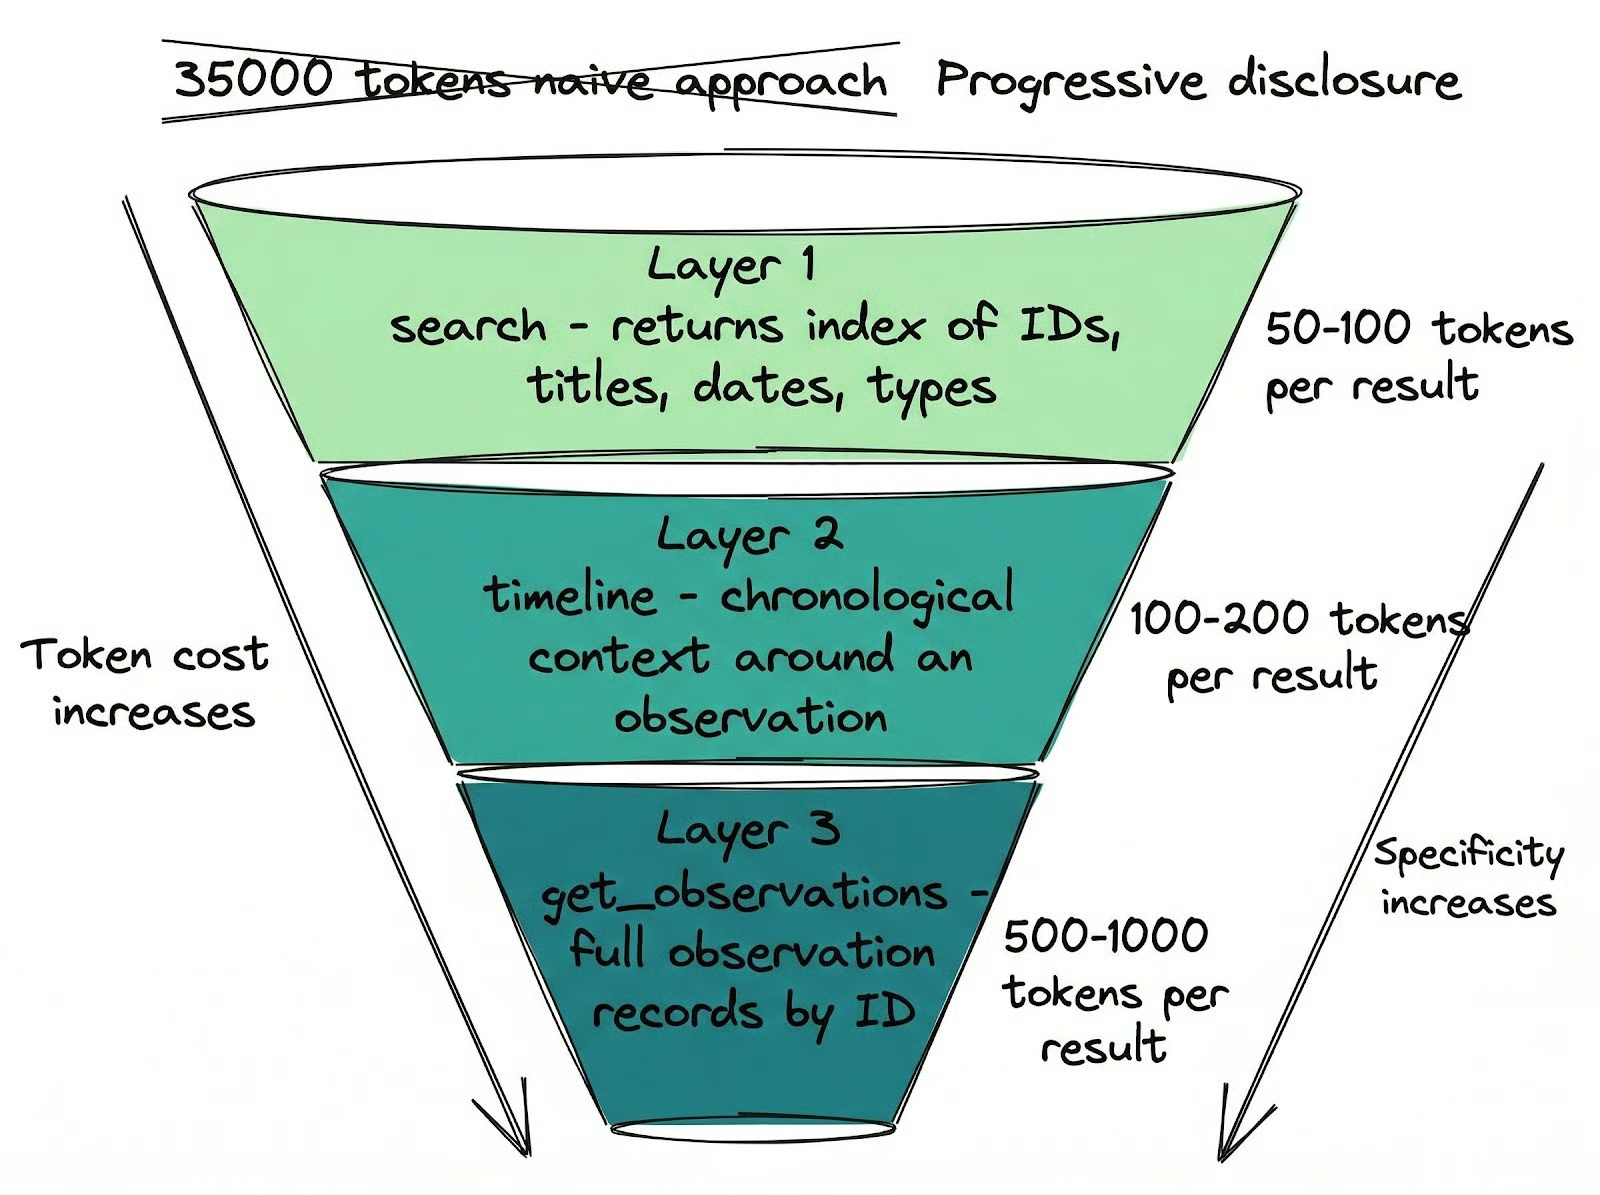
get_observations mengambil rekaman observasi penuh berdasarkan ID secara batch. Biaya: 500–1.000 token per hasil. Hanya tarik yang benar-benar Anda perlukan.Disiplin pengambilan kembali itu tidak menerapkan dirinya sendiri.
claude-mem mendaftarkan alat MCP bernama __IMPORTANT yang satu-satunya tujuan adalah mengingatkan Claude untuk mengikuti pola tiga langkah ini.
Tanpanya, Claude melewati lapisan murah dan mengambil semuanya dengan detail penuh, menggagalkan seluruh arsitektur. Fakta bahwa harus ditambahkan alat bernama khusus hanya untuk menegakkan disiplin pengambilan kembali memberi gambaran realistis bagaimana sistem harus dirancang menyesuaikan perilaku nyata Claude.
Alat pengambilan ini tidak hanya digunakan saat awal sesi.
Selama sesi, ketika Anda menanyakan sesuatu kepada Claude tentang pekerjaan masa lalu, ia mencari langsung di memori.
Anda bisa memintanya menganalisis pola kerja Anda lintas sesi, menemukan detail yang Anda lupakan ("di mana saya menyimpan kunci API itu?", "bagaimana kita menerapkan alur autentikasi?"), atau melanjutkan dari titik terakhir pada proyek yang tidak Anda sentuh selama berminggu-minggu.
Saat Anda menangani banyak codebase dan sesi, detail bocor dari ingatan Anda sendiri lebih cepat daripada yang Anda perkirakan. claude-mem menutup celah itu dengan memberi Claude akses ke semua yang terjadi, bahkan hal-hal yang sudah Anda sendiri lupakan.
Setelah tiga minggu, 61% observasi saya bertipe discovery. Claude paling banyak menangkap apa yang dipelajarinya tentang sebuah codebase alih-alih hanya perubahan yang dibuatnya.
Di 259 sesi, saya memiliki 1.729 ringkasan sesi, rata-rata sekitar 6–7 per sesi. Keberlanjutan lintas sesi itu hanya mungkin karena penangkapan berjalan terus-menerus, bukan hanya di akhir.
Itulah perbedaan antara merangkum sebuah sesi dan benar-benar mengingatnya.
Semua pengaturan claude-mem dapat diakses melalui UI web di http://localhost:37777 pada tab Settings. Anda juga dapat menentukannya sebagai variabel lingkungan atau menyunting ~/.claude-mem/settings.json secara langsung.
Pengaturan pertama yang patut diketahui adalah CLAUDE_MEM_MODEL, yang mengendalikan model mana yang menangani kompresi. Bawaan adalah haiku, yang sudah merupakan opsi termurah di lini model Claude.
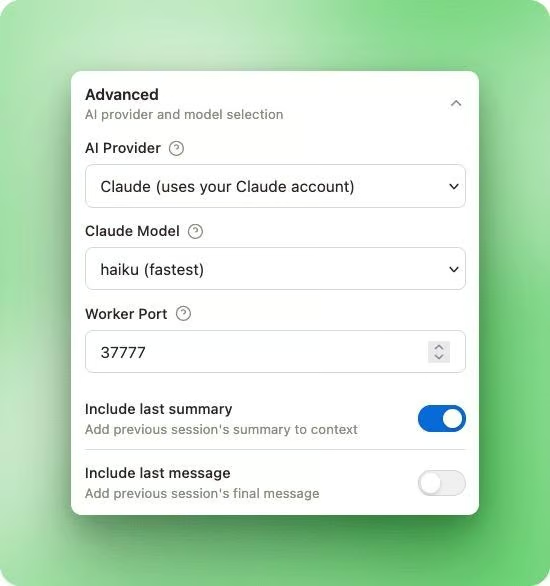
Anda juga dapat mengganti penyedia kompresi sepenuhnya dengan CLAUDE_MEM_PROVIDER, yang menerima claude, gemini, atau openrouter.
Menjalankan kompresi pada Gemini Flash Lite atau model gratis OpenRouter seperti xiaomi/mimo-v2-flash:free menurunkan biaya menjadi nol di luar langganan Claude Code Anda saat ini.
Saya menjalankannya di haiku dengan 30 observasi per sesi. Dengan kira-kira 400 token masukan dan 150 token keluaran per panggilan kompresi, totalnya sekitar 16.500 token per sesi. Pada tarif haiku, sebulan pemakaian berat biayanya jauh di bawah satu dolar.
Setelah tiga minggu di sepuluh proyek, kualitas kompresi tidak menjadi masalah.
Dua pengaturan mengendalikan seberapa banyak konteks dimuat pada awal sesi:
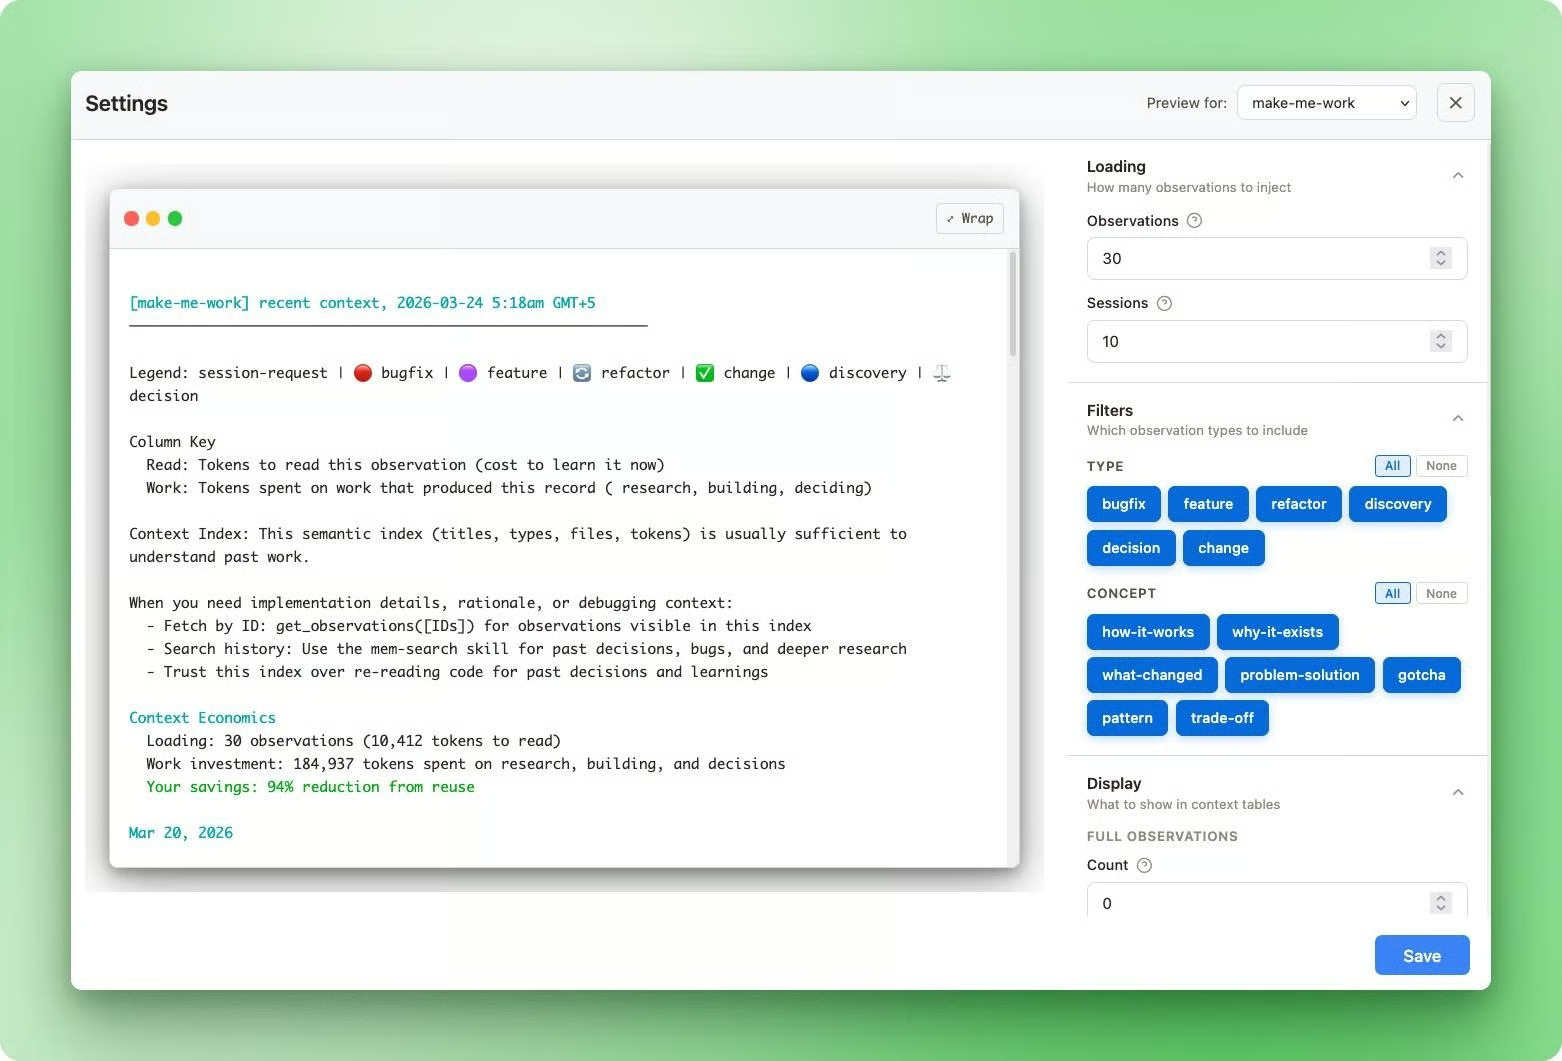
CLAUDE_MEM_CONTEXT_OBSERVATIONS: jumlah total observasi yang disuntikkan pada SessionStart (bawaan 50, rentang 1–200)CLAUDE_MEM_CONTEXT_FULL_COUNT: berapa banyak yang menampilkan detail diperluas dengan field narrative penuh (bawaan 5, rentang 0–20)Sisanya hanya menampilkan judul, tipe, dan tanggal. Semua penyuntikan konteks dibatasi pada direktori proyek tempat Anda bekerja, sehingga observasi dari proyek lain tidak membuat konteks Anda berantakan.
Anda dapat melihat pratinjau persis apa yang disuntikkan dan menyesuaikan jumlah ini per proyek melalui UI web.
Satu hal yang perlu diantisipasi: pada minggu pertama di proyek baru, jendela konteks Anda mungkin terisi lebih cepat dari biasanya.
Saya hampir mencopot claude-mem pada masa awal itu karena sesi cepat mencapai batas konteks dibanding sebelumnya.
Yang terjadi adalah claude-mem mempelajari proyek dari nol, mencatat volume observasi baru yang tinggi dan semuanya disuntikkan saat awal sesi.
Setelah sekitar seminggu, volume penemuan baru turun karena Claude sudah memetakan codebase, dan sesi mulai bertahan lebih lama dibanding sebelum saya memasang plugin.
Jika Anda mengalami overhead awal itu, turunkan CLAUDE_MEM_CONTEXT_OBSERVATIONS sementara dan naikkan kembali setelah periode pembelajaran awal mereda.
CLAUDE_MEM_SKIP_TOOLS memungkinkan Anda mengecualikan alat tertentu dari penangkapan.
Bawaan sudah melewati alat berisik seperti TodoWrite, AskUserQuestion, dan BashTool. Mungkin Anda tidak perlu menyentuh ini kecuali memiliki alat kustom yang menghasilkan keluaran yang tidak ingin disimpan. Daftarnya dipisahkan koma, jadi menambahkan alat itu mudah.
Jika Anda bekerja dengan kunci API atau kredensial, bungkus dalam tag <private> di dalam prompt Anda untuk mengecualikan konten tersebut dari penyimpanan.
claude-mem menghapus apa pun di dalam tag tersebut sebelum membuat observasi.
Ia tidak memindai isi berkas secara proaktif, jadi variabel lingkungan yang dimuat dari disk tidak berisiko, tetapi apa pun yang Anda tempel langsung ke prompt berisiko. Pendekatan tag <private> berarti perlindungan bersifat opt-in: Anda harus ingat untuk menggunakannya.
Claude Code sudah dilengkapi fitur memori, tetapi tidak ada yang menangkap konteks secara otomatis.
CLAUDE.md adalah markdown statis yang dimuat saat awal sesi, berguna untuk aturan dan preferensi proyek, tetapi dibatasi sekitar 200 baris sebelum kepatuhan menurun. Tidak ada pencarian, tidak ada pengambilan kembali. Anda menulis instruksi sekali dan berharap Claude mengikutinya.
Auto Memory, ditambahkan di Claude Code v2.1.59, membuat Claude sendiri yang memutuskan apa yang disimpan antar sesi. Ia menyimpan catatan tak terstruktur di ~/.claude/projects/<project>/memory/ dan memuat 200 baris pertama berkas MEMORY.md saat mulai.
Dalam praktiknya, yang disimpan tidak selalu selaras dengan yang Anda inginkan, dan tidak ada cara untuk mencari atau memfilternya setelahnya. Anda akhirnya mendapatkan berkas teks berisi keputusan yang bisa jadi diperhatikan atau tidak oleh Claude.
Perintah /compact melengkapi opsi bawaan dengan merangkum percakapan Anda untuk mengosongkan ruang konteks. Berkas CLAUDE.md bertahan karena dibaca ulang dari disk, tetapi yang lain lenyap: instruksi percakapan, konteks tengah sesi, apa pun yang Anda ucapkan namun tidak ditulis di suatu tempat.
claude-mem menutup celah yang tidak diisi oleh semua ini: penangkapan berkelanjutan otomatis dengan kompresi terstruktur dan pengambilan kembali yang peka token. Ini juga bukan satu-satunya plugin yang melakukan pekerjaan ini.
|
Tool |
Architecture |
Storage |
Search |
Capture timing |
Pricing |
Cross-machine |
Team memory |
|
Claude built-in |
Native |
Local markdown |
None |
Manual |
Free |
Via git sync |
Via shared CLAUDE.md |
|
claude-mem |
Plugin (hooks) |
Local SQLite + FTS5 |
FTS5 keyword |
Per tool call |
Free |
No |
No |
|
memsearch |
Plugin (hooks + skill) |
Local markdown + Milvus |
Hybrid dense + BM25 |
Session end |
Free |
No |
No |
|
supermemory |
Plugin (hooks + cloud) |
Cloud |
Semantic + temporal |
Session end |
Paid |
Yes |
Yes |
|
mem0 (self-hosted) |
MCP server |
Local Qdrant + Ollama |
Semantic vector |
Session end |
Free |
No |
No |
memsearch adalah alternatif gratis paling dekat jika Anda menginginkan berkas markdown alih-alih basis data dan tidak ingin proses latar belakang berjalan. Ia menjalankan pengambilan dalam subagen terisolasi, sehingga hasil pencarian tidak pernah bercampur ke jendela konteks utama Anda. Gunakan jika Anda lebih suka setup sederhana dan tidak butuh penangkapan per panggilan.
supermemory tepat jika Anda butuh sinkron lintas mesin dan memori tim bersama, meski memerlukan langganan berbayar.
Tumpukan mem0 yang di-host sendiri mengambil pendekatan berbeda sama sekali: Qdrant dan Neo4j untuk pelacakan entitas berbasis grafik, tanpa biaya tambahan, tetapi setup yang lebih berat dan hanya layak jika Anda sudah menjalankan infrastrukturnya.
claude-mem berada di tengah. Sepenuhnya lokal, gratis, penangkapan per panggilan dengan kompresi terstruktur. Komprominya adalah proses worker latar belakang pada port 37777 dan beberapa sisi kasar yang belum dipoles.
Gambaran keamanan adalah kekhawatiran terbesar.
Sebuah audit komunitas pada Februari 2026 menilai risikonya TINGGI, dan isu-isu tersebut masih terbuka.
HTTP API pada port 37777 tidak memiliki autentikasi: proses apa pun di mesin Anda dapat membaca setiap observasi yang disimpan, melihat pengaturan Anda (termasuk kunci API dalam teks jelas), dan menyuntikkan memori sewenang-wenang ke basis data.
Pengikatan host bawaan adalah 0.0.0.0 alih-alih 127.0.0.1, yang pada VM cloud atau mesin tanpa firewall berarti API terekspos ke jaringan.
Alat smart_unfold dan smart_outline juga memiliki kerentanan traversal path tanpa pemeriksaan batas direktori.
Jalankan ini hanya di mesin pengembangan pribadi.
Reliabilitas juga memiliki beberapa sisi tajam.
Integrasi ChromaDB memiliki kebocoran subprocess yang diketahui: seorang pengguna menelusurinya hingga 184 proses yatim dalam 19 jam, mengonsumsi sekitar 16 GB RAM.
Penyebab utamanya adalah model ONNX yang rusak memicu loop retry tak terbatas. Gunakan FTS5 (mesin pencari teks penuh bawaan SQLite) sebagai gantinya, yang bekerja tanpa ChromaDB dan andal berdasarkan pengalaman saya.
Di macOS dengan Apple Silicon, waktu mulai dingin worker bisa melebihi timeout 5 detik yang dikodekan keras saat ChromaDB diaktifkan, menyebabkan hook SessionStart gagal. Ini tidak memengaruhi setup FTS5 saja. Ada juga bug aktif di mana alat MCP search dan timeline memiliki skema parameter kosong, sehingga Claude tidak dapat meneruskan kueri kepada keduanya. get_observations berfungsi baik.
Ini bukan pembatal kesepakatan untuk pengembangan lokal di mesin pribadi. Namun patut diketahui sebelum Anda memasang sesuatu yang memiliki akses ke seluruh riwayat sesi Anda.
Setelah tiga minggu, hal utama yang saya perhatikan adalah apa yang tidak lagi saya lakukan. Saya tidak menjelaskan ulang struktur proyek di awal setiap sesi. Saya tidak menelusuri ulang jalur debugging yang sudah kami jalani. Claude datang dengan konteks, dan kami mulai dari titik terakhir.
Arsitekturnya membuat ini mungkin dengan cara yang tidak dilakukan pendekatan lebih sederhana. Menangkap sekali di akhir sesi berarti kehilangan semuanya jika sesi crash. Menuangkan riwayat tanpa lapisan pengambilan berarti menghabiskan token untuk noise. Pilihan desain di sini disengaja, dan memahaminya membantu Anda menyetel alat alih-alih sekadar mempercayainya.
Kesenjangan keamanan yang dibahas di atas nyata, dan masih terbuka. Ini layak dijalankan di mesin dev pribadi. Tidak layak dijalankan di VM cloud atau mesin bersama sampai isu-isu itu ditambal. Namun untuk pengembangan lokal solo, komprominya masih bisa dikelola.
Jika Anda ingin mendalami, kursus DataCamp Introduction to Claude adalah titik awal yang solid untuk memahami cara kerja Claude Code sebelum menambahkan plugin di atasnya.
Kursus Top DataCamp
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt