Corso
Introduzione ai modelli Claude
3 ore
14.6K
Qualche settimana fa ho installato claude-mem su tutti i miei progetti. Da allora ha catturato 6.814 osservazioni in 259 sessioni, coprendo dieci codebase diverse, tutte in un file SQLite da 39 MB sul mio laptop.
Prima, ogni sessione di Claude Code partiva da zero. Aprivo una nuova sessione e passavo i primi dieci minuti a rispiegare la struttura del progetto. Il bug di autenticazione che avevamo corretto insieme il giorno prima? Claude non ne sapeva nulla. Rileggeva file già analizzati, per poi arrivare alle stesse ipotesi sbagliate che avevamo già corretto.
claude-mem è un plugin per Claude Code che risolve questo problema catturando ciò che accade durante una sessione e rendendolo disponibile a quelle future.
In questo articolo vedremo come funziona davvero sotto il cofano, come installarlo evitando le trappole più comuni, come tararlo in base al tuo budget e cosa sapere prima di usarlo in produzione.
claude-mem è un plugin di Claude Code che:
~/.claude-mem/claude-mem.dbFunziona come plugin, non come server MCP.
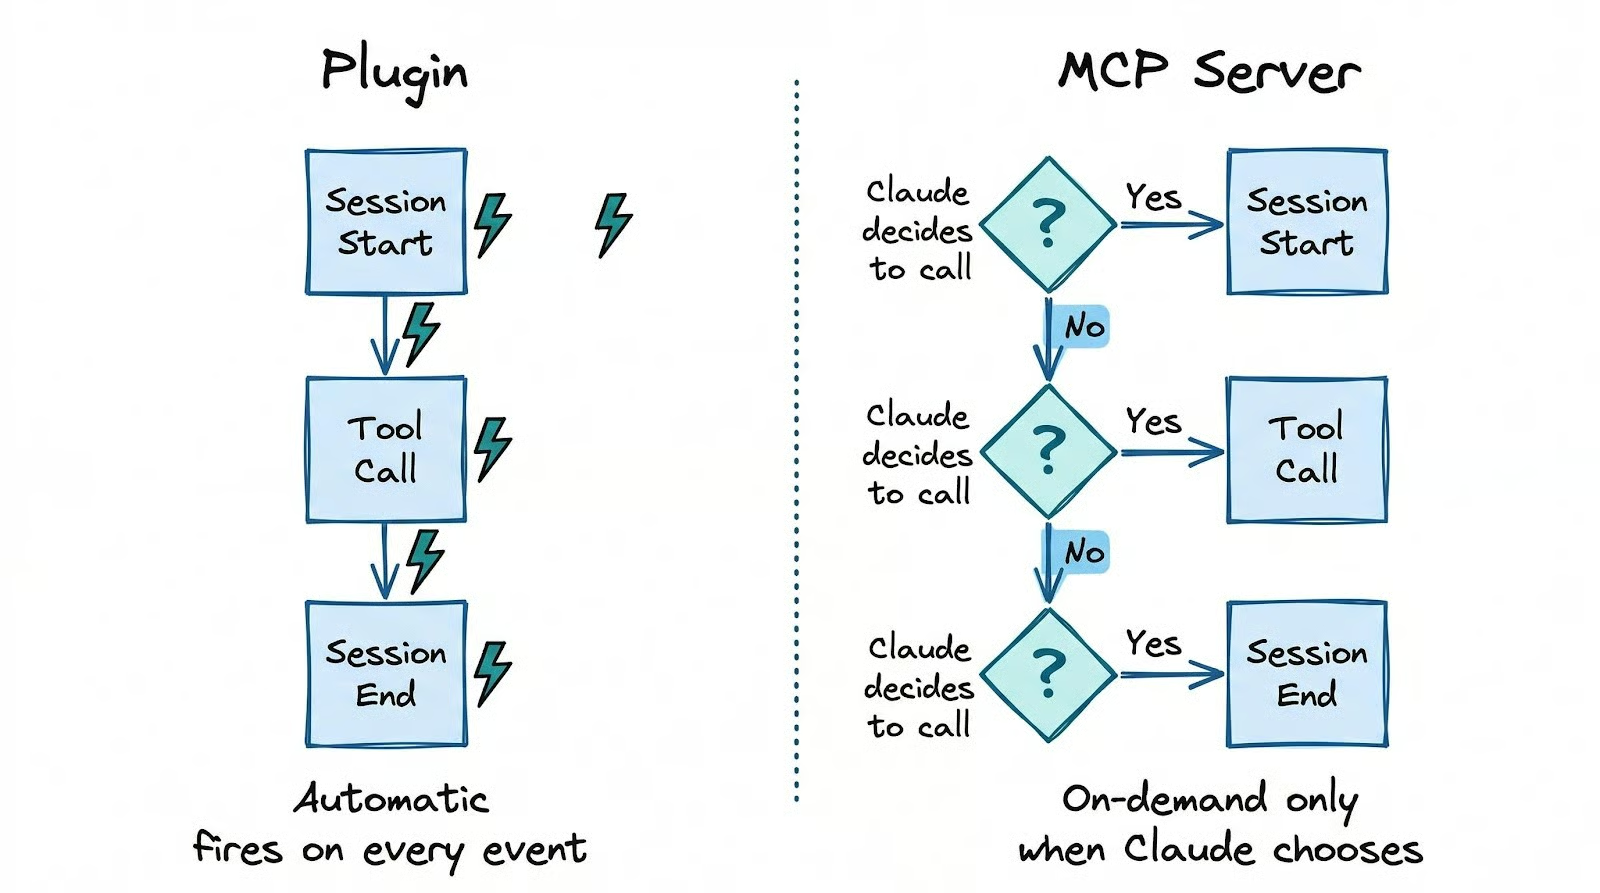
Questa distinzione conta: i plugin si attivano automaticamente su eventi del ciclo di vita come l'avvio della sessione e ogni chiamata a uno strumento, mentre i server MCP restano inattivi finché Claude non decide di chiamarli.
Con un approccio basato su MCP, il recupero avviene solo quando Claude pensa di richiederlo. claude-mem cattura e inietta senza che Claude debba scegliere di farlo.
Tutto resta sulla tua macchina e la compressione usa l'autenticazione già presente in Claude Code, quindi non servono chiavi API o account separati.
Farla partire richiede due comandi dentro una sessione di Claude Code:
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
Riavvia Claude Code dopo.
L'errore comune è eseguire npm install -g claude-mem invece, che installa solo la libreria SDK. Gli hook non vengono registrati, il worker non parte e nulla funziona.
Il percorso dal marketplace dei plugin è l'unico che ti dà il setup completo. L'unico prerequisito serio è Node.js 18+. Tutto il resto (Bun, uv, SQLite) si installa automaticamente al primo avvio.
Per verificare che l'installazione sia andata a buon fine, controlla tre cose. Primo, curl http://localhost:37777/api/health dovrebbe restituire {"status":"ok"}. Se fallisce, il worker in background non è partito. La causa più comune è una versione di Node.js sotto la 18.
Secondo, controlla che ~/.claude/hooks.json contenga voci di claude-mem. Se il file non elenca claude-mem sotto PostToolUse e SessionStart, gli hook non sono stati registrati e nessuna cattura verrà eseguita, a prescindere che il worker sia attivo.
Terzo, apri http://localhost:37777 in un browser per vedere il web viewer, che mostra le osservazioni in arrivo in tempo reale mentre lavori.
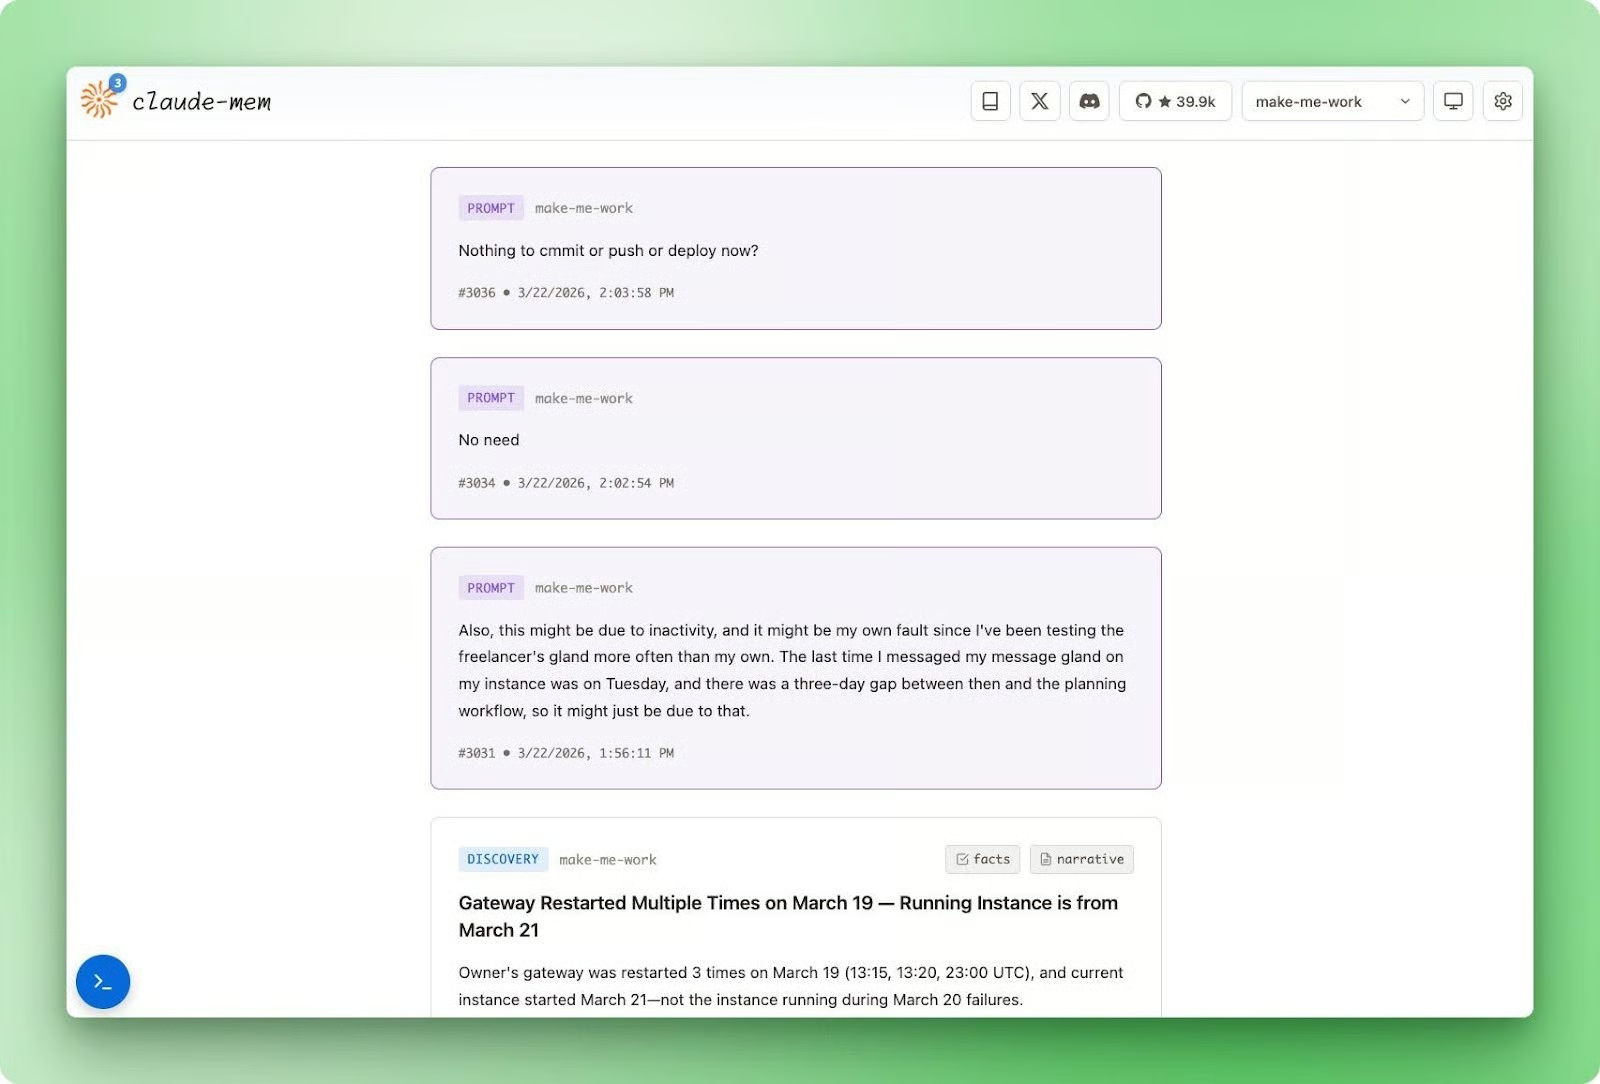
La prima sessione non produce contesto iniettato in SessionStart perché il database è vuoto, ma le osservazioni iniziano ad accumularsi dalla prima chiamata allo strumento.
Dalla seconda sessione, claude-mem avrà un riepilogo di sessione e un pacchetto di osservazioni da iniettare.
Seguire prima questa checklist ti evita di scoprire, dopo tre sessioni, che non è stato catturato nulla. Il web viewer è il segnale più affidabile: se vedi apparire osservazioni dopo una chiamata a uno strumento, è tutto collegato correttamente.
Una volta installato, claude-mem gira silenziosamente in background su cinque hook del ciclo di vita. Capire cosa fa ciascuno spiega perché lo strumento si comporta così.
I cinque hook seguono la linea temporale naturale di una sessione:
SessionStart interroga il database e inietta nella finestra di contesto un indice compresso del lavoro recenteUserPromptSubmit registra la sessione e memorizza il tuo promptPostToolUse si attiva dopo ogni chiamata a uno strumento e invia l'output grezzo a un worker in background per la compressioneStop genera un riepilogo a livello di sessione quando metti in pausa o rimani inattivoSessionEnd segna la sessione come completata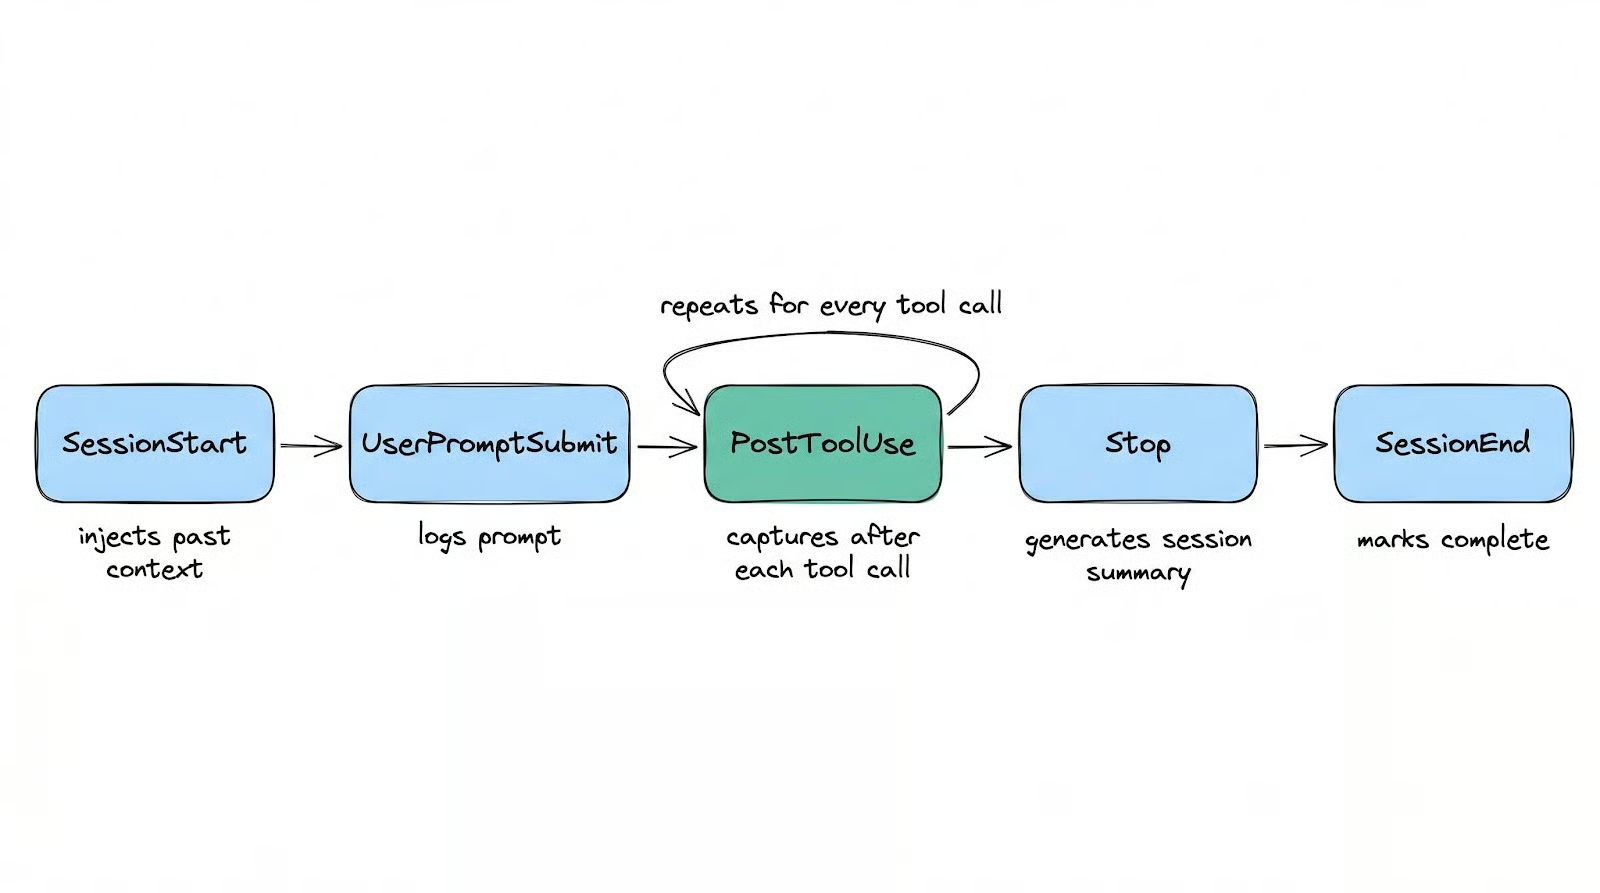
SessionStart costruisce quell'indice iniettato a partire dai riepiloghi di sessione, dai titoli delle osservazioni raggruppati per tipo e dai timestamp: una mappa ricercabile del lavoro recente che Claude può consultare durante la sessione senza che tu faccia nulla.
PostToolUse si attiva dopo ogni chiamata a uno strumento. Invia l'output grezzo a un worker in background tramite una HTTP POST non bloccante (8 ms in media) e il worker lo comprime in un'osservazione strutturata usando il Claude Agent SDK.
Ecco com'è fatta quella struttura:
|
Campo |
Contenuto |
|
|
Uno tra |
|
|
Una stringa concisa e ricercabile |
|
|
Un array di fatti discreti (~50 token, economici da caricare) |
|
|
Una spiegazione in prosa (~155-500 token, caricata solo su richiesta) |
|
|
Tag semantici come come-funziona, problema-soluzione, gotcha, compromesso |
La cattura per chiamata è ciò che distingue claude-mem dagli strumenti che riassumono a fine sessione con una singola chiamata all'IA.
Se la sessione va in crash a metà refactoring, quegli strumenti perdono tutto dall'ultima sessione completata. claude-mem conserva ogni osservazione fino all'ultima chiamata allo strumento.
L'hook Stop produce qualcosa di diverso: un riepilogo a livello di sessione con campi come request, investigated, learned, completed e next_steps. Questi danno a Claude una mappa di alto livello di ciò che è successo senza caricare ogni singola osservazione.
Memorizzare migliaia di osservazioni è una cosa. Caricare quelle giuste nella finestra di contesto senza bruciare token è un problema diverso.
L'approccio ingenuo è riversare il contesto storico nel prompt. La documentazione di claude-mem quantifica la cosa: un caricamento ingenuo tipico invia 35.000 token alla finestra di contesto, di cui circa 2.000 risultano rilevanti. Un segnale del 6%.
Un sistema di recupero a tre livelli porta la percentuale sopra l'80% permettendo a Claude di caricare il contesto in modo progressivo tramite claude-mem:
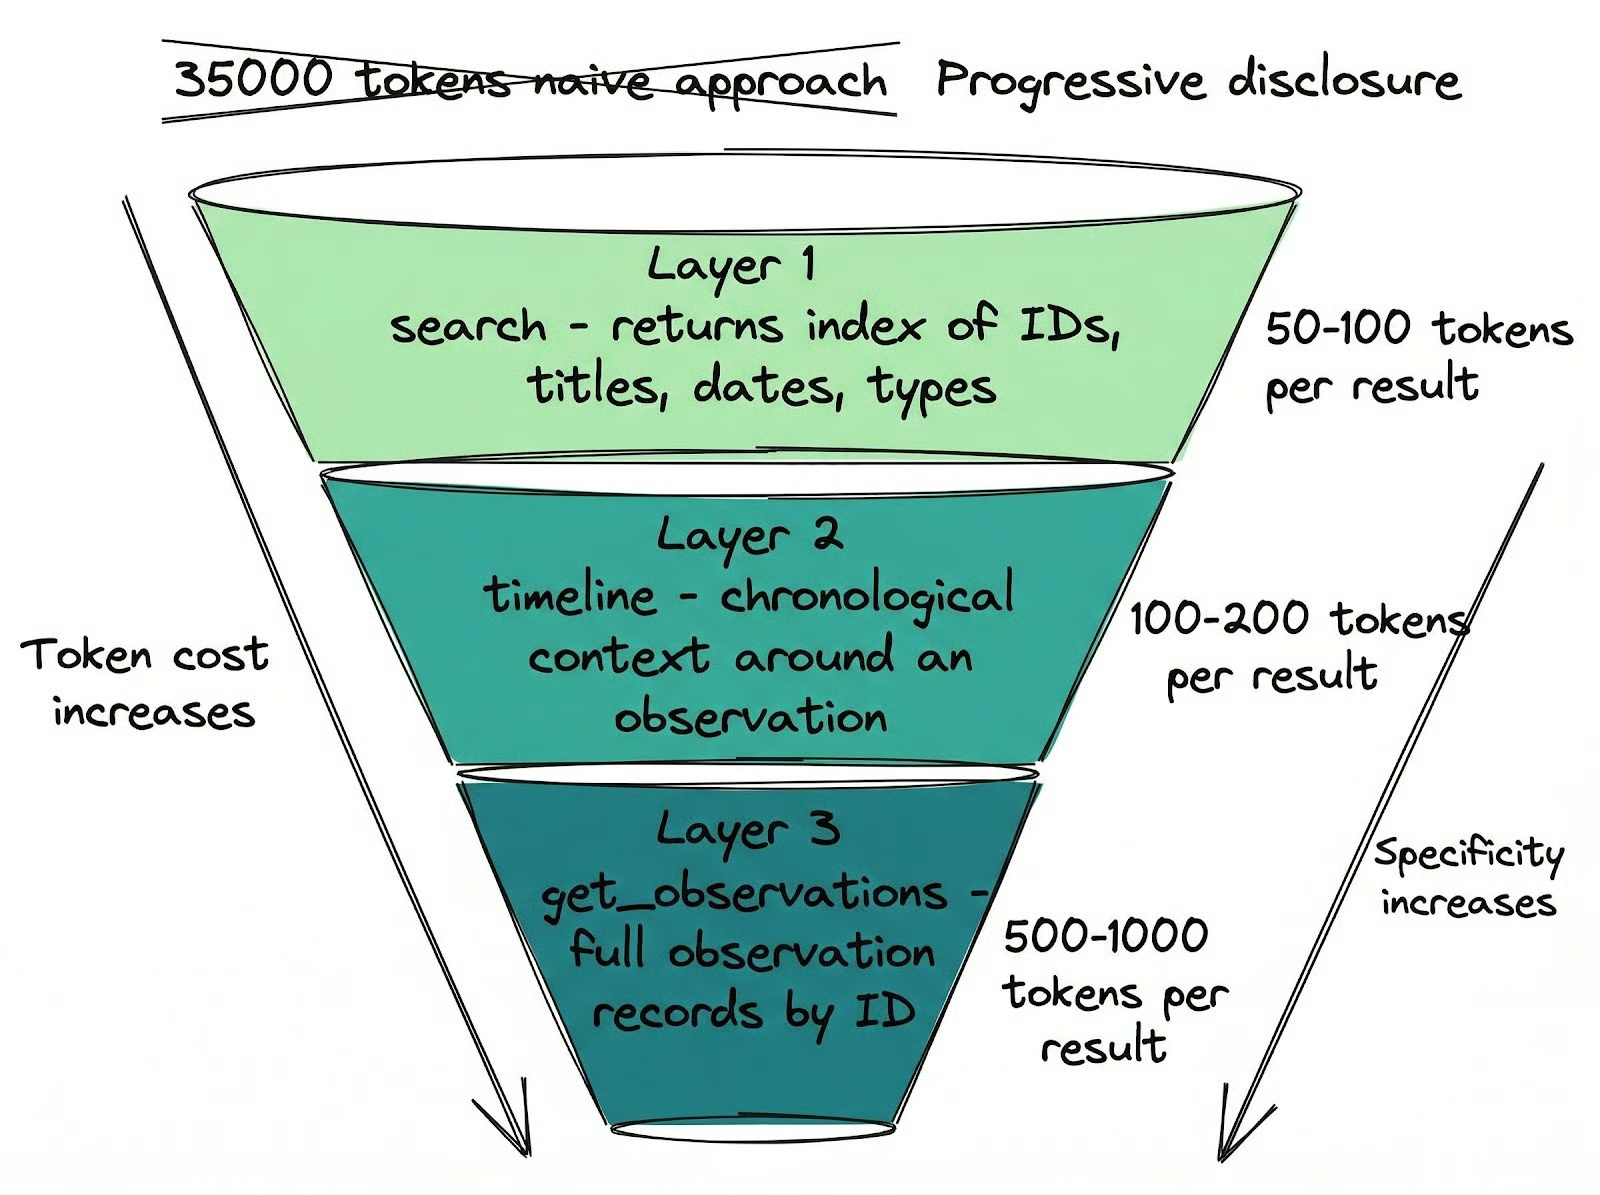
get_observations recupera i record completi delle osservazioni per ID in batch. Costo: 500-1.000 token per risultato. Carica solo ciò che ti serve davvero.Questa disciplina di recupero non si impone da sola.
claude-mem registra uno strumento MCP letteralmente chiamato __IMPORTANT il cui unico scopo è ricordare a Claude di seguire questo schema in tre passaggi.
Senza di esso, Claude salta i livelli economici e recupera tutto nel massimo dettaglio, vanificando l'intera architettura. Il fatto che sia stato necessario aggiungere uno strumento nominato solo per far rispettare la disciplina di recupero dà un'idea realistica di come il sistema sia stato progettato attorno al comportamento effettivo di Claude.
Questi strumenti di recupero non vengono usati solo all'avvio della sessione.
Durante una sessione, quando chiedi a Claude qualcosa sul lavoro passato, cerca direttamente nella memoria.
Puoi chiedergli di analizzare i tuoi schemi di lavoro tra sessioni, trovare dettagli che hai dimenticato ("dove ho salvato quella chiave API?", "come abbiamo implementato il flusso di autenticazione?") o riprendere da dove avevi lasciato un progetto che non tocchi da settimane.
Quando gestisci più codebase e sessioni, i dettagli fuoriescono dalla tua memoria più velocemente di quanto immagini. claude-mem colma quel vuoto dando a Claude accesso a tutto ciò che è successo, anche alle cose che tu stesso hai dimenticato.
Dopo tre settimane, il 61% delle mie osservazioni è classificato come discovery. Claude cattura soprattutto ciò che impara su una codebase, non solo le modifiche che apporta.
In 259 sessioni ho 1.729 riepiloghi di sessione, una media di circa 6-7 per sessione. Questa continuità multi-sessione è possibile solo perché la cattura è continua, non solo alla fine.
È la differenza tra riassumere una sessione e ricordarla davvero.
Tutte le impostazioni di claude-mem sono accessibili dalla web UI su http://localhost:37777 nella scheda Settings. Puoi anche impostarle come variabili d'ambiente o modificare direttamente ~/.claude-mem/settings.json.
La prima impostazione importante è CLAUDE_MEM_MODEL, che controlla quale modello gestisce la compressione. Il default è haiku, già l'opzione più economica nella lineup di Claude.
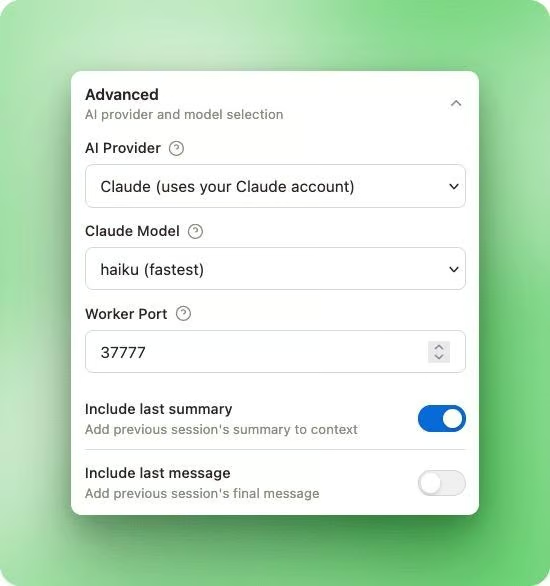
Puoi anche cambiare del tutto il provider di compressione con CLAUDE_MEM_PROVIDER, che accetta claude, gemini o openrouter.
Eseguire la compressione su Gemini Flash Lite o su un modello gratuito di OpenRouter come xiaomi/mimo-v2-flash:free azzera i costi aggiuntivi oltre al tuo abbonamento a Claude Code.
Io uso haiku con 30 osservazioni per sessione. Con circa 400 token di input e 150 di output per chiamata di compressione, sono circa 16.500 token per sessione. Alle tariffe di haiku, un mese di uso intenso costa ben meno di un dollaro.
Dopo tre settimane su dieci progetti, la qualità della compressione non è stata un problema.
Due impostazioni controllano quanto contesto viene caricato all'avvio della sessione:
CLAUDE_MEM_CONTEXT_OBSERVATIONS: numero totale di osservazioni iniettate in SessionStart (default 50, range 1-200)CLAUDE_MEM_CONTEXT_FULL_COUNT: quante di queste mostrano dettagli estesi con il campo narrative completo (default 5, range 0-20)Le restanti mostrano solo titolo, tipo e data. Tutta l'iniezione di contesto è limitata alla directory del progetto su cui stai lavorando, quindi le osservazioni di altri progetti non ingombrano il tuo contesto.
Puoi vedere in anteprima esattamente cosa viene iniettato e regolare questi conteggi per progetto tramite la web UI.
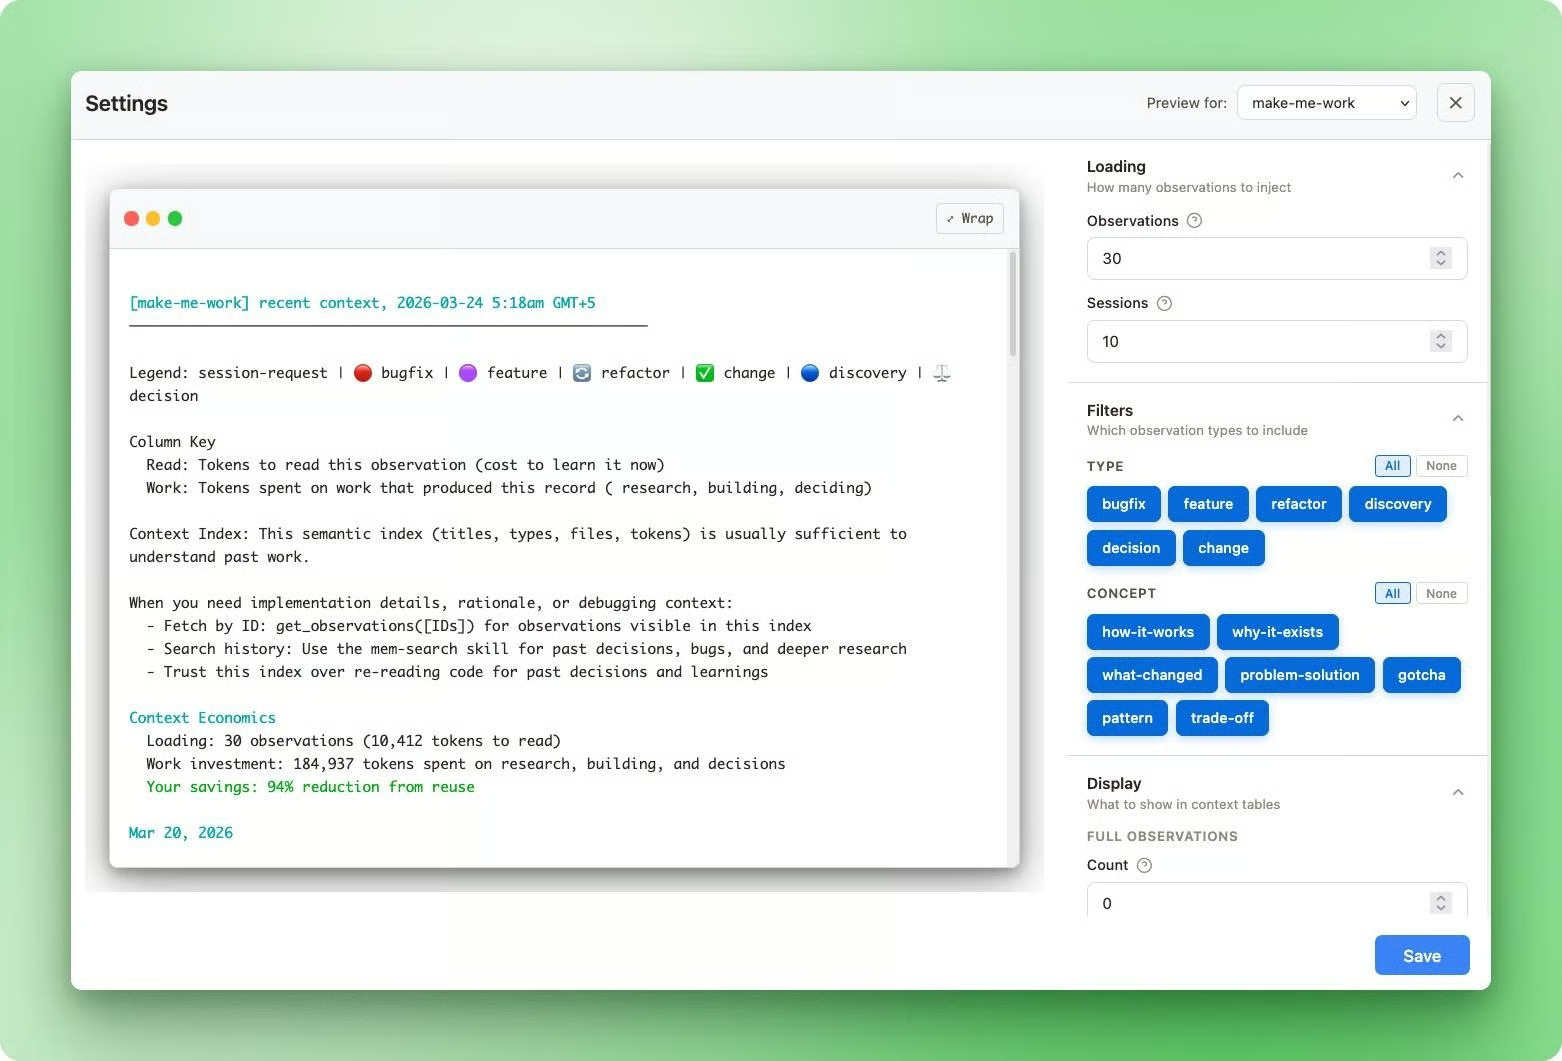
Una cosa da aspettarsi: nella prima settimana su un nuovo progetto, la tua finestra di contesto potrebbe riempirsi più in fretta del solito.
Ho quasi disinstallato claude-mem durante quella fase iniziale perché le sessioni raggiungevano il limite di contesto prima di prima.
Quello che succedeva era che claude-mem stava imparando il progetto da zero, registrando un alto volume di nuove osservazioni che venivano tutte iniettate all'avvio della sessione.
Dopo circa una settimana il volume di nuove scoperte è calato perché Claude aveva già mappato la codebase, e le sessioni hanno iniziato a durare più a lungo rispetto a prima di installare il plugin.
Se incappi in quell'overhead iniziale, abbassa temporaneamente CLAUDE_MEM_CONTEXT_OBSERVATIONS e rialzalo quando il periodo di apprendimento iniziale si stabilizza.
CLAUDE_MEM_SKIP_TOOLS ti permette di escludere strumenti specifici dalla cattura.
I default già escludono strumenti ad alto rumore come TodoWrite, AskUserQuestion e BashTool. Probabilmente non ti servirà toccarlo, a meno che tu non abbia uno strumento personalizzato che genera output che non vuoi memorizzare. È una lista separata da virgole, quindi aggiungere strumenti è semplice.
Se lavori con chiavi API o credenziali, racchiudile tra tag <private> nei tuoi prompt per escludere quel contenuto dalla memorizzazione.
claude-mem rimuove tutto ciò che si trova dentro quei tag prima di creare un'osservazione.
Non analizza proattivamente i contenuti dei file, quindi le variabili d'ambiente caricate da disco non sono a rischio, ma tutto ciò che incolli direttamente in un prompt lo è. L'approccio con i tag <private> significa che la protezione è opt-in: devi ricordarti di usarli.
Claude Code include già funzioni di memoria, ma nessuna cattura il contesto automaticamente.
CLAUDE.md sono file markdown statici caricati all'avvio della sessione, utili per regole e preferenze di progetto, ma limitati a circa 200 righe prima che l'aderenza cali. Niente ricerca, niente recupero. Scrivi le istruzioni una volta e speri che Claude le segua.
Auto Memory, aggiunta in Claude Code v2.1.59, rende Claude stesso responsabile di decidere cosa salvare tra le sessioni. Memorizza note non strutturate in ~/.claude/projects/<project>/memory/ e carica le prime 200 righe di un file MEMORY.md all'avvio.
In pratica, ciò che viene salvato non coincide sempre con quello che vorresti, e non c'è modo di cercarlo o filtrarlo dopo. Ti ritrovi con un file di testo di decisioni a cui Claude potrebbe o meno prestare attenzione.
Il comando /compact completa le opzioni integrate riassumendo la conversazione per liberare spazio di contesto. I file CLAUDE.md sopravvivono perché vengono riletti da disco, ma tutto il resto sparisce: istruzioni conversazionali, contesto a metà sessione, qualsiasi cosa tu abbia detto ma non scritto da qualche parte.
claude-mem colma il vuoto che nessuna di queste copre: cattura continua automatica con compressione strutturata e recupero attento ai token. Non è nemmeno l'unico plugin a fare questo lavoro.
|
Strumento |
Architettura |
Archiviazione |
Ricerca |
Tempistica cattura |
Prezzo |
Multi-macchina |
Memoria di team |
|
Claude integrato |
Nativa |
Markdown locale |
Nessuna |
Manuale |
Gratis |
Via sync git |
Via CLAUDE.md condivisa |
|
claude-mem |
Plugin (hook) |
SQLite locale + FTS5 |
Keyword FTS5 |
Per chiamata a strumento |
Gratis |
No |
No |
|
memsearch |
Plugin (hook + skill) |
Markdown locale + Milvus |
Ibrida densa + BM25 |
Fine sessione |
Gratis |
No |
No |
|
supermemory |
Plugin (hook + cloud) |
Cloud |
Semantica + temporale |
Fine sessione |
A pagamento |
Sì |
Sì |
|
mem0 (self-hosted) |
Server MCP |
Qdrant locale + Ollama |
Vettoriale semantica |
Fine sessione |
Gratis |
No |
No |
memsearch è l'alternativa gratuita più vicina se vuoi file markdown invece di un database e non vuoi un processo in background. Esegue il recupero in un sotto-agente isolato, quindi i risultati della ricerca non si mescolano mai con la tua finestra di contesto principale. Usalo se preferisci un setup più semplice e non ti serve la cattura per chiamata.
supermemory è la scelta giusta se ti serve la sincronizzazione tra macchine e una memoria condivisa di team, anche se richiede un abbonamento a pagamento.
Lo stack mem0 self-hosted adotta un approccio del tutto diverso: Qdrant e Neo4j per il tracciamento entità basato su grafo, costo extra zero, ma un setup più pesante che vale la pena solo se già gestisci quell'infrastruttura.
claude-mem sta nel mezzo. Completamente locale, gratuito, cattura per chiamata con compressione strutturata. Il compromesso è un processo worker in background sulla porta 37777 e qualche spigolo ancora da limare.
La sicurezza è la preoccupazione principale.
Un audit della community nel febbraio 2026 ha valutato il rischio come ALTO e i problemi sono ancora aperti.
L'API HTTP sulla porta 37777 non ha autenticazione: qualsiasi processo sulla tua macchina può leggere ogni osservazione memorizzata, vedere le impostazioni (incluse eventuali chiavi API in chiaro) e iniettare memorie arbitrarie nel database.
L'host di default era 0.0.0.0 anziché 127.0.0.1, il che su VM cloud o macchine senza firewall espone l'API in rete.
Gli strumenti smart_unfold e smart_outline presentano inoltre una vulnerabilità di path traversal senza controlli sul perimetro della directory.
Usalo solo su una macchina di sviluppo personale.
Anche l'affidabilità ha alcuni spigoli vivi.
L'integrazione con ChromaDB ha una perdita nota di sottoprocessi: un utente ha tracciato 184 processi orfani in 19 ore, per circa 16 GB di RAM consumata.
La causa radice era un modello ONNX corrotto che innescava loop di retry infiniti. Resta su FTS5 (il motore di ricerca full-text integrato in SQLite), che funziona senza ChromaDB ed è stato affidabile nella mia esperienza.
Su macOS con Apple Silicon, il cold start del worker può superare il timeout rigido di 5 secondi quando ChromaDB è abilitato, causando il fallimento dell'hook SessionStart. Questo non riguarda le configurazioni solo FTS5. C'è anche un bug attivo in cui gli strumenti MCP search e timeline hanno schemi dei parametri vuoti, quindi Claude non può passare le query. get_observations funziona correttamente.
Questi non sono blocchi totali per lo sviluppo locale su una macchina personale. Ma è bene saperlo prima di installare qualcosa che ha accesso all'intera cronologia delle tue sessioni.
Dopo tre settimane, la cosa principale che noto è ciò che non faccio più. Non rispiego la struttura del progetto all'inizio di ogni sessione. Non ripercorro un percorso di debug già fatto. Claude arriva con il contesto e ripartiamo da dove avevamo lasciato.
L'architettura rende possibile tutto questo in un modo che gli approcci più semplici non consentono. Catturare una sola volta a fine sessione significa perdere tutto se una sessione va in crash. Riversare la cronologia senza livelli di recupero significa spendere token in rumore. Le scelte progettuali qui sono deliberate, e conoscerle ti aiuta a regolare lo strumento invece di limitarti a fidarti.
I gap di sicurezza descritti sopra sono reali e sono ancora aperti. Vale la pena usarlo su una macchina di sviluppo personale. Non vale la pena eseguirlo su una VM cloud o su una macchina condivisa finché quei problemi non saranno risolti. Ma per lo sviluppo locale in solitaria, i compromessi sono gestibili.
Se vuoi approfondire, il corso di DataCamp Introduction to Claude è un ottimo punto di partenza per capire come funziona Claude Code prima di aggiungerci plugin.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min