Curso
Introducción a los modelos Claude
3 h
14.6K
Hace unas semanas instalé claude-mem en todos mis proyectos. Desde entonces, ha capturado 6.814 observaciones en 259 sesiones, cubriendo diez bases de código distintas, todo guardado en un archivo SQLite de 39 MB en mi portátil.
Antes, cada sesión de Claude Code empezaba de cero. Abría una sesión nueva y me pasaba los primeros diez minutos volviendo a explicar la estructura del proyecto. ¿El bug de autenticación que habíamos arreglado el día anterior? Claude ni idea. Volvía a leer archivos ya analizados y acababa sacando las mismas conclusiones erróneas que ya habíamos corregido.
claude-mem es un plugin de Claude Code que soluciona esto capturando lo que ocurre durante una sesión y poniéndolo a disposición de las siguientes.
En este artículo verás cómo funciona por dentro, cómo instalarlo sin caer en los errores típicos, cómo ajustarlo a tu presupuesto y qué debes tener en cuenta antes de usarlo en producción.
claude-mem es un plugin de Claude Code que:
~/.claude-mem/claude-mem.dbSe ejecuta como plugin, no como servidor MCP.
Esa diferencia importa: los plugins se activan automáticamente en eventos del ciclo de vida como el inicio de sesión y cada llamada de herramienta, mientras que los servidores MCP permanecen inactivos hasta que Claude decide llamarlos.
Con un enfoque basado en MCP, la recuperación solo ocurre cuando a Claude «se le ocurre» pedirla. claude-mem captura e inyecta sin que Claude tenga que decidirlo.
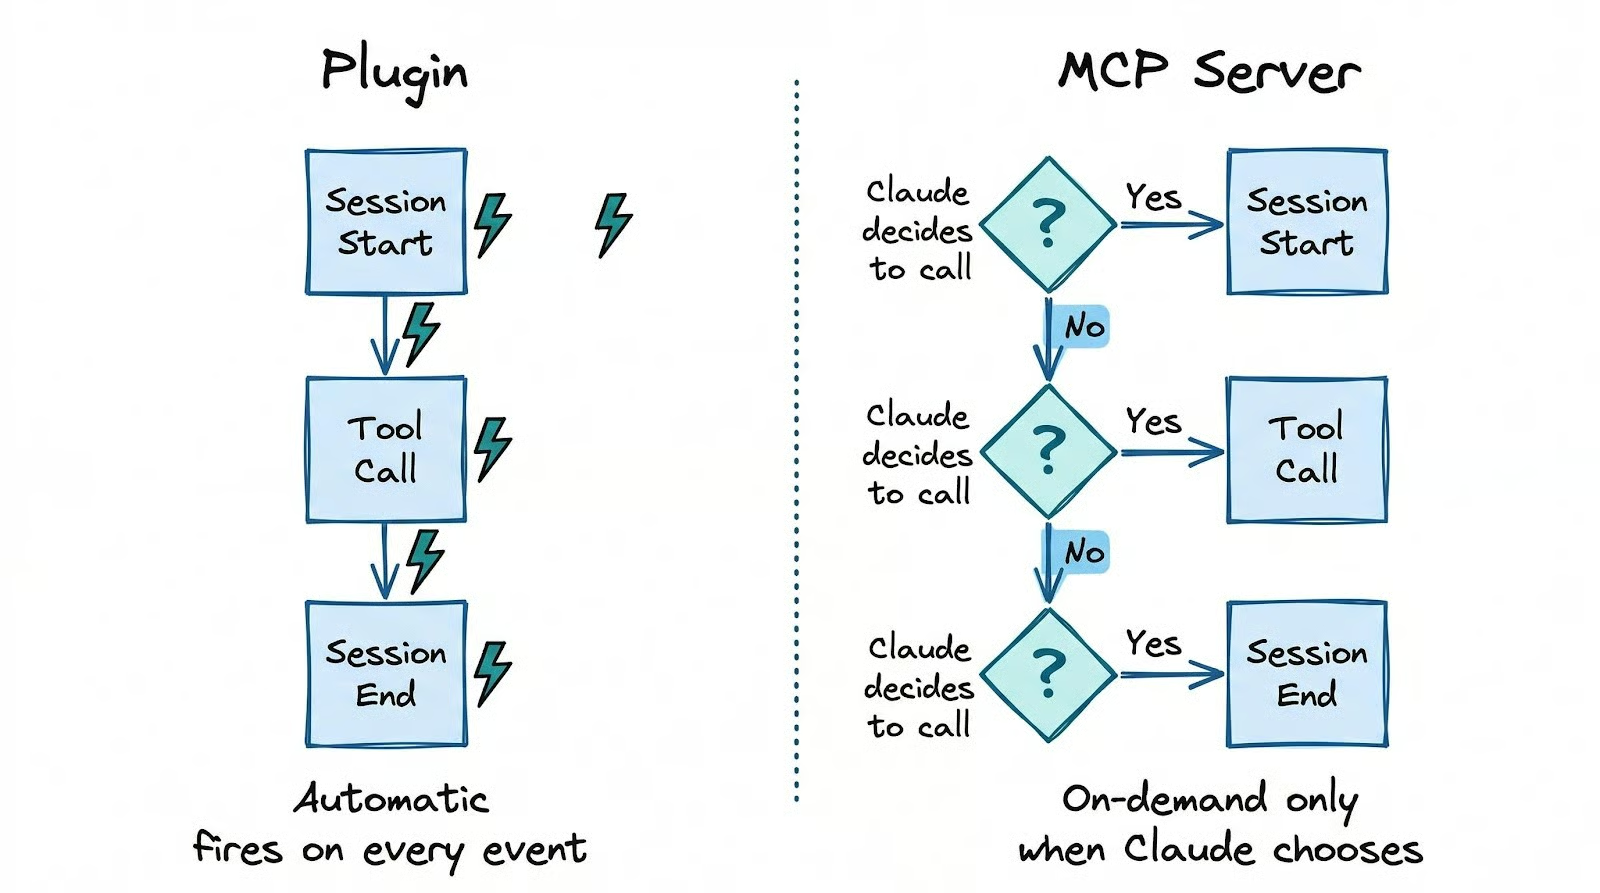
Todo se queda en tu máquina, y la compresión usa tu autenticación de Claude Code, así que no necesitas una API key ni una cuenta aparte.
Ponerlo en marcha requiere dos comandos dentro de una sesión de Claude Code:
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
Reinicia Claude Code después.
El error habitual es ejecutar npm install -g claude-mem, que solo instala la biblioteca del SDK. Los hooks no se registran, el worker nunca arranca y nada funciona.
El camino del marketplace del plugin es el único que te da la instalación completa. El único prerrequisito es Node.js 18+. Todo lo demás (Bun, uv, SQLite) se instala solo en el primer arranque.
Para verificar que la instalación ha funcionado, comprueba tres cosas. Primero, curl http://localhost:37777/api/health debería devolver {"status":"ok"}. Si falla, el worker en segundo plano no se ha iniciado. La causa más común es una versión de Node.js inferior a 18.
Segundo, comprueba que ~/.claude/hooks.json contiene entradas de claude-mem. Si el archivo no lista claude-mem en PostToolUse y SessionStart, los hooks no se registraron y no habrá captura aunque el worker esté vivo.
Tercero, abre http://localhost:37777 en el navegador para ver el visor web, que muestra las observaciones entrando en tiempo real mientras trabajas.
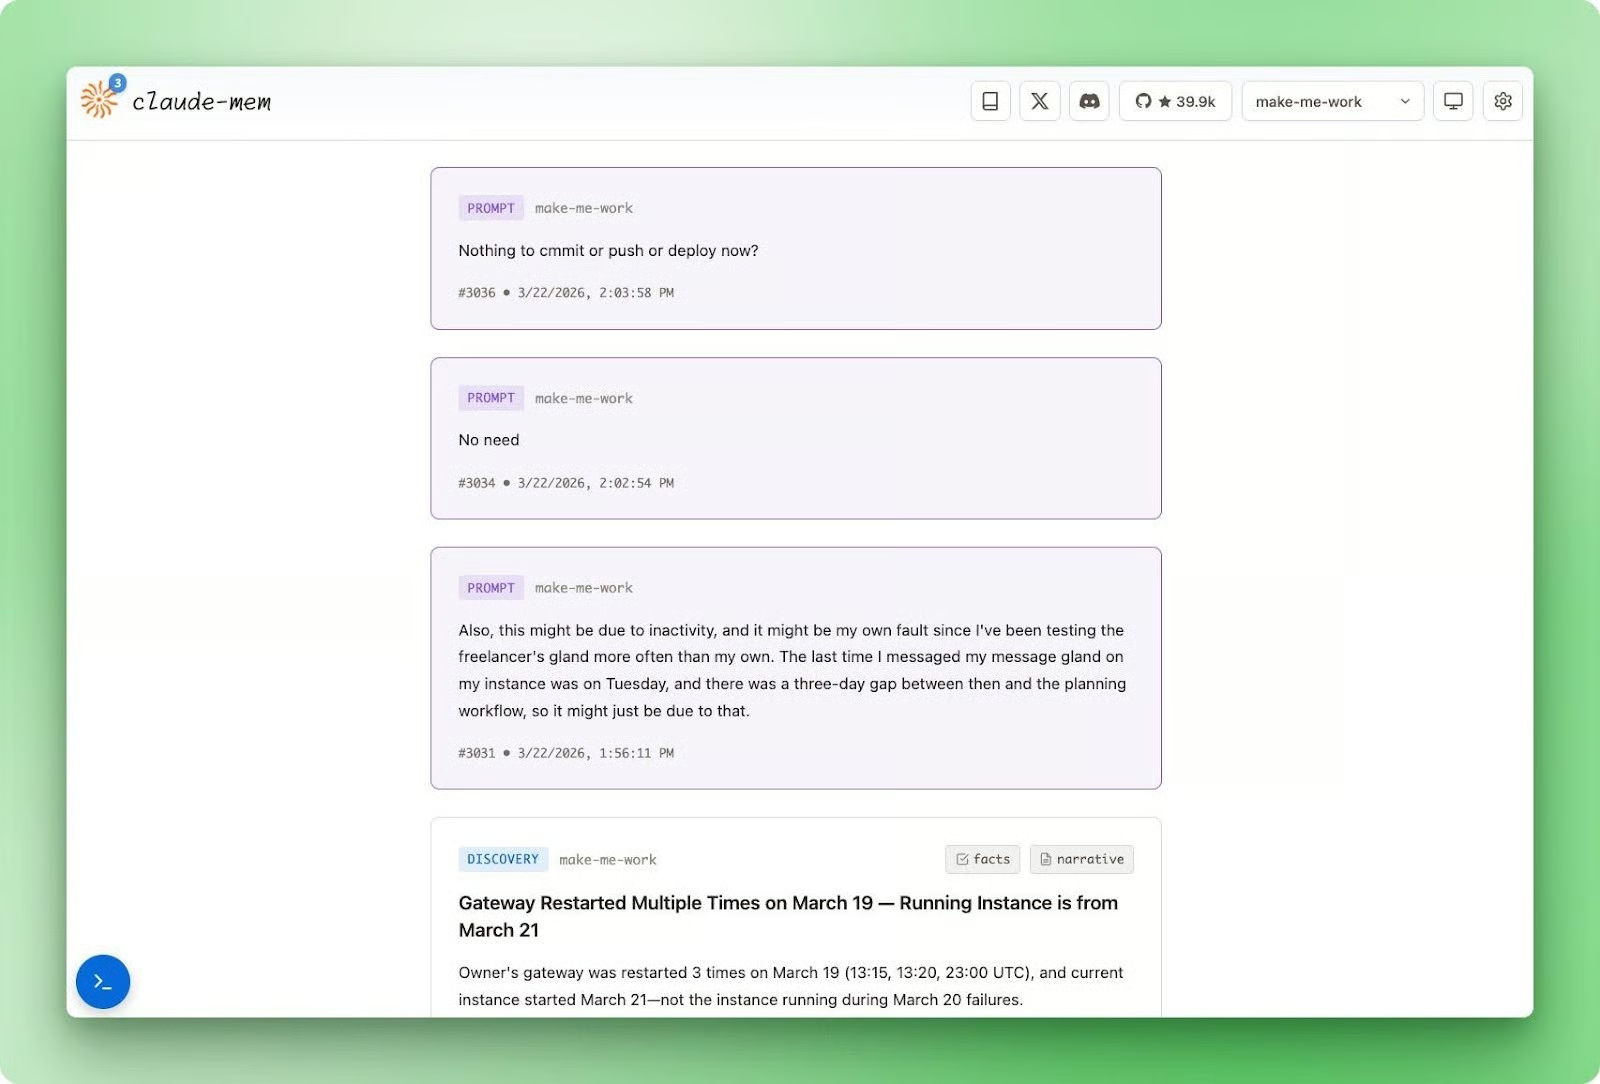
La primera sesión no inyecta contexto en SessionStart porque la base de datos está vacía, pero las observaciones empiezan a acumularse desde la primera llamada de herramienta.
En la segunda sesión, claude-mem ya tendrá un resumen de sesión y un lote de observaciones para inyectar.
Pasar primero por esta lista de verificación te evita descubrir a la tercera sesión que no se había capturado nada. El visor web es la señal más fiable: si ves observaciones aparecer tras una llamada de herramienta, todo está bien cableado.
Una vez instalado, claude-mem se ejecuta en silencio en segundo plano a lo largo de cinco hooks del ciclo de vida. Entender qué hace cada uno explica por qué la herramienta se comporta como lo hace.
Los cinco hooks encajan con la línea temporal natural de una sesión:
SessionStart consulta la base de datos e inyecta en tu ventana de contexto un índice comprimido del trabajo recienteUserPromptSubmit registra la sesión y guarda tu promptPostToolUse se dispara después de cada llamada de herramienta y envía la salida en bruto a un worker en segundo plano para comprimirlaStop genera un resumen a nivel de sesión cuando pausas o quedas inactivoSessionEnd marca la sesión como completada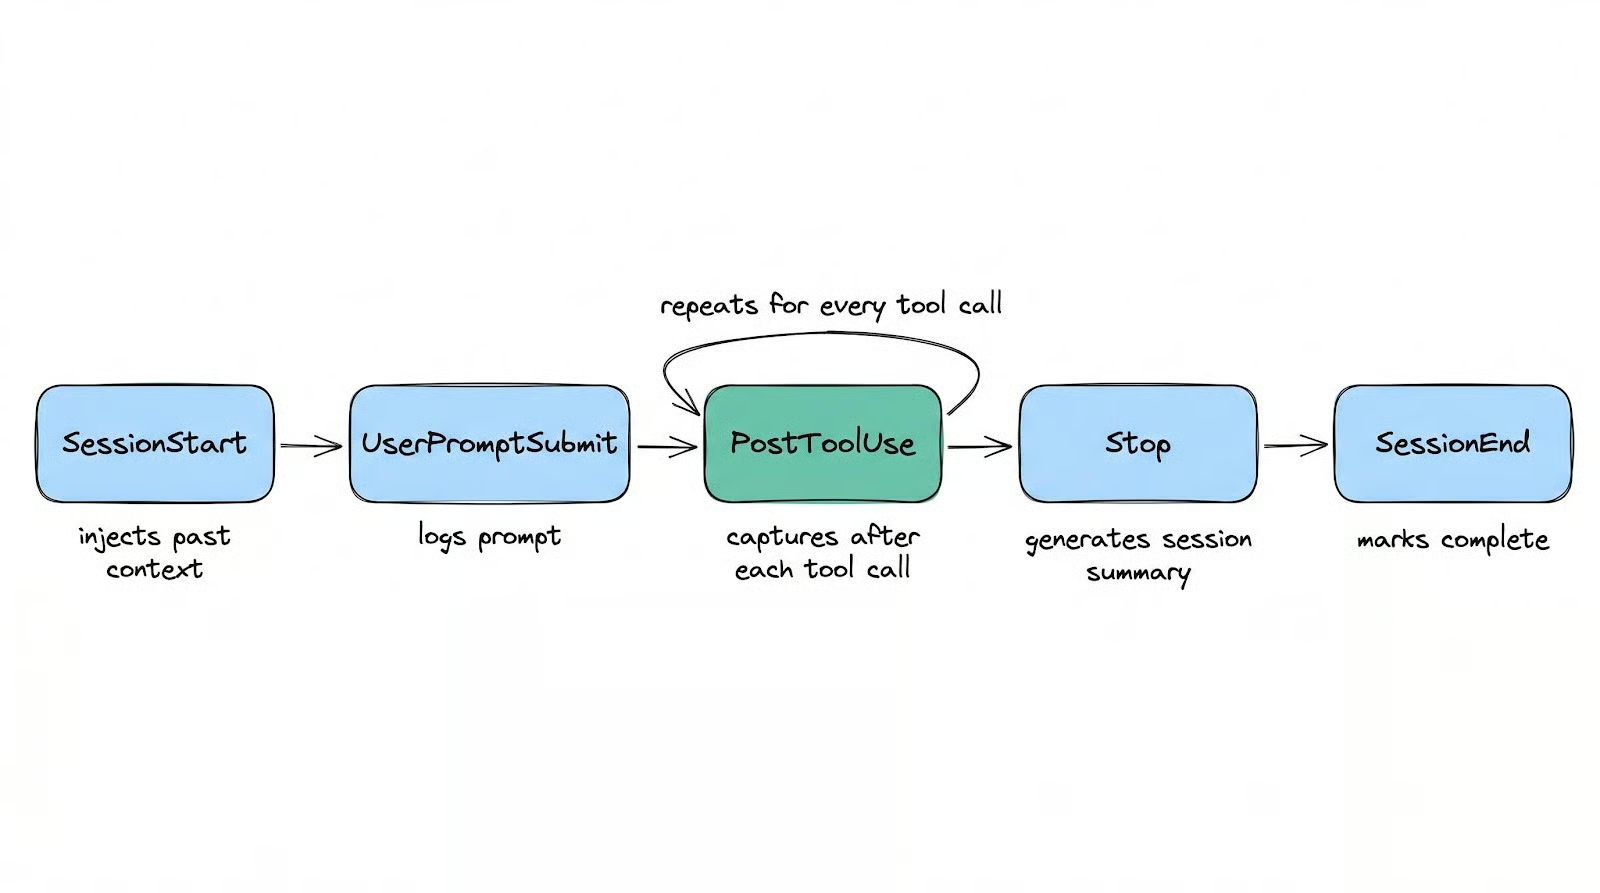
SessionStart construye ese índice inyectado a partir de resúmenes de sesión, títulos de observaciones agrupados por tipo y marcas de tiempo: un mapa consultable del trabajo reciente al que Claude puede remitirse durante la sesión sin que tengas que hacer nada.
PostToolUse se dispara tras cada llamada de herramienta. Envía la salida en bruto a un worker por HTTP POST no bloqueante (8 ms de media), y el worker la comprime en una observación estructurada usando el Claude Agent SDK.
La estructura es así:
|
Campo |
Qué contiene |
|
|
Uno de |
|
|
Una cadena concisa y fácil de buscar |
|
|
Un array de hechos discretos (~50 tokens, barato de cargar) |
|
|
Una explicación en prosa (~155-500 tokens, solo se carga bajo demanda) |
|
|
Etiquetas semánticas como how-it-works, problem-solution, gotcha, trade-off |
La captura por llamada es lo que diferencia a claude-mem de las herramientas que solo resumen al final con una única llamada de IA.
Si tu sesión se cae a mitad de un refactor, esas herramientas pierden todo desde la última sesión completada. claude-mem conserva cada observación hasta la última llamada de herramienta.
El hook Stop produce algo distinto: un resumen a nivel de sesión con campos como request, investigated, learned, completed y next_steps. Esto le da a Claude un mapa de alto nivel de lo ocurrido sin cargar cada observación individual.
Almacenar miles de observaciones es una cosa. Cargar las adecuadas en una ventana de contexto sin quemar tokens es otra bien distinta.
El enfoque ingenuo es volcar el contexto histórico en el prompt. La documentación de claude-mem lo cuantifica: una carga ingenua típica manda 35.000 tokens a la ventana de contexto, de los cuales unos 2.000 resultan relevantes. Es un 6% de señal.
Un sistema de recuperación en tres capas supera el 80% permitiendo que Claude cargue contexto de forma progresiva a través de claude-mem:
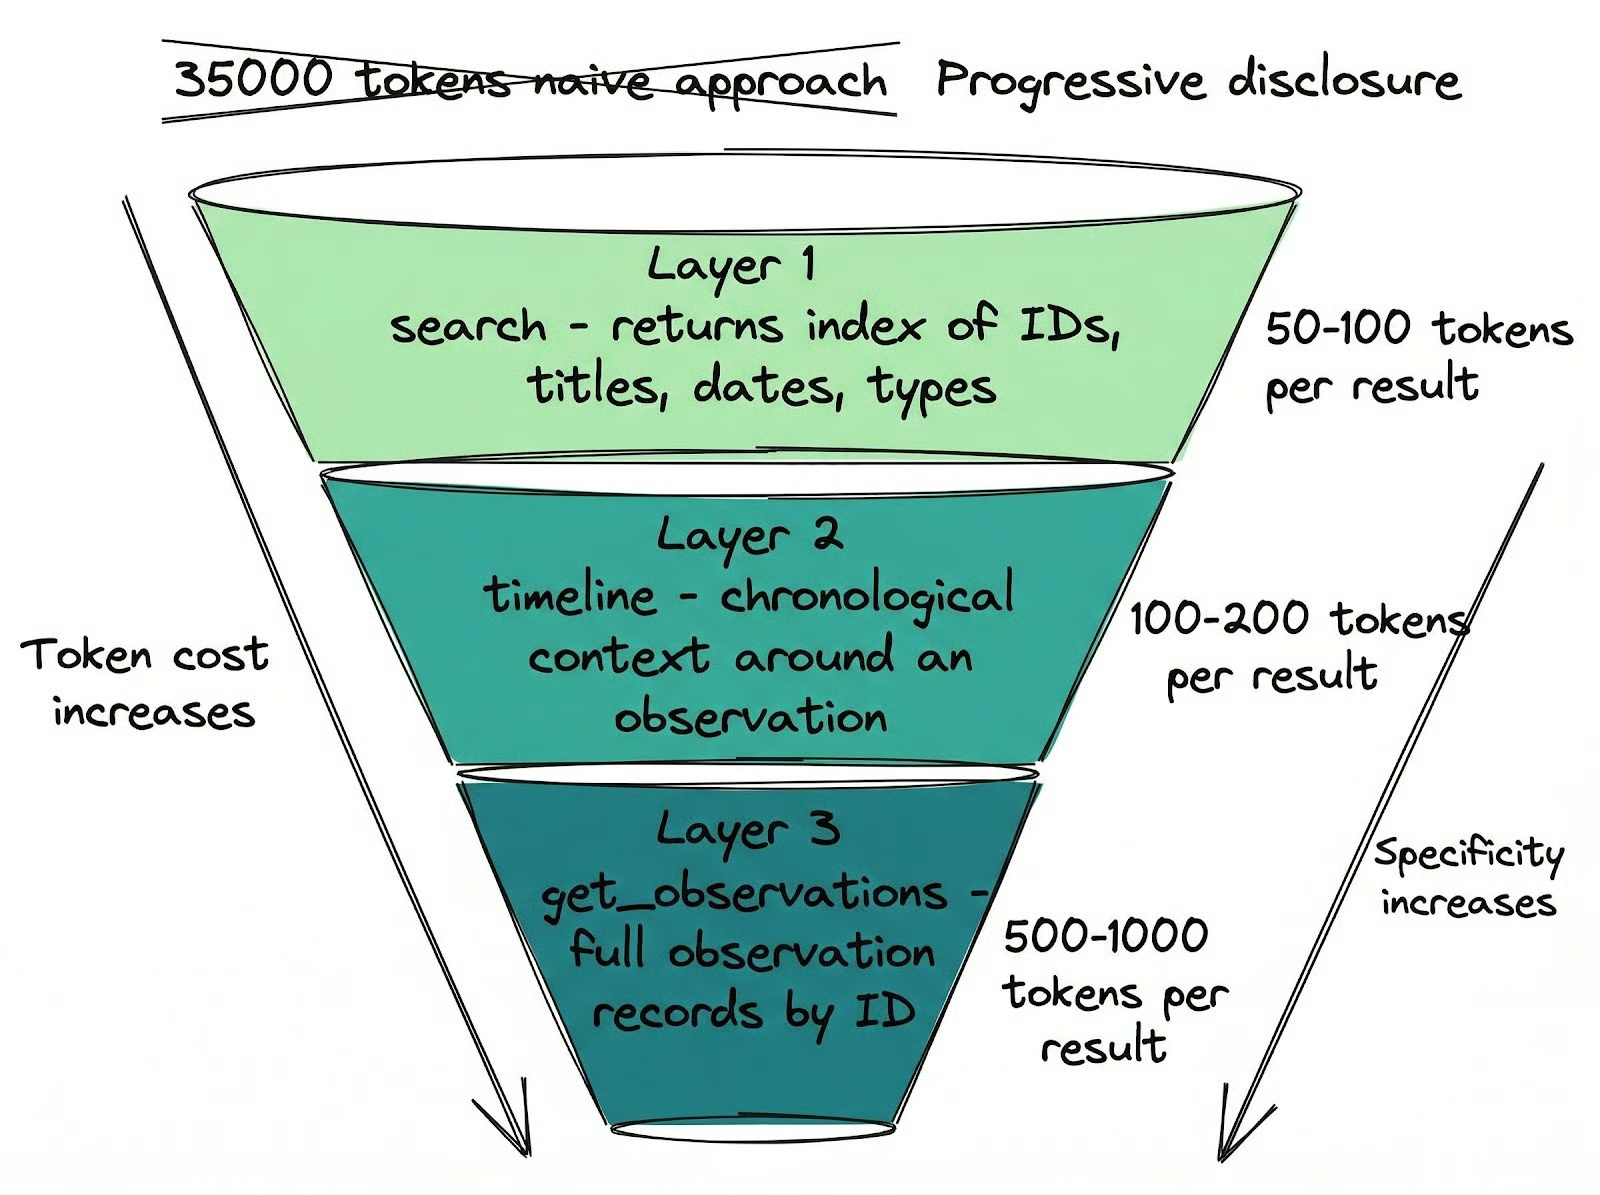
get_observations recupera registros completos por ID en lotes. Coste: 500-1.000 tokens por resultado. Trae solo lo que realmente necesitas.Esa disciplina de recuperación no se aplica sola.
claude-mem registra una herramienta MCP llamada literalmente __IMPORTANT cuya única función es recordarle a Claude que siga este patrón en tres pasos.
Sin ella, Claude se salta las capas baratas y lo recupera todo con máximo detalle, tirando por tierra toda la arquitectura. Que haya que añadir una herramienta con nombre propio solo para imponer disciplina de recuperación da una idea realista de cómo se ha tenido que diseñar el sistema en torno al comportamiento real de Claude.
Estas herramientas de recuperación no se usan solo al inicio de la sesión.
Durante la sesión, cuando le pides a Claude algo sobre trabajo pasado, busca directamente en la memoria.
Puedes pedirle que analice tus patrones de trabajo entre sesiones, que encuentre detalles que has olvidado ("¿dónde guardé esa API key?", "¿cómo implementamos el flujo de auth?") o retomar un proyecto que no tocas desde hace semanas.
Cuando alternas varias bases de código y sesiones, los detalles se te escapan más rápido de lo que crees. claude-mem cubre ese hueco dando a Claude acceso a todo lo que ha ocurrido, incluso a lo que tú ya has olvidado.
Tras tres semanas, el 61% de mis observaciones están tipadas como discovery. Claude capta sobre todo lo que aprende de una codebase, no solo los cambios que hace.
En 259 sesiones tengo 1.729 resúmenes, una media de 6-7 por sesión. Esa continuidad entre sesiones solo es posible porque la captura es continua, no solo al final.
Esa es la diferencia entre resumir una sesión y realmente recordarla.
Todos los ajustes de claude-mem están en la interfaz web en http://localhost:37777 en la pestaña Settings. También puedes definirlos como variables de entorno o editar ~/.claude-mem/settings.json directamente.
El primer ajuste interesante es CLAUDE_MEM_MODEL, que controla qué modelo hace la compresión. El valor por defecto es haiku, el más barato de la familia de modelos de Claude.
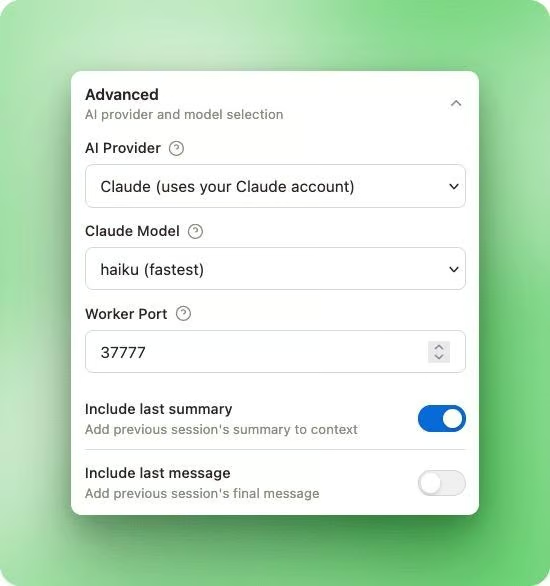
También puedes cambiar por completo el proveedor de compresión con CLAUDE_MEM_PROVIDER, que acepta claude, gemini o openrouter.
Ejecutar la compresión con Gemini Flash Lite o con un modelo gratuito de OpenRouter como xiaomi/mimo-v2-flash:free reduce el coste adicional a cero más allá de tu suscripción a Claude Code.
Yo lo uso con haiku y 30 observaciones por sesión. Con ~400 tokens de entrada y ~150 de salida por compresión, sale unos 16.500 tokens por sesión. A tarifas de haiku, un mes de uso intensivo cuesta bastante menos de un dólar.
Tras tres semanas en diez proyectos, la calidad de compresión no ha sido un problema.
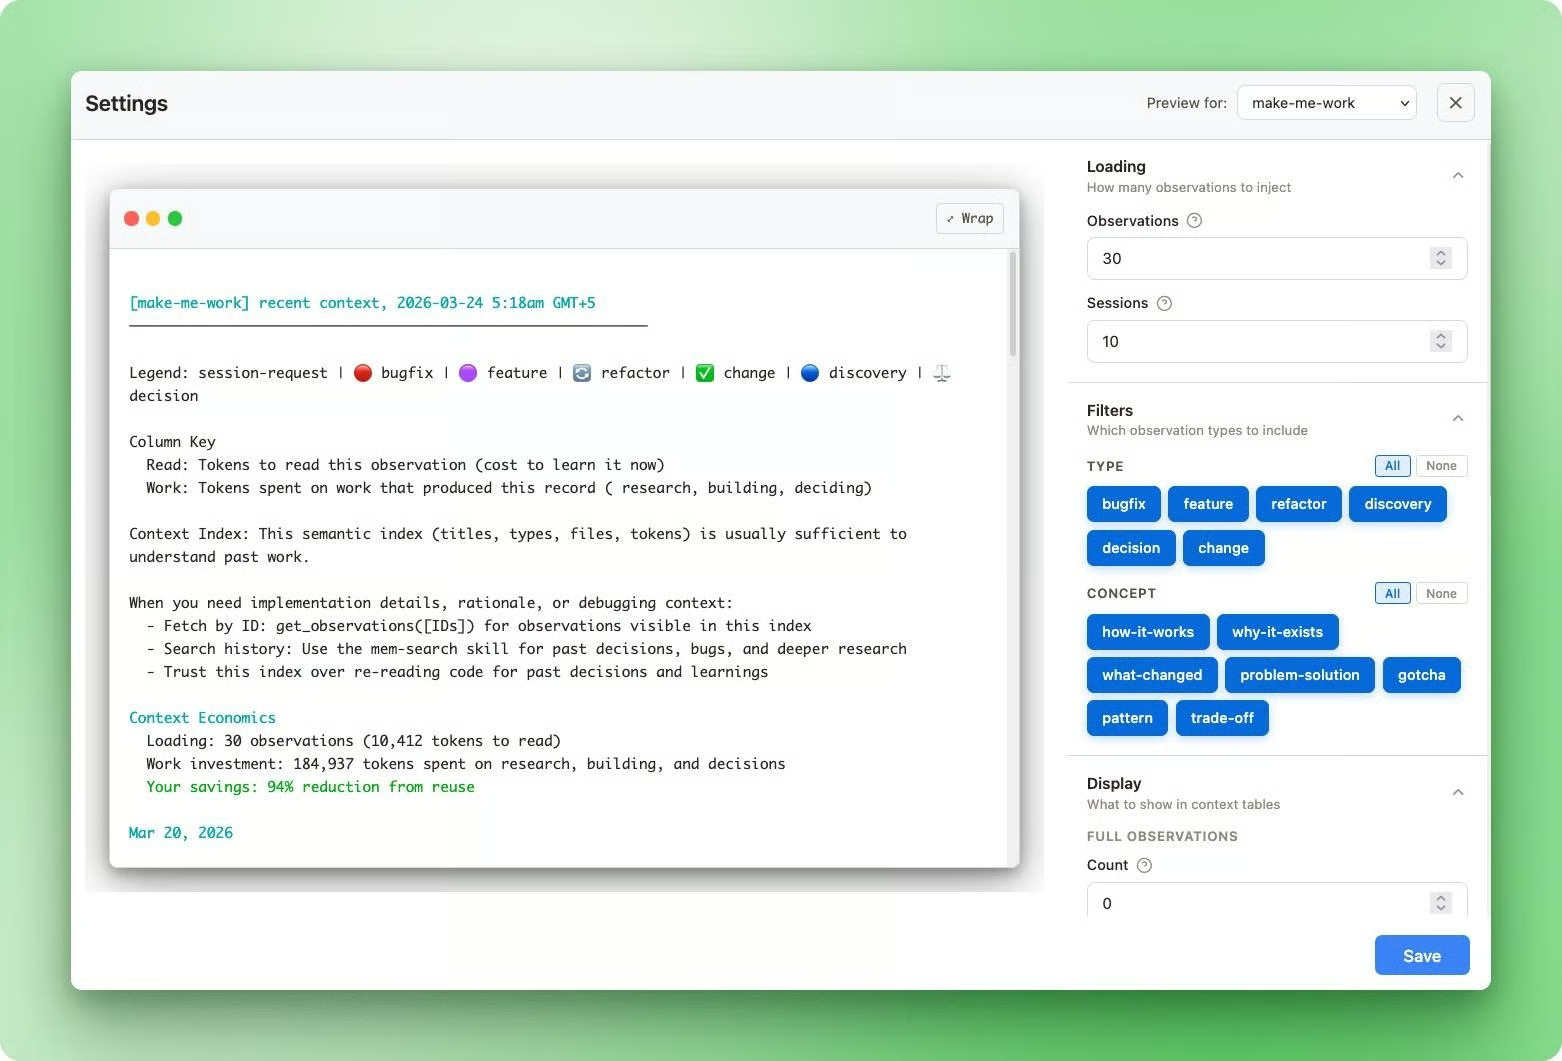
Dos ajustes controlan cuánto contexto se carga al inicio de sesión:
CLAUDE_MEM_CONTEXT_OBSERVATIONS: número total de observaciones inyectadas en SessionStart (por defecto 50, rango 1-200)CLAUDE_MEM_CONTEXT_FULL_COUNT: cuántas de ellas se muestran con detalle ampliado y narrative completo (por defecto 5, rango 0-20)El resto solo muestran título, tipo y fecha. Toda la inyección de contexto se limita al directorio del proyecto en el que estás trabajando, así que las observaciones de otros proyectos no te llenarán el contexto.
Puedes previsualizar exactamente qué se inyecta y ajustar estos valores por proyecto desde la interfaz web.
Algo a tener en cuenta: la primera semana en un proyecto nuevo, tu ventana de contexto puede llenarse más rápido de lo normal.
Estuve a punto de desinstalar claude-mem en esa fase inicial porque las sesiones alcanzaban el límite de contexto antes que antes.
Lo que pasaba es que claude-mem estaba aprendiendo el proyecto desde cero, registrando un volumen alto de observaciones nuevas que se inyectaban al inicio de sesión.
Tras una semana, bajó el ritmo de descubrimientos porque Claude ya había mapeado la base de código, y las sesiones empezaron a durar más que antes de instalar el plugin.
Si te topas con ese sobrecoste inicial, baja CLAUDE_MEM_CONTEXT_OBSERVATIONS temporalmente y súbelo de nuevo cuando pase el periodo de aprendizaje.
CLAUDE_MEM_SKIP_TOOLS te permite excluir herramientas concretas de la captura.
Los valores por defecto ya excluyen herramientas ruidosas como TodoWrite, AskUserQuestion y BashTool. Probablemente no necesites tocar esto salvo que tengas una herramienta personalizada que genere salidas que no quieras almacenar. Es una lista separada por comas, así que añadir herramientas es sencillo.
Si trabajas con API keys o credenciales, envuélvelas en etiquetas <private> dentro de tus prompts para excluir ese contenido del almacenamiento.
claude-mem elimina todo lo que haya dentro de esas etiquetas antes de crear una observación.
No escanea proactivamente el contenido de archivos, así que las variables de entorno cargadas desde disco no están en riesgo, pero cualquier cosa que pegues directamente en un prompt sí. El enfoque con etiquetas <private> implica que la protección es opt-in: tienes que acordarte de usarlo.
Claude Code ya incluye funciones de memoria, pero ninguna captura contexto automáticamente.
CLAUDE.md son archivos markdown estáticos cargados al inicio de sesión, útiles para normas del proyecto y preferencias, pero limitados a unas 200 líneas antes de que baje la adherencia. Sin búsqueda ni recuperación. Escribes tus instrucciones una vez y esperas que Claude las siga.
Auto Memory, añadido en Claude Code v2.1.59, deja en manos de Claude decidir qué guardar entre sesiones. Almacena notas no estructuradas en ~/.claude/projects/<project>/memory/ y carga las primeras 200 líneas de MEMORY.md al arrancar.
En la práctica, lo que se guarda no siempre coincide con lo que querrías, y luego no hay forma de buscar ni filtrar. Acabas con un archivo de texto con decisiones a las que Claude puede que haga caso o no.
El comando /compact completa las opciones integradas resumiendo tu conversación para liberar espacio de contexto. Los CLAUDE.md sobreviven porque se vuelven a leer desde disco, pero lo demás desaparece: instrucciones conversacionales, contexto de mitad de sesión, cualquier cosa que dijeras y no anotaras en algún sitio.
claude-mem cubre el hueco que ninguna de estas opciones llena: captura continua automática con compresión estructurada y recuperación consciente de tokens. Tampoco es el único plugin que hace este trabajo.
|
Herramienta |
Arquitectura |
Almacenamiento |
Búsqueda |
Momento de captura |
Precio |
Entre máquinas |
Memoria de equipo |
|
Claude integrado |
Nativa |
Markdown local |
Ninguna |
Manual |
Gratis |
Vía git sync |
Vía CLAUDE.md compartido |
|
claude-mem |
Plugin (hooks) |
SQLite local + FTS5 |
Búsqueda por palabras (FTS5) |
Por llamada de herramienta |
Gratis |
No |
No |
|
memsearch |
Plugin (hooks + skill) |
Markdown local + Milvus |
Denso híbrido + BM25 |
Fin de sesión |
Gratis |
No |
No |
|
supermemory |
Plugin (hooks + cloud) |
Nube |
Semántica + temporal |
Fin de sesión |
De pago |
Sí |
Sí |
|
mem0 (self-hosted) |
Servidor MCP |
Qdrant local + Ollama |
Vector semántico |
Fin de sesión |
Gratis |
No |
No |
memsearch es la alternativa gratuita más cercana si prefieres archivos markdown en lugar de una base de datos y no quieres un proceso en segundo plano. Ejecuta la recuperación en un subagente aislado, así que los resultados de búsqueda no se mezclan en tu ventana de contexto principal. Úsalo si buscas un montaje más sencillo y no necesitas captura por llamada.
supermemory es la mejor opción si necesitas sincronización entre máquinas y memoria compartida de equipo, aunque requiere suscripción de pago.
La pila autogestionada mem0 sigue un enfoque distinto: Qdrant y Neo4j para seguimiento de entidades basado en grafos, coste extra cero, pero una configuración más pesada que solo compensa si ya operas esa infraestructura.
claude-mem queda en medio. Completamente local, gratis, captura por llamada con compresión estructurada. La contrapartida es un proceso worker en el puerto 37777 y algunos bordes ásperos aún por pulir.
La seguridad es la principal preocupación.
Una auditoría comunitaria en febrero de 2026 calificó el riesgo como ALTO, y los issues siguen abiertos.
La API HTTP en el puerto 37777 no tiene autenticación: cualquier proceso en tu máquina puede leer todas las observaciones almacenadas, ver tu configuración (incluidas API keys en claro) e inyectar recuerdos arbitrarios en la base de datos.
La vinculación de host por defecto era 0.0.0.0 en lugar de 127.0.0.1, lo que en VMs en la nube o máquinas sin firewall expone la API a la red.
Las herramientas smart_unfold y smart_outline también tienen una vulnerabilidad de path traversal sin comprobaciones de límites de directorio.
Úsalo solo en una máquina personal de desarrollo.
La fiabilidad también tiene algún borde afilado.
La integración con ChromaDB tiene una fuga conocida de subprocesos: un usuario rastreó 184 procesos huérfanos en 19 horas, consumiendo unos 16 GB de RAM.
La causa raíz fue un modelo ONNX corrupto que disparaba bucles de reintentos infinitos. Quédate con FTS5 (el motor de búsqueda de texto completo integrado en SQLite), que funciona sin ChromaDB y en mi experiencia ha sido fiable.
En macOS con Apple Silicon, el arranque en frío del worker puede superar el timeout fijo de 5 segundos cuando ChromaDB está habilitado, haciendo que falle el hook SessionStart. Esto no afecta a configuraciones solo con FTS5. También hay un bug activo donde las herramientas MCP search y timeline tienen esquemas de parámetros vacíos, así que Claude no puede pasarles consultas. get_observations funciona bien.
No son bloqueantes para desarrollo local en una máquina personal. Pero conviene saberlo antes de instalar algo que tiene acceso a todo tu historial de sesiones.
Tras tres semanas, lo que más noto es lo que ya no hago. No vuelvo a explicar la estructura del proyecto al inicio de cada sesión. No repito una ruta de depuración que ya recorrimos. Claude llega con contexto y empezamos donde lo dejamos.
Esta arquitectura lo hace posible de una forma que los enfoques más simples no. Capturar solo al final de la sesión implica perderlo todo si la sesión se cae. Volcar el historial sin capas de recuperación implica gastar tokens en ruido. Las decisiones de diseño aquí son deliberadas, y conocerlas te ayuda a ajustar la herramienta en lugar de usarla a ciegas.
Las brechas de seguridad que hemos visto son reales, y siguen abiertas. Esto merece la pena en una máquina personal de desarrollo. No merece la pena en una VM en la nube o en una máquina compartida hasta que se corrijan. Pero para desarrollo local en solitario, las compensaciones son asumibles.
Si quieres profundizar, el curso de DataCamp Introduction to Claude es un buen punto de partida para entender cómo funciona Claude Code antes de añadirle plugins.
Top Cursos de DataCamp
Curso
Curso
Curso
blog
Matt Crabtree
12 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Abid Ali Awan
Tutorial
Adel Nehme
9 min
Tutorial
Dimitri Didmanidze
9 min