Cours
Introduction aux modèles Claude
3 h
14.6K
Il y a quelques semaines, j’ai installé claude-mem sur l’ensemble de mes projets. Depuis, l’outil a enregistré 6 814 observations sur 259 sessions, couvrant dix bases de code différentes, le tout dans un fichier SQLite de 39 Mo stocké localement sur mon ordinateur.
Avant cela, chaque session Claude Code repartait de zéro. J’ouvrais une nouvelle session et passais les dix premières minutes à réexpliquer l’architecture du projet. Le bug d’authentification corrigé la veille ? Claude n’en savait rien. Il relisait des fichiers déjà analysés et retombait sur les mêmes mauvaises hypothèses que nous avions déjà rectifiées.
claude-mem est un plugin Claude Code qui corrige cela en capturant ce qui se passe pendant une session et en le rendant disponible pour les suivantes.
Dans cet article, je vous explique son fonctionnement en coulisses, comment l’installer sans tomber dans les pièges courants, comment l’ajuster à votre budget, et ce qu’il faut savoir avant de l’utiliser en production.
claude-mem est un plugin Claude Code qui :
~/.claude-mem/claude-mem.dbIl fonctionne comme un plugin, pas comme un serveur MCP.
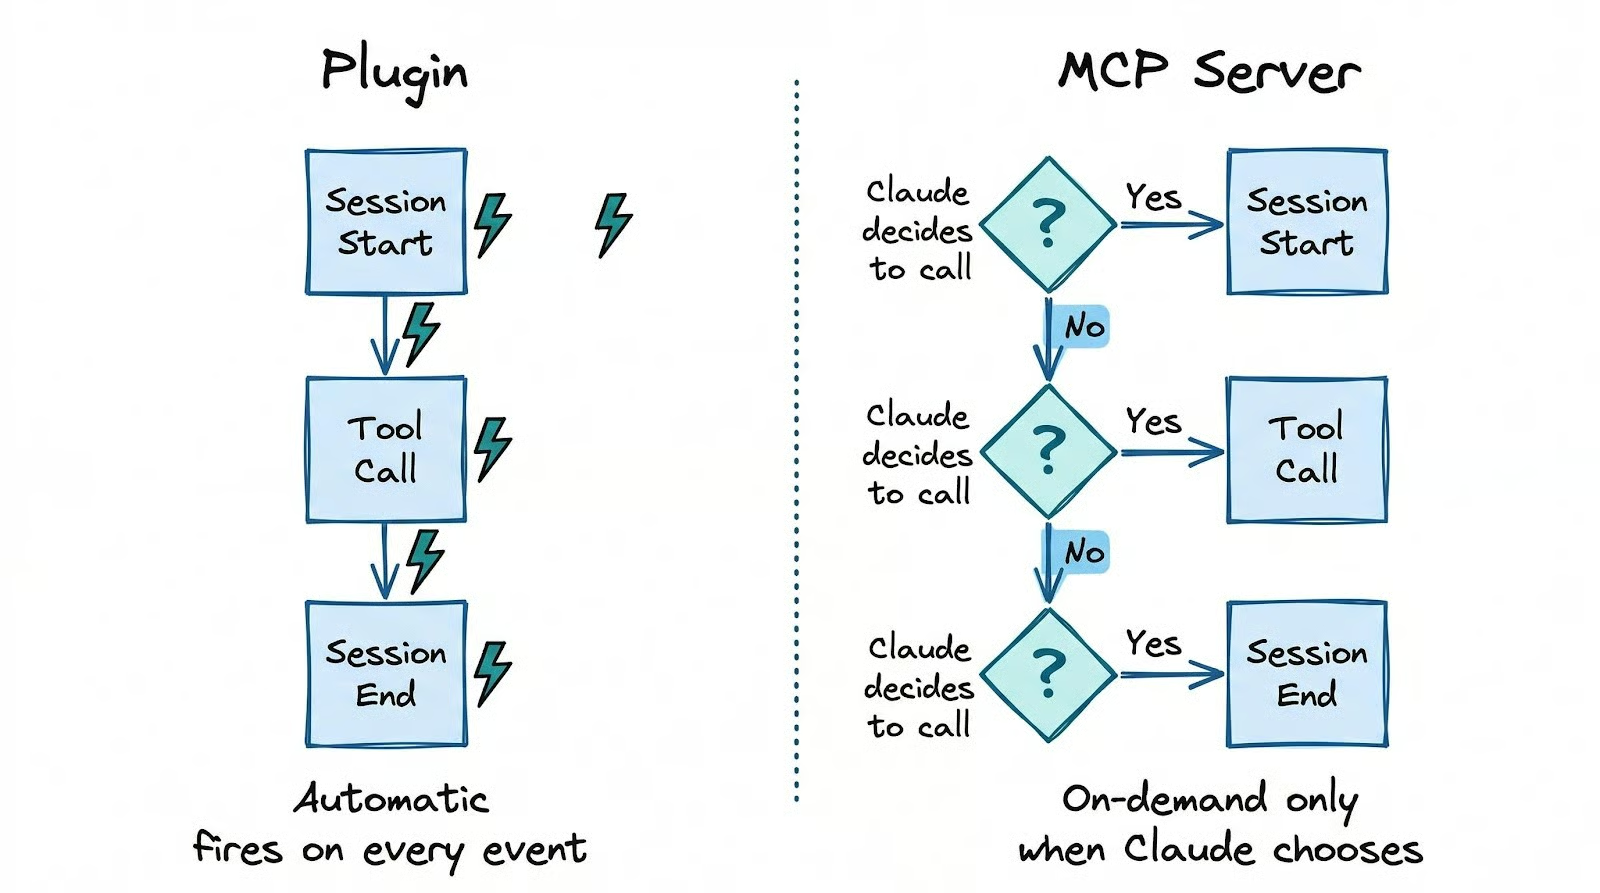
La nuance est importante : les plugins se déclenchent automatiquement sur les événements du cycle de vie (démarrage de session, chaque appel d’outil), alors que les serveurs MCP restent inactifs tant que Claude ne décide pas de les appeler.
Avec une approche basée sur MCP, la récupération n’a lieu que lorsque Claude pense à la demander. claude-mem capture et injecte sans que Claude ait à le choisir.
Tout reste sur votre machine, et la compression s’appuie sur votre authentification Claude Code existante : pas de clé API ni de compte séparé à gérer.
La mise en route tient en deux commandes à lancer dans une session Claude Code :
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
Redémarrez ensuite Claude Code.
L’erreur fréquente consiste à lancer npm install -g claude-mem à la place, ce qui n’installe que la bibliothèque SDK. Les hooks ne sont alors pas enregistrés, le worker ne démarre pas et rien ne fonctionne.
Le passage par la place de marché est le seul à fournir l’installation complète. La seule dépendance stricte est Node.js 18+. Tout le reste (Bun, uv, SQLite) s’installe automatiquement au premier lancement.
Pour vérifier que l’installation a bien abouti, contrôlez trois points. D’abord, curl http://localhost:37777/api/health doit renvoyer {"status":"ok"}. Si ce n’est pas le cas, le worker d’arrière-plan n’a pas démarré. La cause la plus fréquente est une version de Node.js inférieure à 18.
Ensuite, vérifiez que ~/.claude/hooks.json contient des entrées claude-mem. Si le fichier ne liste pas claude-mem sous PostToolUse et SessionStart, les hooks n’ont pas été enregistrés et aucune capture ne s’exécutera, même si le worker est actif.
Enfin, ouvrez http://localhost:37777 dans un navigateur pour accéder au viewer web, qui affiche en direct les observations au fil de votre travail.
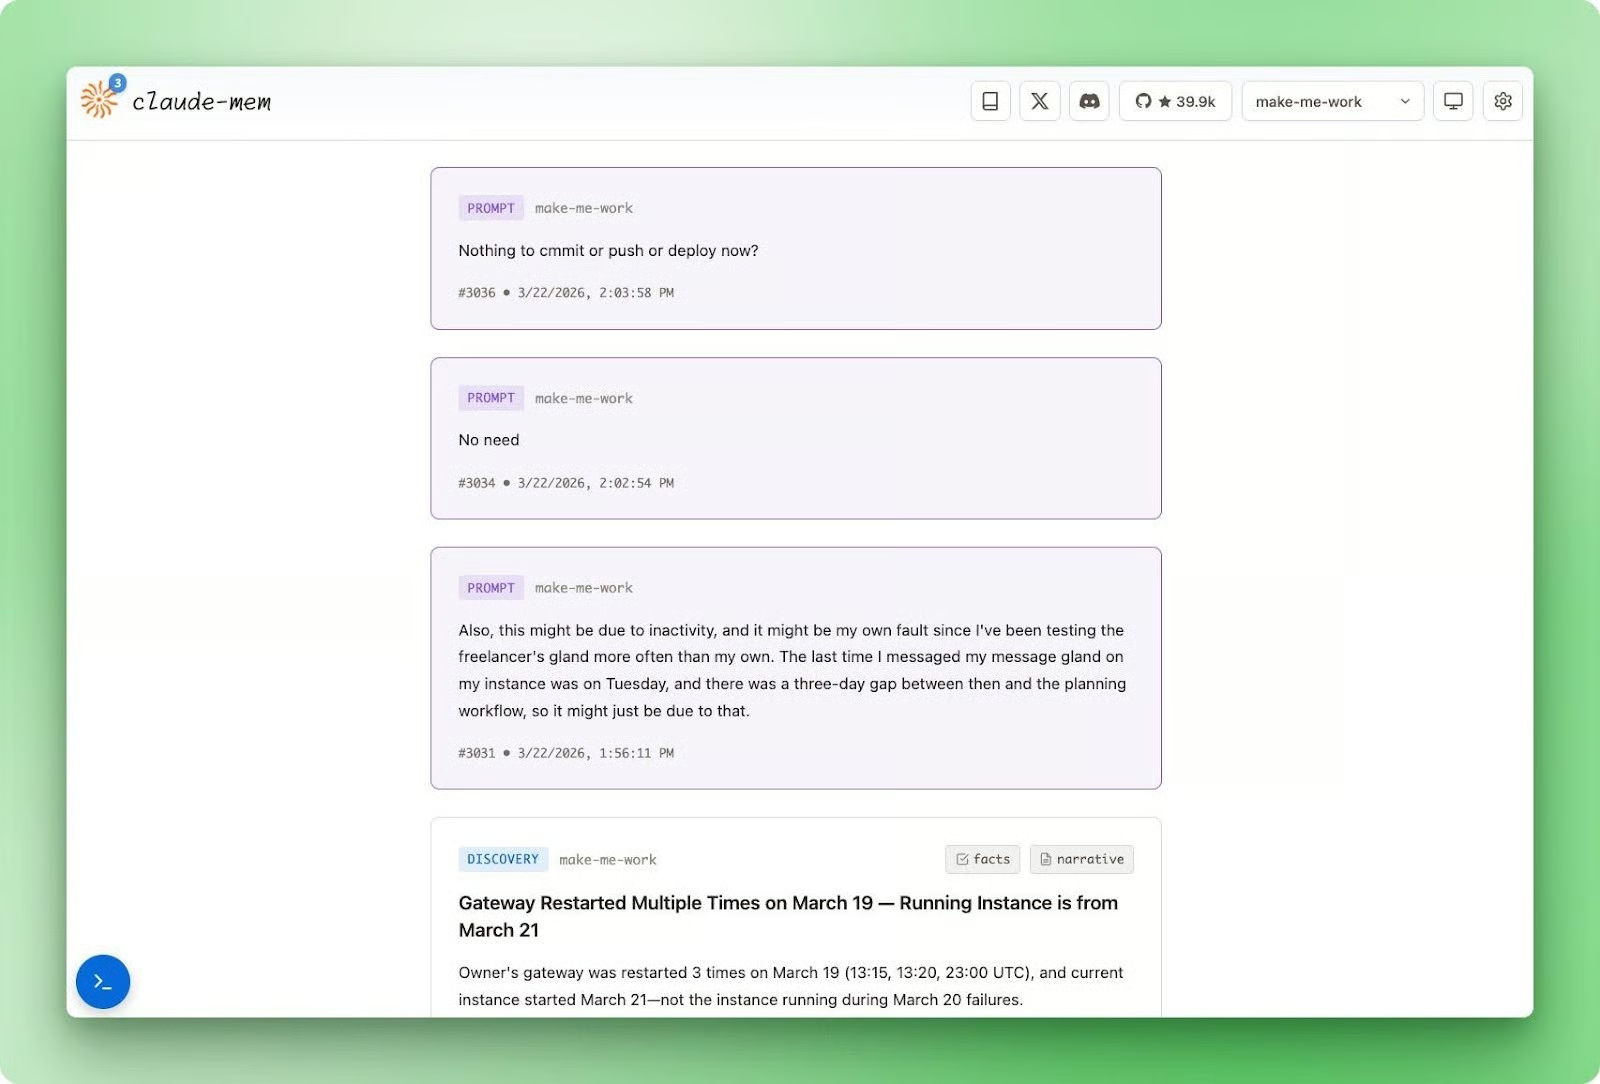
La première session ne produit aucun contexte injecté au SessionStart puisque la base est vide, mais les observations commencent à s’accumuler dès le premier appel d’outil.
Dès la deuxième session, claude-mem disposera d’un résumé de session et d’un lot d’observations à injecter.
Passer par cette check-list de vérification en amont vous évite de découvrir au bout de trois sessions que rien n’a été capturé. Le viewer web reste l’indicateur le plus fiable : si vous voyez des observations apparaître après un appel d’outil, tout est correctement branché.
Une fois installé, claude-mem tourne silencieusement en arrière-plan via cinq hooks du cycle de vie. Comprendre leur rôle éclaire le comportement de l’outil.
Ces cinq hooks suivent la chronologie naturelle d’une session :
SessionStart interroge la base et injecte un index compressé des travaux récents dans la fenêtre de contexteUserPromptSubmit consigne la session et enregistre votre promptPostToolUse se déclenche après chaque appel d’outil et envoie la sortie brute à un worker pour compressionStop génère un résumé de session lorsque vous mettez en pause ou êtes inactifSessionEnd marque la session comme terminée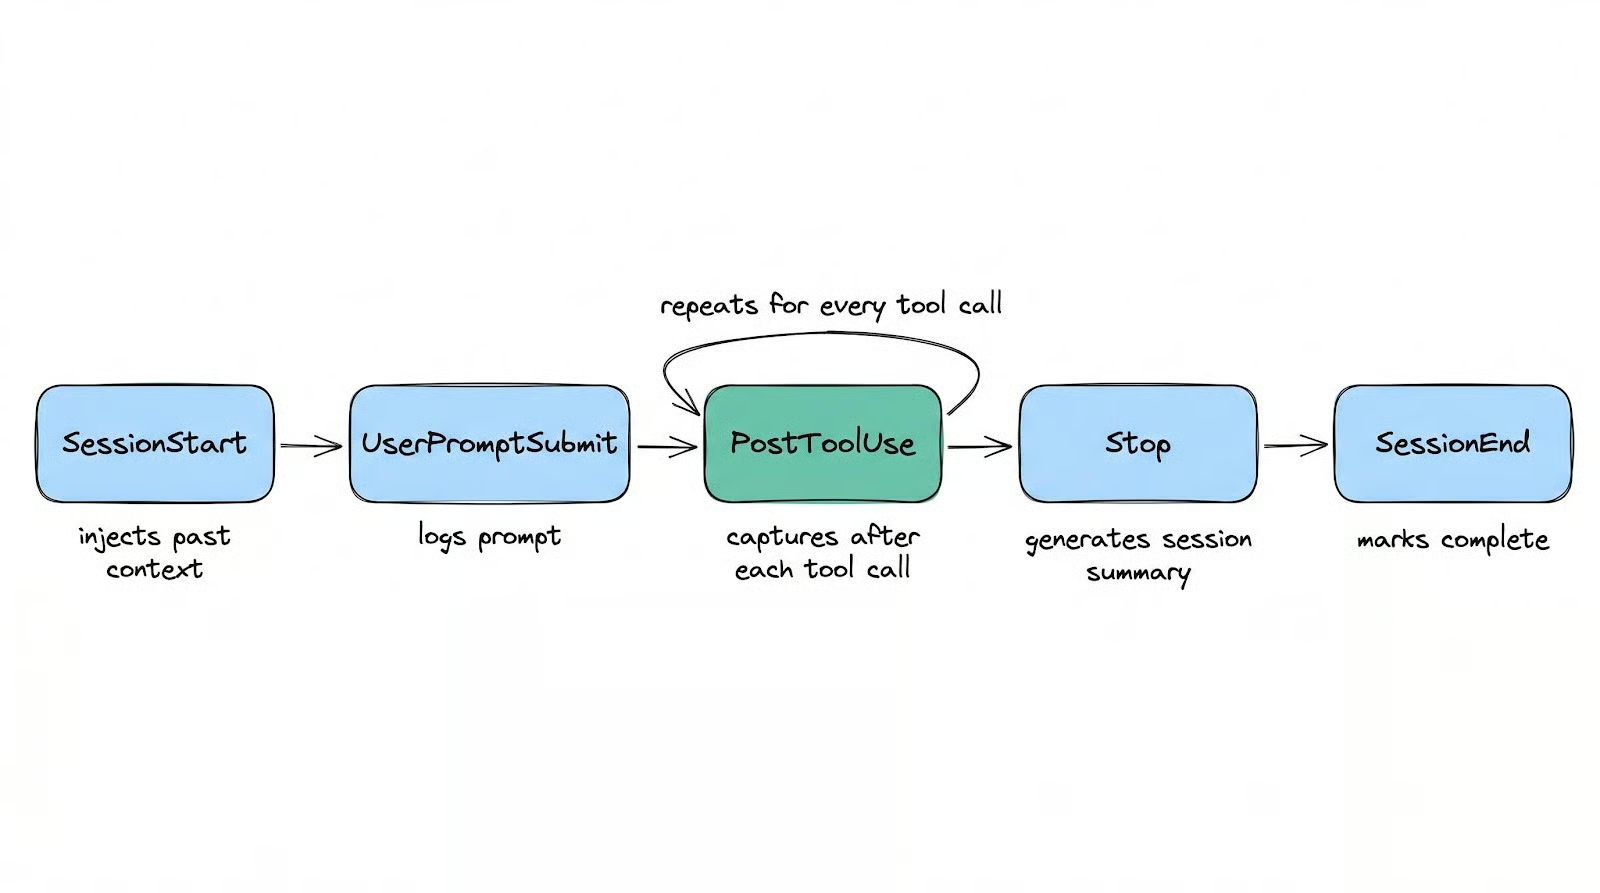
SessionStart construit cet index injecté à partir des résumés de session, des titres d’observations groupés par type et des horodatages : une carte exploitable des travaux récents que Claude peut consulter tout au long de la session, sans action de votre part.
PostToolUse se déclenche après chaque appel d’outil. La sortie brute est envoyée à un worker via un POST HTTP non bloquant (8 ms en moyenne), et le worker la compresse en une observation structurée à l’aide du Claude Agent SDK.
Voici à quoi ressemble cette structure :
|
Champ |
Contenu |
|
|
Parmi : |
|
|
Une chaîne concise et recherchable |
|
|
Un tableau de faits discrets (~50 tokens, peu coûteux à charger) |
|
|
Une explication rédigée (~155–500 tokens, chargée à la demande seulement) |
|
|
Des tags sémantiques comme how-it-works, problem-solution, gotcha, trade-off |
La capture à chaque appel d’outil distingue claude-mem des outils qui se contentent d’un unique résumé en fin de session.
Si votre session plante en plein refactoring, ces outils perdent tout depuis la dernière session achevée. claude-mem, lui, conserve chaque observation jusqu’au dernier appel d’outil.
Le hook Stop produit autre chose : un résumé au niveau de la session avec des champs tels que request, investigated, learned, completed et next_steps. Cela offre à Claude une vue d’ensemble sans devoir charger chaque observation individuellement.
Stocker des milliers d’observations est une chose. Charger les bonnes dans une fenêtre de contexte sans brûler des tokens en est une autre.
L’approche naïve consiste à déverser tout l’historique dans le prompt. La documentation de claude-mem chiffre cela : un chargement naïf typique envoie 35 000 tokens dans la fenêtre de contexte, dont environ 2 000 seulement sont pertinents. Soit 6 % de signal.
Un système de récupération en trois niveaux dépasse 80 % en laissant Claude charger progressivement le contexte via claude-mem :
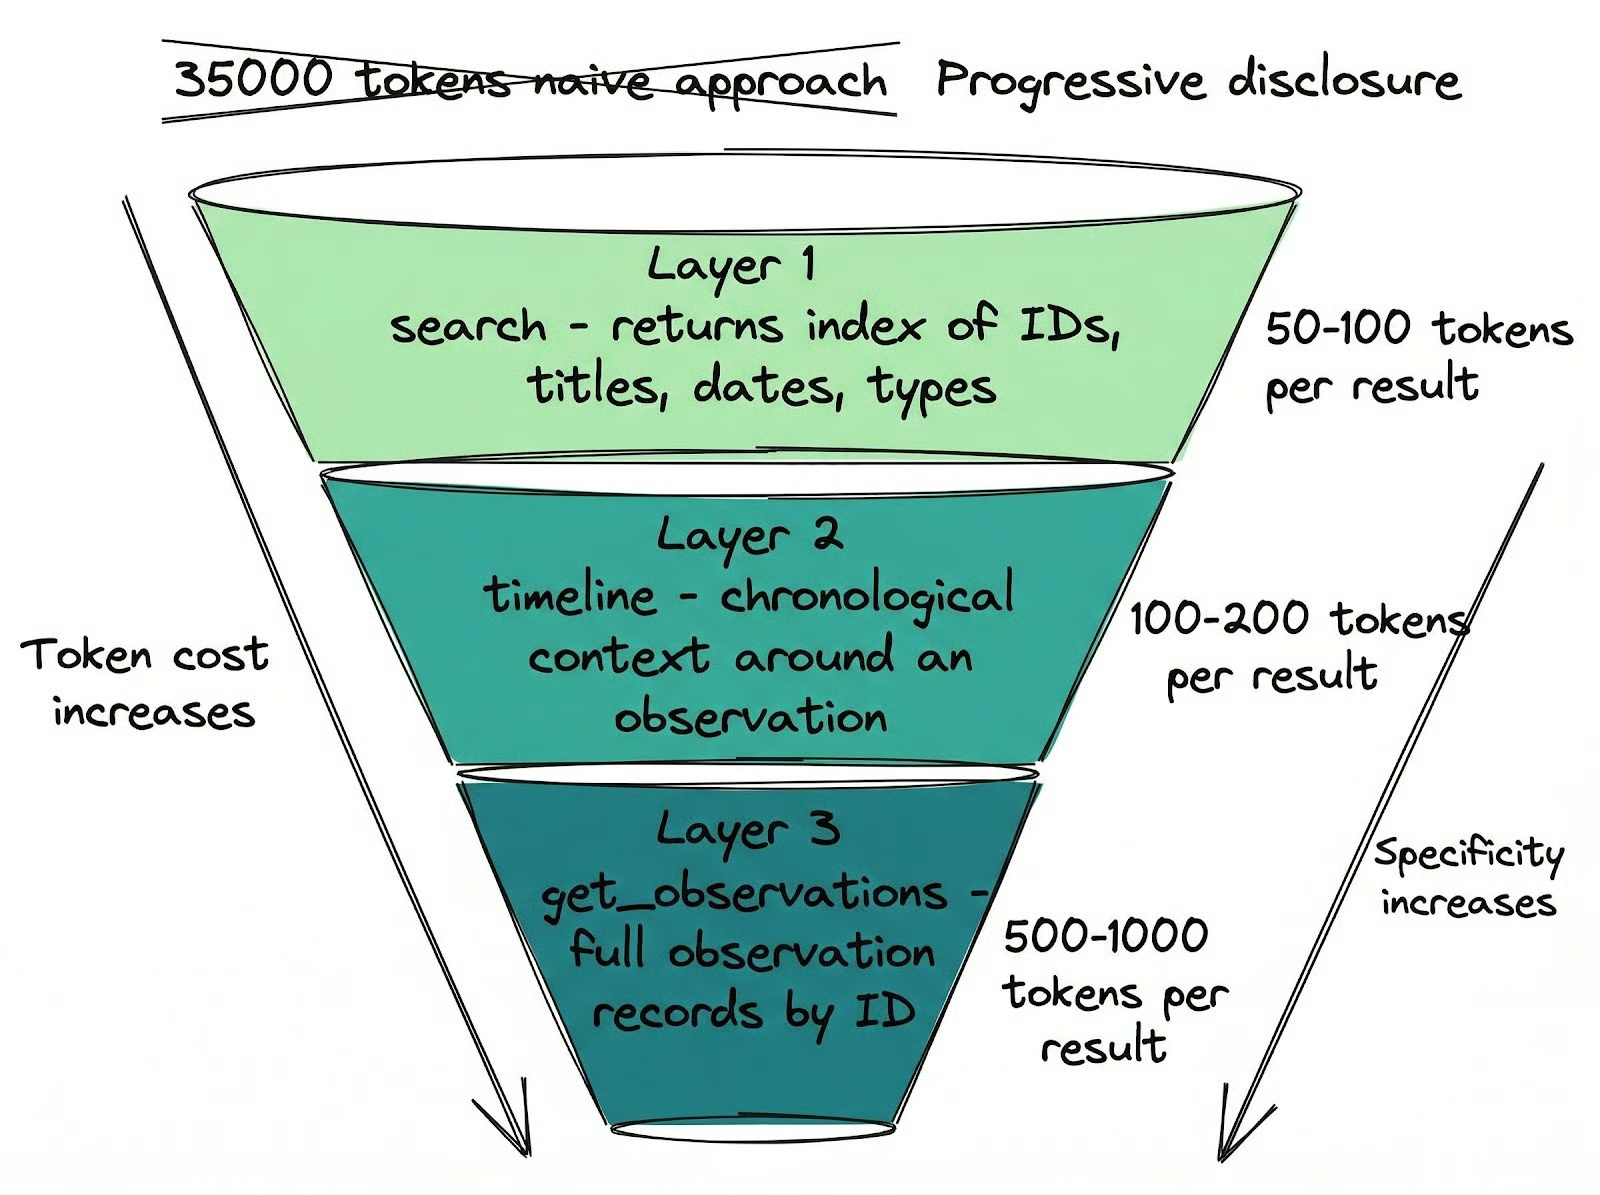
get_observations récupère en lot les enregistrements complets par ID. Coût : 500–1 000 tokens par résultat. Ne tirez que ce dont vous avez réellement besoin.Cette discipline de récupération ne s’impose pas d’elle-même.
claude-mem enregistre un outil MCP littéralement nommé __IMPORTANT dont l’unique but est de rappeler à Claude de suivre ce schéma en trois étapes.
Sans cela, Claude saute les niveaux économiques et récupère tout en détail maximal, ce qui annule l’intérêt de l’architecture. Le fait d’avoir dû ajouter un outil nommé pour imposer cette discipline donne une image réaliste de la manière dont le système a été pensé autour du comportement réel de Claude.
Ces outils de récupération ne servent pas qu’au démarrage de session.
En cours de session, lorsque vous demandez à Claude quelque chose sur des travaux passés, il interroge directement la mémoire.
Vous pouvez lui faire analyser vos habitudes de travail au fil des sessions, retrouver des détails oubliés (« où ai-je enregistré cette clé API ? », « comment avons-nous implémenté le flux d’auth ? »), ou reprendre un projet laissé en plan depuis des semaines.
Quand vous jonglez entre plusieurs bases de code et sessions, des détails s’échappent de votre propre mémoire plus vite que vous ne le pensez. claude-mem comble ce vide en donnant à Claude accès à tout ce qui s’est passé, y compris ce que vous avez vous-même oublié.
Après trois semaines, 61 % de mes observations sont typées discovery. Claude capture surtout ce qu’il apprend d’une base de code plutôt que les seuls changements effectués.
Sur 259 sessions, je compte 1 729 résumés de session, soit 6 à 7 en moyenne par session. Cette continuité multi-sessions n’est possible que parce que la capture tourne en continu, pas seulement en fin de session.
C’est la différence entre résumer une session et véritablement s’en souvenir.
Tous les réglages de claude-mem sont accessibles via l’interface web à http://localhost:37777 dans l’onglet Settings. Vous pouvez aussi les définir via des variables d’environnement ou éditer directement ~/.claude-mem/settings.json.
Le premier paramètre à connaître est CLAUDE_MEM_MODEL, qui détermine le modèle utilisé pour la compression. La valeur par défaut est haiku, déjà l’option la plus économique de la gamme Claude.
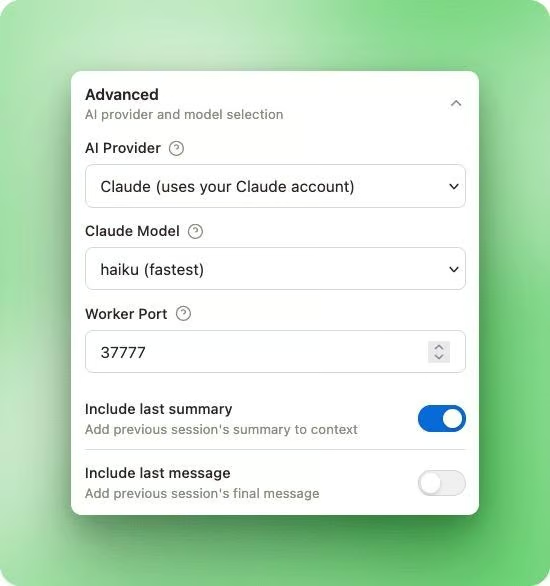
Vous pouvez aussi changer complètement de fournisseur de compression avec CLAUDE_MEM_PROVIDER, qui accepte claude, gemini ou openrouter.
Faire tourner la compression sur Gemini Flash Lite ou un modèle gratuit OpenRouter comme xiaomi/mimo-v2-flash:free ramène le coût additionnel à zéro au-delà de votre abonnement Claude Code existant.
Personnellement, j’utilise haiku avec 30 observations par session. À environ 400 tokens en entrée et 150 en sortie par appel de compression, cela représente ~16 500 tokens par session. Aux tarifs haiku, un mois d’usage intensif coûte bien moins d’un dollar.
Après trois semaines et dix projets, la qualité de compression n’a pas posé problème.
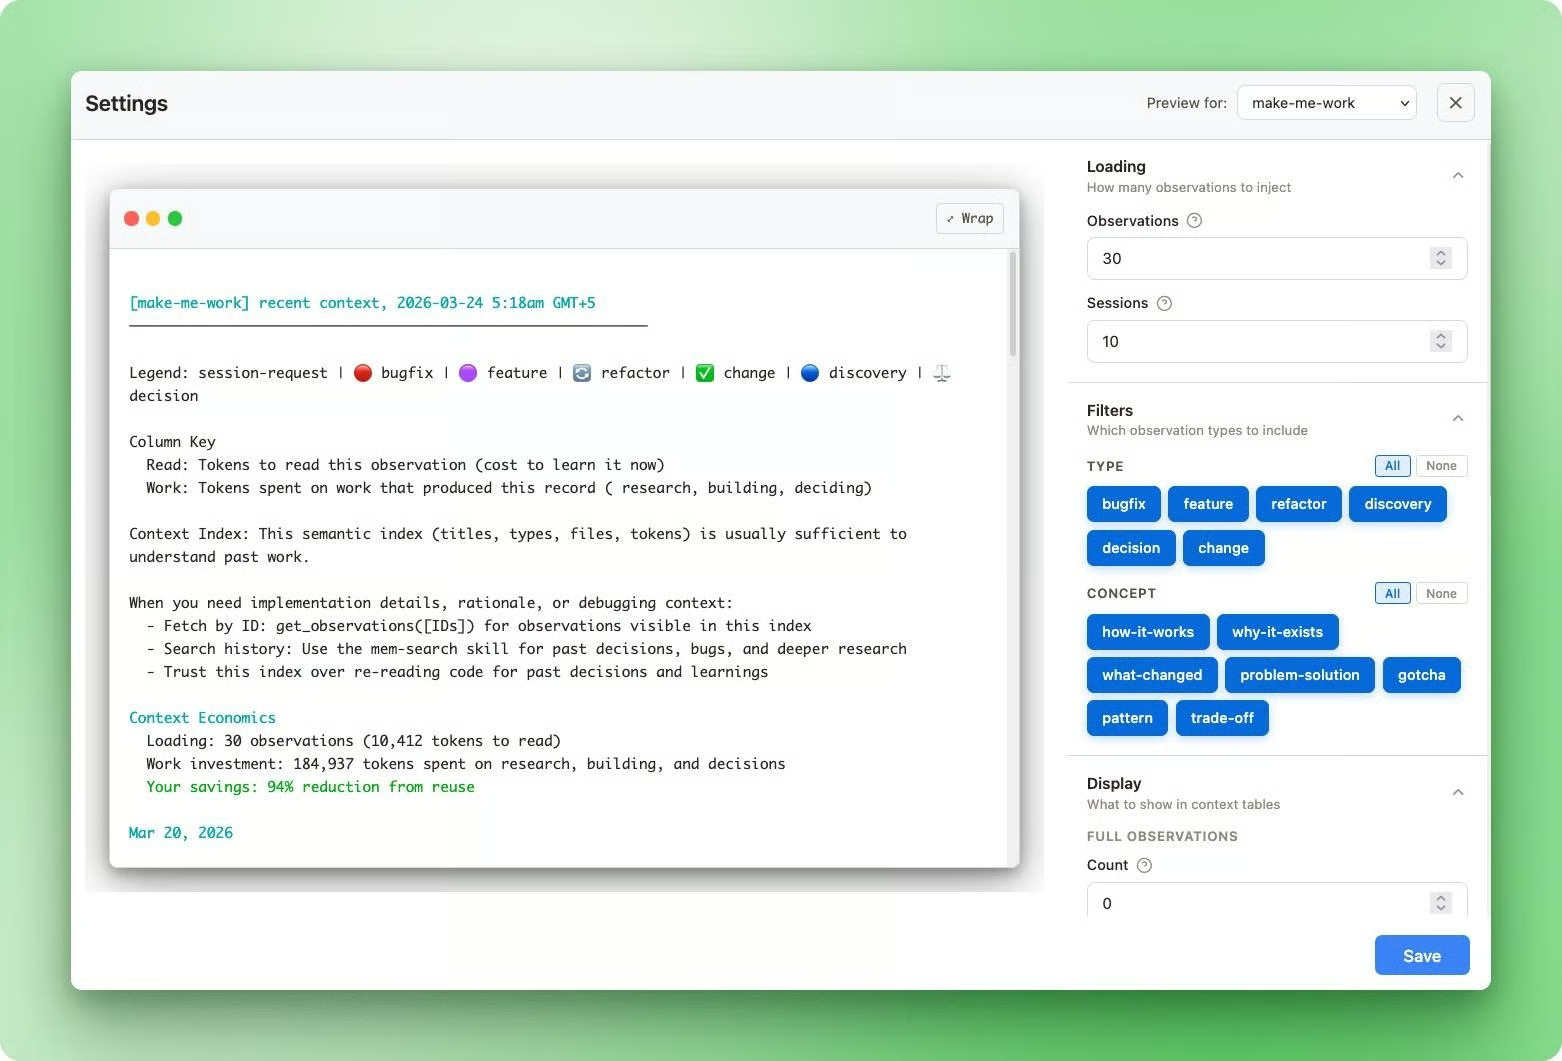
Deux réglages contrôlent la quantité de contexte chargée au démarrage :
CLAUDE_MEM_CONTEXT_OBSERVATIONS : nombre total d’observations injectées à SessionStart (par défaut 50, plage 1–200)CLAUDE_MEM_CONTEXT_FULL_COUNT : nombre d’observations affichées en détail avec le champ narrative complet (par défaut 5, plage 0–20)Les autres n’affichent que le titre, le type et la date. Toute injection de contexte est limitée au répertoire du projet sur lequel vous travaillez, donc les observations d’autres projets ne viennent pas polluer votre contexte.
Vous pouvez prévisualiser exactement ce qui sera injecté et ajuster ces compteurs par projet via l’interface web.
À anticiper : durant la première semaine sur un nouveau projet, votre fenêtre de contexte peut se remplir plus vite que d’habitude.
J’ai presque désinstallé claude-mem pendant cette phase initiale, car les sessions atteignaient la limite de contexte plus tôt qu’avant.
En réalité, claude-mem apprenait le projet depuis zéro, enregistrant un volume élevé de nouvelles observations qui étaient toutes injectées au démarrage.
Au bout d’une semaine environ, le volume de nouvelles découvertes a chuté une fois la base de code cartographiée, et les sessions ont commencé à durer plus longtemps qu’avant l’installation du plugin.
Si vous rencontrez cette surcharge initiale, baissez temporairement CLAUDE_MEM_CONTEXT_OBSERVATIONS puis remontez-le une fois la phase d’apprentissage passée.
CLAUDE_MEM_SKIP_TOOLS permet d’exclure certains outils de la capture.
Par défaut, les outils bruyants comme TodoWrite, AskUserQuestion et BashTool sont déjà ignorés. Vous n’aurez probablement rien à changer, sauf si un outil personnalisé génère une sortie que vous ne souhaitez pas stocker. La liste est séparée par des virgules, l’ajout est donc simple.
Si vous manipulez des clés API ou des identifiants, entourez-les de balises <private> dans vos prompts pour exclure ce contenu du stockage.
claude-mem supprime tout ce qui se trouve entre ces balises avant de créer une observation.
Il n’analyse pas proactivement le contenu des fichiers, donc les variables d’environnement chargées depuis le disque ne sont pas en risque, mais tout ce que vous collez directement dans un prompt l’est. La protection via balises <private> est donc à activer volontairement : à vous d’y penser.
Claude Code intègre déjà des fonctions de mémoire, mais aucune ne capture le contexte automatiquement.
CLAUDE.md sont des fichiers markdown statiques chargés au démarrage, utiles pour les règles et préférences de projet, mais limités à environ 200 lignes avant que l’adhérence ne baisse. Pas de recherche, pas de récupération. Vous écrivez vos consignes une fois et espérez que Claude les suive.
Auto Memory, ajouté dans Claude Code v2.1.59, délègue à Claude le choix de ce qu’il faut conserver entre les sessions. Il stocke des notes non structurées dans ~/.claude/projects/<project>/memory/ et charge les 200 premières lignes d’un fichier MEMORY.md au démarrage.
En pratique, ce qui est sauvegardé ne correspond pas toujours à vos attentes, et il n’existe aucun moyen de recherche ou de filtrage a posteriori. Vous finissez avec un fichier texte de décisions que Claude suivra… ou pas.
La commande /compact complète les options natives en résumant la conversation pour libérer du contexte. Les fichiers CLAUDE.md survivent car relus depuis le disque, mais tout le reste disparaît : instructions conversationnelles, contexte en cours de session, tout ce que vous avez dit sans l’écrire ailleurs.
claude-mem comble ce manque : capture continue et automatique avec compression structurée et récupération économe en tokens. Ce n’est pas le seul plugin sur ce créneau.
|
Outil |
Architecture |
Stockage |
Recherche |
Moment de capture |
Tarification |
Multi-machine |
Mémoire d’équipe |
|
Claude natif |
Natif |
Markdown local |
Aucune |
Manuelle |
Gratuit |
Via synchronisation git |
Via CLAUDE.md partagé |
|
claude-mem |
Plugin (hooks) |
SQLite local + FTS5 |
Mots-clés FTS5 |
À chaque appel d’outil |
Gratuit |
Non |
Non |
|
memsearch |
Plugin (hooks + skill) |
Markdown local + Milvus |
Hybride dense + BM25 |
Fin de session |
Gratuit |
Non |
Non |
|
supermemory |
Plugin (hooks + cloud) |
Cloud |
Sémantique + temporelle |
Fin de session |
Payant |
Oui |
Oui |
|
mem0 (self-hosted) |
Serveur MCP |
Qdrant local + Ollama |
Vecteurs sémantiques |
Fin de session |
Gratuit |
Non |
Non |
memsearch est l’alternative gratuite la plus proche si vous préférez des fichiers markdown à une base de données et ne souhaitez pas de processus d’arrière-plan. Il exécute la récupération dans un sous-agent isolé, donc les résultats de recherche ne polluent jamais votre contexte principal. À privilégier si vous voulez une configuration plus simple et n’avez pas besoin de capture à chaque appel.
supermemory est indiqué si vous avez besoin d’une synchronisation multi-machine et d’une mémoire partagée en équipe, avec un abonnement payant.
La pile mem0 auto-hébergée adopte une approche différente : Qdrant et Neo4j pour le suivi des entités en graphe, aucun coût supplémentaire, mais une mise en place plus lourde, intéressante surtout si vous exploitez déjà cette infrastructure.
claude-mem se place au milieu. Entièrement local, gratuit, capture à chaque appel avec compression structurée. La contrepartie : un worker en arrière-plan sur le port 37777 et quelques aspérités encore présentes.
La sécurité est le sujet le plus sensible.
Un audit communautaire en février 2026 a classé le risque en ÉLEVÉ, et les points restent ouverts.
L’API HTTP sur le port 37777 ne comporte aucune authentification : tout processus local peut lire chaque observation, consulter vos paramètres (y compris d’éventuelles clés API en clair) et injecter des éléments arbitraires dans la base.
Le binding hôte par défaut était 0.0.0.0 plutôt que 127.0.0.1, ce qui, sur des VM cloud ou des machines sans pare-feu, expose l’API au réseau.
Les outils smart_unfold et smart_outline présentent également une vulnérabilité de traversal de chemin sans contrôle de périmètre de répertoire.
N’exécutez ceci que sur une machine de développement personnelle.
Côté fiabilité, il y a aussi quelques angles vifs.
L’intégration ChromaDB souffre d’une fuite de sous-processus : un utilisateur a tracé 184 processus orphelins en 19 heures, consommant ~16 Go de RAM.
La cause racine : un modèle ONNX corrompu déclenchant des boucles de retry infinies. Restez sur FTS5 (le moteur de recherche plein texte intégré à SQLite), qui fonctionne sans ChromaDB et s’est montré fiable dans mon usage.
Sur macOS avec Apple Silicon, le cold start du worker peut dépasser le timeout codé en dur à 5 s lorsque ChromaDB est activé, ce qui fait échouer le hook SessionStart. Cela n’affecte pas les configurations FTS5 seules. Un bug actif vide aussi les schémas de paramètres des outils MCP search et timeline, empêchant Claude d’y passer des requêtes. get_observations fonctionne normalement.
Rien de rédhibitoire pour du développement local sur une machine personnelle. Mais il vaut mieux le savoir avant d’installer un outil qui a accès à l’historique complet de vos sessions.
Après trois semaines, ce qui me frappe, c’est ce que je ne fais plus. Je ne réexplique plus l’architecture au début de chaque session. Je ne refais plus en arrière les chemins de débogage déjà explorés. Claude arrive avec du contexte, et nous reprenons là où nous nous étions arrêtés.
L’architecture permet cela, là où des approches plus simples échouent. Capturer une seule fois en fin de session, c’est tout perdre si elle plante. Déverser l’historique sans paliers de récupération, c’est dépenser des tokens en bruit. Les choix de conception sont délibérés, et les comprendre vous aide à ajuster l’outil plutôt qu’à vous y fier à l’aveugle.
Les failles de sécurité évoquées sont réelles et toujours ouvertes. Cet outil vaut le coup sur une machine de dev personnelle. Il ne vaut pas le risque sur une VM cloud ou une machine partagée tant que ces points ne sont pas corrigés. Pour un développement local en solo, les compromis restent maîtrisables.
Pour aller plus loin, le cours Introduction to Claude de DataCamp est un excellent point de départ pour comprendre le fonctionnement de Claude Code avant d’ajouter des plugins.
Les meilleurs cours DataCamp
Cours
Cours
Cours
blog
Kurtis Pykes
15 min
Tutoriel
Tutoriel
Stephen Gruppetta
12 min
Tutoriel
Josef Waples
8 min
Tutoriel
Laiba Siddiqui
6 min
Tutoriel
Kurtis Pykes
15 min