Curso
Introdução aos modelos Claude
3 h
14.6K
Há algumas semanas, instalei o claude-mem em todos os meus projetos. De lá para cá, ele registrou 6.814 observações em 259 sessões, cobrindo dez bases de código diferentes — tudo guardado em um arquivo SQLite de 39 MB no meu laptop.
Antes disso, toda sessão do Claude Code começava do zero. Eu abria uma nova sessão e gastava os primeiros dez minutos reexplicando a estrutura do projeto. E aquele bug de autenticação que a gente tinha corrigido no dia anterior? O Claude não fazia ideia. Ele relia arquivos que já tinha analisado e acabava nas mesmas suposições erradas que já tínhamos corrigido.
O claude-mem é um plugin do Claude Code que resolve isso capturando o que acontece durante uma sessão e deixando tudo disponível para as próximas.
Neste artigo, vou mostrar como ele funciona por baixo dos panos, como instalar sem cair nas armadilhas mais comuns, como ajustar para caber no seu orçamento e o que você precisa saber antes de rodá-lo em produção.
O claude-mem é um plugin do Claude Code que:
~/.claude-mem/claude-mem.dbEle roda como plugin, não como um servidor MCP.
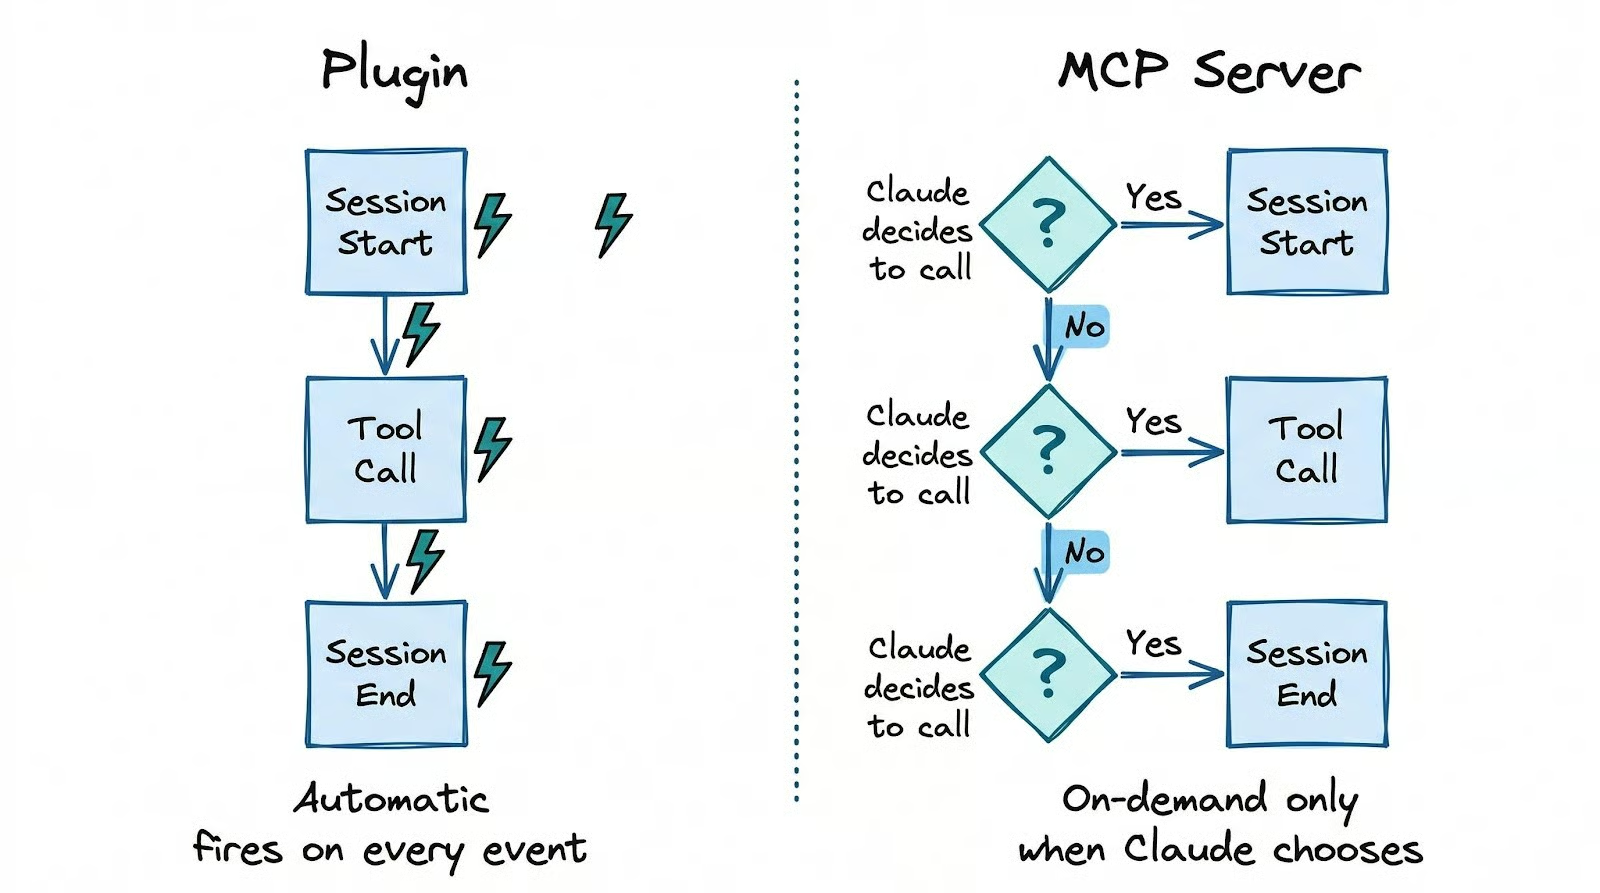
Essa distinção importa: plugins disparam automaticamente em eventos como início da sessão e cada chamada de ferramenta, enquanto servidores MCP ficam ociosos até o Claude decidir chamá-los.
Com uma abordagem baseada em MCP, a recuperação só acontece quando o Claude decide pedir. O claude-mem captura e injeta sem o Claude precisar escolher fazer isso.
Tudo fica na sua máquina, e a compressão usa a autenticação do seu Claude Code, então não é preciso chave de API ou conta separada.
Para colocar no ar, basta rodar dois comandos dentro de uma sessão do Claude Code:
/plugin marketplace add thedotmack/claude-mem
/plugin install claude-mem
Depois disso, reinicie o Claude Code.
O erro mais comum é rodar npm install -g claude-mem, que só instala a biblioteca SDK. Os hooks não são registrados, o worker não inicia e nada funciona.
O caminho pelo marketplace de plugins é o único que entrega a configuração completa. O único pré-requisito é Node.js 18+. Todo o resto (Bun, uv, SQLite) é instalado automaticamente na primeira execução.
Para verificar se a instalação funcionou mesmo, cheque três coisas. Primeiro, curl http://localhost:37777/api/health deve retornar {"status":"ok"}. Se falhar, o worker em background não iniciou. A causa mais comum é usar Node.js abaixo da versão 18.
Segundo, confira se ~/.claude/hooks.json contém entradas do claude-mem. Se o arquivo não listar o claude-mem em PostToolUse e SessionStart, os hooks não foram registrados e nada será capturado, mesmo que o worker esteja vivo.
Terceiro, abra http://localhost:37777 no navegador para ver o visualizador web, que mostra as observações chegando em tempo real enquanto você trabalha.
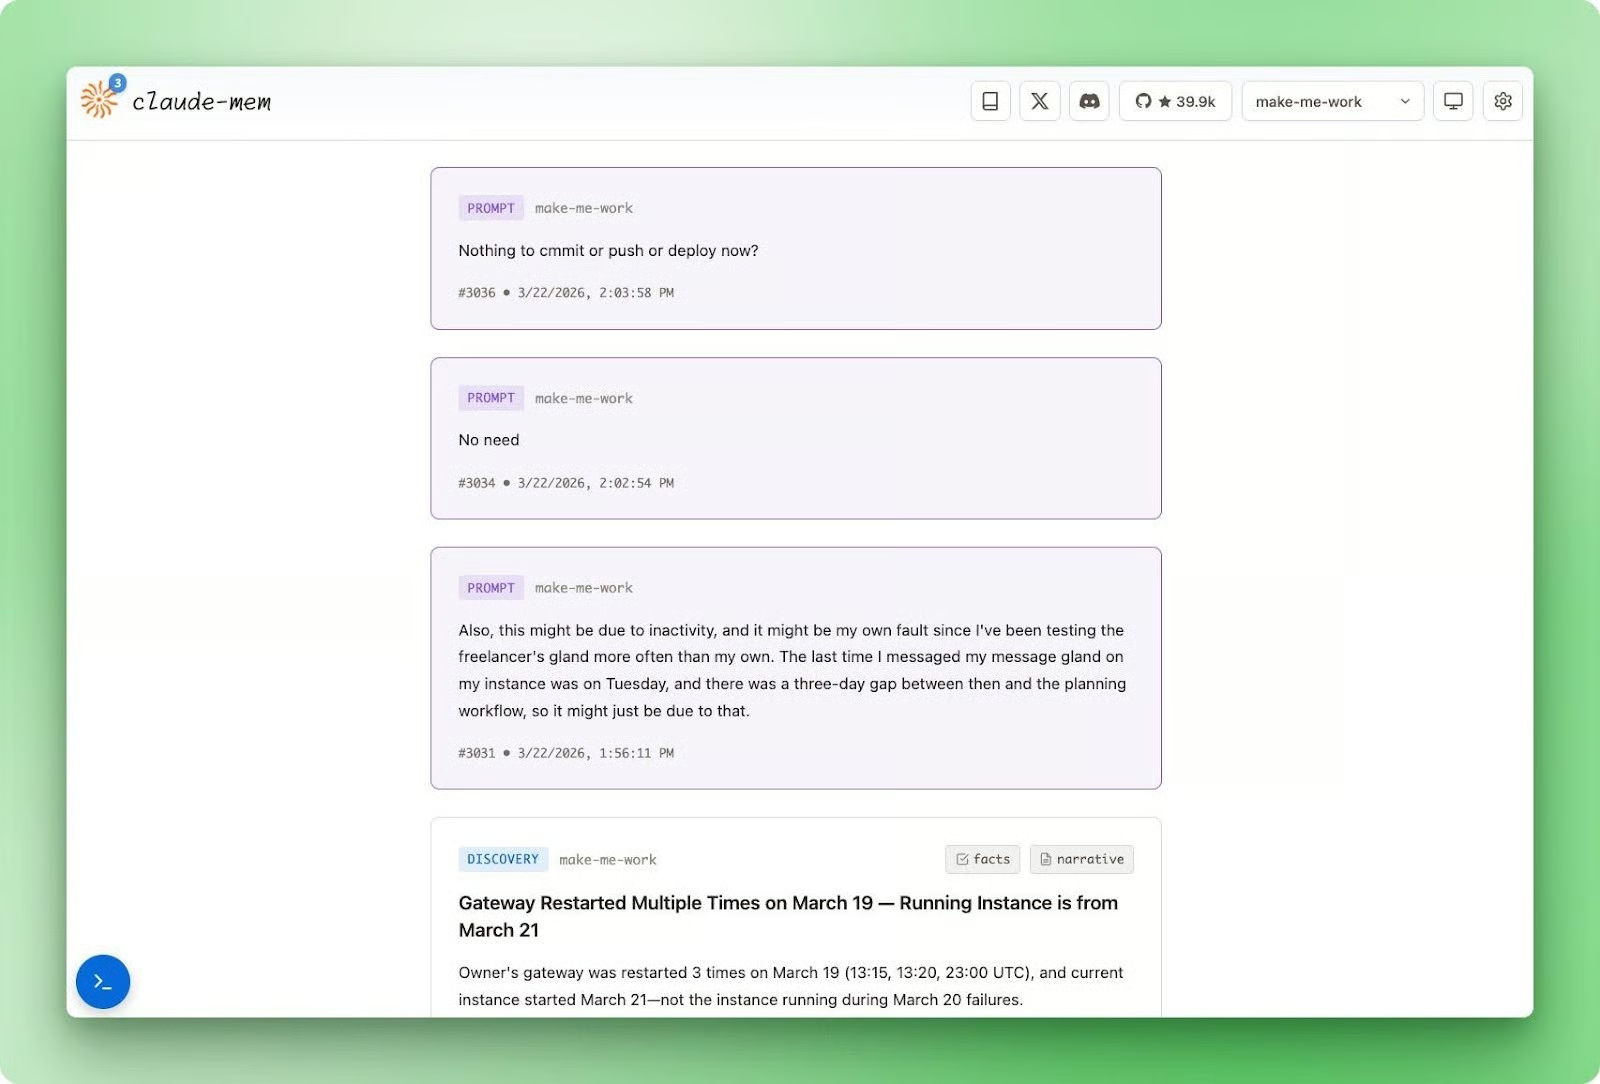
A primeira sessão não injeta contexto em SessionStart porque o banco está vazio, mas as observações começam a acumular a partir da primeira chamada de ferramenta.
Já na segunda sessão, o claude-mem terá um resumo da sessão e um lote de observações para injetar.
Seguir esse checklist de verificação antes evita descobrir, três sessões depois, que nada foi capturado. O visualizador web é o sinal mais confiável: se você vê observações surgindo após uma chamada de ferramenta, está tudo conectado corretamente.
Depois de instalado, o claude-mem roda silenciosamente em segundo plano em cinco hooks do ciclo de vida. Entender o papel de cada um ajuda a explicar o comportamento da ferramenta.
Os cinco hooks acompanham a linha do tempo natural de uma sessão:
SessionStart consulta o banco e injeta um índice comprimido do trabalho recente na sua janela de contextoUserPromptSubmit registra a sessão e armazena seu promptPostToolUse dispara após cada chamada de ferramenta e envia a saída bruta para um worker em background fazer a compressãoStop gera um resumo em nível de sessão quando você pausa ou fica inativoSessionEnd marca a sessão como concluída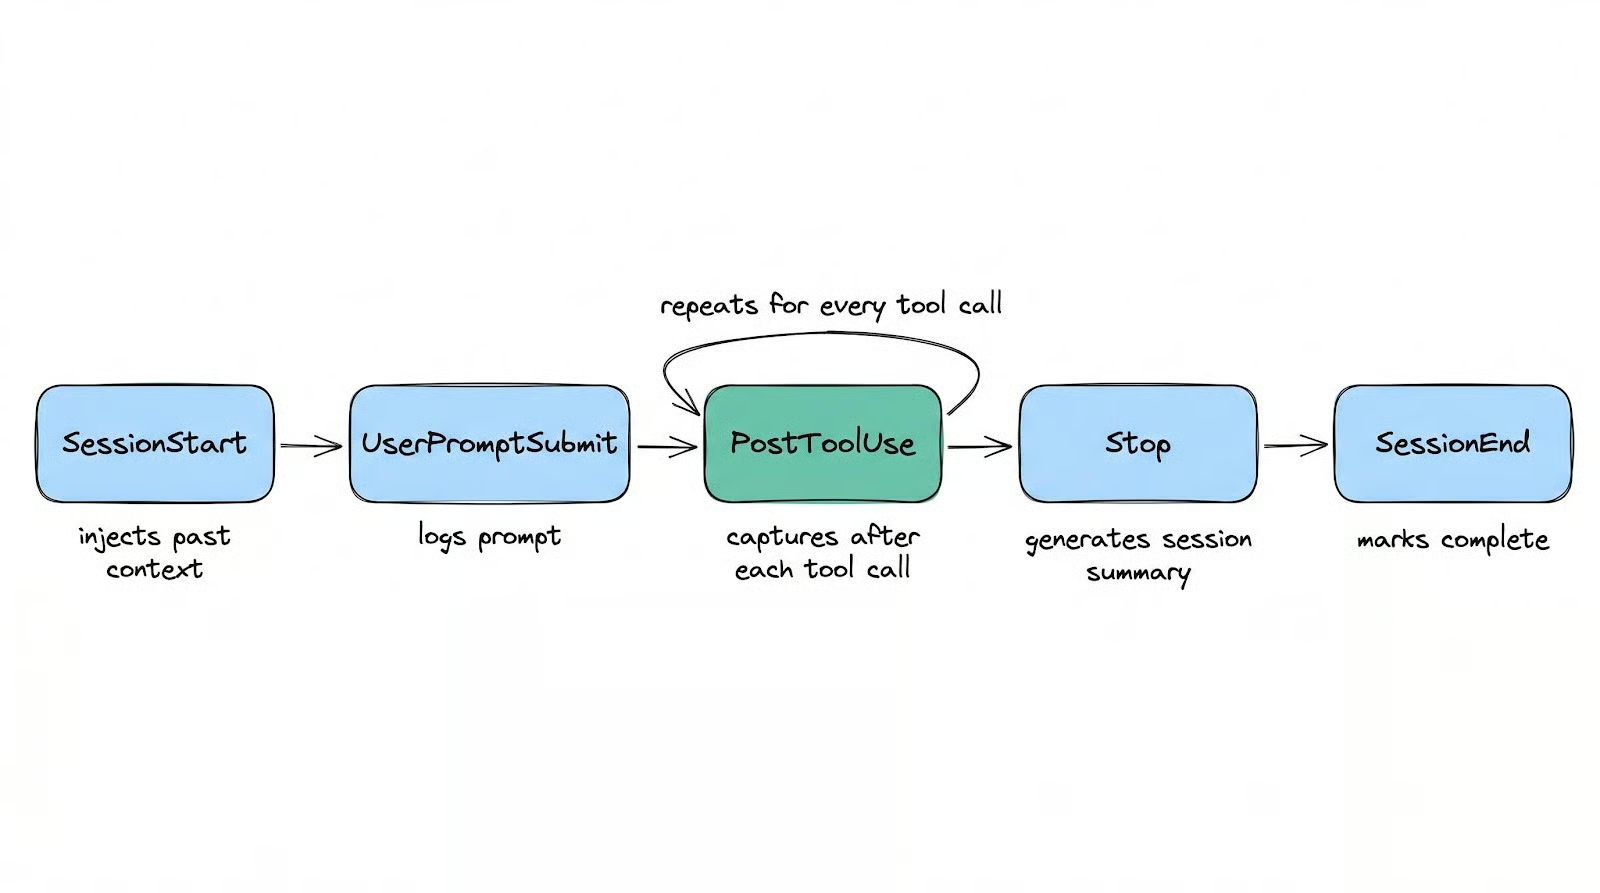
SessionStart monta esse índice injetado a partir de resumos de sessão, títulos de observações agrupados por tipo e carimbos de data e hora: um mapa pesquisável do trabalho recente que o Claude pode consultar durante a sessão, sem você precisar fazer nada.
PostToolUse dispara após cada chamada de ferramenta. Ele envia a saída bruta para um worker em background via HTTP POST não bloqueante (média de 8 ms), e o worker comprime em uma observação estruturada usando o Claude Agent SDK.
A estrutura é assim:
|
Campo |
O que contém |
|
|
Um entre |
|
|
Uma string concisa e pesquisável |
|
|
Um array de fatos discretos (~50 tokens, barato de carregar) |
|
|
Uma explicação em prosa (~155–500 tokens, carregada só sob demanda) |
|
|
Tags semânticas como how-it-works, problem-solution, gotcha, trade-off |
A captura por chamada é o que separa o claude-mem de ferramentas que resumem só no fim da sessão com uma chamada única de IA.
Se sua sessão cair no meio de um refactor, essas ferramentas perdem tudo desde a última sessão concluída. O claude-mem mantém cada observação até a última chamada de ferramenta.
O hook Stop produz algo diferente: um resumo em nível de sessão com campos como request, investigated, learned, completed e next_steps. Eles dão ao Claude um mapa geral do que aconteceu sem precisar carregar cada observação individual.
Armazenar milhares de observações é uma coisa. Carregar as certas na janela de contexto sem torrar tokens é outra.
A abordagem ingênua é despejar contexto histórico no prompt. A documentação do claude-mem traz números: um carregamento ingênuo típico envia 35.000 tokens para a janela de contexto, dos quais uns 2.000 são realmente relevantes. Uma taxa de sinal de 6%.
Um sistema de recuperação em três camadas eleva isso para mais de 80% ao permitir que o Claude carregue o contexto de forma progressiva via claude-mem:
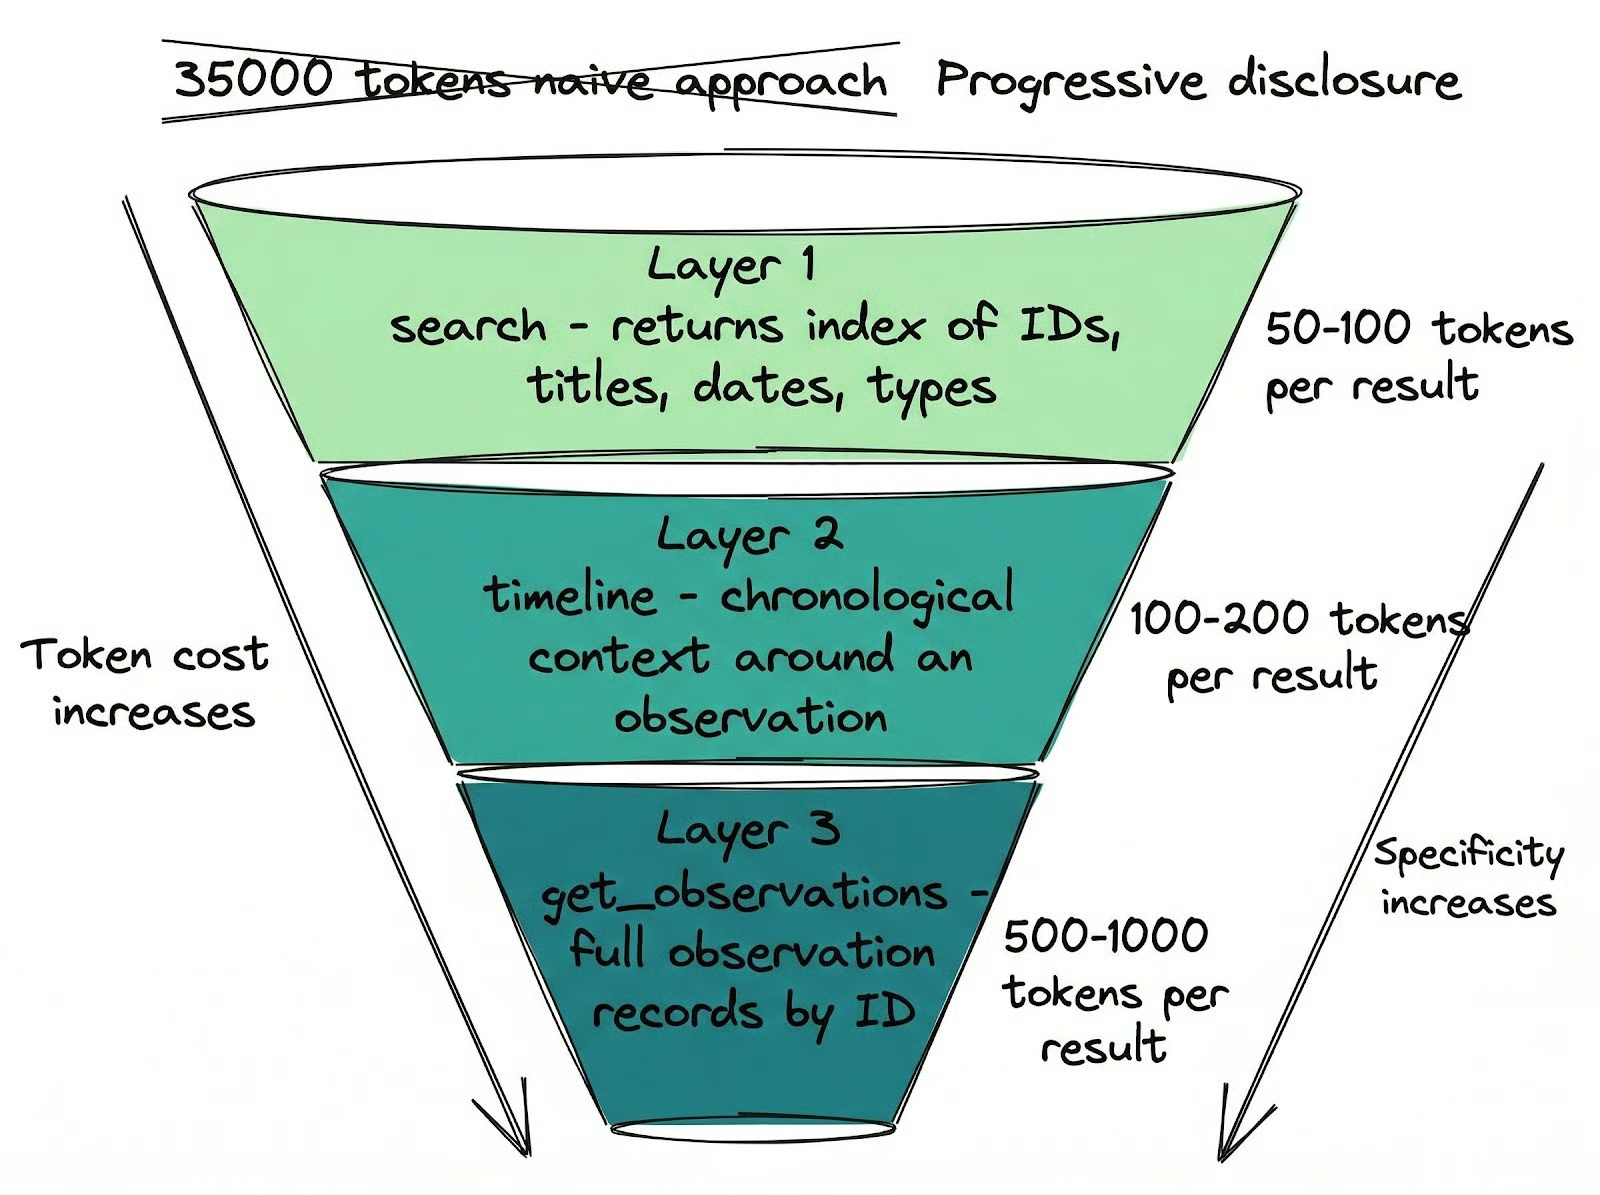
get_observations busca registros completos por ID em lotes. Custo: 500–1.000 tokens por resultado. Traga só o que realmente precisa.Essa disciplina de recuperação não se impõe sozinha.
O claude-mem registra uma ferramenta MCP literalmente chamada __IMPORTANT cuja única função é lembrar o Claude de seguir esse padrão em três etapas.
Sem ela, o Claude pula as camadas baratas e busca tudo em nível de detalhe máximo, jogando fora toda a arquitetura. O fato de precisarem adicionar uma ferramenta nomeada só para impor disciplina de recuperação dá uma noção realista de como o sistema precisou ser desenhado em torno do comportamento real do Claude.
Essas ferramentas de recuperação não são usadas só no início da sessão.
Durante a sessão, quando você pergunta algo ao Claude sobre trabalhos anteriores, ele pesquisa a memória diretamente.
Você pode pedir para analisar seus padrões de trabalho entre sessões, achar detalhes que você esqueceu ("onde salvei aquela chave de API?", "como implementamos o fluxo de auth?") ou retomar um projeto que você não toca há semanas.
Quando você alterna entre várias bases de código e sessões, os detalhes escapam da sua própria memória mais rápido do que parece. O claude-mem cobre essa lacuna dando ao Claude acesso a tudo que aconteceu, até o que você mesmo já esqueceu.
Depois de três semanas, 61% das minhas observações estão como discovery. O Claude captura principalmente o que aprende sobre a base de código, e não só as mudanças que faz.
Ao longo de 259 sessões, tenho 1.729 resumos de sessão, em média 6–7 por sessão. Essa continuidade entre sessões só é possível porque a captura roda continuamente, não apenas no final.
Essa é a diferença entre resumir uma sessão e realmente lembrar dela.
Todas as configurações do claude-mem ficam acessíveis pela interface web em http://localhost:37777, na aba Settings. Você também pode defini-las via variáveis de ambiente ou editar ~/.claude-mem/settings.json diretamente.
A primeira configuração importante é CLAUDE_MEM_MODEL, que controla qual modelo faz a compressão. O padrão é haiku, que já é a opção mais barata da linha de modelos do Claude.
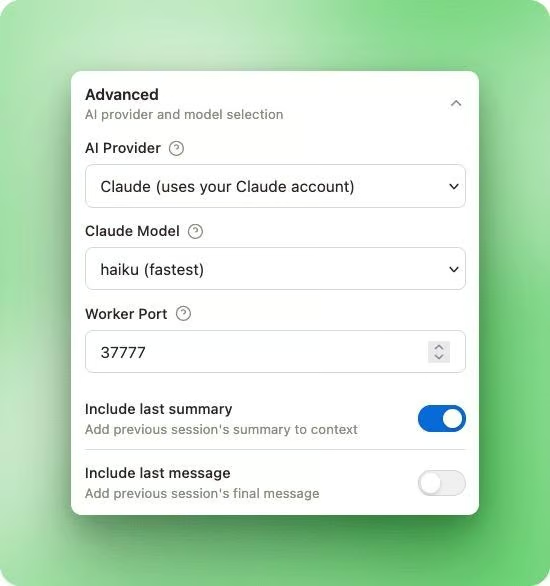
Você também pode trocar totalmente o provedor de compressão com CLAUDE_MEM_PROVIDER, que aceita claude, gemini ou openrouter.
Rodar a compressão no Gemini Flash Lite ou em um modelo gratuito do OpenRouter como xiaomi/mimo-v2-flash:free zera o custo adicional além da sua assinatura do Claude Code.
Eu rodo no haiku com 30 observações por sessão. Com cerca de 400 tokens de entrada e 150 de saída por compressão, dá algo como 16.500 tokens por sessão. Nas tarifas do haiku, um mês de uso intenso sai muito abaixo de um dólar.
Depois de três semanas em dez projetos, a qualidade da compressão não tem sido um problema.
Duas configurações controlam quanto contexto é carregado no início da sessão:
CLAUDE_MEM_CONTEXT_OBSERVATIONS: total de observações injetadas em SessionStart (padrão 50, faixa 1–200)CLAUDE_MEM_CONTEXT_FULL_COUNT: quantas delas aparecem com detalhe expandido com o campo narrative completo (padrão 5, faixa 0–20)O restante exibe só título, tipo e data. Toda a injeção de contexto é limitada ao diretório do projeto em que você está trabalhando, então observações de outros projetos não poluem seu contexto.
Você pode pré-visualizar exatamente o que será injetado e ajustar essas quantidades por projeto pela interface web.
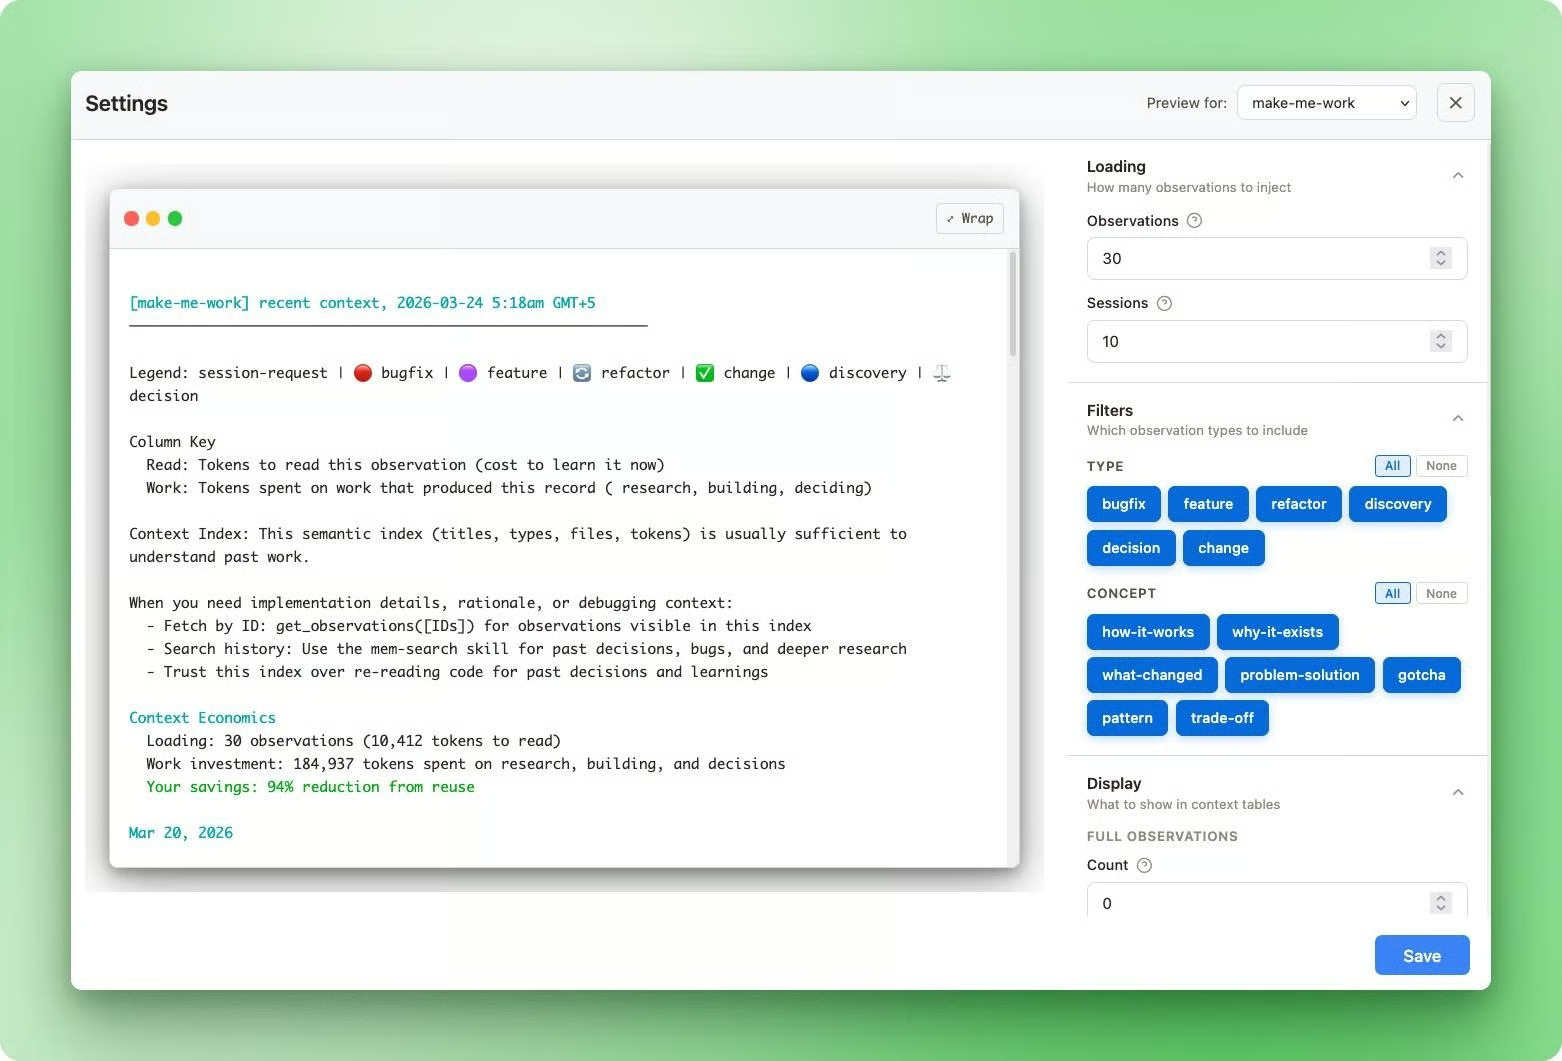
Algo para esperar: na primeira semana em um projeto novo, sua janela de contexto pode encher mais rápido que o usual.
Eu quase desinstalei o claude-mem nesse começo porque as sessões batiam no limite de contexto mais cedo do que antes.
O que acontecia era o claude-mem aprendendo o projeto do zero, registrando um volume alto de novas observações que eram todas injetadas no início da sessão.
Depois de cerca de uma semana, o volume de descobertas novas caiu porque o Claude já tinha mapeado a base de código, e as sessões passaram a durar mais do que antes de eu instalar o plugin.
Se você sentir esse overhead inicial, reduza CLAUDE_MEM_CONTEXT_OBSERVATIONS temporariamente e aumente de novo quando o período de aprendizado estabilizar.
CLAUDE_MEM_SKIP_TOOLS permite excluir ferramentas específicas da captura.
Os padrões já ignoram ferramentas muito ruidosas como TodoWrite, AskUserQuestion e BashTool. Provavelmente você não vai mexer nisso a menos que tenha uma ferramenta customizada gerando saída que não quer armazenar. É uma lista separada por vírgulas, então adicionar ferramentas é simples.
Se você trabalha com chaves de API ou credenciais, envolva-as com tags <private> dentro dos seus prompts para excluir esse conteúdo do armazenamento.
O claude-mem remove tudo que estiver dentro dessas tags antes de criar a observação.
Ele não varre conteúdos de arquivo proativamente, então variáveis de ambiente carregadas do disco não correm risco, mas qualquer coisa que você colar diretamente em um prompt, sim. A tag <private> é uma proteção opt-in: você precisa lembrar de usá-la.
O Claude Code já vem com recursos de memória, mas nenhum deles captura contexto automaticamente.
CLAUDE.md são arquivos markdown estáticos carregados no início da sessão, úteis para regras e preferências do projeto, mas limitados a cerca de 200 linhas antes que a aderência caia. Sem busca, sem recuperação. Você escreve as instruções uma vez e torce para o Claude segui-las.
O Auto Memory, adicionado no Claude Code v2.1.59, deixa o próprio Claude decidir o que salvar entre sessões. Ele guarda anotações não estruturadas em ~/.claude/projects/<project>/memory/ e carrega as primeiras 200 linhas de um arquivo MEMORY.md na inicialização.
Na prática, o que é salvo nem sempre é o que você gostaria, e não há como buscar ou filtrar depois. Você acaba com um arquivo de texto com decisões às quais o Claude pode ou não dar atenção.
O comando /compact fecha o conjunto nativo ao resumir sua conversa para liberar espaço de contexto. Arquivos CLAUDE.md sobrevivem porque são relidos do disco, mas todo o resto desaparece: instruções conversacionais, contexto de meio de sessão, qualquer coisa que você disse mas não registrou em algum lugar.
O claude-mem cobre a lacuna que nenhum dos anteriores resolve: captura contínua automática com compressão estruturada e recuperação consciente de tokens. E não é o único plugin que faz esse trabalho.
|
Ferramenta |
Arquitetura |
Armazenamento |
Busca |
Momento da captura |
Preço |
Entre máquinas |
Memória de time |
|
Claude nativo |
Nativo |
Markdown local |
Nenhuma |
Manual |
Grátis |
Via git sync |
Via CLAUDE.md compartilhado |
|
claude-mem |
Plugin (hooks) |
SQLite local + FTS5 |
Palavra-chave FTS5 |
Por chamada de ferramenta |
Grátis |
Não |
Não |
|
memsearch |
Plugin (hooks + skill) |
Markdown local + Milvus |
Híbrido denso + BM25 |
Fim da sessão |
Grátis |
Não |
Não |
|
supermemory |
Plugin (hooks + nuvem) |
Nuvem |
Semântica + temporal |
Fim da sessão |
Pago |
Sim |
Sim |
|
mem0 (self-hosted) |
Servidor MCP |
Qdrant local + Ollama |
Vetor semântico |
Fim da sessão |
Grátis |
Não |
Não |
memsearch é a alternativa gratuita mais próxima se você quiser arquivos markdown em vez de um banco e não quer um processo em background rodando. Ele faz a recuperação em um subagente isolado, então os resultados de busca não se misturam com a sua janela de contexto principal. Use se preferir uma configuração mais simples e não precisar de captura por chamada.
supermemory é a pedida certa se você precisa de sincronização entre máquinas e memória compartilhada do time, embora exija assinatura paga.
A stack self-hosted do mem0 segue outro caminho: Qdrant e Neo4j para rastreamento de entidades baseado em grafo, zero custo extra, mas uma configuração mais pesada — só vale se você já roda essa infraestrutura.
O claude-mem fica no meio. Totalmente local, grátis, captura por chamada com compressão estruturada. O trade-off é um worker em background na porta 37777 e algumas arestas ainda por aparar.
A parte de segurança é a maior preocupação.
Uma auditoria comunitária em fevereiro de 2026 classificou o risco como ALTO, e os issues seguem em aberto.
A API HTTP na porta 37777 não tem autenticação: qualquer processo na sua máquina pode ler todas as observações armazenadas, ver suas configurações (incluindo chaves de API em texto claro) e injetar memórias arbitrárias no banco.
O binding padrão do host era 0.0.0.0 em vez de 127.0.0.1, o que, em VMs na nuvem ou máquinas sem firewall, expõe a API na rede.
As ferramentas smart_unfold e smart_outline também têm vulnerabilidade de path traversal sem checagem de limites de diretório.
Rode isso somente em máquina pessoal de desenvolvimento.
A confiabilidade também tem algumas arestas.
A integração com ChromaDB tem um vazamento conhecido de subprocessos: um usuário rastreou 184 processos órfãos em 19 horas, consumindo cerca de 16 GB de RAM.
A causa raiz foi um modelo ONNX corrompido acionando loops de retry infinitos. Fique com o FTS5 (o mecanismo de busca full-text nativo do SQLite), que funciona sem o ChromaDB e tem sido confiável na minha experiência.
No macOS com Apple Silicon, o cold start do worker pode exceder o timeout fixo de 5 segundos quando o ChromaDB está ativado, fazendo o hook SessionStart falhar. Isso não afeta setups só com FTS5. Há também um bug ativo em que as ferramentas MCP search e timeline têm schemas de parâmetro vazios, então o Claude não consegue passar queries para elas. get_observations funciona bem.
Nada disso é impeditivo para desenvolvimento local em máquina pessoal. Mas vale saber antes de instalar algo que tem acesso a todo o histórico das suas sessões.
Três semanas depois, o principal que eu percebo é o que eu deixei de fazer. Não reexplico a estrutura do projeto no início de cada sessão. Não refaço o caminho de debug que já percorremos. O Claude já chega com contexto e a gente começa de onde parou.
A arquitetura torna isso possível de um jeito que abordagens mais simples não conseguem. Capturar só no fim da sessão significa perder tudo se a sessão cair. Despejar histórico sem camadas de recuperação significa gastar tokens com ruído. As escolhas de design aqui são intencionais — saber disso ajuda você a ajustar a ferramenta, e não apenas confiar cegamente.
As lacunas de segurança acima são reais e continuam abertas. Vale a pena rodar em máquina pessoal de desenvolvimento. Não vale rodar em VM na nuvem ou máquina compartilhada até corrigirem esses pontos. Mas, para desenvolvimento local solo, os trade-offs são administráveis.
Se quiser se aprofundar, o curso da DataCamp Introduction to Claude é um ótimo ponto de partida para entender como o Claude Code funciona antes de adicionar plugins por cima.
Principais cursos da DataCamp
Curso
Curso
Curso
Tutorial
Abid Ali Awan
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Dimitri Didmanidze
9 min
Tutorial
Moez Ali
12 min
Tutorial
Matt Crabtree
6 min
Tutorial
Zoumana Keita
8 min