Databricks 命令行界面(CLI)是一款功能强大的工具,可让用户直接从终端或命令提示符在 Databricks 平台上自动化执行任务。借助 CLI,用户无需通过图形界面导航即可执行管理集群、作业和笔记本的命令,从而提升效率,并更好地融入自动化工作流。
截至目前,Databricks CLI 0.205 及以上版本处于公开预览阶段。使用旧版本的用户请注意,旧版本被视为遗留版本,可能不支持新版本中的最新功能或改进。
在本教程中,我将向您演示如何安装 CLI,以及如何通过主要命令来在 CLI 中进行导航以自动化您的工作流。开始之前,我强烈建议您查看 DataCamp 的《如何学习 Databricks:统一数据平台初学者指南》博文,帮助您了解 Databricks 的核心功能与应用,并为您的学习提供系统的路径。
为什么使用 Databricks CLI
作为一名常用用户,我认为以下原因足以说明您应当使用 Databricks CLI:
- 自动化:CLI 允许您编写脚本来执行诸如创建集群、提交作业和管理笔记本等操作。这种自动化能够节省时间并降低出错概率。例如,您可以通过一条命令创建并运行作业。
- 集成:Databricks CLI 可与 DevOps 流水线和 CI/CD 流程无缝集成。借助此功能,您可以轻松配置环境,实现 Databricks 工作流的自动部署与更新,无需人工干预。例如,您可以直接从 Jenkins、GitHub Actions 或 Azure DevOps 等工具触发自动化作业。
- 简洁:您可以直接在本地机器上执行任务,无需为日常事务频繁切换到 Web 界面。通过运行命令上传笔记本或管理集群,而不必依赖图形界面,从而更轻松地管理工作流。
- 灵活:Databricks CLI 支持多种操作系统与环境,如 Windows、macOS 和 Linux,便于不同团队使用。CLI 还支持多配置文件的身份验证,助您高效管理多个 Databricks 帐户或工作区。
安装与更新 Databricks CLI
开始使用 Databricks CLI 之前,您需要满足环境先决条件,并按照您的操作系统的特定说明进行安装。我将演示如何在 Linux、macOS 和 Windows 上进行环境设置与 CLI 更新。
环境先决条件
安装 Databricks CLI 之前,请确保您的系统满足以下基本要求:
- 包管理器:虽然使用 Homebrew(适用于 macOS)或 WinGet(适用于 Windows)等包管理器可简化安装,但您也可以直接通过二进制文件或源代码进行安装。
- Python:CLI 需要 Python 3.6 或更高版本。
- 对 Databricks 工作区的网络访问。
- Curl:在 Linux 和 macOS 的某些安装方法中,请确保已安装 curl。
- 管理员权限(适用于部分安装方法)。
在 Linux 上安装
在 Linux 上安装 Databricks CLI 有多种方式,包括以下方法:
使用 Homebrew
如果已安装 Homebrew,运行:
brew install databricks-cli技术支持
使用 curl
您可以通过运行以下命令,使用 curl 下载并安装 Databricks CLI:
curl -Lo databricks-cli.tar.gz https://github.com/databricks/databricks-cli/releases/latest/download/databricks-cli.tar.gz
tar -xzf databricks-cli.tar.gz -C /usr/local/bin技术支持
手动下载
或者,您可以从官方 Databricks CLI GitHub 仓库下载 CLI 二进制文件,并将其移动到您的 PATH 中的某个目录。
在 macOS 上安装
如果您使用 macOS,可以通过以下命令安装 Databricks CLI。
使用 Homebrew
运行下方命令安装 Databricks CLI:
brew install databricks-cli技术支持
直接安装二进制文件
从 GitHub 发布页下载最新二进制文件,解压后放入本地 PATH。使用下方命令赋予可执行权限:
chmod +x /usr/local/bin/databricks技术支持
手动下载
同样地,您可以从官方 Databricks CLI GitHub 仓库下载 CLI 二进制文件,并将其移动到您的 PATH 中的某个目录。
在 Windows 上安装
如果您使用 Windows 操作系统,可以通过以下方法之一安装 Databricks CLI:
使用 WinGet
在命令提示符中运行以下命令:
winget install Databricks.DatabricksCLI技术支持
使用 Chocolatey
如果已安装 Chocolatey,使用:
choco install databricks-cli技术支持
使用 Windows Subsystem for Linux(WSL)
如果已设置 WSL,请参考 Linux 的安装步骤。
直接安装二进制文件
从 Databricks CLI GitHub 仓库下载 .exe 文件。
将包含该文件的目录添加到系统的 PATH,以便于访问。
验证安装
安装完成后,您应验证 Databricks CLI 是否正确安装。打开终端或命令提示符并运行:
databricks --version技术支持
Databricks CLI 的身份验证与配置
要有效使用 Databricks CLI,您需要与 Databricks 工作区完成身份验证。本节将介绍如何设置身份验证并管理配置。
生成个人访问令牌
需要个人访问令牌(PAT)来与 Databricks CLI 进行身份验证。按照以下步骤生成:
步骤 1:进入用户设置
登录您的 Databricks 工作区,点击顶部栏中的用户名。在下拉菜单中选择 Settings。
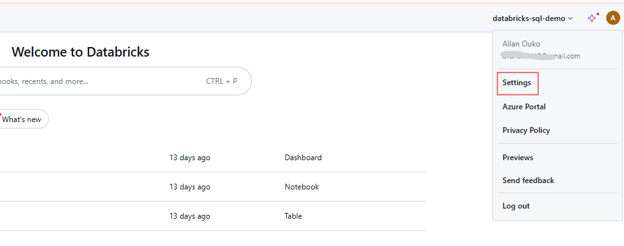
Databricks 工作区用户设置。图片由作者提供。
步骤 2:前往开发者设置
点击 Developer。
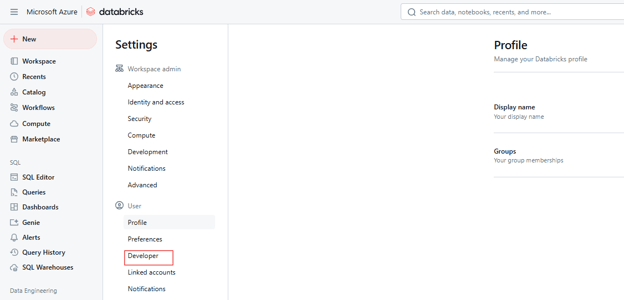
Databricks Developer 设置。图片由作者提供。
步骤 3:管理访问令牌
在 Access tokens 旁,点击 Manage。
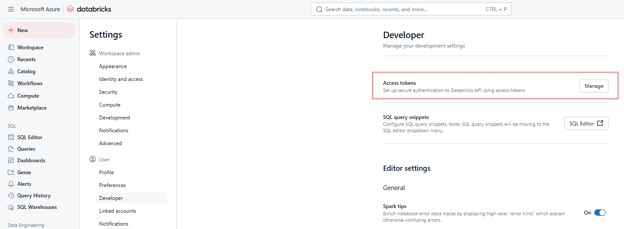
Databricks 访问令牌。图片由作者提供
步骤 4:生成新令牌
点击 Generate new token。
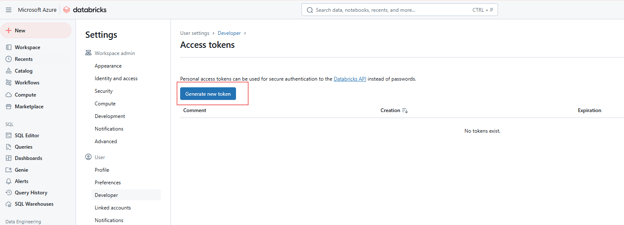
生成新的 Databricks 访问令牌。图片由作者提供。
步骤 5:输入详情并保存令牌
提供用于标识令牌的备注,并设置令牌的有效期(天)。若留空,默认为最大有效期(通常为 730 天)。点击 Generate,安全复制令牌,然后点击 Done。
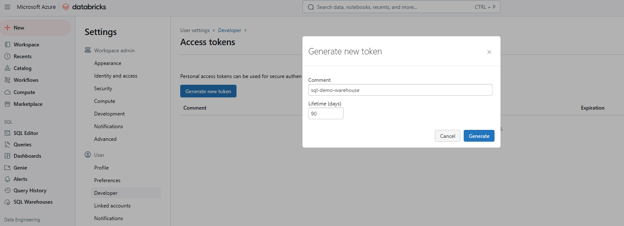
生成新的 Databricks 访问令牌。图片由作者提供。
配置配置文件
获得令牌后,配置 CLI 与您的工作区通信。该过程需要设置包含您的工作区 URL 和令牌的配置文件。
基础配置
运行以下命令设置默认配置文件:
databricks configure --token技术支持
系统会提示您输入:
Databricks 主机 URL(例如:https://<databricks-instance>.cloud.databricks.com)。
之前生成的个人访问令牌。
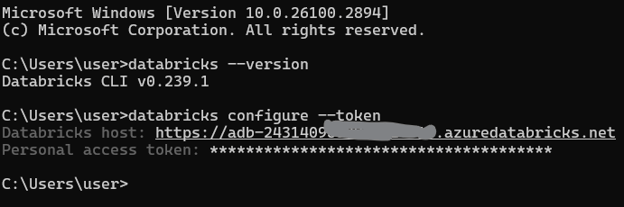
配置 Databricks CLI 配置文件。图片由作者提供。
多个配置文件
您可以为不同环境(例如开发、预生产、生产)配置多个配置文件:
databricks configure --profile <profile-name> --token技术支持
要使用特定配置文件,请在 CLI 命令中加入 --profile 标志:
databricks clusters list --profile staging技术支持
高级身份验证
Databricks CLI 支持 Databricks 统一身份验证,与企业身份管理系统(如单点登录 SSO 和 OAuth)集成。这为所有 Databricks API 提供安全且可扩展的身份验证。统一身份验证通过为多个工作区启用单一 SSO 配置来简化用户管理,使您更易于管理访问权限,并使用服务主体来自动化任务。
主要的 Databricks CLI 命令
Databricks CLI 将功能划分为高层类别,并为各类任务提供相应的子命令。以下是主要类别的拆解与实用示例,帮助您快速上手。如果您需要回顾 Databricks 的主要特性,建议查看我们的教程《数据从业者必备的 7 个概念》。
Clusters(集群)
clusters 命令用于管理 Databricks 集群,包括创建、列出、启动和删除。常见子命令包括:
-
create:创建新集群。
-
list:列出工作区内所有集群。
-
start 与 delete:启动或删除集群。
例如,下列命令将创建一个名为 my-cluster 的新集群,包含 4 个 Standard_D2_v2 类型的工作节点。
databricks clusters create --cluster-name my-cluster --node-type-id Standard_D2_v2 --num-workers 4技术支持
您也可以使用以下命令列出 Databricks 工作区中的所有集群。
databricks clusters list技术支持
Jobs(作业)
此类命令用于管理 Databricks 作业,包括创建、运行和列出。常见子命令包括:
-
create:创建新作业。
-
run-now:立即触发现有作业。
-
list:列出所有可用作业。
例如,您可以创建一个名为 my-job 的新作业来运行笔记本任务。
databricks jobs create --job-name my-job --notebook-task /path/to/notebook技术支持
您也可以使用如下命令,通过作业 ID 触发现有作业。
databricks jobs run-now --job-id 12345技术支持
Workspace(工作区)
此类命令用于管理工作区资源,如导入与导出笔记本。常见子命令包括:
-
import:导入笔记本或库。
-
export:将笔记本导出至本地机器。
-
list:列出工作区目录的内容。
例如,您可以使用下列命令将笔记本导出为本地文件。
databricks workspace export /Users/username/notebook /local/path/notebook.py技术支持
同样,您可以使用以下命令导入笔记本。
databricks workspace import /local/path/notebook.py /Users/username/notebook技术支持
文件系统(DBFS)
此类命令用于与 Databricks 文件系统(DBFS)交互,包括上传和下载文件。常见子命令包括:
-
cp:在本地与 DBFS 之间复制文件。
-
ls:列出 DBFS 目录中的文件。
-
rm:从 DBFS 中删除文件或目录。
例如,您可以使用以下命令将本地文件上传至 DBFS。
databricks fs cp /local/path/file.txt dbfs:/path/in/dbfs/技术支持
同理,可使用以下命令将 DBFS 中的文件下载到本地路径。
databricks fs cp dbfs:/path/in/dbfs/file.txt /local/path/技术支持
Repos(代码仓库)
repos 命令用于管理 Databricks 内的代码仓库,实现版本控制。常见子命令包括:
-
list:列出所有仓库。
-
create:添加新仓库。
例如,下列命令将列出工作区中的所有 Databricks Repos。
databricks repos list技术支持
权限
您可以使用这些命令为工作区、作业和集群设置与管理权限。常见权限子命令包括:
例如,下列命令可查看某个资源的权限。
databricks permissions get --type cluster --id 12345技术支持
Databricks SQL 命令
这些命令可让您与 Databricks SQL 交互,以查询数据库并管理 SQL 仓库。
以下查询将从 sales_table 中获取并显示前 10 行。
databricks sql query 技术支持
如果您需要回顾 Databricks SQL 的相关知识,建议阅读我们的Databricks SQL 教程,了解如何使用 SQL 从 Databricks SQL Warehouse 查询数据。
常见用例与示例场景
Databricks CLI 为自动化日常任务提供了切实可行的方案。下面通过详细示例展示其多样化的应用场景。
创建或编辑集群
要创建集群,可使用 JSON 配置文件(如 cluster-config.json)来指定集群设置。
{
  "cluster_name": "example-cluster",
  "spark_version": "11.3.x-scala2.12",
  "node_type_id": "Standard_DS3_v2",
  "num_workers": 2
}技术支持
然后运行以下命令创建集群:
databricks clusters create --json-file cluster-config.json技术支持
若需更新现有集群的配置,首先使用下列命令导出当前集群设置:
databricks clusters get --cluster-id <cluster-id> > cluster-config.json技术支持
接着,根据需要编辑 cluster-config.json 文件,并将更改应用到集群。
databricks clusters edit --json-file cluster-config.json技术支持
管理笔记本
在某些场景中,您可能需要将笔记本从 Databricks 导出至本地目录,然后再导入回去。使用以下命令导出笔记本:
databricks workspace export /path/to/notebook.ipynb /local/path/notebook.ipynb技术支持
以下命令用于将笔记本上传回 Databricks。
databricks workspace import /local/path/notebook.ipynb /path/to/notebook.ipynb技术支持
触发作业
在创建自动化任务时,您可能需要新建一个运行笔记本或脚本的作业,并将其设定为每日运行。首先,使用 JSON 文件(如 job-config.json)定义一个运行特定笔记本的作业。
{
  "name": "example-job",
  "new_cluster": {
    "spark_version": "11.3.x-scala2.12",
    "node_type_id": "Standard_DS3_v2",
    "num_workers": 1
  },
  "notebook_task": {
    "notebook_path": "/Users/username/my-notebook"
  },
  "schedule": {
    "quartz_cron_expression": "0 0 * * * ?",
    "timezone_id": "UTC"
  }
}技术支持
使用以下命令创建作业:
databricks jobs create --json-file job-config.json技术支持
然后可通过作业 ID 运行该作业。
databricks jobs run-now --job-id <job-id>技术支持
在 DBFS 上进行文件操作
若需在 DBFS 中列出、复制或删除文件,请使用以下命令。
查看目录中的文件:
databricks fs ls dbfs:/path/to/directory技术支持
将本地文件上传至 DBFS:
databricks fs cp /local/path/file.txt dbfs:/path/to/remote-file.txt技术支持
删除文件或目录:
databricks fs rm dbfs:/path/to/file.txt技术支持
最佳实践与技巧
为最大化 Databricks CLI 的效率、安全性与可靠性,建议遵循以下最佳实践:
- 保持版本最新:请确保使用 0.200 或更高版本的 Databricks CLI,以获得持续的功能更新与新特性支持。旧版本属于遗留版本,可能不支持最新功能。
- 安全:避免以明文存储个人访问令牌。请使用环境变量或加密文件、机密管理工具等安全存储方式。
- 脚本化:使用 Bash 或 Python 脚本将多个 CLI 命令串联起来以自动化任务。该方法能简化复杂工作流并提升可复现性。
- 日志/调试:使用 --debug 标志启用详细输出以便调试。这有助于通过更详尽的错误信息来诊断问题。
databricks --debug clusters create --cluster-name my-cluster --node-type-id Standard_D2_v2 --num-workers 4技术支持
将 Databricks CLI 与其他方式对比
在使用 Databricks 时,用户可以通过多种方式与平台交互,包括 Databricks CLI、REST API、Databricks Python SDK 和 Web 界面。根据用户或组织的具体需求与偏好,各方式各有优劣。
REST API
Databricks REST API 提供对 Databricks 功能的直接、底层访问,为与语言无关的集成提供最大灵活性。
Databricks Python SDK
Databricks Python SDK 提供 Python 风格的交互接口,在 REST API 之上提供更高层次的抽象。
Web 界面
Databricks Web 界面提供交互式图形界面,用于管理集群、作业、笔记本等。
我将在下表中概述上述方法的优势、劣势与最佳使用场景:
| Approach | Strengths | Weaknesses | Best Use |
|---|
| Databricks CLI | Simple, scriptable, OS-agnostic automation | Limited to supported CLI commands | Lightweight automation and repetitive tasks |
| REST APIs | Flexible, language-agnostic | Complex, requires more effort to implement | Custom integrations and cutting-edge features |
| Python SDK | Python-friendly, high-level abstractions | Adds dependencies, requires Python skills | Python-heavy workflows and data pipelines |
| Web UI | User-friendly, no setup required | Not scalable for automation | Interactive, one-off, or exploratory tasks |
故障排除与已知问题
在使用 Databricks CLI 时,您可能会遇到一些常见错误与挑战。下面汇总了高发问题与可行的解决方案,并提供诊断网络相关问题的建议。
常见错误
使用 Databricks CLI 时的常见错误包括:
- 授权失败:可能由个人访问令牌错误或过期引起。请确保令牌有效并在 CLI 设置中正确配置。如有需要,请生成新令牌。
- 在 PATH 中找不到 CLI:当 Databricks CLI 可执行文件不在系统 PATH 中时会发生此错误。请将包含 CLI 可执行文件的目录添加到系统的 PATH 环境变量。
- 令牌过期:令牌具有有限的有效期,会在设定时间后过期。请定期续订令牌,或设置自动刷新令牌的机制以避免问题。
诊断网络问题
在网络受限或启用 IP 允许列表的环境中,您可能会遇到连接 Databricks 的问题。以下步骤可帮助诊断与解决:
-
检查网络配置:确保网络允许向 Databricks 工作区 URL 发起出站连接。确认防火墙或代理服务器配置正确。
-
IP 允许列表:如果工作区启用 IP 允许列表,请确保您的 IP 地址已被加入。可使用 curl 等工具从您的机器测试到 Databricks API 的连通性。
-
SSL 校验:如遇到 SSL 校验错误,可尝试在 curl 中暂时使用 -k 选项禁用 SSL 校验,以便定位问题。
结语与延伸资源
希望本文已让您认同:练习使用 Databricks CLI 非常值得。正如您所见,Databricks CLI 能够快速、可脚本化地自动执行集群管理、作业触发和文件操作等任务,减少对 Web 界面的依赖,从而节省时间。它的灵活性以及与 DevOps 流水线的集成能力也给我留下了深刻印象。
本文难免无法覆盖所有细节,如需查找特定问题的答案,请参考Databricks 官方文档或 CLI 的GitHub 页面。若您想进一步掌握重要的基础概念,建议学习我们的《Databricks 入门》课程。本课程将带您了解将 Databricks 用作商业智能的数据仓库解决方案。同时,如果您正打算系统学习 Databricks,也推荐阅读我们的《Databricks 认证指南》,以便在学习的同时更好地提升您的职场竞争力。


Databricks 命令行界面(CLI)是一款功能强大的工具,可让用户直接从终端或命令提示符在 Databricks 平台上自动化执行任务。借助 CLI,用户无需通过图形界面导航即可执行管理集群、作业和笔记本的命令,从而提升效率,并更好地融入自动化工作流。
截至目前,Databricks CLI 0.205 及以上版本处于公开预览阶段。使用旧版本的用户请注意,旧版本被视为遗留版本,可能不支持新版本中的最新功能或改进。
在本教程中,我将向您演示如何安装 CLI,以及如何通过主要命令来在 CLI 中进行导航以自动化您的工作流。开始之前,我强烈建议您查看 DataCamp 的《如何学习 Databricks:统一数据平台初学者指南》博文,帮助您了解 Databricks 的核心功能与应用,并为您的学习提供系统的路径。
为什么使用 Databricks CLI
作为一名常用用户,我认为以下原因足以说明您应当使用 Databricks CLI:
安装与更新 Databricks CLI
开始使用 Databricks CLI 之前,您需要满足环境先决条件,并按照您的操作系统的特定说明进行安装。我将演示如何在 Linux、macOS 和 Windows 上进行环境设置与 CLI 更新。
环境先决条件
安装 Databricks CLI 之前,请确保您的系统满足以下基本要求:
在 Linux 上安装
在 Linux 上安装 Databricks CLI 有多种方式,包括以下方法:
使用 Homebrew
如果已安装 Homebrew,运行:
使用 curl
您可以通过运行以下命令,使用 curl 下载并安装 Databricks CLI:
手动下载
或者,您可以从官方 Databricks CLI GitHub 仓库下载 CLI 二进制文件,并将其移动到您的
PATH中的某个目录。在 macOS 上安装
如果您使用 macOS,可以通过以下命令安装 Databricks CLI。
使用 Homebrew
运行下方命令安装 Databricks CLI:
直接安装二进制文件
从 GitHub 发布页下载最新二进制文件,解压后放入本地
PATH。使用下方命令赋予可执行权限:手动下载
同样地,您可以从官方 Databricks CLI GitHub 仓库下载 CLI 二进制文件,并将其移动到您的
PATH中的某个目录。在 Windows 上安装
如果您使用 Windows 操作系统,可以通过以下方法之一安装 Databricks CLI:
使用 WinGet
在命令提示符中运行以下命令:
使用 Chocolatey
如果已安装 Chocolatey,使用:
使用 Windows Subsystem for Linux(WSL)
如果已设置 WSL,请参考 Linux 的安装步骤。
直接安装二进制文件
从 Databricks CLI GitHub 仓库下载
.exe文件。将包含该文件的目录添加到系统的
PATH,以便于访问。验证安装
安装完成后,您应验证 Databricks CLI 是否正确安装。打开终端或命令提示符并运行:
Databricks CLI 的身份验证与配置
要有效使用 Databricks CLI,您需要与 Databricks 工作区完成身份验证。本节将介绍如何设置身份验证并管理配置。
生成个人访问令牌
需要个人访问令牌(PAT)来与 Databricks CLI 进行身份验证。按照以下步骤生成:
步骤 1:进入用户设置
登录您的 Databricks 工作区,点击顶部栏中的用户名。在下拉菜单中选择 Settings。
Databricks 工作区用户设置。图片由作者提供。
步骤 2:前往开发者设置
点击 Developer。
Databricks Developer 设置。图片由作者提供。
步骤 3:管理访问令牌
在 Access tokens 旁,点击 Manage。
Databricks 访问令牌。图片由作者提供
步骤 4:生成新令牌
点击 Generate new token。
生成新的 Databricks 访问令牌。图片由作者提供。
步骤 5:输入详情并保存令牌
提供用于标识令牌的备注,并设置令牌的有效期(天)。若留空,默认为最大有效期(通常为 730 天)。点击 Generate,安全复制令牌,然后点击 Done。
生成新的 Databricks 访问令牌。图片由作者提供。
配置配置文件
获得令牌后,配置 CLI 与您的工作区通信。该过程需要设置包含您的工作区 URL 和令牌的配置文件。
基础配置
运行以下命令设置默认配置文件:
系统会提示您输入:
Databricks 主机 URL(例如:https://<databricks-instance>.cloud.databricks.com)。
之前生成的个人访问令牌。
配置 Databricks CLI 配置文件。图片由作者提供。
多个配置文件
您可以为不同环境(例如开发、预生产、生产)配置多个配置文件:
要使用特定配置文件,请在 CLI 命令中加入
--profile标志:高级身份验证
Databricks CLI 支持 Databricks 统一身份验证,与企业身份管理系统(如单点登录 SSO 和 OAuth)集成。这为所有 Databricks API 提供安全且可扩展的身份验证。统一身份验证通过为多个工作区启用单一 SSO 配置来简化用户管理,使您更易于管理访问权限,并使用服务主体来自动化任务。
主要的 Databricks CLI 命令
Databricks CLI 将功能划分为高层类别,并为各类任务提供相应的子命令。以下是主要类别的拆解与实用示例,帮助您快速上手。如果您需要回顾 Databricks 的主要特性,建议查看我们的教程《数据从业者必备的 7 个概念》。
Clusters(集群)
clusters 命令用于管理 Databricks 集群,包括创建、列出、启动和删除。常见子命令包括:
create:创建新集群。list:列出工作区内所有集群。start与delete:启动或删除集群。例如,下列命令将创建一个名为
my-cluster的新集群,包含 4 个Standard_D2_v2类型的工作节点。您也可以使用以下命令列出 Databricks 工作区中的所有集群。
Jobs(作业)
此类命令用于管理 Databricks 作业,包括创建、运行和列出。常见子命令包括:
create:创建新作业。run-now:立即触发现有作业。list:列出所有可用作业。例如,您可以创建一个名为
my-job的新作业来运行笔记本任务。您也可以使用如下命令,通过作业 ID 触发现有作业。
Workspace(工作区)
此类命令用于管理工作区资源,如导入与导出笔记本。常见子命令包括:
import:导入笔记本或库。export:将笔记本导出至本地机器。list:列出工作区目录的内容。例如,您可以使用下列命令将笔记本导出为本地文件。
同样,您可以使用以下命令导入笔记本。
文件系统(DBFS)
此类命令用于与 Databricks 文件系统(DBFS)交互,包括上传和下载文件。常见子命令包括:
cp:在本地与 DBFS 之间复制文件。ls:列出 DBFS 目录中的文件。rm:从 DBFS 中删除文件或目录。例如,您可以使用以下命令将本地文件上传至 DBFS。
同理,可使用以下命令将 DBFS 中的文件下载到本地路径。
Repos(代码仓库)
repos 命令用于管理 Databricks 内的代码仓库,实现版本控制。常见子命令包括:
list:列出所有仓库。create:添加新仓库。例如,下列命令将列出工作区中的所有 Databricks Repos。
权限
您可以使用这些命令为工作区、作业和集群设置与管理权限。常见权限子命令包括:
get:查看当前权限。update:修改权限。例如,下列命令可查看某个资源的权限。
Databricks SQL 命令
这些命令可让您与 Databricks SQL 交互,以查询数据库并管理 SQL 仓库。
以下查询将从
sales_table中获取并显示前 10 行。如果您需要回顾 Databricks SQL 的相关知识,建议阅读我们的Databricks SQL 教程,了解如何使用 SQL 从 Databricks SQL Warehouse 查询数据。
常见用例与示例场景
Databricks CLI 为自动化日常任务提供了切实可行的方案。下面通过详细示例展示其多样化的应用场景。
创建或编辑集群
要创建集群,可使用 JSON 配置文件(如
cluster-config.json)来指定集群设置。然后运行以下命令创建集群:
若需更新现有集群的配置,首先使用下列命令导出当前集群设置:
接着,根据需要编辑
cluster-config.json文件,并将更改应用到集群。管理笔记本
在某些场景中,您可能需要将笔记本从 Databricks 导出至本地目录,然后再导入回去。使用以下命令导出笔记本:
以下命令用于将笔记本上传回 Databricks。
触发作业
在创建自动化任务时,您可能需要新建一个运行笔记本或脚本的作业,并将其设定为每日运行。首先,使用 JSON 文件(如
job-config.json)定义一个运行特定笔记本的作业。使用以下命令创建作业:
然后可通过作业 ID 运行该作业。
在 DBFS 上进行文件操作
若需在 DBFS 中列出、复制或删除文件,请使用以下命令。
查看目录中的文件:
将本地文件上传至 DBFS:
删除文件或目录:
最佳实践与技巧
为最大化 Databricks CLI 的效率、安全性与可靠性,建议遵循以下最佳实践:
将 Databricks CLI 与其他方式对比
在使用 Databricks 时,用户可以通过多种方式与平台交互,包括 Databricks CLI、REST API、Databricks Python SDK 和 Web 界面。根据用户或组织的具体需求与偏好,各方式各有优劣。
REST API
Databricks REST API 提供对 Databricks 功能的直接、底层访问,为与语言无关的集成提供最大灵活性。
Databricks Python SDK
Databricks Python SDK 提供 Python 风格的交互接口,在 REST API 之上提供更高层次的抽象。
Web 界面
Databricks Web 界面提供交互式图形界面,用于管理集群、作业、笔记本等。
我将在下表中概述上述方法的优势、劣势与最佳使用场景:
故障排除与已知问题
在使用 Databricks CLI 时,您可能会遇到一些常见错误与挑战。下面汇总了高发问题与可行的解决方案,并提供诊断网络相关问题的建议。
常见错误
使用 Databricks CLI 时的常见错误包括:
诊断网络问题
在网络受限或启用 IP 允许列表的环境中,您可能会遇到连接 Databricks 的问题。以下步骤可帮助诊断与解决:
检查网络配置:确保网络允许向 Databricks 工作区 URL 发起出站连接。确认防火墙或代理服务器配置正确。
IP 允许列表:如果工作区启用 IP 允许列表,请确保您的 IP 地址已被加入。可使用
curl等工具从您的机器测试到 Databricks API 的连通性。SSL 校验:如遇到 SSL 校验错误,可尝试在 curl 中暂时使用 -k 选项禁用 SSL 校验,以便定位问题。
结语与延伸资源
希望本文已让您认同:练习使用 Databricks CLI 非常值得。正如您所见,Databricks CLI 能够快速、可脚本化地自动执行集群管理、作业触发和文件操作等任务,减少对 Web 界面的依赖,从而节省时间。它的灵活性以及与 DevOps 流水线的集成能力也给我留下了深刻印象。
本文难免无法覆盖所有细节,如需查找特定问题的答案,请参考Databricks 官方文档或 CLI 的GitHub 页面。若您想进一步掌握重要的基础概念,建议学习我们的《Databricks 入门》课程。本课程将带您了解将 Databricks 用作商业智能的数据仓库解决方案。同时,如果您正打算系统学习 Databricks,也推荐阅读我们的《Databricks 认证指南》,以便在学习的同时更好地提升您的职场竞争力。