Databricks SQL 是专为 Databricks Lakehouse 平台中的数据管理与分析而设计的强大工具。该平台将数据工程、数据科学与商业分析整合为统一体验。因此,Databricks SQL 对于希望简化数据工作流、查询执行与 BI 任务、且无需传统基础设施管理复杂度的数据专业人士至关重要。
在本文中,我将介绍 Databricks SQL 的组件、特性与工具,并通过实际示例展示如何创建与使用 Databricks SQL 仓库。开始之前,我强烈建议您学习 DataCamp 的Introduction to Databricks课程,了解如何将 Databricks 作为商业智能(BI)的数据仓库解决方案,利用面向 SQL 优化的能力编写查询并分析数据。
Databricks SQL 是什么?
Databricks SQL 是 Databricks Lakehouse 平台中的一款稳健分析工具,使数据专业人士能够运行 SQL 查询、分析数据并创建交互式仪表板。Databricks SQL 采用无服务器架构设计,将数据湖的灵活性与数据仓库的治理与性能能力相结合。
Databricks SQL 的关键组件包括 SQL Warehouses、SQL Editors 和 SQL Dashboards。如果您对这些还不熟悉也不用担心,下面我会逐一解释它们的含义。
Databricks SQL 与 SQL Server 等的对比
与 MySQL、PostgreSQL 或 SQL Server 等面向事务型数据库的 SQL 方言不同,Databricks SQL 针对 Lakehouse 环境中的大规模分析进行了优化。传统 SQL 数据库专注于结构化数据存储,而 Databricks SQL 则在保留数据仓库性能的同时,与数据湖集成。借助无服务器 SQL 仓库,您无需管理基础设施,资源会自动配置并弹性扩展。
另外需要说明的是,在 Databricks SQL 中,查询执行更快,因为其由支持向量化处理的 Photon 引擎加速。最后要说的是:Databricks SQL 面向 BI 与协作构建;它原生支持 Power BI、Tableau 与 Looker。
Databricks SQL 的核心组件
Databricks SQL 的核心组件促进高效查询、数据可视化与用户间协作。以下是 Databricks SQL 中主要工具与功能的概览。
SQL Warehouses
SQL Warehouses 是在 Databricks SQL 中执行 SQL 查询的计算资源。它们旨在处理不同的工作负载,并根据所选仓库类型提供性能优化。主要有三种类型的 SQL Warehouses:
- Classic:支持基础功能,适合入门级性能需求。它使用您云账户中的现有计算层,但不具备智能工作负载管理(IWM)与预测 IO 等高级功能。
- Pro:Pro SQL Warehouses 通过支持 Photon(加速 SQL 操作的向量化查询引擎)提供更强性能,并改进安全选项。
- Serverless 通过自动配置资源、弹性扩展并确保低延迟查询执行,消除基础设施管理。非常适合工作负载波动的环境,且具备高性价比的性能。
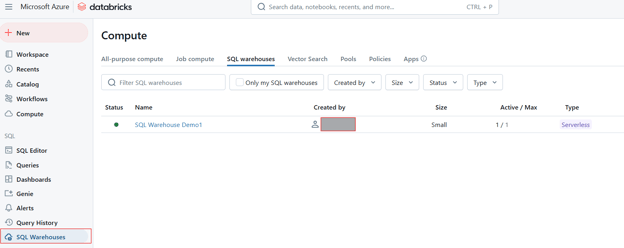
Databricks SQL 中的 SQL Warehouse。作者供图。
SQL Editor
SQL Editor 是一个用户友好的界面,使用户能够编写、执行和管理 SQL 查询。其主要功能包括:
- 直观查询:支持语法高亮、自动补全与错误检测,高效编写查询。
- 数据预览:用户可在编辑器内直接预览数据,便于在执行复杂查询前理解数据集。
- 查询结果缓存:通过缓存先前查询结果提升性能,让重复查询响应更快。
- 参数化查询:通过引入参数创建动态查询,便于以不同取值运行相似查询。
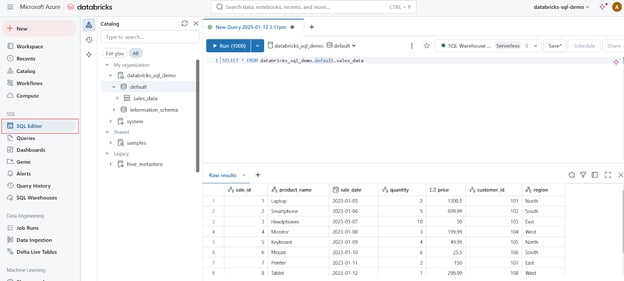
Databricks SQL 中的 SQL Editor。作者供图。
Dashboards
仪表板通过将查询结果转换为交互式图表、图形和小部件来实现数据可视化。仪表板非常适合监控关键指标,并在整个组织内高效传达洞察。其关键能力包括:
- 实时分析:根据实时查询结果自动刷新仪表板。
- 协作:跨团队共享仪表板,推动数据驱动决策。
- 自定义:从多种可视化类型与布局选项中选择,以满足特定需求。
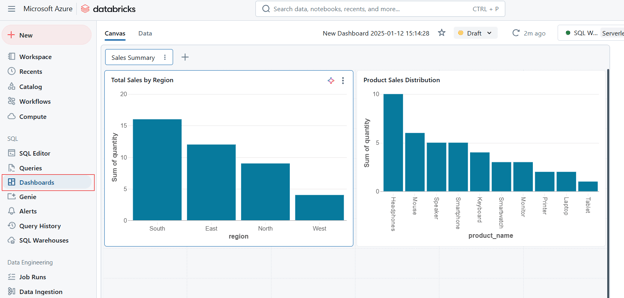
Databricks SQL 中的仪表板。作者供图。
Alerts
Databricks SQL 中的警报用于监控数据变化,并在满足指定条件时触发通知。警报对于维护数据质量、及时响应重要变化至关重要。其工作方式如下:
- 设置条件:基于查询结果定义阈值或规则。
- 触发通知:当条件满足时,通过电子邮件、Slack 或其他集成接收警报。
- 主动监控:实时掌握关键事件,如数据异常或系统问题。
查询历史与分析
最后需要说明的是,Databricks SQL 提供用于跟踪查询历史与分析的工具:
- 查询历史:该功能允许用户回顾先前执行的查询,提供其随时间推移的性能洞察,有助于识别趋势或反复出现的问题。
- 查询分析:查询分析工具会评估已执行查询的效率,突出瓶颈并提出优化建议。此能力对于提升整体查询性能与资源利用率非常重要。
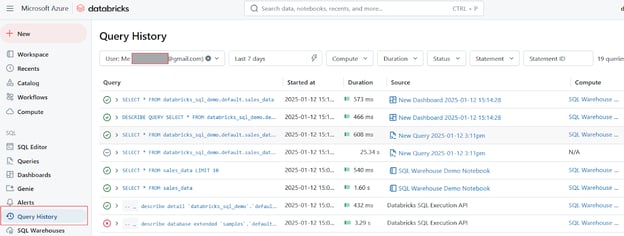
Databricks SQL 中的查询历史。作者供图。
Databricks SQL 的关键功能与工具
Databricks SQL 集成了丰富的高级功能与工具,旨在增强性能、简化工作流,并实现与其他工具的无缝集成。下面我们看看有哪些关键要素使 Databricks SQL 成为出色之选。
Photon 引擎
Photon 引擎是 Databricks 开发的高性能向量化查询引擎,可显著加速 SQL 查询执行。其主要优势包括:
- 向量化执行:不同于传统的逐行处理,Photon 采用批量处理的数据向量化执行方式,能够利用 SIMD(单指令多数据)等高级 CPU 指令以提高效率。
- 与现有工作负载集成:Photon 与 Apache Spark API 完全兼容,用户无需修改现有代码即可启用。此类无缝集成使组织无需大量返工即可获得性能提升。
- 缓存与优化:引擎内置高级查询优化器与缓存层,可智能选择缓存数据,进一步提升查询性能。
CloudFetch 与异步 I/O
CloudFetch 与异步 I/O 旨在提升数据传输速度,并在查询执行期间改进小文件处理。其工作方式如下:
- CloudFetch:通过允许在所有计算节点上并行写入优化将结果写回云存储的方式。它显著减少将大型数据集回传给客户端所需时间,在真实场景中可实现高达 10 倍的性能提升。
- 异步 I/O:通过在处理当前数据块的同时并行读取多个数据块,增强小文件处理能力。在处理小文件(如 1MB)时,可将整体查询性能提升至多 12 倍。对于包含大量小文件或未缓存的“冷数据”的场景尤为有效。
与 BI 工具集成
Databricks SQL 可与主流商业智能(BI)工具无缝集成,便于团队分析与可视化数据。支持的集成包括:
- Power BI:用户可将 Databricks 工作区直接连接至 Power BI,轻松同步数据模型。例如,分析师可直接从 Databricks 发布报告到 Power BI,并保持表之间已定义的关系,无需手动处理。
- Tableau:用户可利用实时连接来可视化存储在 Databricks SQL 中的数据,实现实时分析与反映最新数据更新的交互式仪表板。
- dbt:Databricks SQL 也可与 dbt(data build tool)集成,使团队能够在 Databricks 环境中直接管理转换。此集成支持增量模型与物化视图,简化构建与维护稳健数据管道的流程。
无服务器架构
Databricks SQL 的无服务器架构通过根据工作负载需求自动配置与扩展资源,免除手动管理基础设施的需要。无服务器架构会自动调整资源以处理不同的查询负载且不中断服务。这确保用户无需手动配置或维护集群。同时,无服务器架构也具备成本效率,用户仅为查询执行期间所使用的资源付费。
例如,一家零售公司在业务高峰时段会遇到高查询负载。无服务器架构会自动扩展资源以确保一致的性能,并在非高峰时段缩减资源以节省成本。
创建与使用 Databricks SQL Warehouses 的分步指南
Databricks SQL Warehouses 是在 Databricks 环境中高效执行 SQL 查询的关键。本节我将带您完成创建 SQL 仓库并结合笔记本使用的流程。如果您需要温习数据仓库相关知识,建议学习我们的Data Warehousing Concepts课程,掌握数据建模与数据转换的基础。
创建 Databricks SQL Warehouse
通过 Databricks Web 界面创建 SQL Warehouse 的步骤如下:
步骤 1:进入 Databricks SQL 页面
在 Databricks 工作区,从侧边栏点击SQL图标。
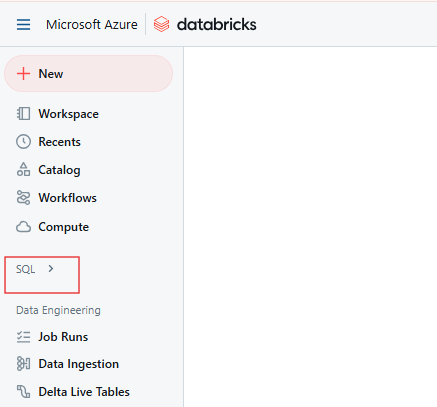
Databricks SQL 页面。作者供图。
步骤 2:打开 SQL Warehouses 选项卡
在 SQL 页面,进入SQL Warehouses选项卡。
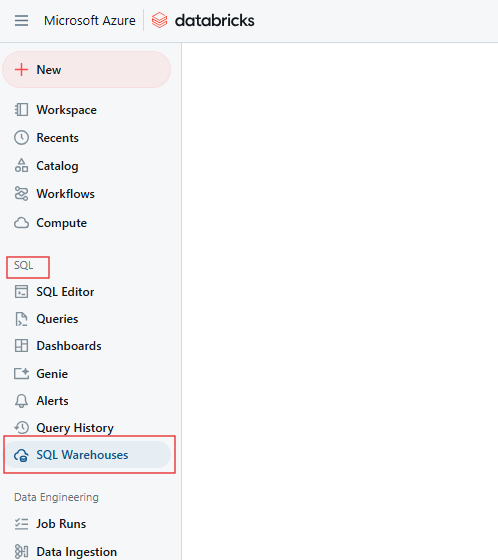
Databricks SQL Warehouse 选项卡。作者供图。
步骤 3:点击 "Create Warehouse"
点击Create Warehouse按钮,开始配置新的 SQL Warehouse。
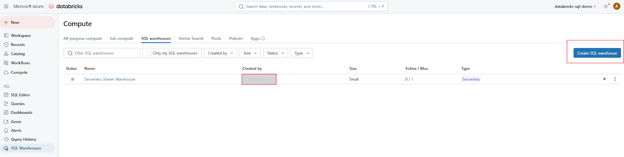
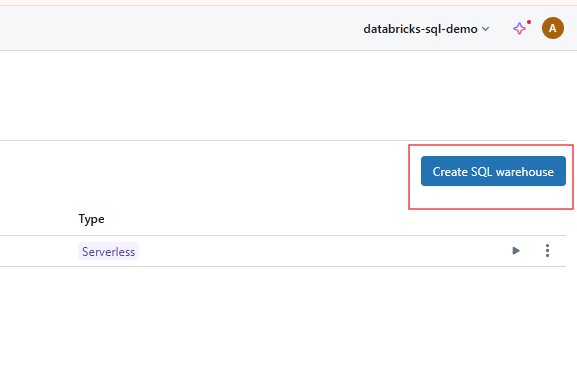
在 Databricks SQL 上创建 SQL Warehouse。作者供图。
步骤 4:配置基础设置
使用以下选项配置仓库设置:
- 名称:为您的 SQL Warehouse 提供唯一且清晰的名称。
- 集群大小:根据工作负载选择集群大小。不言而喻,更大的集群可以处理更多并发查询和更大的数据集。
- 自动停止:设置空闲超时时间,以便在不使用时自动停止仓库。对我而言,10 分钟似乎比较合理。通过在空闲时释放资源来节省成本。
- 伸缩:启用自动伸缩,根据查询负载动态调整资源。指定伸缩的最小与最大集群数。
- 无服务器选项:如果您的账户可用,选择无服务器 SQL Warehouse,以简化管理并实现自动扩展。
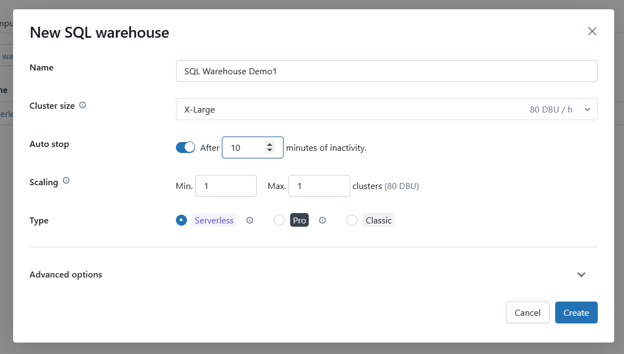
配置 Databricks SQL Warehouse 的基础设置。作者供图。
步骤 5:高级选项(可选)
如有需要,配置高级选项,例如启用 Photon 或设置特定 SQL 配置。
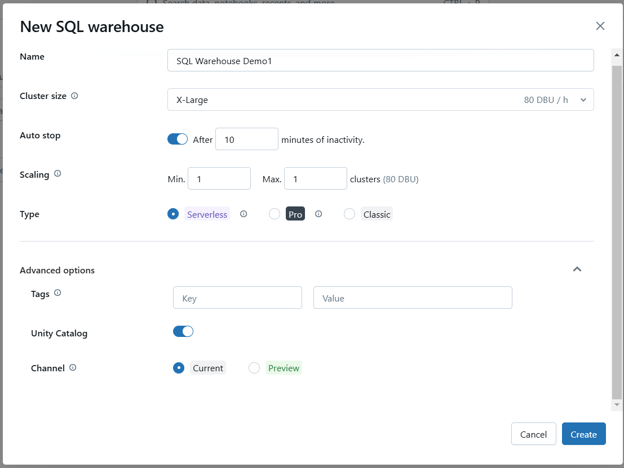
配置 Databricks SQL Warehouse 的高级设置。作者供图。
步骤 6:保存并启动仓库
点击Create保存配置。创建完成后,启动仓库以投入使用。
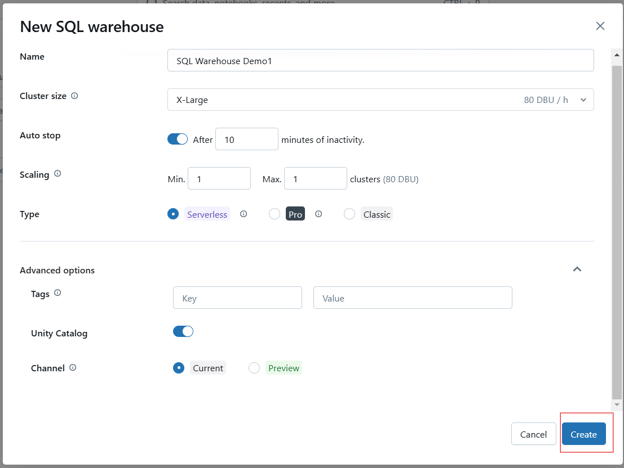
创建 Databricks SQL Warehouse。作者供图。
步骤 7:设置权限(可选)
创建后会弹出权限窗口,您可以在此为用户或用户组授予对仓库的访问权限。
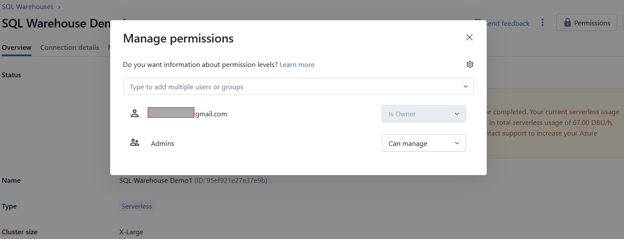
管理 Databricks SQL Warehouse 的权限。作者供图。
创建完成后,您的 SQL 仓库会自动启动,您可以立即执行查询。
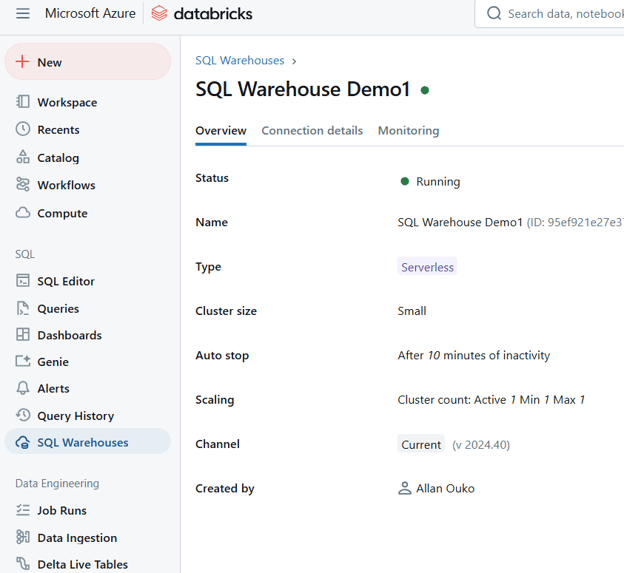
Databricks SQL Warehouse 示例。作者供图。
在 Databricks SQL Warehouse 中使用笔记本
要在笔记本中使用新建的 SQL 仓库执行 SQL 查询,请按以下步骤操作:
步骤 1:打开或创建笔记本
在Databricks工作区中创建新笔记本或打开现有笔记本。
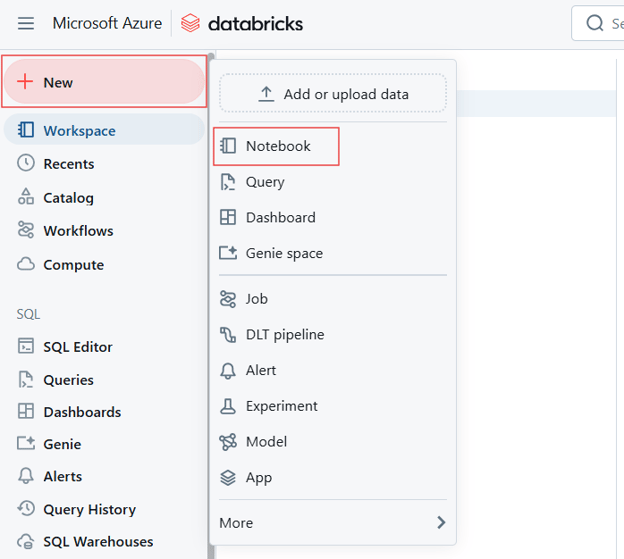
创建新笔记本以创建 Databricks SQL Warehouse。作者供图。
步骤 2:关联 SQL Warehouse
在笔记本工具栏中,找到计算选择器或连接(通常位于顶部)。点击打开下拉菜单以查看可用计算资源。从列表中选择您的 SQL 仓库。若未显示,点击More…以查看所有可用仓库。点击目标 SQL 仓库,然后选择Start and attach。
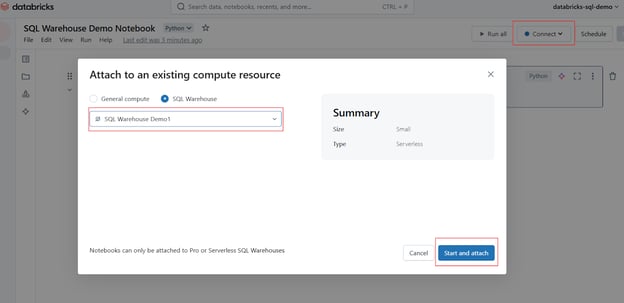
在 Databricks SQL Warehouse 中关联笔记本。作者供图。
步骤 3:编写 SQL 查询
关联后,您可以在笔记本中创建用于 SQL 查询的单元格。使用%sql魔法命令在笔记本中执行 SQL 查询。
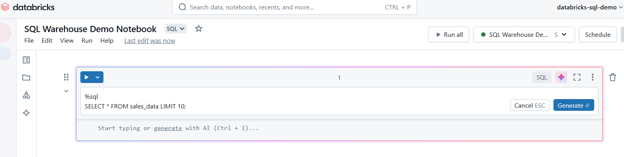
在 Databricks SQL Warehouse 中编写 SQL 查询。作者供图。
步骤 4:执行查询
运行单元格以执行查询。结果会直接显示在单元格下方,便于预览数据。
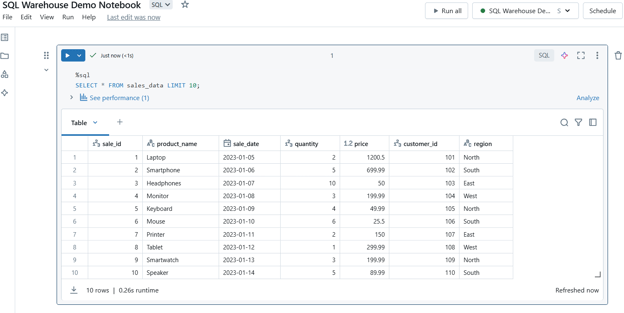
在 Databricks SQL Warehouse 中执行 SQL 查询。作者供图。
在 SQL Warehouse 中使用笔记本的注意事项
以下是在 SQL Warehouses 中使用笔记本时的一些注意事项:
-
查询限制:SQL Warehouses 针对分析型查询进行了优化,不适合频繁、低延迟的事务型查询。
-
数据预览:对于大型数据集,考虑限制查询结果,例如使用LIMIT子句,以避免性能瓶颈。
-
查询缓存:利用结果缓存加速重复查询。
-
资源使用:监控 SQL Warehouse 的使用率,确保集群大小与伸缩设置满足您的工作负载需求。
结语
Databricks SQL 是一款强大的平台,弥合了数据湖与数据仓库之间的鸿沟,为现代数据分析与商业智能提供统一解决方案。无论您是在构建仪表板、优化查询,还是通过警报监控数据,Databricks SQL 都能提供应对当今数据挑战所需的灵活性与性能。我鼓励您深入探索 Databricks SQL 的功能与能力,以提升数据工作流、促进协作,并推动更聪明、更快速的决策。
如果您希望成为专业数据工程师,我强烈建议学习我们的Understanding Data Engineering课程,了解数据工程师如何存储与处理数据以促进与数据科学家的协作。我还推荐我们的Data-Driven Decision-Making in SQL课程,学习如何用 SQL 支持基于真实项目的决策制定。当然,也别忘了浏览我们丰富的云课程。


Databricks SQL 是专为 Databricks Lakehouse 平台中的数据管理与分析而设计的强大工具。该平台将数据工程、数据科学与商业分析整合为统一体验。因此,Databricks SQL 对于希望简化数据工作流、查询执行与 BI 任务、且无需传统基础设施管理复杂度的数据专业人士至关重要。
在本文中,我将介绍 Databricks SQL 的组件、特性与工具,并通过实际示例展示如何创建与使用 Databricks SQL 仓库。开始之前,我强烈建议您学习 DataCamp 的Introduction to Databricks课程,了解如何将 Databricks 作为商业智能(BI)的数据仓库解决方案,利用面向 SQL 优化的能力编写查询并分析数据。
Databricks SQL 是什么?
Databricks SQL 是 Databricks Lakehouse 平台中的一款稳健分析工具,使数据专业人士能够运行 SQL 查询、分析数据并创建交互式仪表板。Databricks SQL 采用无服务器架构设计,将数据湖的灵活性与数据仓库的治理与性能能力相结合。
Databricks SQL 的关键组件包括 SQL Warehouses、SQL Editors 和 SQL Dashboards。如果您对这些还不熟悉也不用担心,下面我会逐一解释它们的含义。
Databricks SQL 与 SQL Server 等的对比
与 MySQL、PostgreSQL 或 SQL Server 等面向事务型数据库的 SQL 方言不同,Databricks SQL 针对 Lakehouse 环境中的大规模分析进行了优化。传统 SQL 数据库专注于结构化数据存储,而 Databricks SQL 则在保留数据仓库性能的同时,与数据湖集成。借助无服务器 SQL 仓库,您无需管理基础设施,资源会自动配置并弹性扩展。
另外需要说明的是,在 Databricks SQL 中,查询执行更快,因为其由支持向量化处理的 Photon 引擎加速。最后要说的是:Databricks SQL 面向 BI 与协作构建;它原生支持 Power BI、Tableau 与 Looker。
Databricks SQL 的核心组件
Databricks SQL 的核心组件促进高效查询、数据可视化与用户间协作。以下是 Databricks SQL 中主要工具与功能的概览。
SQL Warehouses
SQL Warehouses 是在 Databricks SQL 中执行 SQL 查询的计算资源。它们旨在处理不同的工作负载,并根据所选仓库类型提供性能优化。主要有三种类型的 SQL Warehouses:
Databricks SQL 中的 SQL Warehouse。作者供图。
SQL Editor
SQL Editor 是一个用户友好的界面,使用户能够编写、执行和管理 SQL 查询。其主要功能包括:
Databricks SQL 中的 SQL Editor。作者供图。
Dashboards
仪表板通过将查询结果转换为交互式图表、图形和小部件来实现数据可视化。仪表板非常适合监控关键指标,并在整个组织内高效传达洞察。其关键能力包括:
Databricks SQL 中的仪表板。作者供图。
Alerts
Databricks SQL 中的警报用于监控数据变化,并在满足指定条件时触发通知。警报对于维护数据质量、及时响应重要变化至关重要。其工作方式如下:
查询历史与分析
最后需要说明的是,Databricks SQL 提供用于跟踪查询历史与分析的工具:
Databricks SQL 中的查询历史。作者供图。
Databricks SQL 的关键功能与工具
Databricks SQL 集成了丰富的高级功能与工具,旨在增强性能、简化工作流,并实现与其他工具的无缝集成。下面我们看看有哪些关键要素使 Databricks SQL 成为出色之选。
Photon 引擎
Photon 引擎是 Databricks 开发的高性能向量化查询引擎,可显著加速 SQL 查询执行。其主要优势包括:
CloudFetch 与异步 I/O
CloudFetch 与异步 I/O 旨在提升数据传输速度,并在查询执行期间改进小文件处理。其工作方式如下:
与 BI 工具集成
Databricks SQL 可与主流商业智能(BI)工具无缝集成,便于团队分析与可视化数据。支持的集成包括:
无服务器架构
Databricks SQL 的无服务器架构通过根据工作负载需求自动配置与扩展资源,免除手动管理基础设施的需要。无服务器架构会自动调整资源以处理不同的查询负载且不中断服务。这确保用户无需手动配置或维护集群。同时,无服务器架构也具备成本效率,用户仅为查询执行期间所使用的资源付费。
例如,一家零售公司在业务高峰时段会遇到高查询负载。无服务器架构会自动扩展资源以确保一致的性能,并在非高峰时段缩减资源以节省成本。
创建与使用 Databricks SQL Warehouses 的分步指南
Databricks SQL Warehouses 是在 Databricks 环境中高效执行 SQL 查询的关键。本节我将带您完成创建 SQL 仓库并结合笔记本使用的流程。如果您需要温习数据仓库相关知识,建议学习我们的Data Warehousing Concepts课程,掌握数据建模与数据转换的基础。
创建 Databricks SQL Warehouse
通过 Databricks Web 界面创建 SQL Warehouse 的步骤如下:
步骤 1:进入 Databricks SQL 页面
在 Databricks 工作区,从侧边栏点击SQL图标。
Databricks SQL 页面。作者供图。
步骤 2:打开 SQL Warehouses 选项卡
在 SQL 页面,进入SQL Warehouses选项卡。
Databricks SQL Warehouse 选项卡。作者供图。
步骤 3:点击 "Create Warehouse"
点击Create Warehouse按钮,开始配置新的 SQL Warehouse。
在 Databricks SQL 上创建 SQL Warehouse。作者供图。
步骤 4:配置基础设置
使用以下选项配置仓库设置:
配置 Databricks SQL Warehouse 的基础设置。作者供图。
步骤 5:高级选项(可选)
如有需要,配置高级选项,例如启用 Photon 或设置特定 SQL 配置。
配置 Databricks SQL Warehouse 的高级设置。作者供图。
步骤 6:保存并启动仓库
点击Create保存配置。创建完成后,启动仓库以投入使用。
创建 Databricks SQL Warehouse。作者供图。
步骤 7:设置权限(可选)
创建后会弹出权限窗口,您可以在此为用户或用户组授予对仓库的访问权限。
管理 Databricks SQL Warehouse 的权限。作者供图。
创建完成后,您的 SQL 仓库会自动启动,您可以立即执行查询。
Databricks SQL Warehouse 示例。作者供图。
在 Databricks SQL Warehouse 中使用笔记本
要在笔记本中使用新建的 SQL 仓库执行 SQL 查询,请按以下步骤操作:
步骤 1:打开或创建笔记本
在Databricks工作区中创建新笔记本或打开现有笔记本。
创建新笔记本以创建 Databricks SQL Warehouse。作者供图。
步骤 2:关联 SQL Warehouse
在笔记本工具栏中,找到计算选择器或连接(通常位于顶部)。点击打开下拉菜单以查看可用计算资源。从列表中选择您的 SQL 仓库。若未显示,点击More…以查看所有可用仓库。点击目标 SQL 仓库,然后选择Start and attach。
在 Databricks SQL Warehouse 中关联笔记本。作者供图。
步骤 3:编写 SQL 查询
关联后,您可以在笔记本中创建用于 SQL 查询的单元格。使用
%sql魔法命令在笔记本中执行 SQL 查询。在 Databricks SQL Warehouse 中编写 SQL 查询。作者供图。
步骤 4:执行查询
运行单元格以执行查询。结果会直接显示在单元格下方,便于预览数据。
在 Databricks SQL Warehouse 中执行 SQL 查询。作者供图。
在 SQL Warehouse 中使用笔记本的注意事项
以下是在 SQL Warehouses 中使用笔记本时的一些注意事项:
查询限制:SQL Warehouses 针对分析型查询进行了优化,不适合频繁、低延迟的事务型查询。
数据预览:对于大型数据集,考虑限制查询结果,例如使用
LIMIT子句,以避免性能瓶颈。查询缓存:利用结果缓存加速重复查询。
资源使用:监控 SQL Warehouse 的使用率,确保集群大小与伸缩设置满足您的工作负载需求。
结语
Databricks SQL 是一款强大的平台,弥合了数据湖与数据仓库之间的鸿沟,为现代数据分析与商业智能提供统一解决方案。无论您是在构建仪表板、优化查询,还是通过警报监控数据,Databricks SQL 都能提供应对当今数据挑战所需的灵活性与性能。我鼓励您深入探索 Databricks SQL 的功能与能力,以提升数据工作流、促进协作,并推动更聪明、更快速的决策。
如果您希望成为专业数据工程师,我强烈建议学习我们的Understanding Data Engineering课程,了解数据工程师如何存储与处理数据以促进与数据科学家的协作。我还推荐我们的Data-Driven Decision-Making in SQL课程,学习如何用 SQL 支持基于真实项目的决策制定。当然,也别忘了浏览我们丰富的云课程。