dbt Cloud 已成为领先的托管式 数据转换服务,为现代分析团队提供可扩展、可靠且便于协作的工作流。
它扩展了 dbt Core 的能力,提供一个托管环境来自动化部署、编排作业、管理凭据,并为数据团队提供协作功能。
这使组织能够在安全、自动化且适合团队协作的环境中管理基于 SQL 的转换。
在本入门教程中,我们将介绍什么是 dbt Cloud、如何进行设置,以及一些使用示例。
如果您是该框架的新手,并且更喜欢结构化的学习路径,建议从我们的 dbt 入门课程开始。
什么是 dbt Cloud,它如何工作?
我们先来概览一下 dbt Cloud 及其功能。
dbt Cloud 概览
dbt Cloud 的核心是帮助团队采用 ELT(抽取、加载、转换)方法。不同于传统 ETL 在将数据加载至仓库前进行转换,dbt 在数据仓库内部完成转换,利用其计算能力与可扩展性。
来源:dbt
dbt Cloud 简化了数据转换流程,具体体现在:
- 提供使用 dbt 进行 SQL 转换的托管服务。
- 通过将转换移至仓库,融入现代数据管道。
- 通过共享的工作流与实践,标准化分析工程。
核心概念与工作流
dbt Cloud 与 dbt Core 具有相同的概念。
包括:
- 模型(Models):定义转换的 SQL 文件。
- 源(Sources):原始数据表的定义。
- 测试:对数据质量的断言。
- 文档:自动生成的血缘与模型文档。
- 暴露(Exposures):定义下游 BI 或报表依赖。
典型的 dbt Cloud 工作流如下:开发模型 > 测试转换 > 提交至 Git > 通过 dbt Cloud 作业部署 > 在 dbt Cloud 上监控运行。
设置您的 dbt Cloud 环境
为说明 dbt Cloud 的工作方式,我们通过一个实际示例来看看如何自行搭建环境。
dbt Cloud 上手很简单,旨在实现快速入门。以下是您需要执行的步骤:
创建并设置账户
- 注册 dbt Cloud,可获得入门套餐 14 天免费试用。
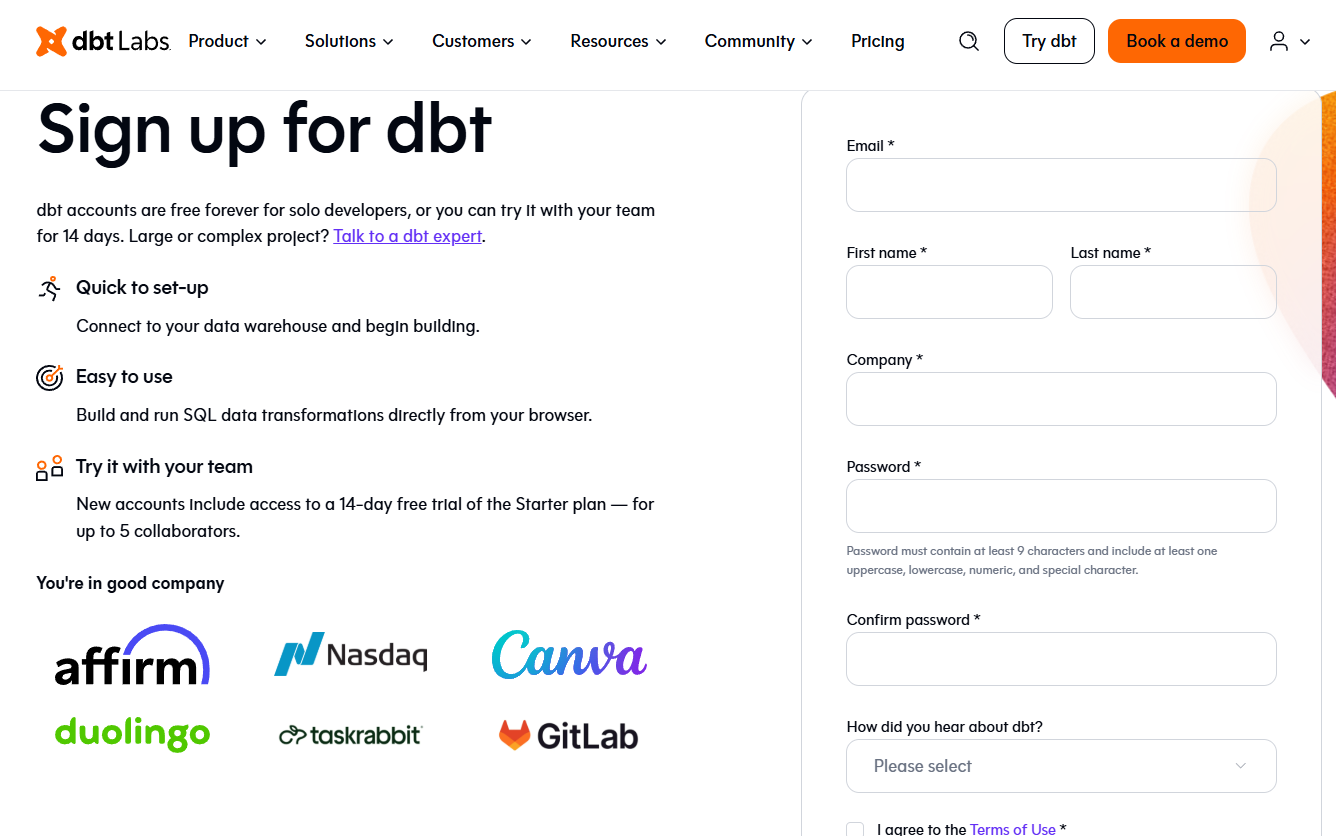
- 根据您对 dbt 的使用经验选择起始配置。
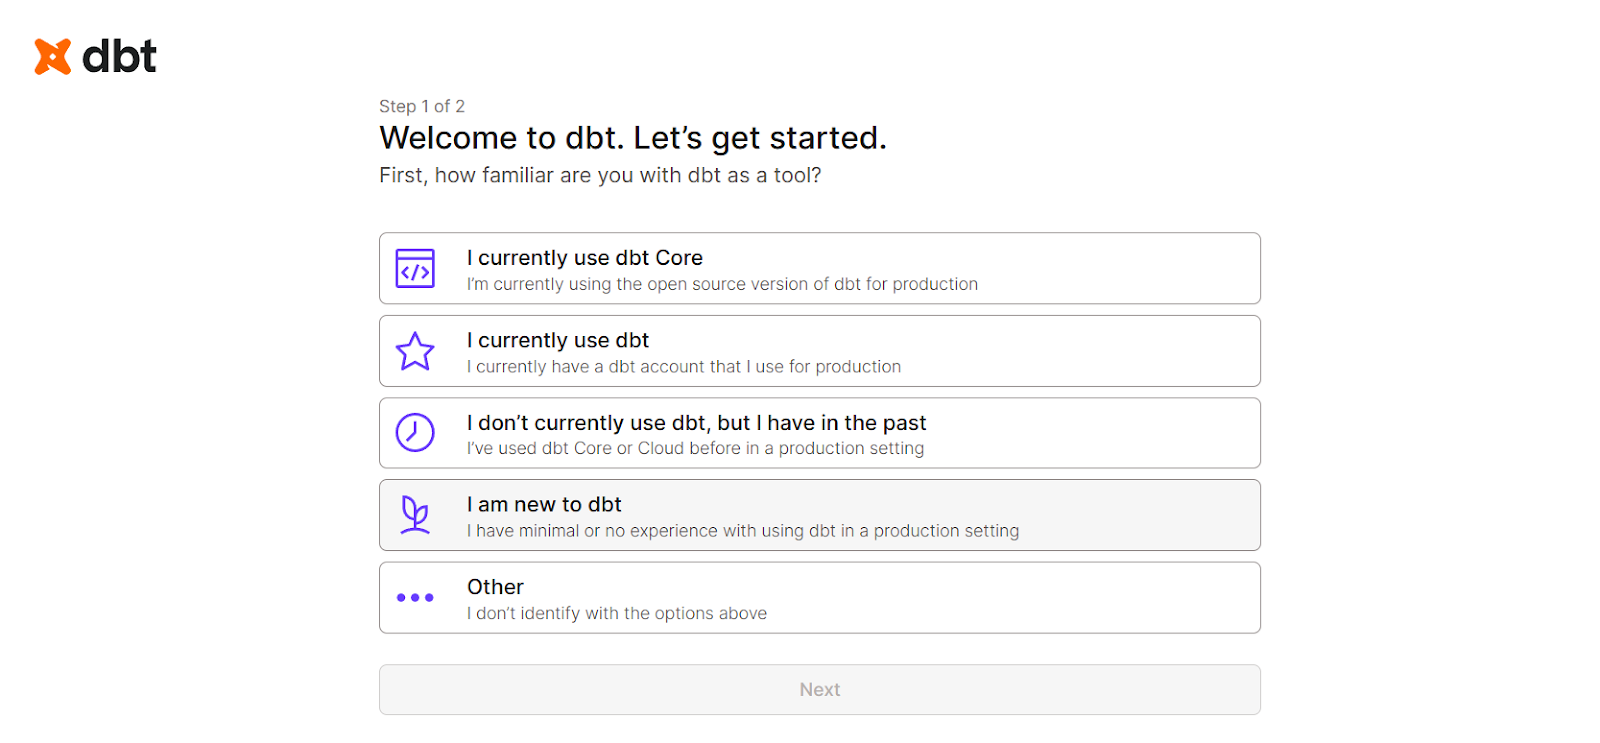
- 为您的项目命名,例如 dbt-Cloud-Analytics。
- 添加一个新连接。
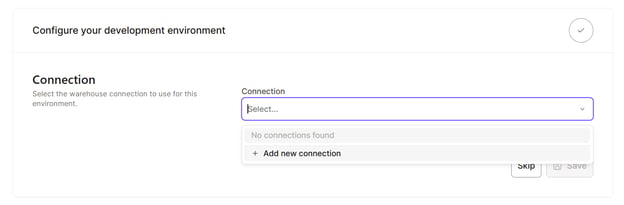
- 连接至您选择的数据仓库(如 Snowflake、BigQuery、PostgreSQL、Redshift 或 Databricks)。我将使用本地 PostgreSQL 数据库。
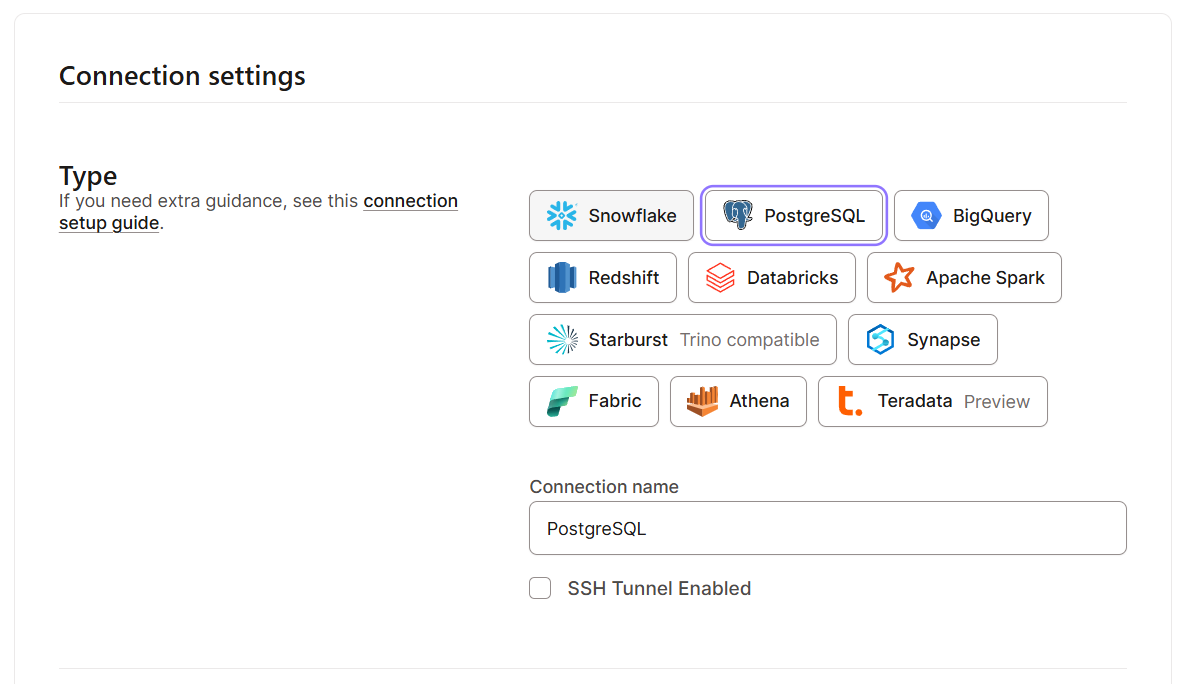
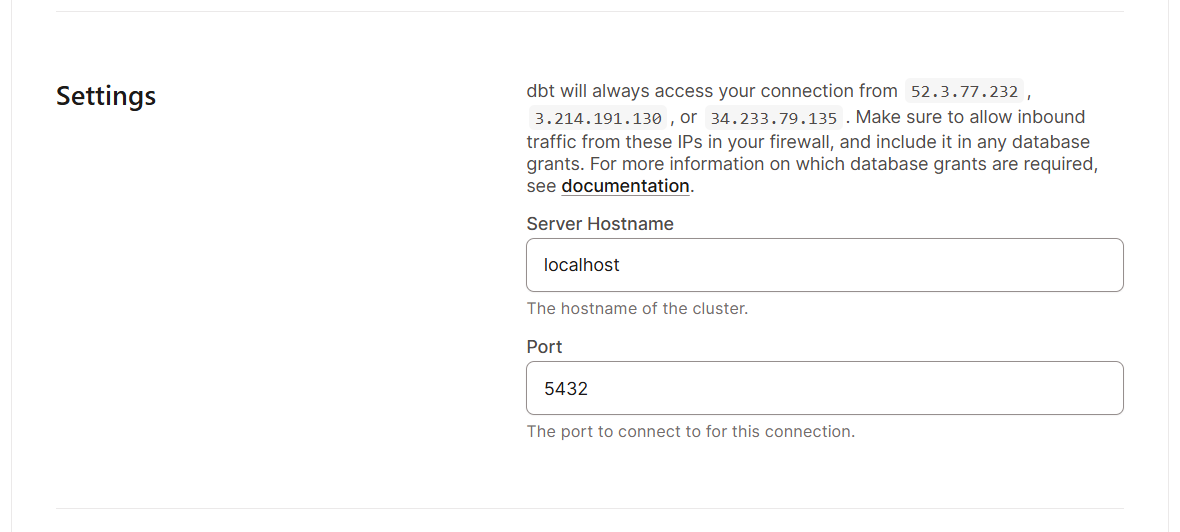
- 配置连接设置。
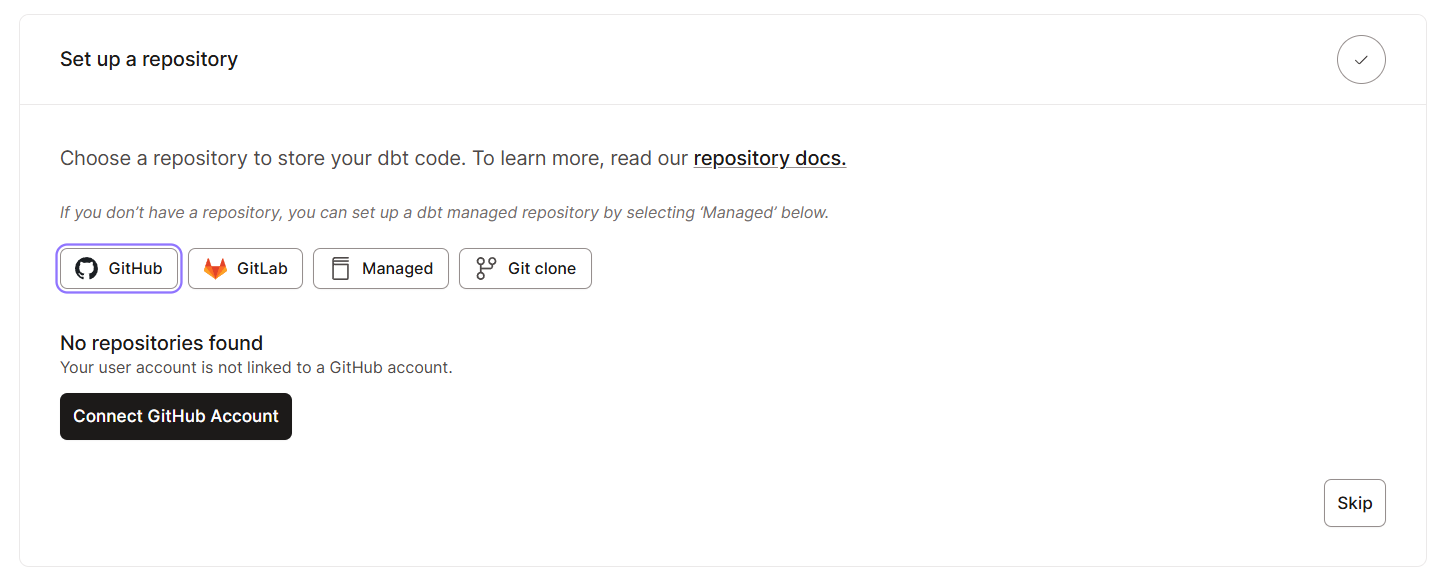
- 设置一个 Git 代码库。
了解用户界面
完成基础设置后,我们来浏览一下界面。以下是您在 dbt Cloud 界面中将看到的内容:
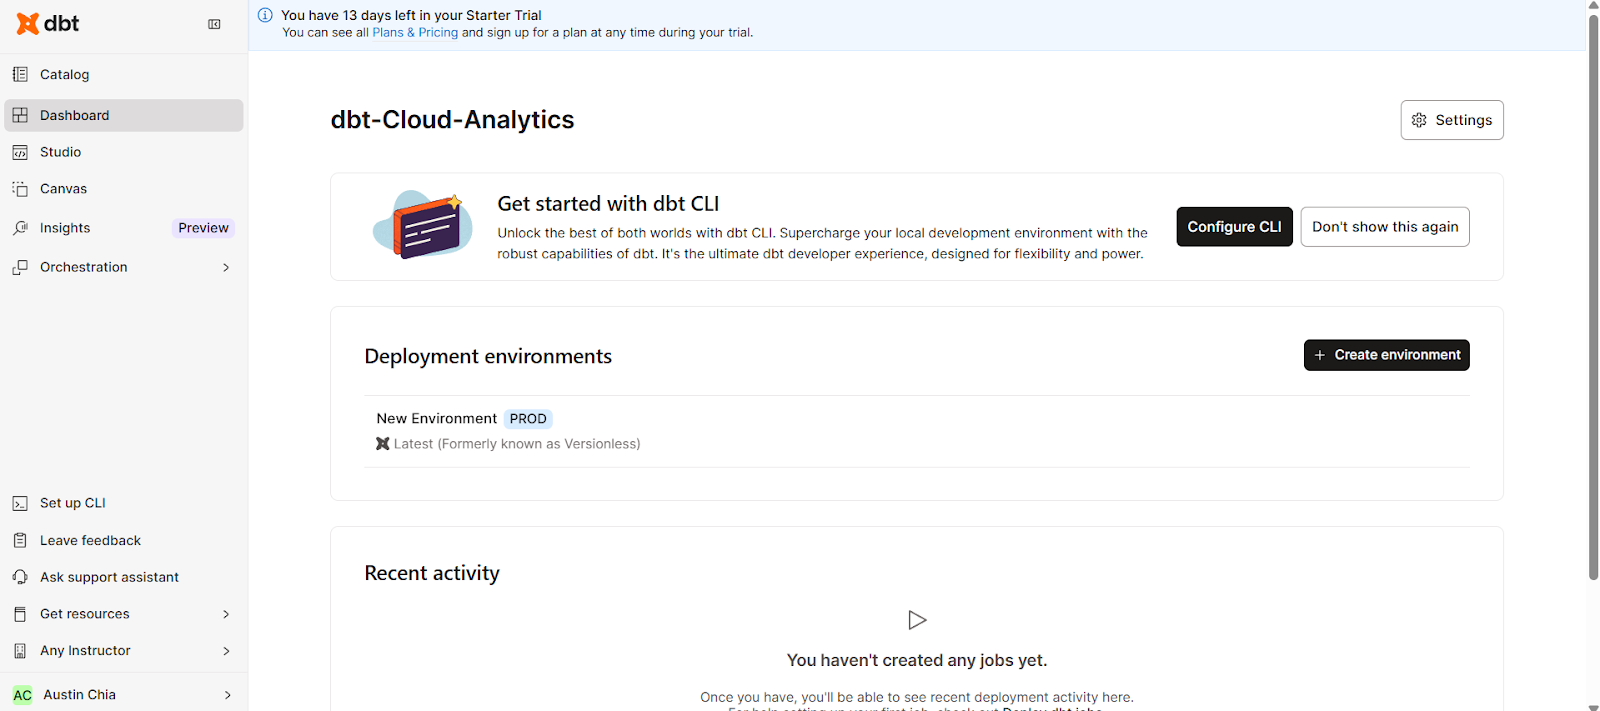
dbt Cloud 的 UI 能高效组织您的工作流。通过导航栏,您可以访问以下关键区域:
- 目录(Catalog):展示项目与模型。
- Studio:作为编写代码文件的工作界面。
- 仪表板(Dashboard):提供作业与活动的集中概览。
- Canvas:支持拖放创建模型(企业版功能)。
- 洞察(Insights):提供已部署环境的补充信息。
- 编排(Orchestration):配置并调度 dbt 运行。
这将所需信息、编码工作室与配置设置整合在同一个网页界面中。
在 dbt Cloud IDE 中进行开发
dbt Cloud 还提供一款专为分析工程打造且集成 GitHub 的浏览器端 IDE。它旨在让您在浏览器中构建、运行、测试并进行 dbt 项目的版本控制。
浏览 Cloud IDE
dbt Cloud IDE 无需本地安装,便于分析师快速上手。您可以点击界面左侧的 Studio 选项卡进入。
这会打开一个用于编写、编译与运行代码的简洁界面。
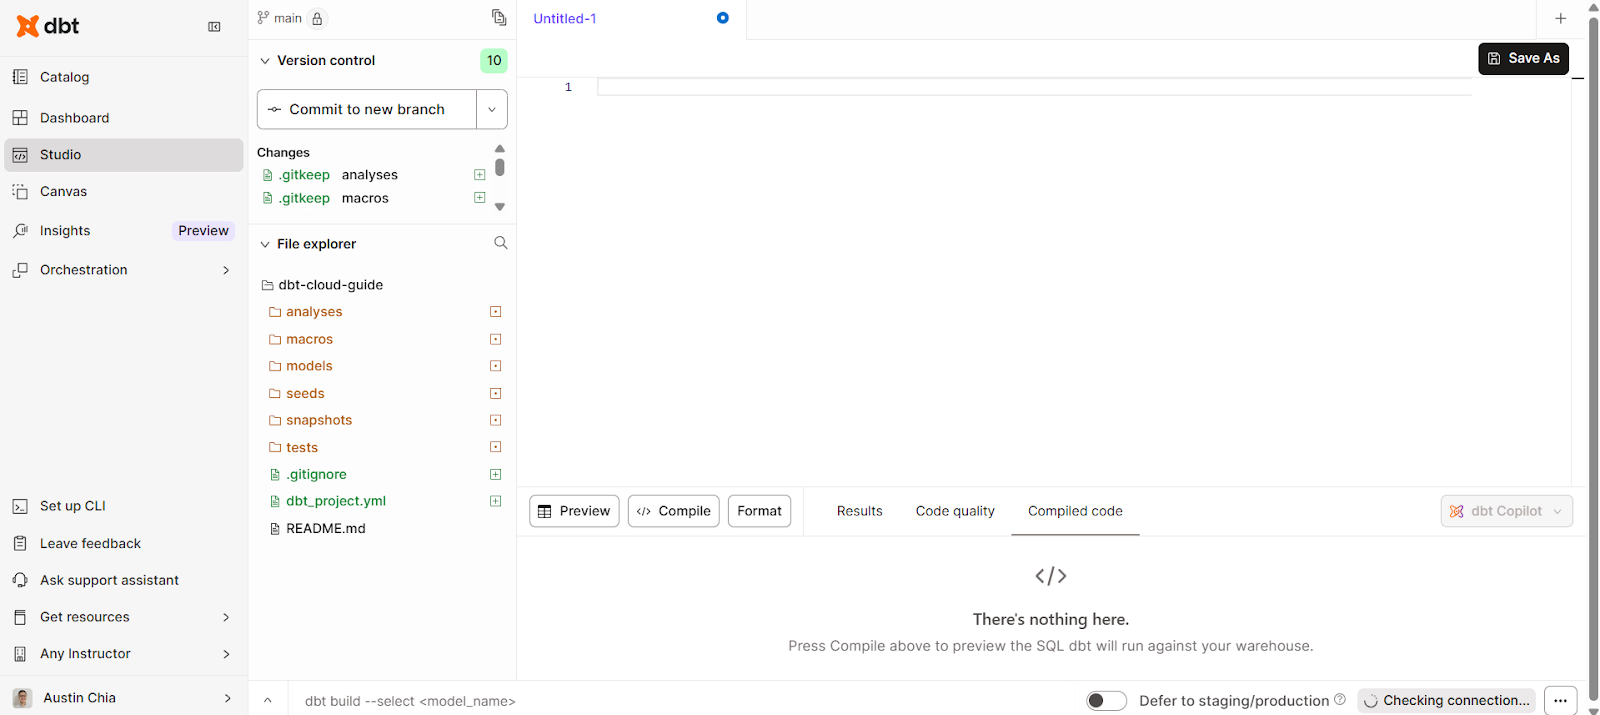
dbt Cloud IDE 支持以下功能:
- 实时查询执行与结果预览。
- SQL 自动补全与 Jinja 模板。
- 错误高亮与调试工具。
版本控制集成
此外,dbt Cloud 还可与 GitHub 集成以进行版本控制。
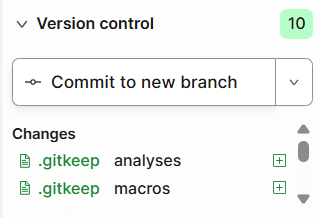
该功能使您能够:
- 将 dbt Cloud 连接到 GitHub、GitLab 或 Bitbucket。
- 直接在 IDE 中管理分支。
- 提交并同步代码更改至中央代码库。
- 通过拉取请求与评审精简协作流程。
在 dbt Cloud 中构建与测试数据模型
与 dbt Core 一样,您也可以在 dbt Cloud 内构建与测试数据模型。我们来看看一些实现方式。
编写 SQL 转换
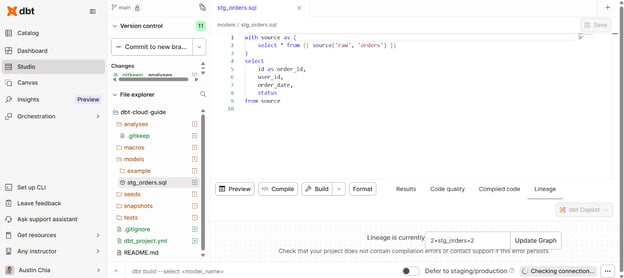
处理数据模型时,您很可能需要进行一些转换。在 dbt Cloud IDE 的 Studio 中,我们可以编写 SQL 语句。
您可以像这样创建一个进行转换的数据模型:
with source as (
    select * from {{ source('raw', 'orders') }}
)
select
    id as order_id,
    user_id,
    order_date,
    status
from source技术支持
界面如下所示:
以下是一些最佳实践:
- 按层次组织模型(staging、intermediate、marts)。
- 使用一致的命名约定。
- 通过宏复用逻辑。
自动化测试与校验
此外,您还可以在 YAML 中定义测试以进行自动检查:
models:
  - name: stg_orders
    columns:
      - name: order_id
        tests:
          - not_null
          - unique
      - name: status
        tests:
          - accepted_values:
              values: ['completed', 'pending', 'cancelled']技术支持
对数据进行测试可增强对转换结果的信任。这确保您运行的任何作业都内置测试以维护完整性。
如果您是高级用户,也可以使用 Jinja 与 SQL 定义自定义测试。
dbt Cloud 的调度与编排
在 dbt Cloud 中,作业调度与编排有助于支持分析自动化。它们确保您的转换能够在正确的环境中按时、稳定地运行,且几乎无需人工干预。
本节介绍如何调度作业、自动触发并实时监控其性能。
作业调度
在 dbt Cloud 界面中,您可以:
- 为开发、预生产或生产环境创建作业。
- 配置 cron 日程或事件驱动的触发器。
- 串联任务(run、test、snapshot)。
在 dbt Cloud 中创建作业计划:
- 进入编排(Orchestration)选项卡,然后在项目中选择Jobs。
- 点击Create Job > Deploy Job,并为其取一个描述性名称(例如“Daily Production Run”或“Staging Incremental Refresh”)。
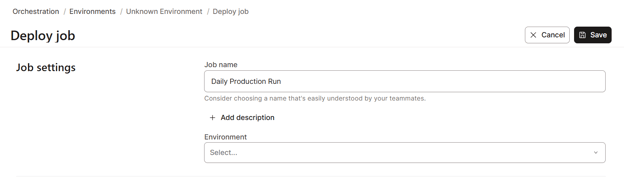
- 选择作业应运行的环境——通常为开发、预生产或生产。
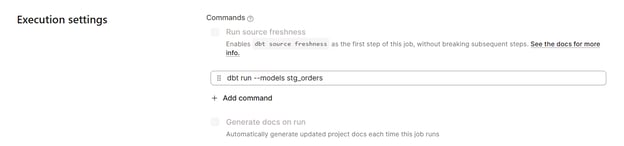
- 添加一个或多个命令,例如 dbt run --models stg_orders。
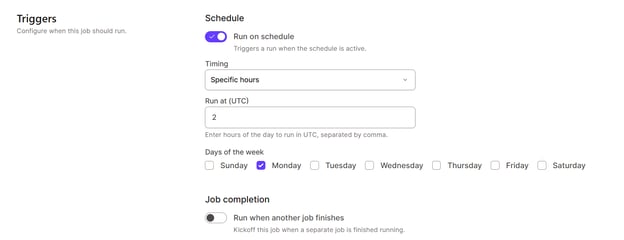
- 在 Schedule 下,选择 cron 语法或使用可视化时间选择器来定义作业执行时间(例如,每晚 2 点、每周一上午)。
- 保存作业,并启用电子邮件或 Slack 通知以接收运行状态更新。
实时监控与日志记录
dbt Cloud 支持监控与日志功能,以提升数据可观测性。这对于排查故障与优化性能至关重要。
它使您能够:
- 在 UI 中直接查看运行日志。
- 导出日志以供外部监控。
- 将通知发送至 Slack、邮箱或 PagerDuty。
dbt Cloud 的高级功能
除核心建模与编排能力外,dbt Cloud 还提供先进功能,为现代分析工作流带来智能性、一致性与自动化。
它们主要体现在两个方面:dbt 语义层与 dbt Copilot 和 Fusion 等 AI 驱动工具。
使用 dbt 语义层
dbt 语义层提供一个集中治理的层,团队可以在此以一致、受版本控制的方式定义、管理并提供业务指标。
它有助于:
- 集中定义与管理业务指标。
- 确保在 BI 与分析工具间保持一致。
- 通过强制单一事实来源来防止指标漂移。
这一统一层通过与常见 BI 工具的连接,弥合数据转换与可视化之间的鸿沟。
想要上手实践,请查看这篇关于使用 dbt 实现语义层的教程。
集成 AI:dbt Copilot 与 Fusion
dbt 的最新功能之一 dbt Copilot,是内置于 dbt Cloud IDE 的 AI 助手。它可借助自然语言提示与具备上下文的建议来帮助开发者编写、调试与优化 dbt 代码。
借助 dbt Copilot,您可以:
- 根据自然语言描述生成 SQL 模型或 Jinja 宏。
- 获取 dbt 命令、测试与配置的自动补全建议。
- 自动为模型生成说明与元数据,实现文档化。
- 在运行作业前识别并修复常见语法或依赖问题。
Fusion 引擎是一款用 Rust 编写、用以替代 dbt Core 的新引擎,具备更多功能。
它带来了一些用例,例如:
- 捕捉 dbt 模型中的不正确 SQL 代码
- 允许内联 CTE 进行预览以加快调试
- 跨项目进行模型追踪
dbt Cloud 的安全与合规
在数据转换工作流中,安全与治理是不容妥协的。因此,dbt Cloud 也构建了企业级安全控制,以保护敏感信息、保持合规,并确保跨团队的责任追踪。
基于角色的访问控制
dbt Cloud 采用基于角色的访问控制(RBAC)来管理用户权限,并限制对项目、环境与凭据等关键资产的访问。
可能的角色包括:
在 dbt Cloud 中配置访问控制:
- 进入账户设置(Account Settings)部分,然后选择 Users。
- 将用户分配至预定义角色,或创建自定义角色以获得更精细的控制。
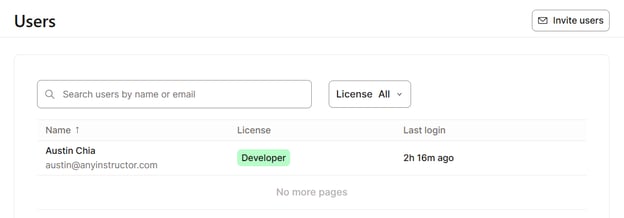
- 定义用户是否可以管理环境与作业计划、修改仓库凭据或 API 令牌,以及/或批准代码部署或合并请求。
- 使用项目级权限在多个团队或部门之间区分访问。
审计日志与合规
dbt Cloud 提供全面的审计日志与合规功能,旨在帮助组织满足严格的数据治理要求,符合 SOC 2、GDPR 等标准。
审计日志还能用于问题排查;SCIM 支持提升了身份管理集成能力。
dbt Cloud 的集成与连接性
dbt Cloud 的一大优势在于它能与更广泛的数据生态系统无缝连接。它可以轻松集成领先的数据仓库、API、编排工具与监控平台。
这使其成为从采集到可视化,构建统一、自动化分析工作流的理想选择。我们来逐一了解:
数据平台连接性
dbt Cloud 支持所有主流云数据仓库与湖仓,让团队可以在数据所在的环境中原生运行转换。
这无需进行数据移动或复制,而是利用各平台的性能与可扩展性。
dbt Cloud 的集成选项包括:
您还可以在各平台间选择多种身份验证方式,例如密钥对认证、OAuth 或用户名/密码。
API 与 Webhook 集成
对于需要可扩展性与自动化的组织,dbt Cloud 还提供强大的 REST API 与 webhook 框架。
借助 dbt Cloud API,开发者可以:
- 以编程方式触发并监控作业运行。
- 检索运行工件,如日志、清单文件或编译后的 SQL。
- 将 dbt Cloud 集成进 CI/CD 流水线(如 GitHub Actions、GitLab CI 或 Azure DevOps),以自动化部署流程。
- 大规模管理用户、环境与项目。
dbt Cloud 的 webhooks 提供基于事件的集成,使外部系统能对作业完成、运行失败或部署更新等关键 dbt 事件作出响应。
webhook 可用于:
- 当作业失败时,将实时警报发送至 Slack 或 Microsoft Teams。
- 触发事件管理工作流。
- 将运行指标与性能数据转发至监控系统。
- 在构建新模型时自动更新仪表板或元数据目录。
dbt Cloud 的性能优化
随着数据管道在规模与复杂度上的增长,可观测性对于维持可靠性、性能与信任至关重要。
dbt Cloud 能提供哪些支持?主要体现在两方面:监控管道与模型优化。
监控数据转换管道
每次作业运行都会在平台内记录、跟踪与可视化,帮助您了解端到端的转换状态。
例如,在运行历史(Run History)仪表板中,dbt Cloud 会显示如下详细信息:
- 运行时长:作业总耗时,并按模型与步骤细分。
- 状态跟踪:实时指示运行是否处于队列中、运行中、已完成或失败。
- 执行日志:详细日志显示 SQL 查询、时间戳与行数。
dbt Cloud 也可轻松集成 Datadog 等数据监控工具。
优化模型性能
庞大的单体式转换难以维护与优化。dbt 提倡模块化开发,将复杂逻辑拆解为更小、可复用且各司其职的模型。
要优化性能,您可以遵循以下最佳实践:
- 谨慎使用公用表表达式(CTE),并将重复逻辑重构到 staging 模型。
- 实行命名约定(
stg_、int_、fct_、dim_),以明确模型用途。
- 定期运行
dbt deps 与 dbt docs generate 以校验依赖与文档。
您也可以使用增量物化来降低计算成本,如下例所示。
{{ config(materialized='incremental') }}

select *
from {{ source('raw', 'events') }}
{% if is_incremental() %}
  where event_timestamp > (select max(event_timestamp) from {{ this }})
{% endif %}技术支持
使用 dbt Mesh 进行多项目协作
随着组织内数据共享需求的提升,您也需要考虑 dbt Cloud 的协作选项。
管理多项目环境
dbt Mesh 通过对完整数据血缘的集中治理,支持在大型组织中进行可扩展的协作。它使您的团队可以创建多个相互依赖的项目,每个项目由不同的业务单元或数据域拥有。
dbt Mesh 的关键优势包括:
- 可扩展性:各团队可独立拥有并部署其 dbt 项目,不受依赖阻塞。
- 跨项目引用:团队可使用定义良好的公共接口,安全地引用其他项目的模型。
- 治理与可发现性:共享模型具备清晰的所有权、文档与版本信息,促进责任与透明度。
- 自治与一致:团队可在遵循公司级数据标准与治理规则的前提下独立创新。
dbt Mesh 的核心是允许团队在保持自治的同时进行跨项目模型引用。
例如,财务团队可维护一个“核心财务指标”项目,而市场团队构建单独项目,在不复制代码或逻辑的情况下引用这些财务模型。
dbt Mesh 通过带有项目命名空间扩展的 ref() 函数实现跨项目引用。例如:
SELECT *
FROM {{ ref('finance_project', 'fct_revenue') }}技术支持
这使得市场团队的模型可以直接查询财务项目中的 fct_revenue 模型,且使用由该团队定义的规范版本。
数据模型的版本与契约
为确保跨项目的向后兼容与信任,dbt Mesh 引入了两项关键机制:模型版本与模型契约。
模型版本
模型版本允许团队在不破坏既有依赖的前提下修改模型。您可以在模型的 YAML 文件中使用 versions: 属性定义同一模型的多个版本。
例如:
models:
  - name: fct_revenue
    versions:
      - v: 1
        description: "Initial revenue aggregation"
      - v: 2
        description: "Includes new discount and refund logic"技术支持
模型契约
模型契约定义模型的结构、数据类型与约束。它充当数据生产者与消费者之间的协议。
当模型包含契约时,dbt 会在执行前进行校验,确保诸如删除列或类型不匹配等架构变更不会将意外错误传导至下游。
简单契约示例:
models:
  - name: fct_revenue
    contract:
      enforced: true
    columns:
      - name: customer_id
        data_type: string
      - name: total_revenue
        data_type: numeric
      - name: report_date
        data_type: date技术支持
若有人尝试移除或更改受契约约束的列,dbt 将报错,以保护依赖的模型与仪表板。
结语
dbt Cloud 通过提供端到端的托管平台扩展了 dbt Core 的功能,服务于分析工程。
在本指南中,我们介绍了它如何通过 Studio IDE 集中化开发、如何执行编排,以及如何支持 dbt Mesh 与语义层等新工具。
通过将这些工具集成到单一平台,dbt Cloud 使团队能够处理从采集到文档化的完整数据生命周期,而无需管理底层基础设施。
如果您希望获得 dbt 的实操体验,我们的 dbt 基础技能路径提供了一个实用的方式,帮助您开始搭建第一个项目。


dbt Cloud 已成为领先的托管式 数据转换服务,为现代分析团队提供可扩展、可靠且便于协作的工作流。
它扩展了 dbt Core 的能力,提供一个托管环境来自动化部署、编排作业、管理凭据,并为数据团队提供协作功能。
这使组织能够在安全、自动化且适合团队协作的环境中管理基于 SQL 的转换。
在本入门教程中,我们将介绍什么是 dbt Cloud、如何进行设置,以及一些使用示例。
如果您是该框架的新手,并且更喜欢结构化的学习路径,建议从我们的 dbt 入门课程开始。
什么是 dbt Cloud,它如何工作?
我们先来概览一下 dbt Cloud 及其功能。
dbt Cloud 概览
dbt Cloud 的核心是帮助团队采用 ELT(抽取、加载、转换)方法。不同于传统 ETL 在将数据加载至仓库前进行转换,dbt 在数据仓库内部完成转换,利用其计算能力与可扩展性。
来源:dbt
dbt Cloud 简化了数据转换流程,具体体现在:
核心概念与工作流
dbt Cloud 与 dbt Core 具有相同的概念。
包括:
典型的 dbt Cloud 工作流如下:开发模型 > 测试转换 > 提交至 Git > 通过 dbt Cloud 作业部署 > 在 dbt Cloud 上监控运行。
设置您的 dbt Cloud 环境
为说明 dbt Cloud 的工作方式,我们通过一个实际示例来看看如何自行搭建环境。
dbt Cloud 上手很简单,旨在实现快速入门。以下是您需要执行的步骤:
创建并设置账户
了解用户界面
完成基础设置后,我们来浏览一下界面。以下是您在 dbt Cloud 界面中将看到的内容:
dbt Cloud 的 UI 能高效组织您的工作流。通过导航栏,您可以访问以下关键区域:
这将所需信息、编码工作室与配置设置整合在同一个网页界面中。
在 dbt Cloud IDE 中进行开发
dbt Cloud 还提供一款专为分析工程打造且集成 GitHub 的浏览器端 IDE。它旨在让您在浏览器中构建、运行、测试并进行 dbt 项目的版本控制。
浏览 Cloud IDE
dbt Cloud IDE 无需本地安装,便于分析师快速上手。您可以点击界面左侧的 Studio 选项卡进入。
这会打开一个用于编写、编译与运行代码的简洁界面。
dbt Cloud IDE 支持以下功能:
版本控制集成
此外,dbt Cloud 还可与 GitHub 集成以进行版本控制。
该功能使您能够:
在 dbt Cloud 中构建与测试数据模型
与 dbt Core 一样,您也可以在 dbt Cloud 内构建与测试数据模型。我们来看看一些实现方式。
编写 SQL 转换
处理数据模型时,您很可能需要进行一些转换。在 dbt Cloud IDE 的 Studio 中,我们可以编写 SQL 语句。
您可以像这样创建一个进行转换的数据模型:
界面如下所示:
以下是一些最佳实践:
自动化测试与校验
此外,您还可以在 YAML 中定义测试以进行自动检查:
对数据进行测试可增强对转换结果的信任。这确保您运行的任何作业都内置测试以维护完整性。
如果您是高级用户,也可以使用 Jinja 与 SQL 定义自定义测试。
dbt Cloud 的调度与编排
在 dbt Cloud 中,作业调度与编排有助于支持分析自动化。它们确保您的转换能够在正确的环境中按时、稳定地运行,且几乎无需人工干预。
本节介绍如何调度作业、自动触发并实时监控其性能。
作业调度
在 dbt Cloud 界面中,您可以:
在 dbt Cloud 中创建作业计划:
实时监控与日志记录
dbt Cloud 支持监控与日志功能,以提升数据可观测性。这对于排查故障与优化性能至关重要。
它使您能够:
dbt Cloud 的高级功能
除核心建模与编排能力外,dbt Cloud 还提供先进功能,为现代分析工作流带来智能性、一致性与自动化。
它们主要体现在两个方面:dbt 语义层与 dbt Copilot 和 Fusion 等 AI 驱动工具。
使用 dbt 语义层
dbt 语义层提供一个集中治理的层,团队可以在此以一致、受版本控制的方式定义、管理并提供业务指标。
它有助于:
这一统一层通过与常见 BI 工具的连接,弥合数据转换与可视化之间的鸿沟。
想要上手实践,请查看这篇关于使用 dbt 实现语义层的教程。
集成 AI:dbt Copilot 与 Fusion
dbt 的最新功能之一 dbt Copilot,是内置于 dbt Cloud IDE 的 AI 助手。它可借助自然语言提示与具备上下文的建议来帮助开发者编写、调试与优化 dbt 代码。
借助 dbt Copilot,您可以:
Fusion 引擎是一款用 Rust 编写、用以替代 dbt Core 的新引擎,具备更多功能。
它带来了一些用例,例如:
dbt Cloud 的安全与合规
在数据转换工作流中,安全与治理是不容妥协的。因此,dbt Cloud 也构建了企业级安全控制,以保护敏感信息、保持合规,并确保跨团队的责任追踪。
基于角色的访问控制
dbt Cloud 采用基于角色的访问控制(RBAC)来管理用户权限,并限制对项目、环境与凭据等关键资产的访问。
可能的角色包括:
在 dbt Cloud 中配置访问控制:
审计日志与合规
dbt Cloud 提供全面的审计日志与合规功能,旨在帮助组织满足严格的数据治理要求,符合 SOC 2、GDPR 等标准。
审计日志还能用于问题排查;SCIM 支持提升了身份管理集成能力。
dbt Cloud 的集成与连接性
dbt Cloud 的一大优势在于它能与更广泛的数据生态系统无缝连接。它可以轻松集成领先的数据仓库、API、编排工具与监控平台。
这使其成为从采集到可视化,构建统一、自动化分析工作流的理想选择。我们来逐一了解:
数据平台连接性
dbt Cloud 支持所有主流云数据仓库与湖仓,让团队可以在数据所在的环境中原生运行转换。
这无需进行数据移动或复制,而是利用各平台的性能与可扩展性。
dbt Cloud 的集成选项包括:
您还可以在各平台间选择多种身份验证方式,例如密钥对认证、OAuth 或用户名/密码。
API 与 Webhook 集成
对于需要可扩展性与自动化的组织,dbt Cloud 还提供强大的 REST API 与 webhook 框架。
借助 dbt Cloud API,开发者可以:
dbt Cloud 的 webhooks 提供基于事件的集成,使外部系统能对作业完成、运行失败或部署更新等关键 dbt 事件作出响应。
webhook 可用于:
dbt Cloud 的性能优化
随着数据管道在规模与复杂度上的增长,可观测性对于维持可靠性、性能与信任至关重要。
dbt Cloud 能提供哪些支持?主要体现在两方面:监控管道与模型优化。
监控数据转换管道
每次作业运行都会在平台内记录、跟踪与可视化,帮助您了解端到端的转换状态。
例如,在运行历史(Run History)仪表板中,dbt Cloud 会显示如下详细信息:
dbt Cloud 也可轻松集成 Datadog 等数据监控工具。
优化模型性能
庞大的单体式转换难以维护与优化。dbt 提倡模块化开发,将复杂逻辑拆解为更小、可复用且各司其职的模型。
要优化性能,您可以遵循以下最佳实践:
stg_、int_、fct_、dim_),以明确模型用途。dbt deps与dbt docs generate以校验依赖与文档。您也可以使用增量物化来降低计算成本,如下例所示。
使用 dbt Mesh 进行多项目协作
随着组织内数据共享需求的提升,您也需要考虑 dbt Cloud 的协作选项。
管理多项目环境
dbt Mesh 通过对完整数据血缘的集中治理,支持在大型组织中进行可扩展的协作。它使您的团队可以创建多个相互依赖的项目,每个项目由不同的业务单元或数据域拥有。
dbt Mesh 的关键优势包括:
dbt Mesh 的核心是允许团队在保持自治的同时进行跨项目模型引用。
例如,财务团队可维护一个“核心财务指标”项目,而市场团队构建单独项目,在不复制代码或逻辑的情况下引用这些财务模型。
dbt Mesh 通过带有项目命名空间扩展的
ref()函数实现跨项目引用。例如:这使得市场团队的模型可以直接查询财务项目中的
fct_revenue模型,且使用由该团队定义的规范版本。数据模型的版本与契约
为确保跨项目的向后兼容与信任,dbt Mesh 引入了两项关键机制:模型版本与模型契约。
模型版本
模型版本允许团队在不破坏既有依赖的前提下修改模型。您可以在模型的 YAML 文件中使用
versions:属性定义同一模型的多个版本。例如:
模型契约
模型契约定义模型的结构、数据类型与约束。它充当数据生产者与消费者之间的协议。
当模型包含契约时,dbt 会在执行前进行校验,确保诸如删除列或类型不匹配等架构变更不会将意外错误传导至下游。
简单契约示例:
若有人尝试移除或更改受契约约束的列,dbt 将报错,以保护依赖的模型与仪表板。
结语
dbt Cloud 通过提供端到端的托管平台扩展了 dbt Core 的功能,服务于分析工程。
在本指南中,我们介绍了它如何通过 Studio IDE 集中化开发、如何执行编排,以及如何支持 dbt Mesh 与语义层等新工具。
通过将这些工具集成到单一平台,dbt Cloud 使团队能够处理从采集到文档化的完整数据生命周期,而无需管理底层基础设施。
如果您希望获得 dbt 的实操体验,我们的 dbt 基础技能路径提供了一个实用的方式,帮助您开始搭建第一个项目。