
Corso
Introduzione a dbt
4 ore
34K
dbt Cloud è emerso come il principale servizio gestito per la trasformazione dei dati, offrendo a team di analytics moderni workflow scalabili, affidabili e collaborativi.
Estende la potenza di dbt Core, offrendo un ambiente ospitato che automatizza i deployment, orchestra i job, gestisce le credenziali e fornisce funzioni di collaborazione per i team dati.
Questo permette alle organizzazioni di gestire trasformazioni basate su SQL in un ambiente sicuro, automatizzato e adatto al lavoro di squadra.
In questo tutorial introduttivo vedremo cos’è dbt Cloud, come configurarlo ed esempi di come può essere utilizzato.
Se sei nuovo del framework e preferisci un percorso di apprendimento strutturato, ti consiglio di iniziare con il nostro corso Introduzione a dbt.
Iniziamo con una panoramica di cosa sia dbt Cloud e alcune delle sue funzionalità.
Alla base, dbt Cloud consente ai team di seguire l’approccio ELT (Extract, Load, Transform). A differenza dei processi ETL tradizionali, in cui le trasformazioni avvengono prima del caricamento nel data warehouse, dbt esegue le trasformazioni all’interno del warehouse sfruttandone capacità di calcolo e scalabilità.
Fonte: dbt
dbt Cloud semplifica il processo di trasformazione dei dati, in quanto:
dbt Cloud include gli stessi concetti di dbt Core.
Tra questi troviamo:
Un tipico workflow in dbt Cloud è il seguente: Sviluppa i modelli > Testa le trasformazioni > Fai commit su Git > Distribuisci tramite job di dbt Cloud > Monitora le esecuzioni su dbt Cloud.
Per spiegare come funziona dbt Cloud, vediamo un esempio pratico di come impostare un ambiente da zero.
Iniziare con dbt Cloud è semplice, perché è pensato per un onboarding rapido. Ecco i passaggi da seguire:
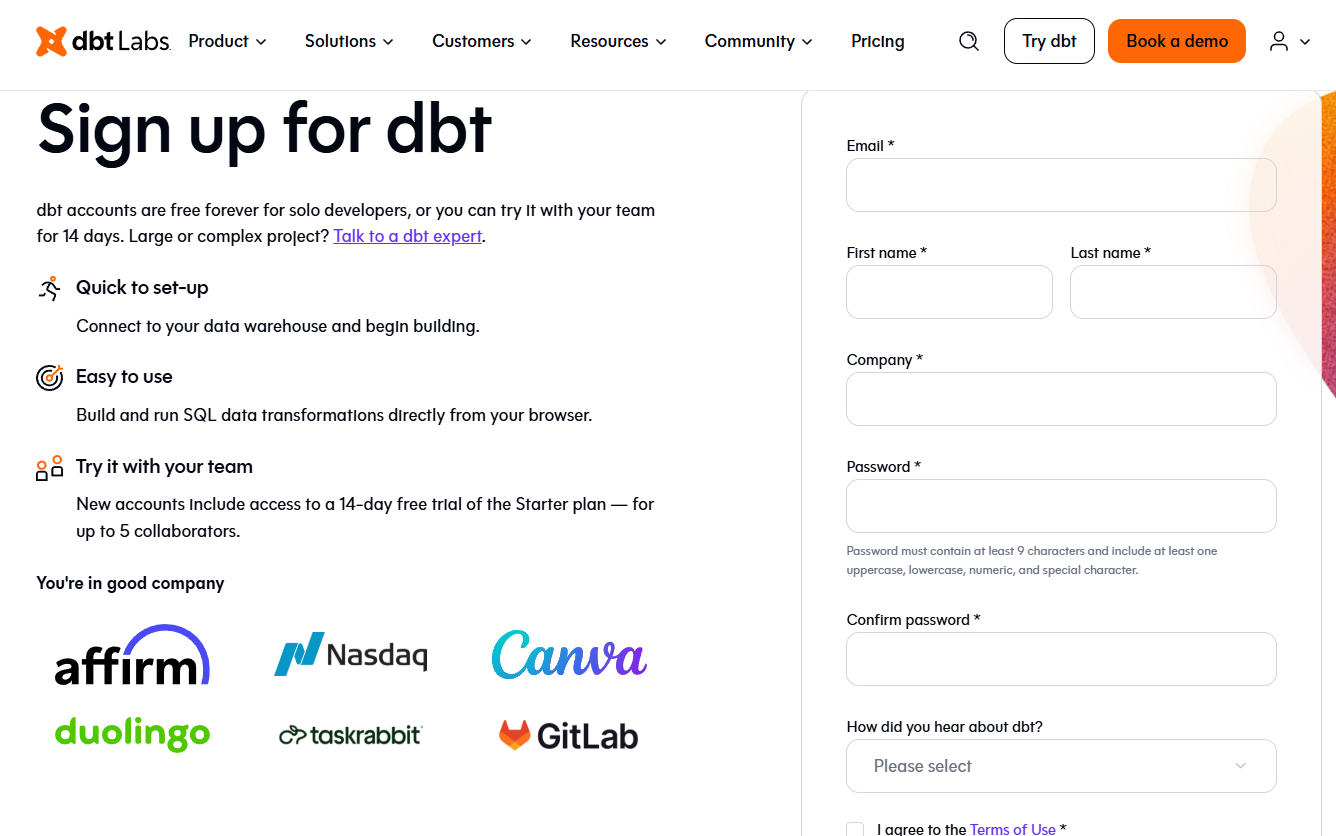
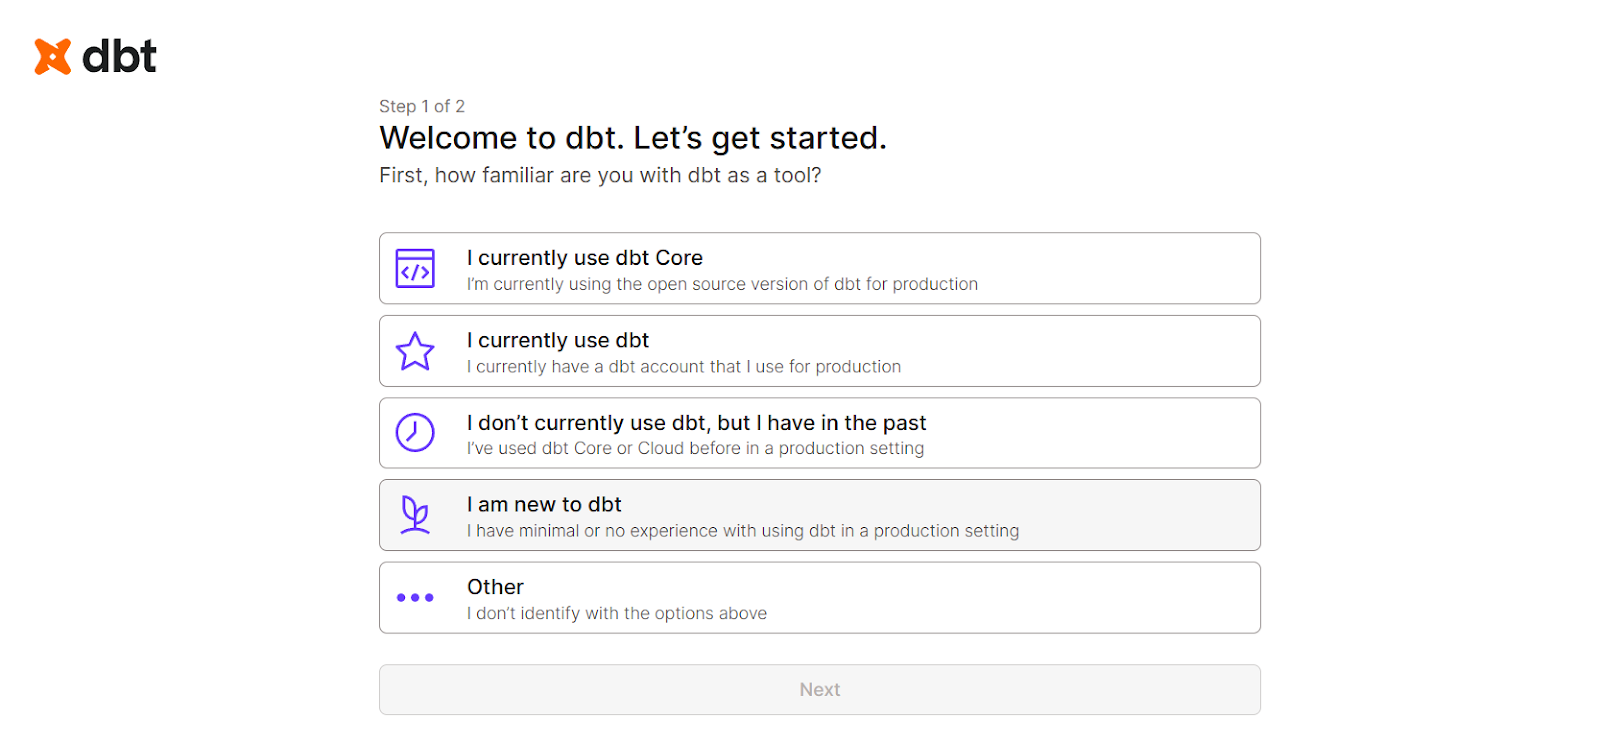
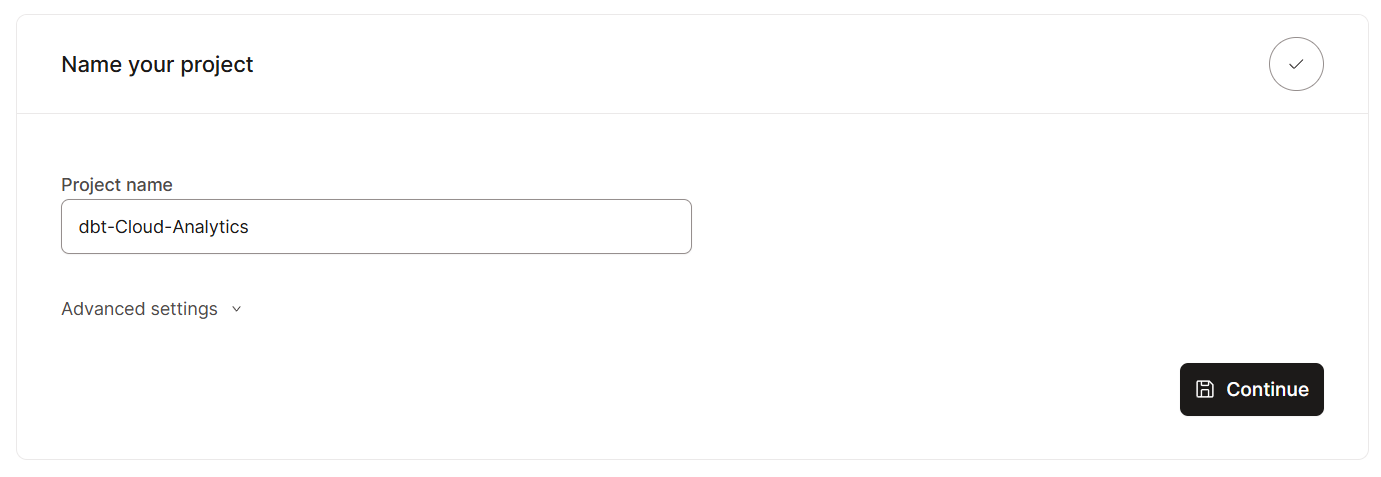
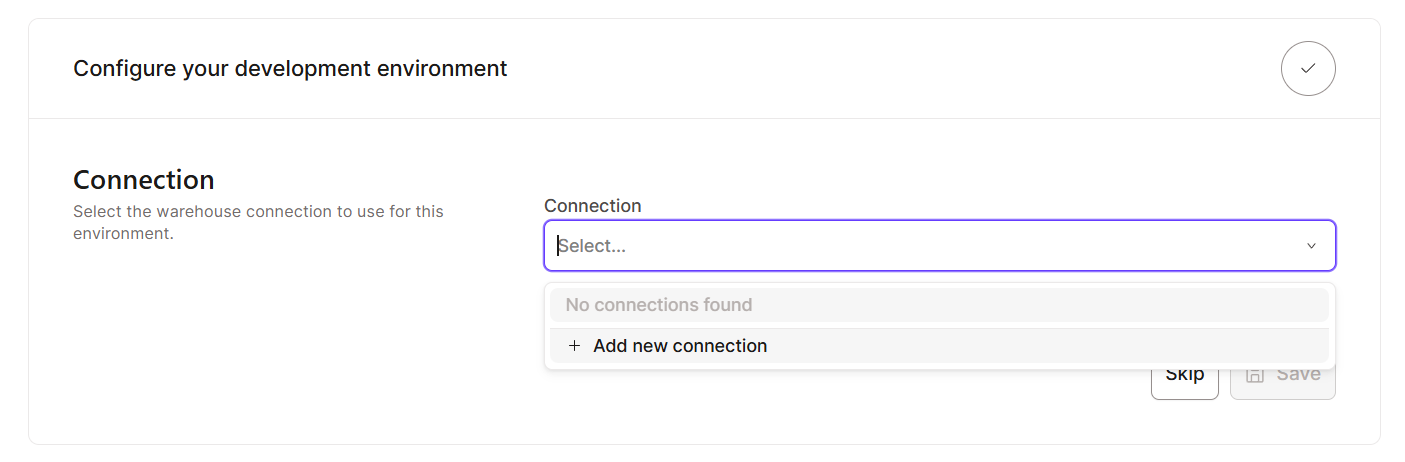
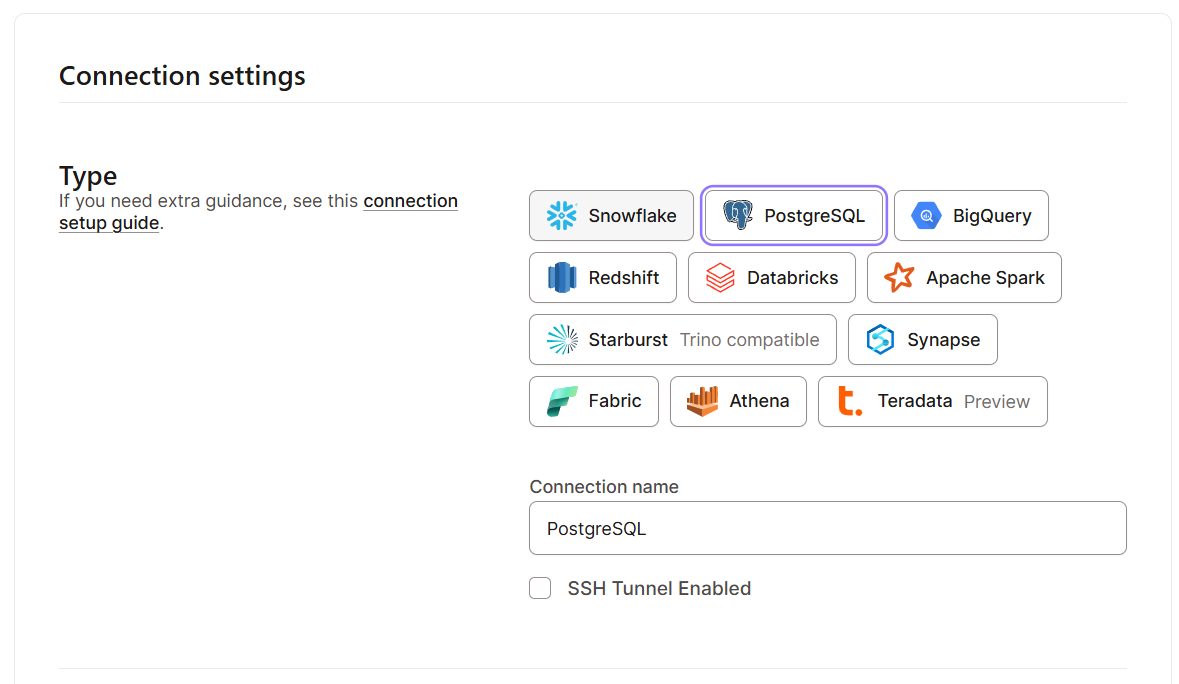
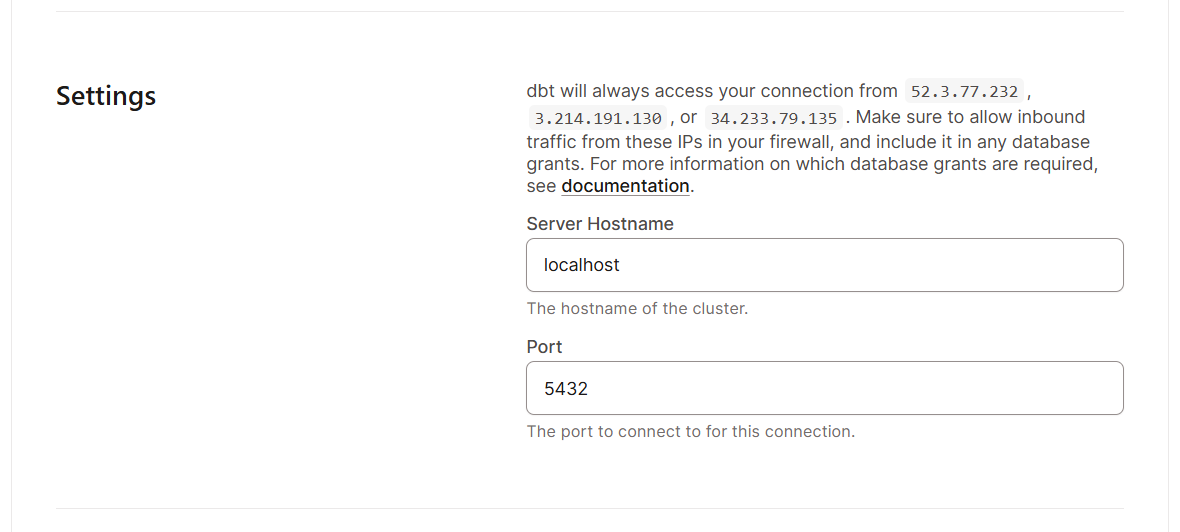
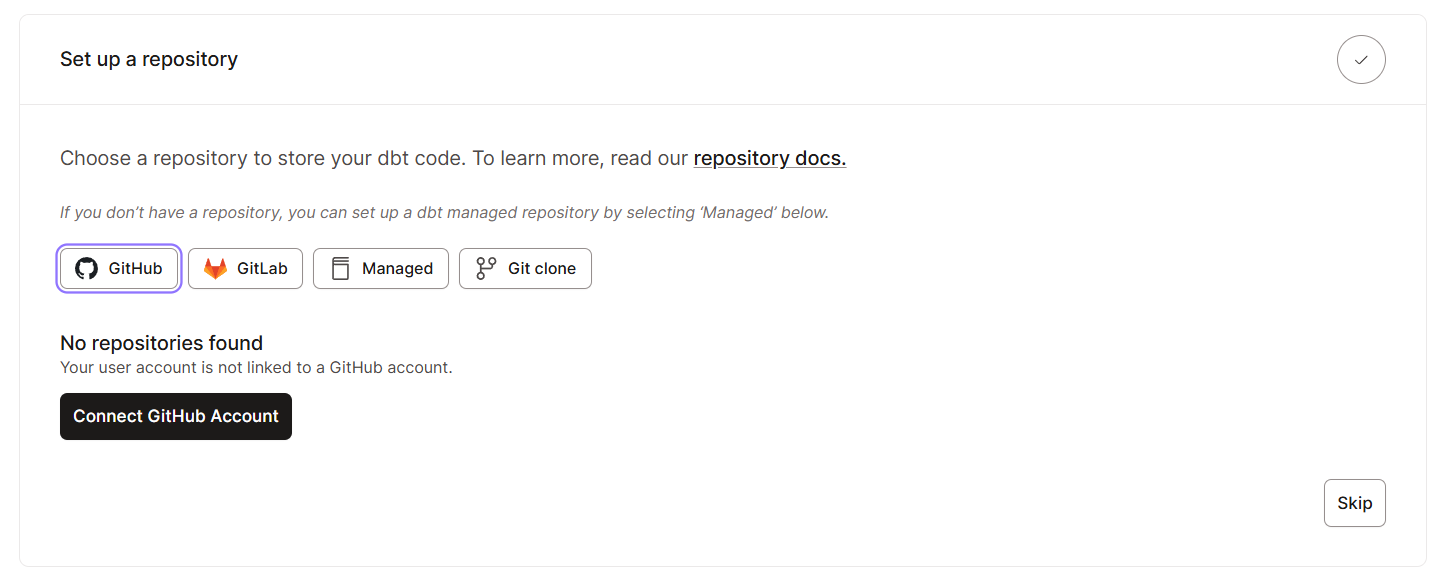
Una volta completate le configurazioni di base, esploriamo l’interfaccia. Ecco cosa dovresti aspettarti di vedere nell’interfaccia di dbt Cloud:
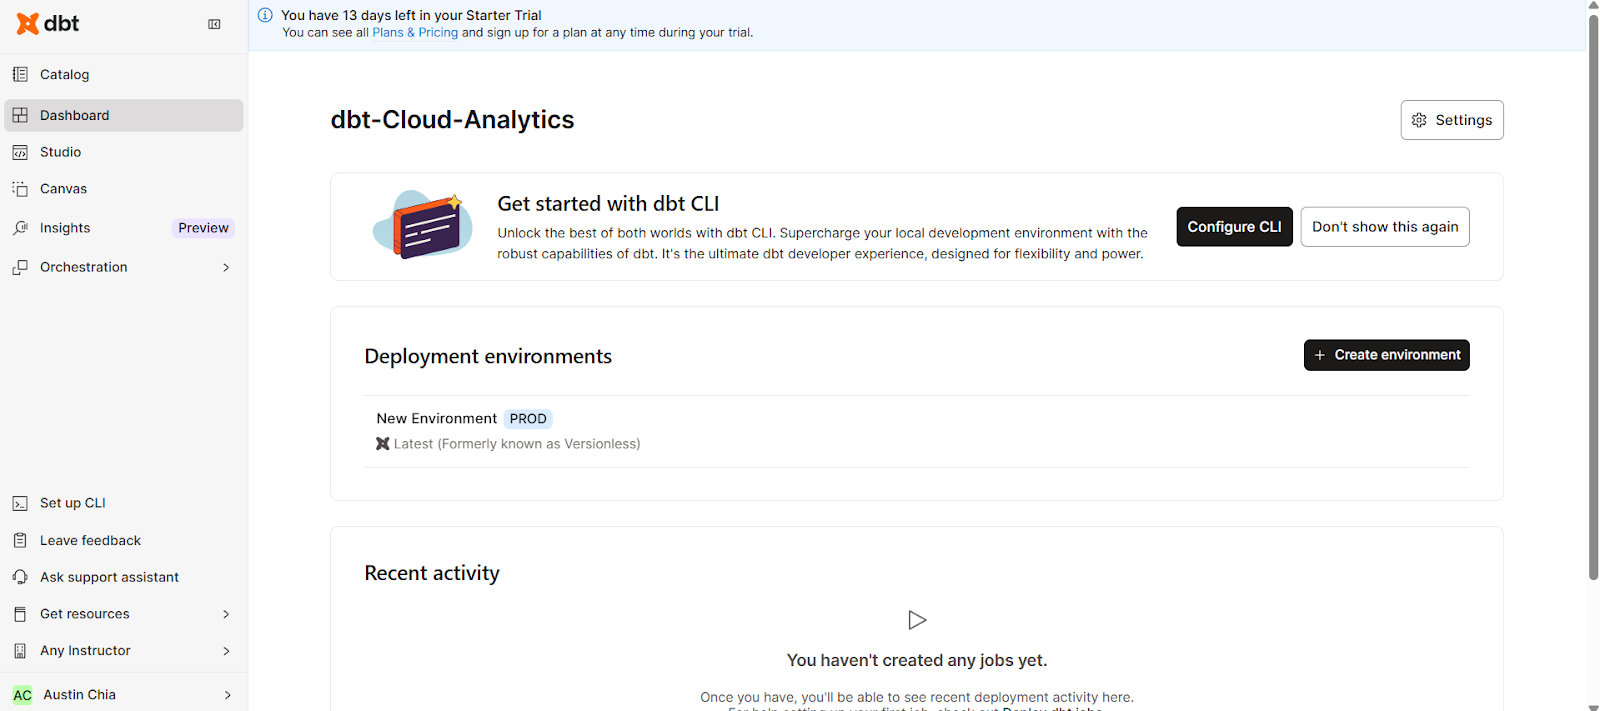
La UI di dbt Cloud organizza in modo efficiente il tuo workflow. Usando la barra di navigazione, puoi accedere alle seguenti aree chiave:
Questo riunisce in un’unica interfaccia web tutte le informazioni necessarie, lo studio di coding e le impostazioni di configurazione.
dbt Cloud offre anche un IDE nel browser progettato per l’analytics engineering con integrazione GitHub. È stato creato per creare, eseguire, testare e versionare progetti dbt direttamente dal browser.
L’IDE di dbt Cloud non richiede configurazioni locali, semplificando l’onboarding per gli analyst. Per accedervi, puoi fare clic sulla scheda Studio sul lato sinistro dell’interfaccia.
Si aprirà un’interfaccia semplice per scrivere, compilare ed eseguire il codice.
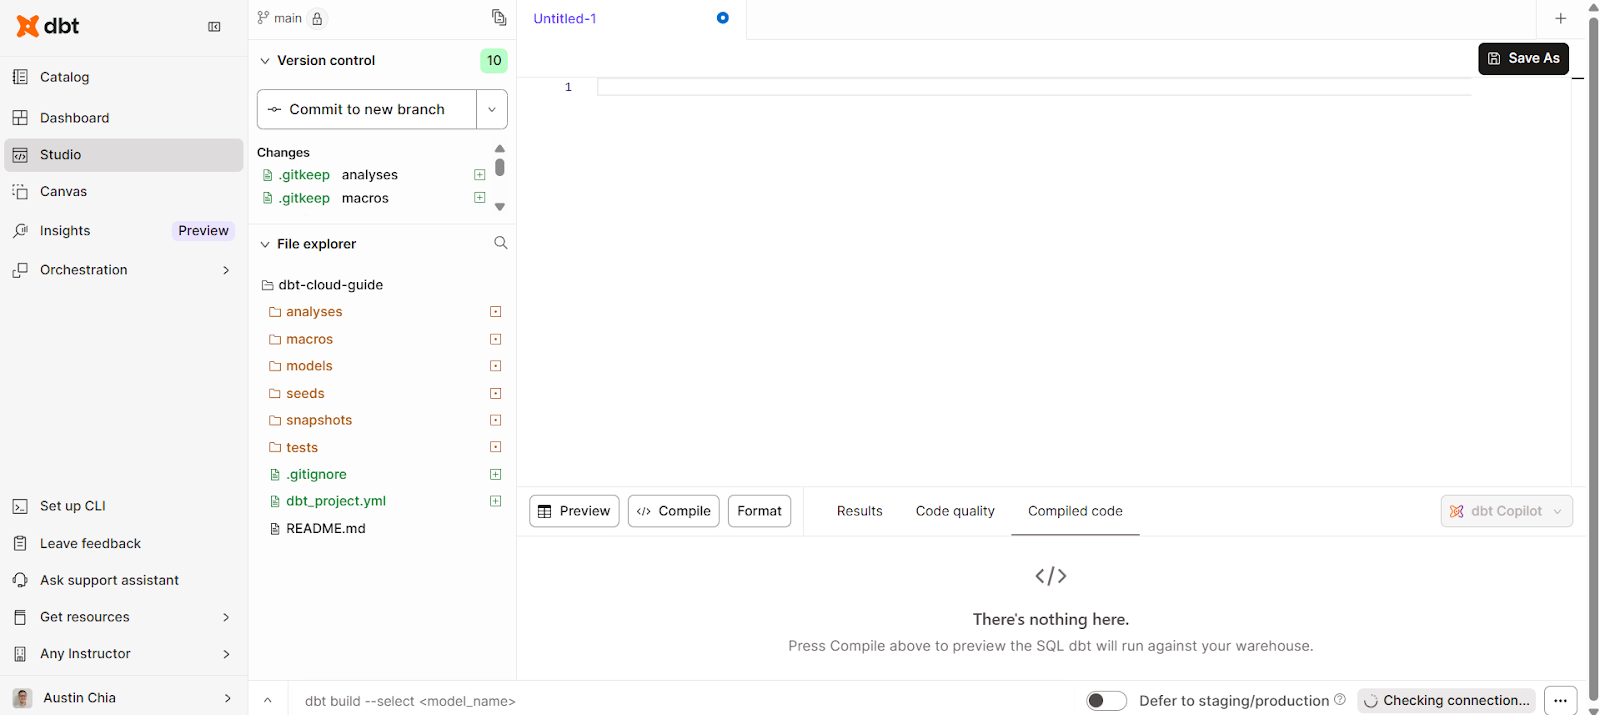
L’IDE di dbt Cloud ti permette di svolgere queste attività:
Inoltre, dbt Cloud ti consente anche di integrarti con GitHub per il controllo versione.
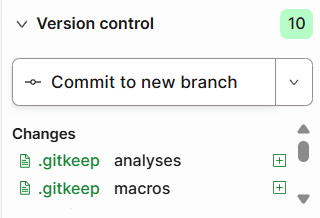
Questa funzione ti permette di:
Come in dbt Core, potrai anche creare e testare i data model direttamente in dbt Cloud. Vediamo alcuni modi per farlo.
Quando lavori con i data model, avrai probabilmente bisogno di effettuare alcune trasformazioni. Nell’IDE di dbt Cloud possiamo scrivere istruzioni SQL all’interno di Studio.
Puoi creare un data model da trasformare in questo modo:
with source as (
    select * from {{ source('raw', 'orders') }}
)
select
    id as order_id,
    user_id,
    order_date,
    status
from source
Ecco come appare l’interfaccia:
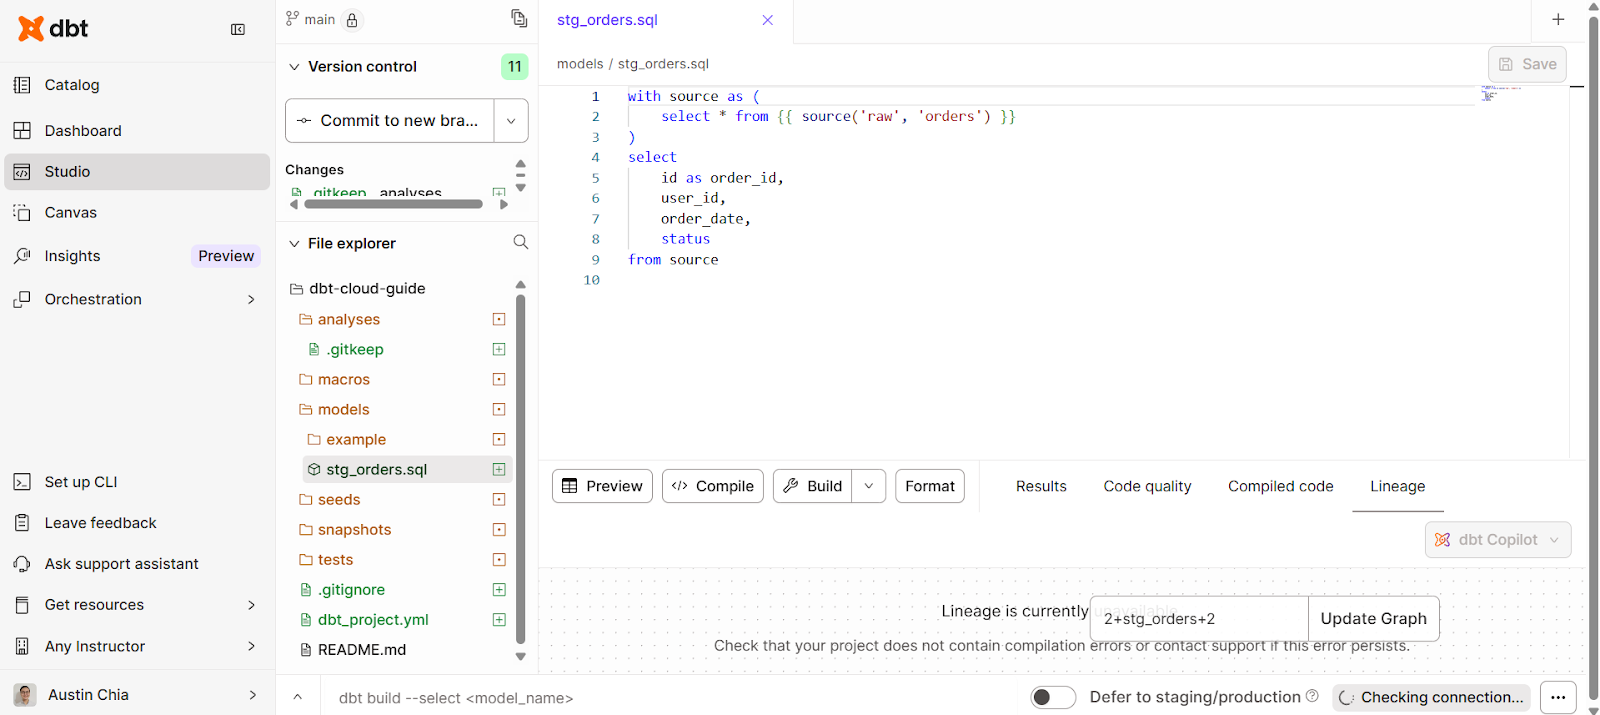
Alcune buone pratiche da tenere a mente:
Inoltre, puoi definire test in YAML per controlli automatici:
models:
  - name: stg_orders
    columns:
      - name: order_id
        tests:
          - not_null
          - unique
      - name: status
        tests:
          - accepted_values:
              values: ['completed', 'pending', 'cancelled']
Testare i tuoi dati rafforza la fiducia nelle trasformazioni. Questo assicura che qualsiasi job eseguirai includa test integrati per mantenere l’integrità.
Se sei un utente avanzato, puoi anche definire test personalizzati usando Jinja e SQL.
In dbt Cloud, pianificazione dei job e orchestrazione supportano l’automazione dell’analytics. Garantiscono che le trasformazioni vengano eseguite in modo costante, puntuale e nell’ambiente corretto con il minimo intervento manuale.
Questa sezione illustra come pianificare i job, attivarli automaticamente e monitorarne le prestazioni in tempo reale.
All’interno dell’interfaccia di dbt Cloud puoi:
Per creare una pianificazione di job in dbt Cloud:
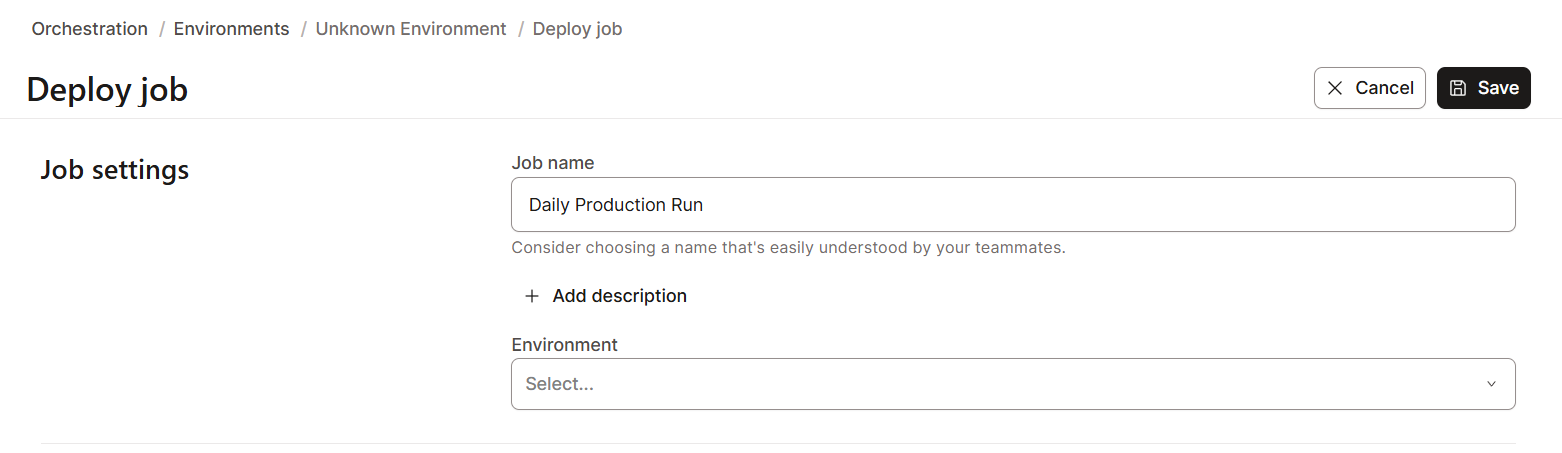
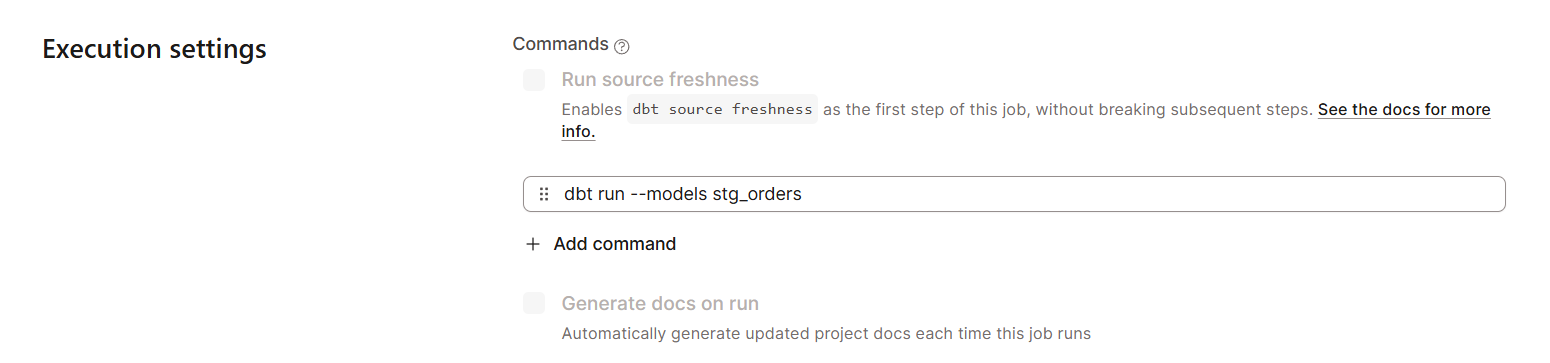
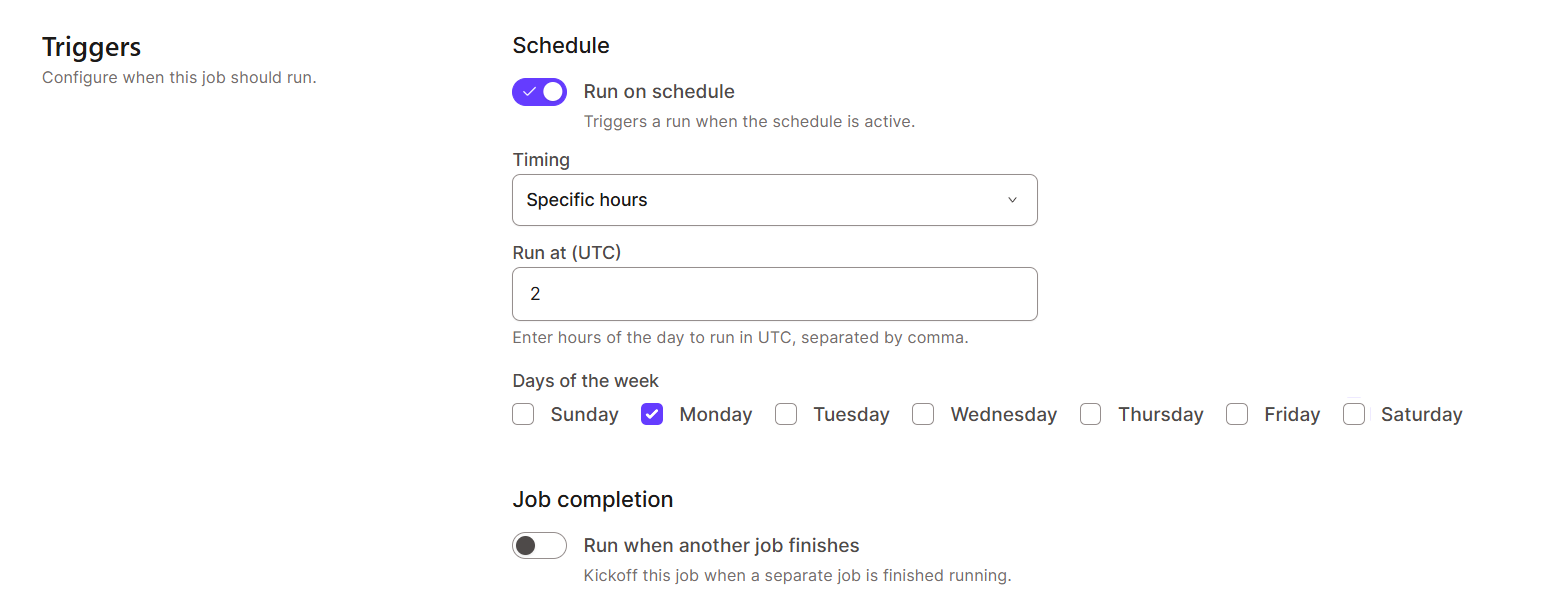
dbt Cloud supporta funzionalità di monitoraggio e logging per una migliore osservabilità dei dati. Questo è essenziale per risolvere i problemi e ottimizzare le prestazioni.
Ti consente di:
Oltre alle funzionalità principali di modellazione e orchestrazione, dbt Cloud offre caratteristiche avanzate che portano intelligenza, coerenza e automazione nei workflow di analytics moderni.
Si trovano in due aree principali: il dbt Semantic Layer e strumenti basati su AI come dbt Copilot e Fusion.
Il dbt Semantic Layer fornisce un livello centrale e governato in cui i team possono definire, gestire e servire metriche di business in modo coerente e sotto controllo di versione.
Aiuta a:
Questo livello unificato colma il divario tra trasformazione e visualizzazione dei dati grazie alle connessioni con i più comuni strumenti di BI.
Per un esempio pratico, consulta questo tutorial su come implementare un semantic layer con dbt.
Una delle funzionalità più recenti, dbt Copilot, è un assistente AI integrato direttamente nell’IDE di dbt Cloud. Aiuta gli sviluppatori a scrivere, eseguire il debug e ottimizzare il codice dbt usando prompt in linguaggio naturale e suggerimenti contestuali.
Con dbt Copilot puoi:
Il motore Fusion è un nuovo engine scritto in Rust per sostituire dbt Core, con molte più funzionalità.
Offre alcuni casi d’uso, come:
Nei workflow di trasformazione dei dati, sicurezza e governance sono imprescindibili. Per questo dbt Cloud è costruito con controlli di sicurezza di livello enterprise per proteggere informazioni sensibili, mantenere la compliance e garantire responsabilità tra i team.
dbt Cloud utilizza RBAC (role-based access control) per gestire i permessi utente e limitare l’accesso ad asset critici come progetti, ambienti e credenziali.
I possibili ruoli includono:
Per configurare il controllo degli accessi in dbt Cloud:
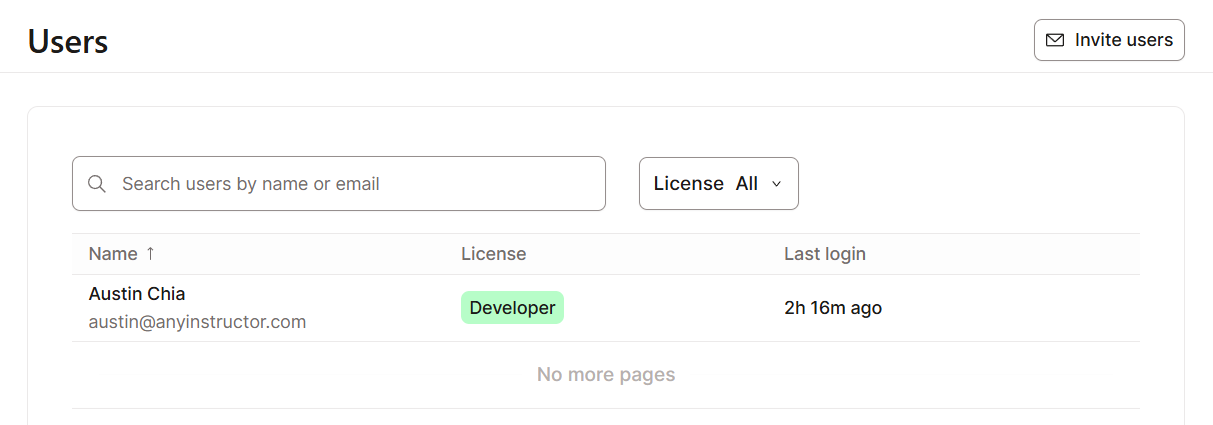
dbt Cloud include funzionalità complete di audit logging e compliance progettate per aiutare le organizzazioni a soddisfare rigorosi requisiti di data governance, in linea con standard come SOC 2, GDPR e altri.
Gli audit log permettono anche di indagare sui problemi, e il supporto SCIM migliora l’integrazione per la gestione delle identità.
Una delle maggiori forze di dbt Cloud è la capacità di collegarsi senza attriti all’ecosistema dati più ampio. Si integra facilmente con i principali data warehouse, API, strumenti di orchestrazione e piattaforme di monitoraggio.
Questo lo rende una buona scelta per costruire un workflow di analytics unificato e automatico, dall’ingestione alla visualizzazione. Esploriamo questi aspetti di seguito:
dbt Cloud supporta tutti i principali cloud data warehouse e lakehouse, consentendo ai team di eseguire le trasformazioni in modo nativo negli ambienti in cui i dati risiedono già.
Questo elimina la necessità di spostare o duplicare i dati, sfruttando invece le prestazioni e la scalabilità di ciascuna piattaforma.
Le opzioni di integrazione di dbt Cloud includono:
Puoi anche avere più opzioni di autenticazione per piattaforma, come key pair, OAuth o nome utente/password.
Per le organizzazioni che necessitano di estendibilità e automazione, dbt Cloud offre anche una potente REST API e un framework di webhook.
La dbt Cloud API consente agli sviluppatori di:
I webhook di dbt Cloud forniscono un’integrazione basata su eventi, consentendo ai sistemi esterni di rispondere a eventi chiave di dbt come completamento dei job, fallimenti di esecuzione o aggiornamenti di deployment.
I webhook possono essere utilizzati per:
Man mano che le pipeline di dati crescono in scala e complessità, l’osservabilità diventa essenziale per mantenere affidabilità, prestazioni e fiducia.
Ma cosa offre dbt Cloud? Si riduce a due aspetti: monitoraggio delle pipeline e ottimizzazione dei modelli.
Ogni esecuzione di job è registrata, tracciata e visualizzata all’interno della piattaforma, permettendoti di comprendere lo stato end-to-end delle trasformazioni.
Ad esempio, nella dashboard Run History, dbt Cloud mostra informazioni dettagliate come:
dbt Cloud si integra facilmente anche con strumenti di monitoraggio dei dati come Datadog.
Grandi trasformazioni monolitiche sono difficili da mantenere e ottimizzare. dbt promuove lo sviluppo modulare, in cui la logica complessa viene suddivisa in modelli più piccoli e riutilizzabili, ciascuno con un compito mirato.
Per ottimizzare le prestazioni, puoi seguire queste buone pratiche:
stg_, int_, fct_, dim_) per chiarire lo scopo del modello.dbt deps e dbt docs generate per convalidare dipendenze e documentazione.Puoi anche usare materializzazioni incrementali per ridurre i costi di calcolo, come mostrato nel seguente esempio.
{{ config(materialized='incremental') }}

select *
from {{ source('raw', 'events') }}
{% if is_incremental() %}
  where event_timestamp > (select max(event_timestamp) from {{ this }})
{% endif %}Poiché i team dati necessitano di una maggiore condivisione dei dati all’interno di un’organizzazione, dovrai anche considerare le opzioni di collaborazione offerte da dbt Cloud.
dbt Mesh abilita una collaborazione scalabile nelle grandi organizzazioni tramite una governance centralizzata dell’intero data lineage. Consente al tuo team di creare più progetti interdipendenti, ciascuno di proprietà di diverse unità di business o domini di dati.
I principali vantaggi di dbt Mesh includono:
In sostanza, dbt Mesh consente ai team di referenziare modelli tra progetti preservando l’autonomia.
Per esempio, un team finance potrebbe mantenere un progetto “metriche finanziarie core”, mentre il team marketing costruisce un progetto separato che referenzia quei modelli finanziari senza duplicare codice o logica.
dbt Mesh abilita i riferimenti cross-project tramite la funzione ref(), estesa con namespace di progetto. Ad esempio:
SELECT *
FROM {{ ref('finance_project', 'fct_revenue') }}
Questo permette al modello marketing di interrogare direttamente il modello fct_revenue dal progetto finance, usando la versione canonica definita da quel team.
Per garantire compatibilità all’indietro e fiducia tra progetti, dbt Mesh introduce due meccanismi fondamentali: versionamento dei modelli e contratti dei modelli.
Il versionamento dei modelli è uno dei metodi che permette ai team di modificare i propri modelli senza rompere le dipendenze esistenti. Puoi definire più versioni dello stesso modello usando la proprietà versions: nel file YAML del modello.
Per esempio:
models:
  - name: fct_revenue
    versions:
      - v: 1
        description: "Initial revenue aggregation"
      - v: 2
description: "Includes new discount and refund logic"I contratti dei modelli definiscono struttura, tipi di dato e vincoli di un modello. Agiscono come un accordo tra produttori e consumatori di dati.
Quando un modello include un contratto, dbt lo convalida prima dell’esecuzione, assicurando che modifiche allo schema (come l’eliminazione di colonne o incongruenze di tipo) non propaghino errori indesiderati a valle.
Esempio di un contratto semplice:
models:
  - name: fct_revenue
    contract:
      enforced: true
    columns:
      - name: customer_id
        data_type: string
      - name: total_revenue
        data_type: numeric
      - name: report_date
        data_type: date
Se qualcuno prova a rimuovere o modificare una colonna contrattualizzata, dbt genererà un errore, proteggendo i modelli e le dashboard dipendenti.
dbt Cloud estende le funzionalità di dbt Core offrendo una piattaforma gestita end-to-end per l’analytics engineering.
In questa guida, abbiamo visto come centralizza lo sviluppo tramite l’IDE Studio, gestisce l’orchestrazione e supporta strumenti più recenti come dbt Mesh e il Semantic Layer.
Integrando questi strumenti in un’unica piattaforma, dbt Cloud consente ai team di gestire l’intero ciclo di vita dei dati, dall’ingestione alla documentazione, senza dover amministrare l’infrastruttura sottostante.
Se vuoi fare pratica con dbt, il nostro skill track dbt Fundamentals offre un modo pratico per iniziare a costruire il tuo primo progetto.
Corsi su dbt
Corso
Programma
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



