

安装与设置 dbt
在本教程中,我们将使用 Google Cloud BigQuery 作为数据仓库解决方案。其免费额度非常适合学习使用。您可以在Google Cloud 帐号中启用 BigQuery。
我们将使用 Python 与 pip 在本地安装 dbt,创建虚拟环境,并开始运行示例模型与测试。
在命令行中运行以下命令:
pip install virtualenv
mkdir dbt
cd dbt
virtualenv dbt_env -p python3.9
source dbt_env/bin/activate
pip install -r requirements.txt我们的 requirements.txt 应包含以下依赖:
dbt-core==1.8.6
dbt-bigquery==1.8.2
dbt-extractor==0.5.1
dbt-semantic-interfaces==0.5.1接下来,在本教程的其余部分我们将完成以下事项:
- 使用 Google 项目的服务账号,将 dbt 连接到 BigQuery。
- 创建示例模型并运行。
- 为模型添加数据质量与单元测试。
- 生成文档。
让我们为 dbt 应用创建服务账号凭据:
- 进入 Google Cloud IAM 控制台,在“Service Accounts”部分创建一个具有 BigQuery Admin 权限的服务账号:
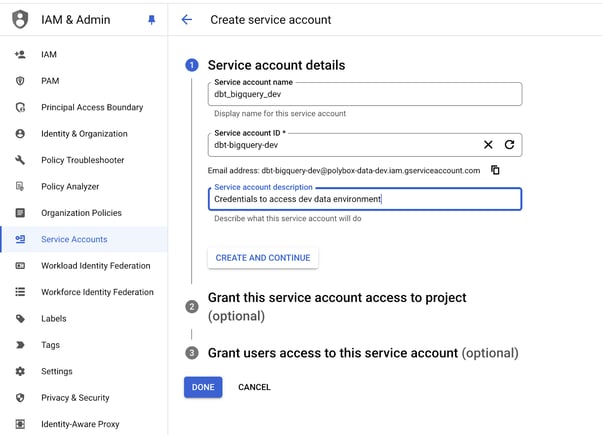
在 Google Cloud 中为 BigQuery 创建服务账号。图片作者自制。
- 为服务账号创建新的 JSON 密钥,并妥善保存,稍后会用到:
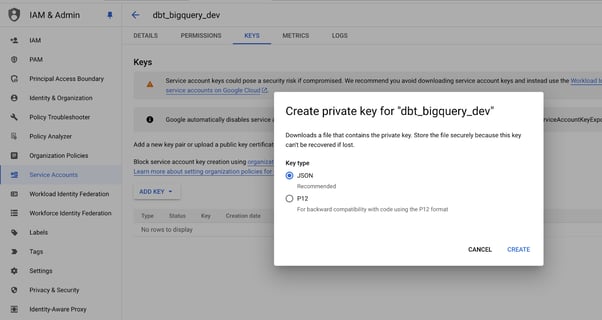
以 JSON 格式保存服务账号私钥。图片作者自制。
- 现在在终端运行
dbt init命令,初始化我们的 dbt 项目。
- 根据提示设置 dbt 项目参数,并指定 BigQuery 服务账号凭据的路径。
完成设置后,您应会看到类似如下的信息:
19:18:45 Profile my_dbt written to /Users/mike/.dbt/profiles.yml using target's profile_template.yml and your supplied values. Run 'dbt debug' to validate the connection.文件夹结构应类似如下:
.
├── my_dbt
│ ├── README.md
│ ├── analyses
│ ├── dbt_project.yml
│ ├── macros
│ ├── models
│ ├── polybox-data-dev.json
│ ├── seeds
│ ├── snapshots
│ └── tests
├── dbt_env
│ ├── bin
│ ├── lib
│ └── pyvenv.cfg
├── logs
│ └── dbt.log
├── readme.md
└── requirements.txt可以看到 profiles.yml 创建在本机用户根目录,但理想情况下我们希望将其置于应用目录中,因此将其移动过去。
cd my_dbt
touch profiles.yml最后,调整 profiles.yml 的内容,以反映我们的项目名称并加入 Google 服务账号凭据:
my_dbt:
target: dev
outputs:
dev:
type: bigquery
method: service-account-json
project: dbt_bigquery_dev # replace with your-bigquery-project-name
dataset: source
threads: 4 # Must be a value of 1 or greater
# [OPTIONAL_CONFIG](#optional-configurations): VALUE
# These fields come from the service account json keyfile
keyfile_json:
type: service_account
project_id: your-bigquery-project-name-data-dev
private_key_id: bd709bd92708a38ae33abbff0
private_key: "-----BEGIN PRIVATE KEY-----\nMIIEv...
...
...
...q8hw==\n-----END PRIVATE KEY-----\n"
client_email: some@your-bigquery-project-name-data-dev.iam.gserviceaccount.com
client_id: 1234
auth_uri: https://accounts.google.com/o/oauth2/auth
token_uri: https://oauth2.googleapis.com/token
auth_provider_x509_cert_url: https://www.googleapis.com/oauth2/v1/certs
client_x509_cert_url: https://www.googleapis.com/robot/v1/metadata/x509/educative%40bq-shakhomirov.iam.gserviceaccount.com就这样!我们可以开始编译项目了。
- 在命令行运行:
export DBT_PROFILES_DIR='.'
dbt compile输出应类似如下:
(dbt_env) mike@MacBook-Pro my_dbt % dbt compile
19:47:32 Running with dbt=1.8.6
19:47:33 Registered adapter: bigquery=1.8.2
19:47:33 Unable to do partial parsing because saved manifest not found. Starting full parse.
19:47:34 Found 2 models, 4 data tests, 479 macros
19:47:34
19:47:35 Concurrency: 4 threads (target='dev')初始项目搭建已完成。
dbt 项目结构
我们希望以便捷、透明的方式设计 dbt 项目,从而清晰地反映数据仓库的架构。
我建议在 dbt 项目中使用模板与宏,并引入自定义数据库名称,将数据环境有效划分为生产、开发与测试。
这种方式可提升组织性,并尽量降低在错误环境中被意外改动的风险,从而增强整体数据管理与工作流稳定性。通过这样做,我们可以更轻松地管理与维护这些环境,确保生产数据不会被试验或测试更改所影响。
不同环境中的数据库也可采用结构化且一致的命名方式,使用相关后缀(_prod、_dev、_test),既便于区分环境,也能平滑过渡与部署。
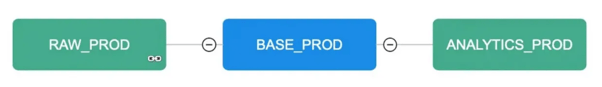
生产环境中的不同数据仓库层。图片作者自制。
例如,我们可以将主要数据模型层体现在数据库命名约定中,在数据库命名中使用 raw_ 与 base_ 前缀:
Schema/Dataset Tanle
RAW_DEV SERVER_DB_1 -- mocked data
RAW_DEV SERVER_DB_2 -- mocked data
RAW_DEV EVENTS -- mocked data
RAW_PROD SERVER_DB_1 -- real production data from pipelines
RAW_PROD SERVER_DB_2 -- real production data from pipelines
RAW_PROD EVENTS -- real production data from pipelines
...
BASE_PROD EVENTS -- enriched data
BASE_DEV EVENTS -- enriched data
...
ANALYTICS_PROD REPORTING -- materialized queries and aggregates
ANALYTICS_DEV REPORTING
ANALYTICS_PROD AD_HOC -- ad-hoc queries and views要动态注入这些自定义数据库名称,您只需创建一个 dbt 宏自动处理此任务。利用这种方式,您可以确保在相应的数据环境中使用正确的数据库名称,而无需每次手动编辑配置。
来看下面的代码片段,它包含一个根据当前环境设置不同 schema 的宏:
-- cd my_dbt
-- ./macros/generate_schema_name.sql
{% macro generate_schema_name(custom_schema_name, node) -%}
{%- set default_schema = target.schema -%}
{%- if custom_schema_name is none -%}
{{ default_schema }}
{%- else -%}
{{ custom_schema_name | trim }}
{%- endif -%}
{%- endmacro %}现在,每当我们编译模型时,dbt 会自动基于各模型的配置应用自定义数据库名称。这意味着在编译过程中会注入正确的数据库名称,确保模型与相应环境(生产、开发或测试)保持一致。
借此,我们无需再手动更改数据库名称,进一步提升工作流的高效与准确。
这些所需配置可以在模型的 properties.yml 中设置:
# my_dbt/models/example/properties.yml
version: 2
models:
- name: table_a
config:
description: "A starter dbt model"
schema: |
{%- if target.name == "dev" -%} raw_dev
{%- elif target.name == "prod" -%} raw_prod
{%- elif target.name == "test" -%} raw_test
{%- else -%} invalid_database
{%- endif -%}
columns:
- name: id
description: "The primary key for this table"
tests:
- unique
- not_null
- name: table_b
config:
description: "A starter dbt model"
schema: |
{%- if target.name == "dev" -%} analytics_dev
{%- elif target.name == "prod" -%} analytics_prod
{%- elif target.name == "test" -%} analytics_test
{%- else -%} invalid_database
{%- endif -%}
columns:
- name: id
description: "The primary key for this table"
tests:
- unique
- not_null如您所见,得益于 dbt 对 Jinja 的支持,我们可以在配置文件中使用基础的条件语句来引入逻辑。
宏在此上下文中不可用,但我们可以在 .yml 文件中使用简单的 Jinja 表达式条件,且需用引号包裹。这样可确保模板语言在执行时被正确解析。
让我们运行一次 dbt 编译命令看看效果:
(dbt_env) mike@Mikes-MacBook-Pro my_dbt % dbt compile -s table_b -t prod
18:43:43 Running with dbt=1.8.6
18:43:44 Registered adapter: bigquery=1.8.2
18:43:44 Unable to do partial parsing because config vars, config profile, or config target have changed
18:43:45 Found 2 models, 480 macros
18:43:45
18:43:46 Concurrency: 4 threads (target='prod')
18:43:46
18:43:46 Compiled node 'table_b' is:
-- Use the ref function to select from other models
select *
from dbt_bigquery_dev.raw_prod.table_a
where id = 1在 dbt 中使用变量
dbt 支持变量,这是非常强大的定制功能。变量可用于 SQL 模板与宏中,并可通过命令行传入,例如:
dbt run -m table_b -t dev --vars '{my_var: my_value}'变量必须在主项目文件 dbt_project.yml 中声明。下面的片段演示了如何声明:
name: 'my_dbt'
version: '1.0.0'
config-version: 2
...
...
...
# In this example config, we tell dbt to build all models in the example/
# directory as views. These settings can be overridden in the individual model
# files using the {{ config(...) }} macro.
models:
polybox_dbt:
# Config indicated by + and applies to all files under models/example/
example:
# +materialized: view
# schema: |
# {%- if target.name == "dev" -%} analytics_dev_mike
# {%- elif target.name == "prod" -%} analytics_prod
# {%- elif target.name == "test" -%} analytics_test
# {%- else -%} invalid_database
# {%- endif -%}
vars:
my_var: ""让我们用变量来在 dbt 中创建自定义表名(别名)。
如果未设置别名,模型的原始名称(文件名)会作为默认别名。该简单逻辑确保模型会依据配置的别名或默认名被引用,具体取决于设置。其实现方式如下,确保跨环境对模型命名与引用的灵活性:
-- get_custom_alias.sql
{% macro generate_alias_name(custom_alias_name=none, node=none) -%}
{%- if custom_alias_name -%}
{{ custom_alias_name | trim }}
{%- elif node.version -%}
{{ return(node.name ~ "_v" ~ (node.version | replace(".", "_"))) }}
{%- else -%}
{{ node.name }}
{%- endif -%}
{%- endmacro %}让我们用变量来覆盖这一行为。这是数据开发者在联调(开发)阶段常见的设置,以降低互相影响的风险。
我们希望将开发工程师的名字追加到其创建的所有数据库对象(表、视图等)上。
创建一个 generate_alias_name.sql 宏:
--my_dbt/macros/generate_alias_name.sql
{% macro generate_alias_name(custom_alias_name=none, node=none) -%}
{% set apply_alias_suffix = var('apply_alias_suffix') %}
{%- if custom_alias_name -%}
{{ custom_alias_name }}{{ apply_alias_suffix | trim }}
{%- elif node.version -%}
{{ return(node.name ~ "_v" ~ (node.version | replace(".", "_"))) }}
{%- else -%}
{{ node.name }}{{ apply_alias_suffix | trim }}
{%- endif -%}
{%- endmacro %}别忘了将新变量添加到 dbt_project.yml,并在命令行运行:
$ dbt compile -m table_b -t dev --vars '{apply_alias_suffix: _mike}'您应会看到类似如下的输出:
08:58:06 Running with dbt=1.8.6
08:58:07 Registered adapter: bigquery=1.8.2
08:58:07 Unable to do partial parsing because config vars, config profile, or config target have changed
08:58:07 Unable to do partial parsing because a project config has changed
08:58:08 Found 2 models, 481 macros
08:58:08
08:58:08 Concurrency: 4 threads (target='dev')
08:58:08
08:58:08 Compiled node 'table_b' is:
-- Use the ref function to select from other models
select *
from bigquery-data-dev.raw_dev.table_a_mike
where id = 1可以看到变量已添加到表名:table_a_mike。
数据模型分层
本节聚焦于我们如何从数据转换角度设计数据仓库。一个简化的 dbt 逻辑项目结构如下:
.
└── models
└── some_data_source
├── _data_source_model__docs.md
├── _data_source__models.yml
├── _sources.yml -- raw data table declarations
└── base -- base transformations, e.g. JSON to cols
| ├── base_transactions.sql
| └── base_orders.sql
└── analytics -- deeply enriched data prod grade data, QA'ed
├── _analytics__models.yml
├── some_model.sql
└── some_other_model.sql我个人始终尽量保持基础(base)数据模型层的干净与简洁,只在必要时进行数据转换。通过这种方式,我们力求将 base_ 数据模型层的处理限定在最小化的列级操作。
当然,在某些情况下,适度的处理有助于优化查询性能。这时,在基础层做一些小的调整就能显著提升效率,值得在简洁与性能之间取得平衡。例如,添加额外的 join 或分区过滤就是合理的。
推荐实践包括以下技巧,以增强数据模型与流水线:
- 在必要时,为最终的
biz_与mart_层对象使用持久化物化与聚簇。这有助于提升性能,并高效管理业务逻辑。 - 避免将 Google Sheets 作为数据源。其在处理大型数据集方面的局限可能带来不一致与性能瓶颈。
- 建议结合聚簇与增量谓词使用增量更新。
- 避免使用
select *的模式,并考虑将冗长且复杂的 SQL 文件拆分为更小的模型,并配套单元测试。 - 尽量不要使用 dbt seeds,因为它只支持 CSV 文件,并不适合在数据库中填充表数据。
- 可考虑通过自定义物化来播种测试数据库表。例如,使用 SQL 查询生成可在其他模型中引用的输出。此方式确保表在数据血缘图中被正确呈现,从而提升在数据基础设施内的可见性与追踪性。
参考下面的 SQL 查询。它说明了如何创建这样的自定义物化:
-- my_dbt/macros/operation.sql
{%- materialization operation, default -%}
{%- set identifier = model['alias'] -%}
{%- set target_relation = api.Relation.create(
identifier=identifier, schema=schema, database=database,
type='table') -%}
-- ... setup database ...
-- ... run pre-hooks...
-- build model
{% call statement('main') -%}
{{ run_sql_as_simple_script(target_relation, sql) }}
{%- endcall %}
-- ... run post-hooks ...
-- ... clean up the database...
-- COMMIT happens here
{{ adapter.commit() }}
-- Return the relations created in this materialization
{{ return({'relations': [target_relation]}) }}
{%- endmaterialization -%}
-- my_dbt/macros/operation_helper.sql
{%- macro run_sql_as_simple_script(relation, sql) -%}
{{ log("Creating table " ~ relation) }}
{{ sql }}
{%- endmacro -%}现在,若新增一个名为 table_c 的模型来演示此特性,我们可以使用以下 SQL:
-- my_dbt/models/example/table_c.sql
{{ config(
materialized='operation',
tags=["example"]
) }}
create or replace table {{this.database}}.{{this.schema}}.{{this.name}} (
id int64
,comments string
);
insert into {{this.database}}.{{this.schema}}.{{this.name}} (id, comments)
select
1 as id
, 'Some comments' as comments
union all
select
2 as id
, 'Some comments' as comments
;现在编译它,输出应呈现为一个 SQL 脚本:
$ dbt compile -m table_c -t dev输出:
10:45:24 Running with dbt=1.8.6
10:45:25 Registered adapter: bigquery=1.8.2
10:45:25 Found 3 models, 483 macros
10:45:25
10:45:26 Concurrency: 4 threads (target='dev')
10:45:26
10:45:26 Compiled node 'table_c' is:
-- Use the ref function to select from other models
create or replace table bigquery-data-dev.source.table_c (
id int64
,comments string
);
insert into bigquery-data-dev.source.table_c (id, comments)
select
1 as id
, 'Some comments' as comments
union all
select
2 as id
, 'Some comments' as comments
;这种方式的好处是,我们不再需要依赖 BigQuery 适配器。如果创建另一个引用此操作的表或视图,只需使用标准的 ref() 函数即可。
这样一来,table_c 会自动作为数据血缘中的依赖被识别。便于追踪各表之间的关系,并确保不同模型之间的关系在您的数据环境中被正确记录。
该方法有助于管理依赖,并清晰展现数据如何流经各个阶段,包括涉及脚本的复杂数据处理步骤。这对于维护复杂的数据流水线尤为有用。
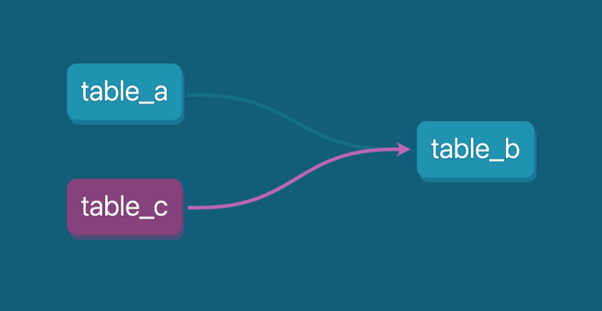
dbt 中的 DAG(有向无环图)展示了 table_b 的依赖关系。图片作者自制
现在,我们只需将 table_c 加入流水线:
-- models/example/table_b.sql
{{ config(
tags=["example"]
) }}
select *
from {{ ref('table_a') }}
where id = 1
union all
select *
from {{ ref('table_c') }}
where id = 2
-- select 1;运行以下命令即可自动生成文档!
dbt docs generate
dbt docs serve一个更高级的 dbt 数据仓库项目示例可能如下结构。它包含多个数据源,并通过各类模型层(stg、base、mrt、biz)进行转换,最终产出数据集市模型。
└── models
├── int -- only if required and 100% necessary for reusable logic
│ └── finance
│ ├── _int_finance__models.yml
│ └── int_payments_pivoted_to_orders.sql
├── marts -- deeply enriched, QAed data with complex transformations
│ ├── finance
│ │ ├── _finance__models.yml
│ │ ├── orders.sql
│ │ └── payments.sql
│ └── marketing
│ ├── _marketing__models.yml
│ └── customers.sql
└── src (or staging) -- raw data with basic transformations applied
├── some_data_source
│ ├── _data_source_model__docs.md
│ ├── _data_source__models.yml
│ ├── _sources.yml
│ └── base
│ ├── base_transactions.sql
│ └── base_orders.sql
└── another_data_source
├── _data_source_model__docs.md
├── _data_source__models.yml
├── _sources.yml
└── base
├── base_marketing.sql
└── base_events.sql模型逻辑的单元测试
单元测试是数据流水线过程中的关键步骤,我们可以据此验证数据模型背后的逻辑。就像您会为 Python 函数编写单元测试以确保其按预期运行一样,我也采用类似方法来测试数据模型。
通过运行这些测试,我们能及早发现潜在问题,并确保转换与逻辑正确运行。这一实践有助于维护数据质量,防止错误在流水线中扩散,是数据工程流程中至关重要的一环。
我们可以仅通过修改 properties.yml 文件为模型添加单元测试:
# my_dbt/models/example/properties.yml
version: 2
models:
...
unit_tests: # dbt test --select "table_b,test_type:unit"
- name: test_table_b
description: "Check my table_b logic captures all records from table_a and table_c."
model: table_b
given:
- input: ref('table_a')
rows:
- {id: 1, comments: 'Some comments'}
- {id: 2, comments: 'Some comments'}
- input: ref('table_c')
rows:
- {id: 1, comments: 'Some comments'}
- {id: 2, comments: 'Some comments'}
expect:
rows:
- {id: 1, comments: 'Some comments'}
- {id: 2, comments: 'Some comments'}现在在命令行运行 dbt test 命令,即可执行单元测试:
% dbt test --select "table_b,test_type:unit"输出如下:
11:33:05 Running with dbt=1.8.6
11:33:06 Registered adapter: bigquery=1.8.2
11:33:06 Unable to do partial parsing because config vars, config profile, or config target have changed
11:33:07 Found 3 models, 483 macros, 1 unit test
11:33:07
11:33:07 Concurrency: 4 threads (target='dev')
11:33:07
11:33:07 1 of 1 START unit_test table_b::test_table_b ................................... [RUN]
11:33:12 1 of 1 PASS table_b::test_table_b .............................................. [PASS in 5.12s]
11:33:12
11:33:12 Finished running 1 unit test in 0 hours 0 minutes and 5.77 seconds (5.77s).
11:33:12
11:33:12 Completed successfully
11:33:12 将 expect 中的行 id 改为 3,再运行同一测试,就会报错:
11:33:28 Completed with 1 error and 0 warnings:
11:33:28
11:33:28 Failure in unit_test test_table_b (models/example/properties.yml)
11:33:28
actual differs from expected:
@@ ,id,comments
,1 ,Some comments
+++,2 ,Some comments
---,3 ,Some comments数据质量测试
dbt 同样支持数据质量检查。我之前在数据契约博文中也有提到。我们几乎可以检查与数据质量相关的一切,如数据新鲜度、行级条件、粒度等。
来看一下我们的 table_b 模型。它已经包含了一些数据检查:
- name: table_b
config:
description: "A starter dbt model"
schema: |
{%- if target.name == "dev" -%} analytics_dev
{%- elif target.name == "prod" -%} analytics_prod
{%- elif target.name == "test" -%} analytics_test
{%- else -%} invalid_database
{%- endif -%}
columns:
- name: id
description: "The primary key for this table"
tests:
- unique
- not_null这里在 tests 定义下,我们对物化后的 table_b.id 进行了 unique 与 not_null 的测试。运行该特定测试可使用以下命令:
dbt test -s table_b我们也可以测试数据集的参照完整性。这在有 join 的数据模型中至关重要,可确保实体之间的关系被准确维护。这些测试有助于定义不同实体(如表或列)之间如何关联。
例如,下面的 dbt 代码展示了如何确保每个 refunds.refund_id 都关联到合法的 transactions.id。此映射确保所有退款都与有效交易相对应,维护数据完整性,避免出现孤立记录或不一致的关系:
- name: refunds
enabled: true
description: An incremental table
columns:
- name: refund_id
tests:
- relationships:
tags: ['relationship']
to: ref('transactions')
field: id数据需求通常涉及规定何时应有新数据可用,并设定更新的最大允许延迟。这些检查对于确保数据对分析保持时效性(最新)至关重要。
在 dbt 中,这可以通过新鲜度测试来实现,用以监控新数据是否在预期时间范围内到达。
例如,您可以配置新鲜度测试,验证某张表中最新记录是否符合您定义的新鲜度标准。这样可确保数据流水线及时且稳定地提供更新,帮助在满足时效性要求的同时,维持数据的可靠性与准确性。
参考下面的代码片段。它说明了如何在 dbt 中设置新鲜度测试:
# example model
- name: orders
enabled: true
description: A source table declaration
tests:
- dbt_utils.recency: # https://github.com/dbt-labs/dbt-utils#recency-source
tags: ['freshness']
datepart: day
field: timestamp
interval: 1这些 dbt 测试非常出色,也是在数据工程师日常工作中极其实用的工具!它们有助于保持数据仓库的良好维护,并确保数据流水线的一致性。
结语
构建数据仓库解决方案是一项复杂工作,需要周密的规划与组织。作为模板引擎,dbt 有助于以一致的方式完成这项工作。
在本文中,我介绍了若干用于组织 dbt 数据转换目录的技巧,以提升清晰度与协作性。通过以逻辑结构存放 SQL 文件,我们为项目新成员也打造了易于探索的环境。
DBT 还提供了丰富的特性以进一步简化流程。例如,我们可以通过宏、变量与常量将可复用代码块融入 SQL 模板。依我经验,当与基础设施即代码实践结合时,这些功能有助于强化 CI/CD 工作流,显著加速开发与部署。
如果您想进一步提升 dbt 知识,建议学习 DataCamp 的 Introduction to dbt 课程。它是非常优秀的资源,能以更多实操练习帮助您顺利起步!
FAQs
dbt 可以与任意数据库一起使用吗?
dbt 适配多种云数据仓库与数据库,例如 Snowflake、BigQuery、Redshift 与 PostgreSQL。每种受支持的数据库都有其对应的适配器,您需要单独安装。
使用 dbt 需要编程技能吗?
需要具备基础 SQL 知识,因为 dbt 专注于基于 SQL 的转换。具备更高级的技能(如 Python)可增强 dbt 的能力,尤其在使用 dbt 扩展或自动化工作流时。
dbt 只适用于云端数据仓库吗?
虽然 dbt 最常用于云端数据仓库,但它也可与本地数据库配合使用。不过,云端仓库提供更强的可扩展性,dbt 与之配合更为契合。
dbt 可以集成到 CI/CD 工作流中吗?
是的!dbt 旨在在 CI/CD 流水线中工作,支持自动化、测试与版本控制。您可以使用 GitHub Actions 或 Jenkins 等工具将 dbt 集成到 CI/CD 工作流中,以确保健壮的数据模型测试与部署。
dbt 可以用于流式数据吗?
dbt 主要面向批处理,而非流式数据。不过,对于近实时需求,您可以结合增量模型按设定频率更新数据,具体取决于新鲜度要求。
dbt Cloud 与 dbt Core 有何区别?
dbt Core 是免费的开源版本,您可以在本地或自有云环境中运行。dbt Cloud 是托管服务,包含 UI、作业调度与 Git 集成等额外功能,更利于团队协作。
dbt 能处理非 SQL 的转换吗?
dbt 专注于 SQL 转换,因此原生不支持非 SQL 转换。但由于 dbt 模块化设计,您可以集成外部工具;若需要更复杂的处理,也可加入自定义脚本。

热爱数字化并专注于此,我在数字营销的挑战中如鱼得水。
在移居英国之前,我在销售、公司银行风险与数字营销领域积累了十余年的经验,形成了在风险管理、数学建模、统计分析、工商管理以及市场营销方面的专业能力。
在完成纽卡斯尔的MBA后,我渴望投身于数据驱动营销、计算机科学或人工智能方向,并有机会继续攻读博士学位。这些领域兼具科学的实际应用、持续的职业发展、创新性,以及为充满活力的行业做出贡献的机会。
在本文中,我将梳理一些有助于学习 dbt、简化项目搭建与数据建模的技巧,使整体流程更易管理。
此外,我还会介绍我在日常工作中依赖的特定 dbt 项目设计模式。这些方法在构建准确、直观、易于导航且对用户友好的数据平台与数据仓库方面价值非凡。
采用这些方法,能够在尽量减少潜在问题的同时,更轻松地打造符合高质量标准的数据平台,最终推动数据驱动项目更为成功。
什么是 dbt?
dbt(Data Build Tool) 是一款强大的开源数据建模解决方案,通过 SQL 模板与
ref()(引用)函数在表、视图、架构等不同数据库对象之间建立关系。它的灵活性非常适合遵循 DRY(Don’t Repeat Yourself,不要重复自己)原则的实践者。借助 dbt,您可以创建可复用、并能轻松适配不同数据环境的单一 SQL 模板。模板编写完成后,可被“编译”为在各个特定环境中执行所需的 SQL 查询。
dbt 的这种方式提升了效率,并确保数据流水线各阶段的一致性,在简化维护与扩展数据基础设施的同时,降低冗余与潜在错误。
数据建模在数据工程中居于核心地位,而 dbt 是出色的工具。事实上,我认为,想要成为成功的数据从业者,精通 dbt 几乎是必不可少的!
来看下面这个 dbt 模板。它是一个简单的表定义,但同时自带元数据,告知用户应使用哪个数据库与架构:
假设在数据流水线的下游,我们基于上面创建的表(
table_a.sql)产出一个视图。那么,我们的数据血缘大致如下:示例数据流水线血缘。图片作者自制。
我们将使用
ref()函数连接流水线的两个阶段。在本例中,table_b.sql可按如下方式定义:ref()函数表明table_b模型位于table_a之后(下游)。现在我们只需一个 dbt 命令即可整体运行该流水线:dbt run --select tag:example。得益于代码可复用能力,dbt 提供了使其成为在不同数据环境(生产、开发、测试等)中管理与优化数据工作流的绝佳工具的诸多特性。
另外,其核心功能之一是自动生成完整的 SQL 文档,这极大提升了透明度,并让数据开发者与业务方更容易理解数据模型。
数据建模的一大挑战是构建包含多层的复杂 SQL 转换流水线,同时保证代码可复用。这类流水线需要深思熟虑与严谨的测试,以确保高效运行并维持组织内的透明度,让所有人都能理解其逻辑。dbt 在这方面同样有所助益。
此外,dbt 支持数据质量测试与 SQL 逻辑的单元测试,帮助您以结构化、自动化的方式验证转换的准确性与可靠性(CI/CD 工作流)。
另一个关键特性是其通过宏实现的灵活自动化,宏允许创建可定制、可复用的代码片段,从而简化复杂任务并提升效率。
这些功能相结合,使 dbt 成为处理各类与 SQL 相关任务与数据环境的理想方案:既能保障数据完整性,也可自动化重复流程,同时兼顾效率与可扩展性。
接下来动手实践,使用 dbt 与 BigQuery 作为数据平台来运行一些示例!