
Cursus
Introductie tot dbt
4 uur
34K
dbt Cloud is uitgegroeid tot de toonaangevende beheerde service voor datatransformatie, en ondersteunt moderne analytics-teams met schaalbare, betrouwbare en collaboratieve workflows.
Het breidt de kracht van dbt Core uit en biedt een gehoste omgeving die deployments automatiseert, jobs orkestreert, referenties beheert en samenwerkingsfuncties voor datateams levert.
Dit stelt organisaties in staat SQL-gebaseerde transformaties te beheren in een veilige, geautomatiseerde en teamvriendelijke omgeving.
In deze introductietutorial lopen we door wat dbt Cloud is, hoe je het instelt en voorbeelden van hoe het gebruikt kan worden.
Als je nieuw bent met het framework en liever een gestructureerd leerpad volgt, raad ik je aan te beginnen met onze cursus Introduction to dbt.
Laten we beginnen met een overzicht van wat dbt Cloud is en enkele van de functies.
In de kern stelt dbt Cloud teams in staat de ELT (Extract, Load, Transform)-aanpak te volgen. In tegenstelling tot traditionele ETL-processen, waarbij transformaties plaatsvinden vóór het laden in het datawarehouse, voert dbt transformaties uit ín het warehouse, gebruikmakend van de rekenkracht en schaalbaarheid daarvan.
Bron: dbt
dbt Cloud vereenvoudigt het datatransformatieproces doordat het:
dbt Cloud bestaat uit dezelfde concepten als dbt Core.
Deze omvatten:
Een typische dbt Cloud-workflow ziet er zo uit: Modellen ontwikkelen > Transformaties testen > Committen naar Git > Deployen via dbt Cloud-jobs > Runs monitoren in dbt Cloud.
Om uit te leggen hoe dbt Cloud werkt, bekijken we een praktisch voorbeeld van hoe je zelf een omgeving instelt.
Aan de slag gaan met dbt Cloud is eenvoudig, want het is ontworpen voor snelle onboarding. Dit zijn de stappen die je moet nemen:
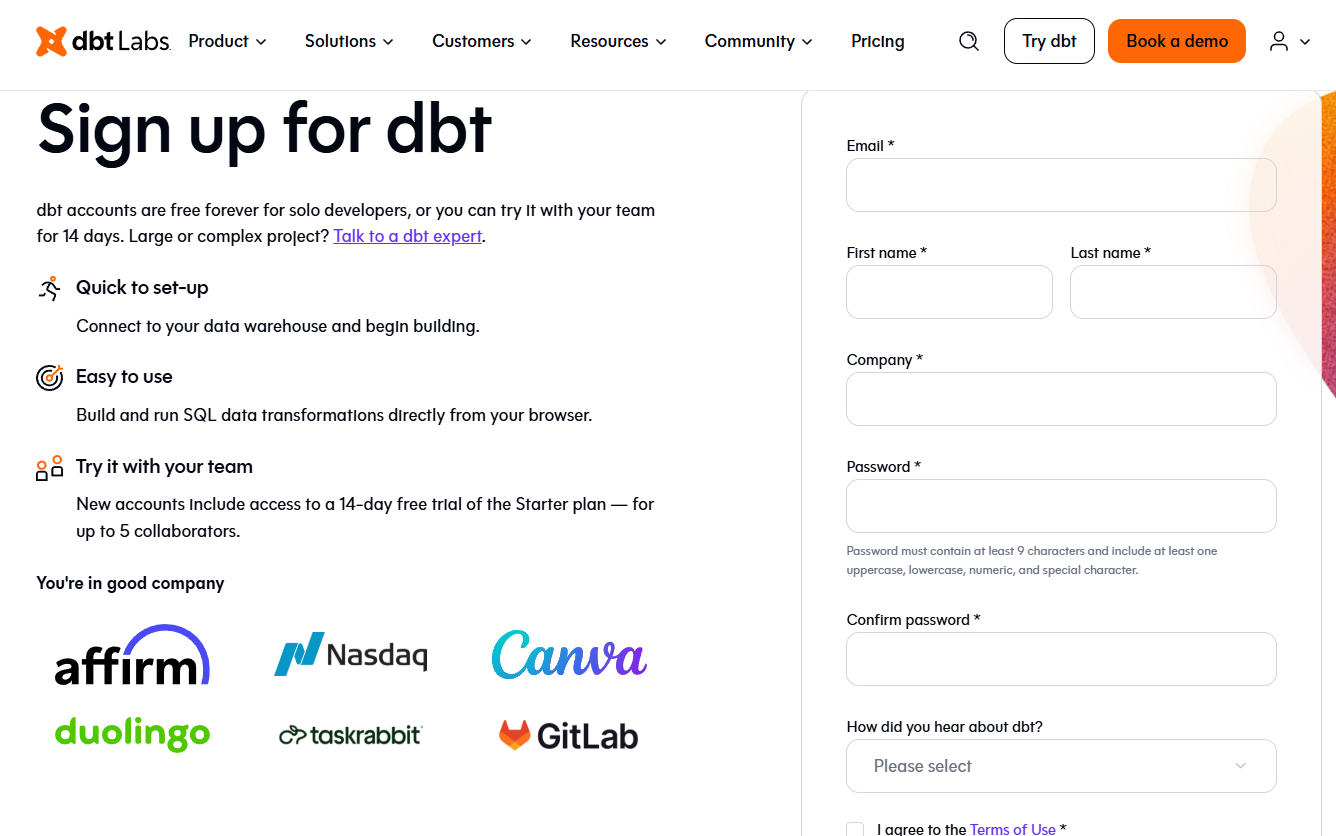
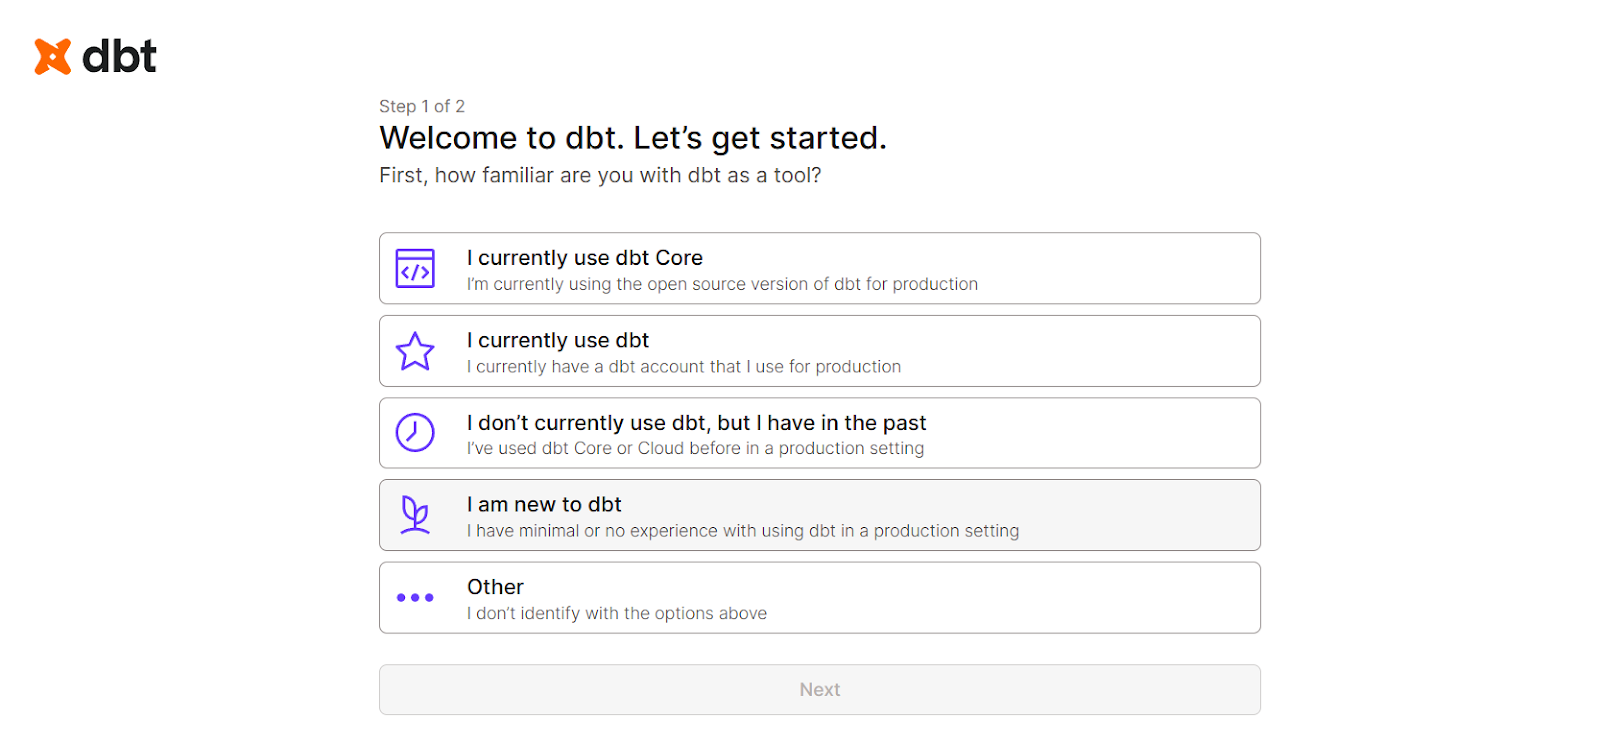
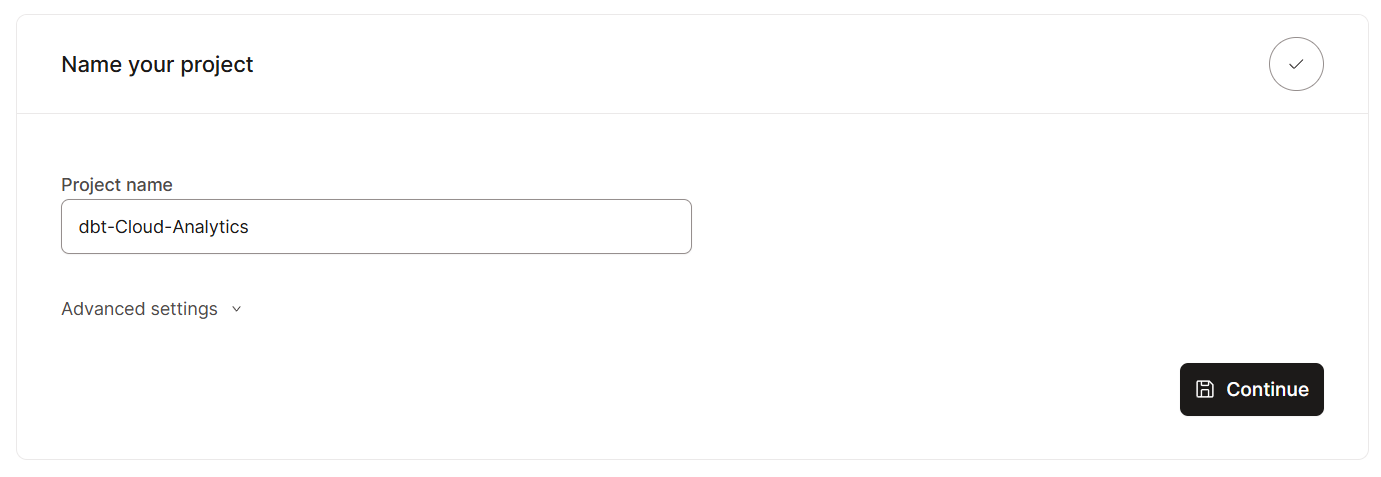
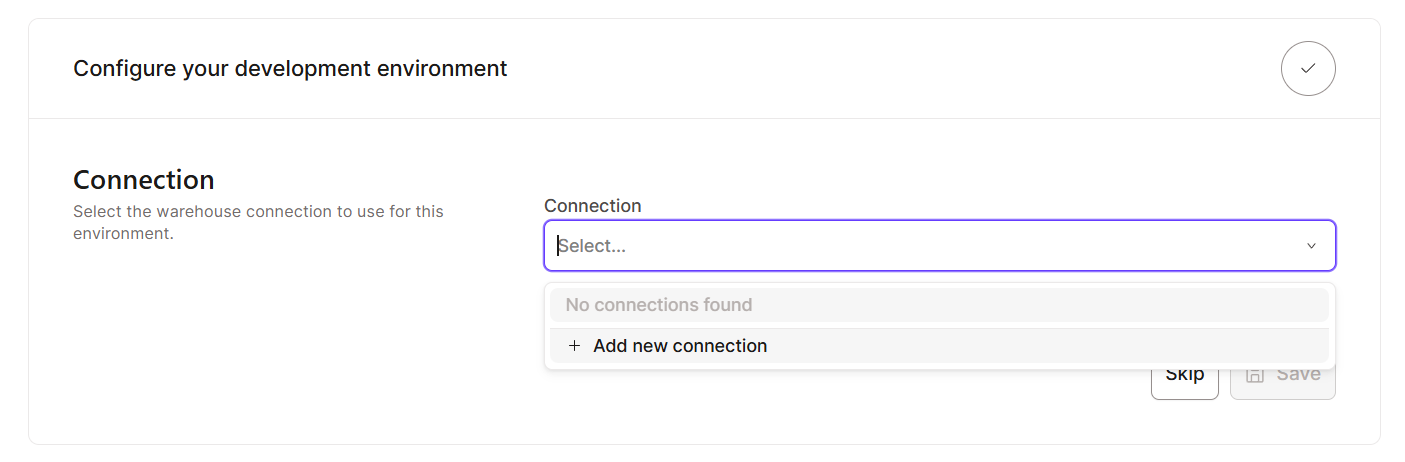
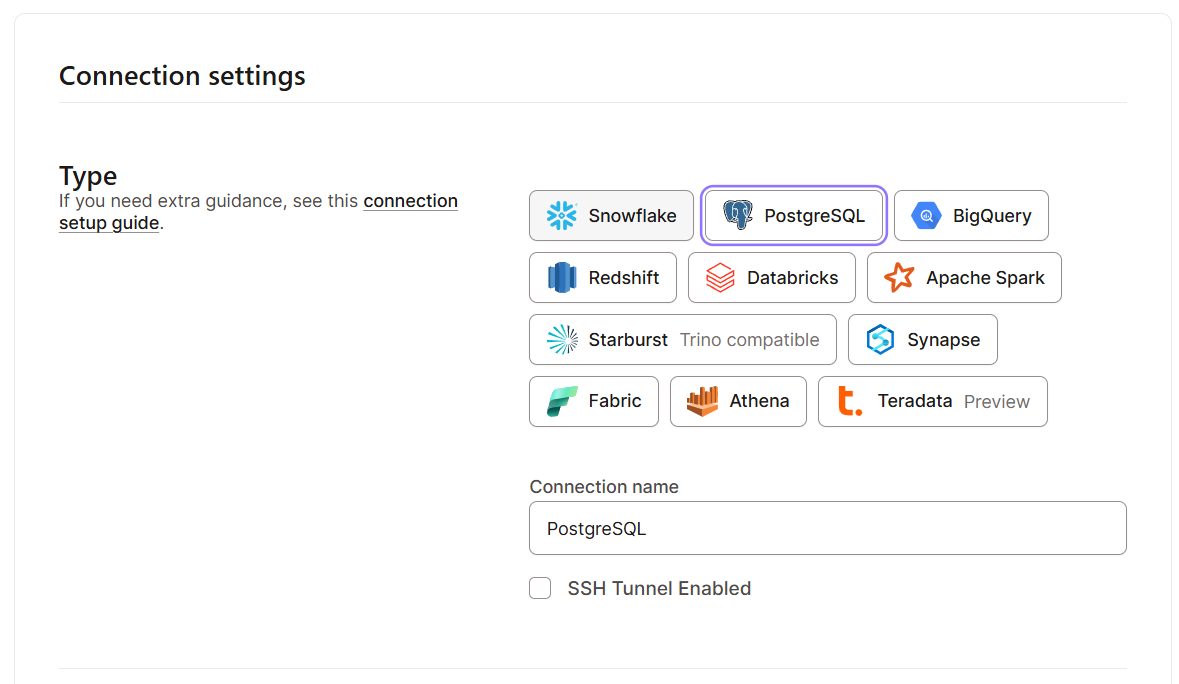
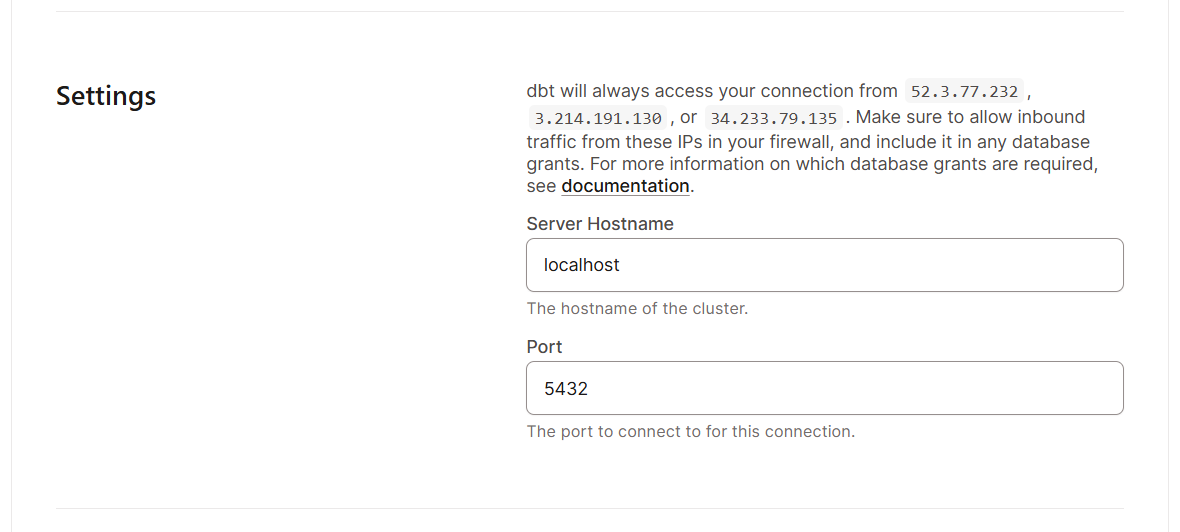
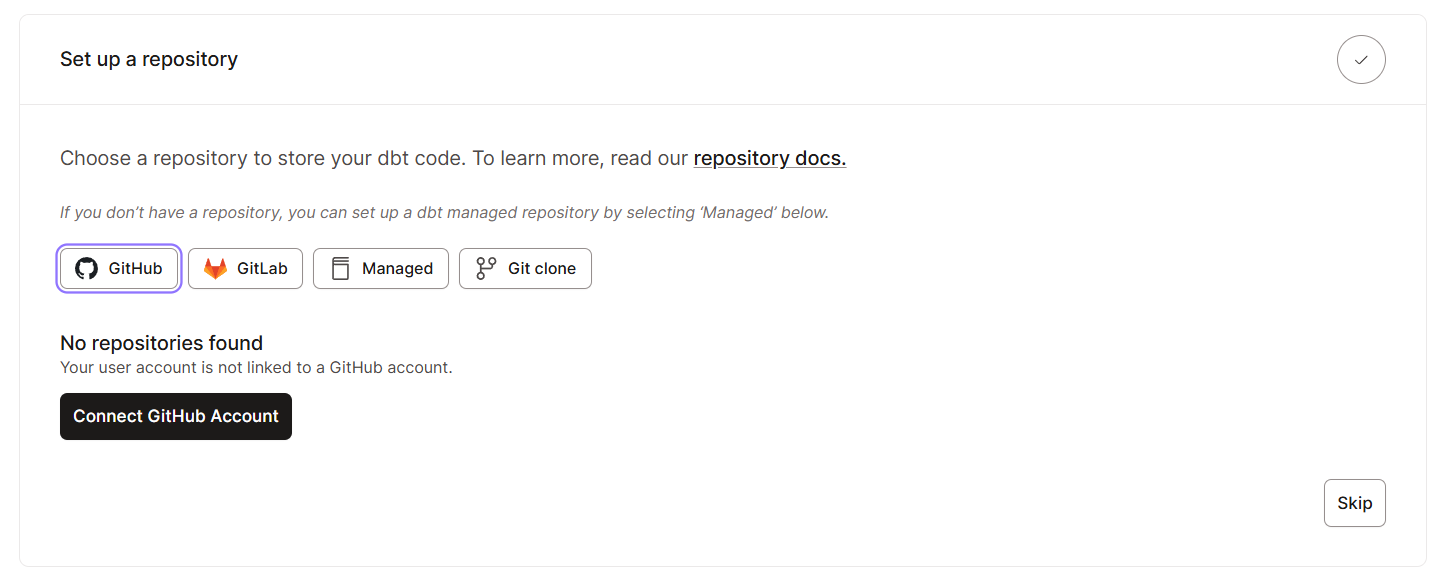
Zodra je de basisinstellingen hebt afgerond, gaan we de interface verkennen. Dit is wat je kunt verwachten te zien in de dbt Cloud-interface:
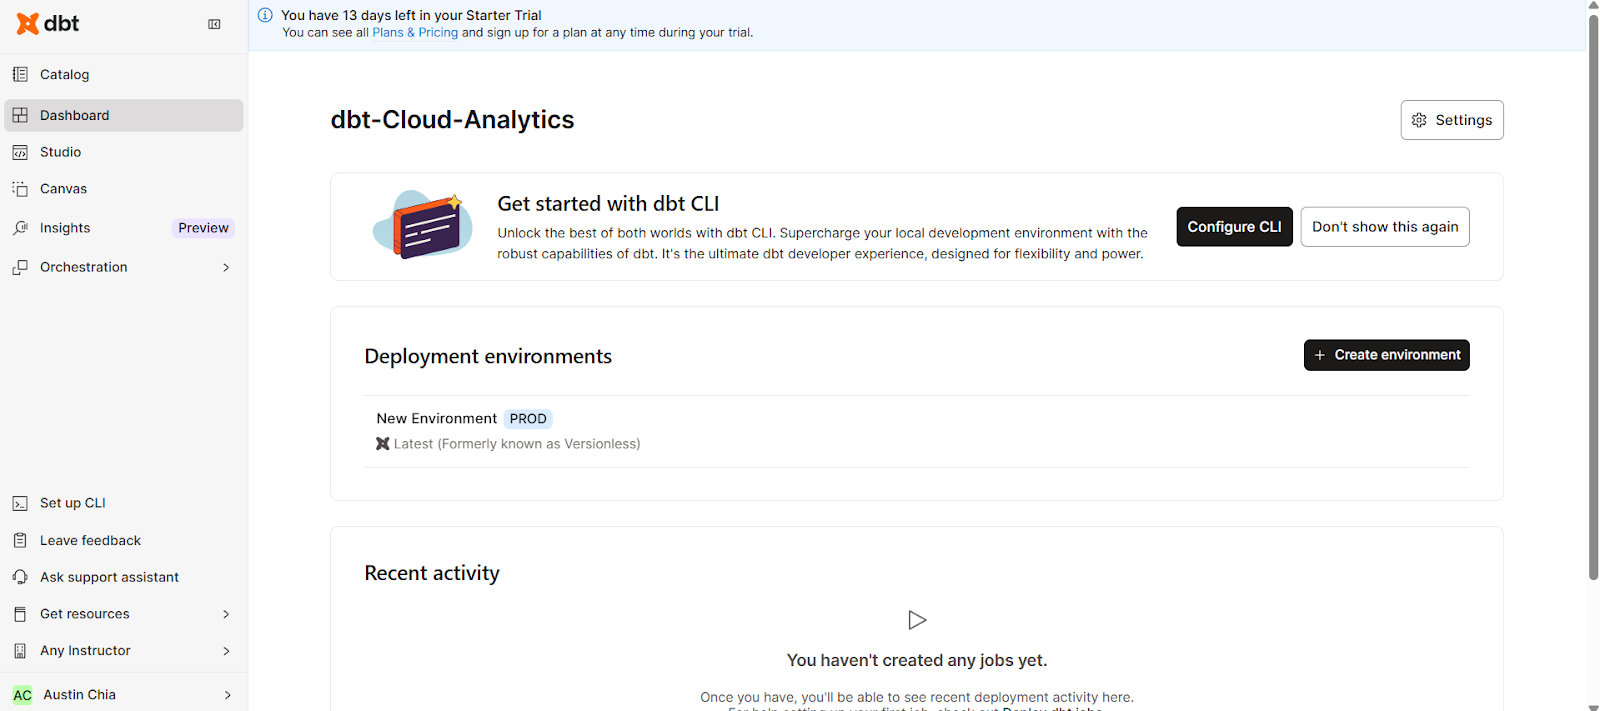
De dbt Cloud-UI organiseert je workflow efficiënt. Via de navigatiebalk krijg je toegang tot de volgende kernonderdelen:
Dit bundelt alle benodigde informatie, de codeerstudio en configuratie-instellingen in één webinterface.
dbt Cloud biedt ook een browsergebaseerde IDE, speciaal gemaakt voor analytics engineering met GitHub-integratie. Deze is gemaakt om dbt-projecten te bouwen, draaien, testen en onder versiebeheer te zetten vanuit je browser.
De dbt Cloud IDE vereist geen lokale setup, wat de onboarding voor analisten vergemakkelijkt. Je opent hem via het tabblad Studio aan de linkerkant van de interface.
Hiermee krijg je een eenvoudige interface om code te schrijven, te compileren en uit te voeren.
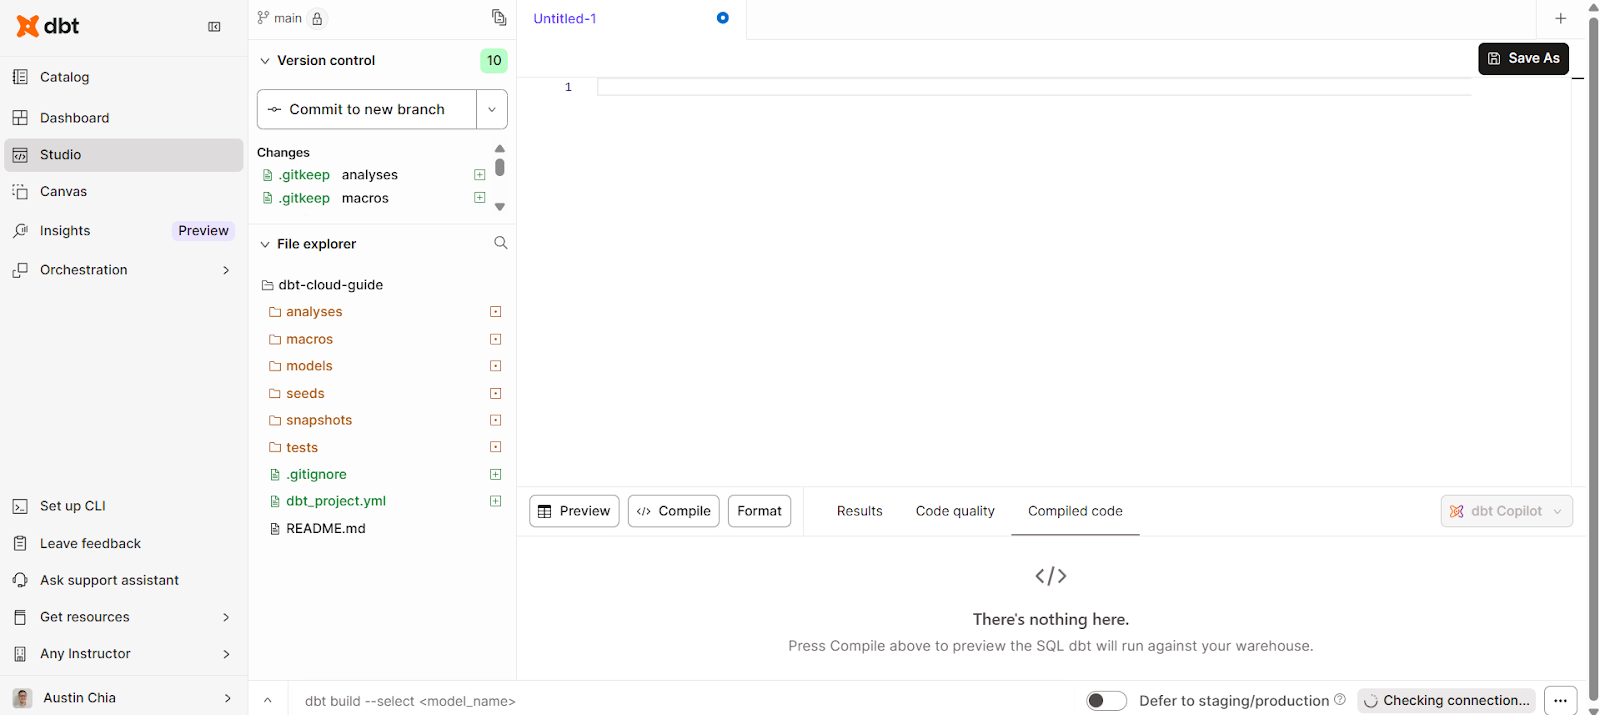
Met de dbt Cloud IDE kun je het volgende doen:
Daarnaast kun je in dbt Cloud integreren met GitHub voor versiebeheer.
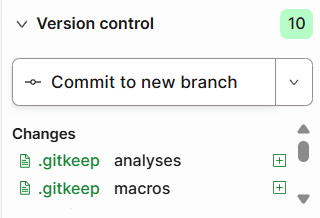
Deze functie biedt je de mogelijkheid om:
Net als in dbt Core kun je ook in dbt Cloud datamodellen bouwen en testen. Laten we kijken hoe je dat kunt doen.
Bij het werken met datamodellen zul je waarschijnlijk transformaties moeten uitvoeren. In de dbt Cloud IDE kunnen we SQL-statements schrijven binnen de Studio.
Je kunt een datamodel maken om te transformeren zoals hier:
with source as (
    select * from {{ source('raw', 'orders') }}
)
select
    id as order_id,
    user_id,
    order_date,
    status
from source
Zo ziet de interface eruit:
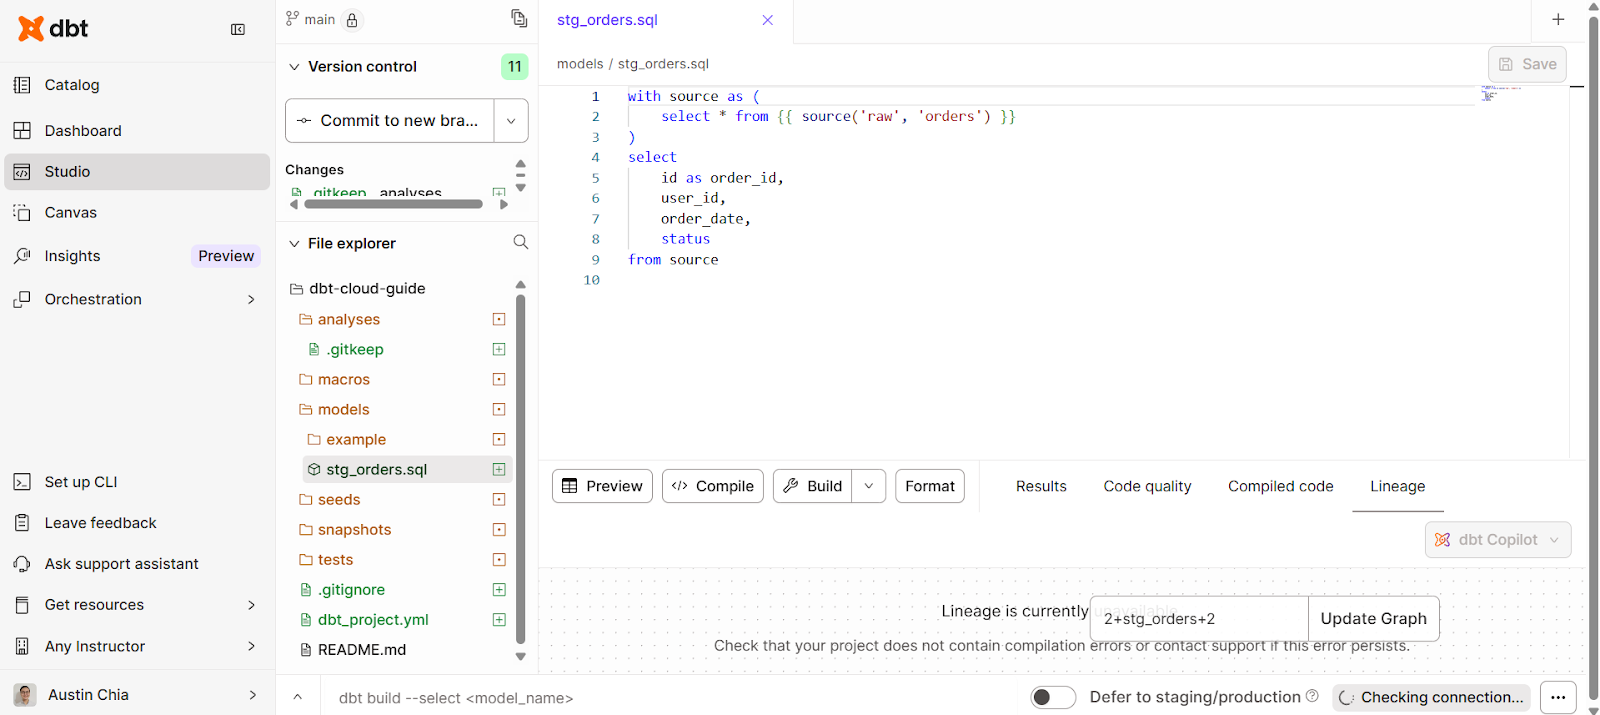
Enkele best practices om rekening mee te houden:
Daarnaast kun je tests definiëren in YAML voor geautomatiseerde controles:
models:
  - name: stg_orders
    columns:
      - name: order_id
        tests:
          - not_null
          - unique
      - name: status
        tests:
          - accepted_values:
              values: ['completed', 'pending', 'cancelled']
Het testen van je data vergroot het vertrouwen in transformaties. Zo zorg je ervoor dat alle jobs die je draait tests ingebouwd hebben om de integriteit te bewaken.
Als je een gevorderde gebruiker bent, kun je ook aangepaste tests definiëren met Jinja en SQL.
In dbt Cloud ondersteunen jobplanning en orkestratie de automatisering van analytics. Ze zorgen ervoor dat je transformaties consistent, op tijd en in de juiste omgeving draaien met minimale handmatige interventie.
Dit onderdeel behandelt hoe je jobs plant, automatisch triggert en de prestaties in realtime monitort.
Binnen de dbt Cloud-interface kun je:
Zo maak je een jobplanning in dbt Cloud:
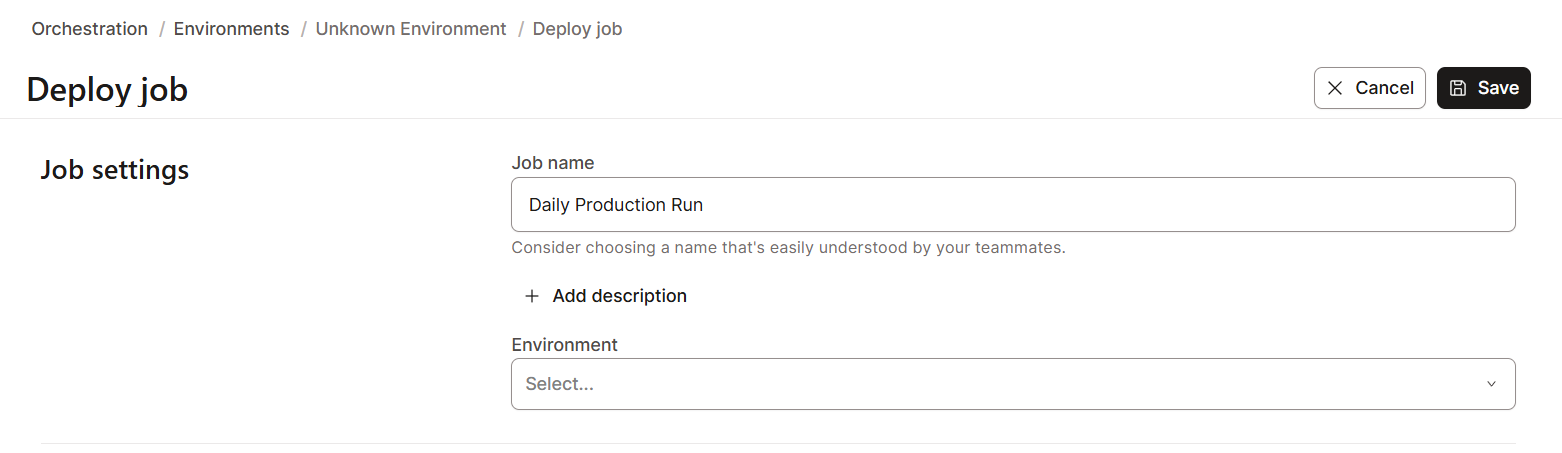
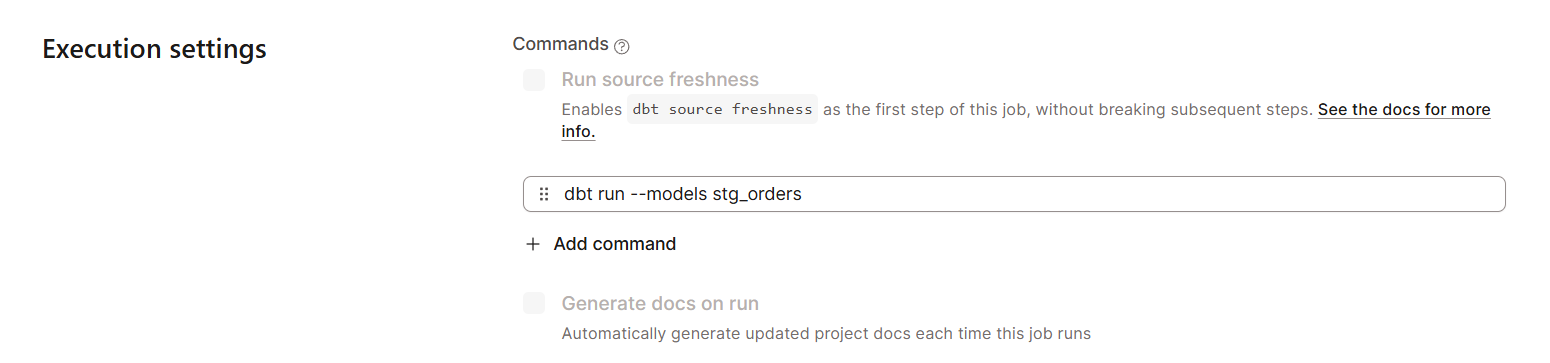
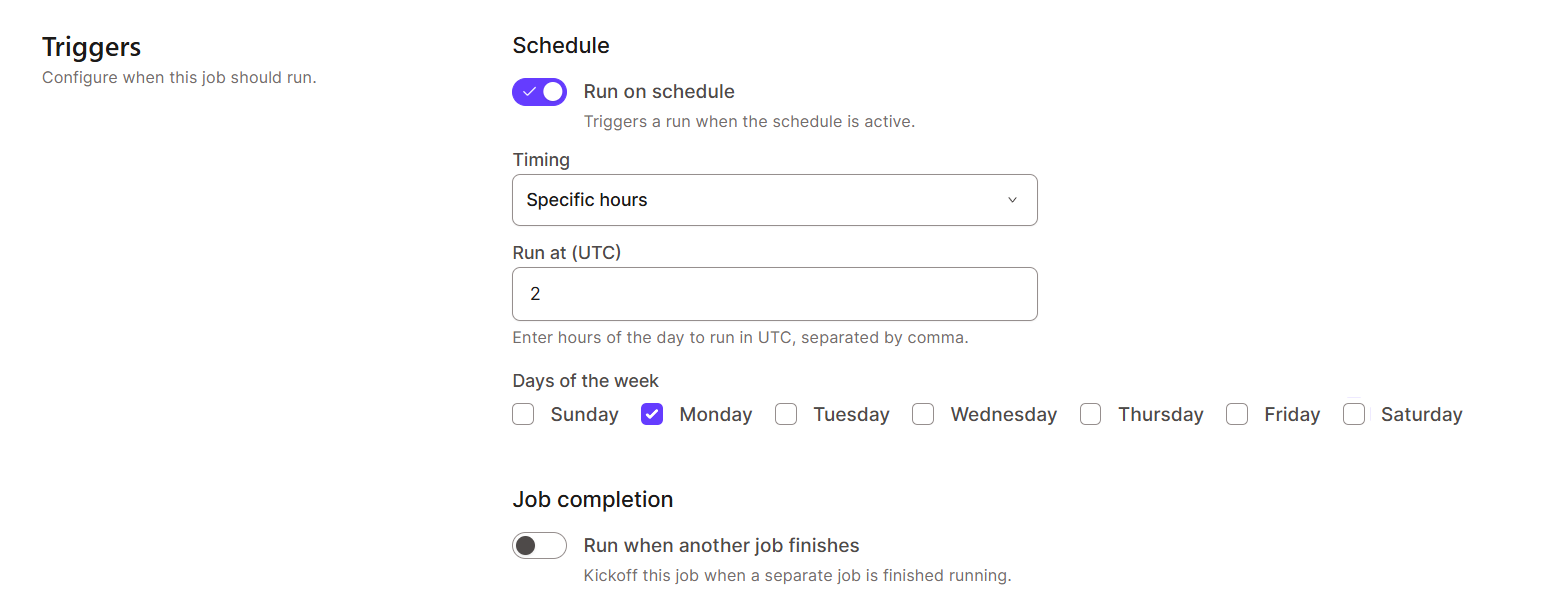
dbt Cloud ondersteunt monitoring- en loggingfuncties voor betere data-observeerbaarheid. Dit is essentieel voor het oplossen van fouten en het optimaliseren van prestaties.
Het stelt je in staat om:
Naast de kernfuncties voor modelleren en orkestratie biedt dbt Cloud geavanceerde features die intelligentie, consistentie en automatisering brengen naar moderne analytics-workflows.
Je vindt ze in twee hoofdonderdelen: de dbt Semantic Layer en AI-gestuurde tools zoals dbt Copilot en Fusion.
De dbt Semantic Layer biedt een centrale, beheerde laag waarin teams bedrijfsmetrics consistent en onder versiebeheer kunnen definiëren, beheren en beschikbaar stellen.
Het helpt om:
Deze uniforme laag overbrugt de kloof tussen datatransformatie en visualisatie via koppelingen met gangbare BI-tools.
Voor een hands-on voorbeeld, bekijk deze tutorial over een semantic layer implementeren met dbt.
Een van de nieuwste functies van dbt, dbt Copilot, is een AI-assistent die rechtstreeks is ingebouwd in de IDE van dbt Cloud. Het helpt ontwikkelaars dbt-code te schrijven, debuggen en optimaliseren met natuurlijke taalprompts en contextbewuste suggesties.
Met dbt Copilot kun je:
De Fusion-engine is een nieuwe engine, geschreven in Rust, ter vervanging van dbt Core, met veel meer functies.
Die brengt enkele use-cases, zoals:
In datatransformatieworkflows zijn beveiliging en governance niet onderhandelbaar. Daarom is dbt Cloud ook gebouwd met beveiligingscontroles op ondernemingsniveau om gevoelige informatie te beschermen, compliance te handhaven en verantwoording binnen teams te borgen.
dbt Cloud gebruikt role-based access control (RBAC) om gebruikersrechten te beheren en de toegang tot kritieke assets zoals projecten, omgevingen en referenties te beperken.
Mogelijke rollen zijn onder andere:
Zo configureer je toegangsbeheer in dbt Cloud:
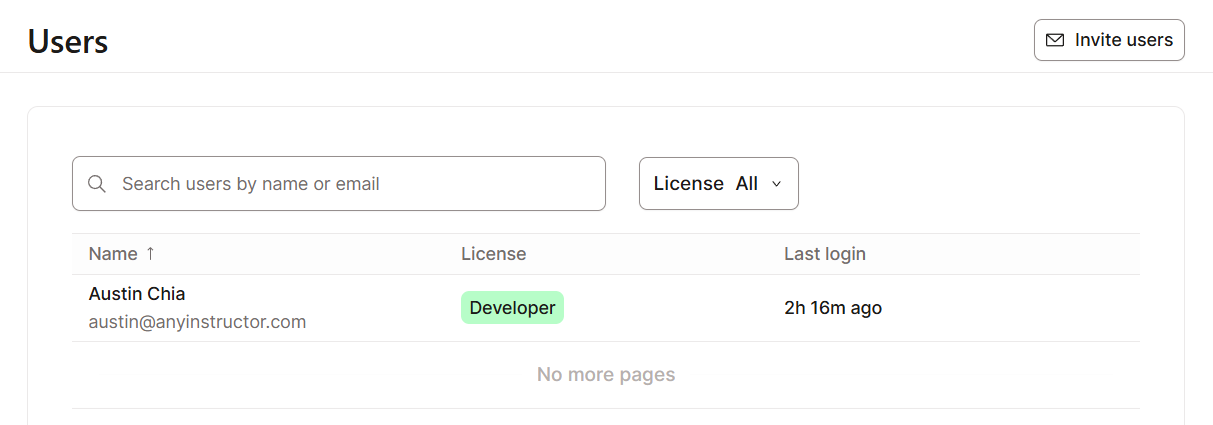
dbt Cloud bevat uitgebreide auditlogging en compliancefuncties die zijn ontworpen om organisaties te helpen voldoen aan strenge data governance-eisen, in overeenstemming met standaarden zoals SOC 2, AVG (GDPR) en andere.
Auditlogs maken het ook mogelijk om issues te onderzoeken, en SCIM-ondersteuning verbetert de integratie met identity management.
Een van de grootste sterkten van dbt Cloud is het naadloos kunnen verbinden met het bredere data-ecosysteem. Het integreert moeiteloos met toonaangevende datawarehouses, API’s, orkestratietools en monitoringplatforms.
Dit maakt het een goede keuze voor het bouwen van een uniforme en geautomatiseerde analytics-workflow, van ingestie tot visualisatie. Laten we deze aspecten hieronder verkennen:
dbt Cloud ondersteunt alle grote cloud datawarehouses en lakehouses, waardoor teams transformaties native kunnen draaien binnen de omgevingen waar hun data al staat.
Dit elimineert de noodzaak voor databeweging of -duplicatie en benut in plaats daarvan de prestaties en schaalbaarheid van elk platform.
dbt Cloud-integratieopties zijn onder andere:
Je hebt ook meerdere authenticatieopties per platform, zoals key pair-authenticatie, OAuth of gebruikersnaam/wachtwoord.
Voor organisaties die uitbreidbaarheid en automatisering nodig hebben, biedt dbt Cloud ook een krachtige REST API en webhookframework.
De dbt Cloud API stelt ontwikkelaars in staat om:
dbt Cloud-webhooks bieden event-based integratie, waardoor externe systemen kunnen reageren op belangrijke dbt-events zoals jobafronding, run-fouten of deploymentupdates.
Webhooks kunnen worden gebruikt voor:
Naarmate datapipelines in schaal en complexiteit groeien, wordt observeerbaarheid essentieel om betrouwbaarheid, prestaties en vertrouwen te behouden.
Maar wat biedt dbt Cloud? Dat komt neer op twee aspecten: pipelines monitoren en modellen optimaliseren.
Elke jobrun wordt gelogd, gevolgd en gevisualiseerd binnen het platform, zodat je de end-to-end status van je transformaties begrijpt.
Binnen het Run History-dashboard toont dbt Cloud bijvoorbeeld gedetailleerde informatie zoals:
dbt Cloud integreert ook eenvoudig met datamonitoringtools zoals Datadog.
Grote, monolithische transformaties zijn moeilijk te onderhouden en te optimaliseren. dbt stimuleert modulaire ontwikkeling, waarbij complexe logica wordt opgesplitst in kleinere, herbruikbare modellen die elk een gerichte taak uitvoeren.
Volg deze best practices om de prestaties te optimaliseren:
stg_, int_, fct_, dim_) om het doel van het model te verduidelijken.dbt deps en dbt docs generate draaien om afhankelijkheden en documentatie te valideren.Je kunt ook incrementele materialisaties gebruiken om compute-kosten te verlagen, zoals in het volgende voorbeeld.
{{ config(materialized='incremental') }}

select *
from {{ source('raw', 'events') }}
{% if is_incremental() %}
  where event_timestamp > (select max(event_timestamp) from {{ this }})
{% endif %}Omdat datateams steeds meer data binnen een organisatie willen delen, moet je ook rekening houden met de samenwerkingsopties van dbt Cloud.
dbt Mesh maakt schaalbare samenwerking mogelijk binnen grote organisaties via gecentraliseerd beheer van de volledige data lineage. Het stelt je team in staat om meerdere onderling afhankelijke projecten te creëren, elk in eigendom van verschillende businessunits of datadomeinen.
Belangrijke voordelen van dbt Mesh zijn:
In de kern stelt dbt Mesh teams in staat om modellen over projecten heen te refereren terwijl autonomie behouden blijft.
Zo kan een finance-team bijvoorbeeld een project “core financial metrics” onderhouden, terwijl het marketingteam een apart project bouwt dat die financiële modellen referereert zonder code of logica te dupliceren.
dbt Mesh maakt cross-project-referenties mogelijk via de ref()-functie, uitgebreid met project-namespaces. Bijvoorbeeld:
SELECT *
FROM {{ ref('finance_project', 'fct_revenue') }}
Hiermee kan het marketingmodel het fct_revenue-model uit het finance-project direct bevragen, met gebruik van de canonieke versie die door dat team is gedefinieerd.
Om achterwaartse compatibiliteit en vertrouwen over projecten heen te garanderen, introduceert dbt Mesh twee essentiële mechanismen: modelversiebeheer en modelcontracten.
Modelversiebeheer is een van de methoden waarmee teams hun modellen kunnen aanpassen zonder bestaande afhankelijkheden te breken. Je kunt meerdere versies van hetzelfde model definiëren met de eigenschap versions: in het YAML-bestand van het model.
Bijvoorbeeld:
models:
  - name: fct_revenue
    versions:
      - v: 1
        description: "Initial revenue aggregation"
      - v: 2
        description: "Includes new discount and refund logic"
Modelcontracten definiëren de structuur, datatypes en constraints van een model. Het fungeert als een overeenkomst tussen dataproducenten en -consumenten.
Wanneer een model een contract bevat, valideert dbt dit vóór uitvoering, zodat schemawijzigingen (zoals het verwijderen van kolommen of type-mismatches) niet onbedoeld downstream-fouten veroorzaken.
Voorbeeld van een eenvoudig contract:
models:
  - name: fct_revenue
    contract:
      enforced: true
    columns:
      - name: customer_id
        data_type: string
      - name: total_revenue
        data_type: numeric
      - name: report_date
        data_type: date
Als iemand probeert een gecontracteerde kolom te verwijderen of te wijzigen, zal dbt een fout geven, zodat afhankelijke modellen en dashboards beschermd blijven.
dbt Cloud breidt de functionaliteit van dbt Core uit door een end-to-end beheerd platform voor analytics engineering te bieden.
In deze gids hebben we onderzocht hoe het ontwikkeling centraliseert via de Studio-IDE, orkestratie afhandelt en nieuwere tools ondersteunt zoals dbt Mesh en de Semantic Layer.
Door deze tools in één platform te integreren, stelt dbt Cloud teams in staat om de volledige datalevenscyclus te beheren, van ingestie tot documentatie, zonder de onderliggende infrastructuur te hoeven beheren.
Als je graag hands-on ervaring wilt opdoen met dbt, biedt onze skill track dbt Fundamentals een praktische manier om je eerste project te bouwen.
dbt-cursussen
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

