

先决条件与环境准备
本教程假设参与者具备以下条件:
- 具备使用 AWS 及相关工具与技术的经验。
- 对关系型与 NoSQL 数据库有基础理解。
- 熟悉 SQL。
- 至少掌握一种编程语言会更有帮助。
数据迁移方法将涉及若干核心 AWS 服务,包括:
- 身份与访问管理(IAM)
- DynamoDB
- Redshift
- S3
- Glue
- Lambda
如果您是 AWS 新手,AWS Cloud Technology and Services 课程可以帮助您入门。
大部分操作将在 AWS 管理控制台中完成。不过,教程中的步骤也可通过 AWS 命令行界面(CLI)或 AWS 软件开发工具包(SDK)执行。您可以在自己选择的工作环境中进行数据迁移。
为数据迁移准备 DynamoDB
进行数据迁移准备时,需考虑 DynamoDB 表的组成以及与关系型数据库的差异:
- DynamoDB 表的构建块是项目(items)(类似于关系型数据库中的行)。
- 每个项目包含一个或多个属性(attributes),每个属性代表一个数据元素。
- 与关系型表类似,DynamoDB 表具有主键(primary keys),用于唯一标识每个项目。主键可以由单一的分区键(partition key)或分区键与排序键(sort key)的组合构成。
- DynamoDB 表的一大特性是无模式(schemaless),即每个项目可以有各自独特的属性。
本教程将使用一个简单的 Products 表来演示数据迁移。以下为 JSON 格式的数据:
{
"product_id": "P001",
"category": "Electronics",
"price": 700,
"product_name": "Phone"
},
{
"product_id": "P002",
"category": "Electronics",
"description": "The laptop is a Macbook.",
"price": 1000,
"product_name": "Laptop"
}需要注意两点:
product_id将作为主键。- 两个项目中的属性并不相同,因为第一个项目缺少
description属性。
这些数据作为设置的一部分被添加到 DynamoDB 的一个表中。
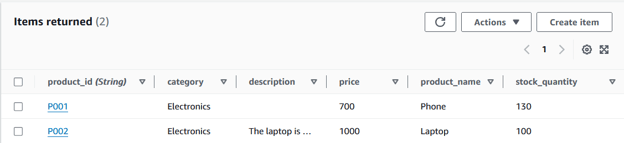
DynamoDB 表项目。图片由作者提供
设置 Amazon Redshift
下一步是在 Redshift 中创建一个表,用于接收来自 DynamoDB 表的数据。
1. 进入 Redshift 控制台并选择“Create cluster”。
在启动集群前,AWS 允许用户定义多个参数。对于本教程,我们将重点关注促成数据迁移所需的参数。
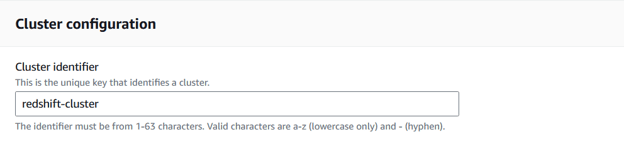
在 Redshift 控制台创建 Redshift 集群。图片由作者提供
2. 选择与待分析数据量相匹配的节点类型与节点数。
针对迁移 Products 表,您可以使用较小的 CPU 能力且仅配置一个节点。
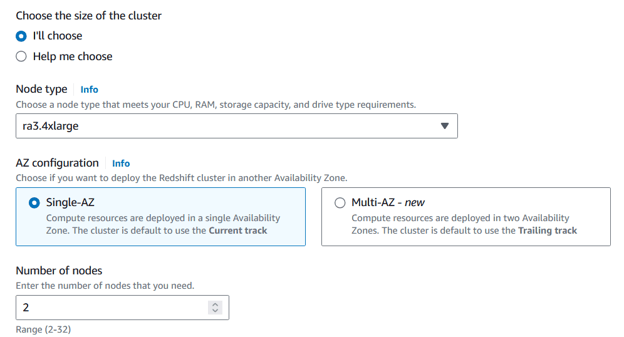
自定义 Redshift 集群配置。图片由作者提供
3. 为该集群选择管理员用户名和密码。
请妥善保存凭证,后续通过其他 AWS 服务访问该集群时将需要用到。
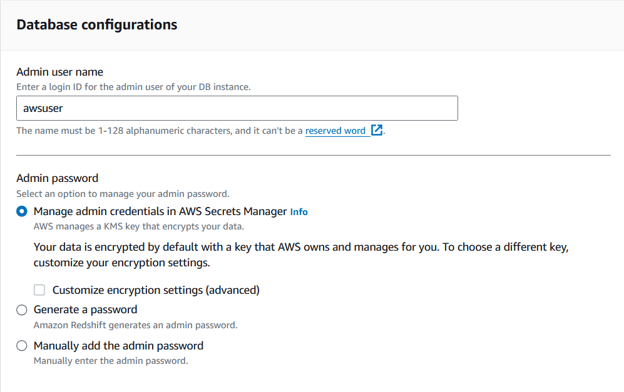
自定义 Redshift 集群配置。图片由作者提供
4. 最后,为集群分配一个 IAM 角色。
该 IAM 角色需要具备允许集群读取 DynamoDB 表以及在 Redshift 中创建表的策略。
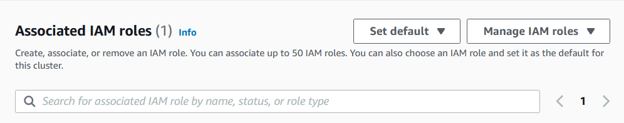
为 Redshift 集群分配 IAM 角色。图片由作者提供
5. 集群创建完成后,进入查询编辑器,使用 CREATE 命令创建用于存放来自 DynamoDB 表数据的表:
CREATE TABLE Products (
product_id VARCHAR(50) PRIMARY KEY,
category VARCHAR(50),
description VARCHAR(100),
price INT,
product_name VARCHAR(50),
stock_quantity INT
);请根据目标数据调整上述命令,并考虑需要应用的其他约束。
就这样!您已准备好开始传输数据。
方法一:使用 COPY 命令将数据从 DynamoDB 传输到 Redshift
Amazon Redshift 提供了 COPY 命令,可将来自指定 AWS 数据源的数据导入到表中。
1. 使用 COPY 命令执行数据迁移。
该命令的语法如下:
COPY <table_name>
FROM <dynamo_db_table_path>
IAM_ROLE 'arn:aws:iam::<aws-account-id>:role/<role-name>'
REGION <region_name>';要将 DynamoDB 中 Products 表的数据添加到 Redshift 中的 Products 表,可将命令改为:
COPY Products
FROM 'dynamodb://Products'
IAM_ROLE 'arn:aws:iam::<1234567890>:role/<dynamo_db_redshift_role>'
REGION ‘us-east-1’使用 COPY 命令的优点
COPY 命令是将数据从 DynamoDB 迁移到 Redshift 最直接的方法之一。它所需设置最少,且易用性高,尤其适合缺乏构建 ETL 管道经验的用户。
此外,由于数据直接传输,无需引入其他 AWS 服务。
使用 COPY 命令的缺点
该方法的主要不足在于,用户无法配置 DynamoDB 表中的属性如何映射到 Redshift 表的字段。这种缺乏灵活性可能导致 COPY 命令在 Redshift 表中错误省略或不准确映射字段。
另外,由于该命令会一次性批量传输所有数据,如果部分记录此前已传输至 Redshift,这种做法会造成冗余数据传输,进而增加处理时间与存储成本。
方法二:使用 AWS Glue 将数据从 DynamoDB 迁移到 Redshift
AWS Glue 是为创建抽取、转换与加载(ETL)管道而设计的服务。用户可以通过创建 ETL 作业来将数据从 DynamoDB 迁移到 Redshift。
如果您是 Glue 新手,建议先阅读 Getting Started with AWS Glue 教程。
在本指南中,我们将读取 DynamoDB 中的 Products 表,将结果以 CSV 文件形式存储到 S3 存储桶中,然后将该数据发送到 Redshift 的 Products 表。
1. 进入 S3 控制台,创建一个存储 CSV 文件的存储桶。
AWS S3 控制台。图片由作者提供
2. 进入 AWS Glue 控制台,并在左侧面板选择“ETL jobs”以开始创建作业。
AWS Glue 控制台。图片由作者提供
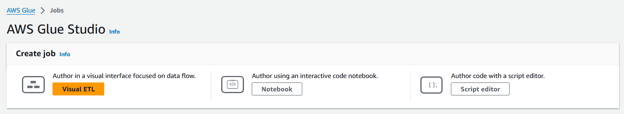
3. 选择创建 ETL 作业的模式。
AWS 提供三种作业创建模式:Visual ETL、Notebook 和 Script editor。每种模式面向不同熟练程度的用户,您可以选择偏好的方式——拖拽式界面(Visual ETL)、交互式开发环境(Notebook)或编写原始代码(Script Editor)。
Glue 作业可以用 Python 或 Spark 手动编写。对这些语言不太熟悉的用户可选择 Visual ETL,仅通过点击即可配置作业。
本教程中的 Glue 作业将使用代码编辑器以 Python 编写;若您对 Visual ETL 感兴趣,请参考AWS 文档。
4. 为该作业分配一个 IAM 角色。
为确保本教程顺利运行,该 IAM 角色需要访问 DynamoDB、Redshift 和 S3。
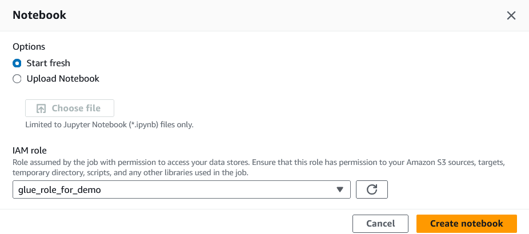
为 Glue 作业分配 IAM 角色。图片由作者提供
5. 创建作业后,切换到“Job details”选项卡并填写基本属性。
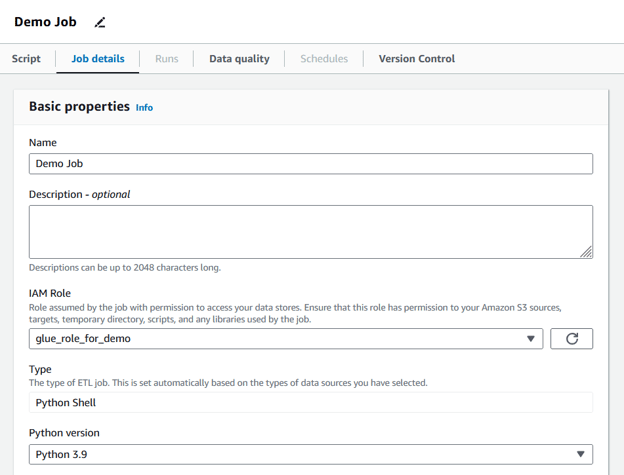
填写 Glue 作业详情。图片由作者提供
在此处,用户可以定义分配的数据处理单元(DPU)、重试次数和超时时间。教程中的作业将使用默认值,但建议根据实际需求调整这些参数。
6. 切换到“Script”选项卡并编写逻辑。
迁移 Products 表数据的 ETL 作业将执行以下代码:
import boto3
import csv
import time
import os
from awsglue.context import GlueContext
from awsglue.job import Job
from pyspark.context import SparkContext
from awsglue.utils import getResolvedOptions
import sys
# initialize Glue context
args = getResolvedOptions(sys.argv, ["JOB_NAME"])
sc = SparkContext()
glueContext = GlueContext(sc)
job = Job(glueContext)
job.init(args["JOB_NAME"], args)
# initialize DynamoDB client and scan the table
dynamodb = boto3.client('dynamodb', region_name=os.getenv('AWS_REGION'))
response = dynamodb.scan(TableName=os.getenv('DYNAMODB_TABLE'))
# extract and write data to a CSV file
items = response['Items']
csv_file = '/tmp/products.csv'
# write each row in the table
with open(csv_file, mode='w', newline='') as file:
writer = csv.writer(file)
writer.writerow(['product_id', 'category', 'description', 'product_name', 'stock_quantity', 'price'])
for item in items:
writer.writerow([
item.get('product_id', {}).get('S', ''),
item.get('category', {}).get('S', ''),
item.get('description', {}).get('S', ''),
item.get('product_name', {}).get('S', ''),
item.get('stock_quantity', {}).get('N', 0),
item.get('price', {}).get('N', 0)
])
# upload the csv file to S3
s3 = boto3.client('s3', region_name=os.getenv('AWS_REGION'))
bucket_name = os.getenv('S3_BUCKET_NAME')
s3_key = 'products/products.csv'
s3.upload_file(csv_file, bucket_name, s3_key)
# wait for the file to upload before continuing
time.sleep(10)
# load data into Redshift using the COPY command
redshift = boto3.client('redshift', region_name=os.getenv('AWS_REGION'))
copy_command = f"""
COPY Products FROM 's3://{bucket_name}/{s3_key}'
IAM_ROLE 'arn:aws:iam::{os.getenv('AWS_ACCOUNT_ID')}:role/{os.getenv('REDSHIFT_ROLE')}'
FORMAT AS CSV
IGNOREHEADER 1;
"""
cluster_id = os.getenv('REDSHIFT_CLUSTER_ID')
database = os.getenv('REDSHIFT_DATABASE')
db_user = os.getenv('REDSHIFT_DB_USER')
# execute the copy statement
response = redshift.execute_statement(
ClusterIdentifier=cluster_id,
Database=database,
DbUser=db_user,
Sql=copy_command
)
# Commit the job
job.commit()下面逐步解析该脚本实现的功能:
- 使用
awsglue库设置作业并准备执行 - 通过
boto3(AWS 的 Python SDK)访问 DynamoDB 表 - 将表项写入内存并导出为 CSV 文件至创建的 S3 存储桶
- 通过
boto3访问 Redshift 集群 - 编写并执行
COPY命令,将 CSV 文件中的数据插入 Redshift 表
注意: 此示例代码展示了实现数据迁移的一种方式。AWS Glue 具有很强的灵活性,提供多种构建 ETL 管道的方法,因此用户可根据自身需求定制作业。
7. 编写完成后,保存更改并点击“Run”按钮执行作业。
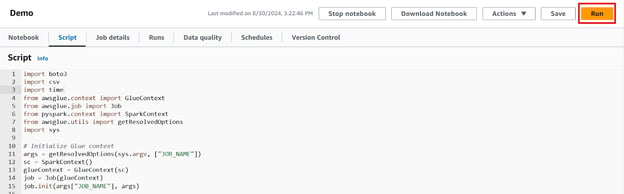
Glue 作业的脚本编辑器。图片由作者提供
8. 在“Runs”选项卡中监控作业进度,任何错误或问题都会显示在此处。
请核验作业状态并查看日志,确保一切如预期执行。
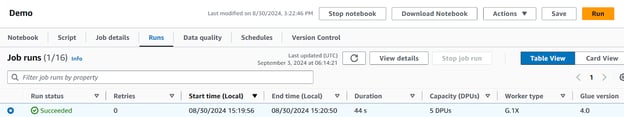
AWS Glue Runs 选项卡显示一个已完成的作业。图片由作者提供
作业成功后,可按需运行或设置调度,从而让您的数据迁移流程更高效并实现自动化。
使用 Glue 的优点
AWS Glue 提供广泛的自定义选项,使用户能够根据需求定制作业。它还支持按周期(如每日)调度作业,实现自动化。此外,Glue 与许多其他服务集成,如有需要可便捷地与非 DynamoDB 的数据源交互。
使用 Glue 的缺点
在 Glue 中配置 ETL 作业通常需要投入较多精力与时间。虽然使用该服务不强制要求编程知识,但若要利用 Glue 的某些功能(如 AWSGlue 库和 SDK),则需要编程能力。
此外,Glue 作业很难在首次尝试时就顺利运行,用户应做好排错准备。最后,如果管理不当,Glue 作业的成本会迅速累积,因此必须仅按需配置资源。
方法三:使用 DynamoDB Streams 将数据从 DynamoDB 迁移到 Redshift
DynamoDB Streams 是一项实时跟踪 DynamoDB 表变更的功能。借助 DynamoDB Streams,每当 DynamoDB 中的数据源发生更改时,用户都可以自动更新 Redshift 表。
有关如何使用 DynamoDB Streams 的更多信息,请阅读AWS 文档。
该方案需要访问 AWS 的 DynamoDB、Redshift 和 Lambda。在此方法中,当 DynamoDB 中 Products 表有项目新增或修改时,将触发一个 Lambda 函数。
步骤如下:
1. 进入 Lambda 控制台并选择“Create Function”。
AWS Lamba 控制台。图片由作者提供
2. 为函数提供基本信息,包括编程语言与 IAM 角色。
该角色必须具备对 Lambda、DynamoDB 和 Redshift 的访问权限。
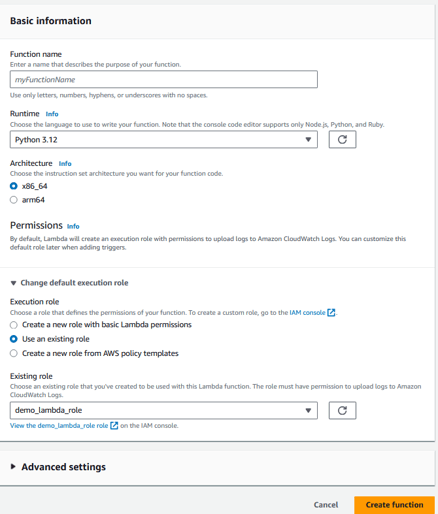
配置 Lambda 函数。图片由作者提供
3. 创建函数后,将 DynamoDB 表(此处为 Products 表)添加为触发器。
此时,示意图应如下所示:
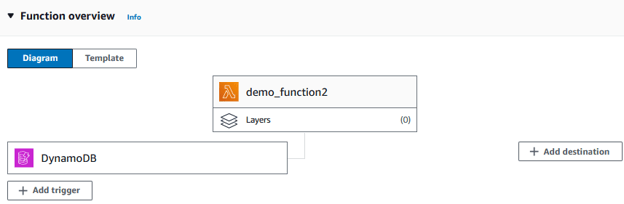
为 Lambda 函数添加触发器。图片由作者提供
4. 切换到配置选项卡,为函数分配所需的内存与运行时间,默认值通常不足。
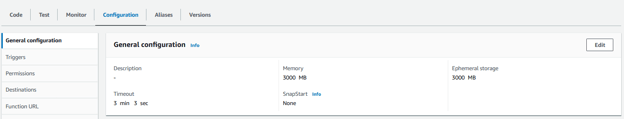
为 Lambda 函数配置触发器。图片由作者提供
5. 在“Code”选项卡,用您选择的语言编写数据迁移逻辑。
以下片段展示了一个 Python 版 Lambda 函数的示例:
import boto3
import os
import json
def lambda_handler(event, context):
# Initialize the Redshift Data API client
redshift_client = boto3.client('redshift-data')
# Redshift cluster details
cluster_id = os.environ['REDSHIFT_CLUSTER_ID']
database = os.environ['REDSHIFT_DB_NAME']
user = os.environ['REDSHIFT_USER']
# IAM role ARN that has access to Redshift Data API
role_arn = os.environ['REDSHIFT_ROLE_ARN']
# Process DynamoDB stream records
for record in event['Records']:
if record['eventName'] in ['INSERT', 'MODIFY']:
new_image = record['dynamodb']['NewImage']
product_id = new_image['product_id']['S']
category = new_image['category']['S']
description = new_image['description']['S']
price = float(new_image['price']['N'])
product_name = new_image['product_name']['S']
stock_quantity = int(new_image['stock_quantity']['N'])
# SQL query to insert data into Redshift
query = f"""
INSERT INTO products (product_id, category, description, price, product_name, stock_quantity)
VALUES ('{product_id}', '{category}', '{description}', {price}, '{product_name}', {stock_quantity});
"""
# Execute the query using Redshift Data API
response = redshift_client.execute_statement(
ClusterIdentifier=cluster_id,
Database=database,
DbUser=user,
Sql=query
)
# Log the statement ID for tracking
print(f'Started SQL statement with ID: {response["Id"]}')
return {
'statusCode': 200,
'body': 'SQL statements executed successfully'
}简而言之,该函数读取由 DynamoDB Streams 记录的新增或修改项目日志,并通过 Redshift API 客户端执行 SQL,将其应用到 Redshift 表中。
出于安全考虑,关键值(如 Redshift 集群 ID)存储在环境变量中,而不是在脚本中硬编码。
关于在 Lambda 中使用环境变量的更多信息,请参阅 AWS 文档。
6. 代码完成后,部署该函数并进行测试以检查是否存在错误。
根据具体用例,建议为函数设计适合的测试用例。
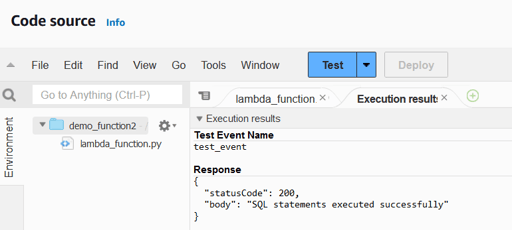
Lambda 函数执行结果。图片由作者提供
当 Lambda 函数可正常工作后,我们需要将 DynamoDB 表配置为在表中项目新增或修改时运行该函数。
7. 选择 DynamoDB 表并切换至“Exports and streams”选项卡。
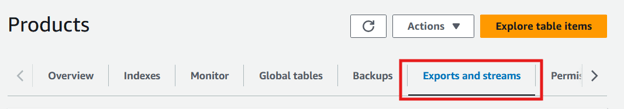
DynamoDB 控制台 Exports and streams 选项卡。图片由作者提供
8. 向下滚动至 DynamoDB stream 详情并选择“Turn on”。
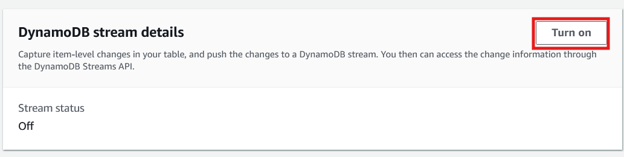
DynamoDB 控制台 Exports and streams 选项卡。图片由作者提供
9. 按提示选择应记录到 DynamoDB Streams 的信息类型。
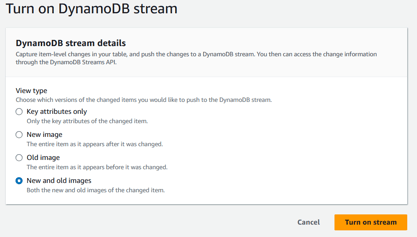
DynamoDB stream 详情界面。图片由作者提供
10. 打开流后,在同一页面向下滚动以创建触发器。
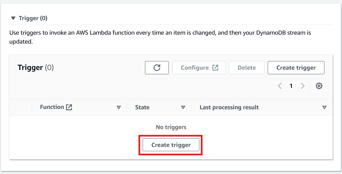
在 DynamoDB 中创建触发器以调用 Lambda 函数。图片由作者提供
11. 最后,在配置触发器时,选择之前创建的 Lambda 函数,然后点击“Create trigger”。
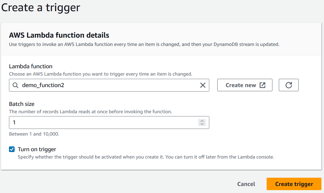
选择要触发的 Lambda 函数。图片由作者提供
实施此方案后,对 DynamoDB 表的任意更改都会自动同步至 Redshift 表,确保实时数据一致性。
使用 DynamoDB Streams 的优点
DynamoDB Streams 可在 DynamoDB 与 Redshift 之间建立实时同步,使用户无需人工干预即可保持 Redshift 表的最新状态。
因此,Redshift 表可以被高频更新,进而支撑需要高数据吞吐的应用(如实时仪表盘)。该方案也能在每次迭代中降低人为错误风险。
使用 DynamoDB Streams 的缺点
搭建该方案需要配置多项 AWS 服务,过程可能较为耗时。
由于 Lambda 是函数即服务(FaaS)工具,用户需要精通至少一种编程语言。此外,每次数据同步迭代会调用多次 API,整体成本可能快速累积,尤其在高频更新情况下。最后,该方案更适合对 Redshift 表的小规模变更,而非整表迁移。
验证数据迁移
在构建数据迁移方案后,数据验证是必不可少的一步。即便 AWS 服务本身运行无误,迁移过程中仍可能存在未被发现的错误。问题可能源自逻辑不一致、属性映射不正确或数据传输不完整。
只有迁移数据不含上述错误,后续在 Redshift 的分析才能顺利进行。
本节将以 Products 表为例,介绍若干用于检查迁移数据的校验与技术。
验证列结构与数据类型
确保 DynamoDB 表中的所有列在 Redshift 表中均已存在,且分配了正确的数据类型。
SELECT column_name, data_type
FROM information_schema.columns
WHERE table_name = Products;核对行数
通过比较 Redshift 表与数据源的行数,确认数据传输是否已完成。
SELECT COUNT(*) FROM your_table_name;预览数据
与其识别列与数据类型,不如先预览数据。用户可以通过快速浏览预览来发现任何差异与异常。
SELECT product_id, category, price FROM your_table_name LIMIT 5;验证复杂业务逻辑
通过创建预览或计数进行数据验证并不适用于所有数据集。当需要基于更复杂的标准评估数据时,用户可以创建视图。
例如,假设 Products 表不应出现电子产品库存过低的情况。可使用以下查询进行监控。
CREATE OR REPLACE VIEW low_stock_electronics AS
SELECT
Product_id, product_name, category, stock_quantity, price,
FROM
your_table_name
WHERE
stock_quantity < 50 AND
Category = ‘Electronics;在 Redshift 中优化性能
优化查询性能对于高效、低成本地获取洞察至关重要。随着每次迁移使数据集逐步增大,编写节省内存、降低运行时间的查询尤为重要。
本节将以 Products 表为参考,探讨若干提升查询优化的方法。
选择分布键
在 Redshift 中,分布键决定数据如何在集群的各节点间分布。为表选择合适的分布键可减少查询运行时间。
例如,若 Products 表常与其他表基于 product_id 字段进行关联,则在创建表时使用 product_id 作为分布键将更为有利。
CREATE TABLE products (
product_id VARCHAR(100),
category VARCHAR(100),
description VARCHAR(100),
price INT,
stock_quantity INT
)
DISTKEY(product_id);选择排序键
选择合适的排序键有助于常见的 SQL 操作(如过滤与连接)。在 Redshift 中,用户可以手动选择排序键,也可以让系统自动选择。排序键分为两类:复合排序键与交错排序键。最佳选择取决于需要在数据上运行的查询类型。
CREATE TABLE products (
product_id VARCHAR(100),
category VARCHAR(100),
description VARCHAR(100),
price INT,
stock_quantity INT
)
COMPOUND SORTKEY(category, product_id);关于排序键的更多信息,请参阅 AWS 文档。
使用压缩
压缩是指使用更少的位对给定数据进行编码。这样可使表占用更少的存储,同时仍保留全部信息。
若不确定哪种压缩最适合您的数据,Redshift 可通过以下命令执行压缩分析,从而为每个字段找到最佳编码:
ANALYZE COMPRESSION <table_name>;结论与后续步骤
将数据从 DynamoDB 迁移到 Redshift,可以让用户利用 Redshift 的 OLAP 能力进行更复杂的数据分析。
本教程介绍了三种不同的迁移方法,各有优缺点。选择最佳方案时,请仔细评估您的分析需求、数据限制及预算考量,以确保为特定用例找到最有效的解决方案。
下一步的不错选择是开始学习 Introduction to Redshift 课程,以学习或复习基础概念。另一个很好的替代选择是 AWS Security and Cost Management 课程,涵盖所有使用 AWS 的人员都应掌握的关键概念。
FAQs
我可以使用文中方法自动化迁移流程吗?
可以,AWS Glue 和 DynamoDB Streams 都支持自动化。Glue 作业可以按特定时间间隔调度运行,而 DynamoDB Streams 则可通过 Lambda 实现实时数据同步触发。
哪种方法在处理大数据集时最有效率?
对于大型数据集,通常 AWS Glue 是更高效的方案。它提供广泛的自定义与可扩展能力,非常适合复杂 ETL 任务,但可能需要更多的前期配置时间。
使用这些方法时的成本考虑是什么?
对于一次性、简单的迁移,COPY 命令最具成本效益。然而,Glue 与 DynamoDB Streams 因为持续使用资源,成本可能更高,因此务必监控并优化您的 AWS 服务消耗。
我能否只选择性地传输特定数据,而不是迁移整张表?
可以。AWS Glue 和 DynamoDB Streams 提供灵活性,可筛选并传输特定项目或属性。相比之下,COPY 命令会在无筛选能力的情况下传输整个数据集。
在将数据从 DynamoDB 迁移到 Redshift 时,能处理 DynamoDB 的模式变更吗?
可以。Redshift 需要定义好的模式,而 DynamoDB 是无模式的。您必须在迁移前手动更新 Redshift 表结构以容纳新的属性或字段。AWS Glue 在处理模式差异方面提供了最大的灵活性。

作为一名有志的数据科学家,我擅长将原始数据转化为可执行的策略。我专注于运用 Python、SQL 和机器学习技术,在数据分析中产出有影响力的解决方案,并构建稳健的 ETL 流水线,用于摄取和处理海量数据。
Amazon DynamoDB 是市场上最可靠、最广泛使用的 NoSQL 数据库之一。将数据从 DynamoDB 迁移到 Amazon Redshift,有助于更深入地理解存储在 DynamoDB 中的数据。
在本教程中,我将介绍三种将数据从 DynamoDB 迁移到 Redshift 的方法,并为每种方法提供分步操作说明。同时,我还将探讨确保数据完整性的最佳实践,并讨论如何优化性能的策略。
什么是 DynamoDB?
DynamoDB 是 AWS 提供的全托管无服务器 NoSQL 数据库,旨在提供高性能与无缝扩展能力。它擅长处理事务型负载,可支持包含 TB 级数据的表,并在每天处理数十亿次请求。
凭借其强大能力,DynamoDB 已成为金融、电商、医疗、媒体和游戏等行业的关键组件。它常用于构建和维护用户画像排行榜、存储与处理物联网数据,以及其他需要实时数据访问的应用。
如果您对这类数据库感兴趣,NoSQL Concepts 课程将带您了解四种流行的 NoSQL 引擎——包括 Redis、MongoDB、Apache Cassandra 和 Neo4j。
什么是 Redshift?
Redshift 是 AWS 的全托管云数据仓库,旨在高效、快速地处理大规模数据。
借助大规模并行处理(MPP)技术,Redshift 能将海量数据分布并处理于多个节点上,从而快速执行复杂 SQL 查询。
此外,与传统数据仓库相比,Redshift 上的查询更具性价比。Redshift 的分析能力适用于多种场景,包括大数据分析、实时仪表盘和机器学习应用。
想更深入了解这个强大的数据仓库,请查看 Introduction to Redshift 课程。
理解用例:为什么要将数据从 DynamoDB 迁移到 Redshift?
众所周知,DynamoDB 擅长处理在线事务处理(OLTP)系统中常见的事务型负载,但它并未针对复杂分析进行优化。相反,Redshift 专为联机分析处理(OLAP)系统而设计,更适合承担此角色。
因此,通过将数据从 DynamoDB 迁移到 Redshift,AWS 用户可以执行高级的基于 SQL 的分析,从而对数据获得更深入的洞察。