

पूर्वापेक्षाएँ और सेटअप
यह ट्यूटोरियल निम्नलिखित पूर्वज्ञान मानकर चलता है:
- AWS और संबद्ध टूल्स व तकनीकों का पूर्व अनुभव।
- रिलेशनल और NoSQL डेटाबेस की बुनियादी समझ।
- SQL से परिचित होना।
- कम-से-कम एक प्रोग्रामिंग भाषा जानना लाभदायक होगा।
डेटा माइग्रेशन के तरीकों में कुछ मुख्य AWS सेवाएँ शामिल होंगी, जिनमें शामिल हैं:
- Identity and Access Management (IAM)
- DynamoDB
- Redshift
- S3
- Glue
- Lambda
AWS Cloud Technology and Services कोर्स, यदि आप AWS में नए हैं, तो शुरुआत करने में मदद करेगा।
ज्यादातर प्रक्रिया AWS Management Console में पूरी की जाएगी। हालाँकि, ट्यूटोरियल में दिए गए चरण AWS command line interface (CLI) या AWS software development kit (SDK) से भी निष्पादित किए जा सकते हैं। आप अपने पसंदीदा कार्य वातावरण में डेटा माइग्रेशन कर सकते हैं।
डेटा माइग्रेशन के लिए DynamoDB तैयार करना
डेटा माइग्रेशन की तैयारी करते समय, DynamoDB तालिकाओं के घटकों और उनके रिलेशनल डेटाबेस से अंतर को समझना महत्वपूर्ण है:
- DynamoDB तालिकाओं के निर्माण खंड items होते हैं (जो रिलेशनल डेटाबेस में पंक्तियों के समान हैं)।
- Items में एक या एकाधिक attributes होते हैं, जिनमें से प्रत्येक एक डेटा एलिमेंट का प्रतिनिधित्व करता है।
- रिलेशनल तालिकाओं की तरह, DynamoDB तालिकाओं में primary keys होती हैं, जो प्रत्येक आइटम के लिए अद्वितीय पहचानकर्ता का काम करती हैं। एक प्राइमरी की अकेली partition key से या partition key और sort key के संयोजन से बन सकती है।
- DynamoDB तालिकाओं की एक प्रमुख विशेषता यह है कि वे schemaless होती हैं, अर्थात प्रत्येक आइटम के अपने अनूठे एट्रिब्यूट हो सकते हैं।
ट्यूटोरियल में डेटा माइग्रेशन प्रदर्शित करने के लिए एक सरल Products तालिका का उपयोग किया जाएगा। नीचे JSON फ़ॉर्मेट में डेटा दिया गया है:
{
"product_id": "P001",
"category": "Electronics",
"price": 700,
"product_name": "Phone"
},
{
"product_id": "P002",
"category": "Electronics",
"description": "The laptop is a Macbook.",
"price": 1000,
"product_name": "Laptop"
}दो महत्वपूर्ण बातों पर ध्यान दें:
product_idप्राइमरी की का काम करेगा।- दोनों आइटम्स में एट्रिब्यूट समान नहीं हैं क्योंकि पहले आइटम में
descriptionएट्रिब्यूट नहीं है।
यह डेटा सेटअप के हिस्से के रूप में DynamoDB की एक तालिका में जोड़ा गया है।
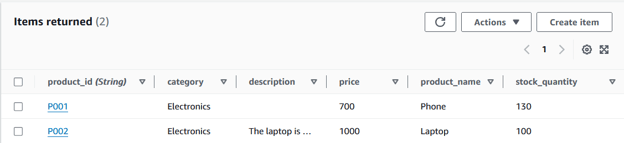
DynamoDB तालिका के आइटम्स। चित्र: लेखक
Amazon Redshift सेटअप करना
अगला चरण Redshift में एक तालिका बनाना है जो DynamoDB तालिका का डेटा ग्रहण करेगी।
1. Redshift कंसोल पर जाएँ और “Create cluster” चुनें।
AWS उपयोगकर्ताओं को क्लस्टर चालू करने से पहले कई पैरामीटर्स परिभाषित करने देता है। इस ट्यूटोरियल के लिए, ध्यान उन सेटिंग्स पर रहेगा जो डेटा माइग्रेशन में सहायक हैं।
Redshift कंसोल में क्लस्टर बनाना। चित्र: लेखक
2. नोड टाइप और नोड्स की संख्या चुनें, जो विश्लेषित किए जाने वाले डेटा वॉल्यूम के अनुरूप हों।
Products तालिका के माइग्रेशन के लिए, आप न्यूनतम CPU क्षमता और केवल एक नोड का उपयोग कर सकते हैं।
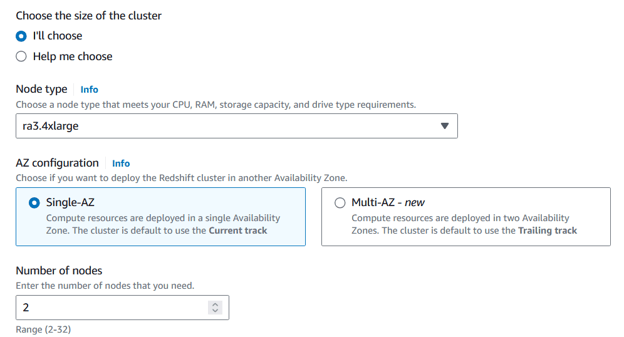
Redshift क्लस्टर कॉन्फ़िगरेशन को कस्टमाइज़ करना। चित्र: लेखक
3. इस क्लस्टर के लिए एडमिन यूज़रनेम और पासवर्ड चुनें।
क्रेडेंशियल्स को सुरक्षित स्थान पर रखें, क्योंकि अन्य AWS सेवाओं के माध्यम से इस क्लस्टर तक पहुँचने के लिए उनकी आवश्यकता होगी।
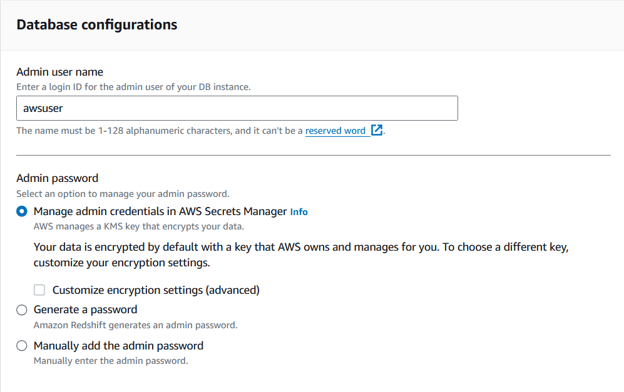
Redshift क्लस्टर कॉन्फ़िगरेशन को कस्टमाइज़ करना। चित्र: लेखक
4. अंत में, क्लस्टर को एक IAM रोल असाइन करें।
IAM रोल में ऐसी नीतियाँ होनी चाहिए जो क्लस्टर को DynamoDB तालिकाएँ पढ़ने और Redshift में तालिकाएँ बनाने की अनुमति दें।
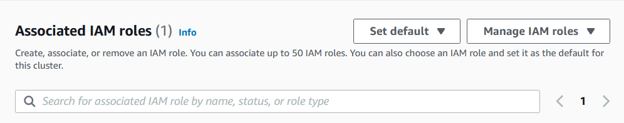
Redshift क्लस्टर को IAM रोल असाइन करना। चित्र: लेखक
5. क्लस्टर बनने के बाद, क्वेरी एडिटर पर जाएँ और CREATE कमांड का उपयोग करके वह तालिका बनाएँ जिसमें DynamoDB तालिका का डेटा रखा जाएगा:
CREATE TABLE Products (
product_id VARCHAR(50) PRIMARY KEY,
category VARCHAR(50),
description VARCHAR(100),
price INT,
product_name VARCHAR(50),
stock_quantity INT
);ऊपर दिए गए कमांड को अपनी रुचि के डेटा के आधार पर संशोधित करें और आवश्यक अतिरिक्त प्रतिबंधों पर विचार करें।
बस इतना ही! अब आप डेटा स्थानांतरित करना शुरू कर सकते हैं।
विधि 1: COPY कमांड का उपयोग करके DynamoDB से Redshift में डेटा ट्रांसफर
Amazon Redshift COPY कमांड प्रदान करता है, जो किसी निर्दिष्ट AWS डेटा स्रोत से डेटा को एक तालिका में इनपुट करता है।
1. COPY कमांड का उपयोग करके डेटा माइग्रेशन निष्पादित करें।
कमांड का सिंटैक्स निम्नलिखित है:
COPY <table_name>
FROM <dynamo_db_table_path>
IAM_ROLE 'arn:aws:iam::<aws-account-id>:role/<role-name>'
REGION <region_name>';DynamoDB की Products तालिका से Redshift की Products तालिका में डेटा जोड़ने के लिए, कमांड को निम्नलिखित रूप में बदला जा सकता है:
COPY Products
FROM 'dynamodb://Products'
IAM_ROLE 'arn:aws:iam::<1234567890>:role/<dynamo_db_redshift_role>'
REGION ‘us-east-1’COPY कमांड के लाभ
COPY कमांड, DynamoDB से Redshift में डेटा स्थानांतरित करने के सबसे सरल तरीकों में से एक है। इसमें न्यूनतम सेटअप की आवश्यकता होती है, और इसकी सुगमता इसे उन लोगों के लिए भी सुलभ बनाती है जिनका ETL पाइपलाइंस बनाने में कम अनुभव है।
साथ ही, चूँकि डेटा ट्रांसफर सीधे होता है, इसलिए अन्य AWS सेवाएँ शामिल करने की आवश्यकता नहीं पड़ती।
COPY कमांड के नुकसान
इस विधि की मुख्य कमी यह है कि उपयोगकर्ता DynamoDB तालिका के एट्रिब्यूट्स को Redshift तालिका के फ़ील्ड्स से कैसे मैप किया जाए, यह कॉन्फ़िगर नहीं कर सकते। इस लचीलेपन की कमी के कारण COPY कमांड Redshift तालिका में फ़ील्ड्स को गलती से छोड़ सकता है या गलत तरीके से मैप कर सकता है।
इसके अलावा, चूँकि कमांड सारा डेटा एक ही बैच में ट्रांसफर करता है, यदि कुछ रिकॉर्ड पहले से ही Redshift में ट्रांसफर हो चुके हैं तो यह ऑपरेशन अक्षम हो सकता है। ऐसे मामलों में यह दृष्टिकोण अनावश्यक डेटा ट्रांसफर कराएगा, जिससे प्रोसेसिंग समय और स्टोरेज लागत बढ़ेगी।
विधि 2: AWS Glue का उपयोग करके DynamoDB से Redshift में डेटा ट्रांसफर
AWS Glue एक सेवा है जो extract, transform, और load (ETL) पाइपलाइंस बनाने के लिए डिज़ाइन की गई है। उपयोगकर्ता एक ETL जॉब बनाकर DynamoDB से Redshift में डेटा ट्रांसफर कर सकते हैं।
यदि आप Glue में नए हैं, तो Getting Started with AWS Glue ट्यूटोरियल देखें।
इस गाइड में, हम DynamoDB की Products तालिका को पढ़ेंगे, परिणामों को S3 बकेट में CSV फ़ाइल के रूप में संग्रहीत करेंगे, और फिर उस डेटा को Redshift की Products तालिका में भेज देंगे।
1. S3 कंसोल पर जाएँ और CSV फ़ाइल रखने के लिए एक बकेट बनाएँ।
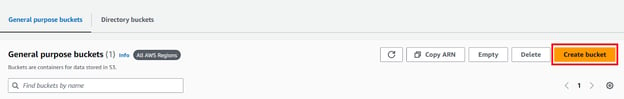
AWS S3 कंसोल। चित्र: लेखक
2. AWS Glue कंसोल पर जाएँ, और बाएँ पैनल से “ETL jobs” चुनकर अपना जॉब बनाना शुरू करें।
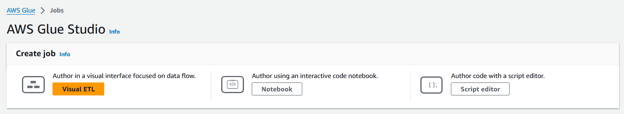
AWS Glue कंसोल। चित्र: लेखक
3. ETL जॉब बनाने का मोड चुनें।
AWS तीन जॉब क्रिएशन मोड प्रदान करता है: Visual ETL, Notebook, और Script editor। प्रत्येक मोड अलग-अलग विशेषज्ञता स्तरों को ध्यान में रखता है—ड्रैग-एंड-ड्रॉप इंटरफ़ेस (Visual ETL), इंटरैक्टिव डेवलपमेंट वातावरण (Notebook), या रॉ कोडिंग (Script Editor)।
Glue जॉब्स को Python या Spark का उपयोग करके मैन्युअल रूप से कोड किया जा सकता है। इन भाषाओं में कम दक्षता रखने वालों के लिए, Visual ETL एक उपयुक्त विकल्प है, क्योंकि यह केवल क्लिक करके जॉब कॉन्फ़िगर करने देता है।
इस ट्यूटोरियल का Glue जॉब Python में कोड एडिटर में लिखा जाएगा, लेकिन जो Visual ETL विकल्प में रुचि रखते हैं, वे AWS दस्तावेज़ देखें।
4. इस जॉब को एक IAM रोल असाइन करें।
इस ट्यूटोरियल को सफलतापूर्वक चलाने के लिए IAM रोल को DynamoDB, Redshift, और S3 तक पहुँच चाहिए।
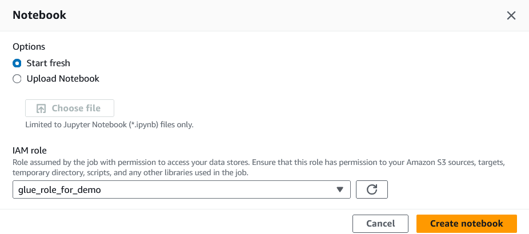
Glue जॉब को IAM रोल असाइन करना। चित्र: लेखक
5. जॉब बनाने के बाद, “Job details” टैब पर जाएँ और बुनियादी गुण भरें।
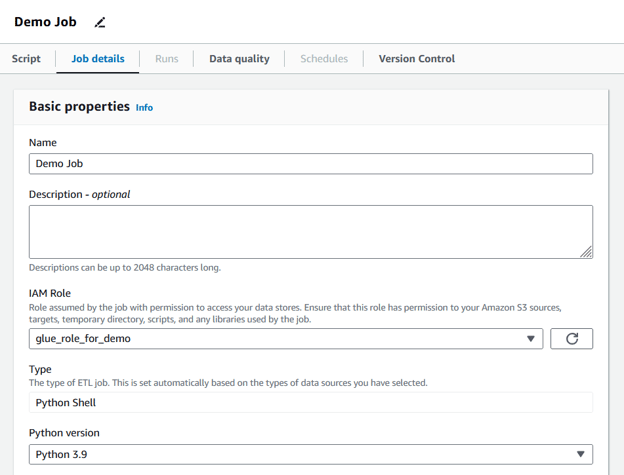
Glue जॉब विवरण भरना। चित्र: लेखक
इस सेक्शन में, उपयोगकर्ता allotted data processing units (DPUs), रीट्राइज़ की संख्या, और जॉब का टाइमआउट निर्धारित कर सकते हैं। इस ट्यूटोरियल के जॉब के लिए डिफ़ॉल्ट मान रखे जाएँगे, लेकिन अनुशंसा है कि उपयोगकर्ता इन पैरामीटर्स को अपनी आवश्यकताओं के अनुसार समायोजित करें।
6. “Script” टैब पर जाएँ और अपनी लॉजिक लिखें।
Products तालिका के डेटा को माइग्रेट करने वाला ETL जॉब निम्नलिखित कोड चलाएगा:
import boto3
import csv
import time
import os
from awsglue.context import GlueContext
from awsglue.job import Job
from pyspark.context import SparkContext
from awsglue.utils import getResolvedOptions
import sys
# initialize Glue context
args = getResolvedOptions(sys.argv, ["JOB_NAME"])
sc = SparkContext()
glueContext = GlueContext(sc)
job = Job(glueContext)
job.init(args["JOB_NAME"], args)
# initialize DynamoDB client and scan the table
dynamodb = boto3.client('dynamodb', region_name=os.getenv('AWS_REGION'))
response = dynamodb.scan(TableName=os.getenv('DYNAMODB_TABLE'))
# extract and write data to a CSV file
items = response['Items']
csv_file = '/tmp/products.csv'
# write each row in the table
with open(csv_file, mode='w', newline='') as file:
writer = csv.writer(file)
writer.writerow(['product_id', 'category', 'description', 'product_name', 'stock_quantity', 'price'])
for item in items:
writer.writerow([
item.get('product_id', {}).get('S', ''),
item.get('category', {}).get('S', ''),
item.get('description', {}).get('S', ''),
item.get('product_name', {}).get('S', ''),
item.get('stock_quantity', {}).get('N', 0),
item.get('price', {}).get('N', 0)
])
# upload the csv file to S3
s3 = boto3.client('s3', region_name=os.getenv('AWS_REGION'))
bucket_name = os.getenv('S3_BUCKET_NAME')
s3_key = 'products/products.csv'
s3.upload_file(csv_file, bucket_name, s3_key)
# wait for the file to upload before continuing
time.sleep(10)
# load data into Redshift using the COPY command
redshift = boto3.client('redshift', region_name=os.getenv('AWS_REGION'))
copy_command = f"""
COPY Products FROM 's3://{bucket_name}/{s3_key}'
IAM_ROLE 'arn:aws:iam::{os.getenv('AWS_ACCOUNT_ID')}:role/{os.getenv('REDSHIFT_ROLE')}'
FORMAT AS CSV
IGNOREHEADER 1;
"""
cluster_id = os.getenv('REDSHIFT_CLUSTER_ID')
database = os.getenv('REDSHIFT_DATABASE')
db_user = os.getenv('REDSHIFT_DB_USER')
# execute the copy statement
response = redshift.execute_statement(
ClusterIdentifier=cluster_id,
Database=database,
DbUser=db_user,
Sql=copy_command
)
# Commit the job
job.commit()आइए चरण-दर-चरण देखें कि यह स्क्रिप्ट क्या करती है:
awsglueलाइब्रेरी का उपयोग कर जॉब को निष्पादन के लिए सेट अप करनाboto3(AWS का Python SDK) से DynamoDB तालिका तक पहुँचना- तालिका के आइटम्स को मेमोरी में लिखकर उन्हें S3 बकेट में CSV फ़ाइल के रूप में एक्सपोर्ट करना
boto3से Redshift क्लस्टर तक पहुँचना- CSV फ़ाइल का डेटा Redshift तालिका में डालने के लिए
COPYकमांड लिखना और निष्पादित करना
नोट: यह सैंपल कोड स्निपेट डेटा माइग्रेशन आसान बनाने का एक तरीका दर्शाता है। AWS Glue लचीलापन प्रदान करता है और ETL पाइपलाइन बनाने के कई तरीके देता है। इसलिए, उपयोगकर्ता अपनी जरूरतों के अनुरूप जॉब बना सकते हैं।
7. कोड लिखने के बाद, बदलाव सहेजें और जॉब चलाने के लिए “Run” बटन पर क्लिक करें।
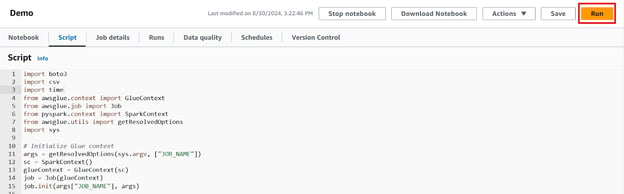
Glue जॉब के लिए स्क्रिप्ट एडिटर। चित्र: लेखक
8. “Runs” टैब में जॉब की प्रगति मॉनिटर करें, जहाँ कोई भी त्रुटि या समस्या दिखाई देगी।
जॉब की स्थिति सत्यापित करें और लॉग की समीक्षा करें ताकि सुनिश्चित हो सके कि सब कुछ अपेक्षा के अनुरूप चला।
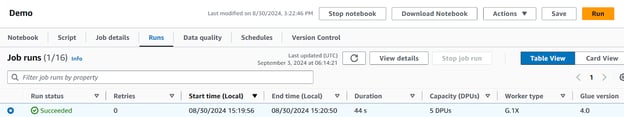
AWS Glue Runs टैब में पूर्ण जॉब दिख रहा है। चित्र: लेखक
जॉब सफल होने के बाद, इसे ऑन-डिमांड चलाया जा सकता है या आवश्यकता अनुसार शेड्यूल किया जा सकता है, जिससे आपका डेटा माइग्रेशन अधिक कुशल और स्वचालित हो जाता है।
Glue के लाभ
AWS Glue व्यापक कस्टमाइज़ेशन विकल्प प्रदान करता है, जिससे उपयोगकर्ता अपनी आवश्यकताओं के अनुरूप जॉब तैयार कर सकते हैं। यह इन जॉब्स को नियमित अंतराल (जैसे, दैनिक) पर शेड्यूल करने की सुविधा भी देता है, जिससे ऑटोमेशन संभव होता है। साथ ही, Glue कई अन्य सेवाओं के साथ एकीकृत है, जिससे आवश्यकता पड़ने पर DynamoDB के अलावा अन्य डेटा स्रोतों के साथ इंटरैक्शन आसान होता है।
Glue के नुकसान
Glue में ETL जॉब कॉन्फ़िगर करना अक्सर काफी परिश्रम और सेटअप समय माँगता है। यद्यपि इस सेवा का उपयोग करने के लिए प्रोग्रामिंग ज्ञान अनिवार्य नहीं है, लेकिन AWSGlue लाइब्रेरी और SDK जैसी कुछ सुविधाओं का लाभ उठाने के लिए यह आवश्यक हो सकता है।
इसके अलावा, Glue जॉब्स पहली बार में सफलतापूर्वक चलने की संभावना कम होती है, इसलिए उपयोगकर्ताओं को समस्या निवारण में समय लगाने के लिए तैयार रहना चाहिए। अंततः, यदि सही ढंग से प्रबंधित न किया जाए तो Glue जॉब्स की लागत तेज़ी से बढ़ सकती है, इसलिए केवल आवश्यक संसाधन ही प्रोविजन करना महत्वपूर्ण है।
विधि 3: DynamoDB Streams का उपयोग करके DynamoDB से Redshift में डेटा ट्रांसफर
DynamoDB Streams एक फीचर है जो DynamoDB तालिकाओं में किए गए बदलावों को रियल-टाइम में ट्रैक करता है। DynamoDB Streams का उपयोग करके, जब भी DynamoDB में डेटा स्रोत में कोई बदलाव होता है, उपयोगकर्ता अपने Redshift तालिका को स्वतः अपडेट कर सकते हैं।
DynamoDB Streams का उपयोग कैसे करें, इस पर अधिक जानकारी के लिए AWS दस्तावेज़ पढ़ें।
इस समाधान के लिए AWS DynamoDB, Redshift, और Lambda तक पहुँच आवश्यक होगी। इस दृष्टिकोण में, जब भी DynamoDB की Products तालिका में कोई आइटम जोड़ा या संशोधित किया जाएगा, एक Lambda फ़ंक्शन ट्रिगर होगा।
चरण इस प्रकार हैं:
1. Lambda कंसोल पर जाएँ और “Create Function” चुनें।
AWS Lambda कंसोल। चित्र: लेखक
2. फ़ंक्शन के लिए बुनियादी जानकारी दें, जिनमें प्रोग्रामिंग भाषा और IAM रोल शामिल हैं।
रोल को Lambda, DynamoDB, और Redshift तक पहुँच होनी चाहिए।
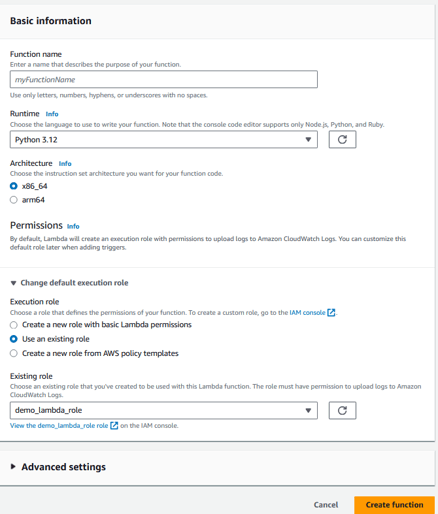
Lambda फ़ंक्शन कॉन्फ़िगर करना। चित्र: लेखक
3. फ़ंक्शन बनने के बाद, DynamoDB तालिका (हमारे मामले में Products तालिका) को एक ट्रिगर के रूप में जोड़ें।
अब डायग्राम निम्नलिखित जैसा दिखना चाहिए:
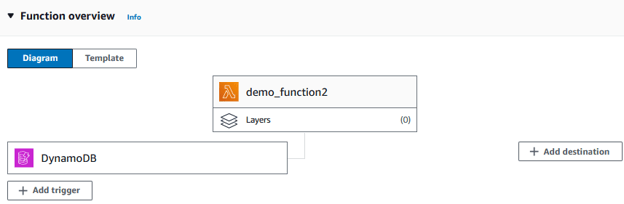
Lambda फ़ंक्शन में ट्रिगर जोड़ना। चित्र: लेखक
4. कॉन्फ़िगरेशन टैब पर जाएँ और फ़ंक्शन के लिए आवश्यक मेमोरी और रन टाइम आवंटित करें, क्योंकि डिफ़ॉल्ट मान अक्सर अपर्याप्त होते हैं।
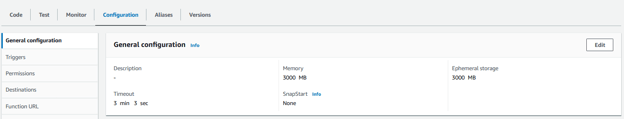
Lambda फ़ंक्शन के ट्रिगर को कॉन्फ़िगर करना। चित्र: लेखक
5. “Code” टैब में, अपनी पसंद की भाषा में डेटा माइग्रेशन की लॉजिक लिखें।
निम्नलिखित स्निपेट Python में एक Lambda फ़ंक्शन का उदाहरण है:
import boto3
import os
import json
def lambda_handler(event, context):
# Initialize the Redshift Data API client
redshift_client = boto3.client('redshift-data')
# Redshift cluster details
cluster_id = os.environ['REDSHIFT_CLUSTER_ID']
database = os.environ['REDSHIFT_DB_NAME']
user = os.environ['REDSHIFT_USER']
# IAM role ARN that has access to Redshift Data API
role_arn = os.environ['REDSHIFT_ROLE_ARN']
# Process DynamoDB stream records
for record in event['Records']:
if record['eventName'] in ['INSERT', 'MODIFY']:
new_image = record['dynamodb']['NewImage']
product_id = new_image['product_id']['S']
category = new_image['category']['S']
description = new_image['description']['S']
price = float(new_image['price']['N'])
product_name = new_image['product_name']['S']
stock_quantity = int(new_image['stock_quantity']['N'])
# SQL query to insert data into Redshift
query = f"""
INSERT INTO products (product_id, category, description, price, product_name, stock_quantity)
VALUES ('{product_id}', '{category}', '{description}', {price}, '{product_name}', {stock_quantity});
"""
# Execute the query using Redshift Data API
response = redshift_client.execute_statement(
ClusterIdentifier=cluster_id,
Database=database,
DbUser=user,
Sql=query
)
# Log the statement ID for tracking
print(f'Started SQL statement with ID: {response["Id"]}')
return {
'statusCode': 200,
'body': 'SQL statements executed successfully'
}सरल शब्दों में, यह फ़ंक्शन DynamoDB Streams द्वारा रिकॉर्ड किए गए जोड़े या संशोधित आइटम्स के लॉग को पढ़ता है और Redshift API क्लाइंट के साथ SQL क्वेरी निष्पादित करके उन्हें Redshift तालिका पर लागू करता है।
सुरक्षा के लिए, प्रमुख मान (जैसे, Redshift क्लस्टर आईडी) को स्क्रिप्ट में हार्ड-कोड करने के बजाय पर्यावरण वेरिएबल्स में संग्रहीत किया जाता है।
Lambda में पर्यावरण वेरिएबल्स के उपयोग के बारे में अधिक जानें: AWS दस्तावेज़।
6. कोड पूरा करने के बाद, फ़ंक्शन को डिप्लॉय करें और किसी भी त्रुटि की जाँच के लिए परीक्षण करें।
उपयोग के मामले के आधार पर, फ़ंक्शन के लिए अपने स्वयं के टेस्ट केस डिज़ाइन करना उपयोगी होगा।
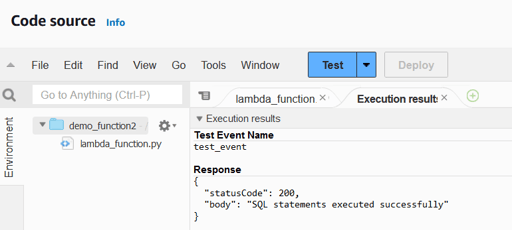
Lambda फ़ंक्शन के निष्पादन के परिणाम। चित्र: लेखक
जब Lambda फ़ंक्शन चालू हो जाए, तो हमें DynamoDB तालिका को इस तरह कॉन्फ़िगर करना होगा कि तालिका में कोई आइटम जोड़ा या संशोधित होने पर यह फ़ंक्शन चले।
7. DynamoDB तालिका चुनें और “Exports and streams” टैब पर जाएँ।
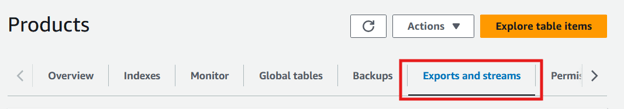
DynamoDB कंसोल का Exports and streams टैब। चित्र: लेखक
8. DynamoDB stream details तक स्क्रॉल करें और “Turn on” चुनें।
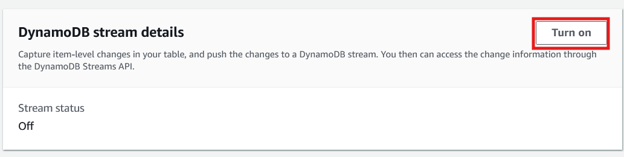
DynamoDB कंसोल का Exports and streams टैब। चित्र: लेखक
9. संकेत मिलने पर, DynamoDB Streams में रिकॉर्ड की जाने वाली जानकारी के प्रकार का चयन करें।
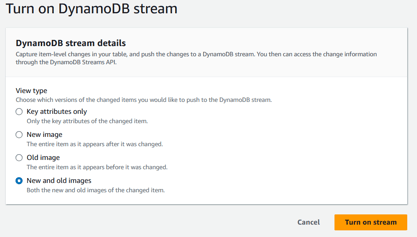
DynamoDB stream details स्क्रीन। चित्र: लेखक
10. स्ट्रीम चालू करने के बाद, उसी पेज पर नीचे स्क्रॉल करें और ट्रिगर बनाएँ।
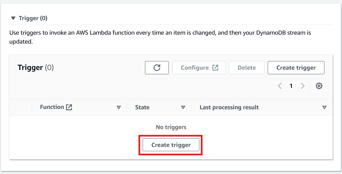
DynamoDB में Lambda फ़ंक्शन को कॉल करने के लिए ट्रिगर बनाना। चित्र: लेखक
11. अंत में, ट्रिगर कॉन्फ़िगर करते समय, पहले से बनाया गया Lambda फ़ंक्शन चुनें और “Create trigger” पर क्लिक करें।
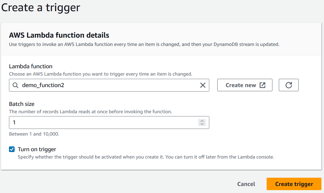
ट्रिगर करने के लिए Lambda फ़ंक्शन चुनना। चित्र: लेखक
इस समाधान को लागू करने से DynamoDB तालिका में किए गए किसी भी बदलाव स्वतः Redshift तालिका पर लागू हो जाएँगे, जिससे रियल-टाइम डेटा स्थिरता सुनिश्चित होगी।
DynamoDB Streams के लाभ
DynamoDB Streams, DynamoDB और Redshift के बीच रियल-टाइम सिंक्रोनाइज़ेशन बनाते हैं। इससे उपयोगकर्ता बिना मैनुअल हस्तक्षेप के अपनी Redshift तालिकाओं को अपडेट रख सकते हैं।
इस प्रकार, Redshift तालिकाएँ बार-बार अपडेट हो सकती हैं, जो उच्च डेटा थ्रूपुट वाली एप्लिकेशन (जैसे, रियल-टाइम डैशबोर्ड) को शक्ति दे सकती हैं। यह समाधान प्रत्येक इटरेशन में मानवीय त्रुटि के जोखिम को भी कम करता है।
DynamoDB Streams के नुकसान
इस समाधान को सेट अप करने के लिए कई AWS सेवाओं को कॉन्फ़िगर करना पड़ता है, जो समय लेने वाला हो सकता है।
क्योंकि Lambda एक Function as a Service (FaaS) टूल है, उपयोगकर्ताओं को किसी एक प्रोग्रामिंग भाषा पर अच्छी पकड़ चाहिए। साथ ही, डेटा सिंक्रोनाइज़ेशन की प्रत्येक इटरेशन में कई API कॉल्स लगती हैं, जिससे कुल लागत तेज़ी से बढ़ सकती है—विशेषकर जब अपडेट बार-बार हों। अंततः, यह समाधान पूरी तालिका के माइग्रेशन की तुलना में Redshift तालिकाओं में छोटे बदलावों के लिए अधिक व्यावहारिक है।
डेटा माइग्रेशन का सत्यापन
डेटा माइग्रेशन समाधान बनाने के बाद डेटा का वैधीकरण एक आवश्यक चरण है। भले ही AWS सेवाएँ बिना किसी समस्या के चलें, माइग्रेशन प्रक्रिया में फिर भी ऐसी त्रुटियाँ हो सकती हैं जिनका ध्यान न रखा गया हो। ये समस्याएँ तार्किक विसंगतियों, एट्रिब्यूट्स के गलत मैपिंग, या अधूरे डेटा ट्रांसफर से उत्पन्न हो सकती हैं।
Redshift में आगे होने वाले किसी भी विश्लेषण की सफलता के लिए माइग्रेटेड डेटा इन त्रुटियों से मुक्त होना चाहिए।
यह सेक्शन Products तालिका के उदाहरण के साथ माइग्रेटेड डेटा की जाँच के कुछ तरीकों और तकनीकों की पड़ताल करता है।
कॉलम संरचना और डेटा प्रकार का सत्यापन
सुनिश्चित करें कि DynamoDB तालिका के सभी कॉलम Redshift तालिका में मौजूद हों और उन्हें सही डेटा प्रकार सौंपे गए हों।
SELECT column_name, data_type
FROM information_schema.columns
WHERE table_name = Products;रो काउंट सत्यापित करें
डेटा स्रोत की तुलना में Redshift तालिका में पंक्तियों की संख्या मिलाकर यह पुष्टि करें कि डेटा ट्रांसफर पूरा हो गया है।
SELECT COUNT(*) FROM your_table_name;डेटा का पूर्वावलोकन
कॉलम्स और डेटा प्रकारों की पहचान करने का एक विकल्प डेटा का सरल पूर्वावलोकन करना है। उपयोगकर्ता किसी भी विसंगति या असामान्यता को पकड़ने के लिए पूर्वावलोकन पर निगाह डाल सकते हैं।
SELECT product_id, category, price FROM your_table_name LIMIT 5;जटिल व्यावसायिक लॉजिक का सत्यापन
सिर्फ पूर्वावलोकन बनाने या काउंट करने से सभी डेटासेट्स का पर्याप्त वैधीकरण नहीं हो पाता। जब डेटा का आकलन अधिक जटिल मानदंडों पर करना हो, तो उपयोगकर्ता व्यू बना सकते हैं।
उदाहरण के लिए, मान लें कि Products तालिका में इलेक्ट्रॉनिक्स का स्टॉक कभी कम नहीं होना चाहिए। इसे निम्नलिखित क्वेरी से मॉनिटर किया जा सकता है।
CREATE OR REPLACE VIEW low_stock_electronics AS
SELECT
Product_id, product_name, category, stock_quantity, price,
FROM
your_table_name
WHERE
stock_quantity < 50 AND
Category = ‘Electronics;Redshift में प्रदर्शन का अनुकूलन
क्वेरी प्रदर्शन का अनुकूलन, इनसाइट्स को कुशलतापूर्वक और कम लागत में निकालने के लिए आवश्यक है। ऐसी क्वेरी लिखना जो मेमोरी की बचत करें और रन टाइम घटाएँ, विशेष रूप से महत्वपूर्ण होगा क्योंकि हर माइग्रेशन के साथ डेटासेट बड़ा होता जाएगा।
यह सेक्शन Products तालिका को संदर्भ के रूप में लेते हुए क्वेरी ऑप्टिमाइज़ेशन के कुछ तरीकों का अन्वेषण करता है।
डिस्ट्रिब्यूशन की चुनें
Redshift में, डिस्ट्रिब्यूशन की यह निर्धारित करता है कि क्लस्टर के नोड्स में डेटा कैसे वितरित होगा। तालिका में सही डिस्ट्रिब्यूशन की चुनने से क्वेरी का रन टाइम घट सकता है।
उदाहरण के लिए, यदि Products तालिका को product_id फ़ील्ड पर अन्य तालिकाओं के साथ जोड़ा जाना है, तो तालिका बनाते समय product_id को डिस्ट्रिब्यूशन की के रूप में उपयोग करना लाभदायक होगा।
CREATE TABLE products (
product_id VARCHAR(100),
category VARCHAR(100),
description VARCHAR(100),
price INT,
stock_quantity INT
)
DISTKEY(product_id);सॉर्ट की चुनें
उचित सॉर्ट की का चयन सामान्य SQL ऑपरेशंस, जैसे फ़िल्टर और जॉइन, को बेहतर बनाता है। Redshift में उपयोगकर्ता सॉर्ट की मैन्युअल रूप से चुन सकते हैं या अपने लिए सॉर्ट की चुने जाने दे सकते हैं। सॉर्ट की दो श्रेणियों में आते हैं: compound sort keys और interleaved sort keys। सर्वश्रेष्ठ सॉर्ट की इस पर निर्भर करता है कि डेटा पर कौन-सी क्वेरी चलाई जानी हैं।
CREATE TABLE products (
product_id VARCHAR(100),
category VARCHAR(100),
description VARCHAR(100),
price INT,
stock_quantity INT
)
COMPOUND SORTKEY(category, product_id);सॉर्ट की पर अधिक जानकारी के लिए AWS दस्तावेज़ देखें।
कंप्रेशन का उपयोग करें
कंप्रेशन का अर्थ है दिए गए डेटा को कम बिट्स में एन्कोड करना। इससे तालिका कम स्टोरेज का उपयोग करती है, फिर भी सारी जानकारी बरकरार रहती है।
यदि आप सुनिश्चित नहीं हैं कि आपके डेटा के लिए कौन-सा कंप्रेशन बेहतर है, तो Redshift निम्न कमांड से प्रत्येक फ़ील्ड के लिए सर्वश्रेष्ठ एन्कोडिंग खोजने हेतु कंप्रेशन विश्लेषण कर सकता है:
ANALYZE COMPRESSION <table_name>;निष्कर्ष और आगे के कदम
DynamoDB से Redshift में डेटा माइग्रेट करने से उपयोगकर्ता Redshift की OLAP क्षमताओं का लाभ उठाकर अधिक जटिल डेटा विश्लेषण कर सकते हैं।
इस ट्यूटोरियल में तीन अलग-अलग माइग्रेशन तरीकों की पड़ताल की गई, जिनमें प्रत्येक के विशिष्ट लाभ और सीमाएँ हैं। सर्वोत्तम दृष्टिकोण का चयन करते समय, अपनी विश्लेषण संबंधी आवश्यकताओं, डेटा सीमाओं, और बजट पर सावधानी से विचार करें ताकि अपने विशिष्ट उपयोग मामले के लिए सबसे प्रभावी समाधान चुन सकें।
अगला अच्छा कदम Introduction to Redshift कोर्स शुरू करना है, ताकि मूलभूत अवधारणाएँ सीखें या दोहराएँ। AWS Security and Cost Management कोर्स भी AWS के साथ काम करने वाले किसी भी व्यक्ति के लिए सीखने योग्य अवधारणाओं का बढ़िया विकल्प है।
FAQs
क्या मैं बताए गए तरीकों से माइग्रेशन प्रक्रिया को स्वचालित कर सकता/सकती हूँ?
हाँ, AWS Glue और DynamoDB Streams दोनों ऑटोमेशन की सुविधा देते हैं। Glue जॉब्स को निश्चित अंतराल पर शेड्यूल किया जा सकता है, जबकि DynamoDB Streams को Lambda का उपयोग कर रियल-टाइम डेटा सिंक्रोनाइज़ेशन ट्रिगर करने के लिए सेट किया जा सकता है।
बड़े डेटासेट्स के लिए कौन-सा तरीका सबसे कुशल है?
बड़े डेटासेट्स के लिए आम तौर पर AWS Glue विधि सबसे अच्छा विकल्प है। यह व्यापक कस्टमाइज़ेशन और स्केलेबिलिटी प्रदान करता है, जिससे यह जटिल ETL कार्यों के लिए आदर्श है, भले ही इसमें अधिक सेटअप समय लग सकता है।
इन तरीकों का उपयोग करते समय लागत संबंधी किन बातों पर ध्यान देना चाहिए?
सीधे-सादे, एक-बार के माइग्रेशन के लिए COPY कमांड सबसे किफायती है। हालाँकि, Glue और DynamoDB Streams में लगातार संसाधन उपयोग के कारण लागत अधिक हो सकती है, इसलिए अपनी AWS सेवा खपत की निगरानी और अनुकूलन करना महत्वपूर्ण है।
क्या मैं पूरी तालिका माइग्रेट करने की बजाय विशिष्ट डेटा को चयनित रूप से ट्रांसफर कर सकता/सकती हूँ?
हाँ, AWS Glue और DynamoDB Streams विशिष्ट आइटम्स या एट्रिब्यूट्स को फ़िल्टर कर ट्रांसफर करने की लचीलापन देते हैं। दूसरी ओर, COPY कमांड पूरे डेटासेट को बिना फ़िल्टरिंग के ट्रांसफर करता है।
DynamoDB से Redshift में माइग्रेट करते समय क्या मैं स्कीमा बदलावों को संभाल सकता/सकती हूँ?
हाँ, Redshift में परिभाषित स्कीमा आवश्यक है, जबकि DynamoDB स्कीमा-लेस है। माइग्रेशन से पहले नए एट्रिब्यूट्स या फ़ील्ड्स को समायोजित करने के लिए आपको Redshift तालिका संरचना को मैन्युअली अपडेट करना होगा। स्कीमा अंतरों को संभालने में AWS Glue सबसे अधिक लचीलापन देता है।

एक उदीयमान डेटा वैज्ञानिक के रूप में, मैं कच्चे डेटा को क्रियाशील रणनीतियों में बदलने में माहिर हूँ। मैं Python, SQL, और मशीन लर्निंग तकनीकों का उपयोग करके डेटा विश्लेषण में प्रभावशाली समाधान निकालने और मजबूत ETL पाइपलाइनों को आर्किटेक्ट करने में विशेषज्ञता रखता/रखती हूँ, जो विशाल मात्रा में डेटा को इन्गेस्ट और प्रोसेस करती हैं।
Amazon DynamoDB बाजार में सबसे विश्वसनीय और व्यापक रूप से प्रयुक्त NoSQL डेटाबेस में से एक है। DynamoDB से Amazon Redshift में डेटा माइग्रेट करना, DynamoDB में संग्रहित डेटा की बेहतर समझ पाने के लिए अत्यंत उपयोगी है।
इस ट्यूटोरियल में, मैं DynamoDB से Redshift में डेटा माइग्रेट करने के तीन तरीके कवर करूँगा और प्रत्येक दृष्टिकोण के लिए चरणबद्ध निर्देश दूँगा। मैं डेटा अखंडता सुनिश्चित करने के सर्वोत्तम तरीकों और प्रदर्शन को अनुकूलित करने की रणनीतियों पर भी चर्चा करूँगा।
DynamoDB क्या है?
DynamoDB AWS द्वारा प्रदान किया गया एक पूर्णतः प्रबंधित सर्वरलेस NoSQL डेटाबेस है, जिसे उच्च प्रदर्शन और निर्बाध स्केलेबिलिटी के लिए डिज़ाइन किया गया है। यह लेन-देन संबंधी वर्कलोड संभालने में उत्कृष्ट है, टेराबाइट्स डेटा वाली तालिकाओं को सपोर्ट करते हुए प्रतिदिन अरबों अनुरोधों को संसाधित करता है।
अपनी असाधारण क्षमताओं के कारण, DynamoDB वित्त, ई-कॉमर्स, स्वास्थ्य सेवा, मीडिया, और गेमिंग क्षेत्रों में महत्वपूर्ण भूमिका निभाता है। इसे अक्सर यूज़र प्रोफ़ाइल लीडरबोर्ड बनाने और बनाए रखने, IoT डेटा संग्रहीत व संसाधित करने, और अन्य रियल-टाइम डेटा एक्सेस वाली एप्लिकेशन के लिए उपयोग किया जाता है।
यदि आप इस प्रकार के डेटाबेस में रुचि रखते हैं, तो NoSQL Concepts कोर्स आपको Redis, MongoDB, Apache Cassandra और Neo4j सहित चार लोकप्रिय NoSQL इंजनों के बारे में सिखाता है।
Redshift क्या है?
Redshift AWS का पूर्णतः प्रबंधित क्लाउड डेटा वेयरहाउस है, जिसे बड़े पैमाने पर डेटा प्रोसेसिंग को कुशलता और तेजी से संभालने के लिए बनाया गया है।
Massively Parallel Processing (MPP) तकनीक का लाभ उठाते हुए, Redshift कई नोड्स में उच्च मात्रा के डेटा को वितरित और प्रोसेस कर सकता है, जिससे जटिल SQL क्वेरी का तेज निष्पादन संभव होता है।
इसके अलावा, Redshift पर क्वेरी पारंपरिक डेटा वेयरहाउस की तुलना में कहीं अधिक किफायती होती हैं। Redshift की विश्लेषणात्मक क्षमताएँ बड़े डेटा एनालिटिक्स, रियल-टाइम डैशबोर्ड, और मशीन लर्निंग एप्लिकेशन सहित विभिन्न उपयोग मामलों के लिए महत्वपूर्ण हैं।
Introduction to Redshift कोर्स देखें और इस शक्तिशाली डेटा वेयरहाउस की गहरी समझ प्राप्त करें।
उपयोग का मामला समझना: DynamoDB से Redshift में डेटा क्यों स्थानांतरित करें?
जहाँ एक ओर DynamoDB, Online Transaction Processing (OLTP) सिस्टम्स के विशिष्ट लेन-देन संबंधी वर्कलोड संभालने में उत्कृष्ट है, वहीं यह जटिल विश्लेषण के लिए अनुकूलित नहीं है। दूसरी ओर, Redshift विशेष रूप से Online Analytical Processing (OLAP) सिस्टम्स के लिए डिज़ाइन किया गया है और इस भूमिका के लिए कहीं अधिक उपयुक्त है।
इस प्रकार, DynamoDB से Redshift में डेटा माइग्रेट करके, AWS उपयोगकर्ता उन्नत SQL-आधारित विश्लेषण कर सकते हैं और अपने डेटा से गहरे इनसाइट्स प्राप्त कर सकते हैं।