

Prasyarat dan Penyiapan
Tutorial ini mengasumsikan peserta memiliki hal berikut:
- Pengalaman sebelumnya dengan AWS dan alat serta teknik terkait lainnya.
- Pemahaman dasar tentang database relasional dan NoSQL.
- Terbiasa dengan SQL.
- Mengetahui setidaknya satu bahasa pemrograman akan bermanfaat.
Metode migrasi data akan memanfaatkan beberapa layanan inti AWS, termasuk:
- Identity and Access Management (IAM)
- DynamoDB
- Redshift
- S3
- Glue
- Lambda
Kursus AWS Cloud Technology and Services dapat membantu Anda memulai jika Anda baru mengenal AWS.
Sebagian besar prosedur akan dilakukan di konsol Manajemen AWS. Namun, langkah-langkah dalam tutorial juga dapat dijalankan dengan antarmuka baris perintah (CLI) AWS atau software development kit (SDK) AWS. Anda dapat melakukan migrasi data di lingkungan kerja pilihan Anda.
Menyiapkan DynamoDB untuk migrasi data
Saat mempersiapkan migrasi data, penting untuk mempertimbangkan komponen tabel DynamoDB dan bagaimana perbedaannya dari database relasional:
- Blok pembangun tabel DynamoDB adalah item (mirip dengan baris pada database relasional).
- Setiap item berisi satu atau banyak atribut, masing-masing merepresentasikan satu elemen data.
- Seperti tabel relasional, tabel DynamoDB memiliki kunci utama (primary key), yang berfungsi sebagai pengenal unik untuk setiap item. Kunci utama dapat terdiri dari satu partition key atau kombinasi partition key dan sort key.
- Fitur penting tabel DynamoDB adalah tanpa skema (schemaless), artinya setiap item dapat memiliki atribut yang unik.
Tutorial ini akan menggunakan tabel Products sederhana untuk mendemonstrasikan migrasi data. Berikut adalah datanya dalam format JSON:
{
"product_id": "P001",
"category": "Electronics",
"price": 700,
"product_name": "Phone"
},
{
"product_id": "P002",
"category": "Electronics",
"description": "The laptop is a Macbook.",
"price": 1000,
"product_name": "Laptop"
}Ada dua hal penting yang perlu diperhatikan:
product_idakan berfungsi sebagai kunci utama.- Atribut pada kedua item tidak sama karena item pertama tidak memiliki atribut
description.
Data ini ditambahkan ke tabel di DynamoDB sebagai bagian dari penyiapan.
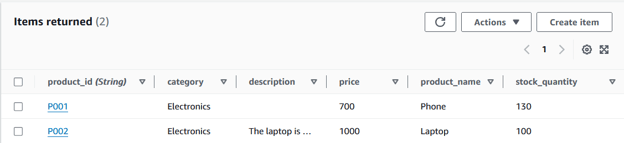
Item tabel DynamoDB. Gambar oleh penulis
Menyiapkan Amazon Redshift
Langkah berikutnya adalah menyiapkan tabel di Redshift yang akan menerima data dari tabel DynamoDB.
1. Buka konsol Redshift dan pilih “Create cluster.”
AWS memungkinkan pengguna menentukan berbagai parameter sebelum menyalakan cluster. Untuk tutorial ini, penekanan akan diberikan pada parameter yang diperlukan untuk memfasilitasi migrasi data.
Membuat cluster Redshift di Konsol Redshift. Gambar oleh penulis
2. Pilih tipe node dan jumlah node yang sesuai dengan volume data yang akan dianalisis.
Untuk memigrasikan tabel Products, Anda dapat menggunakan kapasitas CPU minimal dan hanya memiliki satu node.
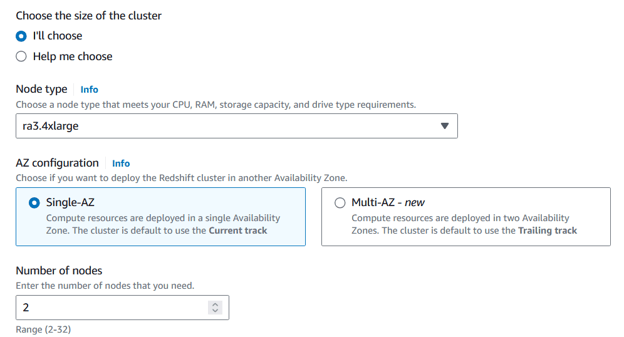
Menyesuaikan konfigurasi cluster Redshift. Gambar oleh penulis
3. Pilih nama pengguna admin dan kata sandi untuk cluster ini.
Simpan kredensial di tempat yang aman, karena akan diperlukan untuk mengakses cluster ini melalui layanan AWS lainnya.
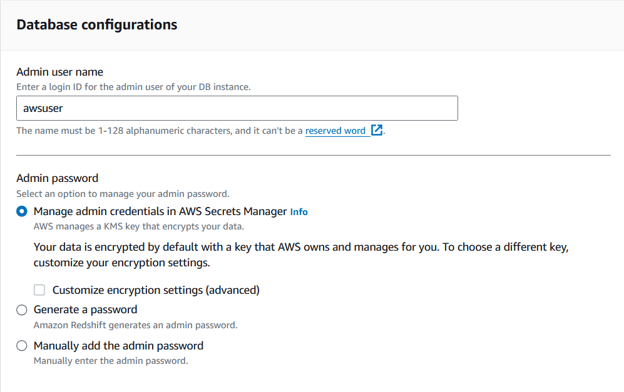
Menyesuaikan konfigurasi cluster Redshift. Gambar oleh penulis
4. Terakhir, tetapkan peran IAM ke cluster.
Peran IAM akan memerlukan kebijakan yang memungkinkan cluster membaca tabel DynamoDB dan membuat tabel di Redshift.
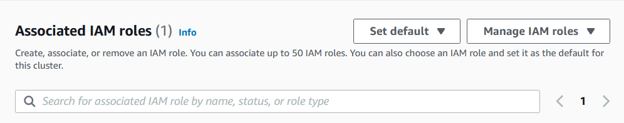
Menetapkan peran IAM ke cluster Redshift. Gambar oleh penulis
5. Setelah cluster dibuat, buka query editor dan buat tabel yang akan menampung data dari tabel DynamoDB menggunakan perintah CREATE:
CREATE TABLE Products (
product_id VARCHAR(50) PRIMARY KEY,
category VARCHAR(50),
description VARCHAR(100),
price INT,
product_name VARCHAR(50),
stock_quantity INT
);Ubah perintah di atas berdasarkan data yang diminati dan pertimbangkan kendala tambahan yang mungkin perlu diterapkan.
Selesai! Anda siap mulai mentransfer data.
Metode 1: Mentransfer Data dari DynamoDB ke Redshift Menggunakan Perintah COPY
Amazon Redshift menawarkan perintah COPY, yang memasukkan data dari sumber data AWS tertentu ke sebuah tabel.
1. Jalankan migrasi data menggunakan perintah COPY.
Sintaks perintahnya sebagai berikut:
COPY <table_name>
FROM <dynamo_db_table_path>
IAM_ROLE 'arn:aws:iam::<aws-account-id>:role/<role-name>'
REGION <region_name>';Untuk menambahkan data dari tabel Products di DynamoDB ke tabel Products di Redshift, perintahnya dapat diubah menjadi berikut:
COPY Products
FROM 'dynamodb://Products'
IAM_ROLE 'arn:aws:iam::<1234567890>:role/<dynamo_db_redshift_role>'
REGION ‘us-east-1’Kelebihan menggunakan perintah COPY
Perintah COPY adalah salah satu metode paling sederhana untuk memindahkan data dari DynamoDB ke Redshift. Penyiapannya minimal, dan kemudahannya membuat metode ini sangat mudah diakses bagi mereka yang kurang berpengalaman membangun pipeline ETL.
Selain itu, karena transfer data dilakukan secara langsung, tidak perlu mengintegrasikan layanan AWS lainnya.
Kekurangan menggunakan perintah COPY
Kelemahan utama metode ini adalah pengguna tidak dapat mengonfigurasi bagaimana atribut di tabel DynamoDB dipetakan ke kolom di tabel Redshift. Kurangnya fleksibilitas ini berpotensi membuat perintah COPY keliru menghilangkan atau salah memetakan kolom di tabel Redshift.
Selain itu, karena perintah ini mentransfer semua data dalam satu batch, operasi ini bisa tidak efisien jika beberapa rekaman sudah ditransfer ke Redshift sebelumnya. Pendekatan ini akan menghasilkan transfer data yang redundan untuk skenario seperti itu, sehingga meningkatkan waktu pemrosesan dan biaya penyimpanan.
Metode 2: Mentransfer Data dari DynamoDB ke Redshift Menggunakan AWS Glue
AWS Glue adalah layanan yang dirancang untuk membuat pipeline extract, transform, and load (ETL). Pengguna dapat mentransfer data dari DynamoDB ke Redshift dengan membuat sebuah pekerjaan (job) ETL.
Jika Anda baru pada Glue, pertimbangkan untuk mengikuti tutorial Getting Started with AWS Glue.
Dalam panduan ini, kita akan membaca tabel Products di DynamoDB, menyimpan hasilnya di bucket S3 sebagai file CSV, lalu mengirim data tersebut ke tabel Products di Redshift.
1. Buka konsol S3 dan buat bucket untuk menampung file CSV.
Konsol AWS S3. Gambar oleh penulis
2. Masuk ke konsol AWS Glue, dan dari panel kiri, pilih “ETL jobs” untuk mulai membuat job Anda.
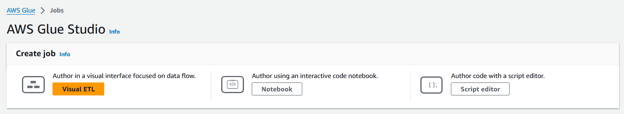
Konsol AWS Glue. Gambar oleh penulis
3. Pilih mode untuk membuat job ETL.
AWS menawarkan tiga mode pembuatan job: Visual ETL, Notebook, dan Script editor. Setiap mode melayani tingkat keahlian yang berbeda, sehingga pengguna dapat memilih metode yang disukai—baik antarmuka seret dan lepas (Visual ETL), lingkungan pengembangan interaktif (Notebook), atau penulisan kode mentah (Script Editor).
Job Glue dapat ditulis secara manual menggunakan Python atau Spark. Bagi yang kurang mahir dalam bahasa tersebut, Visual ETL merupakan pilihan yang tepat karena memungkinkan pengguna mengonfigurasi job hanya dengan klik.
Job Glue pada tutorial ini akan ditulis di code editor menggunakan Python, tetapi bagi yang tertarik pada opsi Visual ETL, silakan lihat dokumentasi AWS.
4. Tetapkan peran IAM ke job ini.
Peran IAM harus memiliki akses ke DynamoDB, Redshift, dan S3 agar tutorial ini dapat berjalan dengan sukses.
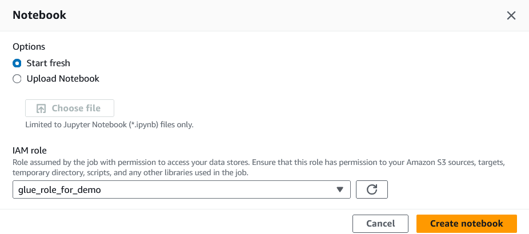
Menetapkan peran IAM ke job Glue. Gambar oleh penulis
5. Setelah membuat job, beralih ke tab “Job details” dan isi properti dasarnya.
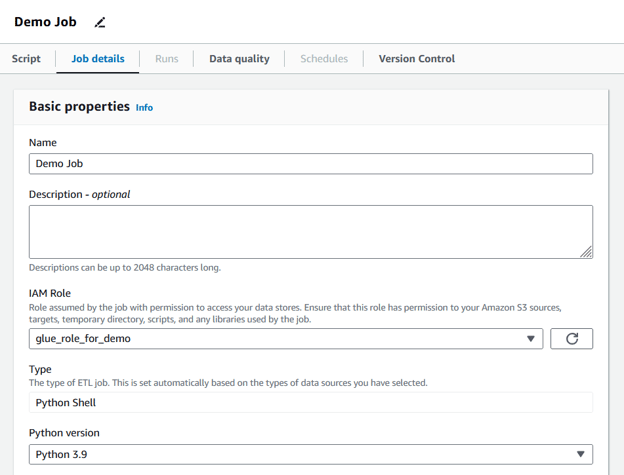
Mengisi detail job Glue. Gambar oleh penulis
Di bagian ini, pengguna dapat menentukan allocated data processing units (DPU), jumlah percobaan ulang (retries), dan batas waktu (timeout) untuk job. Job pada tutorial ini akan mempertahankan nilai default, namun disarankan agar pengguna menyesuaikan parameter sesuai kebutuhan job.
6. Beralih ke tab “Script” dan tulis logikanya.
Job ETL yang memigrasikan data pada tabel Products akan menjalankan kode berikut:
import boto3
import csv
import time
import os
from awsglue.context import GlueContext
from awsglue.job import Job
from pyspark.context import SparkContext
from awsglue.utils import getResolvedOptions
import sys
# initialize Glue context
args = getResolvedOptions(sys.argv, ["JOB_NAME"])
sc = SparkContext()
glueContext = GlueContext(sc)
job = Job(glueContext)
job.init(args["JOB_NAME"], args)
# initialize DynamoDB client and scan the table
dynamodb = boto3.client('dynamodb', region_name=os.getenv('AWS_REGION'))
response = dynamodb.scan(TableName=os.getenv('DYNAMODB_TABLE'))
# extract and write data to a CSV file
items = response['Items']
csv_file = '/tmp/products.csv'
# write each row in the table
with open(csv_file, mode='w', newline='') as file:
writer = csv.writer(file)
writer.writerow(['product_id', 'category', 'description', 'product_name', 'stock_quantity', 'price'])
for item in items:
writer.writerow([
item.get('product_id', {}).get('S', ''),
item.get('category', {}).get('S', ''),
item.get('description', {}).get('S', ''),
item.get('product_name', {}).get('S', ''),
item.get('stock_quantity', {}).get('N', 0),
item.get('price', {}).get('N', 0)
])
# upload the csv file to S3
s3 = boto3.client('s3', region_name=os.getenv('AWS_REGION'))
bucket_name = os.getenv('S3_BUCKET_NAME')
s3_key = 'products/products.csv'
s3.upload_file(csv_file, bucket_name, s3_key)
# wait for the file to upload before continuing
time.sleep(10)
# load data into Redshift using the COPY command
redshift = boto3.client('redshift', region_name=os.getenv('AWS_REGION'))
copy_command = f"""
COPY Products FROM 's3://{bucket_name}/{s3_key}'
IAM_ROLE 'arn:aws:iam::{os.getenv('AWS_ACCOUNT_ID')}:role/{os.getenv('REDSHIFT_ROLE')}'
FORMAT AS CSV
IGNOREHEADER 1;
"""
cluster_id = os.getenv('REDSHIFT_CLUSTER_ID')
database = os.getenv('REDSHIFT_DATABASE')
db_user = os.getenv('REDSHIFT_DB_USER')
# execute the copy statement
response = redshift.execute_statement(
ClusterIdentifier=cluster_id,
Database=database,
DbUser=db_user,
Sql=copy_command
)
# Commit the job
job.commit()Mari kita uraikan apa yang dilakukan skrip ini selangkah demi selangkah:
- Menggunakan pustaka
awsglueuntuk menyiapkan job agar dapat dieksekusi - Mengakses tabel DynamoDB dengan
boto3, SDK Python untuk AWS - Menulis item tabel di memori dan mengekspornya sebagai file CSV ke bucket S3 yang dibuat
- Mengakses cluster Redshift dengan
boto3 - Menulis dan mengeksekusi perintah
COPYyang memasukkan data dalam file CSV ke tabel Redshift
Catatan: Cuplikan kode contoh menjabarkan salah satu cara untuk memfasilitasi migrasi data. AWS Glue mendukung fleksibilitas, menawarkan berbagai cara untuk membangun pipeline ETL. Dengan demikian, pengguna dapat membuat job yang disesuaikan dengan kebutuhan mereka.
7. Setelah kode ditulis, simpan perubahan dan klik tombol “Run” untuk mengeksekusi job.
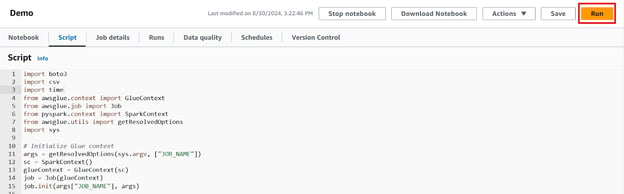
Editor skrip untuk job Glue. Gambar oleh penulis
8. Pantau progres job di tab “Runs”, tempat kesalahan atau masalah apa pun akan ditampilkan.
Verifikasi status job dan tinjau log untuk memastikan semuanya berjalan seperti yang diharapkan.
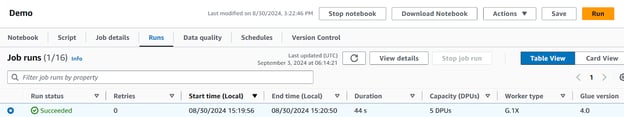
Tab Runs AWS Glue menampilkan job yang selesai. Gambar oleh penulis
Setelah job berhasil, job dapat dijalankan sesuai permintaan atau dijadwalkan sesuai kebutuhan, sehingga proses migrasi data Anda menjadi lebih efisien dan otomatis.
Kelebihan menggunakan Glue
AWS Glue menawarkan opsi kustomisasi yang luas, memungkinkan pengguna menyesuaikan job sesuai kebutuhan. Layanan ini juga memungkinkan penjadwalan job pada interval berkala (misalnya, harian), sehingga mendukung otomatisasi. Selain itu, Glue terintegrasi dengan banyak layanan lain, memudahkan interaksi dengan sumber data selain DynamoDB jika diperlukan.
Kekurangan menggunakan Glue
Mengonfigurasi job ETL di Glue sering kali memerlukan upaya dan waktu penyiapan. Meskipun pengetahuan pemrograman tidak wajib untuk menggunakan layanan ini, pengetahuan tersebut akan diperlukan untuk memanfaatkan fitur tertentu yang ditawarkan Glue, seperti pustaka AWSGlue dan SDK.
Selain itu, kecil kemungkinan job Glue berjalan sukses pada percobaan pertama, sehingga pengguna harus siap meluangkan waktu untuk pemecahan masalah. Terakhir, biaya job Glue dapat cepat meningkat jika tidak dikelola dengan baik, sehingga penting untuk hanya menyediakan sumber daya yang diperlukan.
Metode 3: Mentransfer Data dari DynamoDB ke Redshift Menggunakan DynamoDB Streams
DynamoDB Streams adalah fitur yang melacak perubahan yang dibuat pada tabel DynamoDB secara waktu nyata. Dengan memanfaatkan DynamoDB Streams, pengguna dapat secara otomatis memperbarui tabel Redshift mereka setiap kali ada perubahan pada sumber data di DynamoDB.
Baca dokumentasi AWS untuk informasi lebih lanjut tentang cara menggunakan DynamoDB Streams.
Solusi ini memerlukan akses ke AWS DynamoDB, Redshift, dan Lambda. Dalam pendekatan ini, sebuah fungsi Lambda akan dipicu saat suatu item ditambahkan atau dimodifikasi di tabel Products di DynamoDB.
Berikut langkah-langkahnya:
1. Buka konsol Lambda dan pilih “Create Function.”
Konsol AWS Lamba. Gambar oleh penulis
2. Berikan informasi dasar untuk fungsi, termasuk bahasa pemrograman dan peran IAM.
Peran tersebut harus memiliki akses ke Lambda, DynamoDB, dan Redshift.
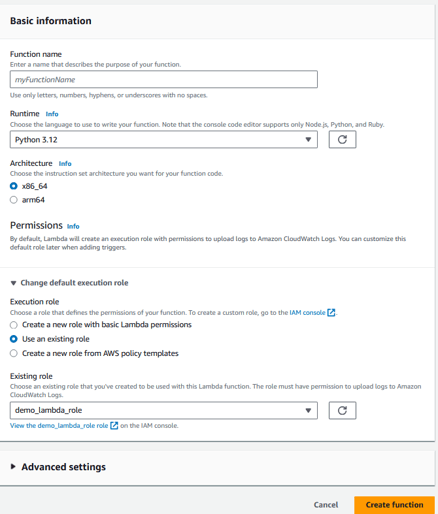
Mengonfigurasi fungsi Lambda. Gambar oleh penulis
3. Setelah membuat fungsi, tambahkan tabel DynamoDB (dalam kasus kita tabel Products) sebagai pemicu.
Diagramnya sekarang akan terlihat seperti berikut:
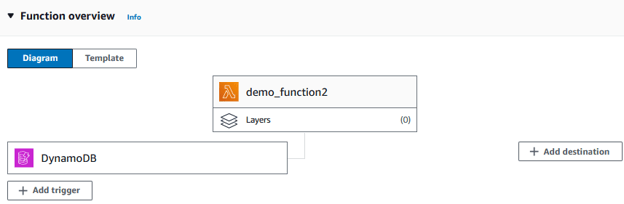
Menambahkan pemicu ke fungsi Lambda. Gambar oleh penulis
4. Beralih ke tab konfigurasi dan alokasikan jumlah memori serta waktu jalan yang diperlukan karena nilai default sering kali tidak mencukupi.
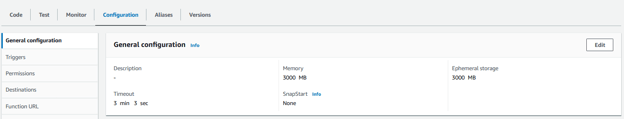
Mengonfigurasi pemicu untuk fungsi Lambda. Gambar oleh penulis
5. Di tab “Code”, tulis logika untuk migrasi data dalam bahasa pilihan Anda.
Cuplikan berikut adalah contoh seperti apa fungsi Lambda dalam Python:
import boto3
import os
import json
def lambda_handler(event, context):
# Initialize the Redshift Data API client
redshift_client = boto3.client('redshift-data')
# Redshift cluster details
cluster_id = os.environ['REDSHIFT_CLUSTER_ID']
database = os.environ['REDSHIFT_DB_NAME']
user = os.environ['REDSHIFT_USER']
# IAM role ARN that has access to Redshift Data API
role_arn = os.environ['REDSHIFT_ROLE_ARN']
# Process DynamoDB stream records
for record in event['Records']:
if record['eventName'] in ['INSERT', 'MODIFY']:
new_image = record['dynamodb']['NewImage']
product_id = new_image['product_id']['S']
category = new_image['category']['S']
description = new_image['description']['S']
price = float(new_image['price']['N'])
product_name = new_image['product_name']['S']
stock_quantity = int(new_image['stock_quantity']['N'])
# SQL query to insert data into Redshift
query = f"""
INSERT INTO products (product_id, category, description, price, product_name, stock_quantity)
VALUES ('{product_id}', '{category}', '{description}', {price}, '{product_name}', {stock_quantity});
"""
# Execute the query using Redshift Data API
response = redshift_client.execute_statement(
ClusterIdentifier=cluster_id,
Database=database,
DbUser=user,
Sql=query
)
# Log the statement ID for tracking
print(f'Started SQL statement with ID: {response["Id"]}')
return {
'statusCode': 200,
'body': 'SQL statements executed successfully'
}Secara sederhana, fungsi ini membaca log item yang ditambahkan atau dimodifikasi yang dicatat oleh DynamoDB Streams dan menerapkannya ke tabel Redshift dengan mengeksekusi kueri SQL menggunakan klien API Redshift.
Untuk keamanan, nilai kunci (misalnya, id cluster Redshift) disimpan dalam variabel lingkungan alih-alih ditulis langsung di skrip.
Pelajari lebih lanjut tentang penggunaan variabel lingkungan di Lambda dalam dokumentasi AWS.
6. Setelah menyelesaikan kodenya, deploy fungsi dan uji untuk memeriksa adanya kesalahan.
Tergantung use case, ada baiknya Anda merancang kasus uji sendiri untuk fungsi tersebut.
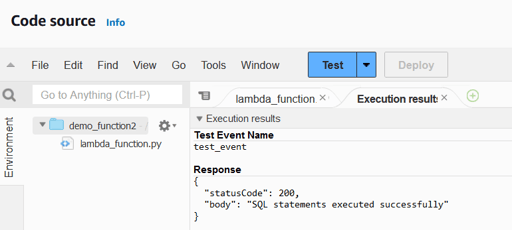
Hasil eksekusi fungsi Lambda. Gambar oleh penulis
Saat fungsi Lambda operasional, kita perlu mengonfigurasi tabel DynamoDB untuk menjalankan fungsi ini setiap kali sebuah item pada tabel ditambahkan atau dimodifikasi.
7. Pilih tabel DynamoDB dan beralih ke tab “Exports and streams”.
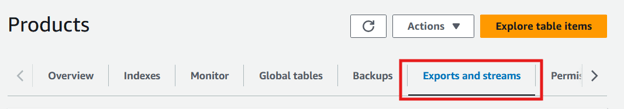
Tab Exports and streams pada konsol DynamoDB. Gambar oleh penulis
8. Gulir ke bawah ke detail stream DynamoDB dan pilih “Turn on.”
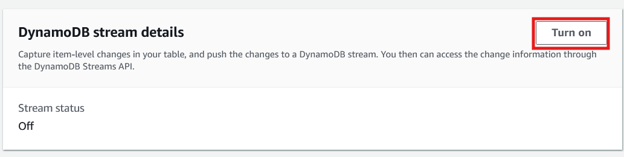
Tab Exports and streams konsol DynamoDB. Gambar oleh penulis
9. Saat diminta, pilih jenis informasi yang harus dicatat dalam DynamoDB Streams.
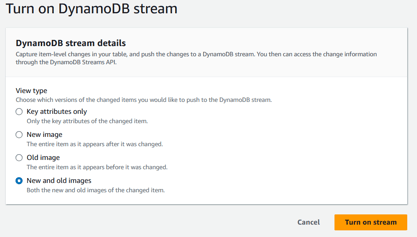
Layar detail stream DynamoDB. Gambar oleh penulis
10. Setelah menyalakan stream, gulir ke bawah pada halaman yang sama untuk membuat pemicu.
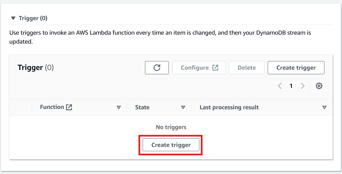
Membuat pemicu untuk memanggil fungsi Lambda di DynamoDB. Gambar oleh penulis
11. Terakhir, saat mengonfigurasi pemicu, pilih fungsi Lambda yang telah dibuat sebelum memilih “Create trigger.”
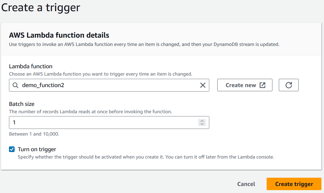
Memilih fungsi Lambda untuk dipicu. Gambar oleh penulis
Menerapkan solusi ini akan secara otomatis menerapkan perubahan apa pun yang dibuat pada tabel DynamoDB ke tabel di Redshift, memastikan konsistensi data waktu nyata.
Kelebihan menggunakan DynamoDB Streams
DynamoDB Streams menciptakan sinkronisasi waktu nyata antara DynamoDB dan Redshift. Ini memungkinkan pengguna menjaga tabel Redshift tetap mutakhir tanpa intervensi manual.
Dengan demikian, tabel Redshift dapat diperbarui secara sering, yang pada gilirannya dapat mendukung aplikasi yang memerlukan throughput data tinggi (misalnya, dasbor waktu nyata). Solusi ini juga mengurangi risiko kesalahan manusia di setiap iterasi.
Kekurangan menggunakan DynamoDB Streams
Menyiapkan solusi ini memerlukan konfigurasi sejumlah layanan AWS, yang dapat menyita waktu.
Karena Lambda adalah alat Function as a Service (FaaS), pengguna akan memerlukan penguasaan yang baik atas satu bahasa pemrograman. Selain itu, karena setiap iterasi sinkronisasi data memerlukan sejumlah panggilan API, total biaya dapat cepat bertambah, terutama dengan pembaruan yang sering. Terakhir, solusi ini lebih cocok untuk perubahan kecil pada tabel Redshift daripada migrasi seluruh tabel.
Memverifikasi Migrasi Data
Validasi data adalah langkah penting setelah membangun solusi migrasi data. Bahkan ketika layanan AWS berjalan tanpa masalah, masih bisa terjadi kesalahan dalam proses migrasi yang tidak terhitung. Masalah ini dapat berasal dari perbedaan logika, pemetaan atribut yang salah, atau transfer data yang tidak lengkap.
Data yang dimigrasikan harus bebas dari kesalahan tersebut agar analisis selanjutnya di Redshift berhasil.
Bagian ini mengeksplorasi beberapa pemeriksaan dan teknik untuk meninjau data yang dimigrasikan, menggunakan tabel Products sebagai contoh.
Validasi struktur kolom dan tipe data
Pastikan semua kolom pada tabel DynamoDB ada di tabel Redshift dan telah ditetapkan tipe data yang benar.
SELECT column_name, data_type
FROM information_schema.columns
WHERE table_name = Products;Verifikasi jumlah baris
Konfirmasikan bahwa transfer data telah selesai dengan membandingkan jumlah baris di tabel Redshift dengan jumlah pada sumber data.
SELECT COUNT(*) FROM your_table_name;Pratinjau data
Alternatif untuk mengidentifikasi kolom dan tipe data adalah dengan mempratinjau data. Pengguna dapat sekilas meninjau pratinjau untuk menemukan ketidaksesuaian atau anomali.
SELECT product_id, category, price FROM your_table_name LIMIT 5;Validasi logika bisnis yang kompleks
Memvalidasi data dengan membuat pratinjau atau melakukan perhitungan tidak cukup untuk semua dataset. Ketika ada kebutuhan untuk mengevaluasi data berdasarkan kriteria yang lebih kompleks, pengguna dapat membuat view.
Misalnya, anggaplah tabel Products tidak boleh memiliki stok rendah untuk kategori elektronik. Hasil ini dapat dipantau dengan kueri berikut.
CREATE OR REPLACE VIEW low_stock_electronics AS
SELECT
Product_id, product_name, category, stock_quantity, price,
FROM
your_table_name
WHERE
stock_quantity < 50 AND
Category = ‘Electronics;Mengoptimalkan Kinerja di Redshift
Mengoptimalkan kinerja kueri sangat penting untuk mengekstrak wawasan secara efisien dan dengan biaya rendah. Menulis kueri yang menghemat memori dan mengurangi waktu jalan akan semakin penting seiring pertumbuhan dataset di setiap migrasi.
Bagian ini mengeksplorasi beberapa metode untuk meningkatkan optimasi kueri, dengan menggunakan tabel Products sebagai referensi.
Pilih kunci distribusi
Di Redshift, kunci distribusi menentukan bagaimana data didistribusikan di node dalam sebuah cluster. Memilih kunci distribusi yang tepat pada suatu tabel dapat mengurangi waktu eksekusi kueri.
Misalnya, jika tabel Products akan digabungkan dengan tabel lain pada kolom product_id, akan bermanfaat untuk menggunakan product_id sebagai kunci distribusi saat membuat tabel.
CREATE TABLE products (
product_id VARCHAR(100),
category VARCHAR(100),
description VARCHAR(100),
price INT,
stock_quantity INT
)
DISTKEY(product_id);Pilih kunci urut (sort key)
Memilih sort key yang tepat memperkuat operasi SQL umum, seperti filter dan join. Di Redshift, pengguna dapat memilih sort key secara manual atau dipilihkan secara otomatis. Sort key terbagi dua kategori: compound sort key dan interleaved sort key. Sort key terbaik bergantung pada kueri yang perlu dijalankan pada data.
CREATE TABLE products (
product_id VARCHAR(100),
category VARCHAR(100),
description VARCHAR(100),
price INT,
stock_quantity INT
)
COMPOUND SORTKEY(category, product_id);Untuk informasi lebih lanjut tentang sort key, kunjungi dokumentasi AWS.
Gunakan kompresi
Kompresi berarti mengenkode data dengan bit yang lebih sedikit. Ini menghasilkan tabel yang menggunakan penyimpanan lebih kecil namun tetap mempertahankan semua informasi.
Bagi yang tidak yakin jenis kompresi apa yang paling cocok untuk datanya, Redshift dapat melakukan analisis kompresi untuk menemukan pengodean terbaik untuk setiap kolom dengan perintah berikut:
ANALYZE COMPRESSION <table_name>;Kesimpulan dan Langkah Selanjutnya
Migrasi data dari DynamoDB ke Redshift memungkinkan pengguna memanfaatkan kapabilitas OLAP Redshift untuk analisis data yang lebih kompleks.
Tutorial ini mengeksplorasi tiga metode migrasi yang berbeda, masing-masing dengan kelebihan dan kekurangan unik. Saat memilih pendekatan terbaik, evaluasilah dengan cermat kebutuhan analisis Anda, keterbatasan data, dan pertimbangan anggaran untuk memastikan solusi yang paling efektif untuk use case spesifik Anda.
Langkah bagus berikutnya adalah memulai kursus Introduction to Redshift, untuk mempelajari atau menyegarkan konsep dasar. Kursus AWS Security and Cost Management adalah alternatif lain yang bagus untuk mempelajari konsep yang harus dikuasai siapa pun yang bekerja dengan AWS.
FAQs
Bisakah saya mengotomatisasi proses migrasi menggunakan metode yang dijelaskan?
Ya, baik AWS Glue maupun DynamoDB Streams memungkinkan otomatisasi. Job Glue dapat dijadwalkan untuk berjalan pada interval tertentu, sedangkan DynamoDB Streams dapat diatur untuk memicu sinkronisasi data waktu nyata menggunakan Lambda.
Metode mana yang paling efisien untuk dataset besar?
Metode AWS Glue biasanya menjadi opsi terbaik untuk menangani dataset besar. Metode ini menyediakan kustomisasi dan skalabilitas yang luas, sehingga ideal untuk tugas ETL yang kompleks, meskipun mungkin membutuhkan waktu penyiapan lebih lama.
Apa pertimbangan biaya saat menggunakan metode ini?
Perintah COPY adalah yang paling hemat biaya untuk migrasi satu kali yang sederhana. Namun, Glue dan DynamoDB Streams dapat menimbulkan biaya lebih tinggi karena penggunaan sumber daya yang berkelanjutan, jadi penting untuk memantau dan mengoptimalkan konsumsi layanan AWS Anda.
Bisakah saya mentransfer data tertentu secara selektif alih-alih memigrasikan seluruh tabel?
Ya, AWS Glue dan DynamoDB Streams menawarkan fleksibilitas untuk memfilter dan mentransfer item atau atribut tertentu. Sementara itu, perintah COPY mentransfer seluruh dataset tanpa kemampuan pemfilteran.
Bisakah saya menangani perubahan skema di DynamoDB saat memigrasikan ke Redshift?
Ya, Redshift memerlukan skema yang terdefinisi, sementara DynamoDB tidak memiliki skema. Anda harus secara manual memperhitungkan perubahan skema dengan memperbarui struktur tabel Redshift untuk mengakomodasi atribut atau kolom baru sebelum migrasi. AWS Glue menawarkan fleksibilitas paling besar untuk menangani perbedaan skema.

Sebagai calon data scientist, saya unggul dalam mengubah data mentah menjadi strategi yang dapat ditindaklanjuti. Saya mengkhususkan diri dalam memanfaatkan Python, SQL, dan teknik machine learning untuk menghasilkan solusi berdampak dalam analisis data serta merancang pipeline ETL yang andal untuk mengumpulkan dan memproses data dalam jumlah besar.




Amazon DynamoDB adalah salah satu database NoSQL paling andal dan paling banyak digunakan di pasar. Memigrasikan data dari DynamoDB ke Amazon Redshift sangat bermanfaat untuk memperoleh pemahaman yang lebih mendalam tentang data yang disimpan di DynamoDB.
Dalam tutorial ini, saya membahas tiga metode untuk memigrasikan data dari DynamoDB ke Redshift, dengan instruksi langkah demi langkah untuk setiap pendekatan. Saya juga akan mengulas praktik terbaik untuk memastikan integritas data dan membahas strategi untuk mengoptimalkan kinerja.
Apa itu DynamoDB?
DynamoDB adalah database NoSQL tanpa server (serverless) yang sepenuhnya dikelola oleh AWS, dirancang untuk memberikan kinerja tinggi dan skalabilitas yang mulus. Layanan ini unggul dalam menangani beban kerja transaksional, mendukung tabel dengan data berukuran terabita sambil memproses miliaran permintaan per hari.
Berkat kemampuannya yang luar biasa, DynamoDB menjadi komponen penting di sektor keuangan, e-niaga, kesehatan, media, dan gim. Layanan ini sering digunakan untuk membangun dan memelihara papan peringkat profil pengguna, menyimpan dan memproses data IoT, serta aplikasi lain yang membutuhkan akses data waktu nyata.
Jika Anda tertarik dengan jenis database ini, kursus NoSQL Concepts mengajarkan empat mesin NoSQL populer—termasuk Redis, MongoDB, Apache Cassandra, dan Neo4j.
Apa itu Redshift?
Redshift adalah gudang data cloud AWS yang sepenuhnya dikelola, dirancang untuk menangani pemrosesan data skala besar secara efisien dan cepat.
Dengan memanfaatkan teknologi Massively Parallel Processing (MPP), Redshift dapat mendistribusikan dan memproses volume data yang tinggi di banyak node, sehingga memungkinkan eksekusi cepat pada kueri SQL yang kompleks.
Selain itu, kueri di Redshift jauh lebih hemat biaya dibandingkan gudang data tradisional. Kapabilitas analitik Redshift sangat penting untuk berbagai kasus penggunaan, termasuk analitik big data, dasbor waktu nyata, dan aplikasi pembelajaran mesin.
Lihat kursus Introduction to Redshift untuk pemahaman lebih mendalam tentang gudang data yang kuat ini.
Memahami Use Case: Mengapa Memindahkan Data dari DynamoDB ke Redshift?
Meski jelas bahwa DynamoDB unggul dalam menangani beban kerja transaksional yang khas pada sistem Online Transaction Processing (OLTP), layanan ini tidak dioptimalkan untuk analitik yang kompleks. Di sisi lain, Redshift dirancang khusus untuk sistem Online Analytical Processing (OLAP) dan jauh lebih cocok untuk peran ini.
Dengan demikian, dengan memigrasikan data dari DynamoDB ke Redshift, pengguna AWS dapat melakukan analitik berbasis SQL tingkat lanjut untuk mendapatkan wawasan yang lebih mendalam dari data mereka.