

AWS Glue:分步指南
精彩部分来了:让我们学习如何使用 Glue 完成一个非常常见的数据处理任务——将 CSV 文件转换为 Parquet。
1. 设置 AWS 账号
对于刚接触 AWS 的用户,第一步是创建账号并登录管理控制台。
- 前往 AWS 并注册。
- 创建账号后,登录 AWS 管理控制台。
2. 创建 IAM 角色
AWS 身份与访问管理(IAM)允许用户安全地管理对 AWS 服务和资源的访问。
我们需要创建一个 IAM 角色,以允许 Glue 访问相关服务。在本例中,我们主要访问的服务是托管 CSV 文件的 S3。
这篇 AWS 存储教程 是新手了解 S3 等系统的绝佳途径。
从管理控制台开始,创建该 IAM 角色的主要步骤如下:
- 进入 IAM 服务。
- 在左侧边栏点击“Roles(角色)”,然后点击“Create role(创建角色)”。
- 在“Choose a use case(选择用例)”下,选择“Glue”,然后点击“Next: Permissions(下一步:权限)”。
- 搜索并选择以下策略:
AWSGlueServiceRoleAmazonS3FullAccess(注意:在生产环境中,您应创建限制性更强的策略)。- 为您的角色命名(例如“GlueETLRole”),可选地填写描述,但非必填。最后点击“Create role(创建角色)”。
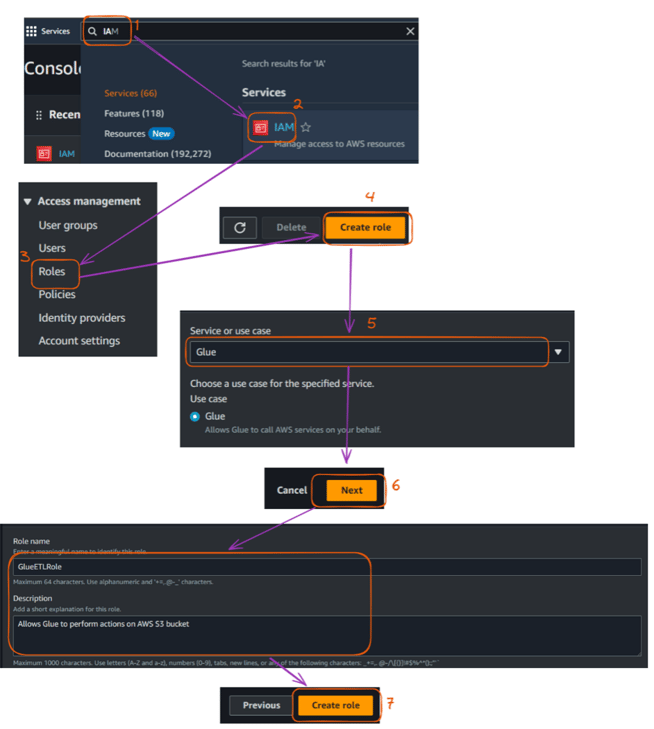
在 AWS 控制台中创建 IAM 角色的步骤。作者供图
这篇 AWS IAM 完整指南 介绍了如何使用 IAM 保护 AWS 环境、通过用户、用户组和角色管理访问,并概述了实现稳健安全性的最佳实践。
3. 设置 S3 存储桶
我们将在 Amazon S3 上存储输入的 CSV 文件和输出的 Parquet 文件。
本示例的输入数据为演示而创建,可在作者的 GitHub 仓库中找到:
athletes.csv:包含运动员的信息,包括其 ID、姓名、国家、项目和年龄。events.csv:列出各类赛事,包括赛事 ID、运动项目、赛事名称、日期和场馆。medals.csv:记录奖牌信息,将赛事和运动员与其所获奖牌关联起来。
现在,我们可以按如下方式设置 S3 存储桶:
- 在 AWS 管理控制台进入 S3 服务。
- 点击“Create bucket(创建存储桶)”,并为其指定唯一名称(例如“my-glue-csv-etl-bucket”)。
- 为简便起见,保留存储桶的默认设置并创建存储桶。
- 在您的存储桶内创建两个文件夹:“input” 和 “output”。
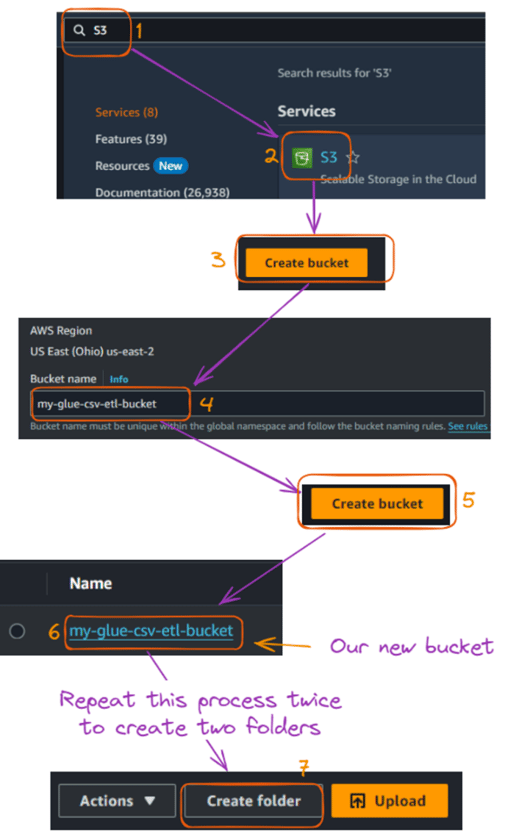
S3 存储桶与文件夹创建流程。作者供图
创建两个文件夹后,您的存储桶内容应如下所示:
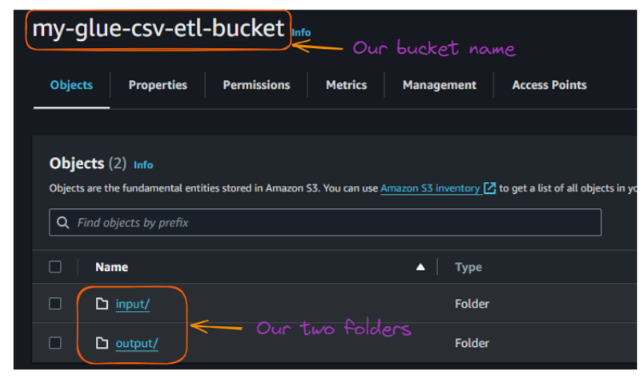
S3 存储桶内文件夹视图。作者供图
现在,我们可以将这些输入 CSV 文件上传到 “input” 文件夹。
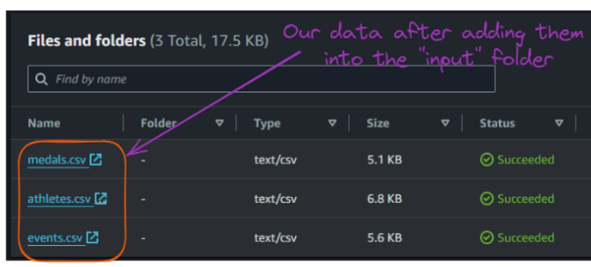
S3 存储桶 “input” 文件夹内容。作者供图
4. 创建 Glue 爬网程序
Glue 爬网程序用于自动发现并编目数据。本节将说明如何创建一个爬网程序来扫描所有输入的 CSV 文件。
主要步骤如下:
- 在 AWS 管理控制台进入 AWS Glue 服务。
- 在左侧边栏的 “Data catalog(数据目录)” 下,点击 “Crawlers(爬网程序)”。
- 点击 “Create crawler(创建爬网程序)”。
- 为爬网程序命名(例如 “CSV-to-Parquet-Crawler”),描述字段留空,然后点击 “Next(下一步)”。
- 我们需要指定 “S3” 作为数据源,即选择 “Add data source(添加数据源)” 作为爬网程序源类型并点击 “Next(下一步)”。
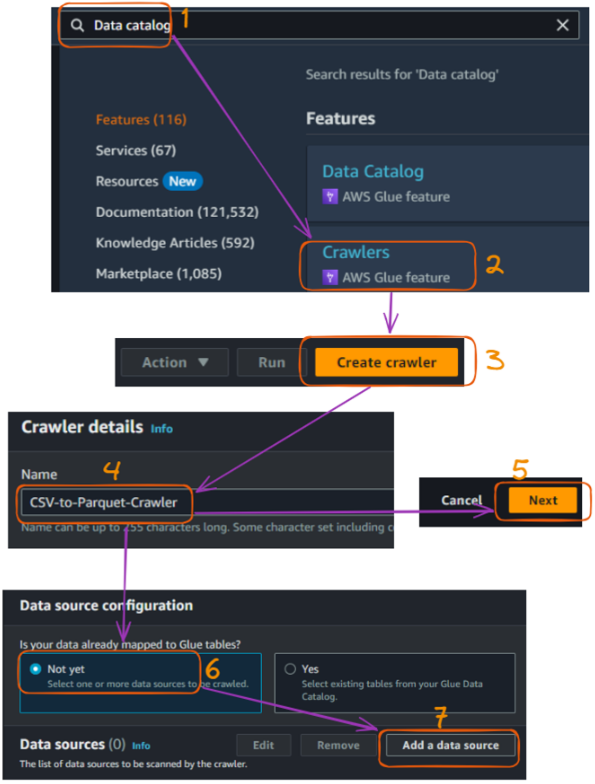
AWS Glue 爬网程序创建流程(控制台)- 第 1 部分。作者供图
- 选择 “S3” 作为数据存储,并通过 “Browse S3(浏览 S3)” 指定您的 S3 存储桶路径。然后点击 “Next(下一步)”。
- 选择 “Crawl all sub-folders(爬取所有子文件夹)”。
- 选择 “Add an S3 data source(添加 S3 数据源)”,然后点击 “Next(下一步)”。
- 继续之前,勾选 “S3” 数据类型,然后点击 “Next(下一步)”。
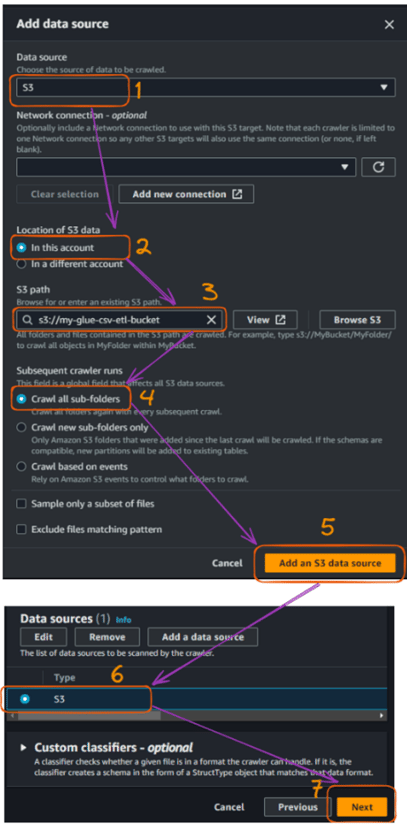
AWS Glue 爬网程序创建流程(控制台)- 第 2 部分。作者供图
连接 S3 存储桶后,我们需要连接之前创建的 IAM 角色,以允许 Glue 访问 S3 存储桶。我们的角色名称为 “GlueETLRole”。
- 在 “Existing IAM role(现有 IAM 角色)” 字段中选择该角色名称。
- 点击 “Next(下一步)”。
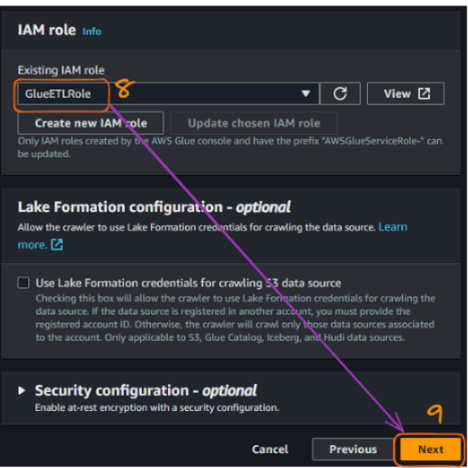
AWS Glue 爬网程序创建流程(控制台)- 第 3 部分。作者供图
下一步是创建数据库。我们将创建的 “paris_olympics_db” 数据库在 AWS Glue 数据目录中充当中心存储库,用于存储并组织有关 CSV 文件的元数据。
该目录将实现高效的数据发现,并简化我们的 ETL 过程,以便合并并将运动员、赛事和奖牌数据转换为 Parquet 格式。
目前我们尚未有任何数据库,创建步骤如下所示:
- 选择 “Add database(添加数据库)”,将打开新窗口以创建数据库。将其命名为 “paris_olympics_db”,其他保持默认,然后点击 “Create database(创建数据库)”。
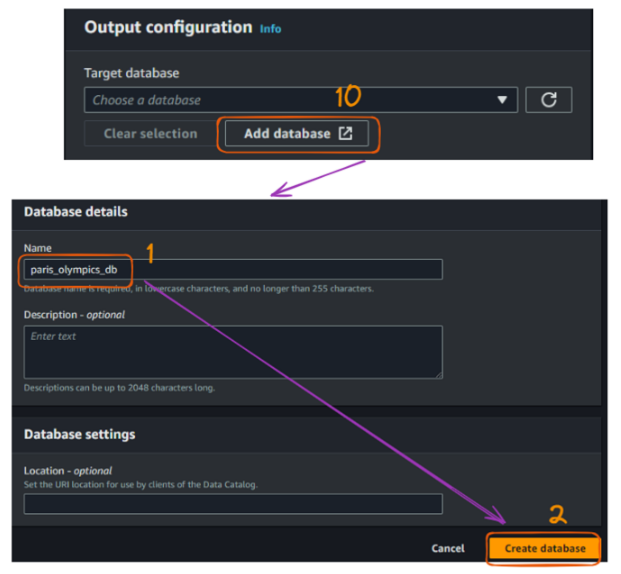
AWS Glue 爬网程序创建流程(控制台)- 第 4 部分。作者供图
回到连接数据库的原始选项卡,刷新 “Target database(目标数据库)” 区域并选择新建的数据库。然后点击 “Next(下一步)”。
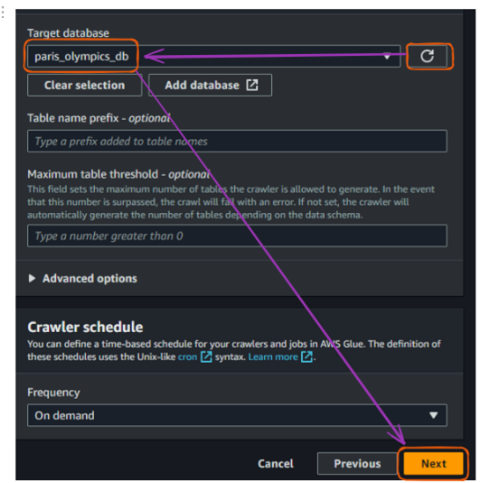
AWS Glue 爬网程序创建流程(控制台)- 第 5 部分。作者供图
最后,检查所有设置并点击 “Create crawler(创建爬网程序)”。
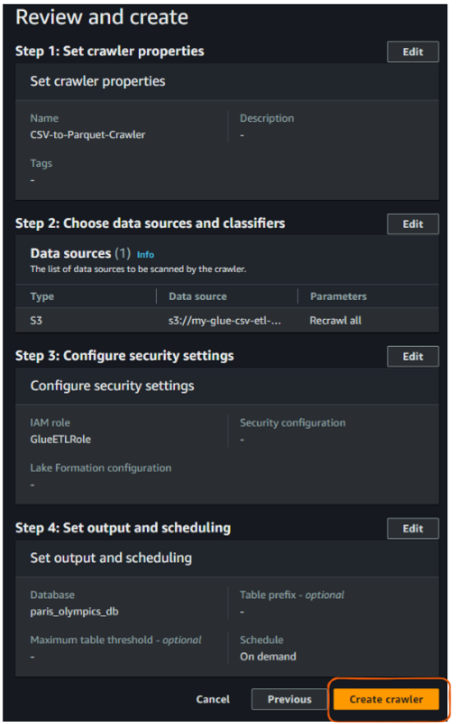
AWS Glue 爬网程序 “Review and create(审查并创建)” 视图。作者供图
创建爬网程序后,您应看到如下结果以确认创建成功:
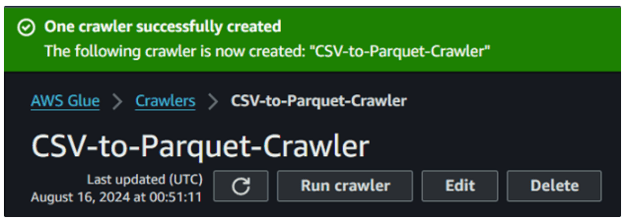
Glue 爬网程序创建成功。作者供图
5. 运行 Glue 爬网程序
既然已创建爬网程序,现在就运行它,看看它如何为我们的数据建立目录。
Glue “Run crawler(运行爬网程序)” 按钮。作者供图
- 从列表中选择您的爬网程序。
- 点击 “Run crawler(运行爬网程序)”。
- 等待爬网程序完成。这可能需要几分钟。
- 完成后,前往左侧边栏 “Data catalog(数据目录)” 下的 “Databases(数据库)”。
- 点击已创建的数据库。
- 您应能看到表示 CSV 数据结构的表。
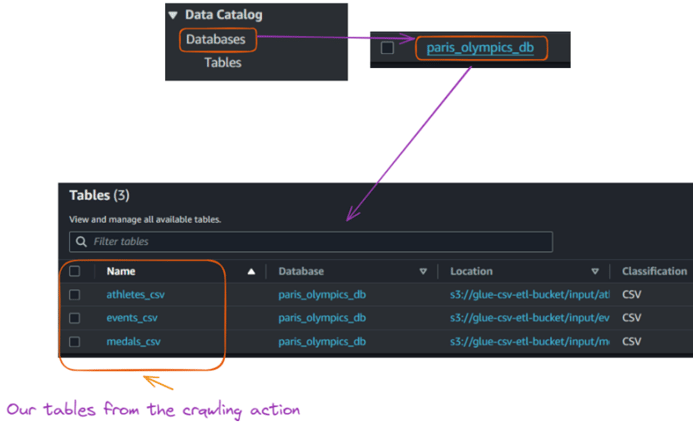
通过 Glue 爬网程序执行在数据库中创建的表视图。作者供图
6. 创建并运行 Glue 作业
在创建好数据目录后,我们现在可以创建一个 Glue 作业来合并 CSV 文件并将其转换为 Parquet 格式。本节将带您创建 Glue 作业,并提供所需的 Python 代码。
- 在 AWS Glue 控制台左侧边栏的 “ETL” 下进入 “Jobs(作业)”。
- 选择 Script editor(脚本编辑器)打开编辑器以编写 Python 代码,并点击 “Create script(创建脚本)”。
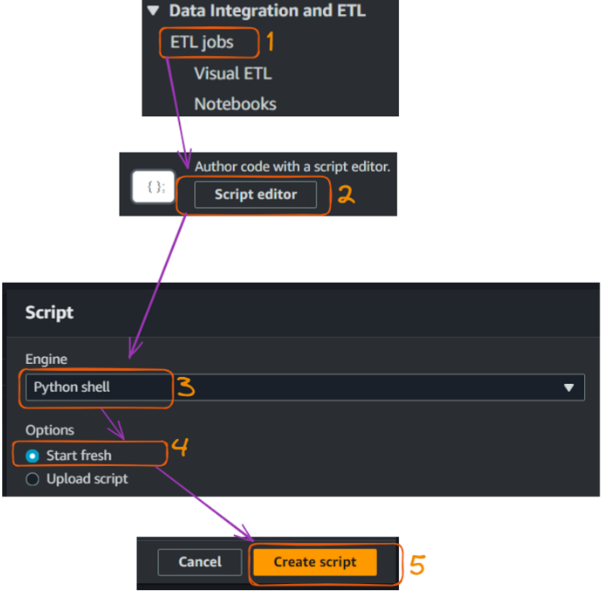
创建并运行 Glue 作业 - 第 1 部分。作者供图
创建脚本的操作会打开如下脚本选项卡,我们可以为作业命名,在本例中为 “CS”。
- 在代码区域中粘贴下方代码,然后点击 “Save(保存)”。
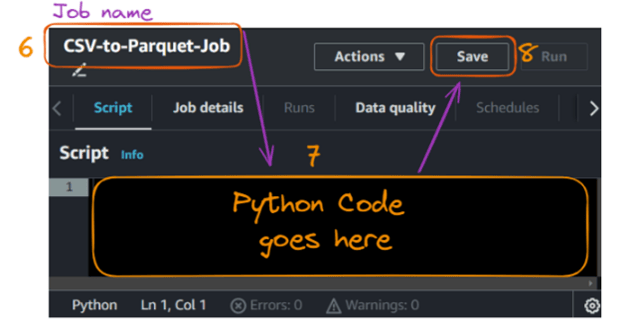
创建并运行 Glue 作业 - 第 2 部分。作者供图
对应的 Python 代码如下:
import sys
from awsglue.transforms import *
from awsglue.utils import getResolvedOptions
from pyspark.context import SparkContext
from awsglue.context import GlueContext
from awsglue.job import Job
from pyspark.sql.functions import col, to_date
# Initialize the Spark and Glue contexts
sc = SparkContext()
glueContext = GlueContext(sc)
spark = glueContext.spark_session
job = Job(glueContext)
# Set Spark configurations for optimization
spark.conf.set("spark.sql.adaptive.enabled", "true")
spark.conf.set("spark.sql.adaptive.coalescePartitions.enabled", "true")
# Get job parameters
args = getResolvedOptions(sys.argv, ['JOB_NAME'])
# Set the input and output paths
input_path = "s3://glue-csv-etl-bucket/input/"
output_path = "s3://glue-csv-etl-bucket/output/"
# Function to read CSV and write Parquet
def csv_to_parquet(input_file, output_file):
try:
# Read CSV
df = spark.read.option("header", "true") \
.option("inferSchema", "true") \
.option("mode", "PERMISSIVE") \
.option("columnNameOfCorruptRecord", "_corrupt_record") \
.csv(input_file)
# Print schema for debugging
print(f"Schema for {input_file}:")
df.printSchema()
# Convert date column if it exists (assuming it's in the format M/d/yyyy)
if "date" in df.columns:
df = df.withColumn("date", to_date(col("date"), "M/d/yyyy"))
# Write Parquet
df.write.mode("overwrite").parquet(output_file)
print(f"Successfully converted {input_file} to Parquet at {output_file}")
print(f"Number of rows processed: {df.count()}")
except Exception as e:
print(f"Error processing {input_file}: {str(e)}")
# List of files to process
files = ["athletes", "events", "medals"]
# Process each file
for file in files:
input_file = f"{input_path}{file}.csv"
output_file = f"{output_path}{file}_parquet"
csv_to_parquet(input_file, output_file)
job.commit()
print("Job completed.")让我们简要了解代码在做什么:
- 导入:从 AWS Glue、PySpark 和 Python 标准库导入必要的库。
- 初始化:初始化 Spark 和 Glue 上下文,并设置 Spark 优化配置。
- 作业参数:从命令行参数中获取作业参数,尤其是作业名称。
- 路径:定义 S3 存储桶中 CSV 与 Parquet 文件的输入与输出路径。
- 函数定义:定义
csv_to_parquet()函数以读取 CSV 文件、打印其模式、在存在时转换日期列,并将数据写为 Parquet 文件;同时在处理过程中进行异常处理。 - 文件处理:通过对文件列表(
athletes、events、medals)调用csv_to_parquet()函数处理每个文件。 - 作业提交:提交作业并打印完成消息。
在运行作业前,我们需要在 “Job details(作业详情)” 部分补充以下配置:
- 提供我们之前创建的 IAM 角色,以允许作业执行。
- 将作业 “Type(类型)” 设置为 “Spark”,其余字段保持默认,并点击 “Save(保存)”。
- 然后,运行作业!
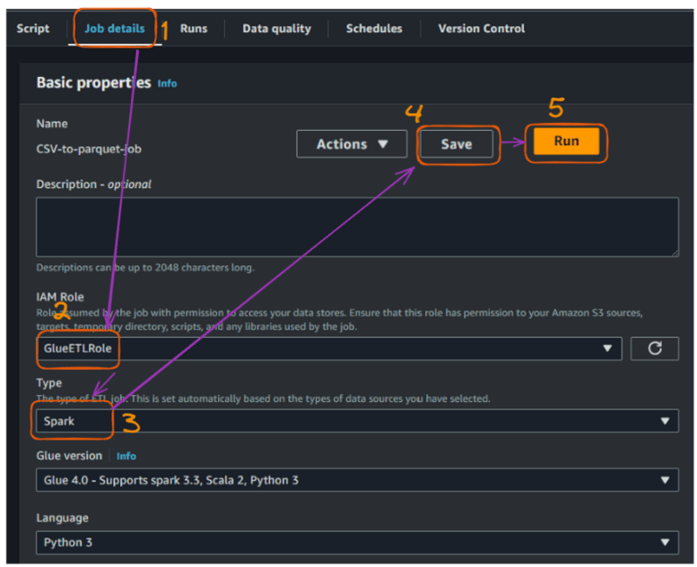
创建并运行 Glue 作业 - 第 3 部分。作者供图
成功运行作业后,我们可以查看更多关于执行状态的详细信息:
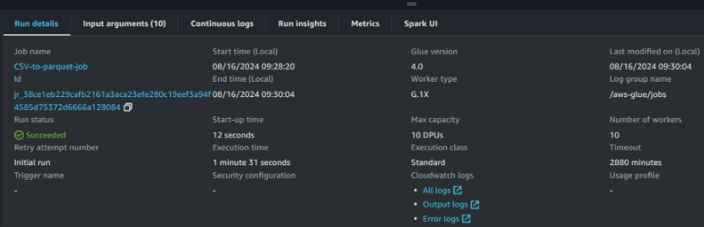
AWS Glue 作业运行详情视图。作者供图
访问并监控运行详情对于维护高效且可靠的数据流水线至关重要。这些指标提供了宝贵洞见,帮助我们做到:
- 性能优化:跟踪执行时间以提升作业效率与资源分配。
- 成本管理:监控资源使用情况(DPU、worker)以符合预算并优化支出。
- 容量规划:利用执行指标预测资源需求并规划可扩展性。
该作业成功执行后,将每个 CSV 文件转换为对应的 Parquet 文件,并将其存储在 “output” 文件夹中,如下所示:
- 左侧为与原始 CSV 文件同名的文件夹。
- 右侧对应每个 CSV 文件的 Parquet 文件。
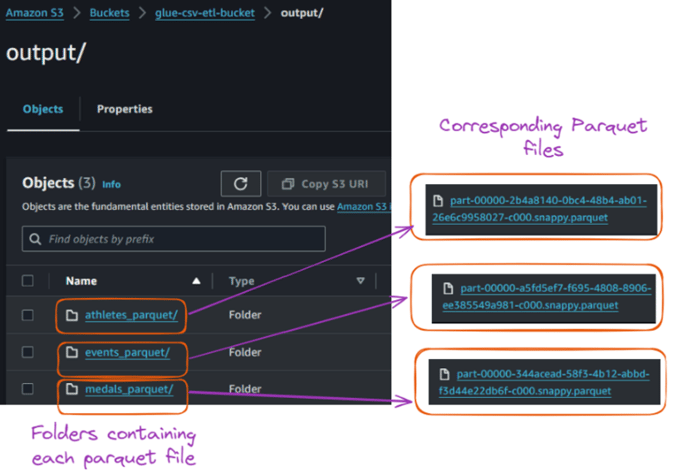
S3 存储桶中 output 文件夹的内容。作者供图
结语与后续步骤
本教程介绍了 AWS Glue 及其功能,引导您搭建 AWS 环境并探索 AWS Glue 界面。同时演示了如何构建并运行 Glue 爬网程序以编目数据,创建 Glue 作业进行转换,并成功将 CSV 文件转换为 Parquet 格式。
您可以在此基础上进一步扩展,例如设置触发器以自动化工作流、实现错误处理与日志记录,以及优化 Parquet 文件以获得更佳性能。您也可以使用 AWS Athena 或 Amazon Redshift Spectrum 查询数据。
此外,请监控您的 AWS 使用量与成本,并在不再需要时清理资源,以避免不必要的费用。
课程 Introduction to AWS 和 AWS Cloud Technology and Services 将是进一步学习的绝佳下一步!
前者为初学者或需要温习关键概念的读者提供扎实的 AWS 与云计算基础;后者侧重动手实践,帮助您加深对 AWS 服务的实操理解。
常见问题
优化 Parquet 文件性能的最佳实践有哪些?
要优化 Parquet 文件性能,可考虑调整文件大小(128 MB 至 1 GB 为宜)、为高效查询进行数据分区,并设置合适的压缩编解码器(如 Snappy 或 Gzip)。在使用 AWS Athena 等工具处理大型数据集时,这些策略可以减少 I/O 并提升查询速度。
如何在 AWS Glue 作业中实现错误处理和日志记录?
AWS Glue 可与 Amazon CloudWatch 集成,使您能够跟踪作业状态、错误和自定义日志。您可以将 Glue 作业配置为将日志写入 CloudWatch,以便更轻松地监控性能、排查问题,并确保 ETL 流程顺利执行。
除了 CSV 转 Parquet,AWS Glue 的常见用例还有哪些?
AWS Glue 功能多样,可处理诸如数据去重、数据丰富和模式转换等任务。它常用于将多个来源(如 RDS、S3、Redshift)的数据整合为统一格式、为机器学习模型准备数据,以及在数据湖中执行转换。
AWS Glue 与 Apache Airflow 或 Databricks 等其他 ETL 工具有何比较?
AWS Glue 是一项全托管、无服务器的 ETL 服务,而 Apache Airflow 是开源的工作流编排工具,需要更多配置与基础设施管理。另一方面,Databricks 专注于大规模数据分析与机器学习。AWS Glue 在易用性和与其他 AWS 服务的集成方面表现出色,但对于高度复杂的工作流,Airflow 或 Databricks 等工具可能提供更高的灵活性。
如何使用触发器自动化 AWS Glue 作业?
AWS Glue 中的触发器可通过在特定时间或特定事件(如 S3 存储桶中有新数据到达)后调度作业来自动化 ETL 工作流。您可以在 AWS Glue 控制台基于时间或事件设置触发器,从而实现无需人工干预的无缝数据处理。

一位多才多艺、乐于分享知识并回馈他人的数据科学家。Zoumana 是 YouTube 内容创作者,也是 Medium 上的顶尖科技写作者。他热爱演讲、编程与教学。Zoumana 拥有两个硕士学位:其一是在法国巴黎获得的计算机科学硕士,专注于机器学习;其二是在美国德州理工大学获得的数据科学硕士。他的职业生涯始于法国 Groupe OPEN 的软件开发工程师,随后加入 IBM 担任机器学习顾问,为保险公司构建端到端的 AI 解决方案。之后,Zoumana 加入了 Axionable——一家总部位于巴黎与蒙特利尔的首家“可持续 AI”初创公司。在那里,他担任数据科学家,为来自法国、蒙特利尔、新加坡和瑞士的客户交付 AI 产品,主要聚焦 NLP 场景。此外,他将 5% 的时间投入到研发工作。目前,他在 IFC(世界银行集团)担任高级数据科学家。
云原生解决方案因其安全性、灵活性和可扩展性,在各行各业日益流行。其中之一是 AWS Glue,它简化了数据处理——这是制定明智决策和优化业务运营的核心组成部分。
在本教程中,我们将使用 AWS Glue 演示一个常见的 ETL(抽取、转换、加载)任务:将存储在 S3 存储桶中的 CSV 文件转换为 Parquet 格式。使用 Parquet 能提升数据处理效率和查询性能。
我们将介绍 AWS Glue、其核心功能以及自动化数据准备的优势。接着,我们将带您完成 AWS 账号设置、创建 IAM 角色以及配置对 S3 存储桶的访问。最后,我们将指导您创建 Glue 爬网程序来扫描数据集并生成 Parquet 文件。
什么是 AWS Glue?
在开始实践步骤之前,先了解一下 AWS Glue 是什么,以及它为何适用于数据处理任务。
AWS Glue 是一项全托管的 ETL 服务,可轻松为分析准备和加载数据。它提供无服务器环境来创建、运行和监控 ETL 作业。AWS Glue 可通过 AWS Glue 数据目录自动发现和分析您的数据,推荐并生成 ETL 代码,并提供灵活的调度器来处理依赖关系解析、作业监控和重试。
为什么使用 AWS Glue?
了解 AWS Glue 的优势将帮助您认识它在数据处理流程中的价值。以下是使用 AWS Glue 的几个有力理由,其中一些如下所示:
为何选择 AWS Glue?作者供图