Nếu bạn mới bắt đầu với cơ sở dữ liệu, có thể bạn chưa từng đối mặt với mớ dữ liệu lộn xộn, trùng lặp hay nỗi bực bội vì truy vấn chậm rì. Nhưng tin tôi đi, sau năm năm làm việc ở nhiều startup với đủ kiểu cấu trúc cơ sở dữ liệu, tôi có thể nói rằng những vấn đề này xuất hiện thường xuyên hơn bạn tưởng.
Chuẩn hoá cơ sở dữ liệu là một trong những cách tốt nhất để xử lý những vấn đề trên, và tất cả bắt đầu từ dạng chuẩn thứ nhất (1NF). 1NF là một khái niệm đơn giản nhưng mạnh mẽ, giúp tạo ra các cơ sở dữ liệu hiệu quả, tin cậy và dễ bảo trì bằng cách đảm bảo tính nguyên tử trong các bảng. Đây cũng là bước nền tảng cho các dạng chuẩn khác như 2NF và 3NF.
Trong bài viết này, tôi sẽ hướng dẫn bạn mọi điều cần biết về 1NF: nó là gì, cách áp dụng trong thực tế và vì sao nó quan trọng. Dù bạn mới làm quen với thiết kế cơ sở dữ liệu hay đang muốn nâng cao kỹ năng, hướng dẫn này sẽ giúp bạn chỉnh trang các bảng và đặt nền tảng vững chắc cho các bước chuẩn hoá tiếp theo.
Sự phát triển lịch sử của chuẩn hoá cơ sở dữ liệu
Khi cơ sở dữ liệu mới ra đời, cấu trúc của chúng còn xa mới đạt đến những gì ta gọi là “chuẩn hoá” ngày nay. Các hệ thống thời kỳ đầu thường dựa vào tệp phẳng hoặc cấu trúc phân cấp, khiến việc quản lý và truy xuất dữ liệu trở nên cồng kềnh. Những thiết kế đó có nhiều hạn chế nghiêm trọng như dư thừa dữ liệu, thiếu nhất quán và kém linh hoạt. Sự ra đời của chuẩn hoá cơ sở dữ liệu, bắt đầu từ dạng chuẩn thứ nhất, đã giải quyết các thách thức này và cách mạng hoá cách chúng ta lưu trữ và quản lý dữ liệu.
Nguồn gốc của 1NF
Khái niệm dạng chuẩn thứ nhất được giới thiệu bởi Edgar F. Codd, người được xem là cha đẻ của cơ sở dữ liệu quan hệ. Vào thập niên 1970, Codd đề xuất mô hình quan hệ như một lựa chọn thay thế cho các mô hình phân cấp và mạng lưới vốn chiếm ưu thế thời bấy giờ. Mục tiêu của ông rất rõ ràng: tạo ra một phương pháp có hệ thống để tổ chức dữ liệu giúp giảm dư thừa, loại bỏ dị thường và làm cho việc thao tác dữ liệu hiệu quả hơn.
Trọng tâm của mô hình này là 1NF, đặt ra quy tắc nền tảng rằng mỗi ô trong bảng phải chứa một giá trị đơn, nguyên tử và cần loại bỏ các nhóm lặp. Nguyên tắc này giải quyết những vấn đề phổ biến ở các hệ thống trước đó, như cập nhật thiếu nhất quán và khó khăn khi truy vấn dữ liệu lồng hoặc nhóm. Công trình của Codd về chuẩn hoá không chỉ giải quyết các vấn đề trước mắt mà còn mở đường cho những cấu trúc và thao tác cơ sở dữ liệu tiên tiến hơn.
Từ cơ sở dữ liệu thời kỳ đầu đến các hệ thống hiện đại
Việc áp dụng 1NF đánh dấu bước ngoặt trong phát triển cơ sở dữ liệu. Nó chuẩn hoá quá trình tổ chức dữ liệu thành các bảng với quan hệ rõ ràng, đặt nền móng cho các hệ thống dựa trên SQL vốn đang chiếm lĩnh bức tranh cơ sở dữ liệu ngày nay.
Trước 1NF, các hệ thống như Information Management System (IMS) của IBM dựa vào cấu trúc phân cấp, đòi hỏi thiết kế dạng cây cứng nhắc. Những hệ thống này gặp khó khi thích ứng với thay đổi dữ liệu hay nhu cầu kinh doanh. Với sự xuất hiện của 1NF và mô hình quan hệ, cơ sở dữ liệu trở nên linh hoạt hơn, cho phép các quan hệ động giữa các bảng và khả năng mở rộng tốt hơn.
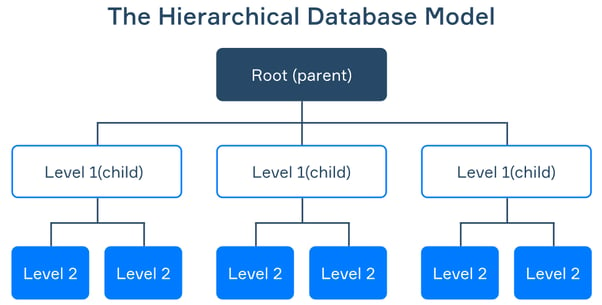
Nguồn: Airbyte
Các hệ quản trị cơ sở dữ liệu quan hệ (RDBMS) hiện đại như MySQL, PostgreSQL và Microsoft SQL Server thừa hưởng các nguyên lý thiết kế từ những khái niệm nền tảng của 1NF. Những hệ thống này cho phép nhà phát triển làm việc với dữ liệu có cấu trúc tốt, giúp việc thực hiện các truy vấn, cập nhật và tích hợp phức tạp trở nên dễ dàng hơn nhiều.
Việc áp dụng trong ngành
Lợi ích thực tiễn của 1NF – và của chuẩn hoá cơ sở dữ liệu nói chung – nhanh chóng được đón nhận trên nhiều lĩnh vực. Chẳng hạn, trong ngân hàng, 1NF giúp quản lý hồ sơ khách hàng và lịch sử giao dịch bằng cách đảm bảo dữ liệu được lưu trữ theo định dạng nhất quán và có thể truy vấn. Các nhà bán lẻ dùng 1NF để theo dõi tồn kho, bán hàng và đơn đặt hàng của khách. Hệ thống quản lý hàng tồn cũng là một lĩnh vực mà 1NF tỏ ra vô giá. Bằng cách cấu trúc dữ liệu ở dạng nguyên tử, không lặp, nhà sản xuất có thể duy trì bản ghi chính xác về linh kiện, mức tồn và luồng vận chuyển trong chuỗi cung ứng.
Điều kiện để đạt dạng chuẩn thứ nhất
Để đạt 1NF, cần thoả 4 điều kiện chính:
- Tính duy nhất của các hàng: Mỗi hàng phải là duy nhất, có một định danh riêng. Thông thường được đảm bảo bằng khoá chính để không có hàng trùng lặp.
- Không giả định về thứ tự: Thứ tự lưu trữ hay truy xuất các hàng không nên ảnh hưởng đến thiết kế cơ sở dữ liệu.
- Tính nguyên tử: Mỗi cột phải chứa giá trị nguyên tử (không thể chia nhỏ). Nghĩa là không được có tập hợp, mảng hoặc danh sách giá trị trong một cột.
- Không có cột trùng lặp: Không được có các cột lặp lại (tức là không có hai cột lưu cùng một loại thông tin).
Hai điều kiện đầu thường được thực thi ngay từ thiết kế trong hầu hết các cơ sở dữ liệu hiện đại, nên trong bài này chúng ta sẽ tập trung vào hai điều kiện sau: tính nguyên tử và cột duy nhất.
Các bước phân rã bảng để đạt 1NF
Có một vài bước đơn giản để phân rã một bảng đang vi phạm 1NF.
Bước 1: Xác định các giá trị không nguyên tử và nhóm lặp
Bước đầu là tìm các cột lưu nhiều giá trị trong một ô, hoặc – trong nỗ lực tránh điều đó – bị lặp cột. Những vi phạm này thường xuất hiện dưới dạng:
- Danh sách hoặc mảng (ví dụ: nhiều số điện thoại trong một cột, ngăn cách bằng dấu phẩy).
- Bảng lồng hoặc cấu trúc nhúng trong một ô đơn.
- Nhiều cột biểu diễn cùng một loại dữ liệu (ví dụ: ba cột có tiêu đề PhoneNumber1, PhoneNumber2, PhoneNumber3)
Bước 2: Tách giá trị thành các hàng mới
Tiếp theo, chúng ta cần cấu trúc lại bảng để mỗi ô chỉ chứa một giá trị và mỗi cột biểu diễn một loại dữ liệu. Điều này thường bao gồm:
- Nhân bản các hàng khi cần để đảm bảo mọi tổ hợp dữ liệu đều được giữ lại.
- Tạo các hàng mới hoặc thậm chí các bảng mới để tổ chức dữ liệu đúng cách.
Bước 3: Đảm bảo tính nhất quán
Sau khi tái cấu trúc, hãy kiểm tra bảng của bạn đáp ứng các yêu cầu 1NF sau. Nếu chưa chắc, hãy tự hỏi “Mình có thể sắp xếp, lọc hoặc truy vấn dữ liệu dễ dàng mà không cần xử lý bổ sung không?”. “Mỗi cột có biểu diễn một loại thuộc tính và mỗi hàng là một bản ghi duy nhất không?”. Nếu cả hai câu trả lời đều là có, thì bảng đã đạt 1NF.
Ví dụ về dạng chuẩn thứ nhất trong thực tế
Giờ chúng ta đã hiểu các bước chuyển đổi một bảng để đạt 1NF, hãy xem hai ví dụ thực tiễn.
Ví dụ 1: Bảng đơn hàng khách hàng
Hãy hình dung một bảng Customer Orders như sau:
| CustomerID | Name | Product1 | Product2 | OrderDate |
|---|
| 1 | Alice | Apples | Bananas | 2025-01-10 |
| 2 | Bob | Oranges | Grapes | 2025-01-11 |
Vấn đề ở đâu?
Bảng này vi phạm 1NF vì có nhiều cột, Product1 và Product2, cùng biểu diễn một loại dữ liệu (sản phẩm).
Vậy sửa thế nào?Để đạt 1NF, hãy tách dữ liệu thành các hàng riêng để mỗi ô chỉ chứa một giá trị:
| CustomerID | Name | Product | OrderDate |
|---|
| 1 | Alice | Apples | 2025-01-10 |
| 1 | Alice | Bananas | 2025-01-10 |
| 2 | Bob | Oranges | 2025-01-11 |
| 2 | Bob | Grapes | 2025-01-11 |
Tại sao điều này quan trọng?
Trong ví dụ 1NF này, chúng ta đã loại bỏ mơ hồ và làm cho việc truy vấn, phân tích dữ liệu đơn giản hơn. Việc tìm tất cả khách hàng đặt mua bananas giờ cực kỳ dễ!
Ví dụ 2: Bảng điểm sinh viên
Hãy xét một bảng Student Grades như sau:
| StudentID | Name | Grades |
|---|
| 101 | Sarah | A, B, C |
| 102 | Michael | B, A, A |
Vấn đề ở đâu?
Cột Grades vi phạm 1NF vì lưu nhiều điểm trong một ô thay vì dùng các giá trị nguyên tử.
Vậy sửa thế nào?Để tuân thủ 1NF, chúng ta cần tạo các hàng riêng cho từng điểm:
| StudentID | Name | Grade |
|---|
| 101 | Sarah | A |
| 101 | Sarah | B |
| 101 | Sarah | C |
| 102 | Michael | B |
| 102 | Michael | A |
| 102 | Michael | A |
Tại sao điều này quan trọng?
Việc tách điểm số thành các giá trị nguyên tử giúp tổ chức dữ liệu tốt hơn và dễ dàng tính điểm trung bình, xác định sinh viên xuất sắc hoặc phân tích phân bố điểm.
Nếu bạn muốn tự tay xây dựng cơ sở dữ liệu, hãy xem khoá học PostgresQL của chúng tôi. Nếu đã ở mức cao hơn một chút, bạn có thể thử Introduction to Data Modeling in Snowflake, trong đó đề cập các ý tưởng như mô hình hoá thực thể - quan hệ và mô hình hoá đa chiều.
Ưu và nhược điểm của dạng chuẩn thứ nhất
Hãy cùng xem điểm mạnh và điểm hạn chế:
Lợi ích của 1NF
Áp dụng 1NF mang lại vài lợi ích chủ chốt giúp làm việc với cơ sở dữ liệu dễ dàng và hiệu quả hơn.
Bằng cách buộc các giá trị phải nguyên tử, 1NF loại bỏ khả năng xuất hiện dữ liệu ghép chuỗi lộn xộn như "Apples, Bananas" ở một hàng và "Apples;Bananas" ở hàng khác. Sự thống nhất này làm dữ liệu sạch hơn và đơn giản hơn để đọc, truy vấn và cập nhật.
1NF cũng khiến việc thao tác dữ liệu trở nên trực quan hơn nhiều. Với các giá trị nguyên tử, bạn có thể dễ dàng tìm kiếm, lọc và cập nhật dữ liệu mà không gặp trục trặc. Ví dụ, một truy vấn tìm "Apples" sẽ nhanh hơn và chính xác hơn khi mỗi sản phẩm nằm ở hàng riêng thay vì bị dồn chung trong một cột. Nó cũng giảm rủi ro thiếu nhất quán khi cập nhật, vì thay đổi được giới hạn trong các hàng cụ thể.
Hạn chế của 1NF
1NF không phải là giải pháp hoàn hảo. Việc chuyển các cột lặp thành các hàng riêng hoặc tách các ô đa giá trị thành các hàng riêng có thể làm tăng số lượng hàng của bảng. Nhiều hàng hơn đồng nghĩa nhiều dữ liệu phải duyệt hơn, điều này có thể ảnh hưởng đến hiệu năng truy vấn.
Cần lưu ý rằng 1NF không phải là đích đến cuối cùng vì nó không xử lý mọi dạng dư thừa. Những vấn đề như phụ thuộc bộ phận hoặc phụ thuộc bắc cầu được giải quyết ở các dạng chuẩn cao hơn như dạng chuẩn thứ hai và dạng chuẩn thứ ba. Vì vậy, dù 1NF là nền tảng vững chắc, nó chỉ là bước đầu trong chuẩn hoá cơ sở dữ liệu và không thể tối ưu hoàn toàn cấu trúc cơ sở dữ liệu nếu đứng riêng lẻ.
Tiến xa hơn 1NF: Hướng tới dạng chuẩn thứ hai (2NF)
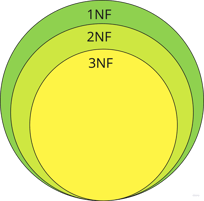
Các dạng chuẩn hoá cơ sở dữ liệu đầu tiên. Nguồn: Tác giả
Khi bạn đã xác nhận cơ sở dữ liệu đạt dạng chuẩn thứ nhất, bước hợp lý tiếp theo là hướng đến dạng chuẩn thứ hai. 2NF xây trên nền tảng của 1NF bằng cách xử lý một vấn đề then chốt: phụ thuộc bộ phận.
Trong 2NF, mục tiêu là loại bỏ phụ thuộc bộ phận, xảy ra khi một thuộc tính không khoá (thuộc tính không thuộc khoá chính) phụ thuộc chỉ vào một phần của khoá chính kết hợp. Điều này đặc biệt quan trọng với các bảng có khoá kết hợp – khoá tạo bởi nhiều cột. Nghe có vẻ trừu tượng, nhưng tôi đã viết hướng dẫn về dạng chuẩn thứ hai để phân tích khái niệm và đưa ra ví dụ thực tiễn. Bạn sẽ nắm vững rất nhanh!
Kết luận
Dạng chuẩn thứ nhất là bước đầu trong chuẩn hoá cơ sở dữ liệu, đảm bảo mỗi cột chứa các giá trị nguyên tử và loại bỏ các cột lặp.
Vì đặt nền tảng cho các dạng chuẩn nâng cao như 2NF và 3NF, nhiều khả năng bạn sẽ cần áp dụng 1NF nếu dự định xây dựng các cơ sở dữ liệu hiệu quả, có khả năng mở rộng và dễ bảo trì, có thể xử lý các truy vấn phức tạp và tập dữ liệu lớn một cách nhẹ nhàng!
Nếu bạn sẵn sàng nâng cao kỹ năng, hãy khám phá khoá học Database Design để đào sâu hiểu biết về các kỹ thuật chuẩn hoá và ứng dụng thực tiễn. Bạn cũng có thể xác thực kỹ năng SQL và quản trị cơ sở dữ liệu, đồng thời chứng minh chuyên môn của mình với SQL Associate Certification!


Nếu bạn mới bắt đầu với cơ sở dữ liệu, có thể bạn chưa từng đối mặt với mớ dữ liệu lộn xộn, trùng lặp hay nỗi bực bội vì truy vấn chậm rì. Nhưng tin tôi đi, sau năm năm làm việc ở nhiều startup với đủ kiểu cấu trúc cơ sở dữ liệu, tôi có thể nói rằng những vấn đề này xuất hiện thường xuyên hơn bạn tưởng.
Chuẩn hoá cơ sở dữ liệu là một trong những cách tốt nhất để xử lý những vấn đề trên, và tất cả bắt đầu từ dạng chuẩn thứ nhất (1NF). 1NF là một khái niệm đơn giản nhưng mạnh mẽ, giúp tạo ra các cơ sở dữ liệu hiệu quả, tin cậy và dễ bảo trì bằng cách đảm bảo tính nguyên tử trong các bảng. Đây cũng là bước nền tảng cho các dạng chuẩn khác như 2NF và 3NF.
Trong bài viết này, tôi sẽ hướng dẫn bạn mọi điều cần biết về 1NF: nó là gì, cách áp dụng trong thực tế và vì sao nó quan trọng. Dù bạn mới làm quen với thiết kế cơ sở dữ liệu hay đang muốn nâng cao kỹ năng, hướng dẫn này sẽ giúp bạn chỉnh trang các bảng và đặt nền tảng vững chắc cho các bước chuẩn hoá tiếp theo.
Sự phát triển lịch sử của chuẩn hoá cơ sở dữ liệu
Khi cơ sở dữ liệu mới ra đời, cấu trúc của chúng còn xa mới đạt đến những gì ta gọi là “chuẩn hoá” ngày nay. Các hệ thống thời kỳ đầu thường dựa vào tệp phẳng hoặc cấu trúc phân cấp, khiến việc quản lý và truy xuất dữ liệu trở nên cồng kềnh. Những thiết kế đó có nhiều hạn chế nghiêm trọng như dư thừa dữ liệu, thiếu nhất quán và kém linh hoạt. Sự ra đời của chuẩn hoá cơ sở dữ liệu, bắt đầu từ dạng chuẩn thứ nhất, đã giải quyết các thách thức này và cách mạng hoá cách chúng ta lưu trữ và quản lý dữ liệu.
Nguồn gốc của 1NF
Khái niệm dạng chuẩn thứ nhất được giới thiệu bởi Edgar F. Codd, người được xem là cha đẻ của cơ sở dữ liệu quan hệ. Vào thập niên 1970, Codd đề xuất mô hình quan hệ như một lựa chọn thay thế cho các mô hình phân cấp và mạng lưới vốn chiếm ưu thế thời bấy giờ. Mục tiêu của ông rất rõ ràng: tạo ra một phương pháp có hệ thống để tổ chức dữ liệu giúp giảm dư thừa, loại bỏ dị thường và làm cho việc thao tác dữ liệu hiệu quả hơn.
Trọng tâm của mô hình này là 1NF, đặt ra quy tắc nền tảng rằng mỗi ô trong bảng phải chứa một giá trị đơn, nguyên tử và cần loại bỏ các nhóm lặp. Nguyên tắc này giải quyết những vấn đề phổ biến ở các hệ thống trước đó, như cập nhật thiếu nhất quán và khó khăn khi truy vấn dữ liệu lồng hoặc nhóm. Công trình của Codd về chuẩn hoá không chỉ giải quyết các vấn đề trước mắt mà còn mở đường cho những cấu trúc và thao tác cơ sở dữ liệu tiên tiến hơn.
Từ cơ sở dữ liệu thời kỳ đầu đến các hệ thống hiện đại
Việc áp dụng 1NF đánh dấu bước ngoặt trong phát triển cơ sở dữ liệu. Nó chuẩn hoá quá trình tổ chức dữ liệu thành các bảng với quan hệ rõ ràng, đặt nền móng cho các hệ thống dựa trên SQL vốn đang chiếm lĩnh bức tranh cơ sở dữ liệu ngày nay.
Trước 1NF, các hệ thống như Information Management System (IMS) của IBM dựa vào cấu trúc phân cấp, đòi hỏi thiết kế dạng cây cứng nhắc. Những hệ thống này gặp khó khi thích ứng với thay đổi dữ liệu hay nhu cầu kinh doanh. Với sự xuất hiện của 1NF và mô hình quan hệ, cơ sở dữ liệu trở nên linh hoạt hơn, cho phép các quan hệ động giữa các bảng và khả năng mở rộng tốt hơn.
Nguồn: Airbyte
Các hệ quản trị cơ sở dữ liệu quan hệ (RDBMS) hiện đại như MySQL, PostgreSQL và Microsoft SQL Server thừa hưởng các nguyên lý thiết kế từ những khái niệm nền tảng của 1NF. Những hệ thống này cho phép nhà phát triển làm việc với dữ liệu có cấu trúc tốt, giúp việc thực hiện các truy vấn, cập nhật và tích hợp phức tạp trở nên dễ dàng hơn nhiều.
Việc áp dụng trong ngành
Lợi ích thực tiễn của 1NF – và của chuẩn hoá cơ sở dữ liệu nói chung – nhanh chóng được đón nhận trên nhiều lĩnh vực. Chẳng hạn, trong ngân hàng, 1NF giúp quản lý hồ sơ khách hàng và lịch sử giao dịch bằng cách đảm bảo dữ liệu được lưu trữ theo định dạng nhất quán và có thể truy vấn. Các nhà bán lẻ dùng 1NF để theo dõi tồn kho, bán hàng và đơn đặt hàng của khách. Hệ thống quản lý hàng tồn cũng là một lĩnh vực mà 1NF tỏ ra vô giá. Bằng cách cấu trúc dữ liệu ở dạng nguyên tử, không lặp, nhà sản xuất có thể duy trì bản ghi chính xác về linh kiện, mức tồn và luồng vận chuyển trong chuỗi cung ứng.
Điều kiện để đạt dạng chuẩn thứ nhất
Để đạt 1NF, cần thoả 4 điều kiện chính:
Hai điều kiện đầu thường được thực thi ngay từ thiết kế trong hầu hết các cơ sở dữ liệu hiện đại, nên trong bài này chúng ta sẽ tập trung vào hai điều kiện sau: tính nguyên tử và cột duy nhất.
Các bước phân rã bảng để đạt 1NF
Có một vài bước đơn giản để phân rã một bảng đang vi phạm 1NF.
Bước 1: Xác định các giá trị không nguyên tử và nhóm lặp
Bước đầu là tìm các cột lưu nhiều giá trị trong một ô, hoặc – trong nỗ lực tránh điều đó – bị lặp cột. Những vi phạm này thường xuất hiện dưới dạng:
Bước 2: Tách giá trị thành các hàng mới
Tiếp theo, chúng ta cần cấu trúc lại bảng để mỗi ô chỉ chứa một giá trị và mỗi cột biểu diễn một loại dữ liệu. Điều này thường bao gồm:
Bước 3: Đảm bảo tính nhất quán
Sau khi tái cấu trúc, hãy kiểm tra bảng của bạn đáp ứng các yêu cầu 1NF sau. Nếu chưa chắc, hãy tự hỏi “Mình có thể sắp xếp, lọc hoặc truy vấn dữ liệu dễ dàng mà không cần xử lý bổ sung không?”. “Mỗi cột có biểu diễn một loại thuộc tính và mỗi hàng là một bản ghi duy nhất không?”. Nếu cả hai câu trả lời đều là có, thì bảng đã đạt 1NF.
Ví dụ về dạng chuẩn thứ nhất trong thực tế
Giờ chúng ta đã hiểu các bước chuyển đổi một bảng để đạt 1NF, hãy xem hai ví dụ thực tiễn.
Ví dụ 1: Bảng đơn hàng khách hàng
Hãy hình dung một bảng Customer Orders như sau:
Vấn đề ở đâu?
Bảng này vi phạm 1NF vì có nhiều cột, Product1 và Product2, cùng biểu diễn một loại dữ liệu (sản phẩm).
Vậy sửa thế nào?Để đạt 1NF, hãy tách dữ liệu thành các hàng riêng để mỗi ô chỉ chứa một giá trị:
Tại sao điều này quan trọng?
Trong ví dụ 1NF này, chúng ta đã loại bỏ mơ hồ và làm cho việc truy vấn, phân tích dữ liệu đơn giản hơn. Việc tìm tất cả khách hàng đặt mua bananas giờ cực kỳ dễ!
Ví dụ 2: Bảng điểm sinh viên
Hãy xét một bảng Student Grades như sau:
Vấn đề ở đâu?
Cột Grades vi phạm 1NF vì lưu nhiều điểm trong một ô thay vì dùng các giá trị nguyên tử.
Vậy sửa thế nào?Để tuân thủ 1NF, chúng ta cần tạo các hàng riêng cho từng điểm:
Tại sao điều này quan trọng?
Việc tách điểm số thành các giá trị nguyên tử giúp tổ chức dữ liệu tốt hơn và dễ dàng tính điểm trung bình, xác định sinh viên xuất sắc hoặc phân tích phân bố điểm.
Nếu bạn muốn tự tay xây dựng cơ sở dữ liệu, hãy xem khoá học PostgresQL của chúng tôi. Nếu đã ở mức cao hơn một chút, bạn có thể thử Introduction to Data Modeling in Snowflake, trong đó đề cập các ý tưởng như mô hình hoá thực thể - quan hệ và mô hình hoá đa chiều.
Ưu và nhược điểm của dạng chuẩn thứ nhất
Hãy cùng xem điểm mạnh và điểm hạn chế:
Lợi ích của 1NF
Áp dụng 1NF mang lại vài lợi ích chủ chốt giúp làm việc với cơ sở dữ liệu dễ dàng và hiệu quả hơn.
Bằng cách buộc các giá trị phải nguyên tử, 1NF loại bỏ khả năng xuất hiện dữ liệu ghép chuỗi lộn xộn như "Apples, Bananas" ở một hàng và "Apples;Bananas" ở hàng khác. Sự thống nhất này làm dữ liệu sạch hơn và đơn giản hơn để đọc, truy vấn và cập nhật.
1NF cũng khiến việc thao tác dữ liệu trở nên trực quan hơn nhiều. Với các giá trị nguyên tử, bạn có thể dễ dàng tìm kiếm, lọc và cập nhật dữ liệu mà không gặp trục trặc. Ví dụ, một truy vấn tìm "Apples" sẽ nhanh hơn và chính xác hơn khi mỗi sản phẩm nằm ở hàng riêng thay vì bị dồn chung trong một cột. Nó cũng giảm rủi ro thiếu nhất quán khi cập nhật, vì thay đổi được giới hạn trong các hàng cụ thể.
Hạn chế của 1NF
1NF không phải là giải pháp hoàn hảo. Việc chuyển các cột lặp thành các hàng riêng hoặc tách các ô đa giá trị thành các hàng riêng có thể làm tăng số lượng hàng của bảng. Nhiều hàng hơn đồng nghĩa nhiều dữ liệu phải duyệt hơn, điều này có thể ảnh hưởng đến hiệu năng truy vấn.
Cần lưu ý rằng 1NF không phải là đích đến cuối cùng vì nó không xử lý mọi dạng dư thừa. Những vấn đề như phụ thuộc bộ phận hoặc phụ thuộc bắc cầu được giải quyết ở các dạng chuẩn cao hơn như dạng chuẩn thứ hai và dạng chuẩn thứ ba. Vì vậy, dù 1NF là nền tảng vững chắc, nó chỉ là bước đầu trong chuẩn hoá cơ sở dữ liệu và không thể tối ưu hoàn toàn cấu trúc cơ sở dữ liệu nếu đứng riêng lẻ.
Tiến xa hơn 1NF: Hướng tới dạng chuẩn thứ hai (2NF)
Các dạng chuẩn hoá cơ sở dữ liệu đầu tiên. Nguồn: Tác giả
Khi bạn đã xác nhận cơ sở dữ liệu đạt dạng chuẩn thứ nhất, bước hợp lý tiếp theo là hướng đến dạng chuẩn thứ hai. 2NF xây trên nền tảng của 1NF bằng cách xử lý một vấn đề then chốt: phụ thuộc bộ phận.
Trong 2NF, mục tiêu là loại bỏ phụ thuộc bộ phận, xảy ra khi một thuộc tính không khoá (thuộc tính không thuộc khoá chính) phụ thuộc chỉ vào một phần của khoá chính kết hợp. Điều này đặc biệt quan trọng với các bảng có khoá kết hợp – khoá tạo bởi nhiều cột. Nghe có vẻ trừu tượng, nhưng tôi đã viết hướng dẫn về dạng chuẩn thứ hai để phân tích khái niệm và đưa ra ví dụ thực tiễn. Bạn sẽ nắm vững rất nhanh!
Kết luận
Dạng chuẩn thứ nhất là bước đầu trong chuẩn hoá cơ sở dữ liệu, đảm bảo mỗi cột chứa các giá trị nguyên tử và loại bỏ các cột lặp.
Vì đặt nền tảng cho các dạng chuẩn nâng cao như 2NF và 3NF, nhiều khả năng bạn sẽ cần áp dụng 1NF nếu dự định xây dựng các cơ sở dữ liệu hiệu quả, có khả năng mở rộng và dễ bảo trì, có thể xử lý các truy vấn phức tạp và tập dữ liệu lớn một cách nhẹ nhàng!
Nếu bạn sẵn sàng nâng cao kỹ năng, hãy khám phá khoá học Database Design để đào sâu hiểu biết về các kỹ thuật chuẩn hoá và ứng dụng thực tiễn. Bạn cũng có thể xác thực kỹ năng SQL và quản trị cơ sở dữ liệu, đồng thời chứng minh chuyên môn của mình với SQL Associate Certification!