
कोर्स
डेटाबेस डिज़ाइन
4 घंटा
130.8K
यदि आप डेटाबेस के साथ अभी शुरू कर रहे हैं, तो शायद आपने बिखरे, दोहराए हुए डेटा की अव्यवस्था या बहुत धीमी क्वेरीज़ की झुंझलाहट का सामना नहीं किया होगा। पर मुझ पर भरोसा कीजिए, विभिन्न स्टार्टअप्स में पाँच साल काम करने और तरह-तरह की डेटाबेस संरचनाओं से जूझने के बाद, मैं कह सकता हूँ कि ये समस्याएँ आपकी उम्मीद से कहीं ज़्यादा बार सामने आती हैं।
डेटाबेस नॉर्मलाइज़ेशन इन समस्याओं से निपटने के सबसे अच्छे तरीकों में से एक है, और इसकी शुरुआत फर्स्ट नॉर्मल फॉर्म (1NF) से होती है। 1NF एक सरल लेकिन शक्तिशाली अवधारणा है जो आपकी तालिकाओं में एटोमिकिटी लागू करके कुशल, भरोसेमंद और सुगम रूप से बनाए रखने योग्य डेटाबेस बनाने में मदद करती है। यह 2NF और 3NF जैसी अन्य नॉर्मल फॉर्म्स की आधारशिला भी है।
इस लेख में, मैं आपको 1NF के बारे में वह सब कुछ समझाऊँगा जो आपको जानना चाहिए: यह क्या है, इसे व्यवहार में कैसे लागू करें, और यह क्यों महत्वपूर्ण है। चाहे आप डेटाबेस डिज़ाइन में नए हों या अपने कौशल को और निखारना चाहते हों, यह गाइड आपकी तालिकाओं को अपडेट करने और आगे की नॉर्मलाइज़ेशन प्रक्रियाओं के लिए मजबूत नींव रखने में मदद करेगा।
जब डेटाबेस पहली बार विकसित हुए थे, उनकी संरचनाएँ आज जिसे हम “नॉर्मलाइज़्ड” मानते हैं, उससे काफी अलग थीं। शुरुआती डेटाबेस सिस्टम अक्सर फ्लैट फाइल्स या हाइरार्किकल संरचनाओं पर निर्भर थे, जिससे डेटा का प्रबंधन और प्राप्ति मुश्किल हो जाती थी। इन डिज़ाइनों में डेटा दोहराव, असंगतता और अलचीलापन जैसी बड़ी सीमाएँ थीं। फर्स्ट नॉर्मल फॉर्म से शुरू हुई डेटाबेस नॉर्मलाइज़ेशन की प्रगति ने इन चुनौतियों का समाधान किया और डेटा को संग्रहित व प्रबंधित करने के तरीके में क्रांति ला दी।
फर्स्ट नॉर्मल फॉर्म की अवधारणा एडगर एफ. कॉड ने पेश की, जिन्हें व्यापक रूप से रिलेशनल डेटाबेस का जनक माना जाता है। 1970 के दशक में, कॉड ने रिलेशनल मॉडल का प्रस्ताव रखा, जो शुरुआती डेटाबेस सिस्टम्स में प्रचलित हाइरार्किकल और नेटवर्क मॉडलों के विकल्प के रूप में आया। उनका उद्देश्य स्पष्ट था: डेटा को व्यवस्थित करने के लिए एक व्यवस्थित तरीका बनाना, जो दोहराव कम करे, विसंगतियों को समाप्त करे और डेटा हैंडलिंग को अधिक कुशल बनाए।
इस मॉडल के केंद्र में 1NF था, जिसने यह बुनियादी नियम निर्धारित किया कि डेटाबेस तालिका की हर सेल में एकल, एटोमिक मान होना चाहिए और दोहराए जाने वाले समूहों को समाप्त करना चाहिए। इस सिद्धांत ने शुरुआती प्रणालियों की आम समस्याओं—जैसे असंगत अपडेट और नेस्टेड या समूहित डेटा पर क्वेरी करने में कठिनाई—का समाधान किया। नॉर्मलाइज़ेशन पर कॉड का काम न केवल तात्कालिक मुद्दों को हल करता है, बल्कि अधिक उन्नत डेटाबेस संरचनाओं और कार्यों का मार्ग भी प्रशस्त करता है।
1NF को अपनाना डेटाबेस विकास में एक निर्णायक मोड़ था। इसने स्पष्ट संबंधों वाली तालिकाओं में डेटा को व्यवस्थित करने की प्रक्रिया को औपचारिक रूप दिया, और आज के डेटाबेस परिदृश्य में प्रभुत्व रखने वाली SQL-आधारित प्रणालियों की नींव रखी।
1NF से पहले, IBM के Information Management System (IMS) जैसे सिस्टम हाइरार्किकल संरचनाओं पर निर्भर थे, जिन्हें सख्त ट्री-जैसे डिज़ाइन की आवश्यकता होती थी। ये सिस्टम डेटा या व्यावसायिक जरूरतों में बदलावों के अनुकूल बनने में संघर्ष करते थे। 1NF और रिलेशनल मॉडल के आने के साथ, डेटाबेस अधिक लचीले बने, जिससे तालिकाओं के बीच गतिशील संबंध और अधिक स्केलेबिलिटी संभव हुई।
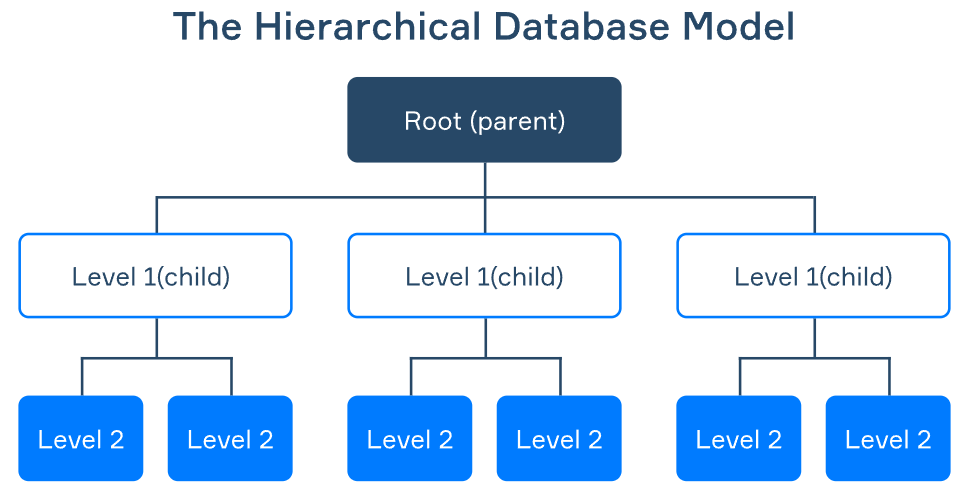
स्रोत: Airbyte
MySQL, PostgreSQL और Microsoft SQL Server जैसे आधुनिक रिलेशनल डेटाबेस मैनेजमेंट सिस्टम (RDBMS) अपने डिज़ाइन सिद्धांतों के लिए 1NF की बुनियादी अवधारणाओं के ऋणी हैं। ये सिस्टम डेवलपरों को सुव्यवस्थित डेटा के साथ काम करने में सक्षम बनाते हैं, जिससे जटिल क्वेरीज़, अपडेट और इंटीग्रेशन करना काफी आसान हो जाता है।
1NF—और सामान्य रूप से डेटाबेस नॉर्मलाइज़ेशन—के व्यावहारिक लाभों ने उद्योगों में तेजी से पैठ बनाई। उदाहरण के लिए, बैंकिंग में 1NF ने ग्राहक रिकॉर्ड और लेन-देन इतिहास को एक सुसंगत और क्वेरी करने योग्य प्रारूप में संग्रहीत करने में मदद की। रिटेलर्स ने 1NF का उपयोग इन्वेंटरी, बिक्री और ग्राहक ऑर्डर ट्रैक करने में किया। इन्वेंटरी प्रबंधन प्रणालियाँ भी ऐसा क्षेत्र थीं जहाँ 1NF बेहद उपयोगी साबित हुआ। एटोमिक, गैर-दोहराए जाने वाले रूपों में डेटा संरचित करके, निर्माता घटकों, स्टॉक स्तरों और सप्लाई चेन मूवमेंट्स का सटीक रिकॉर्ड रख सकते थे।
1NF प्राप्त करने के लिए 4 मुख्य शर्तें पूरी करनी होती हैं:
पहली दो शर्तें आमतौर पर अधिकांश आधुनिक डेटाबेस में डिज़ाइन के स्तर पर ही लागू हो जाती हैं, इसलिए इस लेख में हम आखिरी दो—एटोमिकिटी और यूनिक कॉलम्स—पर ध्यान देंगे।
1NF का उल्लंघन करने वाली तालिका को डीकंपोज़ करने के लिए कुछ सरल चरणों का पालन करें।
पहला कदम उन कॉलम्स को ढूँढना है जो एक ही सेल में कई मान स्टोर करते हैं, या—ऐसा करने से बचने के प्रयास में—दोहराए गए होते हैं। ये उल्लंघन अक्सर इस तरह दिखते हैं:
अगला, हमें तालिका को फिर से इस तरह संरचित करना है कि प्रत्येक सेल में केवल एक मान हो, और प्रत्येक कॉलम एक प्रकार के डेटा का प्रतिनिधित्व करे। इसमें प्रायः शामिल होता है:
पुनर्संरचना के बाद, जाँचें कि आपकी तालिका निम्नलिखित 1NF आवश्यकताओं को पूरी करती है। यदि संदेह हो, तो स्वयं से पूछें, “क्या मैं बिना अतिरिक्त प्रोसेसिंग के डेटा को आसानी से सॉर्ट, फ़िल्टर या क्वेरी कर सकता/सकती हूँ?” “क्या हर कॉलम एक प्रकार के एट्रिब्यूट का प्रतिनिधित्व करता है, और हर पंक्ति एक अद्वितीय रिकॉर्ड है?” यदि दोनों प्रश्नों का उत्तर हाँ है, तो तालिका 1NF में है।
अब जब हम तालिका को 1NF तक पहुँचाने के चरण समझ चुके हैं, तो दो व्यावहारिक उदाहरण देखते हैं।
मान लीजिए एक Customer Orders तालिका कुछ इस तरह दिखती है:
| CustomerID | Name | Product1 | Product2 | OrderDate |
|---|---|---|---|---|
| 1 | Alice | Apples | Bananas | 2025-01-10 |
| 2 | Bob | Oranges | Grapes | 2025-01-11 |
यह तालिका 1NF का उल्लंघन करती है क्योंकि इसमें कई कॉलम—Product1 और Product2—एक ही प्रकार के डेटा (प्रोडक्ट्स) को संदर्भित करते हैं।
इसे कैसे ठीक करें?1NF प्राप्त करने के लिए, डेटा को अलग-अलग पंक्तियों में बाँट दें ताकि हर सेल में केवल एक मान हो:
| CustomerID | Name | Product | OrderDate |
|---|---|---|---|
| 1 | Alice | Apples | 2025-01-10 |
| 1 | Alice | Bananas | 2025-01-10 |
| 2 | Bob | Oranges | 2025-01-11 |
| 2 | Bob | Grapes | 2025-01-11 |
इस फर्स्ट नॉर्मल फॉर्म उदाहरण में, हमने अस्पष्टता दूर की और डेटा को क्वेरी और विश्लेषण करना आसान बना दिया। अब उन सभी ग्राहकों को खोजना बहुत सरल है जिन्होंने केले मँगवाए!
एक Student Grades तालिका पर नज़र डालें जो कुछ इस तरह दिखती है:
| StudentID | Name | Grades |
|---|---|---|
| 101 | Sarah | A, B, C |
| 102 | Michael | B, A, A |
यहाँ Grades कॉलम 1NF का उल्लंघन करता है क्योंकि यह एक ही सेल में कई ग्रेड्स स्टोर करता है, बजाय एटोमिक मानों के।
इसे कैसे ठीक करें?1NF के अनुरूप बनने के लिए, हमें प्रत्येक ग्रेड के लिए अलग-अलग पंक्तियाँ बनानी होंगी:
| StudentID | Name | Grade |
|---|---|---|
| 101 | Sarah | A |
| 101 | Sarah | B |
| 101 | Sarah | C |
| 102 | Michael | B |
| 102 | Michael | A |
| 102 | Michael | A |
ग्रेड्स को एटोमिक मानों में तोड़ने से डेटा का संगठन बेहतर होता है और औसत निकालना, टॉप-परफॉर्मिंग छात्रों की पहचान करना या ग्रेड वितरण का विश्लेषण करना आसान हो जाता है।
यदि आप हाथ-से-हाथ सीखना चाहते हैं और अपने खुद के डेटाबेस बनाना चाहते हैं, तो हमारे PostgresQL कोर्स पर नज़र डालें। यदि आप थोड़े उन्नत हैं, तो यह Introduction to Data Modeling in Snowflake आज़मा सकते हैं, जिसमें एंटिटी-रिलेशनशिप और डाइमेंशनल मॉडलिंग जैसे विचार शामिल हैं।
आइए प्लस और माइनस देखते हैं:
1NF अपनाने से कुछ प्रमुख लाभ मिलते हैं, जो डेटाबेस के साथ काम करना कहीं अधिक आसान और कुशल बनाते हैं।
एटोमिक मानों को लागू करके, यह “Apples, Bananas” एक पंक्ति में और “Apples;Bananas” दूसरी पंक्ति में जैसी गड़बड़ी की संभावना खत्म कर देता है। यह एकरूपता डेटा को साफ-सुथरा और पढ़ने, क्वेरी करने तथा अपडेट करने में सरल बनाती है।
1NF डेटा मैनिपुलेशन को भी काफी सीधा बना देता है। एटोमिक मान होने पर आप आसानी से डेटा को खोज, फ़िल्टर और अपडेट कर सकते हैं। उदाहरण के लिए, “Apples” को खोजने वाली क्वेरी तब कहीं तेज़ और अधिक सटीक होती है जब हर प्रोडक्ट अपनी अलग पंक्ति में हो, बजाय इसके कि वे एक ही कॉलम में साथ-साथ समेटे हों। अपडेट करते समय असंगतियों का जोखिम भी कम होता है, क्योंकि बदलाव विशिष्ट पंक्तियों तक सीमित रहते हैं।
1NF कोई पूर्ण समाधान नहीं है। दोहराए गए कॉलम्स को अलग-अलग पंक्तियों में बदलना या मल्टी-वैल्यू सेल्स को व्यक्तिगत पंक्तियों में तोड़ना तालिका की लंबाई बढ़ा सकता है। अधिक पंक्तियों का मतलब छँटाई के लिए अधिक डेटा हो सकता है, जिससे क्वेरी प्रदर्शन पर प्रभाव पड़ सकता है।
यह ध्यान रखना महत्वपूर्ण है कि 1NF अपने आप में अंत नहीं है, क्योंकि यह सभी प्रकार के दोहराव से नहीं निपटता। आंशिक निर्भरताएँ या ट्रांज़िटिव निर्भरताएँ जैसी समस्याएँ उच्चतर नॉर्मल फॉर्म्स—जैसे सेकेंड नॉर्मल फॉर्म और थर्ड नॉर्मल फॉर्म—में संबोधित की जाती हैं। इसलिए, 1NF ठोस नींव तो है, पर यह डेटाबेस नॉर्मलाइज़ेशन का पहला कदम मात्र है और अकेले किसी डेटाबेस संरचना को पूरी तरह ऑप्टिमाइज़ नहीं करता।
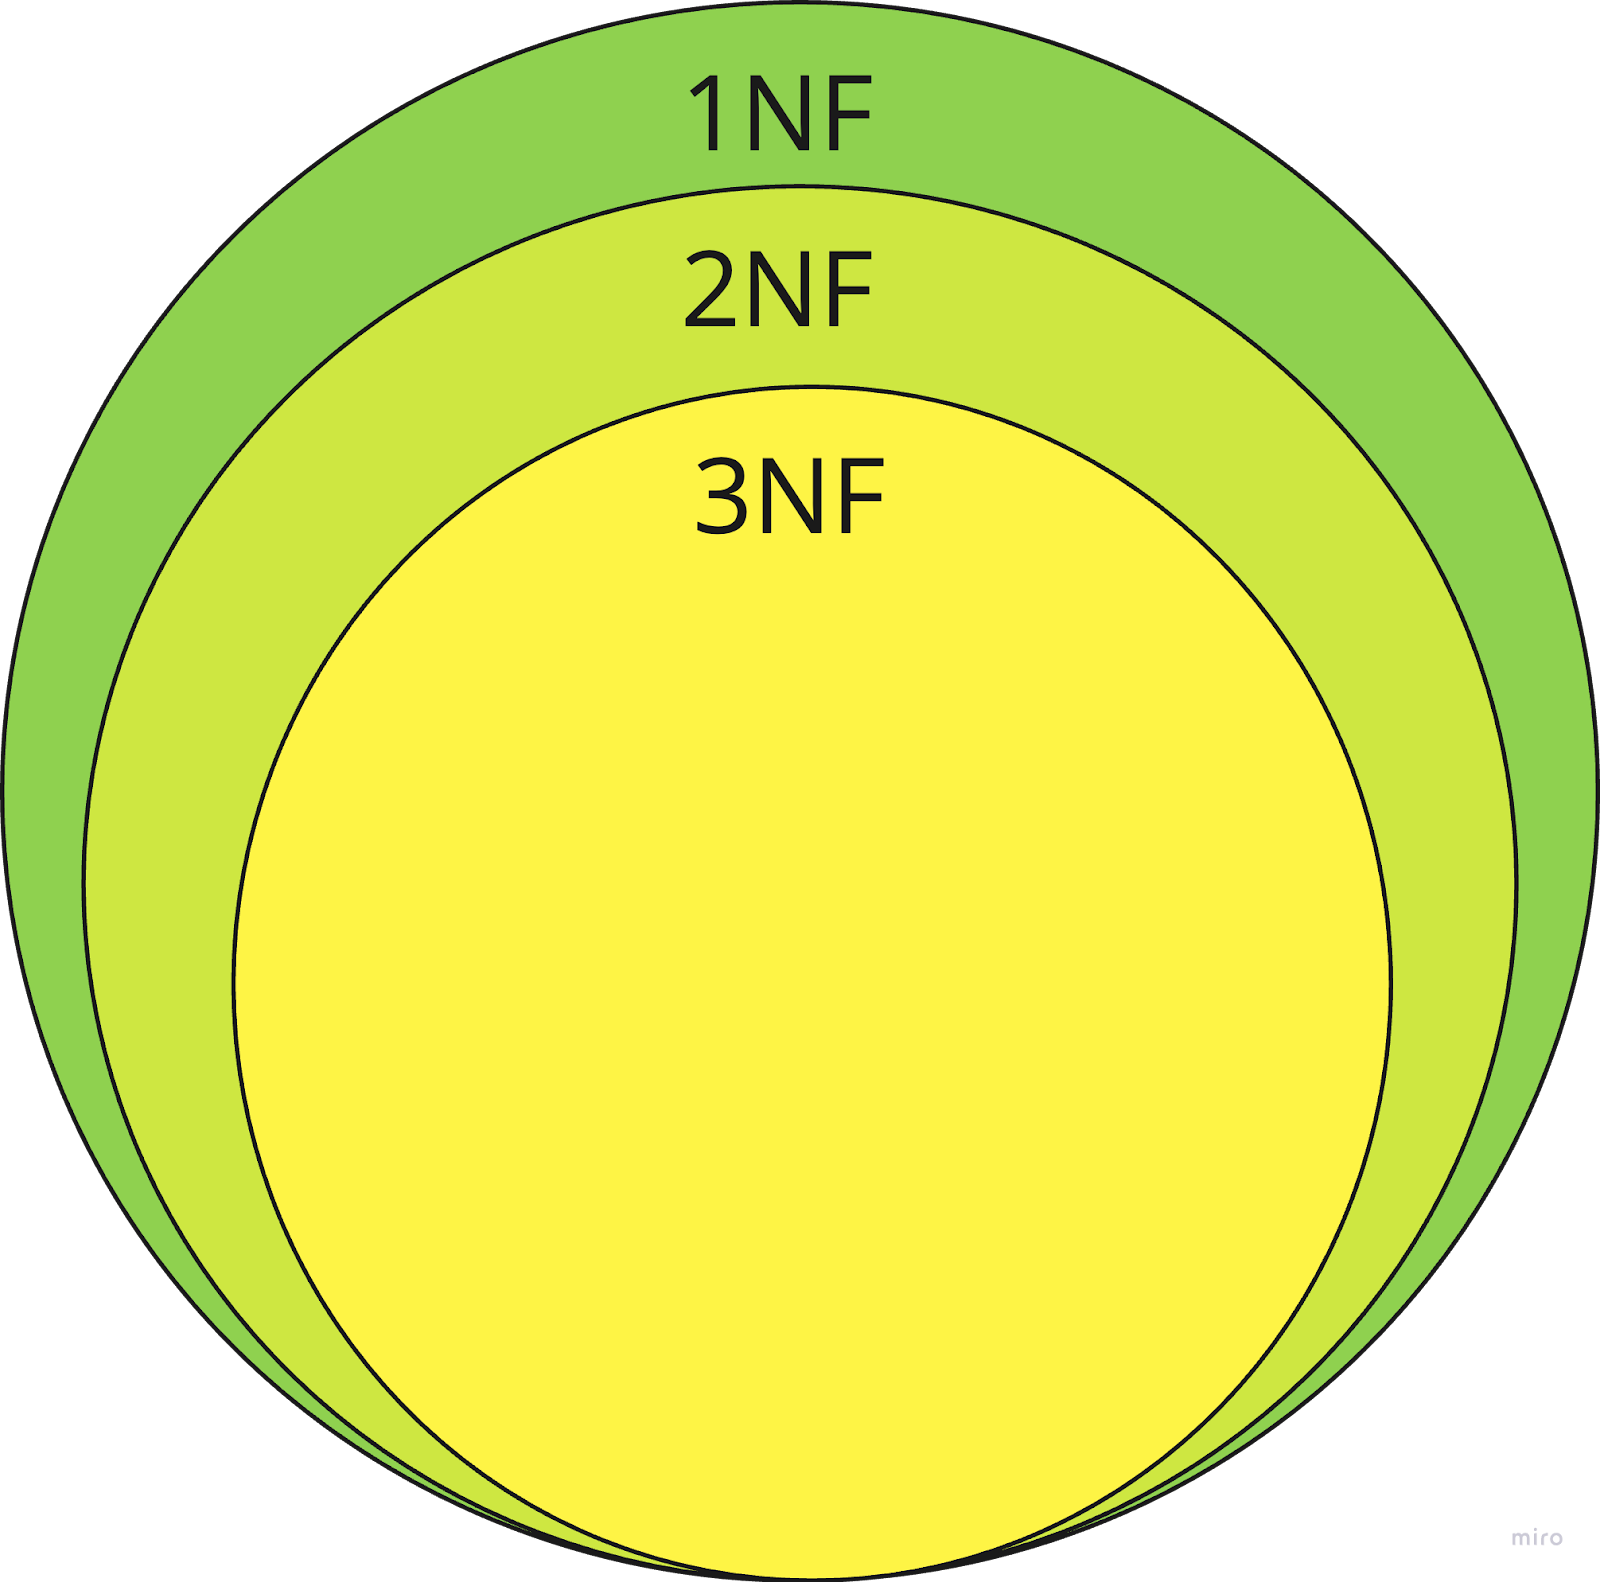
पहली डेटाबेस नॉर्मलाइज़ेशन फॉर्म्स। स्रोत: लेखक
एक बार जब आप स्थापित कर लेते हैं कि आपका डेटाबेस फर्स्ट नॉर्मल फॉर्म में है, अगला तर्कसंगत कदम सेकेंड नॉर्मल फॉर्म की ओर बढ़ना है। 2NF, 1NF द्वारा रखी नींव पर बनता है और एक मुख्य मुद्दे—आंशिक निर्भरताओं—को संबोधित करता है।
2NF में लक्ष्य आंशिक निर्भरताओं को समाप्त करना है, जो तब होती हैं जब कोई नॉन-प्राइम एट्रिब्यूट (जो प्राइमरी की का हिस्सा नहीं है) एक कंपोज़िट प्राइमरी की के केवल एक हिस्से पर निर्भर हो। यह विशेष रूप से उन तालिकाओं में महत्वपूर्ण है जिनमें कंपोज़िट की होती है—यानी कई कॉलम्स से बनी की। यह थोड़ा अमूर्त लग सकता है, लेकिन मैंने सेकेंड नॉर्मल फॉर्म पर यह गाइड लिखा है, जो अवधारणा को खोलकर समझाता है और व्यावहारिक उदाहरण दिखाता है। आप इसे जल्दी ही अच्छी तरह समझ जाएँगे!
फर्स्ट नॉर्मल फॉर्म डेटाबेस नॉर्मलाइज़ेशन का पहला कदम है, जो सुनिश्चित करता है कि प्रत्येक कॉलम में एटोमिक मान हों और दोहराए जाने वाले कॉलम समाप्त हों।
क्योंकि यह 2NF और 3NF जैसी उन्नत नॉर्मलाइज़ेशन फॉर्म्स की नींव रखता है, यदि आप ऐसे कुशल, स्केलेबल और मेंटेन करने योग्य डेटाबेस बनाना चाहते हैं जो जटिल क्वेरीज़ और बड़े डेटासेट्स को आसानी से संभाल सकें, तो आपको 1NF अपनाना ही होगा!
यदि आप अपने कौशल को और आगे ले जाने के लिए तैयार हैं, तो हमारे Database Design कोर्स को एक्सप्लोर करें ताकि नॉर्मलाइज़ेशन तकनीकों और उनके व्यावहारिक अनुप्रयोगों की समझ गहरी हो। आप हमारे SQL Associate Certification के साथ अपने SQL और डेटाबेस मैनेजमेंट कौशल को प्रमाणित कर सकते हैं और संभावित नियोक्ताओं के सामने अपनी विशेषज्ञता प्रदर्शित कर सकते हैं!
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स