
Corso
Progettazione di database
4 ore
130.6K
Se stai iniziando ora a lavorare con i database, potresti non esserti ancora imbattuto nel caos di dati disordinati e ridondanti o nella frustrazione di query lentissime. Ma credimi, dopo cinque anni passati in varie startup e con ogni tipo di struttura dati, posso dirti che questi problemi emergono più spesso di quanto vorresti.
La normalizzazione dei database è uno dei modi migliori per affrontare questi problemi, e tutto parte dalla prima forma normale (1NF). La 1NF è un concetto semplice ma potente che aiuta a creare database efficienti, affidabili e manutenibili imponendo l'atomicità nelle tabelle. È anche il passaggio fondamentale per le altre forme di normalizzazione, come 2NF e 3NF.
In questo articolo ti guiderò attraverso tutto ciò che devi sapere sulla 1NF: che cos'è, come applicarla in pratica e perché è importante. Che tu sia alle prime armi con il design dei database o voglia semplicemente fare un salto di qualità, questa guida ti aiuterà a sistemare le tue tabelle e a gettare solide basi per i passaggi successivi di normalizzazione.
Quando i database sono stati sviluppati per la prima volta, le loro strutture erano ben lontane da ciò che oggi consideriamo "normalizzato". I primi sistemi spesso si basavano su file piatti o strutture gerarchiche, che rendevano la gestione e il recupero dei dati macchinosi. Questi progetti avevano limiti significativi, tra cui ridondanza, incoerenza e rigidità. L'evoluzione della normalizzazione, a partire dalla prima forma normale, ha affrontato queste sfide e rivoluzionato il modo in cui archiviamo e gestiamo i dati.
Il concetto di prima forma normale è stato introdotto da Edgar F. Codd, ampiamente considerato il padre dei database relazionali. Negli anni '70, Codd propose il modello relazionale come alternativa ai modelli gerarchici e a rete che dominavano i primi sistemi di database. La sua motivazione era chiara: creare un approccio sistematico all'organizzazione dei dati che riducesse la ridondanza, eliminasse le anomalie e rendesse più efficiente la manipolazione dei dati.
Cuore del modello era la 1NF, che stabiliva la regola fondamentale secondo cui ogni cella di una tabella deve contenere un valore singolo e atomico, e i gruppi ripetuti devono essere eliminati. Questo principio affrontava problemi comuni dei sistemi precedenti, come aggiornamenti incoerenti e difficoltà nel fare query su dati annidati o raggruppati. Il lavoro di Codd sulla normalizzazione non solo risolse problemi immediati, ma spianò anche la strada a strutture e operazioni di database più avanzate.
L'adozione della 1NF segnò un punto di svolta nello sviluppo dei database. Formalizzò il processo di organizzazione dei dati in tabelle con relazioni chiare, ponendo le basi per i sistemi basati su SQL che oggi dominano il panorama dei database.
Prima della 1NF, sistemi come l'Information Management System (IMS) di IBM si basavano su strutture gerarchiche, che richiedevano progetti rigidamente ad albero. Questi sistemi faticavano ad adattarsi ai cambiamenti nei dati o nelle esigenze di business. Con l'introduzione della 1NF e del modello relazionale, i database sono diventati più flessibili, consentendo relazioni dinamiche tra tabelle e maggiore scalabilità.
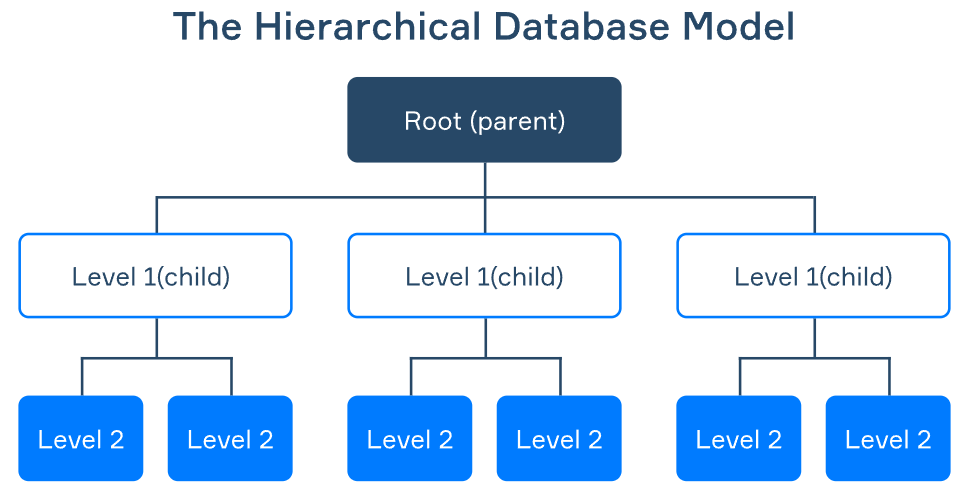
Fonte: Airbyte
I moderni sistemi di gestione di database relazionali (RDBMS) come MySQL, PostgreSQL e Microsoft SQL Server devono i loro principi di progettazione ai concetti fondanti della 1NF. Questi sistemi permettono agli sviluppatori di lavorare con dati ben strutturati, rendendo molto più semplici query, aggiornamenti e integrazioni complesse.
I benefici pratici della 1NF – e della normalizzazione in generale – si sono rapidamente diffusi nei vari settori. Nel banking, ad esempio, la 1NF ha aiutato a gestire anagrafiche clienti e storici delle transazioni garantendo che i dati fossero archiviati in un formato coerente e interrogabile. I retailer hanno usato la 1NF per tracciare inventario, vendite e ordini dei clienti. I sistemi di gestione dell'inventario sono stati un'altra area in cui la 1NF si è rivelata preziosa. Strutturando i dati in forme atomiche e non ripetute, i produttori hanno potuto mantenere registri accurati di componenti, livelli di stock e movimenti nella supply chain.
Per raggiungere la 1NF occorre soddisfare 4 condizioni chiave:
Le prime due condizioni sono generalmente imposte dal design nella maggior parte dei database moderni, quindi in questo articolo ci concentreremo sulle ultime due: atomicità e unicità delle colonne.
Ci sono semplici passaggi da seguire per scomporre una tabella che viola la 1NF.
Il primo passo è trovare le colonne che memorizzano più valori in una singola cella oppure – nel tentativo di evitare proprio questo – che sono ripetute. Queste violazioni si presentano spesso come:
Successivamente, dobbiamo ristrutturare la tabella in modo che ogni cella contenga un solo valore e che ogni colonna rappresenti un unico tipo di dato. Questo spesso comporta:
Dopo la ristrutturazione, verifica che la tua tabella soddisfi i seguenti requisiti della 1NF. Se non sei sicuro, chiediti: "Posso ordinare, filtrare o interrogare i dati facilmente senza elaborazioni aggiuntive?" "Ogni colonna rappresenta un solo tipo di attributo ed ogni riga un record univoco?" Se hai risposto sì a entrambe le domande, la tabella è in 1NF.
Ora che abbiamo capito i passaggi per trasformare una tabella e ottenere la 1NF, vediamo due esempi pratici di prima forma normale.
Immagina una tabella Customer Orders fatta così:
| CustomerID | Name | Product1 | Product2 | OrderDate |
|---|---|---|---|---|
| 1 | Alice | Mele | Banane | 2025-01-10 |
| 2 | Bob | Arance | Uva | 2025-01-11 |
Questa tabella viola la 1NF perché contiene più colonne, Product1 e Product2, che si riferiscono allo stesso tipo di dato (prodotti).
Come si risolve?Per ottenere la 1NF, separa i dati in righe distinte in modo che ogni cella contenga un solo valore:
| CustomerID | Name | Product | OrderDate |
|---|---|---|---|
| 1 | Alice | Mele | 2025-01-10 |
| 1 | Alice | Banane | 2025-01-10 |
| 2 | Bob | Arance | 2025-01-11 |
| 2 | Bob | Uva | 2025-01-11 |
In questo esempio di prima forma normale, abbiamo eliminato l'ambiguità e reso più semplice interrogare e analizzare i dati. Trovare tutti i clienti che hanno ordinato banane ora è facilissimo!
Consideriamo una tabella Student Grades fatta così:
| StudentID | Name | Grades |
|---|---|---|
| 101 | Sarah | A, B, C |
| 102 | Michael | B, A, A |
La colonna Grades viola la 1NF perché memorizza più voti in una singola cella, invece di usare valori atomici.
Come si risolve?Per rispettare la 1NF, dobbiamo creare righe separate per ciascun voto:
| StudentID | Name | Grade |
|---|---|---|
| 101 | Sarah | A |
| 101 | Sarah | B |
| 101 | Sarah | C |
| 102 | Michael | B |
| 102 | Michael | A |
| 102 | Michael | A |
Scomporre i voti in valori atomici migliora l'organizzazione dei dati e rende più semplice calcolare le medie, individuare gli studenti migliori o analizzare la distribuzione dei voti.
Se vuoi passare alla pratica e creare i tuoi database, dai un'occhiata al nostro corso su PostgresQL. Se hai già un po' di esperienza, puoi provare questa Introduzione al Data Modeling in Snowflake, che copre concetti come l'entity-relationship e il dimensional modeling.
Vediamo i pro e i contro:
Adottare la 1NF offre alcuni vantaggi chiave che rendono il lavoro con i database molto più semplice ed efficiente.
Imponendo valori atomici, elimina il rischio di dati confusi e concatenati come "Mele, Banane" in una riga e "Mele;Banane" in un'altra. Questa uniformità rende i dati più puliti e più semplici da leggere, interrogare e aggiornare.
La 1NF rende anche la manipolazione dei dati molto più lineare. Con valori atomici, puoi cercare, filtrare e aggiornare i dati con facilità, senza intoppi. Ad esempio, una query che cerca "Mele" è molto più veloce e precisa quando ogni prodotto è in una propria riga, invece che ammassato in un'unica colonna. Inoltre riduce il rischio di incoerenze durante gli aggiornamenti, poiché le modifiche sono confinate a righe specifiche.
La 1NF non è una soluzione perfetta. Convertire colonne ripetute in righe separate o suddividere celle multivalore in righe individuali può aumentare la lunghezza della tabella. Poiché più righe possono significare più dati da scorrere, ciò può avere un impatto sulle prestazioni delle query.
È importante notare che la 1NF non è un fine a sé: non affronta tutte le forme di ridondanza. Problemi come dipendenze parziali o dipendenze transitive vengono gestiti in forme normali superiori come la seconda forma normale e la terza forma normale. Quindi, pur essendo una base solida, la 1NF è solo il primo passo della normalizzazione e non ottimizza completamente da sola la struttura di un database.
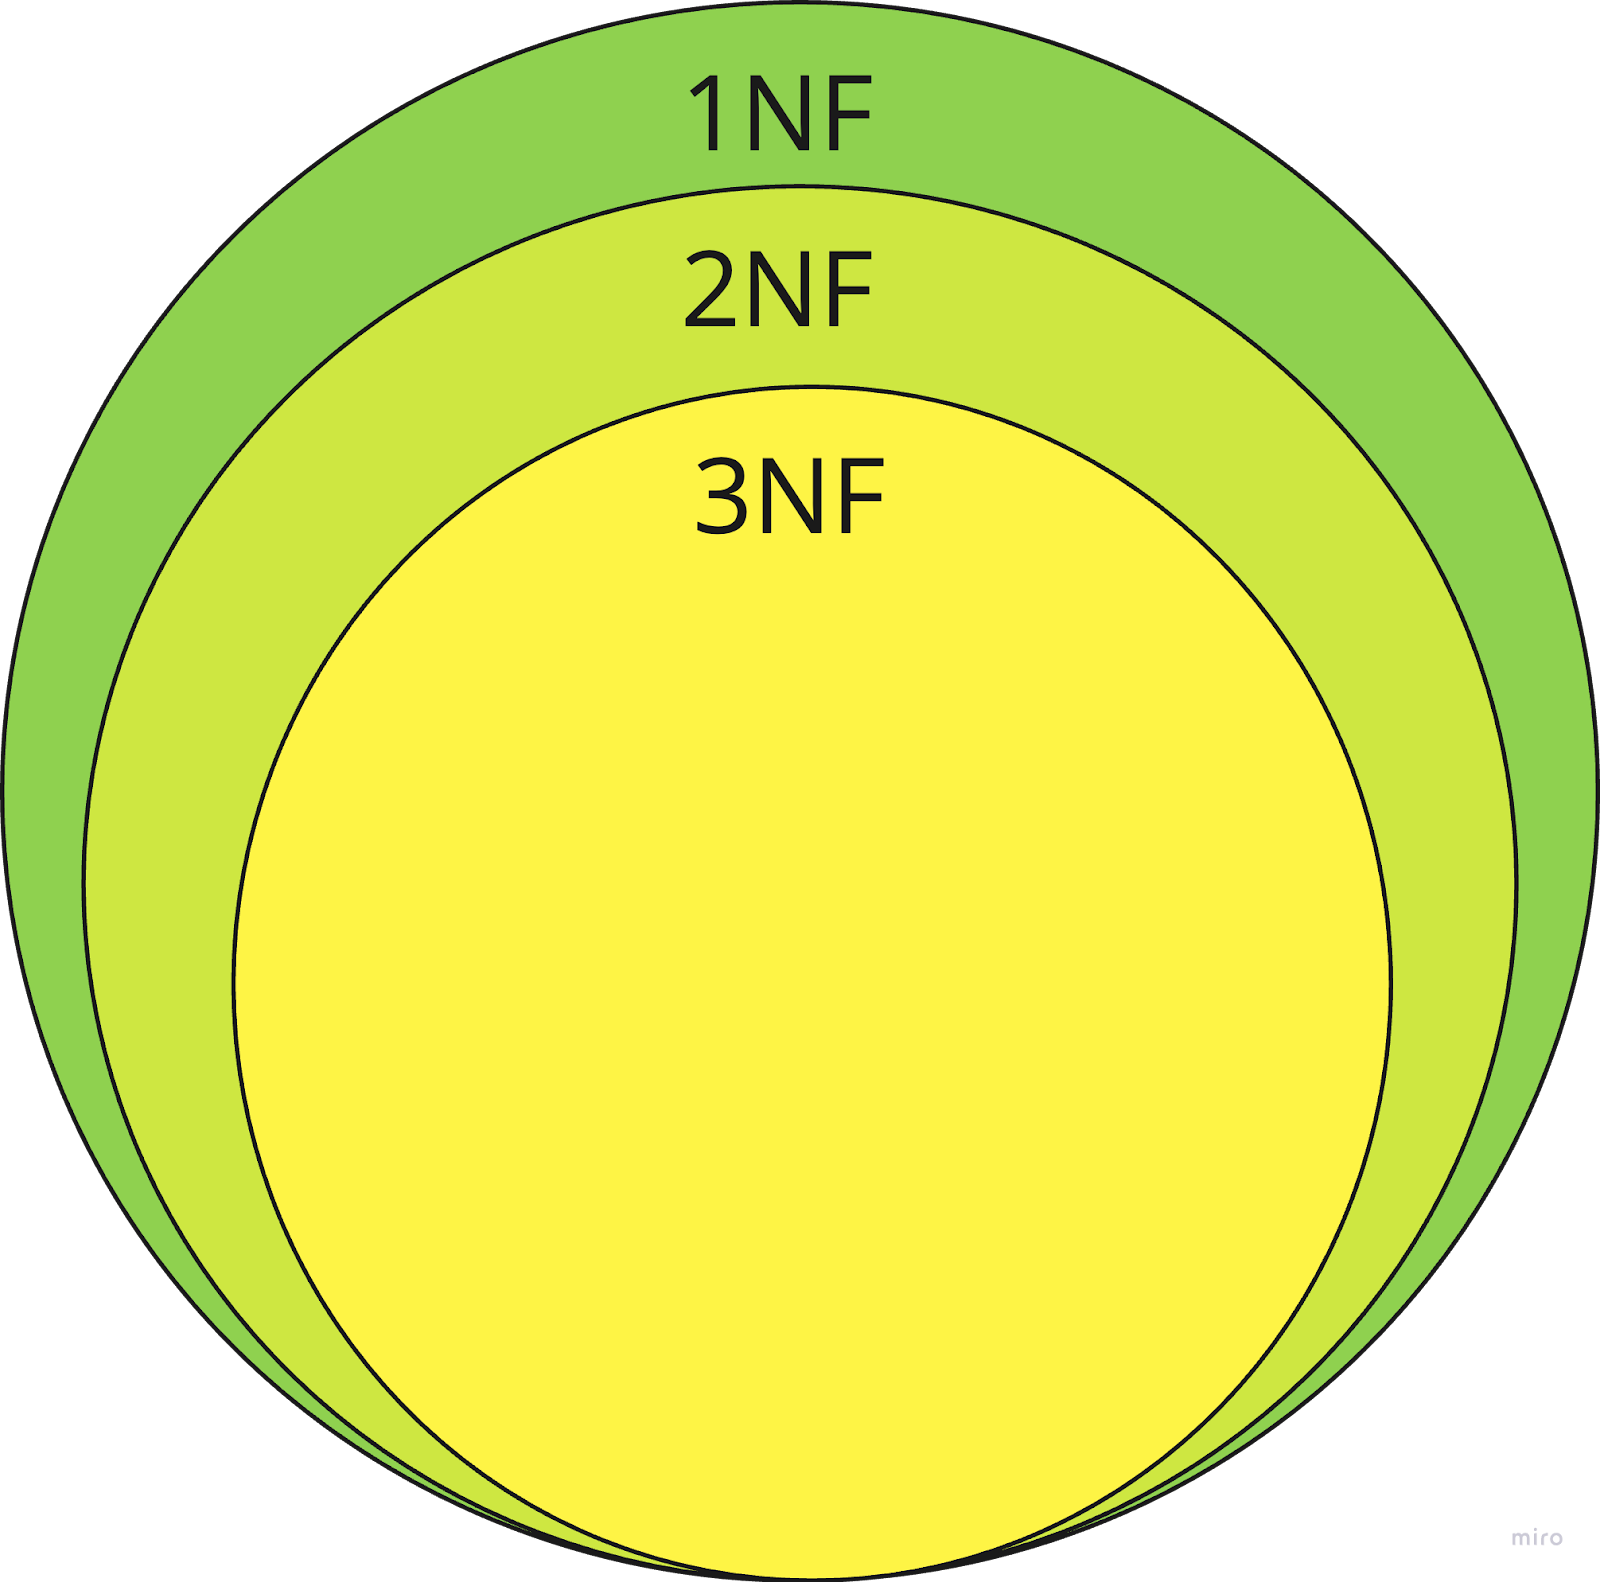
Le prime forme di normalizzazione dei database. Fonte: Autore
Una volta che hai verificato che il tuo database sia in prima forma normale, il passo logico successivo è muoversi verso la seconda forma normale. La 2NF costruisce sulle basi poste dalla 1NF affrontando un tema chiave: le dipendenze parziali.
In 2NF, l'obiettivo è eliminare le dipendenze parziali, che si verificano quando un attributo non primo (un attributo che non fa parte della chiave primaria) dipende solo da una porzione di una chiave primaria composta. Questo è particolarmente importante nelle tabelle con chiavi composte – chiavi costituite da più colonne. Può sembrare un po' astratto, ma ho scritto questa guida alla seconda forma normale, che scompone il concetto e mostra esempi pratici. La assimilerai in un attimo!
La prima forma normale è il primo passo della normalizzazione dei database, assicurando che ogni colonna contenga valori atomici ed eliminando le colonne ripetute.
Poiché prepara il terreno per forme di normalizzazione più avanzate come 2NF e 3NF, con ogni probabilità dovrai adottare la 1NF se vuoi creare database efficienti, scalabili e manutenibili, in grado di gestire con facilità query complesse e grandi volumi di dati!
Se sei pronto a fare un passo avanti, esplora il nostro corso di Database Design per approfondire le tecniche di normalizzazione e le loro applicazioni pratiche. Puoi anche convalidare le tue competenze in SQL e gestione dei database e dimostrare la tua expertise ai potenziali datori di lavoro con la nostra Certificazione SQL Associate!
Impara con DataCamp
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



