Als je net begint met databases, heb je misschien nog niet te maken gehad met de chaos van rommelige, dubbele data of de frustratie van supertrage queries. Maar geloof me, na vijf jaar werken bij verschillende startups en het omgaan met allerlei databasestructuren kan ik je vertellen dat deze problemen vaker opduiken dan je lief is.
Database-normalisatie is een van de beste manieren om deze problemen aan te pakken, en het begint allemaal met first normal form (1NF). 1NF is een eenvoudig maar krachtig concept dat helpt om efficiënte, betrouwbare en onderhoudbare databases te maken door atomaire waarden in je tabellen af te dwingen. Het is ook de basisstap voor andere normalisatievormen, zoals 2NF en 3NF.
In dit artikel neem ik je mee door alles wat je moet weten over 1NF: wat het is, hoe je het in de praktijk toepast en waarom het ertoe doet. Of je nu nieuw bent in databaseontwerp of je vaardigheden wilt aanscherpen, deze gids helpt je je tabellen op te schonen en een stevige basis te leggen voor volgende normalisatiestappen.
Historische evolutie van database-normalisatie
Toen databases voor het eerst werden ontwikkeld, waren hun structuren ver verwijderd van wat we nu als “genormaliseerd” beschouwen. Vroegere databasesystemen vertrouwden vaak op platte bestanden of hiërarchische structuren, wat het beheer en het ophalen van data omslachtig maakte. Deze ontwerpen hadden grote beperkingen, waaronder redundantie, inconsistentie en inflexibiliteit. De evolutie van database-normalisatie, beginnend met first normal form, pakte deze uitdagingen aan en veranderde de manier waarop we data opslaan en beheren.
De oorsprong van 1NF
Het concept van first normal form werd geïntroduceerd door Edgar F. Codd, algemeen gezien als de vader van relationele databases. In de jaren 70 stelde Codd het relationele model voor als alternatief voor de hiërarchische en netwerkmodellen die vroege databasesystemen domineerden. Zijn motivatie was duidelijk: een systematische manier creëren om data te organiseren die redundantie vermindert, anomalieën elimineert en datamanipulatie efficiënter maakt.
Centraal in dit model stond 1NF, dat de basisregel stelde dat elke cel in een databasetabel één enkele, atomaire waarde moet bevatten en dat herhalende groepen moeten worden geëlimineerd. Dit principe pakte veelvoorkomende problemen in eerdere systemen aan, zoals inconsistente updates en moeilijkheden bij het bevragen van geneste of gegroepeerde data. Codds werk aan normalisatie loste niet alleen directe problemen op, maar effende ook het pad voor geavanceerdere databasestructuren en -operaties.
Van vroege databases tot moderne systemen
De adoptie van 1NF markeerde een keerpunt in databaseontwikkeling. Het formaliseerde het proces van het organiseren van data in tabellen met duidelijke relaties en legde de basis voor SQL-gebaseerde systemen die vandaag de databasewereld domineren.
Voor 1NF vertrouwden systemen zoals IBM’s Information Management System (IMS) op hiërarchische structuren, die rigide boomachtige ontwerpen vereisten. Deze systemen hadden moeite zich aan te passen aan veranderingen in data of bedrijfsbehoeften. Met de introductie van 1NF en het relationele model werden databases flexibeler, met dynamische relaties tussen tabellen en meer schaalbaarheid.
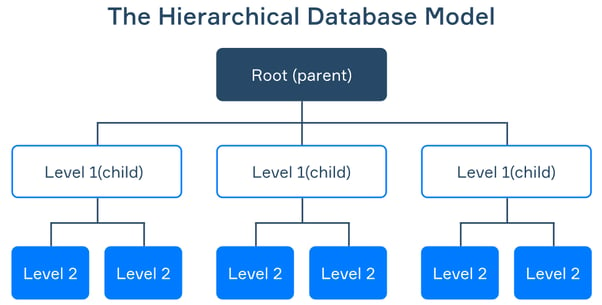
Bron: Airbyte
Moderne relationele databasebeheersystemen (RDBMS) zoals MySQL, PostgreSQL en Microsoft SQL Server danken hun ontwerpprincipes aan de basisconcepten van 1NF. Deze systemen stellen ontwikkelaars in staat om met goed gestructureerde data te werken, waardoor complexe queries, updates en integraties een stuk makkelijker worden.
Adoptie in de industrie
De praktische voordelen van 1NF – en database-normalisatie in het algemeen – vonden al snel weerklank in verschillende sectoren. In de bankwereld hielp 1NF bijvoorbeeld bij het beheren van klantgegevens en transactiehistorie door data in een consistente en bevraagbare vorm op te slaan. In de retail werd 1NF gebruikt om voorraad, verkoop en klantorders bij te houden. Voorraadbeheersystemen waren een ander gebied waar 1NF van onschatbare waarde bleek. Door data atomaire, niet-herhalende vormen te geven, konden producenten nauwkeurige registraties bijhouden van componenten, voorraadniveaus en bewegingen in de supply chain.
Om 1NF te bereiken, moet je aan vier kernvoorwaarden voldoen:
- Uniekheid van rijen: elke rij moet uniek zijn, met een eigen identificator. Dit wordt meestal bereikt met een primaire sleutel die dubbele rijen voorkomt.
- Geen aannames over volgorde: de volgorde waarin rijen worden opgeslagen of opgehaald mag niet uitmaken voor het databaseontwerp.
- Atomiciteit: elke kolom moet atomaire (ondeelbare) waarden bevatten. Er mogen dus geen sets, arrays of lijsten met waarden in één kolom staan.
- Geen gedupliceerde kolommen: er mogen geen herhaalde kolommen zijn (dus geen twee kolommen die hetzelfde type informatie opslaan).
De eerste twee voorwaarden worden in de meeste moderne databases doorgaans al door het ontwerp afgedwongen, dus in dit artikel focussen we op de laatste twee: atomiciteit en unieke kolommen.
Stappen om tabellen te ontleden om 1NF te bereiken
Er zijn eenvoudige stappen om een tabel die 1NF schendt te ontleden.
Stap 1: Niet-atomaire waarden en herhalende groepen identificeren
De eerste stap is het opsporen van kolommen die meerdere waarden in één cel opslaan, of – in een poging dat te vermijden – herhaald worden. Deze schendingen zie je vaak als:
- Lijsten of arrays (bijv. meerdere telefoonnummers in één kolom, gescheiden door een komma).
- Geneste tabellen of structuren ingebed in één cel.
- Meerdere kolommen die hetzelfde type data voorstellen (bijv. drie kolommen met de titels PhoneNumber1, PhoneNumber2, PhoneNumber3)
Stap 2: Waarden opsplitsen in nieuwe rijen
Vervolgens moeten we de tabel herstructureren zodat elke cel slechts één waarde bevat en elke kolom één type data vertegenwoordigt. Dit houdt vaak in:
- Rijen dupliceren waar nodig om te zorgen dat elke combinatie van data behouden blijft.
- Nieuwe rijen of zelfs nieuwe tabellen aanmaken om de data goed te organiseren.
Stap 3: Consistentie waarborgen
Controleer na de herstructurering of je tabel aan de volgende 1NF-eisen voldoet. Als je twijfelt, vraag jezelf dan: “Kan ik de data eenvoudig sorteren, filteren of bevragen zonder extra verwerking?” “Vertegenwoordigt elke kolom één type attribuut en elke rij één uniek record?” Als je beide vragen met ja beantwoordt, dan staat de tabel in 1NF.
Nu we de stappen kennen om een tabel te transformeren en 1NF te bereiken, kijken we naar twee praktische voorbeelden van first normal form.
Voorbeeld 1: Tabel met klantbestellingen
Stel je een tabel Customer Orders voor die er zo uitziet:
| CustomerID | Name | Product1 | Product2 | OrderDate |
|---|
| 1 | Alice | Apples | Bananas | 2025-01-10 |
| 2 | Bob | Oranges | Grapes | 2025-01-11 |
Wat is hier mis?
Deze tabel schendt 1NF omdat hij meerdere kolommen bevat, Product1 en Product2, die verwijzen naar hetzelfde type data (producten).
Hoe lossen we dit op?Om 1NF te bereiken, splits je de data op in aparte rijen zodat elke cel slechts één waarde bevat:
| CustomerID | Name | Product | OrderDate |
|---|
| 1 | Alice | Apples | 2025-01-10 |
| 1 | Alice | Bananas | 2025-01-10 |
| 2 | Bob | Oranges | 2025-01-11 |
| 2 | Bob | Grapes | 2025-01-11 |
Waarom is dit belangrijk?
In dit voorbeeld van first normal form hebben we dubbelzinnigheid weggehaald en het eenvoudiger gemaakt om de data te bevragen en te analyseren. Alle klanten vinden die bananen bestelden is nu supersimpel!
Voorbeeld 2: Tabel met cijfers van studenten
Neem een tabel Student Grades die er zo uitziet:
| StudentID | Name | Grades |
|---|
| 101 | Sarah | A, B, C |
| 102 | Michael | B, A, A |
Wat is hier mis?
De kolom Grades schendt 1NF omdat die meerdere cijfers in één cel opslaat, in plaats van atomaire waarden te gebruiken.
Hoe lossen we dit op?Om te voldoen aan 1NF moeten we aparte rijen voor elk cijfer aanmaken:
| StudentID | Name | Grade |
|---|
| 101 | Sarah | A |
| 101 | Sarah | B |
| 101 | Sarah | C |
| 102 | Michael | B |
| 102 | Michael | A |
| 102 | Michael | A |
Waarom is dit belangrijk?
Door de cijfers op te splitsen in atomaire waarden, verbeter je de data-organisatie en wordt het makkelijker om gemiddelden te berekenen, toppresteerders te identificeren of cijferverdelingen te analyseren.
Wil je zelf aan de slag en je eigen databases bouwen, bekijk dan onze PostgresQL-cursus. Ben je al iets verder, probeer dan deze Introduction to Data Modeling in Snowflake, met onderwerpen als entiteit-relatiemodellering en dimensionaal modelleren.
Laten we de plus- en minpunten bekijken:
Voordelen van 1NF
Het toepassen van 1NF biedt enkele belangrijke voordelen die werken met databases veel makkelijker en efficiënter maken.
Door atomaire waarden af te dwingen, voorkom je rommelige, samengevoegde data zoals "Apples, Bananas" in de ene rij en "Apples;Bananas" in de andere. Deze uniformiteit maakt de data schoner en eenvoudiger te lezen, bevragen en bijwerken.
1NF maakt datamanipulatie ook een stuk eenvoudiger. Met atomaire waarden kun je de data gemakkelijk zoeken, filteren en bijwerken zonder problemen. Een query die zoekt naar "Apples" is bijvoorbeeld veel sneller en preciezer wanneer elk product in zijn eigen rij staat, in plaats van samengevoegd in één kolom. Het verkleint ook het risico op inconsistenties bij updates, omdat wijzigingen zich in specifieke rijen bevinden.
Beperkingen van 1NF
1NF is geen perfecte oplossing. Het omzetten van herhalende kolommen naar aparte rijen of het opsplitsen van cellen met meerdere waarden in individuele rijen kan leiden tot een toename van de lengte van de tabel. Meer rijen betekent mogelijk meer data om door te zoeken, wat impact kan hebben op de queryprestaties.
Belangrijk om te onthouden: 1NF is geen doel op zich, omdat het niet alle vormen van redundantie aanpakt. Problemen zoals partiële afhankelijkheden of transitieve afhankelijkheden worden behandeld in hogere normaalvormen zoals second normal form en de third normal form. 1NF is dus een solide basis, maar slechts de eerste stap in database-normalisatie en optimaliseert een databasestructuur niet volledig op zichzelf.
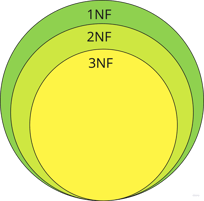
De eerste normalisatievormen van databases. Bron: auteur
Zodra je hebt vastgesteld dat je database in first normal form staat, is de volgende logische stap richting second normal form. 2NF bouwt voort op de basis van 1NF door een belangrijk issue aan te pakken: partiële afhankelijkheden.
In 2NF is het doel om partiële afhankelijkheden te elimineren. Die treden op wanneer een niet-prima attribuut (een attribuut dat geen onderdeel is van de primaire sleutel) slechts afhankelijk is van een deel van een samengestelde primaire sleutel. Dit is vooral relevant in tabellen met samengestelde sleutels – sleutels die uit meerdere kolommen bestaan. Klinkt dat wat abstract? Ik schreef deze gids voor second normal form, die het concept uiteenrafelt en praktische voorbeelden laat zien. Je hebt het zo onder de knie!
Conclusie
First normal form is de eerste stap in database-normalisatie en zorgt ervoor dat elke kolom atomaire waarden bevat en herhalende kolommen worden geëlimineerd.
Omdat het de basis legt voor geavanceerdere normaalvormen zoals 2NF en 3NF, zul je 1NF waarschijnlijk moeten toepassen als je efficiënte, schaalbare en onderhoudbare databases wilt bouwen die moeiteloos complexe queries en grote datasets aankunnen!
Klaar om je skills verder te brengen? Verdiep je dan in onze cursus Database Design om je begrip van normalisatietechnieken en hun praktische toepassingen te vergroten. Je kunt je SQL- en databasebeheervaardigheden ook valideren en je expertise tonen aan potentiële werkgevers met onze SQL Associate Certification!




Als je net begint met databases, heb je misschien nog niet te maken gehad met de chaos van rommelige, dubbele data of de frustratie van supertrage queries. Maar geloof me, na vijf jaar werken bij verschillende startups en het omgaan met allerlei databasestructuren kan ik je vertellen dat deze problemen vaker opduiken dan je lief is.
Database-normalisatie is een van de beste manieren om deze problemen aan te pakken, en het begint allemaal met first normal form (1NF). 1NF is een eenvoudig maar krachtig concept dat helpt om efficiënte, betrouwbare en onderhoudbare databases te maken door atomaire waarden in je tabellen af te dwingen. Het is ook de basisstap voor andere normalisatievormen, zoals 2NF en 3NF.
In dit artikel neem ik je mee door alles wat je moet weten over 1NF: wat het is, hoe je het in de praktijk toepast en waarom het ertoe doet. Of je nu nieuw bent in databaseontwerp of je vaardigheden wilt aanscherpen, deze gids helpt je je tabellen op te schonen en een stevige basis te leggen voor volgende normalisatiestappen.
Historische evolutie van database-normalisatie
Toen databases voor het eerst werden ontwikkeld, waren hun structuren ver verwijderd van wat we nu als “genormaliseerd” beschouwen. Vroegere databasesystemen vertrouwden vaak op platte bestanden of hiërarchische structuren, wat het beheer en het ophalen van data omslachtig maakte. Deze ontwerpen hadden grote beperkingen, waaronder redundantie, inconsistentie en inflexibiliteit. De evolutie van database-normalisatie, beginnend met first normal form, pakte deze uitdagingen aan en veranderde de manier waarop we data opslaan en beheren.
De oorsprong van 1NF
Het concept van first normal form werd geïntroduceerd door Edgar F. Codd, algemeen gezien als de vader van relationele databases. In de jaren 70 stelde Codd het relationele model voor als alternatief voor de hiërarchische en netwerkmodellen die vroege databasesystemen domineerden. Zijn motivatie was duidelijk: een systematische manier creëren om data te organiseren die redundantie vermindert, anomalieën elimineert en datamanipulatie efficiënter maakt.
Centraal in dit model stond 1NF, dat de basisregel stelde dat elke cel in een databasetabel één enkele, atomaire waarde moet bevatten en dat herhalende groepen moeten worden geëlimineerd. Dit principe pakte veelvoorkomende problemen in eerdere systemen aan, zoals inconsistente updates en moeilijkheden bij het bevragen van geneste of gegroepeerde data. Codds werk aan normalisatie loste niet alleen directe problemen op, maar effende ook het pad voor geavanceerdere databasestructuren en -operaties.
Van vroege databases tot moderne systemen
De adoptie van 1NF markeerde een keerpunt in databaseontwikkeling. Het formaliseerde het proces van het organiseren van data in tabellen met duidelijke relaties en legde de basis voor SQL-gebaseerde systemen die vandaag de databasewereld domineren.
Voor 1NF vertrouwden systemen zoals IBM’s Information Management System (IMS) op hiërarchische structuren, die rigide boomachtige ontwerpen vereisten. Deze systemen hadden moeite zich aan te passen aan veranderingen in data of bedrijfsbehoeften. Met de introductie van 1NF en het relationele model werden databases flexibeler, met dynamische relaties tussen tabellen en meer schaalbaarheid.
Bron: Airbyte
Moderne relationele databasebeheersystemen (RDBMS) zoals MySQL, PostgreSQL en Microsoft SQL Server danken hun ontwerpprincipes aan de basisconcepten van 1NF. Deze systemen stellen ontwikkelaars in staat om met goed gestructureerde data te werken, waardoor complexe queries, updates en integraties een stuk makkelijker worden.
Adoptie in de industrie
De praktische voordelen van 1NF – en database-normalisatie in het algemeen – vonden al snel weerklank in verschillende sectoren. In de bankwereld hielp 1NF bijvoorbeeld bij het beheren van klantgegevens en transactiehistorie door data in een consistente en bevraagbare vorm op te slaan. In de retail werd 1NF gebruikt om voorraad, verkoop en klantorders bij te houden. Voorraadbeheersystemen waren een ander gebied waar 1NF van onschatbare waarde bleek. Door data atomaire, niet-herhalende vormen te geven, konden producenten nauwkeurige registraties bijhouden van componenten, voorraadniveaus en bewegingen in de supply chain.
Voorwaarden om First Normal Form te bereiken
Om 1NF te bereiken, moet je aan vier kernvoorwaarden voldoen:
De eerste twee voorwaarden worden in de meeste moderne databases doorgaans al door het ontwerp afgedwongen, dus in dit artikel focussen we op de laatste twee: atomiciteit en unieke kolommen.
Stappen om tabellen te ontleden om 1NF te bereiken
Er zijn eenvoudige stappen om een tabel die 1NF schendt te ontleden.
Stap 1: Niet-atomaire waarden en herhalende groepen identificeren
De eerste stap is het opsporen van kolommen die meerdere waarden in één cel opslaan, of – in een poging dat te vermijden – herhaald worden. Deze schendingen zie je vaak als:
Stap 2: Waarden opsplitsen in nieuwe rijen
Vervolgens moeten we de tabel herstructureren zodat elke cel slechts één waarde bevat en elke kolom één type data vertegenwoordigt. Dit houdt vaak in:
Stap 3: Consistentie waarborgen
Controleer na de herstructurering of je tabel aan de volgende 1NF-eisen voldoet. Als je twijfelt, vraag jezelf dan: “Kan ik de data eenvoudig sorteren, filteren of bevragen zonder extra verwerking?” “Vertegenwoordigt elke kolom één type attribuut en elke rij één uniek record?” Als je beide vragen met ja beantwoordt, dan staat de tabel in 1NF.
Voorbeelden van First Normal Form in de praktijk
Nu we de stappen kennen om een tabel te transformeren en 1NF te bereiken, kijken we naar twee praktische voorbeelden van first normal form.
Voorbeeld 1: Tabel met klantbestellingen
Stel je een tabel Customer Orders voor die er zo uitziet:
Wat is hier mis?
Deze tabel schendt 1NF omdat hij meerdere kolommen bevat, Product1 en Product2, die verwijzen naar hetzelfde type data (producten).
Hoe lossen we dit op?Om 1NF te bereiken, splits je de data op in aparte rijen zodat elke cel slechts één waarde bevat:
Waarom is dit belangrijk?
In dit voorbeeld van first normal form hebben we dubbelzinnigheid weggehaald en het eenvoudiger gemaakt om de data te bevragen en te analyseren. Alle klanten vinden die bananen bestelden is nu supersimpel!
Voorbeeld 2: Tabel met cijfers van studenten
Neem een tabel Student Grades die er zo uitziet:
Wat is hier mis?
De kolom Grades schendt 1NF omdat die meerdere cijfers in één cel opslaat, in plaats van atomaire waarden te gebruiken.
Hoe lossen we dit op?Om te voldoen aan 1NF moeten we aparte rijen voor elk cijfer aanmaken:
Waarom is dit belangrijk?
Door de cijfers op te splitsen in atomaire waarden, verbeter je de data-organisatie en wordt het makkelijker om gemiddelden te berekenen, toppresteerders te identificeren of cijferverdelingen te analyseren.
Wil je zelf aan de slag en je eigen databases bouwen, bekijk dan onze PostgresQL-cursus. Ben je al iets verder, probeer dan deze Introduction to Data Modeling in Snowflake, met onderwerpen als entiteit-relatiemodellering en dimensionaal modelleren.
Voor- en nadelen van First Normal Form
Laten we de plus- en minpunten bekijken:
Voordelen van 1NF
Het toepassen van 1NF biedt enkele belangrijke voordelen die werken met databases veel makkelijker en efficiënter maken.
Door atomaire waarden af te dwingen, voorkom je rommelige, samengevoegde data zoals "Apples, Bananas" in de ene rij en "Apples;Bananas" in de andere. Deze uniformiteit maakt de data schoner en eenvoudiger te lezen, bevragen en bijwerken.
1NF maakt datamanipulatie ook een stuk eenvoudiger. Met atomaire waarden kun je de data gemakkelijk zoeken, filteren en bijwerken zonder problemen. Een query die zoekt naar "Apples" is bijvoorbeeld veel sneller en preciezer wanneer elk product in zijn eigen rij staat, in plaats van samengevoegd in één kolom. Het verkleint ook het risico op inconsistenties bij updates, omdat wijzigingen zich in specifieke rijen bevinden.
Beperkingen van 1NF
1NF is geen perfecte oplossing. Het omzetten van herhalende kolommen naar aparte rijen of het opsplitsen van cellen met meerdere waarden in individuele rijen kan leiden tot een toename van de lengte van de tabel. Meer rijen betekent mogelijk meer data om door te zoeken, wat impact kan hebben op de queryprestaties.
Belangrijk om te onthouden: 1NF is geen doel op zich, omdat het niet alle vormen van redundantie aanpakt. Problemen zoals partiële afhankelijkheden of transitieve afhankelijkheden worden behandeld in hogere normaalvormen zoals second normal form en de third normal form. 1NF is dus een solide basis, maar slechts de eerste stap in database-normalisatie en optimaliseert een databasestructuur niet volledig op zichzelf.
Verder dan First Normal Form: richting Second Normal Form (2NF)
De eerste normalisatievormen van databases. Bron: auteur
Zodra je hebt vastgesteld dat je database in first normal form staat, is de volgende logische stap richting second normal form. 2NF bouwt voort op de basis van 1NF door een belangrijk issue aan te pakken: partiële afhankelijkheden.
In 2NF is het doel om partiële afhankelijkheden te elimineren. Die treden op wanneer een niet-prima attribuut (een attribuut dat geen onderdeel is van de primaire sleutel) slechts afhankelijk is van een deel van een samengestelde primaire sleutel. Dit is vooral relevant in tabellen met samengestelde sleutels – sleutels die uit meerdere kolommen bestaan. Klinkt dat wat abstract? Ik schreef deze gids voor second normal form, die het concept uiteenrafelt en praktische voorbeelden laat zien. Je hebt het zo onder de knie!
Conclusie
First normal form is de eerste stap in database-normalisatie en zorgt ervoor dat elke kolom atomaire waarden bevat en herhalende kolommen worden geëlimineerd.
Omdat het de basis legt voor geavanceerdere normaalvormen zoals 2NF en 3NF, zul je 1NF waarschijnlijk moeten toepassen als je efficiënte, schaalbare en onderhoudbare databases wilt bouwen die moeiteloos complexe queries en grote datasets aankunnen!
Klaar om je skills verder te brengen? Verdiep je dan in onze cursus Database Design om je begrip van normalisatietechnieken en hun praktische toepassingen te vergroten. Je kunt je SQL- en databasebeheervaardigheden ook valideren en je expertise tonen aan potentiële werkgevers met onze SQL Associate Certification!