

编辑与编辑距离
模糊字符串匹配算法旨在确定两个不同字符串之间的接近程度。这通过一种称为“编辑距离”的度量来实现。编辑距离通过找到将一个字符串转换为另一个字符串所需的最少“编辑”次数来衡量两个字符串有多接近。
如果编辑距离用编辑操作的次数来表示一个字符串距离另一个字符串有多少步,那么“编辑”就是对字符串执行的、将其变为另一个字符串的操作。
主要有四种编辑类型:
| 编辑操作 | 描述 | 示例 |
|---|---|---|
| 插入 | 添加一个字母 | "Londn" -> "London" |
| 删除 | 移除一个字母 | "Londoon" -> "London" |
| 交换 | 交换相邻的两个字母 | "Lnodon" -> "London" |
| 替换 | 将一个字母换成另一个 | "Londin" -> "London" |
这四种编辑操作使我们可以修改任意字符串。
将这些编辑操作组合起来,您可以找出与原字符串相距 N 次编辑(N 为编辑操作次数)的所有可能字符串。例如,“London”和“Londin”之间的编辑距离为 1,因为把“i”替换为“o”即可完全匹配。
那么具体如何计算编辑距离呢?
计算编辑距离有不同的变体。例如,有 Levenshtein 距离、Hamming 距离、Jaro 距离等。
Levenshtein 距离如何计算?
本教程只关注 Levenshtein 距离。
该度量以 Vladimir Levenshtein 的名字命名,他在 1965 年最初提出用于衡量两个序列之间的差异。我们可以用它来找出将一个单词序列变成另一个所需的最少编辑次数。
其形式化计算如下:
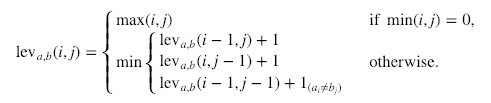
其中,当a=b时, 取 0,否则取 1。
需要注意,上式中取最小值的三项依次对应删除、插入和替换。
还可以基于 Levenshtein 距离计算 Levenshtein 相似度比。这可以通过以下公式完成:
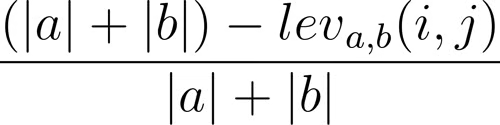
其中 |a| 和 |b| 分别是序列 a 与序列 b 的长度。
简单的模糊字符串匹配
历史上,Python 中最受欢迎的模糊字符串匹配包之一是FuzzyWuzzy。不过,为了解决许可问题并更新代码库,该项目在 2021 年更名为 TheFuzz。由于其简单易用,它仍然是初学者的首选库,也是我们在本教程中使用的库。
它最初由SeatGeek 开发,用于区分名称相似的两张门票是否对应同一场活动。与前身一样,TheFuzz 使用Levenshtein 编辑距离来计算两个字符串的接近程度。
专业提示:生产环境建议使用 RapidFuzz。尽管TheFuzz非常适合学习和小型数据集,但在大规模数据处理中可能较慢。业内已广泛转向一个更新的库——RapidFuzz。
- 速度:RapidFuzz 由 C++ 编写,速度显著更快。
- 许可:采用 MIT 许可,相比 TheFuzz 的 GPL 许可对企业使用更为宽松。
- 兼容性:其语法几乎完全相同(例如
fuzz.ratio),因此日后可轻松切换。
在本指南中,我们将继续使用TheFuzz,因为它在许多环境中已预装,并且非常适合理解核心概念。
首先,我们需要安装TheFuzz包。您可以使用 pip 运行以下命令:
!pip install thefuzz注意:此库在DataLab 工作簿中已预装。
现在,让我们看看 thefuzz 能做什么。
请在此DataLab 工作簿中跟进代码。
简单比率
我们可以使用 fuzz 对象上的 ratio() 方法来计算两个字符串之间的简单比率。它基于两个输入字符串的顺序计算编辑距离,difflib.ratio()——参见difflib 文档了解更多。
# Check the similarity score
name = "Kurtis Pykes"
full_name = "Kurtis K D Pykes"
print(f"Similarity score: {fuzz.ratio(name, full_name)}")
"""
Similarity Score: 86
"""在代码中,我们用了我名字的两种写法来比较相似度,结果为 86。
让我们对比一下部分比率。
部分比率
要检查部分比率,我们只需将上面代码中的 ratio() 改为对 fuzz 对象调用partial_ratio()即可。
# Check the similarity score
name = "Kurtis Pykes"
full_name = "Kurtis K D Pykes"
print(f"Similarity score: {fuzz.partial_ratio(name, full_name)}")
"""
Similarity Score: 67
"""我们看到分数下降了。这是怎么回事?
partial_ratio()旨在衡量两个字符串的部分相似性。如果两个字符串中有一部分词以相同顺序出现,则它们部分相似。
partial_ratio()的计算方式是取较短的字符串(本例中为变量 name),然后与较长字符串(full_name)中长度相同的各个子串进行比较。
由于在部分比率中顺序很重要,因此此处分数下降。因此,要获得 100% 的相似度,您需要将“K D”(表示我的中间名)移动到字符串末尾。例如:
# Order matters with partial ratio
# Check the similarity score
name = "Kurtis Pykes"
full_name = "Kurtis Pykes K D"
print(f"Partial ratio similarity score: {fuzz.partial_ratio(name, full_name)}")
# But order will not effect simple ratio if strings do not match
print(f"Simple ratio similarity score: {fuzz.ratio(name, full_name)}")
"""
Partial ratio similarity score: 100
Simple ratio similarity score: 86
"""那么如果我们希望模糊匹配忽略顺序呢?
您也许会用到“token sort ratio”。
Token sort ratio
好的,我们想忽略字符串中词语的顺序,但仍要衡量它们的相似度——token sort 正是为此而生。Token sort 不关心词语出现的顺序。它能处理像上面那样顺序不同但文本相似的情况。
因此,在最近的示例中,使用 token sort ratio 应该会得到 100% 的分数:
# Check the similarity score
full_name = "Kurtis K D Pykes"
full_name_reordered = "Kurtis Pykes K D"
# Order does not matter for token sort ratio
print(f"Token sort ratio similarity score: {fuzz.token_sort_ratio(full_name_reordered, full_name)}")
# Order matters for partial ratio
print(f"Partial ratio similarity score: {fuzz.partial_ratio(full_name, full_name_reordered)}")
# Order will not effect simple ratio if strings do not match
print(f"Simple ratio similarity score: {fuzz.ratio(name, full_name)}")
"""
Token sort ratio similarity score: 100
Partial ratio similarity score: 75
Simple ratio similarity score: 86
"""……正如预期,我们确实得到了。
让我们回到最初的 name 和 full_name 变量。现在使用 token sort 会发生什么?
# Check the similarity score
name = "Kurtis Pykes"
full_name = "Kurtis K D Pykes"
print(f"Token sort ratio similarity score: {fuzz.token_sort_ratio(name, full_name)}")
"""
Token sort ratio similarity score: 86
"""分数下降了。
这是因为 token sort 只忽略顺序。如果字符串中存在不相同的词,会对相似度产生负面影响,如上所示。
不过有一种变通方法。
Token set ratio
token_set_ratio()方法与token_sort_ratio()很相似,不同之处在于它会在计算相似度之前先去除公共的 token:当两个字符串长度差异较大时,这非常有用。
由于 name 和 full_name 变量都包含“Kurtis Pykes”,我们可以预期 token set ratio 的相似度为 100%。
# Check the similarity score
name = "Kurtis Pykes"
full_name = "Kurtis K D Pykes"
print(f"Token sort ratio similarity score: {fuzz.token_set_ratio(name, full_name)}")
"""
Token sort ratio similarity score: 100
"""Process
process 模块可以借助模糊字符串匹配从一个集合中抽取文本。对 process 模块调用extract()方法会返回带有相似度得分的字符串向量。例如:
from thefuzz import process
collection = ["AFC Barcelona", "Barcelona AFC", "barcelona fc", "afc barcalona"]
print(process.extract("barcelona", collection, scorer=fuzz.ratio))
"""
[('barcelona fc', 86), ('AFC Barcelona', 82), ('Barcelona AFC', 82), ('afc barcalona', 73)]
"""我们可以通过设置 limit 参数来控制 extract() 方法返回向量的长度。
print(process.extract("barcelona", collection, scorer=fuzz.ratio))
"""
[('barcelona fc', 86), ('AFC Barcelona', 82), ('Barcelona AFC', 82)]
"""在此示例中,extract() 会基于我们指定的 scorer 返回三个最接近的匹配字符串。
使用 TheFuzz 的模糊匹配技术对比
在下表中,您可以快速对比 TheFuzz 中可用的不同技术类型:
| 技术 | 描述 | 代码示例 |
|---|---|---|
| 简单比率 | 在考虑输入字符串顺序的情况下计算相似度。 | fuzz.ratio(name, full_name) |
| 部分比率 | 通过比较较短字符串与子串来发现部分相似。 | fuzz.partial_ratio(name, full_name) |
| Token Sort Ratio | 忽略字符串中词语的顺序。 | fuzz.token_sort_ratio(full_name_reordered, full_name) |
| Token Set Ratio | 在计算相似度前去除公共 token。 | fuzz.token_set_ratio(name, full_name) |
结合 pandas 进行模糊字符串匹配
本节我们将看看如何在 pandas 数据框上进行模糊字符串匹配。
假设您将一些数据导出到 pandas 数据框中,并希望将其与现有数据进行合并。
import pandas as pd
# Creating a dataframe
dict_one = {
"country": ["England", "Scotland", "Wales", "United Kingdom", "Northern Ireland"],
"population_in_millions": [55.98, 5.45, 3.14, 67.33, 1.89]
}
dict_two = {
"country": ["Northern Iland", "Wles", "Scotlnd", "Englnd", "United K."],
"GDP_per_capita": [24900, 23882, 37460, 45101, 46510.28]
}
existing_data = pd.DataFrame(dict_one)
exported_data = pd.DataFrame(dict_two)
print(existing_data, exported_data, sep="\n\n")
"""
country population_in_millions
0 England 55.98
1 Scotland 5.45
2 Wales 3.14
3 United Kingdom 67.33
4 Northern Ireland 1.89
country GDP_per_capita
0 Northern Iland 24900.00
1 Wles 23882.00
2 Scotlnd 37460.00
3 Englnd 45101.00
4 United K. 46510.28
"""这里有个大问题。
现有数据中的国家拼写正确,但导出数据并非如此。如果我们尝试在 country 列上连接两个数据框,pandas 不会将拼写错误的词识别为与正确拼写相同。因此,merge 函数返回的结果不会符合预期。
如果我们尝试这样做,会发生什么:
# Attempt to join the two dataframe
data = pd.merge(existing_data, exported_data, on="country", how="left")
print(data.head())
"""
country population_in_millions GDP_per_capita
0 England 55.98 NaN
1 Scotland 5.45 NaN
2 Wales 3.14 NaN
3 United Kingdom 67.33 NaN
4 Northern Ireland 1.89 NaN
"""这就违背了我们想要合并这些数据框的初衷。
不过,我们可以通过模糊字符串匹配来解决这个问题。
看看代码如何实现:
# Rename the misspelled columns
exported_data["country"] = exported_data["country"].apply(
lambda x: process.extractOne(x, existing_data["country"], scorer=fuzz.partial_ratio)[0]
)
# Attempt to join the two dataframe
data = pd.merge(existing_data, exported_data, on="country", how="left")
print(data.head())
"""
country population_in_millions GDP_per_capita
0 England 55.98 45101.00
1 Scotland 5.45 37460.00
2 Wales 3.14 23882.00
3 United Kingdom 67.33 46510.28
4 Northern Ireland 1.89 24900.00
"""在这段代码中,我们使用了一个简洁的 lambda 函数配合process.extractOne()方法,来重命名导出数据中 country 列的拼写错误值。注意,我们对extractOne()的结果使用了索引 0,只返回相似的字符串本身,而不是包含字符串及相似度值的列表。
随后,我们在 country 列上使用左连接合并数据框。结果是一个包含正确国家名称(包括联合政治体“联合王国”)的单一数据框。
虽然上述方案非常适合本教程和小型数据集,但在应用到“大数据”时要谨慎。
当您将.apply()与模糊匹配一起使用时,计算机会将数据框 A 的每一行与数据框 B 的每一行进行比较(笛卡尔积)。
- 小数据:100 行 x 100 行 = 1 万次比较(瞬间完成)。
- 大数据:50,000 行 x 50,000 行 = 25 亿次比较(这会导致脚本崩溃)。
对于超过数千行的数据集,考虑使用RapidFuzz(使用 C++ 加速)或Splink(通过“阻塞”减少比较次数)。
在 pandas DataFrame 中进行模糊字符串匹配
如果您需要快速回顾上述技术,可参见下表:
| 步骤 | 描述 | 代码片段 |
|---|---|---|
| 创建 DataFrame | 定义包含可能拼写错误的数据。 | existing_data = pd.DataFrame(dict_one), exported_data = pd.DataFrame(dict_two) |
| 尝试有误的合并 | 由于字符串不匹配,初次合并失败。 | data = pd.merge(existing_data, exported_data, on="country", how="left") |
| 纠正拼写错误 | 使用模糊匹配纠正国家名称的拼写。 | exported_data["country"] = exported_data["country"].apply(lambda x: process.extractOne(x, existing_data["country"], scorer=fuzz.partial_ratio)[0]) |
| 成功合并 | 在纠正拼写后使用模糊匹配合并数据框。 | data = pd.merge(existing_data, exported_data, on="country", how="left") |
结语
在本教程中,您已学习:
- 编辑及编辑距离
- Levenshtein 编辑距离及其原理
- 如何在 Python 中使用 thefuzz 库进行模糊字符串匹配
- 如何在 Pandas 数据框中进行模糊字符串匹配
这里的示例也许简单,但足以说明如何处理计算机判定为不匹配的各种字符串情况。模糊匹配在拼写检查、生物信息学(例如使用模糊逻辑匹配 DNA 序列)等领域有多种应用。
更多资源
Python 模糊字符串匹配常见问题
模糊字符串匹配如何处理大小写敏感性?
除非另行指定,否则模糊字符串匹配通常区分大小写。您可以在匹配前将字符串转换为小写以实现不区分大小写。
TheFuzz 库能与字符串以外的数据结构一起使用吗?
TheFuzz 主要用于字符串比较。不过,您可以在应用模糊匹配技术之前,将其他数据类型转换为字符串。
如何在大型数据集上进行性能优化的模糊匹配?
对于大型数据集,考虑使用索引技术或过滤以减少比较次数。也可以使用为速度优化的 RapidFuzz 等库。
除了搜索引擎,模糊字符串匹配还有哪些常见应用?
模糊字符串匹配用于拼写检查、数据清洗、生物信息学中的 DNA 序列比对,以及数据库中的记录链接等。
Levenshtein 距离与其他编辑距离算法有何不同?
Levenshtein 距离考虑插入、删除和替换。其他算法如 Hamming 距离只考虑替换,且要求字符串等长。
FuzzyWuzzy 与 TheFuzz 有何区别?
它们本质上是同一个库。在 2021 年,流行库FuzzyWuzzy为了解决许可问题更名为TheFuzz。API 保持不变,因此如果您看到旧教程使用import fuzzywuzzy,只需import thefuzz,代码大概率无需修改即可运行。
“合适”的相似度阈值是多少?
没有放之四海而皆准的数值,但 80–90 是常见的起点。
- 高阈值(90+):当精确性至关重要时使用(例如合并财务记录)。您会遗漏一些匹配,但找到的通常是正确的。
- 低阈值(60–70):用于探索。您会捕获到更多潜在匹配,但也会出现需要人工审核的“误报”。
在匹配前我是否需要预处理文本?
是的,预处理对准确性至关重要。原始文本通常包含噪声,会降低相似度。在运行算法之前,您应对字符串进行标准化:
- 转为小写:("Apple" $\to$ "apple")
- 去除标点:("Inc." $\to$ "Inc")
- 修剪空白:(" London " $\to$ "London")
什么是模糊字符串匹配?
人类往往只需一眼就能判断拼写错误词语的本意。对计算机而言,这种区分并不那么明确。
模糊字符串匹配是近似字符串匹配的俗称——在本教程中我们将沿用“模糊字符串匹配”这一术语。它是一种用于识别两段文本字符串是否部分匹配(而非完全一致)的技术。
我们通常会在搜索引擎中见到这种现象。例如,用户如果在 Google 中输入“Londin”而不是“London”,模糊字符串匹配会识别出用户的本意是“London”,并返回相应的搜索结果。
在本文中,您将学习:
想学习更多 Python 技巧?现在就开始我们的《Python 数据清洗》课程。
查看DataLab 工作簿,跟进本文中使用的代码。