

Edits और edit distance
Fuzzy string matching एल्गोरिदम का लक्ष्य दो अलग-अलग स्ट्रिंग्स के बीच निकटता की डिग्री निर्धारित करना है। यह “edit distance” नामक डिस्टेंस मेट्रिक से ज्ञात होता है। Edit distance यह पता करता है कि एक स्ट्रिंग को दूसरी में बदलने के लिए न्यूनतम कितने “edits” आवश्यक हैं, और उसी से निकटता मापी जाती है।
यदि edit distance हमें यह बताने के लिए edit operations की संख्या गिनता है कि एक स्ट्रिंग दूसरी से कितनी दूर है, तो एक edit वह ऑपरेशन है जो किसी स्ट्रिंग पर उसे दूसरी स्ट्रिंग में बदलने के लिए किया जाता है।
Edits के चार मुख्य प्रकार हैं:
| Edit Operation | Description | Example |
|---|---|---|
| Insert | एक अक्षर जोड़ना | "Londn" -> "London" |
| Delete | एक अक्षर हटाना | "Londoon" -> "London" |
| Switch | दो सटे हुए अक्षरों की अदला-बदली | "Lnodon" -> "London" |
| Replace | एक अक्षर को दूसरे से बदलना | "Londin" -> "London" |
इन चार edit operations से किसी भी स्ट्रिंग को संशोधित करना संभव हो जाता है।
Edit operations को मिलाकर आप उन संभावित स्ट्रिंग्स की सूची खोज सकते हैं जो N edits दूर हैं, जहाँ N edit operations की संख्या है। उदाहरण के लिए, “London” और “Londin” के बीच edit distance एक है, क्योंकि “i” को “o” से बदलते ही बिल्कुल मिलान हो जाता है।
लेकिन edit distance वास्तव में कैसे गणना की जाती है?
Edit distance निकालने के अलग-अलग तरीके हैं। जैसे Levenshtein distance, Hamming distance, Jaro distance, आदि।
Levenshtein Distance कैसे निकाला जाता है?
इस ट्यूटोरियल में, हम केवल Levenshtein distance पर ध्यान देंगे।
यह एक मेट्रिक है जिसका नाम Vladimir Levenshtein के नाम पर है, जिन्होंने 1965 में इसे शब्दों के दो अनुक्रमों के बीच अंतर मापने के लिए प्रस्तावित किया था। हम इसका उपयोग यह पता करने के लिए कर सकते हैं कि एक शब्द-अनुक्रम को दूसरे में बदलने के लिए आपको न्यूनतम कितने edits करने होंगे।
औपचारिक गणना इस प्रकार है:
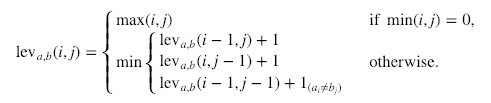
जहाँ  का मान a=b होने पर 0 होता है और अन्यथा 1।
ध्यान देने योग्य बात यह है कि ऊपर के न्यूनतम वाले पंक्तियाँ क्रमशः deletion, insertion, और substitution के अनुरूप हैं।
Levenshtein distance के आधार पर Levenshtein similarity ratio निकालना भी संभव है। यह निम्न सूत्र से किया जा सकता है:
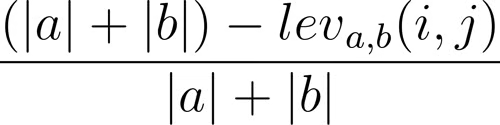
जहाँ |a| और |b| क्रमशः a और b अनुक्रमों की लंबाइयाँ हैं।
Simple Fuzzy String Matching
Python में fuzzy string matching के लिए ऐतिहासिक रूप से सबसे लोकप्रिय पैकेजों में से एक FuzzyWuzzy था। हालांकि, लाइसेंसिंग समस्याओं को सुलझाने और कोडबेस को अपडेट करने के लिए, 2021 में प्रोजेक्ट का नाम बदलकर TheFuzz कर दिया गया। अपनी सरलता के कारण यह शुरुआती लोगों के लिए अब भी पसंदीदा लाइब्रेरी है और हम इस ट्यूटोरियल में इसी का उपयोग करेंगे।
इसे मूल रूप से SeatGeek ने विकसित किया था ताकि यह पहचाना जा सके कि समान नाम वाली दो टिकट लिस्टिंग्स एक ही इवेंट के लिए हैं या नहीं। अपने पूर्ववर्ती की तरह, TheFuzz दो स्ट्रिंग्स के बीच निकटता की डिग्री निकालने के लिए Levenshtein edit distance का उपयोग करता है।
प्रो टिप: प्रोडक्शन के लिए RapidFuzz प्रयोग करें। जबकि TheFuzz सीखने और छोटे डेटा सेट्स के लिए बेहतरीन है, बड़े पैमाने की प्रोसेसिंग में यह धीमा हो सकता है। उद्योग व्यापक रूप से RapidFuzz नामक नई लाइब्रेरी की ओर बढ़ गया है।
- गति: RapidFuzz C++ में लिखा है, जिससे यह काफी तेज़ है।
- लाइसेंस: यह MIT लाइसेंस का उपयोग करता है, जो TheFuzz के GPL लाइसेंस की तुलना में कॉर्पोरेट उपयोग के लिए अधिक उदार है।
- संगतता: इसका सिंटैक्स लगभग वही है (जैसे,
fuzz.ratio), इसलिए बाद में स्विच करना आसान है।
इस गाइड के लिए, हम TheFuzz पर ही टिके रहेंगे क्योंकि यह कई वातावरणों में पहले से इंस्टॉल आता है और मूल अवधारणाओं को समझने के लिए बिल्कुल उपयुक्त है।
सबसे पहले, हमें TheFuzz पैकेज इंस्टॉल करना होगा। आप इसे pip से निम्न आदेश के साथ कर सकते हैं:
!pip install thefuzzनोट: यह लाइब्रेरी DataLab workbook में पहले से इंस्टॉल होती है।
अब देखते हैं, thefuzz के साथ हम क्या-क्या कर सकते हैं।
इस DataLab workbook में दिए गए कोड के साथ चलें।
Simple ratio
हम fuzz ऑब्जेक्ट पर ratio() मेथड का उपयोग करके दो स्ट्रिंग्स के बीच simple ratio पता कर सकते हैं। यह बस दोनों इनपुट स्ट्रिंग्स के क्रम के आधार पर edit distance की गणना करता है difflib.ratio() – अधिक जानने के लिए difflib प्रलेखन देखें।
# Check the similarity score
name = "Kurtis Pykes"
full_name = "Kurtis K D Pykes"
print(f"Similarity score: {fuzz.ratio(name, full_name)}")
"""
Similarity Score: 86
"""कोड में, हमने मेरे नाम के दो रूपों का उपयोग समानता स्कोर की तुलना के लिए किया, जो 86 निकला।
आइए इसे partial ratio के साथ परखते हैं।
Partial ratio
Partial ratio जांचने के लिए, ऊपर दिए कोड में हमें बस ratio() की जगह अपने fuzz ऑब्जेक्ट पर partial_ratio() कॉल करना है।
# Check the similarity score
name = "Kurtis Pykes"
full_name = "Kurtis K D Pykes"
print(f"Similarity score: {fuzz.partial_ratio(name, full_name)}")
"""
Similarity Score: 67
"""हम कमी देखते हैं। क्या हो रहा है?
दरअसल, partial_ratio() यह पता करता है कि दो स्ट्रिंग्स आंशिक रूप से कितनी समान हैं। दो स्ट्रिंग्स आंशिक रूप से समान तब मानी जाती हैं जब उनमें कुछ शब्द समान क्रम में हों।
partial_ratio() समानता इस तरह निकालता है कि वह सबसे छोटी स्ट्रिंग लेता है, जो यहाँ name वेरिएबल में है, फिर उसे लंबी स्ट्रिंग, यानी full_name, में उसी लंबाई के उप-स्ट्रिंग्स से तुलना करता है।
क्योंकि partial ratio में क्रम मायने रखता है, इस बार हमारा स्कोर गिर गया। इसलिए, 100% समानता पाने के लिए, आपको स्ट्रिंग के अंत में "K D" भाग (जो मेरा मध्य नाम दर्शाता है) ले जाना होगा। उदाहरण के लिए:
# Order matters with partial ratio
# Check the similarity score
name = "Kurtis Pykes"
full_name = "Kurtis Pykes K D"
print(f"Partial ratio similarity score: {fuzz.partial_ratio(name, full_name)}")
# But order will not effect simple ratio if strings do not match
print(f"Simple ratio similarity score: {fuzz.ratio(name, full_name)}")
"""
Partial ratio similarity score: 100
Simple ratio similarity score: 86
"""तो क्या करें यदि हम चाहते हैं कि हमारा fuzzy string matcher क्रम को नज़रअंदाज़ कर दे?
तब आप “token sort ratio” का उपयोग करना चाहेंगे।
Token sort ratio
ठीक है, हम स्ट्रिंग्स में शब्दों के क्रम को नज़रअंदाज़ करना चाहते हैं, लेकिन फिर भी उनकी समानता जानना चाहते हैं – token sort यही काम करता है। Token sort इस बात की परवाह नहीं करता कि शब्द किस क्रम में आते हैं। यह ऊपर बताए अनुसार क्रम से बाहर होते हुए भी समान स्ट्रिंग्स का हिसाब रखता है।
इसलिए, हमें हालिया उदाहरण में token sort ratio का उपयोग करने पर 100% स्कोर मिलना चाहिए:
# Check the similarity score
full_name = "Kurtis K D Pykes"
full_name_reordered = "Kurtis Pykes K D"
# Order does not matter for token sort ratio
print(f"Token sort ratio similarity score: {fuzz.token_sort_ratio(full_name_reordered, full_name)}")
# Order matters for partial ratio
print(f"Partial ratio similarity score: {fuzz.partial_ratio(full_name, full_name_reordered)}")
# Order will not effect simple ratio if strings do not match
print(f"Simple ratio similarity score: {fuzz.ratio(name, full_name)}")
"""
Token sort ratio similarity score: 100
Partial ratio similarity score: 75
Simple ratio similarity score: 86
"""… और जैसा अपेक्षित था, मिला भी।
आइए मूल name और full_name वेरिएबल्स पर लौटते हैं। अब यदि हम token sort उपयोग करें तो क्या होगा?
# Check the similarity score
name = "Kurtis Pykes"
full_name = "Kurtis K D Pykes"
print(f"Token sort ratio similarity score: {fuzz.token_sort_ratio(name, full_name)}")
"""
Token sort ratio similarity score: 86
"""स्कोर गिर जाता है।
यह इसलिए क्योंकि token sort केवल क्रम को नज़रअंदाज़ करता है। यदि स्ट्रिंग्स में असमान शब्द हैं, तो इसका समानता अनुपात पर नकारात्मक प्रभाव पड़ेगा, जैसा कि हमने ऊपर देखा।
पर इसका एक उपाय है।
Token set ratio
token_set_ratio() मेथड token_sort_ratio() से काफ़ी मिलता-जुलता है, सिवाय इसके कि यह समानता निकालने से पहले सामान्य टोकन्स को हटा देता है: जब स्ट्रिंग्स की लंबाई में बड़ा अंतर हो, तब यह अत्यंत सहायक होता है।
क्योंकि name और full_name वेरिएबल्स में “Kurtis Pykes” दोनों में है, हम अपेक्षा कर सकते हैं कि token set ratio समानता 100% होगी।
# Check the similarity score
name = "Kurtis Pykes"
full_name = "Kurtis K D Pykes"
print(f"Token sort ratio similarity score: {fuzz.token_set_ratio(name, full_name)}")
"""
Token sort ratio similarity score: 100
"""Process
Process मॉड्यूल उपयोगकर्ताओं को fuzzy string matching का उपयोग करके किसी कलेक्शन से टेक्स्ट निकालने में सक्षम बनाता है। Process मॉड्यूल पर extract() मेथड कॉल करने से समानता स्कोर के साथ स्ट्रिंग्स एक वेक्टर में लौटती हैं। उदाहरण:
from thefuzz import process
collection = ["AFC Barcelona", "Barcelona AFC", "barcelona fc", "afc barcalona"]
print(process.extract("barcelona", collection, scorer=fuzz.ratio))
"""
[('barcelona fc', 86), ('AFC Barcelona', 82), ('Barcelona AFC', 82), ('afc barcalona', 73)]
"""हम extract() मेथड द्वारा लौटाए गए वेक्टर की लंबाई को limit पैरामीटर को इच्छित लंबाई पर सेट करके नियंत्रित कर सकते हैं।
print(process.extract("barcelona", collection, scorer=fuzz.ratio))
"""
[('barcelona fc', 86), ('AFC Barcelona', 82), ('Barcelona AFC', 82)]
"""इस स्थिति में, extract() हमारे परिभाषित स्कोरर के आधार पर सबसे निकट के तीन मेल खाने वाली स्ट्रिंग्स लौटाता है।
TheFuzz के साथ fuzzy string matching तकनीकों की तुलना
नीचे दी गई तालिका में, आप TheFuzz में उपलब्ध विभिन्न तकनीकों की त्वरित तुलना देख सकते हैं:
| Technique | Description | Code Example |
|---|---|---|
| Simple Ratio | इनपुट स्ट्रिंग्स के क्रम को ध्यान में रखकर समानता निकालता है। | fuzz.ratio(name, full_name) |
| Partial Ratio | सबसे छोटी स्ट्रिंग की उप-स्ट्रिंग्स से तुलना कर आंशिक समानता ढूंढता है। | fuzz.partial_ratio(name, full_name) |
| Token Sort Ratio | स्ट्रिंग्स में शब्दों के क्रम को नज़रअंदाज़ करता है। | fuzz.token_sort_ratio(full_name_reordered, full_name) |
| Token Set Ratio | समानता निकालने से पहले सामान्य टोकन्स को हटा देता है। | fuzz.token_set_ratio(name, full_name) |
pandas के साथ Fuzzy String Matching
इस खंड में, हम देखेंगे कि pandas dataframe पर fuzzy string matching कैसे करें।
मान लें कि आपके पास कुछ डेटा है जिसे आपने pandas dataframe में निर्यात किया है, और आप उसे अपने मौजूदा डेटा से जोड़ना चाहते हैं।
import pandas as pd
# Creating a dataframe
dict_one = {
"country": ["England", "Scotland", "Wales", "United Kingdom", "Northern Ireland"],
"population_in_millions": [55.98, 5.45, 3.14, 67.33, 1.89]
}
dict_two = {
"country": ["Northern Iland", "Wles", "Scotlnd", "Englnd", "United K."],
"GDP_per_capita": [24900, 23882, 37460, 45101, 46510.28]
}
existing_data = pd.DataFrame(dict_one)
exported_data = pd.DataFrame(dict_two)
print(existing_data, exported_data, sep="\n\n")
"""
country population_in_millions
0 England 55.98
1 Scotland 5.45
2 Wales 3.14
3 United Kingdom 67.33
4 Northern Ireland 1.89
country GDP_per_capita
0 Northern Iland 24900.00
1 Wles 23882.00
2 Scotlnd 37460.00
3 Englnd 45101.00
4 United K. 46510.28
"""एक बड़ी समस्या है।
मौजूदा डेटा में देशों की वर्तनी सही है, लेकिन निर्यातित डेटा में नहीं। यदि हम country कॉलम पर दोनों dataframes को जोड़ने का प्रयास करें, तो pandas गलत वर्तनी वाले शब्दों को सही वर्तनी वाले शब्दों के बराबर नहीं मानेगा। इसलिए, merge फंक्शन का परिणाम अपेक्षित नहीं होगा।
यदि हम ऐसा करने की कोशिश करें तो यह होगा:
# Attempt to join the two dataframe
data = pd.merge(existing_data, exported_data, on="country", how="left")
print(data.head())
"""
country population_in_millions GDP_per_capita
0 England 55.98 NaN
1 Scotland 5.45 NaN
2 Wales 3.14 NaN
3 United Kingdom 67.33 NaN
4 Northern Ireland 1.89 NaN
"""यह इन dataframes को मर्ज करने के उद्देश्य को ही विफल कर देता है।
हालाँकि, हम इस समस्या को fuzzy string matching से दूर कर सकते हैं।
कोड में यह ऐसे दिखेगा:
# Rename the misspelled columns
exported_data["country"] = exported_data["country"].apply(
lambda x: process.extractOne(x, existing_data["country"], scorer=fuzz.partial_ratio)[0]
)
# Attempt to join the two dataframe
data = pd.merge(existing_data, exported_data, on="country", how="left")
print(data.head())
"""
country population_in_millions GDP_per_capita
0 England 55.98 45101.00
1 Scotland 5.45 37460.00
2 Wales 3.14 23882.00
3 United Kingdom 67.33 46510.28
4 Northern Ireland 1.89 24900.00
"""इस कोड में, हमने exported data के country कॉलम में गलत वर्तनी वाले मानों का नाम, process.extractOne() मेथड के साथ एक सरल lambda फंक्शन का उपयोग करके, बदल दिया है। ध्यान दें, हमने extractOne() के परिणाम पर इंडेक्स 0 उपयोग किया है ताकि सूची के बजाय केवल समान स्ट्रिंग लौटे, न कि स्ट्रिंग और समानता मान वाली सूची।
इसके बाद, हमने country कॉलम पर लेफ्ट जॉइन के साथ dataframes को मर्ज किया। परिणाम एक एकल dataframe है जिसमें सही वर्तनी वाले देश (United Kingdom के राजनीतिक संघ सहित) मौजूद हैं।
उपरोक्त समाधान इस ट्यूटोरियल और छोटे डेटा सेट्स के लिए तो उपयुक्त है, लेकिन इसे "Big Data" पर लागू करते समय सावधान रहें।
जब आप fuzzy matching के साथ .apply() का उपयोग करते हैं, तो कंप्यूटर को dataframe A की हर पंक्ति की तुलना dataframe B की हर पंक्ति से करनी पड़ती है (एक Cartesian Product)।
- Small Data: 100 पंक्तियाँ x 100 पंक्तियाँ = 10,000 तुलनाएँ (तुरंत)।
- Big Data: 50,000 पंक्तियाँ x 50,000 पंक्तियाँ = 2.5 बिलियन तुलनाएँ (यह आपका स्क्रिप्ट क्रैश कर देगा)।
कुछ हज़ार पंक्तियों से बड़े डेटा सेट्स के लिए, RapidFuzz (जो गति के लिए C++ का उपयोग करता है) या Splink (जो तुलनाओं को घटाने के लिए "blocking" उपयोग करता है) पर विचार करें।
pandas DataFrames के साथ fuzzy string matching
यदि आपको ऊपर बताई तकनीकों का त्वरित पुनरावलोकन चाहिए, तो वे नीचे तालिका में मिलेंगी:
| Step | Description | Code Snippet |
|---|---|---|
| Create DataFrames | संभावित गलत वर्तनी वाला डेटा परिभाषित करें। | existing_data = pd.DataFrame(dict_one), exported_data = pd.DataFrame(dict_two) |
| Attempt Merge with Errors | आरंभिक मर्ज असमान स्ट्रिंग्स के कारण विफल होता है। | data = pd.merge(existing_data, exported_data, on="country", how="left") |
| Correct Misspellings | गलत वर्तनी वाले देश-नाम ठीक करने के लिए fuzzy matching का उपयोग करें। | exported_data["country"] = exported_data["country"].apply(lambda x: process.extractOne(x, existing_data["country"], scorer=fuzz.partial_ratio)[0]) |
| Successful Merge | गलत वर्तनी सुधारने के बाद fuzzy string matching से dataframes मर्ज करें। | data = pd.merge(existing_data, exported_data, on="country", how="left") |
अंतिम विचार
इस ट्यूटोरियल में, आपने सीखा:
- Edits और edit distance
- Levenshtein edit distance और यह कैसे काम करता है
- Python में thefuzz लाइब्रेरी के साथ fuzzy string matching कैसे करें
- Pandas dataframes के साथ fuzzy string matching कैसे करें।
यहाँ दिए उदाहरण सरल हो सकते हैं, पर ये इतने पर्याप्त हैं कि यह दिखा सकें कि कंप्यूटर जिन स्ट्रिंग्स को mismatch मानता है, उनके विभिन्न मामलों को कैसे संभाला जाए। Fuzzy matching के कई उपयोग हैं, जैसे spell-checking और bioinformatics, जहाँ DNA अनुक्रमों के मिलान के लिए fuzzy logic का उपयोग किया जाता है।
अतिरिक्त संसाधन
Python में Fuzzy String Matching FAQs
Fuzzy string matching case sensitivity को कैसे संभालता है?
Fuzzy string matching सामान्यतः case-sensitive होता है, जब तक कि इसे स्पष्ट रूप से अन्यथा न सेट किया जाए। आप case-insensitivity पाने के लिए मिलान से पहले स्ट्रिंग्स को लोअरकेस में बदल सकते हैं।
क्या मैं स्ट्रिंग्स के अलावा अन्य डेटा स्ट्रक्चर के साथ TheFuzz लाइब्रेरी का उपयोग कर सकता/सकती हूँ?
TheFuzz मुख्यतः स्ट्रिंग तुलना के लिए डिज़ाइन किया गया है। हालाँकि, आप अन्य डेटा प्रकारों को स्ट्रिंग्स में बदलकर fuzzy matching तकनीकें लागू कर सकते हैं।
बड़े डेटा सेट्स में प्रदर्शन अनुकूलन के लिए fuzzy matching कैसे संभालें?
बड़े डेटा सेट्स के लिए, तुलनाओं की संख्या घटाने हेतु indexing तकनीकें या फ़िल्टरिंग का उपयोग करें। गति के लिए अनुकूलित RapidFuzz जैसी लाइब्रेरी भी उपयोग की जा सकती है।
सर्च इंजनों से इतर fuzzy string matching के कुछ सामान्य उपयोग क्या हैं?
Fuzzy string matching का उपयोग स्पेल-चेकर, डेटा क्लीनिंग, DNA sequence alignment के लिए bioinformatics, और डेटाबेस में record linkage में किया जाता है।
Levenshtein distance अन्य edit distance एल्गोरिदम से कैसे भिन्न है?
Levenshtein distance insertions, deletions और substitutions को ध्यान में रखता है। अन्य एल्गोरिदम, जैसे Hamming distance, केवल substitutions पर विचार करते हैं और समान लंबाई की स्ट्रिंग्स की आवश्यकता होती है।
FuzzyWuzzy और TheFuzz में क्या अंतर है?
ये व्यवहार में वही लाइब्रेरी हैं. 2021 में, लोकप्रिय लाइब्रेरी FuzzyWuzzy का नाम लाइसेंसिंग समस्याएँ सुलझाने के लिए बदलकर TheFuzz कर दिया गया। API वही रहा, इसलिए यदि आप किसी पुराने ट्यूटोरियल में import fuzzywuzzy देखते हैं, तो आप बस import thefuzz कर सकते हैं और कोड बिना बदलाव के काम करने की प्रबल संभावना है।
एक "अच्छा" similarity score थ्रेशोल्ड क्या है?
कोई सार्वभौमिक संख्या नहीं है, लेकिन 80-90 एक सामान्य शुरुआती बिंदु है।
- उच्च थ्रेशोल्ड (90+): जब परिशुद्धता महत्वपूर्ण हो (जैसे, वित्तीय रिकॉर्ड मर्ज करना)। आप कुछ मेल चूकेंगे, पर जो मिलेंगे वे संभवतः सही होंगे।
- निम्न थ्रेशोल्ड (60-70): अन्वेषण के लिए उपयोग करें। आप अधिक संभावित मेल पकड़ेंगे, पर साथ ही ऐसे "false positives" भी आएँगे जिनकी मैनुअल समीक्षा चाहिए होगी।
क्या मिलान से पहले मुझे अपना टेक्स्ट प्री-प्रोसेस करना चाहिए?
हाँ, पूर्व-प्रसंस्करण शुद्धता के लिए महत्वपूर्ण है। कच्चे टेक्स्ट में अक्सर ऐसा शोर होता है जो समानता स्कोर घटाता है। एल्गोरिदम चलाने से पहले, आपको अपनी स्ट्रिंग्स को मानकीकृत करना चाहिए:
- लोअरकेस करना: ("Apple" $\to$ "apple")
- विराम चिह्न हटाना: ("Inc." $\to$ "Inc")
- व्हाइटस्पेस ट्रिम करना: (" London " $\to$ "London")
Fuzzy String Matching क्या है?
कोई मानव एक नज़र में गलत वर्तनी वाले शब्द का आशय समझ सकता है। कंप्यूटर के लिए, यह भेद उतना स्पष्ट नहीं होता।
Fuzzy string matching, approximate string matching का बोलचाल का नाम है – इस ट्यूटोरियल में हम इसी शब्द का उपयोग करेंगे। यह एक तकनीक है जो उन दो टेक्स्ट स्ट्रिंग्स की पहचान करती है जो आंशिक रूप से मिलती-जुलती हैं, पर बिल्कुल एक जैसी नहीं होतीं।
हम आमतौर पर इसे सर्च इंजनों में देखते हैं। उदाहरण के लिए, यदि कोई उपयोगकर्ता Google में “Londin” की जगह “London” टाइप करे, तो fuzzy string matching यह पहचान लेगा कि आशय “London” था, और Google उसी के लिए परिणाम लौटाएगा।
इस लेख में, आप सीखेंगे:
और अधिक Python तकनीकों के लिए आज ही हमारा Cleaning Data in Python कोर्स शुरू करें।
इस लेख में उपयोग किए गए कोड के साथ चलने के लिए DataLab workbook देखें।