尽管 AWS EC2 仍是云计算领域的领导者,Google Cloud 已经打造出极具吸引力且竞争力的云计算平台。
在本教程中,您将学到如何:
在 Google Compute Engine(GCE)上创建实例;
安装基于 Anaconda 的数据科学环境;以及
在线访问并运行 Jupyter Notebook。
在云端而非本地机器上开展数据科学项目,主要有两大优势:
可扩展性:您可以根据当下需求调整实例的算力(RAM、CPU、GPU)。从小而经济的实例起步,随着项目推进再逐步增加内存、存储、CPU 或 GPU。
可复现性:这是任何数据科学项目的关键要求。允许其他数据科学家审阅您的模型并复现实验,是成功落地的必要条件。通过在虚拟实例上搭建工作环境,您可以确保工作便于分享、复现和由团队成员审核。
Google Compute Engine
虽然 EC2 和 GCE 都建立在类似的概念和元素(实例、镜像与快照)之上,但它们在访问方式和资源组织上有所不同。
Google Cloud Platform(GCP)的一个关键特性是其以项目为中心的组织方式。所有计费、权限、资源和设置都归属于用户定义的项目,项目基本上充当一个全局命名空间。这不仅简化了您所用资源(存储、数据库、实例等)之间的关联映射,也让从基于角色的权限到实际的 SSH 密钥和安全策略的访问管理更加简单。就易用性以及访问与角色管理而言,我认为在 GCP 上工作比在 AWS 上更为轻松,尤其是在同时使用多种服务时。
GCP 还提供了一些对数据科学尤为相关的服务,包括但不限于:
较低的学习门槛和对数据友好的服务,使 GCP 成为数据科学家工具箱中的必备品。
在开始启动实例并安装 Python 包之前,我们先用一点时间回顾一下云计算中的一些常用术语。
VM、磁盘、镜像与快照
虚拟机(VM),也称为“实例”,是您按需启用的服务器。底层硬件会与其他用户共享,并以透明方式进行虚拟化。您只需选择托管在 Google 某个数据中心的实例的大致地理位置。
VM 由持久磁盘类型以及其所基于的操作系统(OS,如 Windows 或 Linux)共同定义。持久磁盘就是您的虚拟硬件切片。
镜像是持久磁盘与操作系统的物理组合。VM 镜像常用于在多台 VM 上共享并实施特定配置。公共镜像由 Google 提供,包含多种特定 OS 选项;私有镜像则由用户自定义。
快照是在某一时刻对 VM(磁盘、软件、库、文件)内容的映射,主要用于即时备份。快照与镜像的主要区别在于,快照以相对于前一快照的差异形式存储,而镜像则不是。
镜像和快照都可以用来定义并启用新的 VM。
回顾一下:当您启动新实例时,GCE 会先将一个持久磁盘挂载到 VM 上。这既提供了磁盘空间,也为实例提供了启动所需的根文件系统。该磁盘会安装您所选镜像关联的操作系统。通过对镜像进行快照,您可以创建即时备份,并可从现有 VM 复制数据以启动新的 VM。
现在就把这些付诸实践,开始创建您的第一台 VM!
在 GCP 上的第一台 VM:快速开始
创建账户和项目
要在 GCP 上开户,您需要一个标准的 Google(Gmail)账户。撰文时,Google 提供为期 12 个月/300 美元的免费试用 。尽管该优惠附带一些限制 (例如禁止比特币挖矿),但足以让您在这一环境中起步。
要使用免费试用创建 GCP 账户,请访问 cloud.google.com 并点击 try it free 按钮。系统会要求您使用 Google 账户登录并添加结算信息。创建账户后,您可以通过 http://console.cloud.google.com/ 访问网页版控制台。
您将先使用网页版控制台定义并启动一个基于 Debian 的实例,然后切换到基于网页的 Shell 终端安装数据科学技术栈所需的软件包。
但首先,您需要创建一个新项目:
前往资源管理页面 ;
点击“Create a new project”;
填写项目标题,并留意 Google 如何即时生成项目 ID;
按需编辑项目 ID,然后点击“Create”。
项目 ID 必须在 GCP 命名空间内全局唯一,而项目标题可以随意。我的项目命名为 datacamp-gcp,如下所示:
默认情况下,创建新项目时,您的 Google 账户会被设为该项目的所有者,拥有对项目所有资源及计费的完全权限和访问权。
在 IAM 页面 的角色部分,您可以为项目添加具有特定角色的成员。出于本教程目的,您可以跳过此步骤,仅保留您自己作为项目的唯一用户和管理员。
创建实例
要创建第一台 VM,请按以下步骤操作:
访问 https://console.cloud.google.com/home/dashboard 的仪表板,选择刚创建的项目。
在左上角菜单中选择“Compute Engine”,点击“VM instances”。
在弹窗中点击“Create”按钮。
您现在来到了“Create an Instance”页面。
为实例命名:名称可随意。我将实例命名为 starling。
选择区域:经验法则是选择离您最近且价格最低的区域,以减少延迟。我选择 east-d。请注意,不同区域价格差异较大。
选择所需的内存、存储和 CPU。您可以使用多个预设,也可自定义实例。这里我选择默认配置 n1-standard-1,即 3.75 GB 内存和 1 个 vCPU,预估每月 $24.67。
选择启动磁盘 ,使用默认的 Debian GNU/Linux 9(stretch)操作系统和 10 GB 存储。如果您更喜欢 Ubuntu 或其他 Linux 发行版,点击“Change”并进行相应选择。由于 Ubuntu 与 Debian 关系密切,本教程中两者皆可。
5. 确保能从互联网访问该 VM,勾选允许 HTTP 和 HTTPS 流量。
6.(可选)启用持久磁盘用于备份:点击“Management, Disks, networking, SSH keys”链接。将显示一组选项卡,选择“Disks”选项卡并取消选中“Deletion Rule”。这样,当您删除实例时,磁盘不会被删除,可在后续用于快速启动新实例。
7. 最后,点击“Create”。几分钟后实例即可就绪。
注意 Create 按钮下方的“Equivalent command line”链接。该链接会显示从零创建同一实例所需的等效命令行。这是个非常聪明的功能,有助于学习 gcloud SDK 的语法。
至此,您有了一个正在运行的实例,但几乎还是空的。访问实例有两种方式:要么在本地机器上安装 gcloud SDK ,要么使用 Google 的 Cloud Shell。
Google 的 Cloud Shell
Google 的 Cloud Shell 是浏览器中的独立终端,您可以用它来访问和管理资源。点击控制台页面右上角的 >\_ 图标即可激活 Cloud Shell。浏览器下方会变成一个 Shell 终端。
该终端运行在一台 f1-micro 的 Google Compute Engine 虚拟机上,操作系统为 Debian,带有 5 GB 存储。它按用户、按会话创建。在您的 Cloud Shell 会话活动期间保持存在,若 20 分钟无操作则会删除。由于关联磁盘在会话之间保持持久,您的内容(文件、配置等)会在各会话间保留。Cloud Shell 实例预装了 gcloud SDK 和 vim。
需要明确区分基于用户的 Cloud Shell 实例与您刚创建的实例。支撑 Cloud Shell 的实例只是一个便捷的资源管理环境,用于在临时实例上存储您的配置。而您刚创建的那台 VM(上例中命名为 starling)才是您要安装数据科学环境的地方。
除了使用 Google Cloud Shell,您也可以在本地机器上安装 gcloud SDK ,在本地环境中进行全部管理。
以下是一些管理实例的实用命令:
列出您的实例
gcloud compute instances list
停止实例(需数秒)
gcloud compute instances stop <instance name>
启动实例(同样需数秒)
gcloud compute instances start <instance name>
通过 SSH 连接到 starling 实例
gcloud compute ssh <instance name>
设置 VM
在 Google Shell 窗口中运行上面的最后一个命令登录到您的实例。接下来的步骤包括:
使用 apt-get install 安装若干 Debian 包;
安装 Anaconda 或 Miniconda 发行版;
配置实例,使 Jupyter Notebook 能安全地在线访问。
Debian 软件包
先从安装以下 Debian 包开始:
bzip2:安装 Mini/Anaconda 所需;
git:常用工具;
libxml2-dev:目前不是必需,但在后续安装部分 Python 库时常常需要。
在终端中运行以下命令(Ubuntu 与 Debian 通用):
$ sudo apt- get update
$ sudo apt- get install bzip2 git libxml2- dev
技术支持 Anaconda / Miniconda
安装完上述软件包后,开始安装 Python 3 的 Anaconda 发行版。您可以选择安装包含众多科学 Python 库的完整版 Anaconda(其中一些您可能暂时用不到),也可选择更轻量的 Miniconda 版本(需要您手动安装 Jupyter 等库)。两种方式过程相似。
要安装更轻量的 Miniconda 发行版 ,运行:
$ wget https: / / repo. continuum. io/ miniconda/ Miniconda3- latest- Linux- x86_64. sh
$ bash Miniconda3- latest- Linux- x86_64. sh
$ rm Miniconda3- latest- Linux- x86_64. sh
$ source . bashrc
$ conda install scikit- learn pandas jupyter ipython
技术支持 前两行下载并运行安装脚本。安装时请接受许可并使用默认路径。第 3 行删除不再需要的安装脚本文件。第 4 行通过执行 .bashrc,无需重开终端即可将 conda 命令加入 $PATH。最后一行安装所需的 Python 库:scikit-learn pandas jupyter ipython。
安装完整版 Anaconda 的命令非常类似。请务必查看下载页面 以获取最新脚本文件版本:
$ wget https: / / repo. continuum. io/ archive/ Anaconda3- 5.0 .1 - Linux- x86_64. sh
$ bash Anaconda3- 5.0 .1 - Linux- x86_64. sh
$ rm Anaconda3- 5.0 .1 - Linux- x86_64. sh
$ source . bahsrc
技术支持 为验证一切安装正确,可用 python --version 查看 Python 版本,并用 which python 确认默认调用的是正确的 Python。您应能得到类似下面的结果:
至此,您已经拥有一个可用的 Python 环境,并安装了标准的数据科学库(sklearn、pandas)。
允许网页访问
第三步也是最后一步,是配置 VM 以允许通过网页访问您的 Jupyter Notebook。
首先需要让 VM 能从外网访问。为此,您将在 Google Cloud 控制台中创建一条防火墙规则。返回实例仪表板 ,在左上角菜单中选择“VPC Network > Firewall rules”。点击“CREATE FIREWAL RULE”链接,并填写如下值:
Name :jupyter-rule (名称可自定义 )Source IP ranges :0.0.0.0/0 Specified protocols and ports :tcp:8888 其余变量保持默认。
表单应类似如下:
该防火墙规则允许所有传入流量(来自所有 IP)访问 8888 端口。
通过“Equivalent command line”链接,您可以看到也可在终端中用以下命令创建该防火墙规则:
$ gcloud compute --project=datacamp-gcp firewall-rules create jupyter-rule --direction=INGRESS --priority=1000 --network=default --action=ALLOW --rules=tcp:8888 --source-ranges=0.0.0.0/0
现在返回 VM 页面(左上角菜单 > Compute Engine > VM instances),点击您的 VM 名称。
记下 VM 的 IP 地址。您将用该 IP 在浏览器中访问 Jupyter 环境。就我这里的示例而言,IP 地址是:35.196.81.49,您的会不同。
并确保已勾选防火墙规则:
Jupyter 配置
Jupyter Notebook 提供了一个需要生成并编辑的配置文件,以便设置在线访问。在终端中运行 jupyter notebook --generate-config 生成配置文件,并运行 jupyter notebook password 生成密码。
提示 :请务必设置一个强密码!
现在用 vim .jupyter/jupyter_notebook_config.py 编辑您刚创建的配置文件,并在文件顶部添加以下一行:
c.NotebookApp.ip = '*'
(在 vim 中切换到编辑模式,按下 i 键)。使用 ESC:wq 组合键保存并退出。
这将允许 Notebook 在您的 VM 上对所有 IP 可用,而不仅仅是您在本机工作时常见的 http://localhost:8888 URL。
启动
现在您可以用以下命令启动 Jupyter Notebook:
$ jupyter-notebook --no-browser --port=8888
终端中应看到类似如下输出:
在浏览器中访问 URL:http://<your_VM_IP>:8888/,即可进入刚搭建好的 Jupyter Notebook。
为检查一切正常,创建一个新的 Python 3 笔记本,并执行 import pandas。
插曲
关于当前设置的几点说明:
您在浏览器中使用的 IP 地址是临时的。这意味着每次重启 VM,Notebook 的 URL 都会改变。您可以通过:左上角菜单 > VPC Network > External IP addresses 将其改为“static”,如下图所示:
当前设置的安全性依赖于您之前设定的 Jupyter Notebook 密码的强度。互联网上的任何人都可以访问与您相同的 URL(而且机器人一定会尝试)。Jupyter Notebook 的一个强大却非常不安全的核心功能是,您可以直接从 Notebook 打开具有 sudo 权限的终端。这意味着,一旦有人破解了您的 Notebook 密码,就可能接管您的 VM,并运行任何会让您的账单激增的操作。第一层防护措施包括:
确保您的 Jupyter 密码足够强;
不工作时记得停止 VM。
此外,您目前通过 http 而非 https 访问服务器,安全性不足。Let’s Encrypt 提供免费的 SSL/TLS 证书,并且是Jupyter 文档 中推荐的加密方案。关于运行公共 Jupyter Notebook 的安全问题,更多信息可参见这篇文章 。
IPython
Jupyter Notebook 非常适合在线协作。但您也可以在终端中直接运行 ipython 命令开启 IPython 会话。它具备 Jupyter Notebook 的所有便利功能(如魔法命令 %paste、%run 等),只是没有网页界面。
R
要在 Jupyter 控制台中启用 R Notebook 也很容易。启用 R Markdown 的说明请参考这篇精彩的 DataCamp 教程:Karlijn Willems 的《Jupyter 与 R Markdown:R 笔记本》 。
结语
Google Cloud 为数据科学提供了许多有趣的服务,并配备强大却易于配置的 VM 实例,同时还有极具吸引力的免费试用。其网页版控制台易于导航,并常常展示当前配置页面的等效命令行,从而降低了使用 gcloud SDK 的门槛。
在本文中,您学会了如何选择并启动 VM 实例,安装必要的 Debian 软件包、Anaconda 发行版和数据科学栈,最后配置访问规则,从浏览器启动可访问的 Jupyter Notebook。
尽管首次操作可能显得有些复杂,但随着您创建并启动越来越多的 VM,这一流程会很快变得驾轻就熟。如果遇到混乱,随时可以删除当前 VM 从头再来——这正是云端工作的优势之一。几次练习之后,您就能在几分钟内在 Google Cloud 上搭建完整的数据科学环境。欢迎通过 Twitter 与我交流您的看法与问题:@alexip 。


尽管 AWS EC2 仍是云计算领域的领导者,Google Cloud 已经打造出极具吸引力且竞争力的云计算平台。
在本教程中,您将学到如何:
在云端而非本地机器上开展数据科学项目,主要有两大优势:
Google Compute Engine
虽然 EC2 和 GCE 都建立在类似的概念和元素(实例、镜像与快照)之上,但它们在访问方式和资源组织上有所不同。
Google Cloud Platform(GCP)的一个关键特性是其以项目为中心的组织方式。所有计费、权限、资源和设置都归属于用户定义的项目,项目基本上充当一个全局命名空间。这不仅简化了您所用资源(存储、数据库、实例等)之间的关联映射,也让从基于角色的权限到实际的 SSH 密钥和安全策略的访问管理更加简单。就易用性以及访问与角色管理而言,我认为在 GCP 上工作比在 AWS 上更为轻松,尤其是在同时使用多种服务时。
GCP 还提供了一些对数据科学尤为相关的服务,包括但不限于:
较低的学习门槛和对数据友好的服务,使 GCP 成为数据科学家工具箱中的必备品。
在开始启动实例并安装 Python 包之前,我们先用一点时间回顾一下云计算中的一些常用术语。
VM、磁盘、镜像与快照
虚拟机(VM),也称为“实例”,是您按需启用的服务器。底层硬件会与其他用户共享,并以透明方式进行虚拟化。您只需选择托管在 Google 某个数据中心的实例的大致地理位置。
VM 由持久磁盘类型以及其所基于的操作系统(OS,如 Windows 或 Linux)共同定义。持久磁盘就是您的虚拟硬件切片。
镜像是持久磁盘与操作系统的物理组合。VM 镜像常用于在多台 VM 上共享并实施特定配置。公共镜像由 Google 提供,包含多种特定 OS 选项;私有镜像则由用户自定义。
快照是在某一时刻对 VM(磁盘、软件、库、文件)内容的映射,主要用于即时备份。快照与镜像的主要区别在于,快照以相对于前一快照的差异形式存储,而镜像则不是。
镜像和快照都可以用来定义并启用新的 VM。
回顾一下:当您启动新实例时,GCE 会先将一个持久磁盘挂载到 VM 上。这既提供了磁盘空间,也为实例提供了启动所需的根文件系统。该磁盘会安装您所选镜像关联的操作系统。通过对镜像进行快照,您可以创建即时备份,并可从现有 VM 复制数据以启动新的 VM。
现在就把这些付诸实践,开始创建您的第一台 VM!
在 GCP 上的第一台 VM:快速开始
创建账户和项目
要在 GCP 上开户,您需要一个标准的 Google(Gmail)账户。撰文时,Google 提供为期 12 个月/300 美元的免费试用。尽管该优惠附带一些限制(例如禁止比特币挖矿),但足以让您在这一环境中起步。
要使用免费试用创建 GCP 账户,请访问 cloud.google.com 并点击
try it free按钮。系统会要求您使用 Google 账户登录并添加结算信息。创建账户后,您可以通过 http://console.cloud.google.com/ 访问网页版控制台。您将先使用网页版控制台定义并启动一个基于 Debian 的实例,然后切换到基于网页的 Shell 终端安装数据科学技术栈所需的软件包。
但首先,您需要创建一个新项目:
项目 ID 必须在 GCP 命名空间内全局唯一,而项目标题可以随意。我的项目命名为
datacamp-gcp,如下所示:默认情况下,创建新项目时,您的 Google 账户会被设为该项目的所有者,拥有对项目所有资源及计费的完全权限和访问权。
在 IAM 页面的角色部分,您可以为项目添加具有特定角色的成员。出于本教程目的,您可以跳过此步骤,仅保留您自己作为项目的唯一用户和管理员。
创建实例
要创建第一台 VM,请按以下步骤操作:
您现在来到了“Create an Instance”页面。
为实例命名:名称可随意。我将实例命名为
starling。选择区域:经验法则是选择离您最近且价格最低的区域,以减少延迟。我选择
east-d。请注意,不同区域价格差异较大。选择所需的内存、存储和 CPU。您可以使用多个预设,也可自定义实例。这里我选择默认配置
n1-standard-1,即 3.75 GB 内存和 1 个 vCPU,预估每月 $24.67。选择启动磁盘,使用默认的 Debian GNU/Linux 9(stretch)操作系统和 10 GB 存储。如果您更喜欢 Ubuntu 或其他 Linux 发行版,点击“Change”并进行相应选择。由于 Ubuntu 与 Debian 关系密切,本教程中两者皆可。
5. 确保能从互联网访问该 VM,勾选允许 HTTP 和 HTTPS 流量。
6.(可选)启用持久磁盘用于备份:点击“Management, Disks, networking, SSH keys”链接。将显示一组选项卡,选择“Disks”选项卡并取消选中“Deletion Rule”。这样,当您删除实例时,磁盘不会被删除,可在后续用于快速启动新实例。
7. 最后,点击“Create”。几分钟后实例即可就绪。
注意
Create按钮下方的“Equivalent command line”链接。该链接会显示从零创建同一实例所需的等效命令行。这是个非常聪明的功能,有助于学习 gcloud SDK 的语法。至此,您有了一个正在运行的实例,但几乎还是空的。访问实例有两种方式:要么在本地机器上安装 gcloud SDK,要么使用 Google 的 Cloud Shell。
Google 的 Cloud Shell
Google 的 Cloud Shell 是浏览器中的独立终端,您可以用它来访问和管理资源。点击控制台页面右上角的
>\_图标即可激活 Cloud Shell。浏览器下方会变成一个 Shell 终端。该终端运行在一台 f1-micro 的 Google Compute Engine 虚拟机上,操作系统为 Debian,带有 5 GB 存储。它按用户、按会话创建。在您的 Cloud Shell 会话活动期间保持存在,若 20 分钟无操作则会删除。由于关联磁盘在会话之间保持持久,您的内容(文件、配置等)会在各会话间保留。Cloud Shell 实例预装了 gcloud SDK 和 vim。
需要明确区分基于用户的 Cloud Shell 实例与您刚创建的实例。支撑 Cloud Shell 的实例只是一个便捷的资源管理环境,用于在临时实例上存储您的配置。而您刚创建的那台 VM(上例中命名为
starling)才是您要安装数据科学环境的地方。除了使用 Google Cloud Shell,您也可以在本地机器上安装 gcloud SDK,在本地环境中进行全部管理。
以下是一些管理实例的实用命令:
列出您的实例
gcloud compute instances list停止实例(需数秒)
gcloud compute instances stop <instance name>启动实例(同样需数秒)
gcloud compute instances start <instance name>通过 SSH 连接到 starling 实例
gcloud compute ssh <instance name>设置 VM
在 Google Shell 窗口中运行上面的最后一个命令登录到您的实例。接下来的步骤包括:
apt-get install安装若干 Debian 包;Debian 软件包
先从安装以下 Debian 包开始:
在终端中运行以下命令(Ubuntu 与 Debian 通用):
Anaconda / Miniconda
安装完上述软件包后,开始安装 Python 3 的 Anaconda 发行版。您可以选择安装包含众多科学 Python 库的完整版 Anaconda(其中一些您可能暂时用不到),也可选择更轻量的 Miniconda 版本(需要您手动安装 Jupyter 等库)。两种方式过程相似。
要安装更轻量的 Miniconda 发行版,运行:
前两行下载并运行安装脚本。安装时请接受许可并使用默认路径。第 3 行删除不再需要的安装脚本文件。第 4 行通过执行
.bashrc,无需重开终端即可将conda命令加入$PATH。最后一行安装所需的 Python 库:scikit-learn pandas jupyter ipython。安装完整版 Anaconda 的命令非常类似。请务必查看下载页面以获取最新脚本文件版本:
为验证一切安装正确,可用
python --version查看 Python 版本,并用which python确认默认调用的是正确的 Python。您应能得到类似下面的结果:至此,您已经拥有一个可用的 Python 环境,并安装了标准的数据科学库(
sklearn、pandas)。允许网页访问
第三步也是最后一步,是配置 VM 以允许通过网页访问您的 Jupyter Notebook。
首先需要让 VM 能从外网访问。为此,您将在 Google Cloud 控制台中创建一条防火墙规则。返回实例仪表板,在左上角菜单中选择“VPC Network > Firewall rules”。点击“CREATE FIREWAL RULE”链接,并填写如下值:
表单应类似如下:
该防火墙规则允许所有传入流量(来自所有 IP)访问 8888 端口。
通过“Equivalent command line”链接,您可以看到也可在终端中用以下命令创建该防火墙规则:
$ gcloud compute --project=datacamp-gcp firewall-rules create jupyter-rule --direction=INGRESS --priority=1000 --network=default --action=ALLOW --rules=tcp:8888 --source-ranges=0.0.0.0/0现在返回 VM 页面(左上角菜单 > Compute Engine > VM instances),点击您的 VM 名称。
记下 VM 的 IP 地址。您将用该 IP 在浏览器中访问 Jupyter 环境。就我这里的示例而言,IP 地址是:
35.196.81.49,您的会不同。并确保已勾选防火墙规则:
Jupyter 配置
Jupyter Notebook 提供了一个需要生成并编辑的配置文件,以便设置在线访问。在终端中运行
jupyter notebook --generate-config生成配置文件,并运行jupyter notebook password生成密码。提示:请务必设置一个强密码!
现在用
vim .jupyter/jupyter_notebook_config.py编辑您刚创建的配置文件,并在文件顶部添加以下一行:c.NotebookApp.ip = '*'(在 vim 中切换到编辑模式,按下
i键)。使用ESC:wq组合键保存并退出。这将允许 Notebook 在您的 VM 上对所有 IP 可用,而不仅仅是您在本机工作时常见的
http://localhost:8888URL。启动
现在您可以用以下命令启动 Jupyter Notebook:
$ jupyter-notebook --no-browser --port=8888终端中应看到类似如下输出:
在浏览器中访问 URL:
http://<your_VM_IP>:8888/,即可进入刚搭建好的 Jupyter Notebook。为检查一切正常,创建一个新的 Python 3 笔记本,并执行
import pandas。插曲
关于当前设置的几点说明:
您在浏览器中使用的 IP 地址是临时的。这意味着每次重启 VM,Notebook 的 URL 都会改变。您可以通过:左上角菜单 > VPC Network > External IP addresses 将其改为“static”,如下图所示: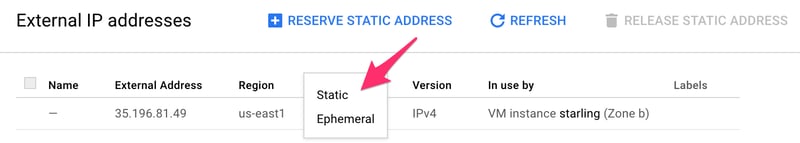
当前设置的安全性依赖于您之前设定的 Jupyter Notebook 密码的强度。互联网上的任何人都可以访问与您相同的 URL(而且机器人一定会尝试)。Jupyter Notebook 的一个强大却非常不安全的核心功能是,您可以直接从 Notebook 打开具有 sudo 权限的终端。这意味着,一旦有人破解了您的 Notebook 密码,就可能接管您的 VM,并运行任何会让您的账单激增的操作。第一层防护措施包括:
确保您的 Jupyter 密码足够强;
此外,您目前通过 http 而非 https 访问服务器,安全性不足。Let’s Encrypt 提供免费的 SSL/TLS 证书,并且是Jupyter 文档中推荐的加密方案。关于运行公共 Jupyter Notebook 的安全问题,更多信息可参见这篇文章。
IPython
Jupyter Notebook 非常适合在线协作。但您也可以在终端中直接运行
ipython命令开启 IPython 会话。它具备 Jupyter Notebook 的所有便利功能(如魔法命令 %paste、%run 等),只是没有网页界面。R
要在 Jupyter 控制台中启用 R Notebook 也很容易。启用 R Markdown 的说明请参考这篇精彩的 DataCamp 教程:Karlijn Willems 的《Jupyter 与 R Markdown:R 笔记本》。
结语
Google Cloud 为数据科学提供了许多有趣的服务,并配备强大却易于配置的 VM 实例,同时还有极具吸引力的免费试用。其网页版控制台易于导航,并常常展示当前配置页面的等效命令行,从而降低了使用 gcloud SDK 的门槛。
在本文中,您学会了如何选择并启动 VM 实例,安装必要的 Debian 软件包、Anaconda 发行版和数据科学栈,最后配置访问规则,从浏览器启动可访问的 Jupyter Notebook。
尽管首次操作可能显得有些复杂,但随着您创建并启动越来越多的 VM,这一流程会很快变得驾轻就熟。如果遇到混乱,随时可以删除当前 VM 从头再来——这正是云端工作的优势之一。几次练习之后,您就能在几分钟内在 Google Cloud 上搭建完整的数据科学环境。欢迎通过 Twitter 与我交流您的看法与问题:@alexip。