जहाँ AWS EC2 क्लाउड कंप्यूटिंग में अग्रणी है, वहीं Google Cloud ने एक बेहद प्रभावशाली और प्रतिस्पर्धी क्लाउड कंप्यूटिंग प्लेटफ़ॉर्म विकसित किया है।
इस ट्यूटोरियल में, आप सीखेंगे कि कैसे:
Google Compute Engine (GCE) पर एक इंस्टेंस बनाना,
Anaconda Python डिस्ट्रीब्यूशन के आधार पर डेटा साइंस वातावरण इंस्टॉल करना, और
ऑनलाइन एक्सेस होने वाले Jupyter नोटबुक्स चलाना।
क्लाउड में काम करने के, अपनी मशीन पर काम करने की तुलना में, डेटा साइंस प्रोजेक्ट्स के लिए दो मुख्य फायदे हैं:
स्केलेबिलिटी: आप अपनी तात्कालिक ज़रूरतों के अनुसार अपने इंस्टेंस की शक्ति (RAM, CPU, GPU) तय कर सकते हैं। छोटे और सस्ते इंस्टेंस से शुरू करके, जैसे-जैसे आपका प्रोजेक्ट आगे बढ़ता है, आप मेमोरी, स्टोरेज, CPU या GPU जोड़ सकते हैं।
रीप्रोड्यूसिबिलिटी: किसी भी डेटा साइंस प्रोजेक्ट की एक मुख्य शर्त। अन्य डेटा वैज्ञानिकों को आपके मॉडल्स की समीक्षा करने और आपके शोध को दोहराने देना सफल इम्प्लीमेंटेशन की आवश्यक शर्त है। एक वर्चुअल इंस्टेंस पर कार्य वातावरण सेट करके, आप सुनिश्चित करते हैं कि आपका काम आसानी से साझा, पुन: उत्पादित और टीम के अन्य सदस्यों द्वारा जाँचा जा सके।
Google Compute Engine
हालाँकि वही अवधारणाएँ और तत्व (इंस्टेंस, इमेज और स्नैपशॉट) केंद्र में हैं, EC2 और GCE, एक्सेस और संसाधनों के संगठन दोनों में अलग हैं।
Google Cloud Platform (GCP) का एक मुख्य पहलू इसका प्रोजेक्ट-केंद्रित संगठन है। सभी बिलिंग, अनुमतियाँ, संसाधन और सेटिंग्स उपयोगकर्ता-परिभाषित प्रोजेक्ट के भीतर समूहित होती हैं जो मूल रूप से एक ग्लोबल नेमस्पेस की तरह कार्य करती है। यह न केवल आपके उपयोग किए गए संसाधनों (स्टोरेज, डेटाबेस, इंस्टेंस, ...) के आपस में जुड़े मैपिंग को सरल बनाता है, बल्कि रोल-आधारित परमिशन से लेकर वास्तविक ssh कुंजियों और सुरक्षा तक, एक्सेस मैनेजमेंट को भी सरल करता है। उपयोगकर्ता-मैत्रीता, एक्सेस और रोल मैनेजमेंट की दृष्टि से, खासकर जब कई सेवाओं का उपयोग हो, तो मुझे GCP पर काम करना AWS से आसान लगता है।
GCP डेटा साइंस के लिए कुछ विशेष रूप से प्रासंगिक सेवाएँ भी प्रदान करता है, जिनमें शामिल हैं:
BigQuery — एक डेटा वेयरहाउस समाधान जिसमें कई रोचक बिग डेटा डेटासेट्स हैं।
कम लर्निंग कर्व और डेटा-फ्रेंडली सेवाएँ GCP को आपके डेटा साइंटिस्ट टूलबॉक्स में अनिवार्य बनाती हैं।
इंस्टेंस लॉन्च करने और Python पैकेज इंस्टॉल करने से पहले, चलिए क्लाउड कंप्यूटिंग में प्रयुक्त कुछ सामान्य शब्दावली का संक्षेप में पुनरावलोकन करते हैं।
VMs, डिस्क, इमेज और स्नैपशॉट
वर्चुअल मशीन (VM), जिसे "इंस्टेंस" भी कहा जाता है, एक ऑन-डिमांड सर्वर है जिसे आप ज़रूरत पड़ने पर सक्रिय करते हैं। आधारभूत हार्डवेयर अन्य उपयोगकर्ताओं के साथ पारदर्शी रूप से साझा होता है और इस प्रकार आपके लिए पूरी तरह वर्चुअल हो जाता है। आप केवल उस इंस्टेंस के लिए एक वैश्विक भौगोलिक स्थान चुनते हैं, जो Google के किसी डेटा सेंटर में होस्ट होता है।
VM, पर्सिस्टेंट डिस्क के प्रकार और ऑपरेटिंग सिस्टम (OS) — जैसे Windows या Linux — से परिभाषित होती है, जिस पर यह बनी होती है। पर्सिस्टेंट डिस्क आपके लिए हार्डवेयर का वर्चुअल हिस्सा है।
एक इमेज पर्सिस्टेंट डिस्क और ऑपरेटिंग सिस्टम का भौतिक संयोजन है। VM इमेजेस का उपयोग अक्सर किसी विशेष कॉन्फ़िगरेशन को कई अन्य VMs पर साझा करने और लागू करने के लिए किया जाता है। पब्लिक इमेज वे हैं जो Google द्वारा विशिष्ट OS विकल्पों के साथ प्रदान की जाती हैं, जबकि प्राइवेट इमेज उपयोगकर्ताओं द्वारा अनुकूलित होती हैं।
स्नैपशॉट किसी दिए गए समय पर VM (डिस्क, सॉफ़्टवेयर, लाइब्रेरी, फाइलें) की सामग्री का प्रतिबिंब है और मुख्य रूप से त्वरित बैकअप के लिए उपयोग होता है। स्नैपशॉट और इमेज के बीच मुख्य अंतर यह है कि स्नैपशॉट्स पिछले स्नैपशॉट्स के सापेक्ष डिफ्स के रूप में संग्रहीत होते हैं, जबकि इमेजेस नहीं।
नई VM को परिभाषित और सक्रिय करने के लिए इमेज और स्नैपशॉट दोनों का उपयोग किया जा सकता है।
संक्षेप में, जब आप नया इंस्टेंस लॉन्च करते हैं, तो GCE आपकी VM से पर्सिस्टेंट डिस्क जोड़कर शुरू करता है। यह डिस्क स्पेस प्रदान करती है और इंस्टेंस को बूट होने के लिए आवश्यक रूट फाइलसिस्टम देती है। डिस्क, आपके द्वारा चुनी गई इमेज के साथ संबद्ध OS इंस्टॉल करती है। इमेज के स्नैपशॉट लेकर, आप त्वरित बैकअप बनाते हैं और मौजूदा VMs से डेटा कॉपी करके नई VMs शुरू कर सकते हैं।
आइए अब इन्हें व्यवहार में उतारें और अपनी पहली VM से शुरू करें!
GCP पर अपनी पहली VM के साथ शुरुआत
अकाउंट और प्रोजेक्ट बनाएँ
GCP पर अकाउंट खोलने के लिए, आपको एक मानक Google (Gmail) अकाउंट की आवश्यकता होती है। लेखन के समय, Google प्लेटफ़ॉर्म का 12 महीने / $300 का फ्री ट्रायल प्रदान करता है। हालाँकि इस ऑफ़र के साथ कुछ प्रतिबंध आते हैं (उदाहरण के लिए, बिटकॉइन माइनिंग नहीं), फिर भी यह इस वातावरण में काम शुरू करने के लिए पर्याप्त होना चाहिए।
फ्री ट्रायल के साथ अपना GCP अकाउंट बनाने के लिए, cloud.google.com पर जाएँ और try it free बटन पर क्लिक करें। आपसे अपने Google अकाउंट से लॉगिन करने और अपनी बिलिंग जानकारी जोड़ने के लिए कहा जाएगा। एक बार आपका अकाउंट बन जाने पर, आप वेब कंसोल तक http://console.cloud.google.com/ पर पहुँच सकते हैं।
आप पहले वेब कंसोल का उपयोग करके एक Debian-आधारित इंस्टेंस को परिभाषित और लॉन्च करेंगे और फिर अपने डेटा साइंस स्टैक के लिए आवश्यक सभी पैकेज इंस्टॉल करने हेतु वेब-आधारित शेल टर्मिनल पर स्विच करेंगे।
अपने प्रोजेक्ट का शीर्षक निर्दिष्ट करें और देखें कि Google कैसे ऑन-द-फ्लाई एक प्रोजेक्ट ID जनरेट करता है।
आवश्यकतानुसार प्रोजेक्ट ID संपादित करें और "Create" पर क्लिक करें।
प्रोजेक्ट ID पूरे GCP नेमिंग स्पेस में यूनिक होना चाहिए, जबकि प्रोजेक्ट टाइटल कुछ भी हो सकता है। मैं अपने प्रोजेक्ट का नाम datacamp-gcp रखता हूँ, जैसा कि नीचे दिखाया गया है:
डिफ़ॉल्ट रूप से, जब आप नया प्रोजेक्ट बनाते हैं, तो आपका Google अकाउंट उस प्रोजेक्ट का ओनर सेट होता है, जिसके पास प्रोजेक्ट के सभी संसाधनों और बिलिंग पर पूर्ण परमिशन और एक्सेस होती है।
IAM पेज के Roles सेक्शन में, आप अपने प्रोजेक्ट में विशिष्ट भूमिकाओं के साथ लोगों को जोड़ सकते हैं। इस ट्यूटोरियल के उद्देश्य से, आप उस हिस्से को छोड़ देंगे और खुद को प्रोजेक्ट का एकमात्र यूज़र और एडमिन रखेंगे।
ऊपर बाएँ मेनू में "Compute Engine" चुनें और "VM instances" पर क्लिक करें।
डायलॉग में, "Create" बटन पर क्लिक करें।
अब आप "Create an Instance" पेज पर हैं।
इंस्टेंस का नाम दें: आप कोई भी नाम चुन सकते हैं। मैं अपने इंस्टेंस का नाम starling रखता हूँ।
रीजन चुनें: thumb rule है कि अपने सबसे नज़दीकी और सस्ते रीजन का चयन करें ताकि लेटेंसी कम हो। मैं east-d चुनता हूँ। ध्यान दें कि कीमतें रीजन के अनुसार काफ़ी अलग हो सकती हैं।
आवश्यक मेमोरी, स्टोरेज और CPU चुनें। आप कई प्रीसेट्स में से एक का उपयोग कर सकते हैं या अपना इंस्टेंस कस्टमाइज़ कर सकते हैं। यहाँ, मैं डिफ़ॉल्ट सेटअप n1-standard-1 चुनता हूँ जिसमें 3.75 Gb RAM और 1vCPU है, अनुमानित कीमत $24.67 प्रति माह।
बूट डिस्क चुनें और 10 Gb के साथ डिफ़ॉल्ट Debian GNU/Linux 9 (stretch) OS पर जाएँ। यदि आप Ubuntu या किसी अन्य Linux डिस्ट्रीब्यूशन का उपयोग करना पसंद करते हैं, तो "Change" बटन पर क्लिक करें और उपयुक्त चयन करें। चूँकि Ubuntu, Debian का निकट संबंधी है, इसलिए इस ट्यूटोरियल के लिए दोनों डिस्ट्रीब्यूशन काम करेंगी।
5.यह सुनिश्चित करें कि आप http और https ट्रैफ़िक की अनुमति देकर इंटरनेट से VM तक पहुँच सकते हैं।
6.(वैकल्पिक) बैकअप उद्देश्यों के लिए एक पर्सिस्टेंट डिस्क सक्षम करें: "Management, Disks, networking, SSH keys" लिंक पर क्लिक करें। इससे टैब्स का एक सेट प्रदर्शित होगा, "Disks" टैब चुनें और "Deletion Rule" को अनचेक करें। इस तरह, जब आप अपना इंस्टेंस डिलीट करेंगे, तो डिस्क डिलीट नहीं होगी और बाद में नए इंस्टेंस को स्पिन-अप करने के लिए उपयोग की जा सकेगी।
7.अंत में, "Create" पर क्लिक करें। आपका इंस्टेंस कुछ ही मिनटों में तैयार हो जाएगा।
Create बटन के नीचे "Equivalent command line" लिंक पर ध्यान दें। यह लिंक, वही इंस्टेंस स्क्रैच से बनाने के लिए आवश्यक समकक्ष कमांड लाइन दिखाता है। यह gcloud SDK की सिंटैक्स सीखने में सहायक एक वाकई स्मार्ट फीचर है।
इस बिंदु पर, आपके पास एक चल रहा इंस्टेंस है जो काफ़ी हद तक खाली है। इंस्टेंस तक पहुँचने के 2 तरीके हैं। या तो आप अपनी लोकल मशीन पर gcloud SDK इंस्टॉल करें या Google का Cloud Shell उपयोग करें।
Google का Cloud Shell
Google का Cloud Shell आपके ब्राउज़र में एक स्टैंडअलोन टर्मिनल है, जिससे आप अपने संसाधनों तक पहुँच और उनका प्रबंधन कर सकते हैं। आप कंसोल पेज के ऊपरी दाएँ भाग में >\_ आइकन पर क्लिक करके Google Shell सक्रिय करते हैं। आपके ब्राउज़र का निचला भाग एक शेल टर्मिनल बन जाता है।
यह टर्मिनल Debian ऑपरेटिंग सिस्टम और 5Gb स्टोरेज के साथ f1-micro Google Compute Engine वर्चुअल मशीन पर चलता है। यह प्रति-यूज़र, प्रति-सेशन के आधार पर बनाया जाता है। यह तब तक बना रहता है जब तक आपका क्लाउड शेल सेशन सक्रिय है और 20 मिनट की निष्क्रियता के बाद हटा दिया जाता है। चूँकि संबद्ध डिस्क सेशन्स के बीच पर्सिस्टेंट रहती है, आपका कंटेंट (फाइलें, कॉन्फ़िगरेशन, ...) सेशन दर सेशन उपलब्ध रहेगा। क्लाउड शेल इंस्टेंस में gcloud SDK और vim प्री-इंस्टॉल आते हैं।
यूज़र-आधारित Cloud shell इंस्टेंस और आपने जो इंस्टेंस अभी बनाया है, उनके बीच फर्क करना महत्वपूर्ण है। क्लाउड शेल के अंतर्गत आने वाला इंस्टेंस सिर्फ़ एक सुविधाजनक तरीका है जिससे आपके पास रिसोर्स मैनेजमेंट वातावरण हो और एक क्षणिक इंस्टेंस पर अपनी कॉन्फ़िगरेशन संग्रहीत कर सकें। ऊपर दिए गए उदाहरण में starling नामक जो VM इंस्टेंस आपने बनाया है, वही वह इंस्टेंस है जहाँ आप अपना डेटा साइंस वातावरण इंस्टॉल करना चाहते हैं।
Google Cloud shell का उपयोग करने के बजाय, आप अपनी लोकल मशीन पर भी gcloud SDK इंस्टॉल कर सकते हैं और सबकुछ अपने लोकल वातावरण से मैनेज कर सकते हैं।
अपने इंस्टेंस मैनेज करने के लिए कुछ उपयोगी कमांड्स यहाँ हैं।
अपने इंस्टेंस की सूची लें
gcloud compute instances list
इंस्टेंस रोकें (कुछ सेकंड लगते हैं)
gcloud compute instances stop <instance name>
इंस्टेंस शुरू करें (इसमें भी कुछ सेकंड लगते हैं)
gcloud compute instances start <instance name>
और starling इंस्टेंस में ssh करें
gcloud compute ssh <instance name>
VM सेट करना
अपने इंस्टेंस में लॉगिन करने के लिए अपने Google Shell विंडो में आख़िरी कमांड चलाएँ। अगले चरणों में आप यह करेंगे:
apt-get install के साथ कुछ Debian पैकेज इंस्टॉल करना।
Anaconda या Miniconda डिस्ट्रीब्यूशन इंस्टॉल करना।
Jupyter नोटबुक्स को सुरक्षित रूप से ऑनलाइन एक्सेसिबल बनाने के लिए इंस्टेंस सेट करना।
Debian पैकेज
आइए Debian पैकेज इंस्टॉल करने से शुरू करें:
bzip2, जो Mini/Anaconda इंस्टॉल करने के लिए आवश्यक है,
git, जो रखना हमेशा उपयोगी है, और
libxml2-dev, जो फिलहाल आवश्यक नहीं है लेकिन आगे और Python लाइब्रेरी इंस्टॉल करते समय अक्सर काम आएगा।
टर्मिनल में निम्न कमांड्स चलाएँ, जो Ubuntu और Debian दोनों पर काम करती हैं:
उपरोक्त पैकेज इंस्टॉल होने के बाद, Python 3 के लिए Anaconda डिस्ट्रीब्यूशन इंस्टॉल करने पर ध्यान दें। आपके पास विकल्प है कि या तो पूरा Anaconda वर्ज़न इंस्टॉल करें जिसमें कई वैज्ञानिक Python लाइब्रेरी शामिल हैं, जिनमें से कुछ की आपको वास्तव में ज़रूरत न हो, या हल्का Miniconda वर्ज़न इंस्टॉल करें जिसमें आपको Jupyter लाइब्रेरीज़ मैन्युअली इंस्टॉल करनी होंगी। दोनों ही मामलों में प्रक्रिया काफ़ी समान है।
पहली 2 लाइनों से इंस्टॉल शेल स्क्रिप्ट डाउनलोड और रन होती है। आपको लाइसेंस और डिफ़ॉल्ट लोकेशन स्वीकार करनी चाहिए। लाइन 3 में, अब आवश्यक न रहने वाली शेल फ़ाइल हटा दी जाती है। लाइन 4 पर .bashrc को सोर्स करने से, बिना नया टर्मिनल खोले, conda कमांड आपके $PATH में जुड़ जाती है। और अंत में, आख़िरी लाइन आवश्यक python लाइब्रेरीज़ इंस्टॉल करती है: scikit-learn pandas jupyter ipython।
पूरी Anaconda डिस्ट्रीब्यूशन इंस्टॉल करने के कमांड्स बहुत समान हैं। शेल स्क्रिप्ट फ़ाइल का नवीनतम वर्ज़न पाने के लिए डाउनलोड पेज ज़रूर देखें:
यह सत्यापित करने के लिए कि सबकुछ ठीक से इंस्टॉल हुआ है, python --version से अपना python वर्ज़न जाँचें और which python कमांड से यह सत्यापित करें कि डिफ़ॉल्ट रूप से सही python कॉल हो रहा है। आपको कुछ इस तरह का आउटपुट मिलना चाहिए
अब आपके पास मानक डेटा साइंस लाइब्रेरीज़ (sklearn, pandas) के साथ एक कार्यशील Python वातावरण है।
वेब एक्सेस की अनुमति देना
तीसरा और अंतिम चरण आपके VM को आपके Jupyter नोटबुक्स के लिए वेब एक्सेस की अनुमति देने हेतु कॉन्फ़िगर करना है।
आपको पहले VM को वेब से एक्सेस करने योग्य बनाना होगा। इसके लिए आप Google Cloud कंसोल के माध्यम से एक फ़ायरवॉल नियम बनाएँगे। अपने Instances डैशबोर्ड पर वापस जाएँ और ऊपर बाएँ मेनू में "VPC Network > Firewall rules" चुनें। "CREATE FIREWAL RULE" लिंक पर क्लिक करें और निम्न मान भरें:
Name: jupyter-rule (आप कोई भी नाम चुन सकते हैं)
Source IP ranges: 0.0.0.0/0
Specified protocols and ports: tcp:8888
और बाकी सभी वेरिएबल्स को उनके डिफ़ॉल्ट मानों पर छोड़ दें।
फ़ॉर्म इस तरह दिखना चाहिए:
यह फ़ायरवॉल नियम सभी इनकमिंग ट्रैफ़िक (सभी IPs से) को पोर्ट 8888 पर आने देता है।
"Equivalent command line" लिंक का उपयोग करके, आप देख सकते हैं कि यह फ़ायरवॉल नियम टर्मिनल से निम्न कमांड लाइन के साथ भी बनाया जा सकता है:
अब VM पेज पर वापस जाएँ (ऊपर बाएँ मेनू > Compute Engine > VM instances), अपने VM नाम पर क्लिक करें।
अपने VM IP पते का नोट बना लें। यही वह IP पता है जिसका उपयोग आप अपने ब्राउज़र में अपने Jupyter वातावरण तक पहुँचने के लिए करेंगे। मेरे उदाहरण में, IP पता है: 35.196.81.49, आपका अलग होगा।
और सुनिश्चित करें कि फ़ायरवॉल नियम चेक किए गए हैं:
Jupyter कॉन्फ़िगरेशन
Jupyter नोटबुक्स के साथ एक कॉन्फ़िगरेशन फ़ाइल आती है, जिसे ऑनलाइन एक्सेस सेटअप करने के लिए जनरेट और संपादित करने की आवश्यकता होती है। टर्मिनल में jupyter notebook --generate-config चलाकर कॉन्फ़िगरेशन फ़ाइल जनरेट करें। और jupyter notebook password चलाकर एक पासवर्ड बनाएँ।
टिप: सुनिश्चित करें कि यह पासवर्ड मज़बूत हो!
अब अभी-अभी बनाई गई कॉन्फ़िगरेशन फ़ाइल को vim .jupyter/jupyter_notebook_config.py से संपादित करें और फ़ाइल के शीर्ष पर निम्न पंक्ति जोड़ें
c.NotebookApp.ip = '*'
(vim में एडिट मोड में स्विच करने के लिए, बस i कैरेक्टर टाइप करें)। निम्न अनुक्रम ESC:wq के साथ सेव करके बाहर निकलें।
यह नोटबुक को आपके VM पर सभी IP पतों के लिए उपलब्ध होने देगा और केवल उस http://localhost:8888 URL तक सीमित नहीं रखेगा जिससे आप अपनी लोकल मशीन पर काम करते समय परिचित हो सकते हैं।
लॉन्च
अब आप निम्न कमांड लाइन के साथ अपना Jupyter नोटबुक लॉन्च करने के लिए तैयार हैं:
$ jupyter-notebook --no-browser --port=8888
और आपको टर्मिनल में कुछ इस तरह दिखाई देना चाहिए:
अपने ब्राउज़र में URL पर जाएँ: http://<your_VM_IP>:8888/ ताकि आप अपने नए ऑपरेशनल Jupyter नोटबुक तक पहुँच सकें।
यह जाँचने के लिए कि सबकुछ अपेक्षित रूप से काम कर रहा है, नया Python 3 नोटबुक बनाएँ, और import pandas करें
Intermezzo
आपकी वर्तमान सेटअप पर कुछ नोट्स:
आपने अपने ब्राउज़र में जिस IP पते का उपयोग किया, वह क्षणिक (ephemeral) है। अर्थात, हर बार जब आप अपनी VM को रीस्टार्ट करेंगे, तो आपके नोटबुक्स का URL अलग होगा। आप उस IP को स्टैटिक बना सकते हैं: ऊपर बाएँ मेनू > VPC Network > External IP addresses पर जाएँ और ड्रॉपडाउन मेनू में "static" चुनें
आपकी वर्तमान सेटअप की सुरक्षा, आपके द्वारा पहले परिभाषित किए गए Jupyter नोटबुक पासवर्ड की मज़बूती पर निर्भर करती है। इंटरनेट पर कोई भी वही URL उपयोग करके आपके Jupyter वातावरण तक पहुँच सकता है (और बॉट्स निश्चित रूप से कोशिश करेंगे)। Jupyter नोटबुक्स की एक शक्तिशाली लेकिन बहुत असुरक्षित मुख्य सुविधा यह है कि आप नोटबुक से सीधे sudo एक्सेस के साथ एक टर्मिनल लॉन्च कर सकते हैं। इसका अर्थ है कि कोई भी जो आपके नोटबुक तक पहुँचता है, वह आपका नोटबुक पासवर्ड क्रैक करने के बाद आपकी VM का नियंत्रण ले सकता है और संभावित रूप से कुछ भी चला सकता है जो आपके बिल को बहुत बढ़ा दे। इसे रोकने के लिए पहले स्तर के उपायों में शामिल हैं
सुनिश्चित करें कि आपका Jupyter पासवर्ड मज़बूत हो
याद रखें कि जब आप उस पर काम नहीं कर रहे हों, तो अपनी VM को रोक दें
आप वर्तमान में सर्वर को http पर चला रहे हैं, https पर नहीं, जो पर्याप्त सुरक्षित नहीं है। Let’s Encrypt मुफ्त SSL/TLS सर्टिफिकेट प्रदान करता है और jupyter दस्तावेज़ में अनुशंसित एन्क्रिप्शन समाधान है। पब्लिक Jupyter नोटबुक चलाने से संबंधित सुरक्षा मुद्दों पर अधिक जानकारी के लिए, यह पढ़ें।
IPython
Jupyter नोटबुक्स ऑनलाइन सहयोगात्मक काम के लिए बहुत सुविधाजनक हैं। लेकिन आप अपने टर्मिनल से केवल ipython कमांड के साथ एक IPython सेशन भी चला सकते हैं। यह एक IPython सेशन खोलेगा जिसमें Jupyter नोटबुक की सभी सुविधाएँ होती हैं, जैसे मैजिक कमांड्स (%paste, %run, ...), लेकिन वेब इंटरफ़ेस के बिना।
R
अपने Jupyter कंसोल में R नोटबुक्स सक्षम करने के लिए अपनी VM सेट करना आसान है। R Markdown सक्षम करने के निर्देश इस शानदार DataCamp ट्यूटोरियल में उपलब्ध हैं: Karlijn Willems द्वारा Jupyter And R Markdown: Notebooks With R।
निष्कर्ष
Google Cloud, डेटा साइंस के लिए कई रोचक सेवाएँ और शक्तिशाली, फिर भी आसानी से सेटअप होने वाले VM इंस्टेंस, साथ ही एक अत्यंत आकर्षक फ्री ट्रायल ऑफ़र प्रदान करता है। वेब कंसोल नेविगेट करने में आसान है और अक्सर वर्तमान कॉन्फ़िगरेशन पेजों का कमांड लाइन समकक्ष दिखाता है, जिससे gcloud SDK का उपयोग करने की बाधा कम होती है।
इस लेख में, आपने सीखा कि VM इंस्टेंस कैसे चुनना और लॉन्च करना है, आवश्यक Debian पैकेज, Anaconda डिस्ट्रीब्यूशन और डेटा साइंस स्टैक कैसे इंस्टॉल करना है, और अंत में अपने ब्राउज़र से एक्सेस योग्य Jupyter नोटबुक लॉन्च करने के लिए एक्सेस नियम कैसे सेट करना है।
हालाँकि पहली बार में पूरा प्रोसेस थोड़ा जटिल लग सकता है, लेकिन जैसे-जैसे आप अधिक VMs बनाएँगे और लॉन्च करेंगे, यह जल्दी ही परिचित हो जाएगा। और यदि चीज़ें कुछ अधिक उलझ जाएँ, तो आप हमेशा जिस VM पर काम कर रहे हैं उसे डिलीट कर सकते हैं और स्क्रैच से फिर से शुरू कर सकते हैं। यही क्लाउड में काम करने के फ़ायदों में से एक है। कुछ बार के बाद आप Google Cloud पर कुछ ही मिनटों में पूर्ण डेटा साइंस वातावरण स्पिन-अप करने में सक्षम होंगे। बेझिझक मुझसे ट्विटर पर अपने कमेंट्स और सवाल साझा करें: @alexip।


जहाँ AWS EC2 क्लाउड कंप्यूटिंग में अग्रणी है, वहीं Google Cloud ने एक बेहद प्रभावशाली और प्रतिस्पर्धी क्लाउड कंप्यूटिंग प्लेटफ़ॉर्म विकसित किया है।
इस ट्यूटोरियल में, आप सीखेंगे कि कैसे:
क्लाउड में काम करने के, अपनी मशीन पर काम करने की तुलना में, डेटा साइंस प्रोजेक्ट्स के लिए दो मुख्य फायदे हैं:
Google Compute Engine
हालाँकि वही अवधारणाएँ और तत्व (इंस्टेंस, इमेज और स्नैपशॉट) केंद्र में हैं, EC2 और GCE, एक्सेस और संसाधनों के संगठन दोनों में अलग हैं।
Google Cloud Platform (GCP) का एक मुख्य पहलू इसका प्रोजेक्ट-केंद्रित संगठन है। सभी बिलिंग, अनुमतियाँ, संसाधन और सेटिंग्स उपयोगकर्ता-परिभाषित प्रोजेक्ट के भीतर समूहित होती हैं जो मूल रूप से एक ग्लोबल नेमस्पेस की तरह कार्य करती है। यह न केवल आपके उपयोग किए गए संसाधनों (स्टोरेज, डेटाबेस, इंस्टेंस, ...) के आपस में जुड़े मैपिंग को सरल बनाता है, बल्कि रोल-आधारित परमिशन से लेकर वास्तविक ssh कुंजियों और सुरक्षा तक, एक्सेस मैनेजमेंट को भी सरल करता है। उपयोगकर्ता-मैत्रीता, एक्सेस और रोल मैनेजमेंट की दृष्टि से, खासकर जब कई सेवाओं का उपयोग हो, तो मुझे GCP पर काम करना AWS से आसान लगता है।
GCP डेटा साइंस के लिए कुछ विशेष रूप से प्रासंगिक सेवाएँ भी प्रदान करता है, जिनमें शामिल हैं:
कम लर्निंग कर्व और डेटा-फ्रेंडली सेवाएँ GCP को आपके डेटा साइंटिस्ट टूलबॉक्स में अनिवार्य बनाती हैं।
इंस्टेंस लॉन्च करने और Python पैकेज इंस्टॉल करने से पहले, चलिए क्लाउड कंप्यूटिंग में प्रयुक्त कुछ सामान्य शब्दावली का संक्षेप में पुनरावलोकन करते हैं।
VMs, डिस्क, इमेज और स्नैपशॉट
वर्चुअल मशीन (VM), जिसे "इंस्टेंस" भी कहा जाता है, एक ऑन-डिमांड सर्वर है जिसे आप ज़रूरत पड़ने पर सक्रिय करते हैं। आधारभूत हार्डवेयर अन्य उपयोगकर्ताओं के साथ पारदर्शी रूप से साझा होता है और इस प्रकार आपके लिए पूरी तरह वर्चुअल हो जाता है। आप केवल उस इंस्टेंस के लिए एक वैश्विक भौगोलिक स्थान चुनते हैं, जो Google के किसी डेटा सेंटर में होस्ट होता है।
VM, पर्सिस्टेंट डिस्क के प्रकार और ऑपरेटिंग सिस्टम (OS) — जैसे Windows या Linux — से परिभाषित होती है, जिस पर यह बनी होती है। पर्सिस्टेंट डिस्क आपके लिए हार्डवेयर का वर्चुअल हिस्सा है।
एक इमेज पर्सिस्टेंट डिस्क और ऑपरेटिंग सिस्टम का भौतिक संयोजन है। VM इमेजेस का उपयोग अक्सर किसी विशेष कॉन्फ़िगरेशन को कई अन्य VMs पर साझा करने और लागू करने के लिए किया जाता है। पब्लिक इमेज वे हैं जो Google द्वारा विशिष्ट OS विकल्पों के साथ प्रदान की जाती हैं, जबकि प्राइवेट इमेज उपयोगकर्ताओं द्वारा अनुकूलित होती हैं।
स्नैपशॉट किसी दिए गए समय पर VM (डिस्क, सॉफ़्टवेयर, लाइब्रेरी, फाइलें) की सामग्री का प्रतिबिंब है और मुख्य रूप से त्वरित बैकअप के लिए उपयोग होता है। स्नैपशॉट और इमेज के बीच मुख्य अंतर यह है कि स्नैपशॉट्स पिछले स्नैपशॉट्स के सापेक्ष डिफ्स के रूप में संग्रहीत होते हैं, जबकि इमेजेस नहीं।
नई VM को परिभाषित और सक्रिय करने के लिए इमेज और स्नैपशॉट दोनों का उपयोग किया जा सकता है।
संक्षेप में, जब आप नया इंस्टेंस लॉन्च करते हैं, तो GCE आपकी VM से पर्सिस्टेंट डिस्क जोड़कर शुरू करता है। यह डिस्क स्पेस प्रदान करती है और इंस्टेंस को बूट होने के लिए आवश्यक रूट फाइलसिस्टम देती है। डिस्क, आपके द्वारा चुनी गई इमेज के साथ संबद्ध OS इंस्टॉल करती है। इमेज के स्नैपशॉट लेकर, आप त्वरित बैकअप बनाते हैं और मौजूदा VMs से डेटा कॉपी करके नई VMs शुरू कर सकते हैं।
आइए अब इन्हें व्यवहार में उतारें और अपनी पहली VM से शुरू करें!
GCP पर अपनी पहली VM के साथ शुरुआत
अकाउंट और प्रोजेक्ट बनाएँ
GCP पर अकाउंट खोलने के लिए, आपको एक मानक Google (Gmail) अकाउंट की आवश्यकता होती है। लेखन के समय, Google प्लेटफ़ॉर्म का 12 महीने / $300 का फ्री ट्रायल प्रदान करता है। हालाँकि इस ऑफ़र के साथ कुछ प्रतिबंध आते हैं (उदाहरण के लिए, बिटकॉइन माइनिंग नहीं), फिर भी यह इस वातावरण में काम शुरू करने के लिए पर्याप्त होना चाहिए।
फ्री ट्रायल के साथ अपना GCP अकाउंट बनाने के लिए, cloud.google.com पर जाएँ और
try it freeबटन पर क्लिक करें। आपसे अपने Google अकाउंट से लॉगिन करने और अपनी बिलिंग जानकारी जोड़ने के लिए कहा जाएगा। एक बार आपका अकाउंट बन जाने पर, आप वेब कंसोल तक http://console.cloud.google.com/ पर पहुँच सकते हैं।आप पहले वेब कंसोल का उपयोग करके एक Debian-आधारित इंस्टेंस को परिभाषित और लॉन्च करेंगे और फिर अपने डेटा साइंस स्टैक के लिए आवश्यक सभी पैकेज इंस्टॉल करने हेतु वेब-आधारित शेल टर्मिनल पर स्विच करेंगे।
लेकिन पहले आपको एक नया प्रोजेक्ट बनाना होगा:
प्रोजेक्ट ID पूरे GCP नेमिंग स्पेस में यूनिक होना चाहिए, जबकि प्रोजेक्ट टाइटल कुछ भी हो सकता है। मैं अपने प्रोजेक्ट का नाम
datacamp-gcpरखता हूँ, जैसा कि नीचे दिखाया गया है:डिफ़ॉल्ट रूप से, जब आप नया प्रोजेक्ट बनाते हैं, तो आपका Google अकाउंट उस प्रोजेक्ट का ओनर सेट होता है, जिसके पास प्रोजेक्ट के सभी संसाधनों और बिलिंग पर पूर्ण परमिशन और एक्सेस होती है।
IAM पेज के Roles सेक्शन में, आप अपने प्रोजेक्ट में विशिष्ट भूमिकाओं के साथ लोगों को जोड़ सकते हैं। इस ट्यूटोरियल के उद्देश्य से, आप उस हिस्से को छोड़ देंगे और खुद को प्रोजेक्ट का एकमात्र यूज़र और एडमिन रखेंगे।
इंस्टेंस बनाएँ
अपनी पहली VM बनाने के लिए, निम्न चरणों से गुजरें:
अब आप "Create an Instance" पेज पर हैं।
इंस्टेंस का नाम दें: आप कोई भी नाम चुन सकते हैं। मैं अपने इंस्टेंस का नाम
starlingरखता हूँ।रीजन चुनें: thumb rule है कि अपने सबसे नज़दीकी और सस्ते रीजन का चयन करें ताकि लेटेंसी कम हो। मैं
east-dचुनता हूँ। ध्यान दें कि कीमतें रीजन के अनुसार काफ़ी अलग हो सकती हैं।आवश्यक मेमोरी, स्टोरेज और CPU चुनें। आप कई प्रीसेट्स में से एक का उपयोग कर सकते हैं या अपना इंस्टेंस कस्टमाइज़ कर सकते हैं। यहाँ, मैं डिफ़ॉल्ट सेटअप
n1-standard-1चुनता हूँ जिसमें 3.75 Gb RAM और 1vCPU है, अनुमानित कीमत $24.67 प्रति माह।बूट डिस्क चुनें और 10 Gb के साथ डिफ़ॉल्ट Debian GNU/Linux 9 (stretch) OS पर जाएँ। यदि आप Ubuntu या किसी अन्य Linux डिस्ट्रीब्यूशन का उपयोग करना पसंद करते हैं, तो "Change" बटन पर क्लिक करें और उपयुक्त चयन करें। चूँकि Ubuntu, Debian का निकट संबंधी है, इसलिए इस ट्यूटोरियल के लिए दोनों डिस्ट्रीब्यूशन काम करेंगी।
5.यह सुनिश्चित करें कि आप http और https ट्रैफ़िक की अनुमति देकर इंटरनेट से VM तक पहुँच सकते हैं।
6.(वैकल्पिक) बैकअप उद्देश्यों के लिए एक पर्सिस्टेंट डिस्क सक्षम करें: "Management, Disks, networking, SSH keys" लिंक पर क्लिक करें। इससे टैब्स का एक सेट प्रदर्शित होगा, "Disks" टैब चुनें और "Deletion Rule" को अनचेक करें। इस तरह, जब आप अपना इंस्टेंस डिलीट करेंगे, तो डिस्क डिलीट नहीं होगी और बाद में नए इंस्टेंस को स्पिन-अप करने के लिए उपयोग की जा सकेगी।
7.अंत में, "Create" पर क्लिक करें। आपका इंस्टेंस कुछ ही मिनटों में तैयार हो जाएगा।
Createबटन के नीचे "Equivalent command line" लिंक पर ध्यान दें। यह लिंक, वही इंस्टेंस स्क्रैच से बनाने के लिए आवश्यक समकक्ष कमांड लाइन दिखाता है। यह gcloud SDK की सिंटैक्स सीखने में सहायक एक वाकई स्मार्ट फीचर है।इस बिंदु पर, आपके पास एक चल रहा इंस्टेंस है जो काफ़ी हद तक खाली है। इंस्टेंस तक पहुँचने के 2 तरीके हैं। या तो आप अपनी लोकल मशीन पर gcloud SDK इंस्टॉल करें या Google का Cloud Shell उपयोग करें।
Google का Cloud Shell
Google का Cloud Shell आपके ब्राउज़र में एक स्टैंडअलोन टर्मिनल है, जिससे आप अपने संसाधनों तक पहुँच और उनका प्रबंधन कर सकते हैं। आप कंसोल पेज के ऊपरी दाएँ भाग में
>\_आइकन पर क्लिक करके Google Shell सक्रिय करते हैं। आपके ब्राउज़र का निचला भाग एक शेल टर्मिनल बन जाता है।यह टर्मिनल Debian ऑपरेटिंग सिस्टम और 5Gb स्टोरेज के साथ f1-micro Google Compute Engine वर्चुअल मशीन पर चलता है। यह प्रति-यूज़र, प्रति-सेशन के आधार पर बनाया जाता है। यह तब तक बना रहता है जब तक आपका क्लाउड शेल सेशन सक्रिय है और 20 मिनट की निष्क्रियता के बाद हटा दिया जाता है। चूँकि संबद्ध डिस्क सेशन्स के बीच पर्सिस्टेंट रहती है, आपका कंटेंट (फाइलें, कॉन्फ़िगरेशन, ...) सेशन दर सेशन उपलब्ध रहेगा। क्लाउड शेल इंस्टेंस में gcloud SDK और vim प्री-इंस्टॉल आते हैं।
यूज़र-आधारित Cloud shell इंस्टेंस और आपने जो इंस्टेंस अभी बनाया है, उनके बीच फर्क करना महत्वपूर्ण है। क्लाउड शेल के अंतर्गत आने वाला इंस्टेंस सिर्फ़ एक सुविधाजनक तरीका है जिससे आपके पास रिसोर्स मैनेजमेंट वातावरण हो और एक क्षणिक इंस्टेंस पर अपनी कॉन्फ़िगरेशन संग्रहीत कर सकें। ऊपर दिए गए उदाहरण में
starlingनामक जो VM इंस्टेंस आपने बनाया है, वही वह इंस्टेंस है जहाँ आप अपना डेटा साइंस वातावरण इंस्टॉल करना चाहते हैं।Google Cloud shell का उपयोग करने के बजाय, आप अपनी लोकल मशीन पर भी gcloud SDK इंस्टॉल कर सकते हैं और सबकुछ अपने लोकल वातावरण से मैनेज कर सकते हैं।
अपने इंस्टेंस मैनेज करने के लिए कुछ उपयोगी कमांड्स यहाँ हैं।
अपने इंस्टेंस की सूची लें
gcloud compute instances listइंस्टेंस रोकें (कुछ सेकंड लगते हैं)
gcloud compute instances stop <instance name>इंस्टेंस शुरू करें (इसमें भी कुछ सेकंड लगते हैं)
gcloud compute instances start <instance name>और starling इंस्टेंस में ssh करें
gcloud compute ssh <instance name>VM सेट करना
अपने इंस्टेंस में लॉगिन करने के लिए अपने Google Shell विंडो में आख़िरी कमांड चलाएँ। अगले चरणों में आप यह करेंगे:
apt-get installके साथ कुछ Debian पैकेज इंस्टॉल करना।Debian पैकेज
आइए Debian पैकेज इंस्टॉल करने से शुरू करें:
टर्मिनल में निम्न कमांड्स चलाएँ, जो Ubuntu और Debian दोनों पर काम करती हैं:
Anaconda / Miniconda
उपरोक्त पैकेज इंस्टॉल होने के बाद, Python 3 के लिए Anaconda डिस्ट्रीब्यूशन इंस्टॉल करने पर ध्यान दें। आपके पास विकल्प है कि या तो पूरा Anaconda वर्ज़न इंस्टॉल करें जिसमें कई वैज्ञानिक Python लाइब्रेरी शामिल हैं, जिनमें से कुछ की आपको वास्तव में ज़रूरत न हो, या हल्का Miniconda वर्ज़न इंस्टॉल करें जिसमें आपको Jupyter लाइब्रेरीज़ मैन्युअली इंस्टॉल करनी होंगी। दोनों ही मामलों में प्रक्रिया काफ़ी समान है।
हल्का Miniconda डिस्ट्रीब्यूशन इंस्टॉल करने के लिए, चलाएँ
पहली 2 लाइनों से इंस्टॉल शेल स्क्रिप्ट डाउनलोड और रन होती है। आपको लाइसेंस और डिफ़ॉल्ट लोकेशन स्वीकार करनी चाहिए। लाइन 3 में, अब आवश्यक न रहने वाली शेल फ़ाइल हटा दी जाती है। लाइन 4 पर
.bashrcको सोर्स करने से, बिना नया टर्मिनल खोले,condaकमांड आपके$PATHमें जुड़ जाती है। और अंत में, आख़िरी लाइन आवश्यक python लाइब्रेरीज़ इंस्टॉल करती है:scikit-learn pandas jupyter ipython।पूरी Anaconda डिस्ट्रीब्यूशन इंस्टॉल करने के कमांड्स बहुत समान हैं। शेल स्क्रिप्ट फ़ाइल का नवीनतम वर्ज़न पाने के लिए डाउनलोड पेज ज़रूर देखें:
यह सत्यापित करने के लिए कि सबकुछ ठीक से इंस्टॉल हुआ है,
python --versionसे अपना python वर्ज़न जाँचें औरwhich pythonकमांड से यह सत्यापित करें कि डिफ़ॉल्ट रूप से सही python कॉल हो रहा है। आपको कुछ इस तरह का आउटपुट मिलना चाहिएअब आपके पास मानक डेटा साइंस लाइब्रेरीज़ (
sklearn,pandas) के साथ एक कार्यशील Python वातावरण है।वेब एक्सेस की अनुमति देना
तीसरा और अंतिम चरण आपके VM को आपके Jupyter नोटबुक्स के लिए वेब एक्सेस की अनुमति देने हेतु कॉन्फ़िगर करना है।
आपको पहले VM को वेब से एक्सेस करने योग्य बनाना होगा। इसके लिए आप Google Cloud कंसोल के माध्यम से एक फ़ायरवॉल नियम बनाएँगे। अपने Instances डैशबोर्ड पर वापस जाएँ और ऊपर बाएँ मेनू में "VPC Network > Firewall rules" चुनें। "CREATE FIREWAL RULE" लिंक पर क्लिक करें और निम्न मान भरें:
फ़ॉर्म इस तरह दिखना चाहिए:
यह फ़ायरवॉल नियम सभी इनकमिंग ट्रैफ़िक (सभी IPs से) को पोर्ट 8888 पर आने देता है।
"Equivalent command line" लिंक का उपयोग करके, आप देख सकते हैं कि यह फ़ायरवॉल नियम टर्मिनल से निम्न कमांड लाइन के साथ भी बनाया जा सकता है:
$ gcloud compute --project=datacamp-gcp firewall-rules create jupyter-rule --direction=INGRESS --priority=1000 --network=default --action=ALLOW --rules=tcp:8888 --source-ranges=0.0.0.0/0अब VM पेज पर वापस जाएँ (ऊपर बाएँ मेनू > Compute Engine > VM instances), अपने VM नाम पर क्लिक करें।
अपने VM IP पते का नोट बना लें। यही वह IP पता है जिसका उपयोग आप अपने ब्राउज़र में अपने Jupyter वातावरण तक पहुँचने के लिए करेंगे। मेरे उदाहरण में, IP पता है:
35.196.81.49, आपका अलग होगा।और सुनिश्चित करें कि फ़ायरवॉल नियम चेक किए गए हैं:
Jupyter कॉन्फ़िगरेशन
Jupyter नोटबुक्स के साथ एक कॉन्फ़िगरेशन फ़ाइल आती है, जिसे ऑनलाइन एक्सेस सेटअप करने के लिए जनरेट और संपादित करने की आवश्यकता होती है। टर्मिनल में
jupyter notebook --generate-configचलाकर कॉन्फ़िगरेशन फ़ाइल जनरेट करें। औरjupyter notebook passwordचलाकर एक पासवर्ड बनाएँ।टिप: सुनिश्चित करें कि यह पासवर्ड मज़बूत हो!
अब अभी-अभी बनाई गई कॉन्फ़िगरेशन फ़ाइल को
vim .jupyter/jupyter_notebook_config.pyसे संपादित करें और फ़ाइल के शीर्ष पर निम्न पंक्ति जोड़ेंc.NotebookApp.ip = '*'(vim में एडिट मोड में स्विच करने के लिए, बस
iकैरेक्टर टाइप करें)। निम्न अनुक्रमESC:wqके साथ सेव करके बाहर निकलें।यह नोटबुक को आपके VM पर सभी IP पतों के लिए उपलब्ध होने देगा और केवल उस
http://localhost:8888URL तक सीमित नहीं रखेगा जिससे आप अपनी लोकल मशीन पर काम करते समय परिचित हो सकते हैं।लॉन्च
अब आप निम्न कमांड लाइन के साथ अपना Jupyter नोटबुक लॉन्च करने के लिए तैयार हैं:
$ jupyter-notebook --no-browser --port=8888और आपको टर्मिनल में कुछ इस तरह दिखाई देना चाहिए:
अपने ब्राउज़र में URL पर जाएँ:
http://<your_VM_IP>:8888/ताकि आप अपने नए ऑपरेशनल Jupyter नोटबुक तक पहुँच सकें।यह जाँचने के लिए कि सबकुछ अपेक्षित रूप से काम कर रहा है, नया Python 3 नोटबुक बनाएँ, और
import pandasकरेंIntermezzo
आपकी वर्तमान सेटअप पर कुछ नोट्स:
आपने अपने ब्राउज़र में जिस IP पते का उपयोग किया, वह क्षणिक (ephemeral) है। अर्थात, हर बार जब आप अपनी VM को रीस्टार्ट करेंगे, तो आपके नोटबुक्स का URL अलग होगा। आप उस IP को स्टैटिक बना सकते हैं: ऊपर बाएँ मेनू > VPC Network > External IP addresses पर जाएँ और ड्रॉपडाउन मेनू में "static" चुनें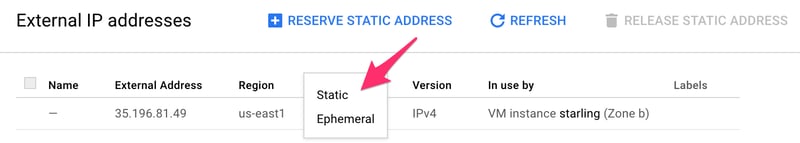
आपकी वर्तमान सेटअप की सुरक्षा, आपके द्वारा पहले परिभाषित किए गए Jupyter नोटबुक पासवर्ड की मज़बूती पर निर्भर करती है। इंटरनेट पर कोई भी वही URL उपयोग करके आपके Jupyter वातावरण तक पहुँच सकता है (और बॉट्स निश्चित रूप से कोशिश करेंगे)। Jupyter नोटबुक्स की एक शक्तिशाली लेकिन बहुत असुरक्षित मुख्य सुविधा यह है कि आप नोटबुक से सीधे sudo एक्सेस के साथ एक टर्मिनल लॉन्च कर सकते हैं। इसका अर्थ है कि कोई भी जो आपके नोटबुक तक पहुँचता है, वह आपका नोटबुक पासवर्ड क्रैक करने के बाद आपकी VM का नियंत्रण ले सकता है और संभावित रूप से कुछ भी चला सकता है जो आपके बिल को बहुत बढ़ा दे। इसे रोकने के लिए पहले स्तर के उपायों में शामिल हैं
सुनिश्चित करें कि आपका Jupyter पासवर्ड मज़बूत हो
आप वर्तमान में सर्वर को http पर चला रहे हैं, https पर नहीं, जो पर्याप्त सुरक्षित नहीं है। Let’s Encrypt मुफ्त SSL/TLS सर्टिफिकेट प्रदान करता है और jupyter दस्तावेज़ में अनुशंसित एन्क्रिप्शन समाधान है। पब्लिक Jupyter नोटबुक चलाने से संबंधित सुरक्षा मुद्दों पर अधिक जानकारी के लिए, यह पढ़ें।
IPython
Jupyter नोटबुक्स ऑनलाइन सहयोगात्मक काम के लिए बहुत सुविधाजनक हैं। लेकिन आप अपने टर्मिनल से केवल
ipythonकमांड के साथ एक IPython सेशन भी चला सकते हैं। यह एक IPython सेशन खोलेगा जिसमें Jupyter नोटबुक की सभी सुविधाएँ होती हैं, जैसे मैजिक कमांड्स (%paste, %run, ...), लेकिन वेब इंटरफ़ेस के बिना।R
अपने Jupyter कंसोल में R नोटबुक्स सक्षम करने के लिए अपनी VM सेट करना आसान है। R Markdown सक्षम करने के निर्देश इस शानदार DataCamp ट्यूटोरियल में उपलब्ध हैं: Karlijn Willems द्वारा Jupyter And R Markdown: Notebooks With R।
निष्कर्ष
Google Cloud, डेटा साइंस के लिए कई रोचक सेवाएँ और शक्तिशाली, फिर भी आसानी से सेटअप होने वाले VM इंस्टेंस, साथ ही एक अत्यंत आकर्षक फ्री ट्रायल ऑफ़र प्रदान करता है। वेब कंसोल नेविगेट करने में आसान है और अक्सर वर्तमान कॉन्फ़िगरेशन पेजों का कमांड लाइन समकक्ष दिखाता है, जिससे gcloud SDK का उपयोग करने की बाधा कम होती है।
इस लेख में, आपने सीखा कि VM इंस्टेंस कैसे चुनना और लॉन्च करना है, आवश्यक Debian पैकेज, Anaconda डिस्ट्रीब्यूशन और डेटा साइंस स्टैक कैसे इंस्टॉल करना है, और अंत में अपने ब्राउज़र से एक्सेस योग्य Jupyter नोटबुक लॉन्च करने के लिए एक्सेस नियम कैसे सेट करना है।
हालाँकि पहली बार में पूरा प्रोसेस थोड़ा जटिल लग सकता है, लेकिन जैसे-जैसे आप अधिक VMs बनाएँगे और लॉन्च करेंगे, यह जल्दी ही परिचित हो जाएगा। और यदि चीज़ें कुछ अधिक उलझ जाएँ, तो आप हमेशा जिस VM पर काम कर रहे हैं उसे डिलीट कर सकते हैं और स्क्रैच से फिर से शुरू कर सकते हैं। यही क्लाउड में काम करने के फ़ायदों में से एक है। कुछ बार के बाद आप Google Cloud पर कुछ ही मिनटों में पूर्ण डेटा साइंस वातावरण स्पिन-अप करने में सक्षम होंगे। बेझिझक मुझसे ट्विटर पर अपने कमेंट्स और सवाल साझा करें: @alexip।