

设置 Llama 3.3
开始之前,我们将流程拆分为几个步骤。首先,我们将介绍如何通过 Hugging Face 访问 Llama 3.3、设置账户并获取必要的权限。然后,我们将创建项目环境并安装所需的依赖。
在 Hugging Face 上访问 Llama 3.3
访问 Llama 3.3 的一种方式是使用 Hugging Face,这是最受欢迎的机器学习模型托管平台之一。要通过 Hugging Face 的 Inference API 使用 Llama 3.3,您需要:
- 一个 Hugging Face 账户。
- 前往 Hugging Face,如果您还没有账户,请注册。
- 具有正确权限的 API 令牌。
- 登录后,进入 Access Tokens 页面。
- 生成一个新的Read token。
- 安全复制该令牌。
- 对Llama-3.3-70B-Instruct 模型的访问权限。
- 前往Llama-3.3-70B-Instruct 页面。
- 您需要同意许可条款并申请访问。
- 注意:访问该模型需要 Pro 订阅。请确保您的账户已升级。
准备项目环境
在拿到模型访问权限后,让我们来设置应用的环境。首先,为该项目创建一个文件夹。打开终端,导航到您希望创建项目文件夹的位置,并运行:
mkdir multilingual-code-explanation
cd multilingual-code-explanation接着,我们创建一个名为app.py 的文件来存放代码:touch app.py现在创建并激活一个环境:
python3 -m venv venv
source venv/bin/activate’安装所需依赖
环境就绪后,我们来安装必要的库。请确保您运行的是 Python 3.8+。在终端中运行以下命令安装 Streamlit、Requests 和 Hugging Face 相关库:
pip install streamlit requests transformers huggingface-hub此时,您应具备:
- 拥有带 API 令牌且已获得 Llama 3.3 模型访问权限的 Hugging Face 账户。
- 一个干净、可用于编码的项目文件夹。
- 已安装所有必要的库,包括:
- 用于界面的 Streamlit。
- 用于调用 API 的 Requests。
- 用于与 Hugging Face 模型交互的 Transformers 与 huggingface-hub。
完成上述设置后,我们就可以开始构建应用了!下一节我们将一步步编写多语言代码讲解应用。
编写后端
后端将与Hugging Face API 通信,发送代码片段并接收讲解。
导入所需库
首先,我们需要导入 requests 库。该库可用于向 API 发送 HTTP 请求。请在app.py 文件顶部写入:
import requests设置 API 访问
要与托管在 Hugging Face 上的 Llama 3.3 API 进行交互,您需要:
- API 端点(模型托管的 URL)。
- 用于认证的 Hugging Face API 密钥。
HUGGINGFACE_API_KEY = "hf_your_api_key_here" # Replace with your actual API key
API_URL = "https://api-inference.huggingface.co/models/meta-llama/Llama-3.3-70B-Instruct"
HEADERS = {"Authorization": f"Bearer {HUGGINGFACE_API_KEY}"}上述代码中:
- 将 "hf_your_api_key_here" 替换为您之前生成的令牌。
- HEADERS 字典包含 API 密钥,便于 Hugging Face 确认您有权使用该端点。
编写查询 Llama 3.3 的函数
现在,我们将编写一个函数向 API 发送请求。该函数将:
- 构造提示词,告诉模型需要完成的任务。
- 向 Hugging Face 发送请求。
- 处理响应并提取生成的讲解。
def query_llama3(input_text, language):
# Create the prompt
prompt = (
f"Provide a simple explanation of this code in {language}:\n\n{input_text}\n"
f"Only output the explanation and nothing else. Make sure that the output is written in {language} and only in {language}"
)
# Payload for the API
payload = {
"inputs": prompt,
"parameters": {"max_new_tokens": 500, "temperature": 0.3},
}
# Make the API request
response = requests.post(API_URL, headers=HEADERS, json=payload)
if response.status_code == 200:
result = response.json()
# Extract the response text
full_response = result[0]["generated_text"] if isinstance(result, list) else result.get("generated_text", "")
# Clean up: Remove the prompt itself from the response
clean_response = full_response.replace(prompt, "").strip()
# Further clean any leading colons or formatting
if ":" in clean_response:
clean_response = clean_response.split(":", 1)[-1].strip()
return clean_response or "No explanation available."
else:
return f"Error: {response.status_code} - {response.text}"该提示词要求 Llama 3.3 用指定语言解释代码片段。
免责声明:我尝试了不同的提示词,以找到能产生最佳输出的方式,因此其中确实涉及一些提示工程!
接下来定义 payload。输入部分我们指定将提示词发送给模型;在参数中,max_new_tokens 控制响应长度,而 temperature 调整输出的创造性。
requests.post() 函数会将数据发送到 Hugging Face。若响应成功(status_code == 200),则提取生成文本;如出现错误,则返回描述性信息。
最后,我们对输出进行清理和格式化,以确保呈现整洁,这将显著提升用户体验。
构建 Streamlit 前端
前端是用户与应用交互的地方。Streamlit 是一个仅用 Python 代码就能创建交互式 Web 应用的库,使构建过程简单直观。我们将用它来构建应用前端。我非常喜欢用 Streamlit 来搭建演示和 POC!
导入 Streamlit
在app.py 文件顶部添加:
import streamlit as st设置页面配置
我们将使用 set_page_config() 定义应用标题和布局。如下所示:
page_title:设置浏览器标签页标题。layout="wide":允许应用使用全屏宽度。
st.set_page_config(page_title="Multilingual Code Explanation Assistant", layout="wide")创建侧边栏说明
为帮助用户了解如何使用该应用,我们将在侧边栏添加说明:如下代码所示:
st.sidebar.title():为侧边栏创建标题。st.sidebar.markdown():添加包含简要说明的文本。divider():添加清晰的视觉分隔。- 自定义 HTML:在底部显示一段带有个人风格的小页脚。您可以自由个性化这部分!
st.sidebar.title("How to Use the App")
st.sidebar.markdown("""
1. Paste your code snippet into the input box.
2. Enter the language you want the explanation in (e.g., English, Spanish, French).
3. Click 'Generate Explanation' to see the results.
""")
st.sidebar.divider()
st.sidebar.markdown(
"""
<div style="text-align: center;color: grey;">
Made with ♡ by Ana
</div>
""",
unsafe_allow_html=True
)添加主界面组件
我们将为页面添加主标题和副标题:
st.title("Multilingual Code Explanation Assistant")
st.markdown("### Powered by Llama 3.3 from Hugging Face 🦙")现在,为了让用户粘贴代码并选择偏好的语言,我们需要输入组件。由于代码文本通常比语言名称更长,我们为代码选择文本区域、为语言选择单行文本输入:
text_area():创建一个用于粘贴代码的大文本框。text_input():允许用户输入语言。
code_snippet = st.text_area("Paste your code snippet here:", height=200)
preferred_language = st.text_input("Enter your preferred language for explanation (e.g., English, Spanish):")接下来我们添加一个按钮来生成讲解。如果用户输入了代码和语言,并点击Generate Explanation 按钮,则会生成答案。
if st.button("Generate Explanation"):
if code_snippet and preferred_language:
with st.spinner("Generating explanation... ⏳"):
explanation = query_llama3(code_snippet, preferred_language)
st.subheader("Generated Explanation:")
st.write(explanation)
else:
st.warning("⚠️ Please provide both the code snippet and preferred language.")
当按钮被点击时,应用将:
- 检查是否提供了代码片段和语言。
- 在查询 API 时显示加载指示。
- 显示生成的讲解,或在缺少输入时给出警告。
添加页脚
最后,添加一个页脚:
st.markdown("---")
st.markdown("🧠 **Note**: This app uses Llama 3.3 from Hugging Face for multilingual code explanations.")运行 Llama 3.3 应用
现在可以运行应用了!在终端中执行以下命令以启动应用:
streamlit run app.py应用将会在浏览器中打开,您可以开始体验!
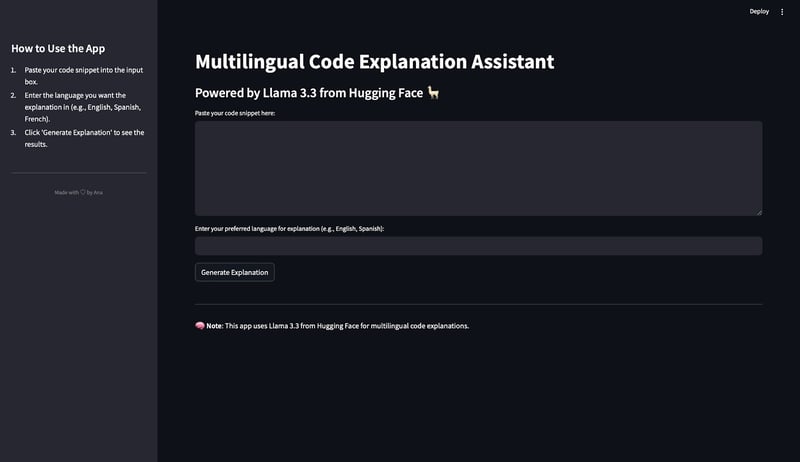
实际测试 Llama 3.3
现在我们已经构建了多语言代码讲解应用,是时候测试模型的表现了。本节我们将用该应用处理几个代码片段,并评估其在不同语言下生成的讲解。
测试 1:Python 中的阶乘函数
首先,从一个使用递归计算阶乘的 Python 脚本开始。以下是我们将使用的代码:
def factorial(n):
if n == 0:
return 1
else:
return n * factorial(n - 1)
num = 5
result = factorial(num)
print(f"The factorial of {num} is {result}")该脚本定义了一个递归函数 factorial(n),用于计算给定数字的阶乘。对于 num = 5,函数将计算 5×4×3×2×1,得到 120。结果通过 print() 语句输出。以下是在我们生成西班牙语讲解时的输出:
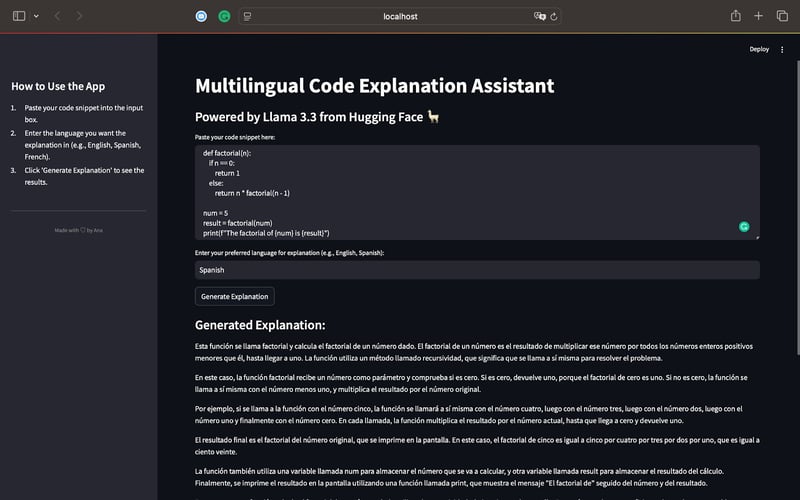
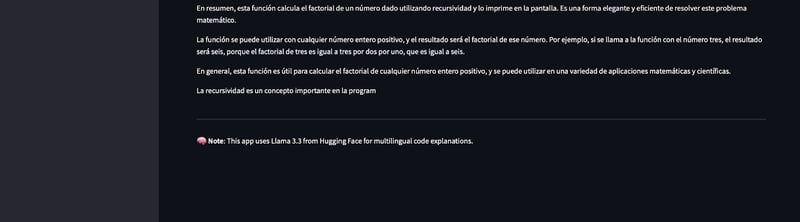
作为一名西班牙语使用者,我可以确认该讲解准确指出代码是通过递归计算一个数的阶乘。它逐步讲解了递归的工作机制,并将其分解为通俗易懂的描述。
模型解释了递归过程,并展示了函数如何以递减的 n 自我调用,直到达到 0。
讲解完全使用西班牙语,体现了 Llama 3.3 的多语言能力。
使用简单表述让递归概念即便对不熟悉编程的读者也容易理解。
它还概述了当输入为 3 时的递归工作方式,并提到递归作为一种高效的编程问题求解思路的重要性。
这第一次测试突出了 Llama 3.3 的强大之处:
- 能够以循序渐进的方式准确解释代码。
- 讲解可适应所请求的语言(此处为西班牙语)。
- 结果详细、清晰、对初学者友好,符合指示。
测试了 Python 脚本后,我们还可以继续尝试 JavaScript 或 SQL。这将帮助我们进一步探索 Llama 3.3 在推理、编码和多语言支持方面的能力。
测试 2:JavaScript 中的阶乘函数
在该测试中,我们将评估多语言代码讲解应用处理 JavaScript 函数并用法语生成讲解的表现。
我们使用以下 JavaScript 代码片段,我有意选择了含糊的变量名,以观察模型的处理效果:
function x(a) {
if (a === 1) return 1;
return a * x(a - 1);
}
const y = 6;
const z = x(y);
console.log("The result is: " + z);该代码定义了一个递归函数 x(a),用于计算给定数字 a 的阶乘。基本条件检查 a === 1,若满足则返回 1;否则函数以 a - 1 作为参数递归调用自身,并将结果与 a 相乘。常量 y 设为 6,因此函数 x 计算 6×5×4×3×2×1。最后结果存入变量 z,并通过 console.log 输出。以下是输出以及其英文翻译:
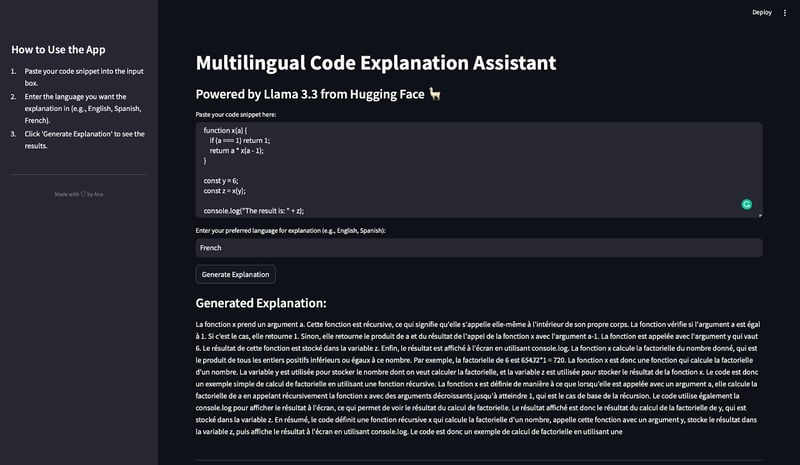
注意:您可能会发现响应似乎被突然截断,这是因为我们将输出限制为 500 个 token!
在完成翻译后,我的结论是:讲解正确识别出函数 x(a) 是递归的。它分解了递归的工作原理,解释了基本情况 (a === 1) 和递归情况 (a * x(a - 1))。讲解明确展示了函数如何计算 6 的阶乘,并提及 y(输入值)和 z(结果)的作用,同时指出 console.log 用于显示结果。
讲解完全使用法语。诸如“récursive”(递归)、“factorielle”(阶乘)、“produit”(乘积)等技术术语使用准确。不仅如此,它还识别出该代码以递归方式计算一个数的阶乘。
讲解避免了过于晦涩的术语,并对递归进行了简化说明,使其对编程新手也很友好。
该测试表明 Llama 3.3:
- 能够准确解释涉及递归的 JavaScript 代码。
- 能够用法语生成清晰详尽的讲解。
- 可以在讲解中涵盖变量角色和代码行为。
我们已经用 Python 和 JavaScript 测试了该应用,接下来用一条 SQL 查询继续评估其多语言与推理能力。
测试 3:德语讲解的 SQL 查询
最后一个测试中,我们将评估该应用处理 SQL 查询并用德语生成讲解的表现。以下是使用的 SQL 片段:
SELECT a.id, SUM(b.value) AS total_amount
FROM table_x AS a
JOIN table_y AS b ON a.ref_id = b.ref
WHERE b.flag = 1
GROUP BY a.id
HAVING SUM(b.value) > 1000
ORDER BY total_amount DESC;该查询选择 id 列,并为每个 id 计算总值 (SUM(b.value))。它从两个表读取数据:table_x(别名 a)和 table_y(别名 b)。然后使用 JOIN 条件连接 a.ref_id = b.ref 的行。它筛选 b.flag = 1 的行,并按 a.id 分组。HAVING 子句将分组结果过滤为仅包含 b.value 之和大于 1000 的分组。最后按 total_amount 降序排序结果。
点击生成讲解按钮后,我们得到如下结果:
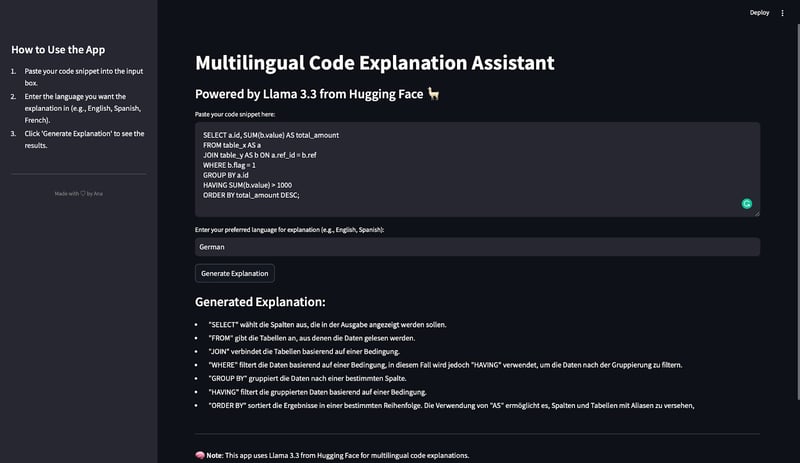
生成的讲解简洁、准确、结构清晰。每个关键 SQL 子句(SELECT、FROM、JOIN、WHERE、GROUP BY、HAVING 和 ORDER BY)都得到清楚解释。此外,描述与 SQL 的执行顺序相契合,便于读者逐步跟随查询逻辑。
讲解完全使用德语。
关键 SQL 术语(如“filtert”“gruppiert”“sortiert”)在上下文中使用准确。讲解指出 HAVING 用于过滤分组结果,这一点常让初学者困惑。它还解释了使用别名(AS)来重命名表和列以提升清晰度。
讲解避免过于复杂的术语,聚焦于各子句的功能,使初学者更容易理解查询的工作方式。
该测试表明 Llama 3.3:
- 能够高效处理 SQL 查询。
- 能够逐条子句生成清晰有条理的讲解。
- 支持输出德语。
- 提供足够细节,帮助初学者理解 SQL 查询背后的逻辑。
我们已使用 Python、JavaScript 和 SQL 的代码片段进行测试,并分别生成了西班牙语、法语和德语的讲解。每次测试中:
- 讲解准确、清晰且细致。
- 模型展现了出色的推理能力和多语言支持。
通过这些测试,我们确认所构建的应用在不同编程语言和自然语言下对代码进行讲解时具有良好的通用性、可靠性和有效性。
结语
恭喜您!您已使用 Streamlit 和 Hugging Face 的 Llama 3.3 构建了一个功能完善的多语言代码讲解助手。
在本教程中,您学习了:
- 如何将 Hugging Face 模型集成到 Streamlit 应用。
- 如何使用 Llama 3.3 API 讲解代码片段。
- 如何清理 API 响应并创建用户友好的应用。
该项目是探索 Llama 3.3 在代码推理、多语言支持和教学内容方面能力的良好起点。欢迎您创建自己的应用,继续发掘该模型的强大功能!

Ana Rojo Echeburúa 是一位人工智能与数据专家,拥有应用数学博士学位。她热衷于将数据转化为可执行的洞见,并在带领技术团队方面拥有丰富经验。Ana 喜欢与客户密切合作,解决其业务难题并打造创新的 AI 解决方案。她以出色的问题解决能力和清晰的沟通著称,对人工智能,尤其是生成式 AI 充满热情。Ana 致力于持续学习与负责任的 AI 开发,同时专注于简化复杂问题,并以通俗易懂的方式解释技术。
在本文中,我们将构建一个多语言代码讲解应用,以展示Llama 3.3 的能力,尤其是其在推理、遵循指令、编码以及多语言支持方面的优势。
该应用将允许用户:
该应用将使用以下技术构建:
我们将直接开始构建 Llama 3.3 应用;如果您想先了解模型概览,请查看这篇Llama 3.3 指南。让我们开始吧!