Cursus
Werken met Llama 3
2 uur
15.7K
Om te beginnen splitsen we dit op in een paar stappen. Eerst behandelen we hoe je Llama 3.3 gebruikt via Hugging Face, je account instelt en de juiste rechten krijgt. Daarna maken we de projectomgeving en installeren we de vereiste dependencies.
Een manier om Llama 3.3 te gebruiken is via Hugging Face, een van de populairste platforms voor het hosten van machinelearningmodellen. Om Llama 3.3 via de Inference API van Hugging Face te gebruiken, heb je nodig:
Nu de toegang tot het model geregeld is, richten we de omgeving van de app in. Eerst maken we een map voor dit project. Open je terminal, navigeer naar de plek waar je de projectmap wilt maken en voer uit:
mkdir multilingual-code-explanation
cd multilingual-code-explanation
Daarna maken we een bestand genaamd app.py om de code in op te slaan: touch app.py. Nu maken we een omgeving aan en activeren die:
python3 -m venv venv
source venv/bin/activate’Nu de omgeving klaar is, installeren we de benodigde libraries. Zorg dat je Python 3.8+ gebruikt. Voer in de terminal de volgende opdracht uit om Streamlit, Requests en Hugging Face-libraries te installeren:
pip install streamlit requests transformers huggingface-hubOp dit punt heb je:
Nu de setup klaar is, kunnen we de app gaan bouwen! In de volgende sectie beginnen we stap voor stap met het coderen van de meertalige app voor code-uitleg.
De backend communiceert met de Hugging Face API om het codefragment te versturen en de uitleg te ontvangen.
Eerst moeten we de library requests importeren. Deze library stelt ons in staat HTTP-verzoeken naar API’s te sturen. Bovenaan je app.py-bestand, schrijf:
import requestsOm te communiceren met de Llama 3.3 API die wordt gehost op Hugging Face, heb je nodig:
HUGGINGFACE_API_KEY = "hf_your_api_key_here"  # Replace with your actual API key
API_URL = "https://api-inference.huggingface.co/models/meta-llama/Llama-3.3-70B-Instruct"
HEADERS = {"Authorization": f"Bearer {HUGGINGFACE_API_KEY}"}
In de code hierboven:
We schrijven nu een functie om een verzoek naar de API te sturen. De functie zal:
def query_llama3(input_text, language):
   # Create the prompt
   prompt = (
       f"Provide a simple explanation of this code in {language}:\n\n{input_text}\n"
       f"Only output the explanation and nothing else. Make sure that the output is written in {language} and only in {language}"
   )
   # Payload for the API
   payload = {
       "inputs": prompt,
       "parameters": {"max_new_tokens": 500, "temperature": 0.3},
   }

   # Make the API request
   response = requests.post(API_URL, headers=HEADERS, json=payload)
   if response.status_code == 200:
       result = response.json()

       # Extract the response text
       full_response = result[0]["generated_text"] if isinstance(result, list) else result.get("generated_text", "")

       # Clean up: Remove the prompt itself from the response
       clean_response = full_response.replace(prompt, "").strip()
       # Further clean any leading colons or formatting
       if ":" in clean_response:
           clean_response = clean_response.split(":", 1)[-1].strip()

       return clean_response or "No explanation available."
   else:
       return f"Error: {response.status_code} - {response.text}"
De prompt instrueert Llama 3.3 om het codefragment in de gewenste taal uit te leggen.
Disclaimer: ik heb met verschillende prompts geëxperimenteerd om te vinden welke de beste output oplevert, dus er kwam zeker een element van prompt engineering bij kijken!
Vervolgens wordt de payload gedefinieerd. Voor de input geven we aan dat de prompt naar het model wordt gestuurd. In de parameters bepaalt max_new_tokens de lengte van de respons, terwijl temperature het creativiteitsniveau van de output aanpast.
De functie requests.post() stuurt de gegevens naar Hugging Face. Als de response succesvol is (status_code == 200), wordt de gegenereerde tekst eruit gehaald. Als er een fout optreedt, wordt een beschrijvende melding teruggegeven.
Tot slot zijn er stappen om de output netjes op te schonen en te formatteren. Dit zorgt voor een verzorgde presentatie, wat de gebruikerservaring aanzienlijk verbetert.
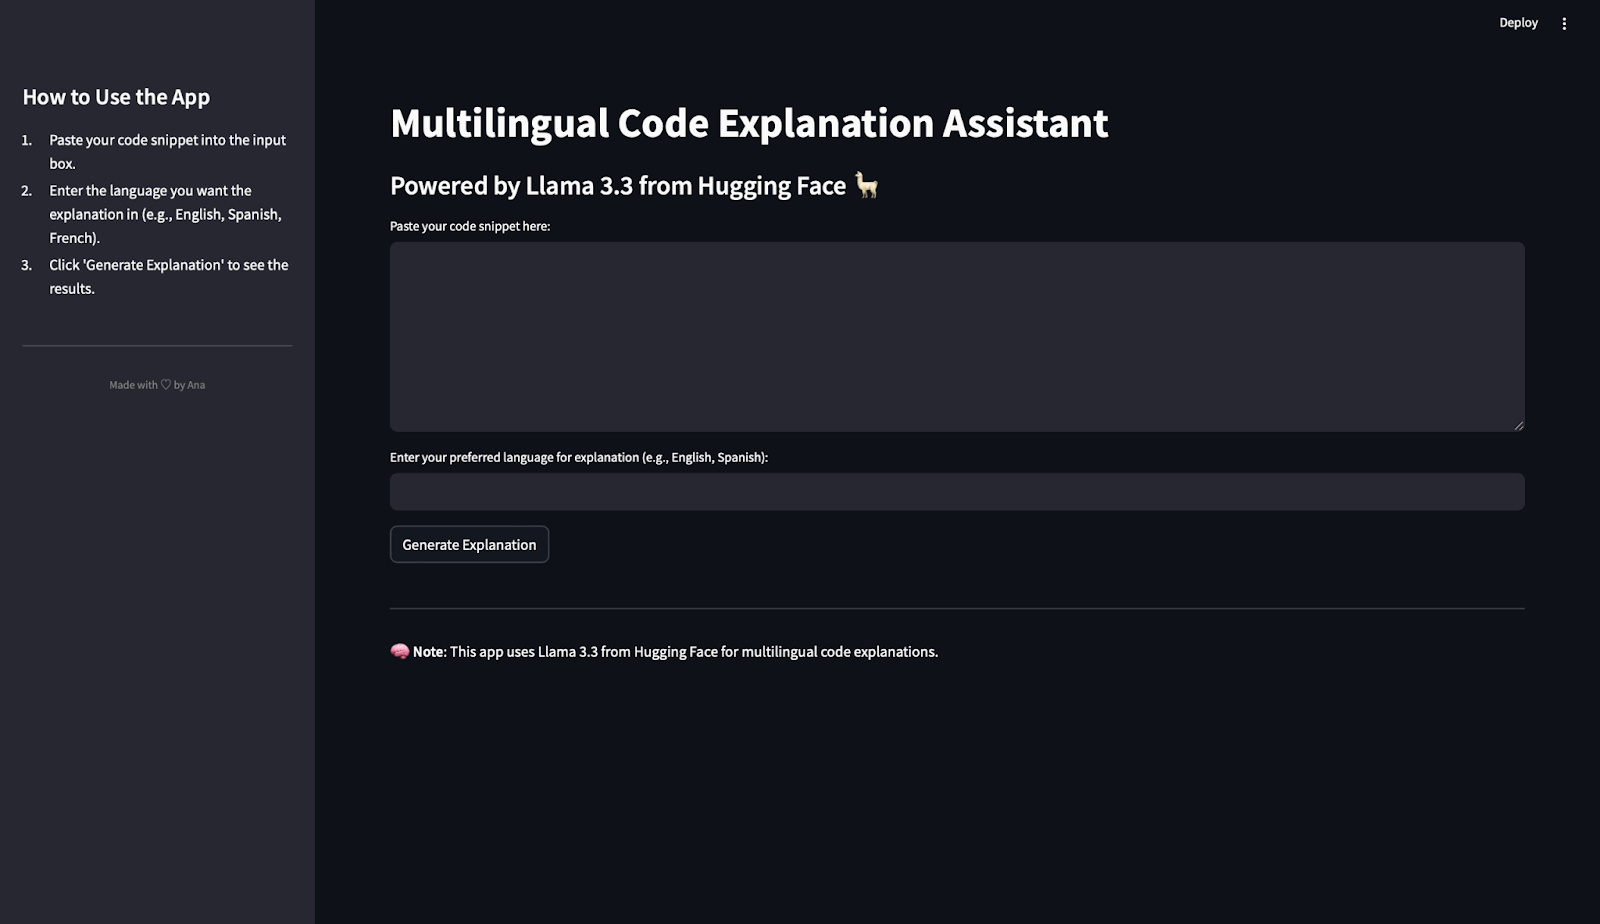
De frontend is waar gebruikers met de app interacteren. Streamlit is een library waarmee je met alleen Python-code interactieve webapps maakt en dit proces eenvoudig en intuïtief maakt. Dit gebruiken we om de frontend van onze app te bouwen. Ik vind Streamlit geweldig voor demo’s en POC’s!
Voeg bovenaan je app.py-bestand toe:
import streamlit as stWe gebruiken set_page_config() om de titel en layout van de app te definiëren. In de code hieronder:
page_title: Stelt de titel van het browsertabblad in.layout="wide": Laat de app de volledige schermbreedte gebruiken.st.set_page_config(page_title="Multilingual Code Explanation Assistant", layout="wide")Om gebruikers te helpen begrijpen hoe ze de app gebruiken, voegen we instructies toe aan de zijbalk: In de code hieronder:
st.sidebar.title(): Maakt een titel voor de zijbalk.st.sidebar.markdown(): Voegt tekst toe met eenvoudige instructies.divider(): Voegt een nette visuele scheiding toe.st.sidebar.title("How to Use the App")
st.sidebar.markdown("""
1. Paste your code snippet into the input box.
2. Enter the language you want the explanation in (e.g., English, Spanish, French).
3. Click 'Generate Explanation' to see the results.
""")
st.sidebar.divider()
st.sidebar.markdown(
"""
<div style="text-align: center;color: grey;">
Made with ♡ by Ana
</div>
""",
unsafe_allow_html=True
)We voegen de hoofdtitel en subtitel toe aan de pagina:
st.title("Multilingual Code Explanation Assistant")
st.markdown("### Powered by Llama 3.3 from Hugging Face 🦙")
Om gebruikers code te laten plakken en hun voorkeurstaal te kiezen, hebben we invoervelden nodig. Omdat de codetekst waarschijnlijk langer is dan de naam van de taal, kiezen we een tekstgebied voor de code en een tekstinvoer voor de taal:
text_area(): Maakt een groot vak om code te plakken.text_input(): Laat gebruikers de taal invoeren.code_snippet = st.text_area("Paste your code snippet here:", height=200)
preferred_language = st.text_input("Enter your preferred language for explanation (e.g., English, Spanish):")We voegen nu een knop toe om de uitleg te genereren. Als de gebruiker de code en de taal invoert en vervolgens op de knop Generate Explanation klikt, wordt er een antwoord gegenereerd.
if st.button("Generate Explanation"):
	   if code_snippet and preferred_language:
	       with st.spinner("Generating explanation... ⏳"):
	           explanation = query_llama3(code_snippet, preferred_language)
	       st.subheader("Generated Explanation:")
	       st.write(explanation)
	   else:
	       st.warning("⚠️ Please provide both the code snippet and preferred language.")
Wanneer op de knop wordt geklikt, doet de app het volgende:
Tot slot voegen we een footer toe:
st.markdown("---")
st.markdown("🧠 **Note**: This app uses Llama 3.3 from Hugging Face for multilingual code explanations.")Tijd om de app te draaien! Voer onderstaande code uit in de terminal om je app te starten:
streamlit run app.pyDe app opent in je browser en je kunt ermee aan de slag!
Nu we onze meertalige app voor code-uitleg hebben gebouwd, is het tijd om te testen hoe goed het model werkt. In deze sectie gebruiken we de app om een paar codefragmenten te verwerken en beoordelen we de uitleg die in verschillende talen is gegenereerd.
Voor onze eerste test beginnen we met een Python-script dat de faculteit van een getal berekent met recursie. Dit is de code die we gebruiken:
def factorial(n):
    if n == 0:
        return 1
    else:
        return n * factorial(n - 1)
num = 5
result = factorial(num)
print(f"The factorial of {num} is {result}")
Dit script definieert een recursieve functie factorial(n) die de faculteit van een gegeven getal berekent. Voor num = 5 berekent de functie 5×4×3×2×1, wat resulteert in 120. Het resultaat wordt op het scherm afgedrukt met het print()-statement. Hier is de output wanneer we een uitleg in het Spaans genereren:
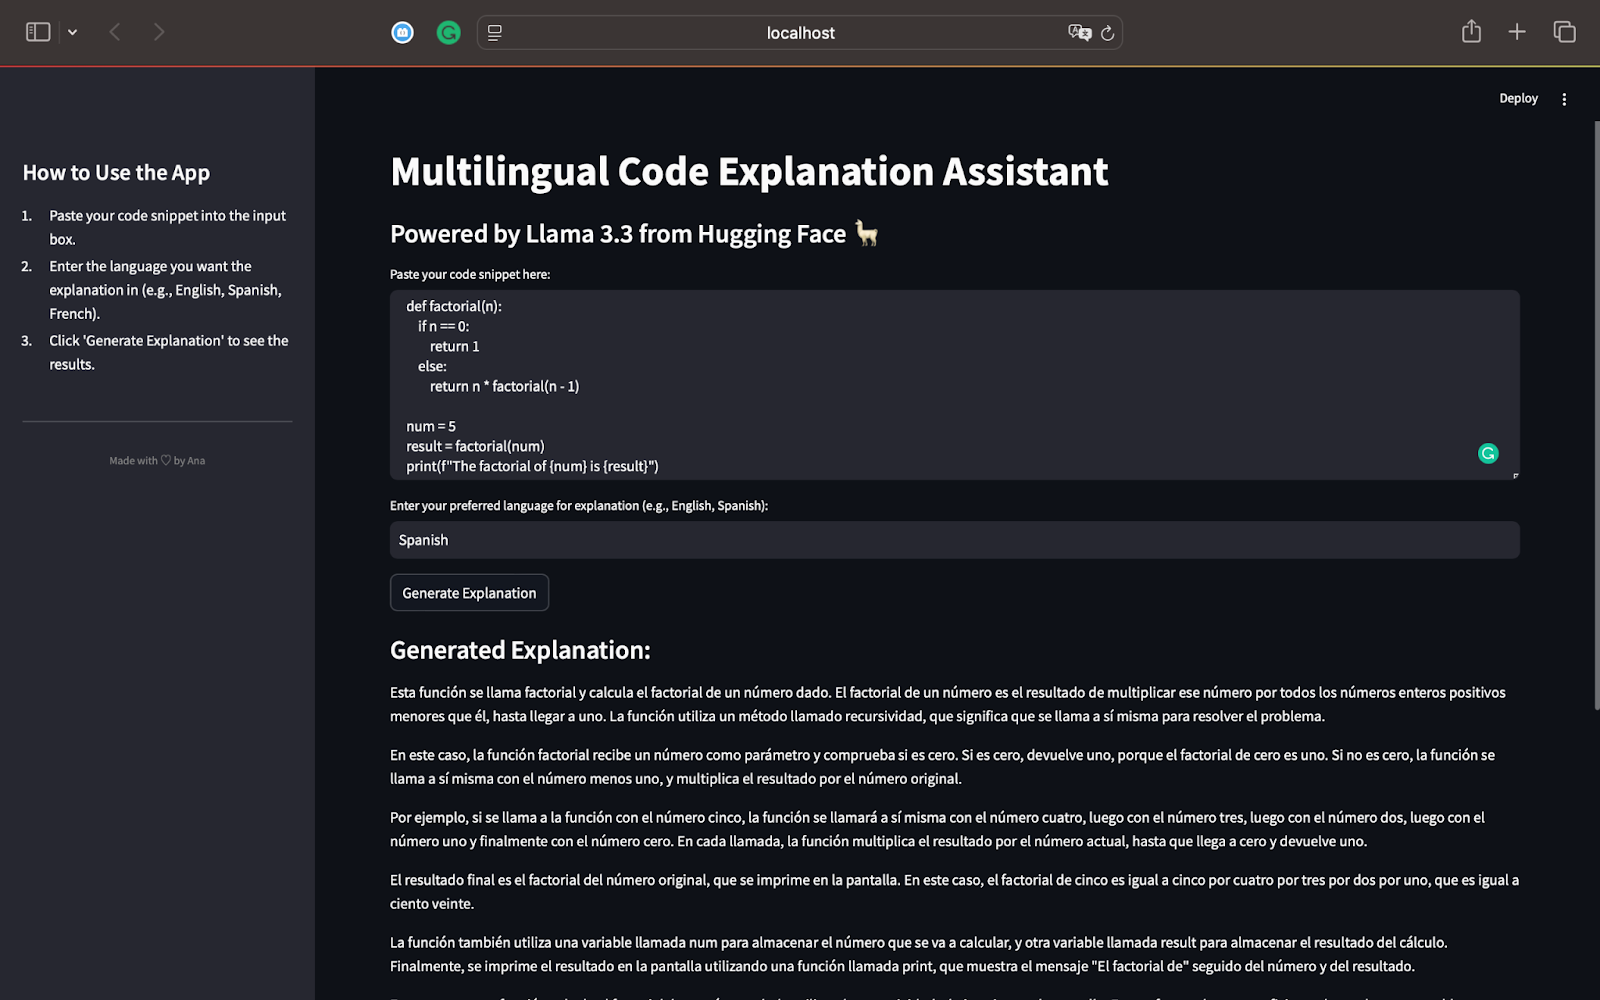
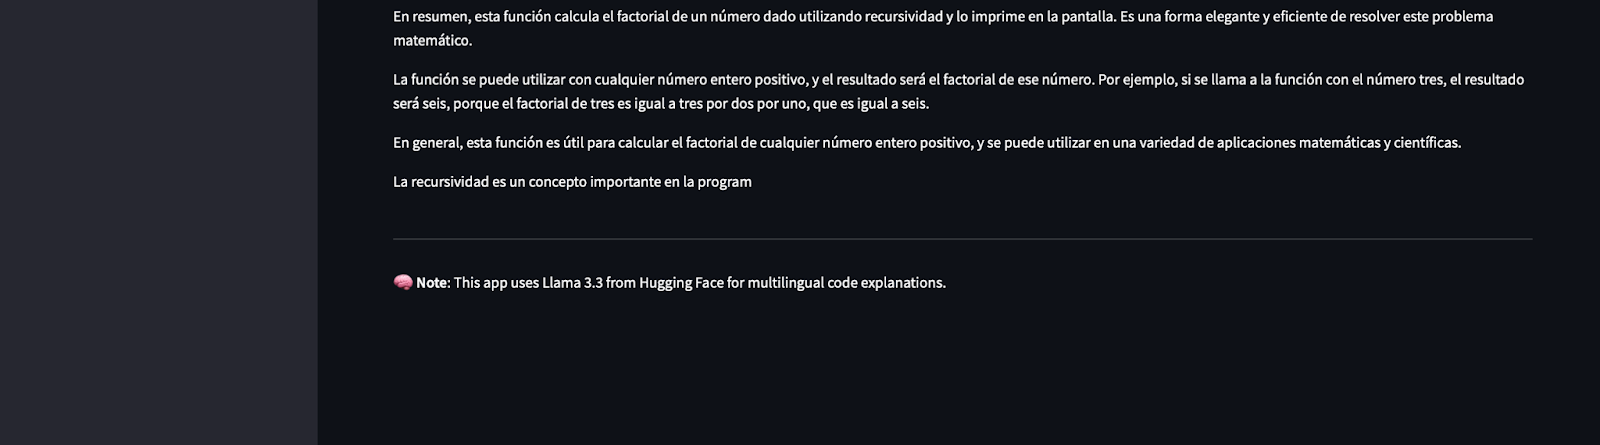
Als Spaanstalige kan ik bevestigen dat de uitleg correct aangeeft dat de code de faculteit van een getal met recursie berekent. Er wordt stap voor stap uitgelegd hoe de recursie werkt, in eenvoudige bewoordingen.
Het model legt het recursieproces uit en laat zien hoe de functie zichzelf aanroept met afnemende waarden van n tot 0 is bereikt.
De uitleg is volledig in het Spaans, zoals gevraagd, wat de meertalige capaciteiten van Llama 3.3 aantoont.
Het gebruik van eenvoudige zinnen maakt het concept van recursie gemakkelijk te volgen, zelfs voor lezers die niet bekend zijn met programmeren.
Er wordt samengevat en genoemd hoe recursie werkt voor andere inputs zoals 3 en het belang van recursie als efficiënt probleemoplossend concept in programmeren.
Deze eerste test benadrukt de kracht van Llama 3.3:
Nu we een Python-script hebben getest, kunnen we doorgaan met andere programmeertalen zoals JavaScript of SQL. Zo verkennen we de mogelijkheden van Llama 3.3 verder op het gebied van redeneren, coderen en meertalige ondersteuning.
In deze test evalueren we hoe goed de meertalige app voor code-uitleg een JavaScript-functie verwerkt en een uitleg in het Frans genereert.
We gebruiken het volgende JavaScript-codefragment waarin ik bewust dubbelzinnige variabelen heb gekozen om te zien hoe goed het model hiermee omgaat:
function x(a) {
    if (a === 1) return 1;
    return a * x(a - 1);
}
const y = 6;
const z = x(y);
console.log("The result is: " + z);
Dit codefragment definieert een recursieve functie x(a) die de faculteit van een gegeven getal a berekent. De basisconditie controleert of a === 1. Zo ja, dan retourneert de functie 1. Anders roept de functie zichzelf aan met a - 1 en vermenigvuldigt de uitkomst met a. De constante y is ingesteld op 6, dus de functie x berekent 6×5×4×3×2×1. Ten slotte wordt het resultaat opgeslagen in de variabele z en weergegeven met console.log. Hier is de output en de vertaling in het Engels:
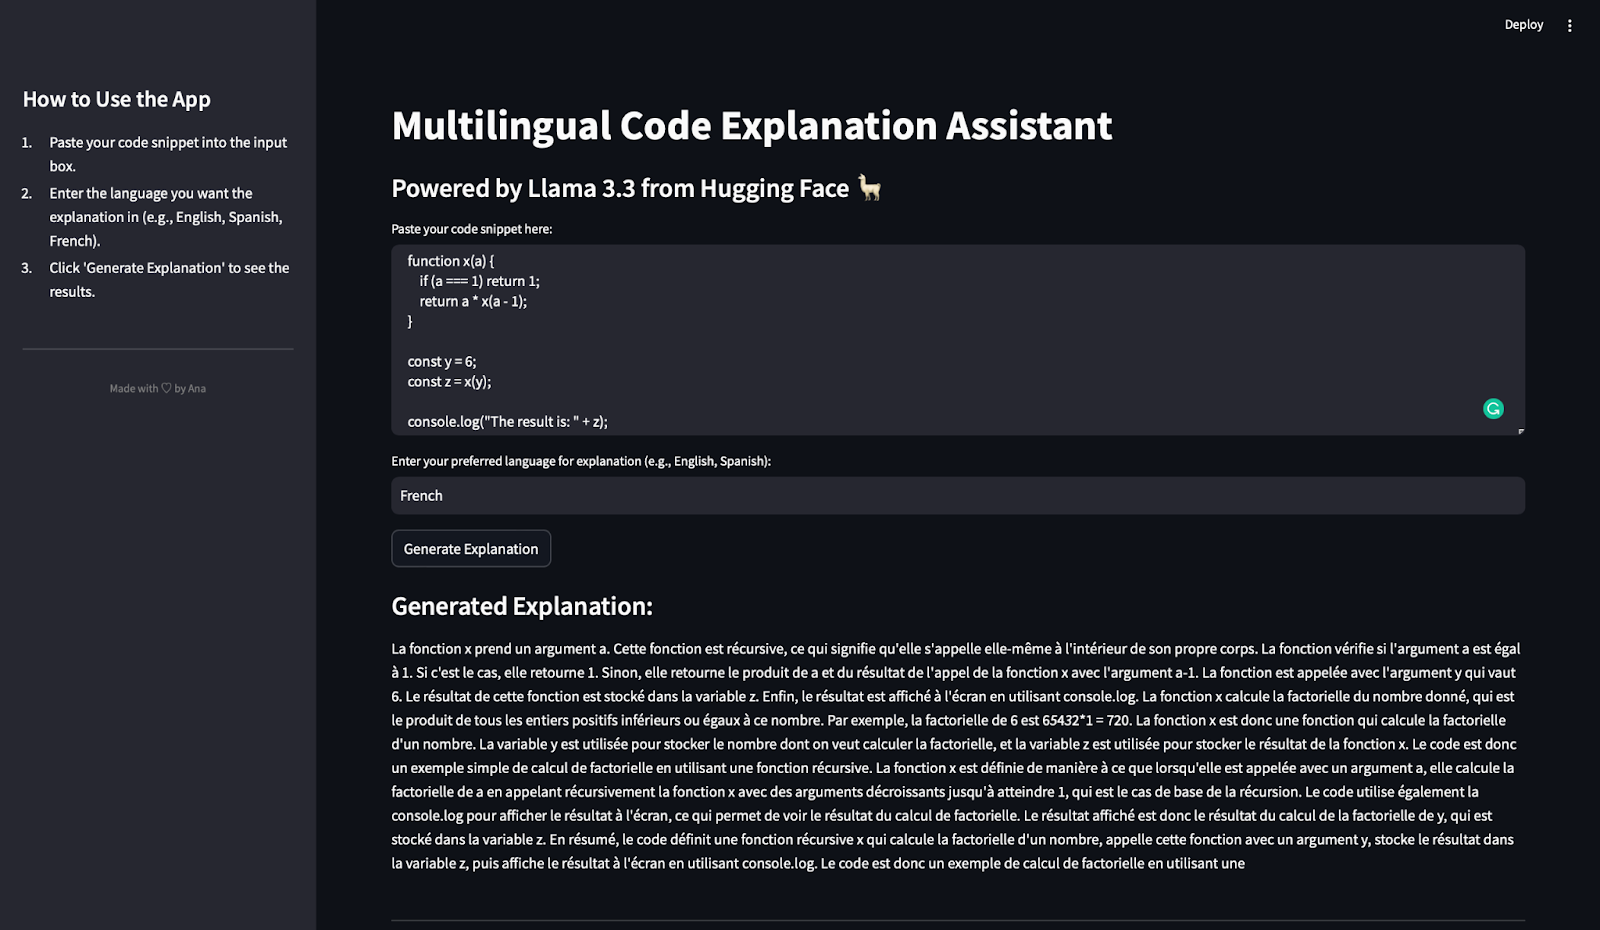
Let op: Het lijkt alsof de response plotseling is afgekapt, maar dat komt doordat we de output hebben beperkt tot 500 tokens!
Na het vertalen concludeerde ik dat de uitleg correct aangeeft dat de functie x(a) recursief is. Er wordt uiteengezet hoe recursie werkt, met uitleg over de basisgeval (a === 1) en het recursieve geval (a * x(a - 1)). De uitleg laat expliciet zien hoe de functie de faculteit van 6 berekent en benoemt de rol van y (de invoerwaarde) en z (het resultaat). Ook wordt genoemd hoe console.log wordt gebruikt om het resultaat te tonen.
De uitleg is volledig in het Frans, zoals gevraagd. Technische termen als “récursive” (recursief), “factorielle” (faculteit) en “produit” (product) worden correct gebruikt. En bovendien wordt herkend dat deze code de faculteit van een getal op recursieve wijze berekent.
De uitleg vermijdt overdreven technisch jargon en vereenvoudigt recursie, zodat het toegankelijk is voor lezers die nieuw zijn met programmeren.
Deze test laat zien dat Llama 3.3:
Nu we de app met Python en JavaScript hebben getest, gaan we verder met een SQL-query om de meertalige en redeneercapaciteiten verder te beoordelen.
In deze laatste test beoordelen we hoe de meertalige app voor code-uitleg een SQL-query verwerkt en een uitleg in het Duits genereert. Hier is het gebruikte SQL-fragment:
SELECT a.id, SUM(b.value) AS total_amount
FROM table_x AS a
JOIN table_y AS b ON a.ref_id = b.ref
WHERE b.flag = 1
GROUP BY a.id
HAVING SUM(b.value) > 1000
ORDER BY total_amount DESC;
Deze query selecteert de kolom id en berekent de totale waarde (SUM(b.value)) voor elke id. Er wordt gelezen uit twee tabellen: table_x (alias a) en table_y (alias b). Vervolgens wordt een JOIN-conditie gebruikt om rijen te koppelen waar a.ref_id = b.ref. Er worden rijen gefilterd waar b.flag = 1 en de gegevens worden gegroepeerd op a.id. De HAVING-clausule filtert de groepen zodat alleen die overblijven waarbij de som van b.value groter is dan 1000. Tot slot worden de resultaten gesorteerd op total_amount in aflopende volgorde.
Na het klikken op de knop om de uitleg te genereren, krijgen we dit:
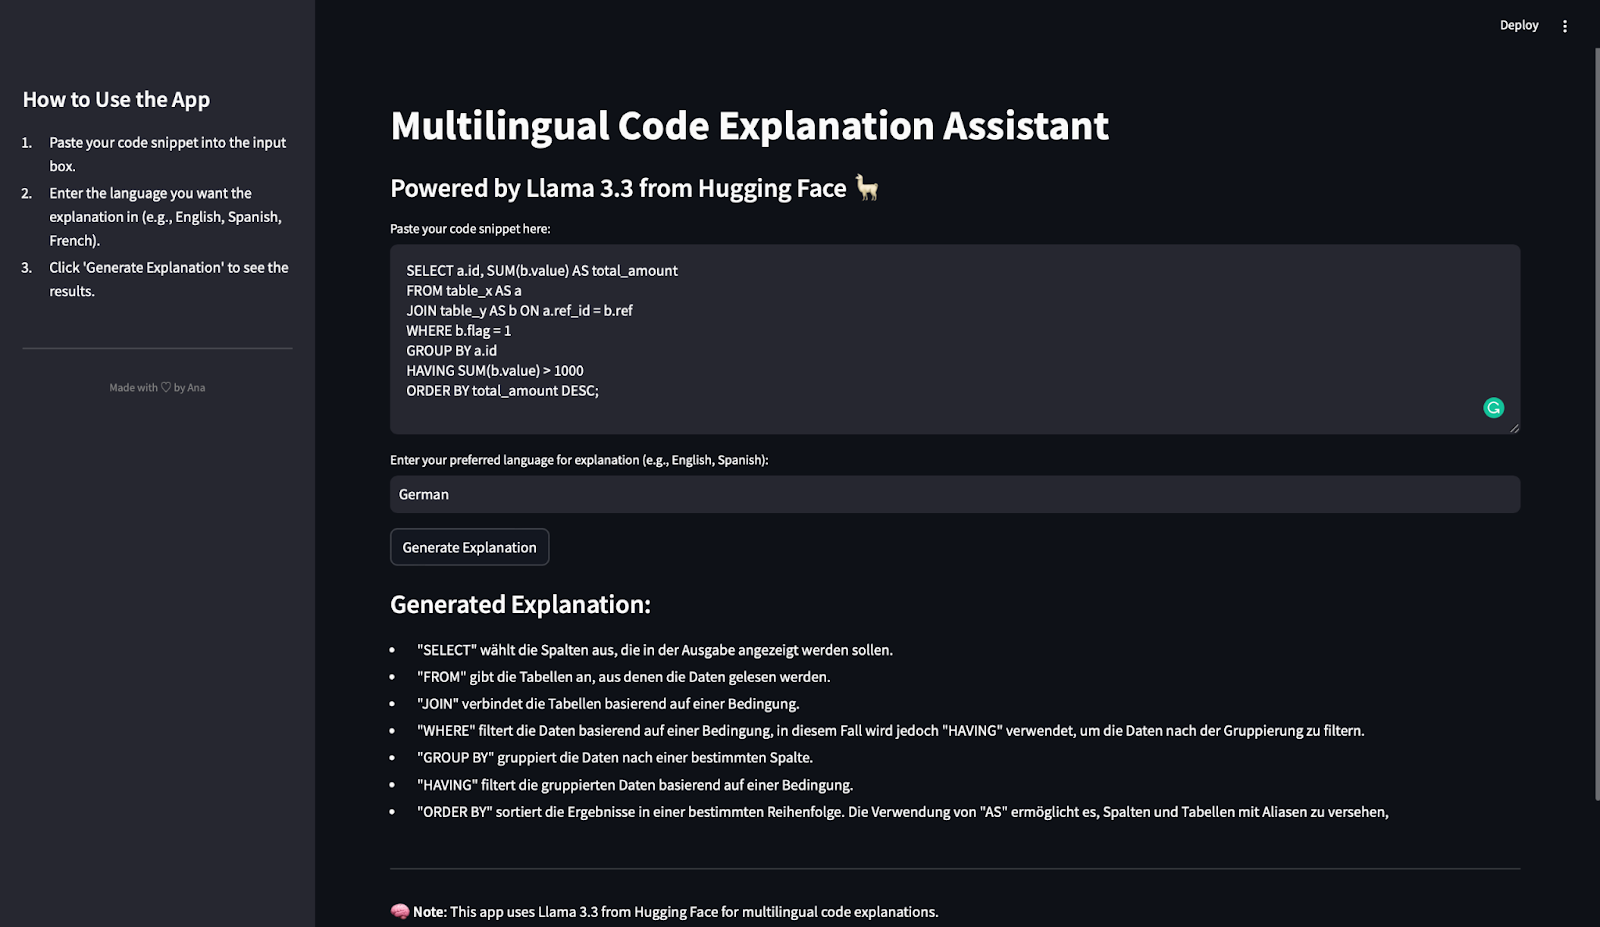
De gegenereerde uitleg is beknopt, nauwkeurig en goed gestructureerd. Elke belangrijke SQL-clausule (SELECT, FROM, JOIN, WHERE, GROUP BY, HAVING en ORDER BY) wordt duidelijk uitgelegd. Ook komt de beschrijving overeen met de volgorde van uitvoering in SQL, waardoor lezers de querylogica stap voor stap kunnen volgen.
De uitleg is volledig in het Duits, zoals gevraagd.
Belangrijke SQL-termen (bijv. "filtert", "gruppiert", "sortiert") worden accuraat in context gebruikt. De uitleg benoemt dat HAVING wordt gebruikt om gegroepeerde resultaten te filteren, wat vaak verwarrend is voor beginners. Ook wordt het gebruik van aliassen (AS) om tabellen en kolommen te hernoemen voor duidelijkheid uitgelegd.
De uitleg vermijdt overdreven complexe terminologie en focust op de functie van elke clausule. Dit maakt het voor beginners eenvoudig om te begrijpen hoe de query werkt.
Deze test laat zien dat Llama 3.3:
We hebben de app getest met codefragmenten in Python, JavaScript en SQL, en uitleg gegenereerd in het Spaans, Frans en Duits. In elke test:
Met deze test hebben we bevestigd dat de app die we hebben gebouwd veelzijdig, betrouwbaar en effectief is voor het uitleggen van code in verschillende programmeertalen en natuurlijke talen.
Gefeliciteerd! Je hebt een volledig functionerende meertalige assistent voor code-uitleg gebouwd met Streamlit en Llama 3.3 van Hugging Face.
In deze tutorial heb je geleerd:
Dit project is een uitstekend startpunt om de mogelijkheden van Llama 3.3 te verkennen op het gebied van coderedenering, meertalige ondersteuning en instructieve content. Maak gerust je eigen app om de krachtige features van dit model verder te ontdekken!
Leer AI met deze cursussen!
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

