
कोर्स
Llama 3 के साथ काम करना
2 घंटा
15.6K
शुरू करने के लिए, हम इसे कुछ चरणों में विभाजित करेंगे। पहले, हम देखेंगे कि Hugging Face का उपयोग करके Llama 3.3 तक कैसे पहुँचा जाए, अपना खाता कैसे सेटअप करें, और आवश्यक अनुमति कैसे प्राप्त करें। फिर, हम प्रोजेक्ट एन्वायरनमेंट बनाएंगे और आवश्यक डिपेंडेंसी इंस्टॉल करेंगे।
Llama 3.3 तक पहुँचने का एक तरीका Hugging Face के माध्यम से है, जो मशीन लर्निंग मॉडल्स को होस्ट करने के लिए सबसे लोकप्रिय प्लेटफॉर्म्स में से एक है। Hugging Face के Inference API के जरिए Llama 3.3 का उपयोग करने के लिए, आपको चाहिए:
मॉडल तक पहुँच सुनिश्चित होने के बाद, ऐप का एन्वायरनमेंट सेटअप करते हैं। सबसे पहले, इस प्रोजेक्ट के लिए एक फ़ोल्डर बनाएँ। अपना टर्मिनल खोलें, उस स्थान पर जाएँ जहाँ आप प्रोजेक्ट फ़ोल्डर बनाना चाहते हैं, और चलाएँ:
mkdir multilingual-code-explanation
cd multilingual-code-explanation
फिर, हम app.py नाम की एक फ़ाइल बनाएँगे जिसमें कोड होगा: touch app.pyअब, हम एक एन्वायरनमेंट बनाते हैं और उसे सक्रिय करते हैं:
python3 -m venv venv
source venv/bin/activate’अब जब एन्वायरनमेंट तैयार है, आवश्यक लाइब्रेरी इंस्टॉल करते हैं। सुनिश्चित करें कि आप Python 3.8+ चला रहे हैं। टर्मिनल में, Streamlit, Requests और Hugging Face लाइब्रेरी इंस्टॉल करने के लिए यह कमांड चलाएँ:
pip install streamlit requests transformers huggingface-hubअब तक, आपके पास होना चाहिए:
अब जब सेटअप पूरा हो गया है, हम ऐप बनाने के लिए तैयार हैं! अगले सेक्शन में, हम बहुभाषी कोड व्याख्या ऐप को चरण-दर-चरण कोड करेंगे।
बैकएंड Hugging Face API से संचार करता है ताकि कोड स्निपेट भेज सके और व्याख्या प्राप्त कर सके।
सबसे पहले, हमें requests लाइब्रेरी इम्पोर्ट करनी होगी। यह लाइब्रेरी हमें API को HTTP रिक्वेस्ट भेजने देती है। अपनी app.py फ़ाइल के शीर्ष पर लिखें:
import requestsHugging Face पर होस्टेड Llama 3.3 API के साथ इंटरेक्ट करने के लिए, आपको चाहिए:
HUGGINGFACE_API_KEY = "hf_your_api_key_here"  # Replace with your actual API key
API_URL = "https://api-inference.huggingface.co/models/meta-llama/Llama-3.3-70B-Instruct"
HEADERS = {"Authorization": f"Bearer {HUGGINGFACE_API_KEY}"}
ऊपर दिए गए कोड में:
अब, हम API को रिक्वेस्ट भेजने के लिए एक फ़ंक्शन लिखेंगे। यह फ़ंक्शन:
def query_llama3(input_text, language):
   # Create the prompt
   prompt = (
       f"Provide a simple explanation of this code in {language}:\n\n{input_text}\n"
       f"Only output the explanation and nothing else. Make sure that the output is written in {language} and only in {language}"
   )
   # Payload for the API
   payload = {
       "inputs": prompt,
       "parameters": {"max_new_tokens": 500, "temperature": 0.3},
   }

   # Make the API request
   response = requests.post(API_URL, headers=HEADERS, json=payload)
   if response.status_code == 200:
       result = response.json()

       # Extract the response text
       full_response = result[0]["generated_text"] if isinstance(result, list) else result.get("generated_text", "")

       # Clean up: Remove the prompt itself from the response
       clean_response = full_response.replace(prompt, "").strip()
       # Further clean any leading colons or formatting
       if ":" in clean_response:
           clean_response = clean_response.split(":", 1)[-1].strip()

       return clean_response or "No explanation available."
   else:
       return f"Error: {response.status_code} - {response.text}"
प्रॉम्प्ट Llama 3.3 को इच्छित भाषा में कोड स्निपेट समझाने के लिए कहता है।
अस्वीकरण: मैंने अलग-अलग प्रॉम्प्ट के साथ प्रयोग किया ताकि सबसे अच्छा आउटपुट देने वाला प्रॉम्प्ट मिल सके, तो इसमें प्रॉम्प्ट इंजीनियरिंग का एक भाग अवश्य शामिल था!
इसके बाद, पेलोड परिभाषित किया गया है। इनपुट के लिए, हम निर्दिष्ट करते हैं कि प्रॉम्प्ट मॉडल को भेजा जाए। पैरामीटर्स में, max_new_tokens रिस्पॉन्स की लंबाई नियंत्रित करता है, जबकि temperature आउटपुट की रचनात्मकता का स्तर समायोजित करता है।
requests.post() फ़ंक्शन डेटा Hugging Face को भेजता है। अगर रिस्पॉन्स सफल होता है (status_code == 200), तो जनरेट किया गया टेक्स्ट निकाला जाता है। अगर कोई त्रुटि है, तो एक विवरणात्मक संदेश लौटाया जाता है।
अंत में, आउटपुट को साफ और ठीक से फॉर्मैट करने के चरण हैं। इससे प्रस्तुति सुव्यवस्थित होती है, जो उपयोगकर्ता अनुभव को काफी बेहतर बनाती है।
फ्रंटएंड वह जगह है जहाँ उपयोगकर्ता ऐप के साथ इंटरैक्ट करेंगे। Streamlit एक लाइब्रेरी है जो सिर्फ Python कोड से इंटरैक्टिव वेब ऐप बनाती है और इस प्रक्रिया को सरल व सहज बनाती है। हम अपने ऐप का फ्रंटएंड बनाने के लिए इसी का उपयोग करेंगे। मुझे डेमो और POC बनाने के लिए Streamlit बहुत पसंद है!
अपनी app.py फ़ाइल के शीर्ष पर यह जोड़ें:
import streamlit as stहम ऐप का शीर्षक और लेआउट परिभाषित करने के लिए set_page_config() का उपयोग करेंगे। नीचे दिए गए कोड में:
page_title: ब्राउज़र टैब का शीर्षक सेट करता है।layout="wide": ऐप को पूरी स्क्रीन चौड़ाई उपयोग करने देता है।st.set_page_config(page_title="Multilingual Code Explanation Assistant", layout="wide")उपयोगकर्ताओं को ऐप का उपयोग समझाने के लिए, हम साइडबार में निर्देश जोड़ने जा रहे हैं: नीचे दिए गए कोड में:
st.sidebar.title(): साइडबार के लिए शीर्षक बनाता है।st.sidebar.markdown(): सरल निर्देशों के साथ टेक्स्ट जोड़ता है।divider(): साफ-सुथरा विजुअल सेपरेशन जोड़ता है।st.sidebar.title("How to Use the App")
st.sidebar.markdown("""
1. Paste your code snippet into the input box.
2. Enter the language you want the explanation in (e.g., English, Spanish, French).
3. Click 'Generate Explanation' to see the results.
""")
st.sidebar.divider()
st.sidebar.markdown(
"""
<div style=\"text-align: center;color: grey;\">
Made with ♡ by Ana
</div>
""",
unsafe_allow_html=True
)हम पेज पर मुख्य शीर्षक और उपशीर्षक जोड़ने जा रहे हैं:
st.title("Multilingual Code Explanation Assistant")
st.markdown("### Powered by Llama 3.3 from Hugging Face 🦙")
अब, उपयोगकर्ताओं को कोड पेस्ट करने और अपनी पसंदीदा भाषा चुनने देने के लिए हमें इनपुट फ़ील्ड्स चाहिए। क्योंकि कोड टेक्स्ट भाषा के नाम से लंबा होने की संभावना है, हम कोड के लिए टेक्स्ट एरिया और भाषा के लिए टेक्स्ट इनपुट चुन रहे हैं:
text_area(): कोड पेस्ट करने के लिए बड़ा बॉक्स बनाता है।text_input(): उपयोगकर्ताओं को भाषा टाइप करने देता है।code_snippet = st.text_area("Paste your code snippet here:", height=200)
preferred_language = st.text_input("Enter your preferred language for explanation (e.g., English, Spanish):")अब हम एक बटन जोड़ते हैं जो व्याख्या जनरेट करेगा। यदि उपयोगकर्ता कोड और भाषा दर्ज करता है और फिर Generate Explanation बटन पर क्लिक करता/करती है, तो एक उत्तर जनरेट होता है।
if st.button("Generate Explanation"):
	   if code_snippet and preferred_language:
	       with st.spinner("Generating explanation... ⏳"):
	           explanation = query_llama3(code_snippet, preferred_language)
	       st.subheader("Generated Explanation:")
	       st.write(explanation)
	   else:
	       st.warning("⚠️ Please provide both the code snippet and preferred language.")
जब बटन क्लिक किया जाता है, ऐप:
समापन के लिए, एक फुटर जोड़ते हैं:
st.markdown("---")
st.markdown("🧠 **Note**: This app uses Llama 3.3 from Hugging Face for multilingual code explanations.")अब ऐप चलाने का समय है! अपना ऐप लॉन्च करने के लिए, टर्मिनल में यह कमांड चलाएँ:
streamlit run app.pyऐप आपके ब्राउज़र में खुल जाएगा, और आप इसके साथ प्रयोग शुरू कर सकते हैं!
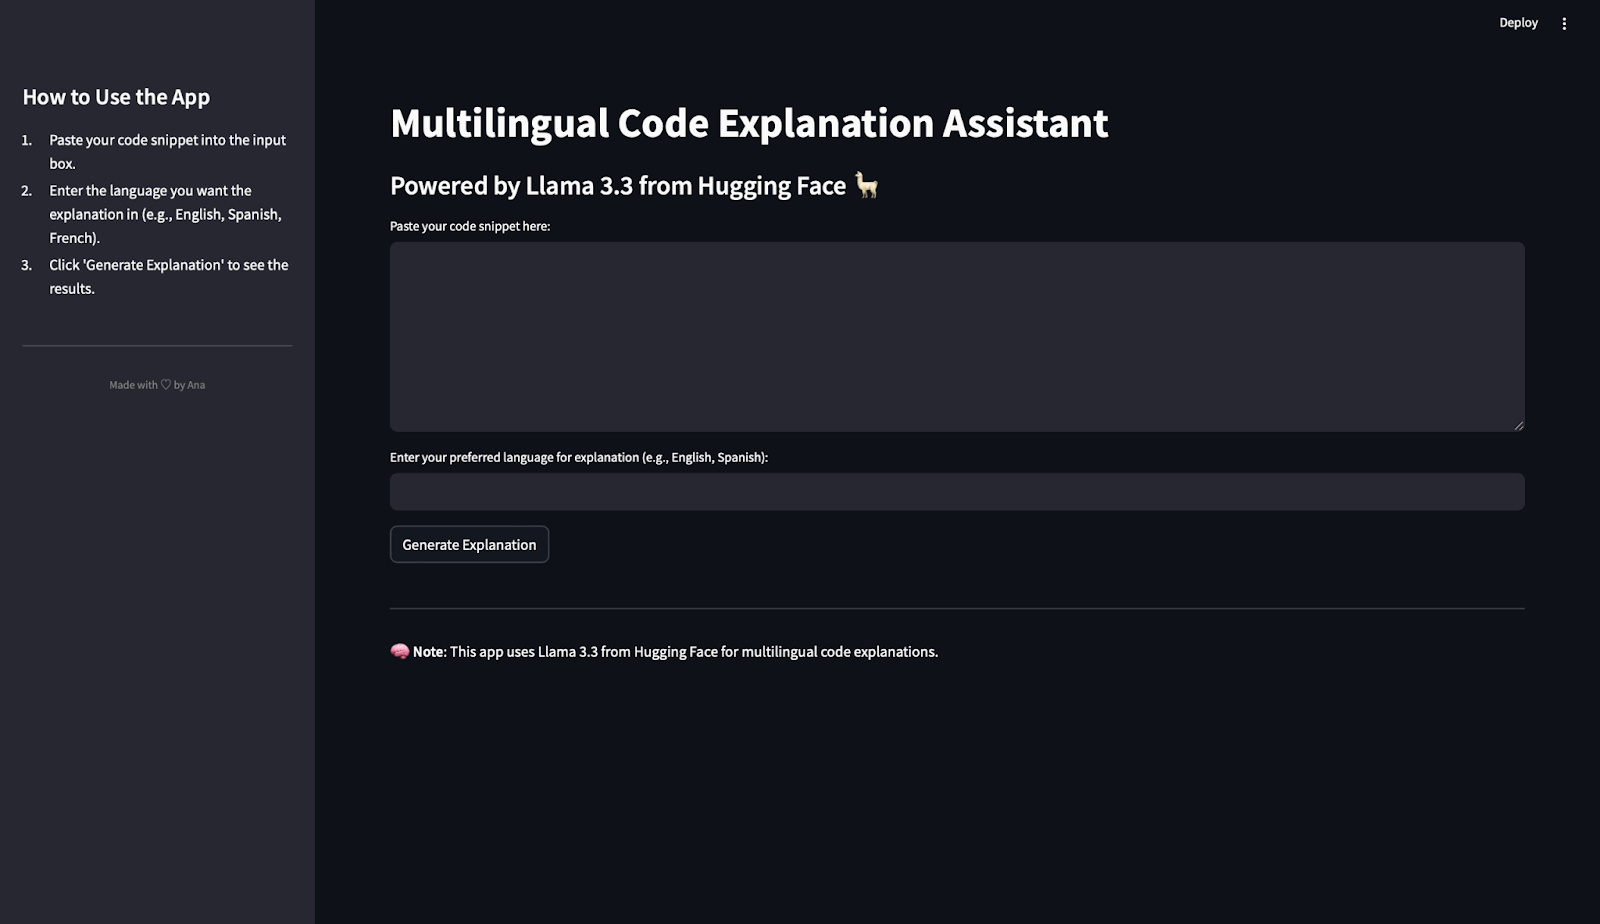
अब जब हमने अपना बहुभाषी कोड व्याख्या ऐप बना लिया है, तो यह परखने का समय है कि मॉडल कितना अच्छा काम करता है। इस सेक्शन में, हम ऐप का उपयोग करके कुछ कोड स्निपेट प्रोसेस करेंगे और अलग-अलग भाषाओं में जनरेट हुई व्याख्याओं का मूल्यांकन करेंगे।
पहले टेस्ट के लिए, चलिए एक Python स्क्रिप्ट से शुरू करते हैं जो रिकर्शन का उपयोग करके किसी संख्या का फैक्टोरियल गणना करती है। यह रहा कोड जिसका हम उपयोग करेंगे:
def factorial(n):
    if n == 0:
        return 1
    else:
        return n * factorial(n - 1)
num = 5
result = factorial(num)
print(f"The factorial of {num} is {result}")
यह स्क्रिप्ट एक रिकर्सिव फ़ंक्शन factorial(n) परिभाषित करती है जो दी गई संख्या का फैक्टोरियल गणना करता है। num = 5 के लिए, फ़ंक्शन 5×4×3×2×1 की गणना करेगा, जिसका परिणाम 120 होगा। परिणाम को print() स्टेटमेंट के जरिए स्क्रीन पर प्रिंट किया जाता है। जब हम स्पैनिश में व्याख्या जनरेट करते हैं, तो यह आउटपुट मिलता है:
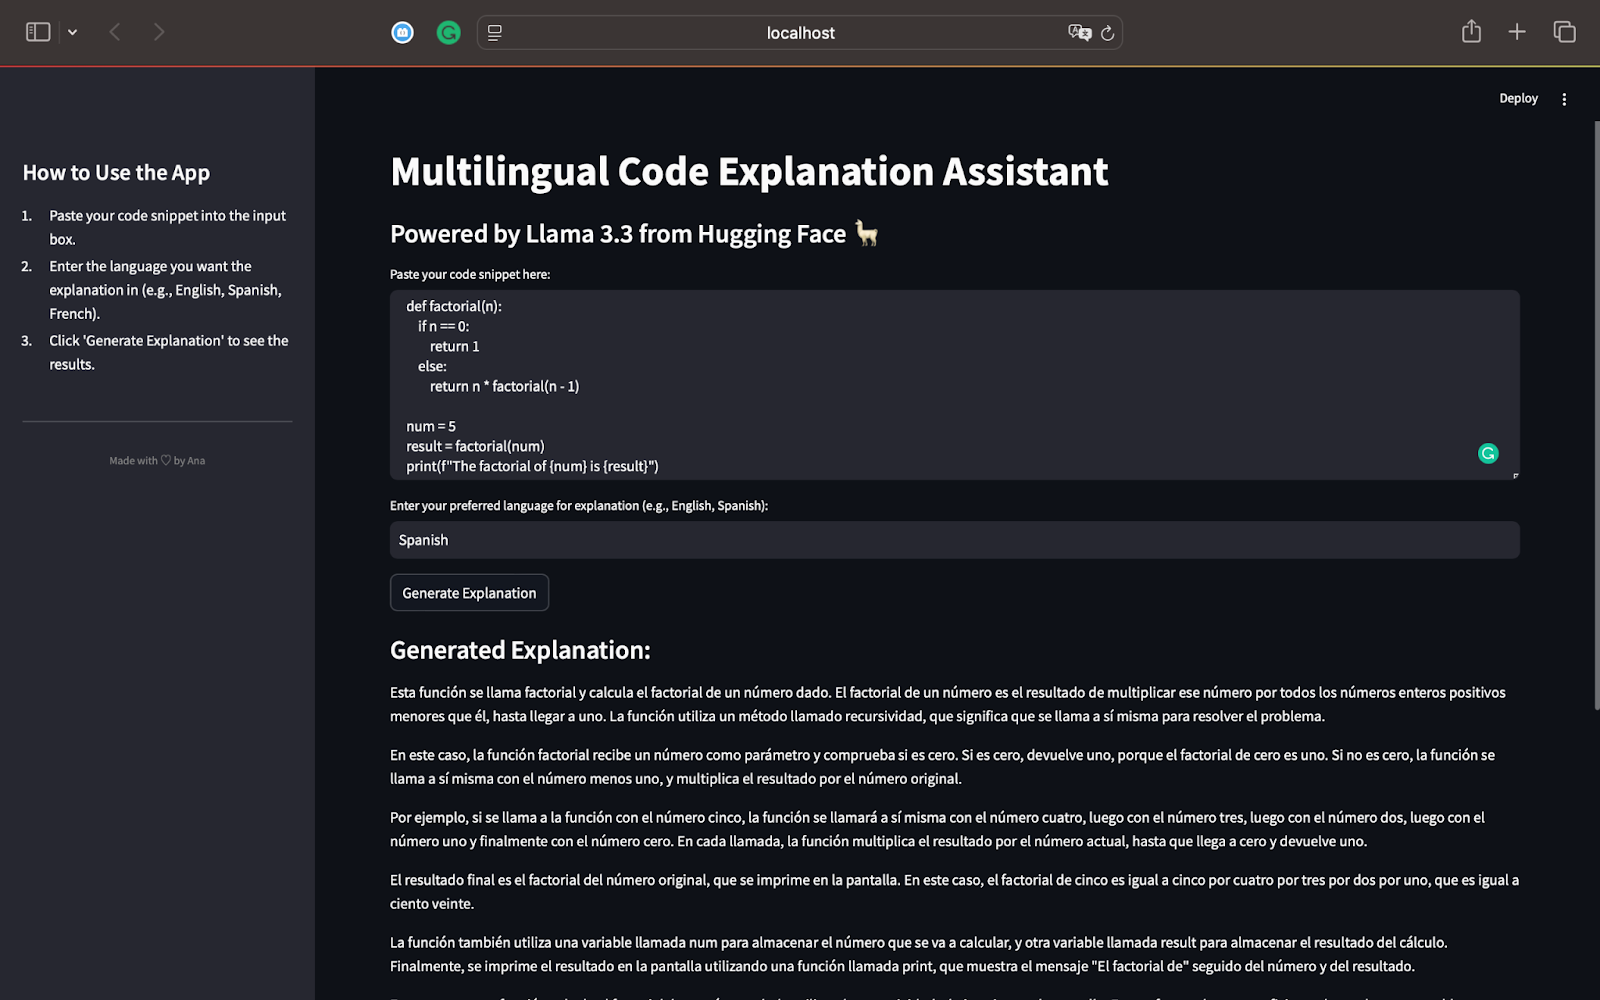
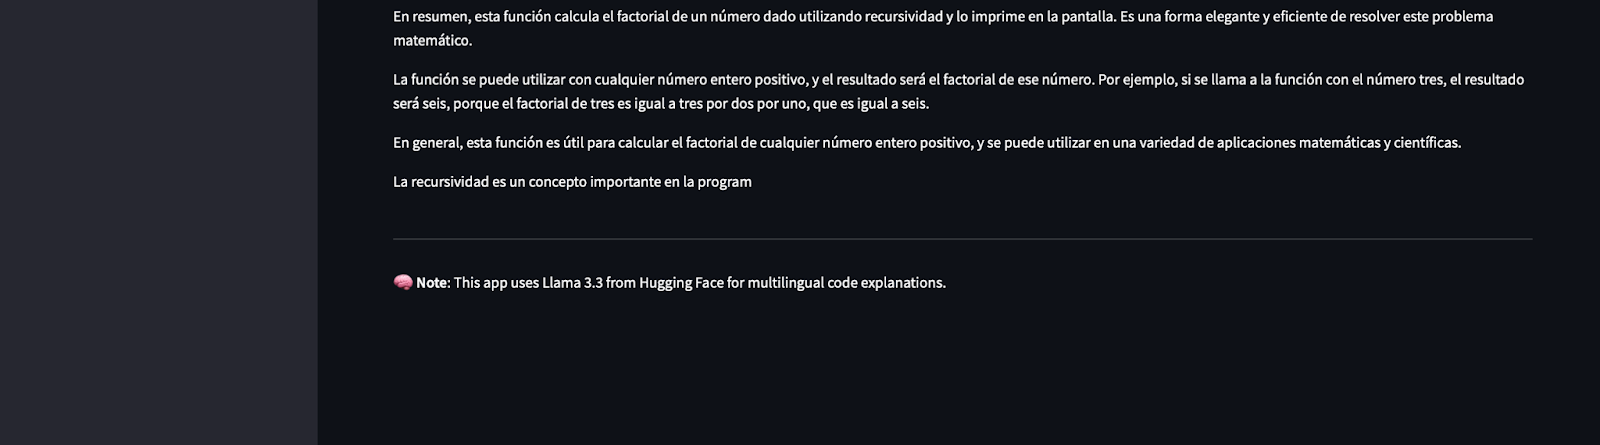
एक स्पैनिश वक्ता के रूप में, मैं पुष्टि कर सकता/सकती हूँ कि व्याख्या ठीक से पहचानती है कि यह कोड रिकर्शन का उपयोग करके किसी संख्या का फैक्टोरियल निकालता है। यह चरण-दर-चरण बताता है कि रिकर्शन कैसे काम करता है और इसे सरल शब्दों में तोड़ता है।
मॉडल रिकर्शन प्रक्रिया समझाता है और दिखाता है कि फ़ंक्शन n के घटते मानों के साथ खुद को कैसे कॉल करता है जब तक कि यह 0 तक न पहुँच जाए।
व्याख्या पूरी तरह से स्पैनिश में है, जैसा अनुरोध किया गया था, जो Llama 3.3 की बहुभाषी क्षमता को दर्शाता है।
सरल वाक्यों का उपयोग रिकर्शन की अवधारणा को समझना आसान बनाता है, भले ही पाठक प्रोग्रामिंग से अपरिचित हों।
यह सारांश देता है और बताता है कि 3 जैसे अन्य इनपुट्स के लिए रिकर्शन कैसे काम करता है, और प्रोग्रामिंग में एक प्रभावी समस्या-समाधान अवधारणा के रूप में रिकर्शन के महत्व को भी रेखांकित करता है।
यह पहला टेस्ट Llama 3.3 की क्षमता को उजागर करता है:
अब जबकि हमने एक Python स्क्रिप्ट का परीक्षण कर लिया है, हम JavaScript या SQL जैसी अन्य प्रोग्रामिंग भाषाओं पर जा सकते हैं। इससे हमें तर्क, कोडिंग और बहुभाषीय समर्थन में Llama 3.3 की क्षमताओं को और खोजने में मदद मिलेगी।
इस परीक्षण में, हम मूल्यांकन करेंगे कि बहुभाषीय कोड व्याख्या ऐप JavaScript फंक्शन को कितना अच्छी तरह संभालता है और फ्रेंच में व्याख्या कैसे जनरेट करता है।
हम निम्न JavaScript कोड स्निपेट का उपयोग करते हैं जिसमें मैंने जानबूझकर संदिग्ध नाम वाले वैरिएबल चुने हैं ताकि देखें कि मॉडल इसे कितना अच्छी तरह संभालता है:
function x(a) {
    if (a === 1) return 1;
    return a * x(a - 1);
}
const y = 6;
const z = x(y);
console.log("The result is: " + z);
यह कोड स्निपेट एक रिकर्सिव फंक्शन x(a) परिभाषित करता है जो दिए गए संख्या a का फैक्टरियल निकालता है। बेस कंडीशन जाँचती है कि a === 1 है या नहीं। यदि हाँ, तो यह 1 लौटाता है। अन्यथा, फंक्शन खुद को a - 1 के साथ कॉल करता है और परिणाम को a से गुणा करता है। कॉन्स्टेंट y को 6 सेट किया गया है, इसलिए फंक्शन x 6×5×4×3×2×1 की गणना करता है। अंत में, परिणाम वैरिएबल z में संग्रहीत होता है और console.log के जरिए प्रदर्शित किया जाता है। यहाँ आउटपुट और उसका अंग्रेज़ी में अनुवाद है:
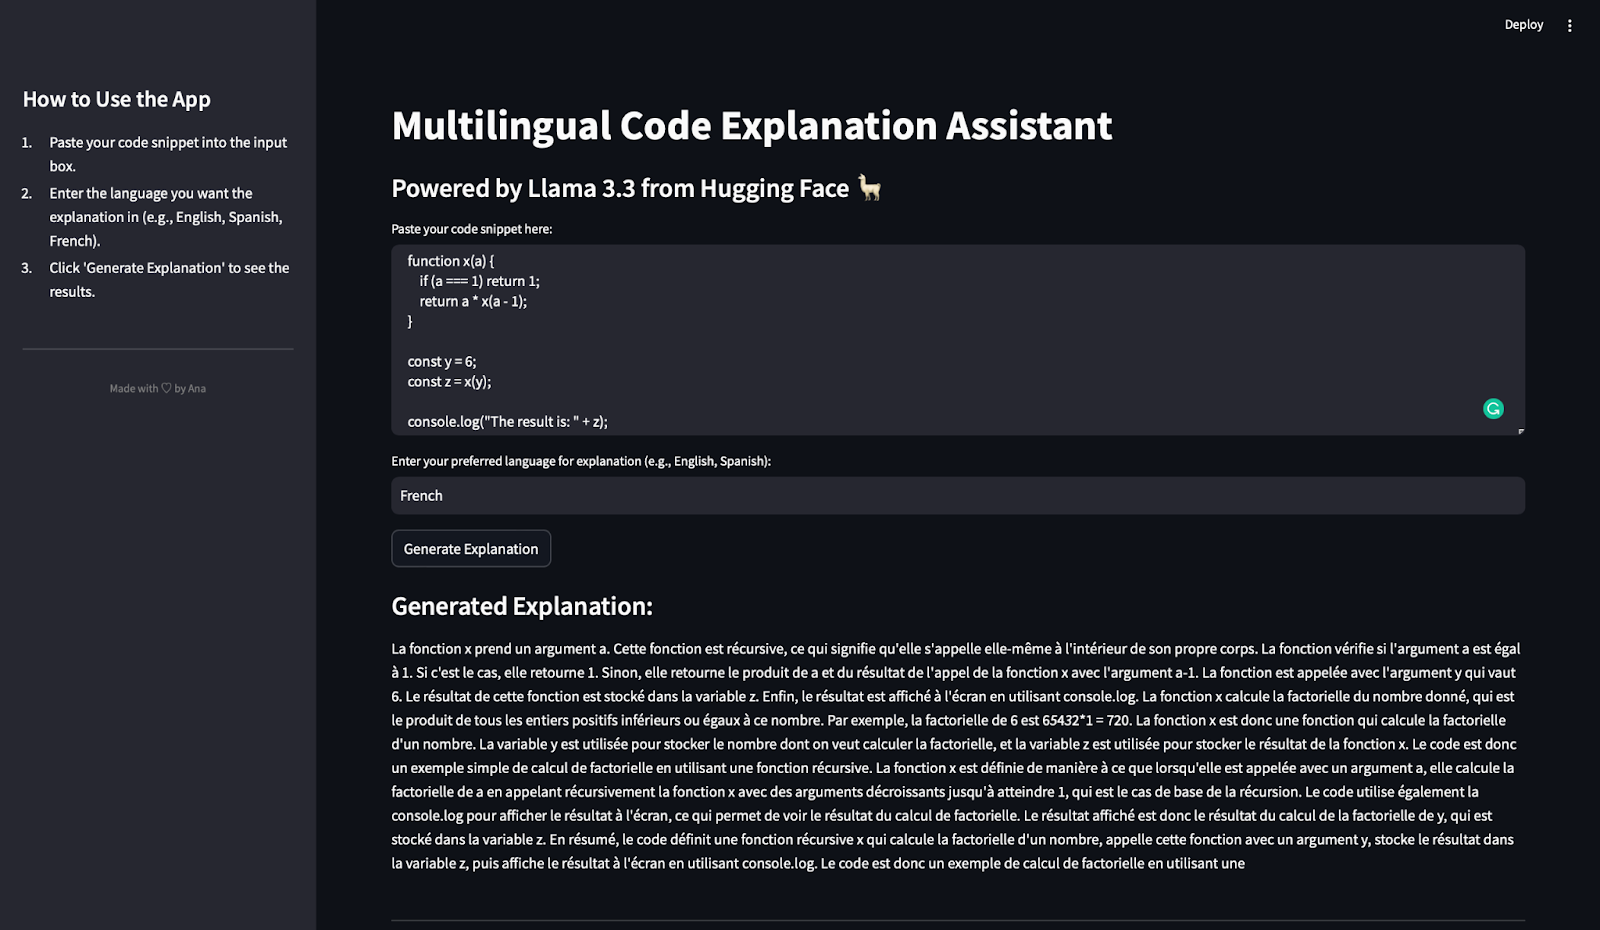
नोट: आप देख सकते हैं कि प्रतिक्रिया अचानक कटी हुई लगती है, लेकिन ऐसा इसलिए है क्योंकि हमने आउटपुट को 500 टोकन तक सीमित किया है!
इसे अनुवादित करने के बाद, मैंने निष्कर्ष निकाला कि व्याख्या सही ढंग से पहचानती है कि फंक्शन x(a) रिकर्सिव है। यह बताता है कि रिकर्शन कैसे काम करता है, बेस केस (a === 1) और रिकर्सिव केस (a * x(a - 1)) को समझाते हुए। व्याख्या स्पष्ट रूप से दिखाती है कि फंक्शन 6 का फैक्टरियल कैसे निकालता है और y (इनपुट मान) और z (परिणाम) की भूमिकाओं का उल्लेख करती है। यह यह भी दर्शाती है कि परिणाम दिखाने के लिए console.log का उपयोग कैसे किया गया है।
व्याख्या अनुरोधानुसार पूरी तरह फ्रेंच में है। “récursive” (रिकर्सिव), “factorielle” (फैक्टरियल), और “produit” (प्रोडक्ट) जैसे तकनीकी शब्दों का सही उपयोग हुआ है। और सिर्फ इतना ही नहीं, यह पहचानता है कि यह कोड रिकर्सिव तरीके से किसी संख्या का फैक्टरियल निकालता है।
व्याख्या अत्यधिक तकनीकी जार्गन से बचती है और रिकर्शन को सरल बनाती है, जिससे प्रोग्रामिंग में नए पाठकों के लिए यह सुलभ हो जाती है।
यह परीक्षण दर्शाता है कि Llama 3.3:
अब जब हमने ऐप का परीक्षण Python और JavaScript के साथ कर लिया है, तो इसकी बहुभाषीय और तर्क क्षमताओं का आगे मूल्यांकन करने के लिए इसे एक SQL क्वेरी के साथ टेस्ट करते हैं।
आखिरी परीक्षण में, हम मूल्यांकन करेंगे कि बहुभाषीय कोड व्याख्या ऐप एक SQL क्वेरी को कैसे संभालता है और जर्मन में व्याख्या कैसे जनरेट करता है। उपयोग किया गया SQL स्निपेट यह है:
SELECT a.id, SUM(b.value) AS total_amount
FROM table_x AS a
JOIN table_y AS b ON a.ref_id = b.ref
WHERE b.flag = 1
GROUP BY a.id
HAVING SUM(b.value) > 1000
ORDER BY total_amount DESC;
यह क्वेरी id कॉलम का चयन करती है और प्रत्येक id के लिए कुल मान (SUM(b.value)) की गणना करती है। यह दो टेबलों से डेटा पढ़ती है: table_x (उपनाम a) और table_y (उपनाम b)। फिर, JOIN शर्त का उपयोग करके उन पंक्तियों को जोड़ती है जहाँ a.ref_id = b.ref है। यह उन पंक्तियों को फ़िल्टर करती है जहाँ b.flag = 1 है और डेटा को a.id के अनुसार समूहित करती है। HAVING क्लॉज केवल उन समूहों को शामिल करने के लिए फ़िल्टर करता है जहाँ b.value का योग 1000 से अधिक है। अंत में, यह परिणामों को total_amount के अनुसार अवरोही क्रम में क्रमित करती है।
Generate explanation बटन दबाने के बाद, हमें यह मिला:
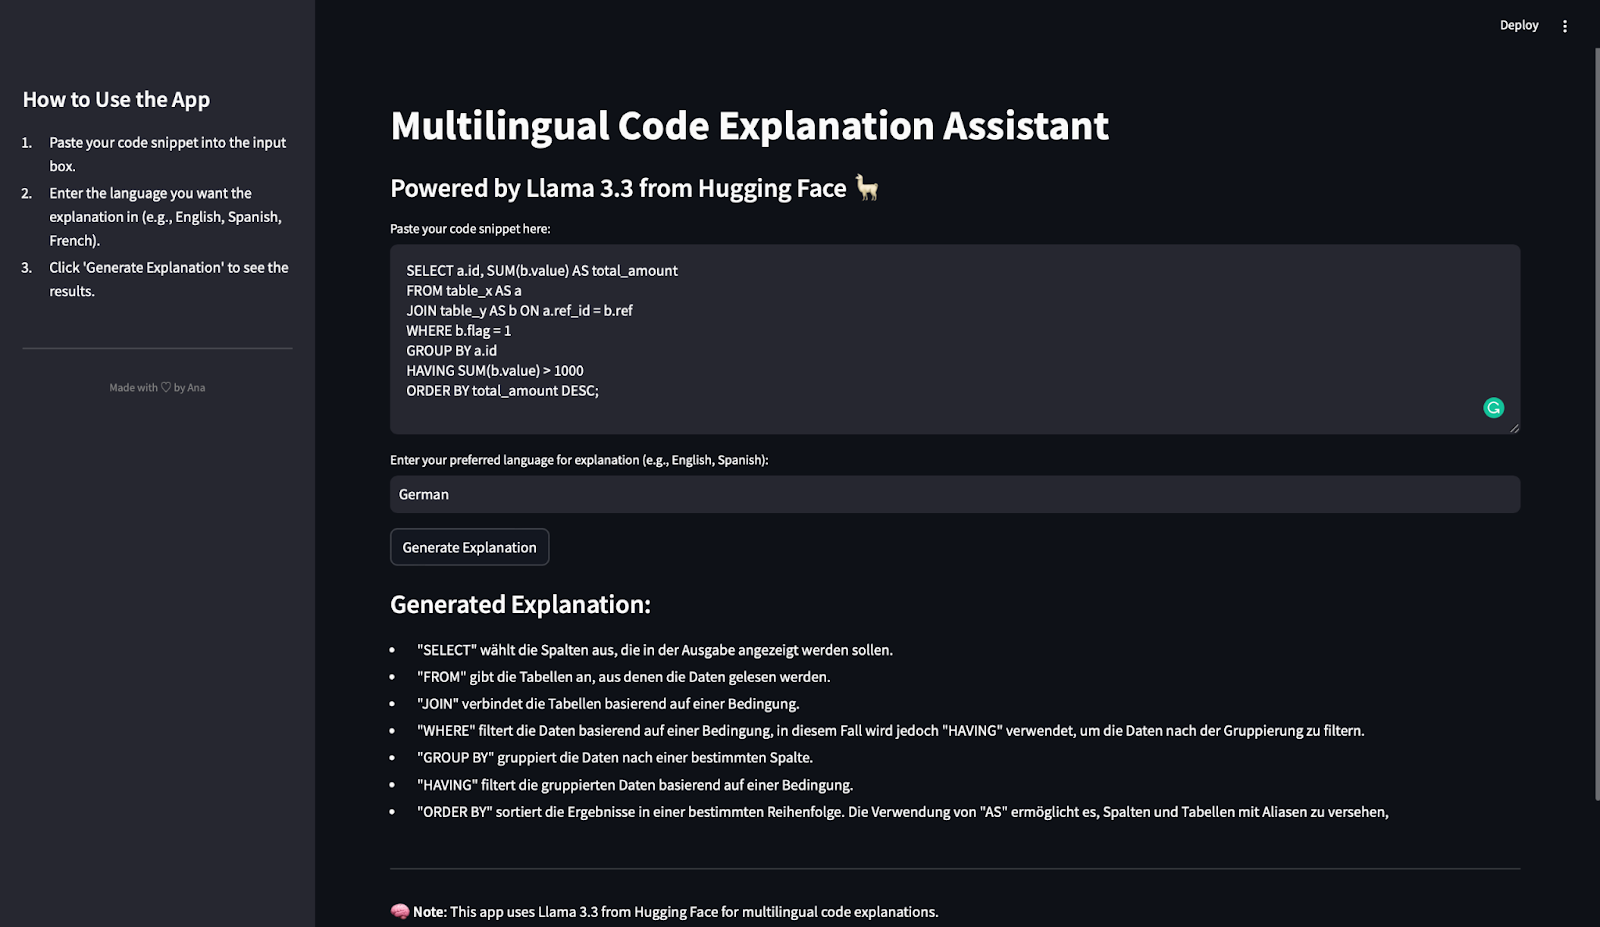
जनरेट की गई व्याख्या संक्षिप्त, सटीक और सुव्यवस्थित है। प्रत्येक प्रमुख SQL क्लॉज (SELECT, FROM, JOIN, WHERE, GROUP BY, HAVING, और ORDER BY) को स्पष्ट रूप से समझाया गया है। साथ ही, विवरण SQL के निष्पादन क्रम से मेल खाता है, जो पाठकों को चरणबद्ध तरीके से क्वेरी लॉजिक का अनुसरण करने में मदद करता है।
व्याख्या अनुरोधानुसार पूरी तरह जर्मन में है।
मुख्य SQL शब्द (जैसे, "filtert", "gruppiert", "sortiert") संदर्भानुसार सटीकता से उपयोग हुए हैं। व्याख्या बताती है कि HAVING का उपयोग समूहित परिणामों को फ़िल्टर करने के लिए किया जाता है, जो शुरुआती लोगों के लिए अक्सर भ्रम का कारण होता है। यह उपनामों (AS) के उपयोग को भी स्पष्टता के लिए टेबल और कॉलम का नाम बदलने हेतु समझाता है।
व्याख्या अत्यधिक जटिल शब्दावली से बचती है और प्रत्येक क्लॉज के कार्य पर ध्यान केंद्रित करती है। इससे शुरुआती लोगों के लिए यह समझना आसान हो जाता है कि क्वेरी कैसे काम करती है।
यह परीक्षण दर्शाता है कि Llama 3.3:
हमने ऐप को Python, JavaScript और SQL के कोड स्निपेट्स के साथ टेस्ट किया, और स्पैनिश, फ्रेंच तथा जर्मन में व्याख्याएँ जनरेट कीं। हर टेस्ट में:
इस परीक्षण के साथ, हमने पुष्टि की कि हमारे द्वारा बनाया गया ऐप विभिन्न प्रोग्रामिंग भाषाओं और प्राकृतिक भाषाओं में कोड की व्याख्या करने के लिए बहुमुखी, विश्वसनीय और प्रभावी है।
बधाई हो! आपने Streamlit और Hugging Face के Llama 3.3 का उपयोग करके एक पूर्णतः कार्यात्मक बहुभाषीय कोड व्याख्या सहायक बना लिया है।
इस ट्यूटोरियल में, आपने सीखा:
यह प्रोजेक्ट कोड तर्क, बहुभाषीय समर्थन और शैक्षणिक सामग्री में Llama 3.3 की क्षमताओं का पता लगाने के लिए एक शानदार शुरुआती बिंदु है। इस मॉडल की शक्तिशाली विशेषताओं का अन्वेषण जारी रखने के लिए बेझिझक अपना ऐप बनाएँ!
इन कोर्सेज के साथ एआई सीखें!
कोर्स
कोर्स
लर्निंग पाथ