
Last chance! 50% off DataCamp Premium
Sale ends in
Per iniziare, divideremo il tutto in alcuni passaggi. Prima vedremo come accedere a Llama 3.3 tramite Hugging Face, configurare il tuo account e ottenere le autorizzazioni necessarie. Poi creeremo l’ambiente di progetto e installeremo le dipendenze richieste.
Un modo per accedere a Llama 3.3 è tramite Hugging Face, una delle piattaforme più popolari per l’hosting di modelli di machine learning. Per usare Llama 3.3 tramite la Inference API di Hugging Face, ti serviranno:
Ottenuto l’accesso al modello, configuriamo l’ambiente dell’app. Per prima cosa, creiamo una cartella per questo progetto. Apri il terminale, vai nella posizione in cui vuoi creare la cartella del progetto ed esegui:
mkdir multilingual-code-explanation
cd multilingual-code-explanation
Poi creeremo un file chiamato app.py per il codice: touch app.py Ora creiamo un ambiente e lo attiviamo:
python3 -m venv venv
source venv/bin/activate’Ora che l’ambiente è pronto, installiamo le librerie necessarie. Assicurati di usare Python 3.8+. Nel terminale, esegui il seguente comando per installare Streamlit, Requests e le librerie di Hugging Face:
pip install streamlit requests transformers huggingface-hubA questo punto dovresti avere:
Completata la configurazione, siamo pronti a costruire l’app! Nella prossima sezione inizieremo a programmare l’app per spiegare codice multilingue passo dopo passo.
Il backend comunica con la Hugging Face API per inviare lo snippet di codice e ricevere la spiegazione.
Per prima cosa dobbiamo importare la libreria requests. Questa libreria ci permette di inviare richieste HTTP alle API. All’inizio del file app.py, scrivi:
import requestsPer interagire con l’API di Llama 3.3 ospitata su Hugging Face, ti servono:
HUGGINGFACE_API_KEY = "hf_your_api_key_here"  # Replace with your actual API key
API_URL = "https://api-inference.huggingface.co/models/meta-llama/Llama-3.3-70B-Instruct"
HEADERS = {"Authorization": f"Bearer {HUGGINGFACE_API_KEY}"}
Nel codice sopra:
Ora scriveremo una funzione per inviare una richiesta all’API. La funzione:
def query_llama3(input_text, language):
   # Create the prompt
   prompt = (
       f"Provide a simple explanation of this code in {language}:\n\n{input_text}\n"
       f"Only output the explanation and nothing else. Make sure that the output is written in {language} and only in {language}"
   )
   # Payload for the API
   payload = {
       "inputs": prompt,
       "parameters": {"max_new_tokens": 500, "temperature": 0.3},
   }

   # Make the API request
   response = requests.post(API_URL, headers=HEADERS, json=payload)
   if response.status_code == 200:
       result = response.json()

       # Extract the response text
       full_response = result[0]["generated_text"] if isinstance(result, list) else result.get("generated_text", "")

       # Clean up: Remove the prompt itself from the response
       clean_response = full_response.replace(prompt, "").strip()
       # Further clean any leading colons or formatting
       if ":" in clean_response:
           clean_response = clean_response.split(":", 1)[-1].strip()

       return clean_response or "No explanation available."
   else:
       return f"Error: {response.status_code} - {response.text}"
Il prompt dice a Llama 3.3 di spiegare lo snippet di codice nella lingua desiderata.
Disclaimer: ho sperimentato diversi prompt per trovare quello che produceva il risultato migliore, quindi c’è stato sicuramente un elemento di prompt engineering!
Successivamente viene definito il payload. Per l’input specifichiamo che il prompt viene inviato al modello. Nei parametri, max_new_tokens controlla la lunghezza della risposta, mentre temperature regola il livello di creatività dell’output.
La funzione requests.post() invia i dati a Hugging Face. Se la risposta ha esito positivo (status_code == 200), il testo generato viene estratto. In caso di errore, viene restituito un messaggio descrittivo.
Infine, ci sono passaggi per pulire e formattare correttamente l’output. Questo garantisce una presentazione ordinata, che migliora notevolmente l’esperienza utente.
Il frontend è dove gli utenti interagiranno con l’app. Streamlit è una libreria che consente di creare web app interattive con solo codice Python e rende questo processo semplice e intuitivo. È quello che useremo per costruire il frontend della nostra app. Adoro Streamlit per creare demo e POC!
All’inizio del file app.py aggiungi:
import streamlit as stUseremo set_page_config() per definire il titolo dell’app e il layout. Nel codice seguente:
page_title: imposta il titolo della scheda del browser.layout="wide": consente all’app di usare l’intera larghezza dello schermo.st.set_page_config(page_title="Multilingual Code Explanation Assistant", layout="wide")Per aiutare gli utenti a capire come usare l’app, aggiungeremo istruzioni nella sidebar: nel codice qui sotto:
st.sidebar.title(): crea un titolo per la sidebar.st.sidebar.markdown(): aggiunge testo con semplici istruzioni.divider(): aggiunge una pulita separazione visiva.st.sidebar.title("How to Use the App")
st.sidebar.markdown("""
1. Paste your code snippet into the input box.
2. Enter the language you want the explanation in (e.g., English, Spanish, French).
3. Click 'Generate Explanation' to see the results.
""")
st.sidebar.divider()
st.sidebar.markdown(
"""
<div style="text-align: center;color: grey;">
Made with ♡ by Ana
</div>
""",
unsafe_allow_html=True
)Aggiungeremo il titolo principale e il sottotitolo alla pagina:
st.title("Multilingual Code Explanation Assistant")
st.markdown("### Powered by Llama 3.3 from Hugging Face 🦙")
Ora, per permettere agli utenti di incollare il codice e scegliere la lingua preferita, ci servono campi di input. Poiché il testo del codice sarà probabilmente più lungo del nome della lingua, scegliamo un’area di testo per il codice e un campo di testo per la lingua:
text_area(): crea un riquadro ampio per incollare il codice.text_input(): consente di digitare la lingua.code_snippet = st.text_area("Paste your code snippet here:", height=200)
preferred_language = st.text_input("Enter your preferred language for explanation (e.g., English, Spanish):")Ora aggiungiamo un pulsante per generare la spiegazione. Se l’utente inserisce il codice e la lingua e poi clicca sul pulsante Generate Explanation, viene generata una risposta.
if st.button("Generate Explanation"):
	   if code_snippet and preferred_language:
	       with st.spinner("Generating explanation... ⏳"):
	           explanation = query_llama3(code_snippet, preferred_language)
	       st.subheader("Generated Explanation:")
	       st.write(explanation)
	   else:
	       st.warning("⚠️ Please provide both the code snippet and preferred language.")
Quando si clicca sul pulsante, l’app:
Per concludere, aggiungiamo un footer:
st.markdown("---")
st.markdown("🧠 **Note**: This app uses Llama 3.3 from Hugging Face for multilingual code explanations.")È il momento di eseguire l’app! Per avviarla, esegui questo comando nel terminale:
streamlit run app.pyL’app si aprirà nel browser e potrai iniziare a sperimentare!
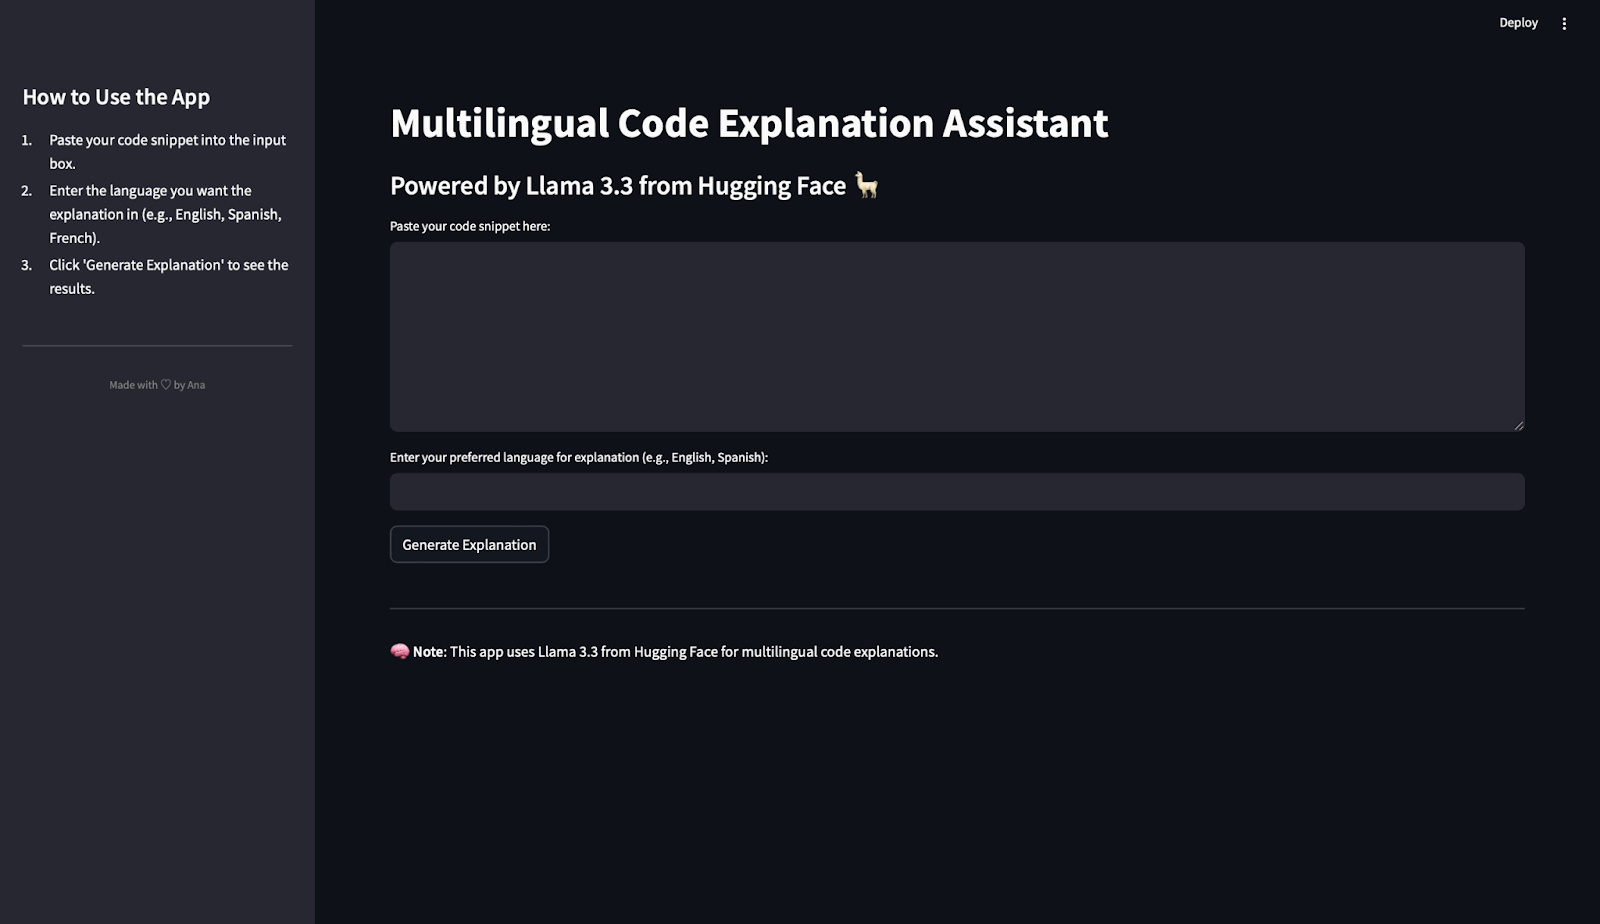
Ora che abbiamo costruito la nostra app per spiegare codice multilingue, è il momento di testare quanto bene funziona il modello. In questa sezione useremo l’app per elaborare un paio di snippet di codice e valuteremo le spiegazioni generate in lingue diverse.
Per il primo test, partiamo da uno script Python che calcola il fattoriale di un numero usando la ricorsione. Ecco il codice che useremo:
def factorial(n):
    if n == 0:
        return 1
    else:
        return n * factorial(n - 1)
num = 5
result = factorial(num)
print(f"The factorial of {num} is {result}")
Questo script definisce una funzione ricorsiva factorial(n) che calcola il fattoriale di un numero dato. Per num = 5, la funzione calcolerà 5×4×3×2×1, ottenendo 120. Il risultato viene stampato a schermo tramite l’istruzione print(). Ecco l’output quando generiamo una spiegazione in spagnolo:
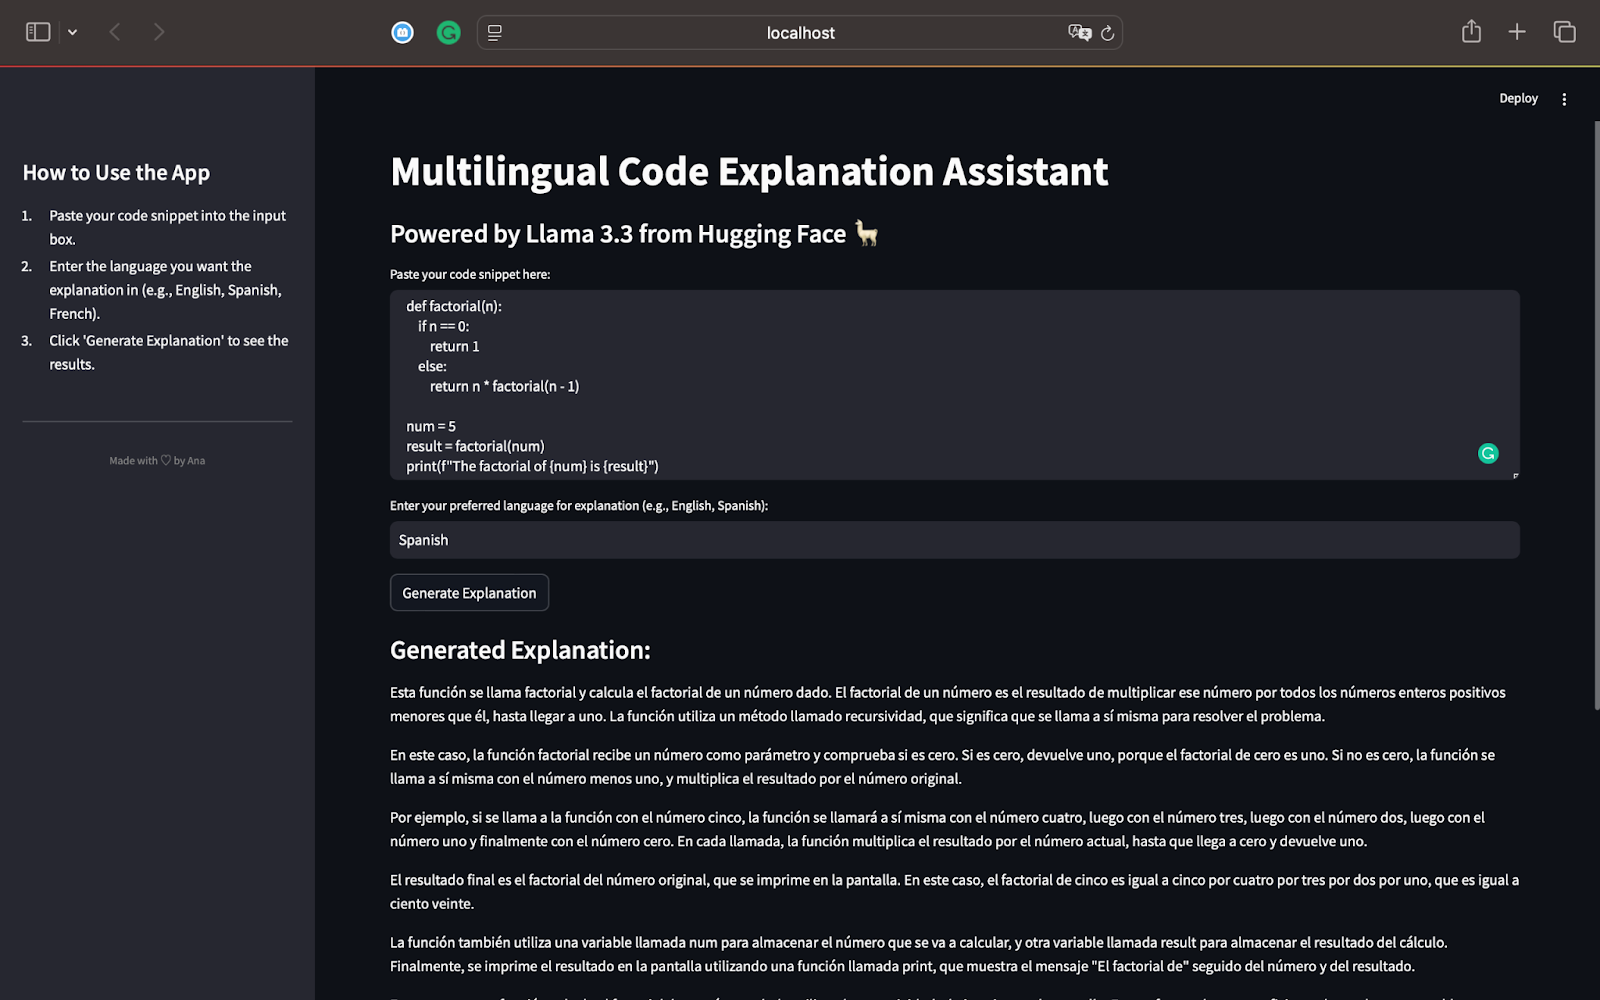
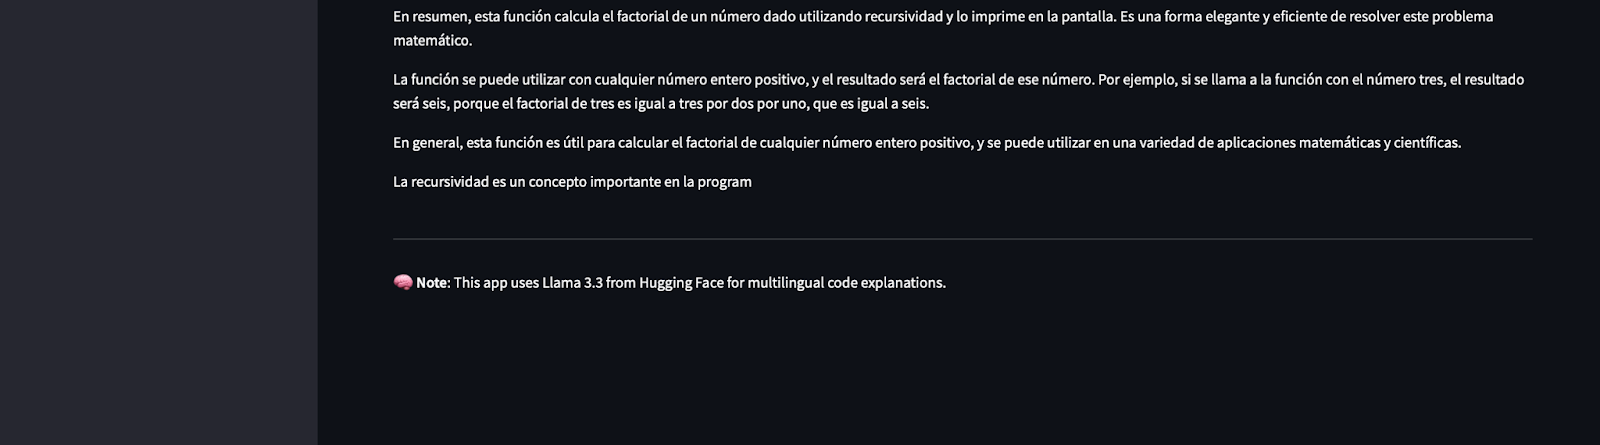
Come parlante spagnola, posso confermare che la spiegazione identifica correttamente che il codice calcola il fattoriale di un numero usando la ricorsione. Illustra passo passo come funziona la ricorsione, scomponendola in termini semplici.
Il modello spiega il processo ricorsivo e mostra come la funzione si richiama con valori decrescenti di n fino a raggiungere 0.
La spiegazione è interamente in spagnolo, come richiesto, a dimostrazione delle capacità multilingue di Llama 3.3.
L’uso di frasi semplici rende il concetto di ricorsione facile da seguire anche per chi non ha familiarità con la programmazione.
Riassume e menziona come funzioni la ricorsione per altri input, come 3, e l’importanza della ricorsione come concetto efficiente di problem solving nella programmazione.
Questo primo test mette in evidenza la potenza di Llama 3.3:
Ora che abbiamo testato uno script Python, possiamo passare ad altri linguaggi di programmazione come JavaScript o SQL. Questo ci aiuterà a esplorare ulteriormente le capacità di Llama 3.3 in termini di ragionamento, coding e supporto multilingue.
In questo test valuteremo quanto bene l’app per spiegare codice multilingue gestisce una funzione JavaScript e genera una spiegazione in francese.
Usiamo il seguente snippet JavaScript in cui ho scelto intenzionalmente variabili ambigue per vedere come il modello gestisce la situazione:
function x(a) {
    if (a === 1) return 1;
    return a * x(a - 1);
}
const y = 6;
const z = x(y);
console.log("The result is: " + z);
Questo snippet definisce una funzione ricorsiva x(a) che calcola il fattoriale di un numero a. La condizione di base verifica se a === 1. In tal caso restituisce 1. Altrimenti, la funzione richiama se stessa con a - 1 e moltiplica il risultato per a. La costante y è impostata a 6, quindi la funzione x calcola 6×5×4×3×2×1. Infine, il risultato è memorizzato nella variabile z e visualizzato con console.log. Ecco l’output e la traduzione in inglese:
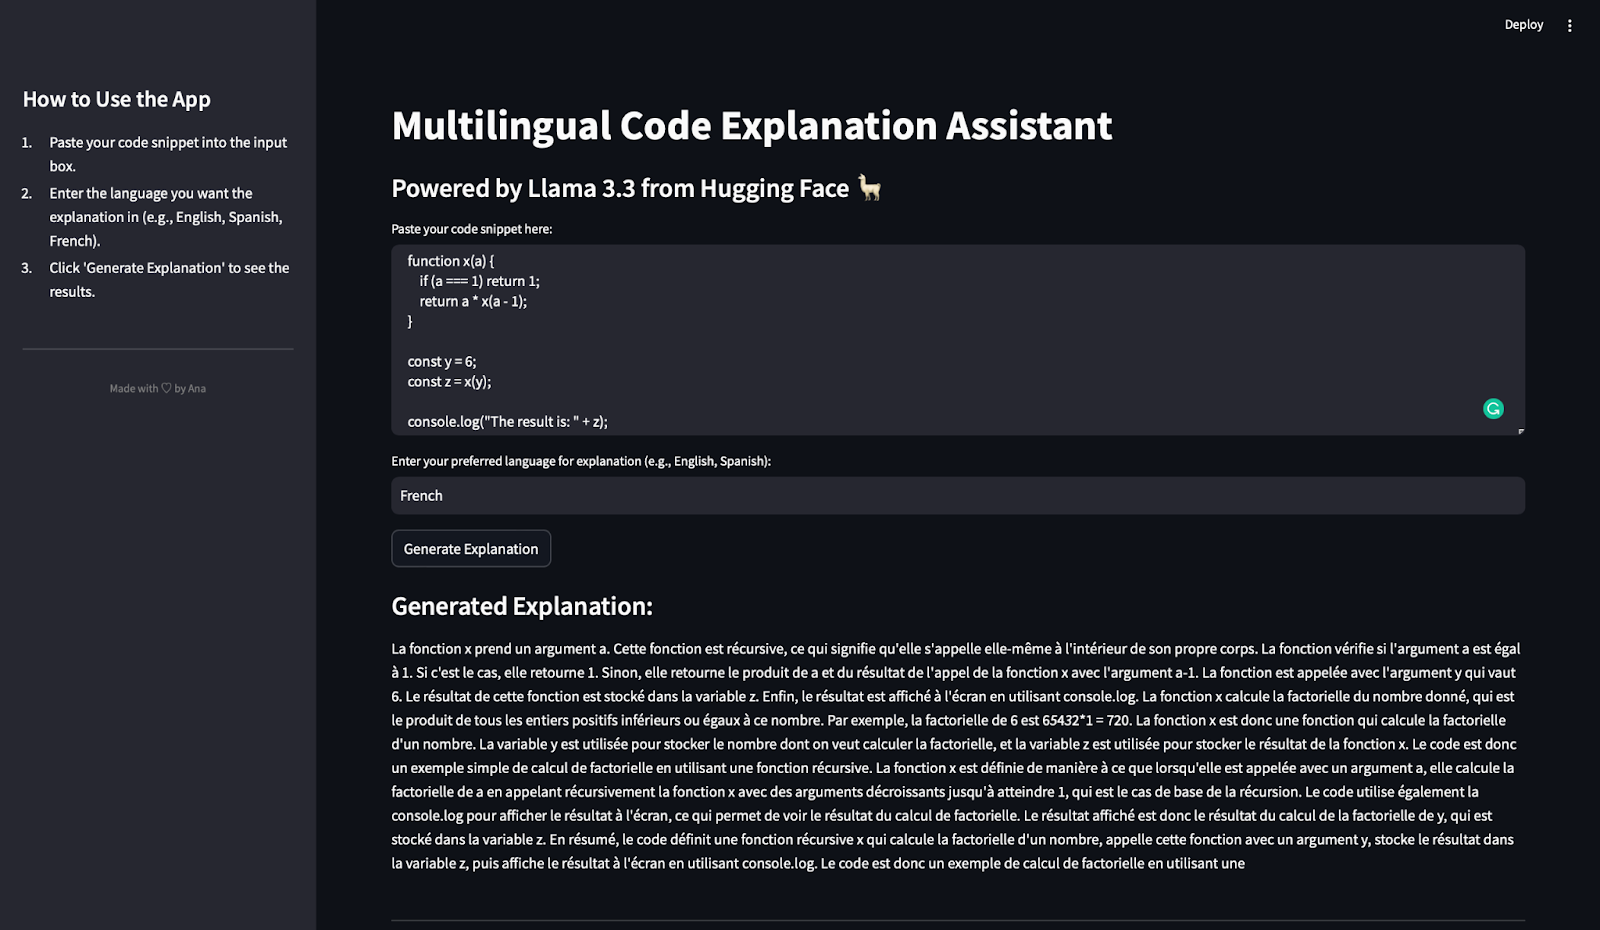
Nota: sembra che la risposta sia improvvisamente troncata, ma è perché abbiamo limitato l’output a 500 token!
Dopo averla tradotta, ho concluso che la spiegazione identifica correttamente che la funzione x(a) è ricorsiva. Scompone come funziona la ricorsione, spiegando il caso base (a === 1) e il caso ricorsivo (a * x(a - 1)). La spiegazione mostra esplicitamente come la funzione calcoli il fattoriale di 6 e menziona i ruoli di y (il valore in input) e z (il risultato). Nota anche come console.log venga usato per visualizzare il risultato.
La spiegazione è interamente in francese, come richiesto. I termini tecnici come “récursive” (ricorsiva), “factorielle” (fattoriale) e “produit” (prodotto) sono usati correttamente. E non solo, identifica che questo codice calcola il fattoriale di un numero in modo ricorsivo.
La spiegazione evita gergo eccessivamente tecnico e semplifica la ricorsione, rendendola accessibile a chi è alle prime armi con la programmazione.
Questo test dimostra che Llama 3.3:
Ora che abbiamo testato l’app con Python e JavaScript, passiamo a testarla con una query SQL per valutare ulteriormente le sue capacità multilingue e di ragionamento.
In quest’ultimo test valuteremo come l’app multilingue per spiegare codice gestisce una query SQL e genera una spiegazione in tedesco. Ecco lo snippet SQL usato:
SELECT a.id, SUM(b.value) AS total_amount
FROM table_x AS a
JOIN table_y AS b ON a.ref_id = b.ref
WHERE b.flag = 1
GROUP BY a.id
HAVING SUM(b.value) > 1000
ORDER BY total_amount DESC;
Questa query seleziona la colonna id e calcola il valore totale (SUM(b.value)) per ogni id. Legge i dati da due tabelle: table_x (alias a) e table_y (alias b). Quindi usa una condizione di JOIN per collegare le righe in cui a.ref_id = b.ref. Filtra le righe in cui b.flag = 1 e raggruppa i dati per a.id. La clausola HAVING filtra i gruppi per includere solo quelli in cui la somma di b.value è maggiore di 1000. Infine, ordina i risultati per total_amount in ordine decrescente.
Dopo aver premuto il pulsante per generare la spiegazione, ecco cosa otteniamo:
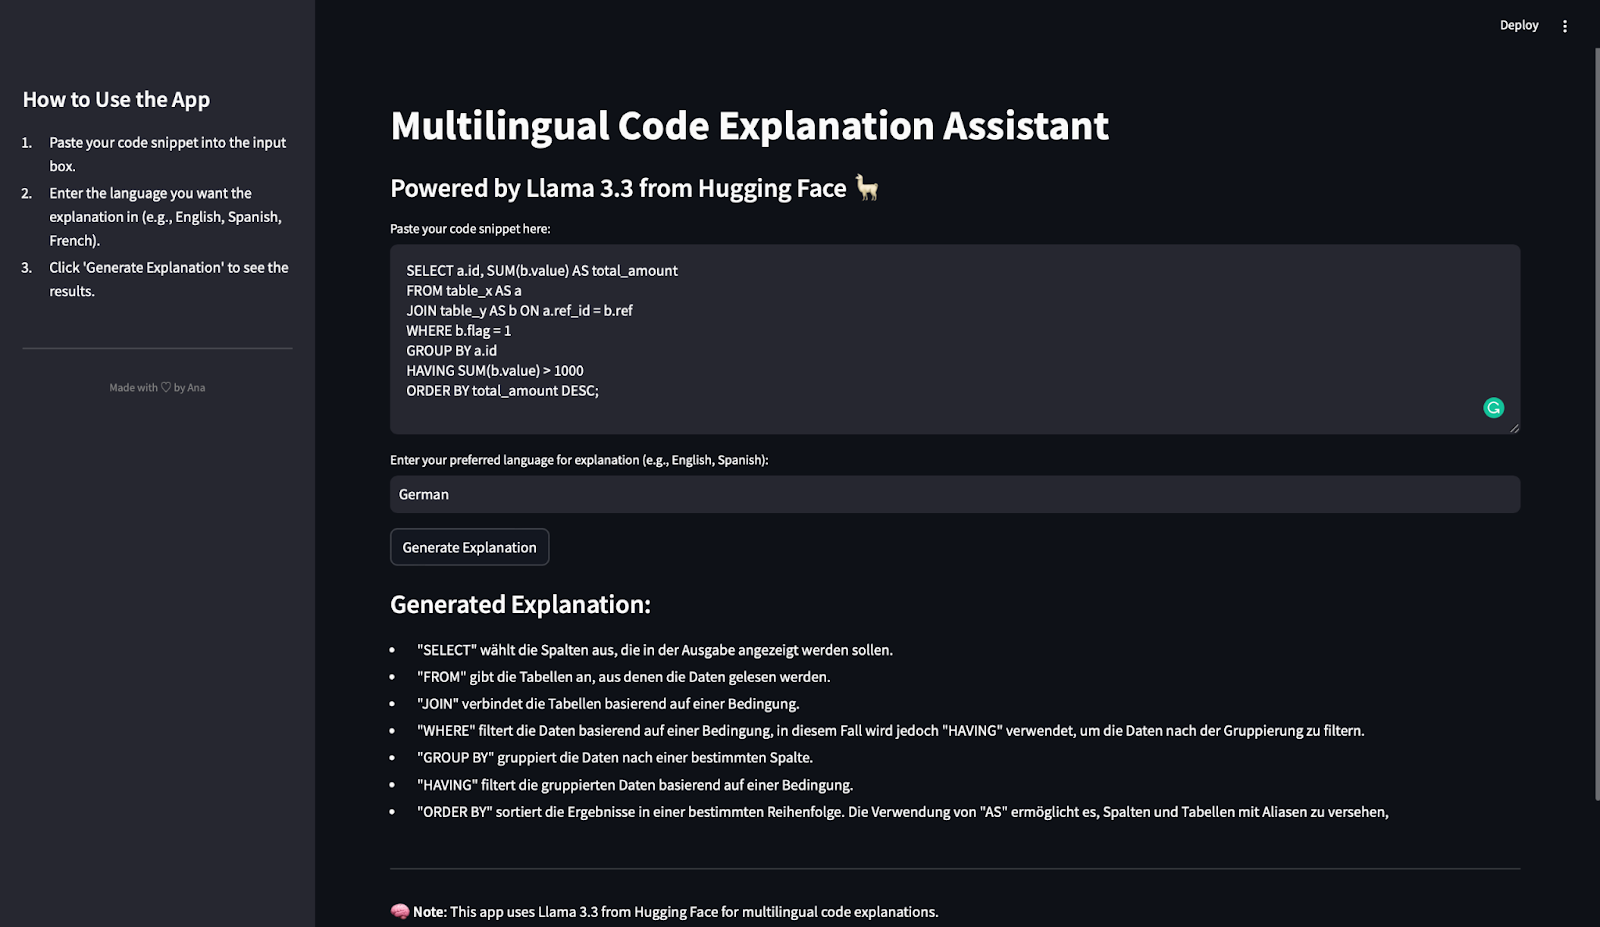
La spiegazione generata è concisa, accurata e ben strutturata. Ogni clausola SQL chiave (SELECT, FROM, JOIN, WHERE, GROUP BY, HAVING e ORDER BY) è spiegata chiaramente. Inoltre, la descrizione rispecchia l’ordine di esecuzione in SQL, aiutando i lettori a seguire la logica della query passo passo.
La spiegazione è interamente in tedesco, come richiesto.
I termini SQL chiave (ad es., "filtert", "gruppiert", "sortiert") sono usati correttamente nel contesto. La spiegazione identifica che HAVING viene usata per filtrare i risultati raggruppati, un punto spesso fonte di confusione per i principianti. Spiega anche l’uso degli alias (AS) per rinominare tabelle e colonne per maggiore chiarezza.
La spiegazione evita una terminologia eccessivamente complessa e si concentra sulla funzione di ciascuna clausola. Questo la rende facile da comprendere per i principianti.
Questo test dimostra che Llama 3.3:
Abbiamo testato l’app con snippet di codice in Python, JavaScript e SQL, generando spiegazioni in spagnolo, francese e tedesco. In ogni test:
Con questo test, abbiamo confermato che l’app che abbiamo costruito è versatile, affidabile ed efficace per spiegare codice in diversi linguaggi di programmazione e lingue naturali.
Congratulazioni! Hai costruito un assistant per spiegare codice multilingue pienamente funzionante usando Streamlit e Llama 3.3 di Hugging Face.
In questo tutorial hai imparato:
Questo progetto è un ottimo punto di partenza per esplorare le capacità di Llama 3.3 nel ragionamento sul codice, nel supporto multilingue e nei contenuti didattici. Sentiti libero di creare la tua app per continuare a esplorare le potenti funzionalità di questo modello!
Impara l'AI con questi corsi!
Corso
Corso
Programma
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min




