
学习路径
使用 LangChain 进行 AI 工程开发
21 小时
在实践中,团队通常会根据他们要衡量的目标,选择以下方法之一:
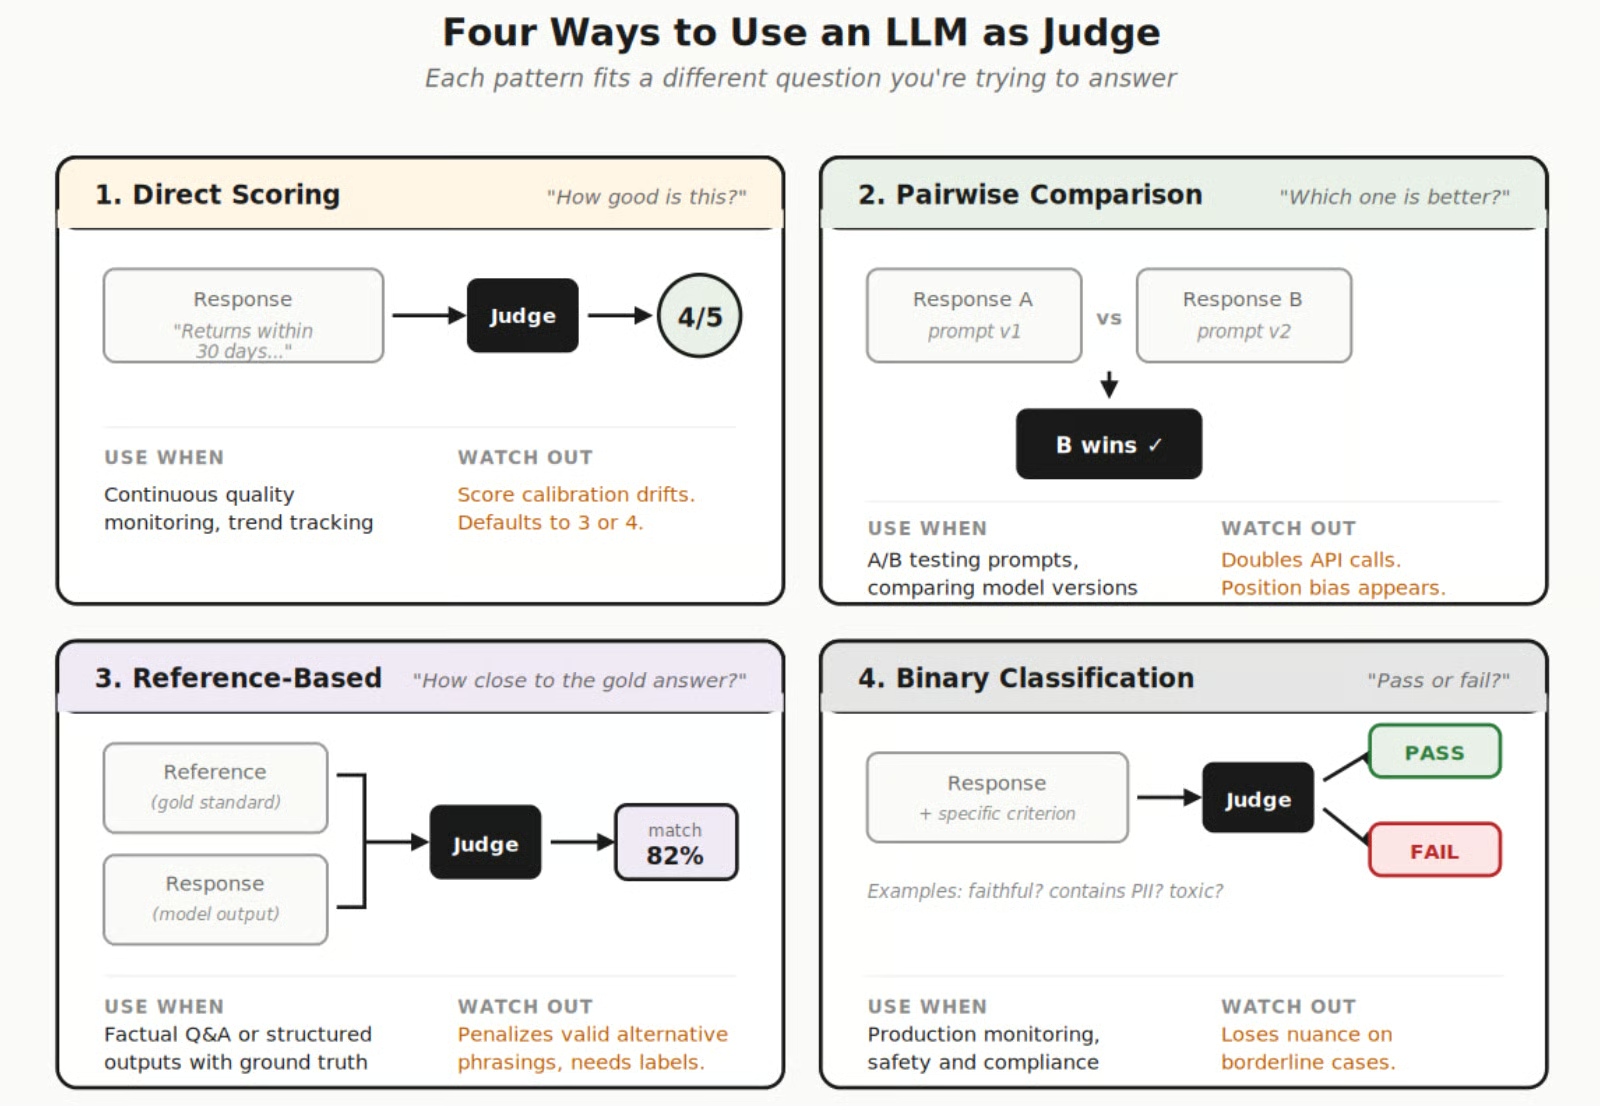
作者制图。LLM 作为评审的四种方法。
若想直观了解各自的优势、使用场景与限制,我在下表中对四种方法做了对比:
|
方法 |
适用场景 |
优势 |
注意事项 |
|
直接打分 |
通用质量监控、持续追踪 |
便于长期趋势分析,适用于单个输出 |
评审的打分校准会漂移 |
|
成对比较 |
模型 A/B 测试、提示变体对比 |
比绝对分更可靠的排序 |
API 调用翻倍,且不提供绝对质量信号 |
|
基于参考 |
事实性问答、结构化输出 |
有清晰真值,评估更直接 |
需要标注数据,可能惩罚同义的合理表述 |
|
二元分类 |
安全检查、幻觉检测、合规 |
歧义小,易于自动化告警 |
在边界案例上会丢失细节 |
若想更全面地了解超越“评审模式”的评估方法,参见LLM 基准详解覆盖的全景。
其底层就是一次简单的 API 调用:把您要评估的内容(模型输出、原始用户问题,以及生成时用到的任意检索上下文)打包起来,再用提示告知评审模型您关心的点,以及希望结果如何格式化。
评审接收后会返回结构化结果,通常包含一个分数和书面推理,解释它为何给出该分数。评估质量几乎完全取决于您写评分细则的水平。这一点怎么强调都不为过。
一个简单的提示,比如“请为该回复打 1 到 5 分”,会导致分数高度分散,因为评审并不理解 3 与 4 的具体含义差别。这就是为什么您需要明确而具体地写出每个分数档位的表现,并尽可能给出示例。
下面进入动手环节,我们将从零构建一条完整的评估流水线:一个检索增强生成(RAG)系统,用小型知识库回答问题;一组用于触发不同失效模式的测试查询;以及一个按真实度和答案相关性打分的 LLM 评审。
您需要 Python 3.9+ 和一个 OpenAI API 密钥,可在 OpenAI 控制台获取。安装依赖:
pip install openai chromadb langchain langchain-openai langchain-community deepeval设置您的 API 密钥:
import os
os.environ["OPENAI_API_KEY"] = "your-key-here"
我们将同时在 RAG 生成器与 LLM 评审中使用 OpenAI,但使用不同模型(生成用 GPT-4o-mini,评审用 GPT-4o)。对于向量嵌入,text-embedding-3-small足以满足教程范围。在生产系统中,您应先在自己的领域数据上对多款嵌入模型做基准评测再做选择。
如果您在进入评估代码前,希望进一步了解 RAG 背景,我们的检索增强生成(RAG)与 LangChain课程会带您走过基础原理。
我们需要一个小型知识库供 RAG 系统检索。我将使用一组关于某虚构公司退货政策的文本片段。内容本身不是重点,但有一个范围明确的文档集更容易看出模型何时超出了提供的上下文(这正是我们希望评审能捕捉到的失效模式)。
from langchain_openai import OpenAIEmbeddings
from langchain_chroma import Chroma
from langchain.schema import Document

# Sample knowledge base
documents = [
    Document(
        page_content="All customers are eligible for a full refund within 30 days of purchase. "
        "The item must be in its original packaging and unused condition. Refunds are "
        "processed to the original payment method within 5-7 business days.",
        metadata={"source": "return_policy.pdf", "section": "refund_eligibility"}
    ),
    Document(
        page_content="Exchanges can be requested within 45 days of purchase for items of "
        "equal or lesser value. Size exchanges on clothing are free of charge. "
        "For items of greater value, the customer pays the difference.",
        metadata={"source": "return_policy.pdf", "section": "exchanges"}
    ),
    Document(
        page_content="Electronics have a 15-day return window due to rapid depreciation. "
        "Opened software and digital downloads are non-refundable. Defective electronics "
        "can be returned within 90 days with proof of defect from an authorized service center.",
        metadata={"source": "return_policy.pdf", "section": "electronics"}
    ),
    Document(
        page_content="Shipping costs for returns are covered by the company for defective items. "
        "For non-defective returns, the customer is responsible for return shipping. "
        "Free return shipping labels are available for loyalty program members regardless of reason.",
        metadata={"source": "return_policy.pdf", "section": "shipping"}
    ),
    Document(
        page_content="Gift purchases can be returned with the gift receipt for store credit only. "
        "Without a gift receipt, returns are processed at the lowest sale price in the last 90 days. "
        "Gift cards and prepaid cards are non-refundable and cannot be exchanged.",
        metadata={"source": "return_policy.pdf", "section": "gifts"}
    ),
]

# Create vector store
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
vectorstore = Chroma.from_documents(documents, embeddings, persist_directory="./chroma_db")

print(f"Indexed {len(documents)} documents")
五份关于退货政策的文档,虽然不多,但足以展示我们关心的检索问题:上下文不完整、拉取到不相关片段,以及当模型为了给出“完整”答案而在上下文不足时出现的幻觉机会。
RAG 流水线会检索相关片段并生成答案。这里没有什么花哨的,就是标准的“先检索再生成”模式。
from openai import OpenAI

client = OpenAI()

def rag_query(question: str, top_k: int = 2) -> dict:
    """Run a RAG query: retrieve context, generate answer."""

    # Retrieve
    results = vectorstore.similarity_search(question, k=top_k)
    context = "\n\n".join([doc.page_content for doc in results])

    # Generate
    system_prompt = """You are a helpful customer support assistant. Answer the
    customer's question based ONLY on the provided context. If the context doesn't
    contain enough information to answer fully, say so."""

    user_prompt = f"""
      Context: {context}

      Question: {question}

      Answer:
    """

    response = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_prompt}
        ],
        temperature=0.3
    )

    answer = response.choices[0].message.content

    return {
        "question": question,
        "context": context,
        "answer": answer,
        "sources": [doc.metadata for doc in results]
    }
我选择用 GPT-4o-mini 作为生成器,因为它便宜且快速,而我们希望将重点放在评估本身。温度设为 0.3,可降低随机性但不会完全消除。
系统提示明确要求模型仅使用提供的上下文,这是 RAG 系统中的常规做法,尽管模型仍比您预期的更容易脱离上下文。这正是我们希望评审能够标记出来的。
我们来测试一下:
result = rag_query("Can I return opened software?")
print(f"Question: {result['question']}")
print(f"Answer: {result['answer']}")
print(f"Sources: {result['sources']}")您需要能覆盖流水线不同部分的测试用例。在生产中,您会从真实用户查询中收集这些。在本教程里,我构建了一组混合问题,刻意包含 RAG 系统易失足的类型。
eval_questions = [
    # Straightforward questions (should be easy)
    "What is the refund window for regular purchases?",
    "Are exchanges free for clothing size changes?",

    # Questions requiring synthesis across chunks
    "What are my options if I received a defective laptop 60 days ago?",

    # Edge cases likely to cause hallucination
    "Can I get a refund for a digital download I purchased yesterday?",
    "What happens if I return a gift without the gift receipt?",

    # Questions where context might be incomplete
    "Do you offer refunds for international orders?",
    "Can I return an item I bought on sale?",

    # Adversarial or tricky questions
    "If I'm a loyalty member, do I get free return shipping even for electronics?",
]

# Generate RAG responses for all questions
eval_results = []
for q in eval_questions:
    result = rag_query(q)
    eval_results.append(result)
    print(f"Q: {q}")
    print(f"A: {result['answer'][:150]}...")
    print()
问题组合很重要。其中一些在文档中有清晰直接的答案,另一些则要求模型跨多个检索片段综合信息(有缺陷笔记本的问题需要同时用到通用的 30 天退款政策与电子产品缺陷 90 天窗口)。
还有几道,比如“国际订单退款”问题,询问的是知识库根本未覆盖的内容。后者最容易出现幻觉,因为模型有“帮忙”的倾向,会用听起来合理但并非基于实际上下文的信息来填补空白。
关于构建与测试 RAG 系统的更多内容,我们的RAG 面试题与答案 Top 30可作参考。
精彩之处来了。我们要构建两个独立的评审:
def judge_faithfulness(question: str, context: str, answer: str) -> dict:
    """Judge whether the answer is faithful to the retrieved context."""

    eval_prompt = f"""
      You are an impartial judge evaluating whether an AI assistant's
      answer is faithful to the provided context.

      Faithfulness means every claim in the answer can be traced back to
      information in the context. The answer should not contain information
      that isn't supported by or inferable from the context.

      Score on a scale of 1 to 5:
      1 - The answer contains multiple claims not supported by the context
      2 - The answer contains at least one significant unsupported claim
      3 - The answer is mostly faithful but includes minor unsupported details
      4 - The answer is faithful with only trivial extrapolations
      5 - Every claim in the answer is directly supported by the context

      Context: {context}

      Question: {question}

      Answer to evaluate: {answer}

      Respond in this exact JSON format: {{"score": <int 1-5>, "reason": "<one paragraph explanation>"}}
    """

    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[{"role": "user", "content": eval_prompt}],
        temperature=0.0,
        response_format={"type": "json_object"}
    )

    import json
    return json.loads(response.choices[0].message.content)


def judge_relevance(question: str, answer: str) -> dict:
    """Judge whether the answer is relevant to the question."""

    eval_prompt = f"""
      You are an impartial judge evaluating whether an AI assistant's answer
      is relevant to the user's question.

      Relevance means the answer directly addresses what the user asked.
      A relevant answer may acknowledge limitations in available information,
      but it should not go off-topic or provide unrelated information.

      Score on a scale of 1 to 5:
      1 - The answer does not address the question at all
      2 - The answer partially addresses the question but misses the main point
      3 - The answer addresses the question but includes significant irrelevant content
      4 - The answer addresses the question well with minor tangents
      5 - The answer directly and completely addresses the question

      Question: {question}

      Answer to evaluate: {answer}

      Respond in this exact JSON format: {{"score": <int 1-5>, "reason": "<one paragraph explanation>"}}
    """

    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[{"role": "user", "content": eval_prompt}],
        temperature=0.0,
        response_format={"type": "json_object"}
    )

    import json
return json.loads(response.choices[0].message.content)这里有几个设计选择值得一提。temperature 设为 0.0,以在多次运行中获得最大一致性。我们使用 response_format={"type": "json_object"},确保输出始终可解析。
评分细则对每个分值段落做了具体描述,而非用“好”“差”这类模糊标签。没有这样的具体性,我发现评审往往会把一切都打成 3 或 4 分,这对您毫无帮助。
注意,尽管 GPT-4o-mini 负责生成,但评审由 GPT-4o 执行。让评审模型比生成模型更强是常见做法,因为评审需要更强的指令遵循能力,才能一致地应用评分细则。
如果两个角色使用同一模型,还会引入已被记录的“自我偏好”偏差,即模型更偏爱给自己的输出更高评分。
现在把一切跑起来并收集结果。
import json

evaluation_report = []

for result in eval_results:
    # Run both judges
    faithfulness = judge_faithfulness(
        result["question"], result["context"], result["answer"]
    )
    relevance = judge_relevance(
        result["question"], result["answer"]
    )

    evaluation_report.append({
        "question": result["question"],
        "answer": result["answer"][:200],
        "faithfulness_score": faithfulness["score"],
        "faithfulness_reason": faithfulness["reason"],
        "relevance_score": relevance["score"],
        "relevance_reason": relevance["reason"],
    })

    print(f"Q: {result['question']}")
    print(f"  Faithfulness: {faithfulness['score']}/5 | Relevance: {relevance['score']}/5")
    print(f"  Faith reason: {faithfulness['reason'][:100]}...")
    print()

# Summary statistics
faith_scores = [r["faithfulness_score"] for r in evaluation_report]
rel_scores = [r["relevance_score"] for r in evaluation_report]
print(f"Average faithfulness: {sum(faith_scores)/len(faith_scores):.2f}")
print(f"Average relevance: {sum(rel_scores)/len(rel_scores):.2f}")
print(f"Questions with faithfulness < 3: {sum(1 for s in faith_scores if s < 3)}")
每个问题会触发对 GPT-4o 的两次 API 调用(各一个评审)。我们这 8 条测试问题共 16 次评估调用,尚可管理。在生产中若每日上千条查询,您需要做批处理、异步运行,并且很可能只抽样评估,而非对每条回复都评估。
数值分能提供概览,但真正指引您如何修复问题的是“原因”部分。
# Find problematic responses
print("=== LOW FAITHFULNESS (score < 4) ===")
for r in evaluation_report:
    if r["faithfulness_score"] < 4:
        print(f"\nQ: {r['question']}")
        print(f"Score: {r['faithfulness_score']}")
        print(f"Reason: {r['faithfulness_reason']}")
        print(f"Answer preview: {r['answer'][:150]}...")

print("\n=== LOW RELEVANCE (score < 4) ===")
for r in evaluation_report:
    if r["relevance_score"] < 4:
        print(f"\nQ: {r['question']}")
        print(f"Score: {r['relevance_score']}")
        print(f"Reason: {r['relevance_reason']}")
“国际订单退款”和“折扣商品退货”这两题几乎肯定在真实度上得分偏低,因为知识库没有涉及这些主题,模型很可能即兴编造了答案。
“有缺陷笔记本”这题也很有意思,因为它需要将通用退款政策(30 天)与电子产品缺陷条款(凭证明 90 天)综合起来,而根据检索到的片段不同,模型可能掌握的信息并不完整。
如何处理结果取决于您发现的问题。某些类别的问题真实度偏低,通常指向两类原因之一:要么检索器拉取了错误的片段(检索问题),要么生成器超出了给定上下文(生成问题)。
将检索到的上下文与答案对照查看,能告诉您属于哪一类。另一方面,相关性分数偏低,通常意味着需要微调系统提示,或检索到的上下文偏题太远,以至于模型无从下手。
关于将评估纳入部署流水线的运维实践,LLMOps 概念课程涵盖了基础设施与工作流模式。
编写自定义评审函数可行,但在生产中,您大概率更需要能处理样板逻辑的框架。DeepEval 是较为成熟的选项之一,内置了经过良好测试的指标实现,覆盖最常见的评估标准。
from deepeval import evaluate
from deepeval.test_case import LLMTestCase
from deepeval.metrics import FaithfulnessMetric, AnswerRelevancyMetric

# Configure metrics
faithfulness_metric = FaithfulnessMetric(
    threshold=0.7,
    model="gpt-4o",
    include_reason=True
)

relevance_metric = AnswerRelevancyMetric(
    threshold=0.7,
    model="gpt-4o",
    include_reason=True
)

# Create test cases from our RAG results
test_cases = []
for result in eval_results:
    test_case = LLMTestCase(
        input=result["question"],
        actual_output=result["answer"],
        retrieval_context=[result["context"]]
    )
    test_cases.append(test_case)

# Run evaluation
evaluate(
    test_cases=test_cases,
    metrics=[faithfulness_metric, relevance_metric]
)
DeepEval 能替您免去的那些自己实现很费劲的事情:
每个指标也会生成自我解释,这意味着每个分数都有一段评审推理,方便在看起来不对劲时进行检查。
想更深入了解 DeepEval 的完整能力,请参见使用 DeepEval 高效评估 LLM。
让 LLM 评审返回分数并不难;要让这些分数对您的团队真正有用,比大多数人一开始预期的更需要用心。
除了 DeepEval,目前还有多种框架可选,生态仍在不断发展。以下是基于各自适用场景的实用对比:
|
框架 |
最佳适用 |
LLM 评审支持 |
RAG 专用指标 |
集成 |
|
DeepEval |
完整评估套件、CI/CD 集成 |
支持,且附带自解释分数 |
真实度、上下文精确率/召回率、相关性 |
pytest、LangChain |
|
RAGAS |
专用于 RAG 流水线评估 |
支持 |
真实度、答案相关性、上下文精确率、上下文召回率 |
LangChain、LlamaIndex |
|
MLflow |
带评估的实验跟踪 |
支持(内置;也可与 DeepEval/RAGAS 组合) |
通过第三方集成 |
MLflow 生态 |
|
Evidently |
生产监控与漂移检测 |
支持,并可持续追踪 |
通过自定义评估器 |
监控看板 |
|
LangSmith |
LangChain 原生的追踪与评估 |
支持 |
通过自定义评估器 |
LangChain |
对于 RAG 系统,四个指标在实践中通常能覆盖大多数需求。
建议将它们联合运行,因为不同的高低组合指向不同的根因。
每种组合都在提示您该从哪里着手修复。
若想在 MLflow 中动手实践评估跟踪,参见用 MLflow 评估 LLM的集成讲解。
生产部署比在笔记本里跑评估要复杂得多,规模化后常见的实际问题大致落在五个方面,值得您在正式采用之前加以考虑。
关于端到端落地 LLM 工作流的更多内容,面向数据科学家的副高级 AI 工程师学习路径覆盖了完整的部署图景。
LLM-as-a-judge 填补了传统自动化指标和人工审阅各自无法在规模上覆盖的实际需求。自动化指标常常错过对 LLM 应用真正重要的东西;而人工评估能抓住关键,却难以跟上生产系统的量级。
处在两者之间的 LLM 评审,让您可以持续监控输出质量,并保留简单指标无法提供的细腻度。
本教程构建了一条完整流水线:一个带小型知识库的 RAG 系统、用于触发不同失效模式的测试问题、用于真实度与相关性的自定义评审,以及更贴近生产的基于 DeepEval 的框架化做法。
如果只记住一件事,那就是评分细则一切皆系于此。因此您应该投入时间撰写具体、明确的评估标准,并为每个分数档位配上清晰示例。设计良好的细则配上一般的模型,往往胜过能力最强的模型却配以含糊的细则。
如果您想从这里继续拓展:
AI 工程课程
学习路径
课程
课程