
लर्निंग पाथ
LangChain के साथ AI इंजीनियरिंग
21 घंटा
व्यवहार में, टीमें आमतौर पर इस आधार पर इन तरीकों में से किसी एक पर आती हैं कि वे क्या मापना चाहती हैं:
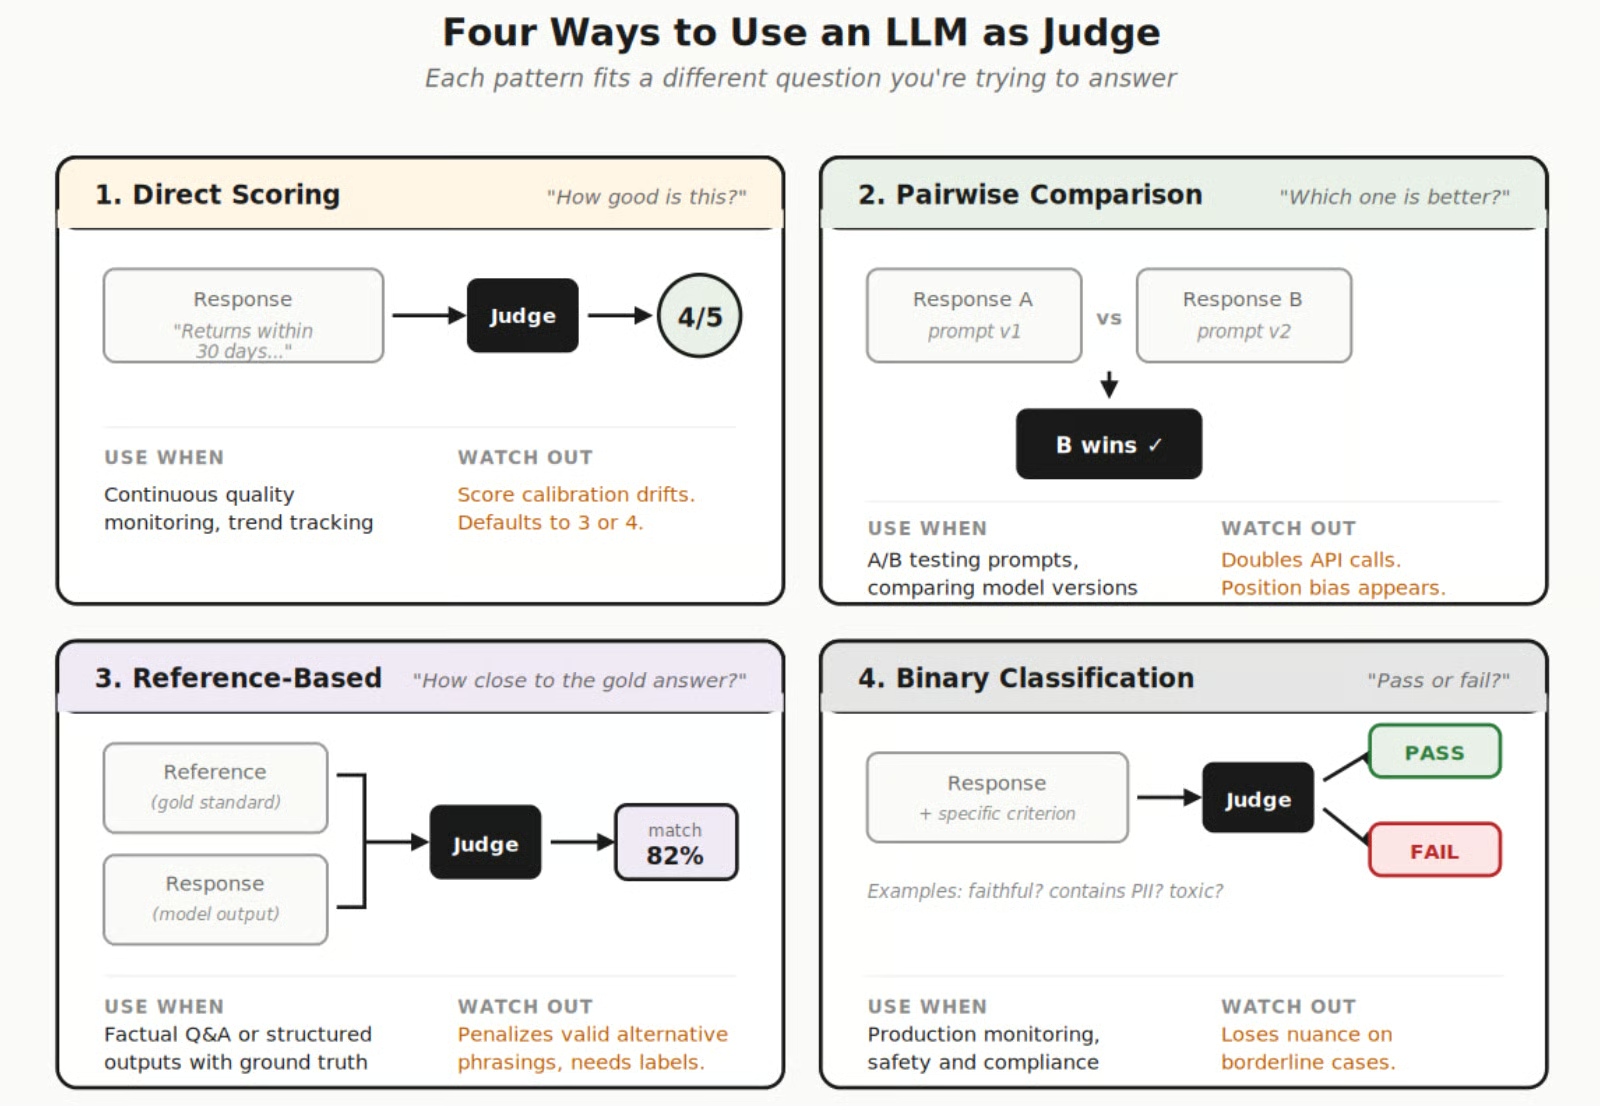
चित्र लेखक द्वारा। जज के रूप में LLM के चार अलग-अलग तरीके।
ताकत, उपयोग के मामले और सीमाओं का सीधे अवलोकन करने के लिए, मैंने निम्न तालिका में सभी चार तरीकों की तुलना की है:
|
तरीका |
कब उपयोग करें |
ताकत |
किससे सावधान रहें |
|
प्रत्यक्ष स्कोरिंग |
सामान्य गुणवत्ता मॉनिटरिंग, सतत ट्रैकिंग |
समय के साथ ट्रेंड करना आसान, एकल आउटपुट्स के साथ कार्य करता है |
जज समय के साथ स्कोर कैलिब्रेशन में भटक सकते हैं |
|
पेयरवाइज़ तुलना |
मॉडलों का A/B परीक्षण, प्रॉम्प्ट वेरिएंट तुलना |
निरपेक्ष स्कोर की तुलना में अधिक भरोसेमंद रैंकिंग |
आपके API कॉल दोगुने, कोई निरपेक्ष गुणवत्ता संकेत नहीं देता |
|
संदर्भ-आधारित |
तथ्यात्मक Q&A, संरचित आउटपुट्स |
स्पष्ट ग्राउंड ट्रुथ से मूल्यांकन सरल हो जाता है |
लेबल्ड डेटा आवश्यक, वैध वैकल्पिक वाक्य-प्रयोगों को दंडित कर सकता है |
|
द्विआधारी वर्गीकरण |
सुरक्षा जांच, hallucination का पता लगाना, अनुपालन |
कम अस्पष्टता, अलर्ट का स्वचालन आसान |
सीमांत मामलों में बारीकियाँ खो देता है |
जज पैटर्न से परे मूल्यांकन तरीकों पर व्यापक नज़र के लिए, LLM Benchmarks Explained पूरा परिदृश्य कवर करता है।
अंदर की बात, यह एक साधारण API कॉल है: आपको बस वह सामग्री पैक करनी है जिसका आप मूल्यांकन कराना चाहते हैं (मॉडल का आउटपुट, मूल उपयोगकर्ता प्रश्न, और कोई भी प्राप्त संदर्भ जिसका जनरेशन के दौरान उपयोग हुआ) और उसे एक प्रॉम्प्ट में लपेटना है जो जज मॉडल को बताता है कि आपको किसकी परवाह है और परिणाम किस प्रारूप में चाहिए।
जज इसे प्रोसेस करता है और एक संरचित प्रतिक्रिया लौटाता है, आमतौर पर एक स्कोर के साथ लिखित तर्क जो बताता है कि वह स्कोर क्यों दिया। आपके मूल्यांकन की गुणवत्ता लगभग पूरी तरह इस पर निर्भर करती है कि आप रूपरेखा कितनी अच्छी लिखते हैं। मैं इसे कम करके नहीं आंक सकता।
यदि आप केवल इतना लिखते हैं "इस उत्तर को 1 से 5 तक रेट करें" तो आपको टेढ़े-मेढ़े स्कोर मिलेंगे, क्योंकि जज को यह साझा समझ नहीं होगी कि 3 का मतलब 4 से कैसे अलग है। इसलिए आपको ठोस रूप से बताना चाहिए कि प्रत्येक स्कोर स्तर कैसा दिखता है और संभव हो तो उदाहरण शामिल करें।
अब हैंड्स-ऑन हिस्से के लिए, हम एक संपूर्ण मूल्यांकन पाइपलाइन शून्य से बनाएंगे: एक retrieval augmented generation (RAG) सिस्टम जो एक छोटे नॉलेज बेस से प्रश्नों के उत्तर देता है, अलग-अलग विफलता मोड ट्रिगर करने के लिए डिज़ाइन किए गए परीक्षण प्रश्नों का सेट, और एक LLM जज जो आउटपुट्स को सत्यता और उत्तर प्रासंगिकता पर स्कोर करता है।
आपको Python 3.9+ और एक OpenAI API कुंजी की आवश्यकता होगी, जिसे आप OpenAI कंसोल में प्राप्त कर सकते हैं। Install डिपेंडेंसीज़:
pip install openai chromadb langchain langchain-openai langchain-community deepevalअपनी API कुंजी सेट करें:
import os
os.environ["OPENAI_API_KEY"] = "your-key-here"
हम RAG जनरेटर और LLM जज दोनों के लिए OpenAI का उपयोग कर रहे हैं, हालांकि वे अलग-अलग मॉडल होंगे (जनरेशन के लिए GPT-4o-mini, जजिंग के लिए GPT-4o)। एम्बेडिंग्स के लिए, text-embedding-3-small इस ट्यूटोरियल के दायरे के लिए पर्याप्त है। प्रोडक्शन सिस्टम में, किसी एक पर टिकने से पहले आप अपने डोमेन डेटा पर कुछ एम्बेडिंग मॉडल्स का बेंचमार्क करना चाहेंगे।
यदि आप मूल्यांकन कोड में कूदने से पहले RAG पर और पृष्ठभूमि बनाना चाहते हैं, तो हमारा Retrieval Augmented Generation (RAG) with LangChain कोर्स आधारभूत बातों से गुज़रता है।
हमें RAG सिस्टम के लिए एक छोटा नॉलेज बेस चाहिए जिससे वह रिट्रीव कर सके। मैं एक काल्पनिक कंपनी की रिटर्न पॉलिसी के बारे में टेक्स्ट खंडों का सेट उपयोग करने जा रहा हूँ। सामग्री स्वयं यहाँ केंद्र में नहीं है, लेकिन दस्तावेज़ों का सीमित सेट होना यह देखना आसान बनाता है कि मॉडल कब दिए गए संदर्भ से आगे जाता है (जो वह विफलता मोड है जिसे हम जज से पकड़वाना चाहते हैं)।
from langchain_openai import OpenAIEmbeddings
from langchain_chroma import Chroma
from langchain.schema import Document

# Sample knowledge base
documents = [
    Document(
        page_content="All customers are eligible for a full refund within 30 days of purchase. "
        "The item must be in its original packaging and unused condition. Refunds are "
        "processed to the original payment method within 5-7 business days.",
        metadata={"source": "return_policy.pdf", "section": "refund_eligibility"}
    ),
    Document(
        page_content="Exchanges can be requested within 45 days of purchase for items of "
        "equal or lesser value. Size exchanges on clothing are free of charge. "
        "For items of greater value, the customer pays the difference.",
        metadata={"source": "return_policy.pdf", "section": "exchanges"}
    ),
    Document(
        page_content="Electronics have a 15-day return window due to rapid depreciation. "
        "Opened software and digital downloads are non-refundable. Defective electronics "
        "can be returned within 90 days with proof of defect from an authorized service center.",
        metadata={"source": "return_policy.pdf", "section": "electronics"}
    ),
    Document(
        page_content="Shipping costs for returns are covered by the company for defective items. "
        "For non-defective returns, the customer is responsible for return shipping. "
        "Free return shipping labels are available for loyalty program members regardless of reason.",
        metadata={"source": "return_policy.pdf", "section": "shipping"}
    ),
    Document(
        page_content="Gift purchases can be returned with the gift receipt for store credit only. "
        "Without a gift receipt, returns are processed at the lowest sale price in the last 90 days. "
        "Gift cards and prepaid cards are non-refundable and cannot be exchanged.",
        metadata={"source": "return_policy.pdf", "section": "gifts"}
    ),
]

# Create vector store
embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
vectorstore = Chroma.from_documents(documents, embeddings, persist_directory="./chroma_db")

print(f"Indexed {len(documents)} documents")
रिटर्न पॉलिसी पर पाँच दस्तावेज़, भले ही वह बहुत नहीं है, लेकिन यह उन रिट्रीवल समस्याओं को दिखाने के लिए पर्याप्त है जिनकी हमें परवाह है: अधूरा संदर्भ, अप्रासंगिक खंडों का खिंच आना, और hallucination के अवसर जब मॉडल पर पूर्ण उत्तर देने का दबाव होता है जबकि संदर्भ उसे पूरी तरह समर्थन नहीं देता।
RAG पाइपलाइन प्रासंगिक खंडों को रिट्रीव करती है और उत्तर जनरेट करती है। यहाँ कुछ विशेष नहीं, बस मानक retrieve-then-generate पैटर्न।
from openai import OpenAI

client = OpenAI()

def rag_query(question: str, top_k: int = 2) -> dict:
    """Run a RAG query: retrieve context, generate answer."""

    # Retrieve
    results = vectorstore.similarity_search(question, k=top_k)
    context = "\n\n".join([doc.page_content for doc in results])

    # Generate
    system_prompt = """You are a helpful customer support assistant. Answer the
    customer's question based ONLY on the provided context. If the context doesn't
    contain enough information to answer fully, say so."""

    user_prompt = f"""
      Context: {context}

      Question: {question}

      Answer:
    """

    response = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_prompt}
        ],
        temperature=0.3
    )

    answer = response.choices[0].message.content

    return {
        "question": question,
        "context": context,
        "answer": answer,
        "sources": [doc.metadata for doc in results]
    }
मैंने जनरेटर के रूप में GPT-4o-mini चुना क्योंकि यह सस्ता और तेज़ है, और हम चाहते हैं कि फोकस स्वयं मूल्यांकन पर रहे। टेम्परेचर 0.3 पर है, जो रैंडमनेस घटाता है लेकिन उसे पूरी तरह खत्म नहीं करता।
और सिस्टम प्रॉम्प्ट स्पष्ट रूप से मॉडल को केवल दिए गए संदर्भ का उपयोग करने का निर्देश देता है, जो RAG सिस्टम में मानक प्रथा है, हालांकि मॉडल संदर्भ से बाहर भी अपेक्षा से अधिक भटकते हैं। यही तो हम चाहते हैं कि जज फ्लैग करे।
इसे आज़माते हैं:
result = rag_query("Can I return opened software?")
print(f"Question: {result['question']}")
print(f"Answer: {result['answer']}")
print(f"Sources: {result['sources']}")आपको ऐसे टेस्ट केस चाहिए जो पाइपलाइन के अलग-अलग हिस्सों को सक्रिय करें। प्रोडक्शन में, आप इन्हें वास्तविक उपयोगकर्ता प्रश्नों से एकत्र करेंगे। इस ट्यूटोरियल के लिए, मैं मिश्रण इस तरह बना रहा हूँ कि उसमें जानबूझकर वे प्रश्न शामिल हों जिन पर RAG सिस्टम अक्सर लड़खड़ाते हैं।
eval_questions = [
    # Straightforward questions (should be easy)
    "What is the refund window for regular purchases?",
    "Are exchanges free for clothing size changes?",

    # Questions requiring synthesis across chunks
    "What are my options if I received a defective laptop 60 days ago?",

    # Edge cases likely to cause hallucination
    "Can I get a refund for a digital download I purchased yesterday?",
    "What happens if I return a gift without the gift receipt?",

    # Questions where context might be incomplete
    "Do you offer refunds for international orders?",
    "Can I return an item I bought on sale?",

    # Adversarial or tricky questions
    "If I'm a loyalty member, do I get free return shipping even for electronics?",
]

# Generate RAG responses for all questions
eval_results = []
for q in eval_questions:
    result = rag_query(q)
    eval_results.append(result)
    print(f"Q: {q}")
    print(f"A: {result['answer'][:150]}...")
    print()
मिश्रण मायने रखता है। इन प्रश्नों में से कुछ के साफ़, सीधे उत्तर दस्तावेज़ों में हैं, जबकि कुछ में मॉडल को कई प्राप्त खंडों की जानकारी को जोड़ना पड़ता है (खराब लैपटॉप वाला प्रश्न सामान्य 30-दिन की रिफंड पॉलिसी और इलेक्ट्रॉनिक्स के दोष पर 90-दिन वाली शर्त—दोनों—की जरूरत रखता है)।
और इनमें से कुछ, जैसे अंतरराष्ट्रीय ऑर्डर्स वाला प्रश्न, उन बातों के बारे में पूछते हैं जिन्हें नॉलेज बेस कवर ही नहीं करता। ये आख़िरी वाले प्रश्नों में आप hallucination सबसे अधिक देखेंगे, क्योंकि मॉडल मददगार बनने की खींच महसूस करता है और ऐसी विश्वसनीय लगने वाली जानकारी से खाली जगहें भर देता है जिसका वास्तविक संदर्भ में कोई आधार नहीं होता।
RAG सिस्टम बनाने और टेस्ट करने पर अधिक जानकारी के लिए, हमारे शीर्ष 30 RAG इंटरव्यू प्रश्न और उत्तर की चयनित सूची एक उपयोगी संदर्भ है।
यहीं चीजें रोचक होती हैं। हम दो अलग-अलग जज बना रहे हैं:
def judge_faithfulness(question: str, context: str, answer: str) -> dict:
    """Judge whether the answer is faithful to the retrieved context."""

    eval_prompt = f"""
      You are an impartial judge evaluating whether an AI assistant's
      answer is faithful to the provided context.

      Faithfulness means every claim in the answer can be traced back to
      information in the context. The answer should not contain information
      that isn't supported by or inferable from the context.

      Score on a scale of 1 to 5:
      1 - The answer contains multiple claims not supported by the context
      2 - The answer contains at least one significant unsupported claim
      3 - The answer is mostly faithful but includes minor unsupported details
      4 - The answer is faithful with only trivial extrapolations
      5 - Every claim in the answer is directly supported by the context

      Context: {context}

      Question: {question}

      Answer to evaluate: {answer}

      Respond in this exact JSON format: {{"score": <int 1-5>, "reason": "<one paragraph explanation>"}}
    """

    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[{"role": "user", "content": eval_prompt}],
        temperature=0.0,
        response_format={"type": "json_object"}
    )

    import json
    return json.loads(response.choices[0].message.content)


def judge_relevance(question: str, answer: str) -> dict:
    """Judge whether the answer is relevant to the question."""

    eval_prompt = f"""
      You are an impartial judge evaluating whether an AI assistant's answer
      is relevant to the user's question.

      Relevance means the answer directly addresses what the user asked.
      A relevant answer may acknowledge limitations in available information,
      but it should not go off-topic or provide unrelated information.

      Score on a scale of 1 to 5:
      1 - The answer does not address the question at all
      2 - The answer partially addresses the question but misses the main point
      3 - The answer addresses the question but includes significant irrelevant content
      4 - The answer addresses the question well with minor tangents
      5 - The answer directly and completely addresses the question

      Question: {question}

      Answer to evaluate: {answer}

      Respond in this exact JSON format: {{"score": <int 1-5>, "reason": "<one paragraph explanation>"}}
    """

    response = client.chat.completions.create(
        model="gpt-4o",
        messages=[{"role": "user", "content": eval_prompt}],
        temperature=0.0,
        response_format={"type": "json_object"}
    )

    import json
    return json.loads(response.choices[0].message.content)
यहाँ कुछ डिज़ाइन चुनाव उल्लेखनीय हैं। temperature को 0.0 पर रखा है ताकि रनों में अधिकतम स्थिरता रहे। हम response_format={"type": "json_object"} का उपयोग कर रहे हैं ताकि आउटपुट हमेशा पार्स किया जा सके।
रूपरेखा प्रत्येक स्कोर स्तर को ठोस रूप से वर्णित करती है, "अच्छा" या "खराब" जैसे अस्पष्ट लेबल्स का उपयोग करने के बजाय। उस स्तर की विशिष्टता के बिना, मैंने पाया है कि जज लगभग हर चीज़ को 3 या 4 दे देते हैं, जो कोई उपयोगी जानकारी नहीं देता।
ध्यान दें कि GPT-4o जजिंग कर रहा है जबकि GPT-4o-mini जनरेशन कर रहा है। जज का जेनरेटर से अधिक सक्षम होना आम पैटर्न है क्योंकि जज को रूपरेखा को सुसंगत रूप से लागू करने के लिए मजबूत निर्देश-अनुसरण की आवश्यकता होती है।
यदि आप दोनों भूमिकाओं के लिए एक ही मॉडल का उपयोग करते हैं, तो आप एक प्रलेखित self-preference bias भी लाते हैं जहाँ मॉडल अपने ही आउटपुट को अधिक अनुकूलता से रेट करता है।
अब सब कुछ चलाने और परिणाम एकत्र करने का समय है।
import json

evaluation_report = []

for result in eval_results:
    # Run both judges
    faithfulness = judge_faithfulness(
        result["question"], result["context"], result["answer"]
    )
    relevance = judge_relevance(
        result["question"], result["answer"]
    )

    evaluation_report.append({
        "question": result["question"],
        "answer": result["answer"][:200],
        "faithfulness_score": faithfulness["score"],
        "faithfulness_reason": faithfulness["reason"],
        "relevance_score": relevance["score"],
        "relevance_reason": relevance["reason"],
    })

    print(f"Q: {result['question']}")
    print(f"  Faithfulness: {faithfulness['score']}/5 | Relevance: {relevance['score']}/5")
    print(f"  Faith reason: {faithfulness['reason'][:100]}...")
    print()

# Summary statistics
faith_scores = [r["faithfulness_score"] for r in evaluation_report]
rel_scores = [r["relevance_score"] for r in evaluation_report]
print(f"Average faithfulness: {sum(faith_scores)/len(faith_scores):.2f}")
print(f"Average relevance: {sum(rel_scores)/len(rel_scores):.2f}")
print(f"Questions with faithfulness < 3: {sum(1 for s in faith_scores if s < 3)}")
प्रत्येक प्रश्न GPT-4o को दो API कॉल ट्रिगर करता है, प्रत्येक जज के लिए एक। हमारे आठ परीक्षण प्रश्नों के लिए, यह कुल सोलह मूल्यांकन कॉल्स हैं, जो प्रबंधनीय है। प्रोडक्शन में, जहाँ रोज़ाना हजारों प्रश्न होते हैं, आप इन्हें बैच में चलाना चाहेंगे, असिंक्रोनस रूप से चलाना चाहेंगे, और संभवतः हर प्रतिक्रिया के बजाय केवल एक सैंपल का मूल्यांकन करेंगे।
संख्यात्मक स्कोर आपको एक ओवरव्यू देते हैं, लेकिन वास्तव में क्या ठीक करना है यह तर्क (reasoning) बताता है।
# Find problematic responses
print("=== LOW FAITHFULNESS (score < 4) ===")
for r in evaluation_report:
    if r["faithfulness_score"] < 4:
        print(f"\nQ: {r['question']}")
        print(f"Score: {r['faithfulness_score']}")
        print(f"Reason: {r['faithfulness_reason']}")
        print(f"Answer preview: {r['answer'][:150]}...")

print("\n=== LOW RELEVANCE (score < 4) ===")
for r in evaluation_report:
    if r["relevance_score"] < 4:
        print(f"\nQ: {r['question']}")
        print(f"Score: {r['relevance_score']}")
        print(f"Reason: {r['relevance_reason']}")
अंतरराष्ट्रीय ऑर्डर्स वाला प्रश्न और सेल आइटम वाला प्रश्न लगभग निश्चित रूप से विश्वसनीयता पर कम स्कोर करेंगे, क्योंकि नॉलेज बेस उन विषयों को संबोधित नहीं करता, और मॉडल ने संभवतः एक मनगढ़ंत उत्तर दे दिया होगा।
खराब लैपटॉप वाला प्रश्न भी दिलचस्प है क्योंकि इसमें सामान्य रिफंड पॉलिसी (30 दिन) और इलेक्ट्रॉनिक्स के दोष खंड (प्रमाण के साथ 90 दिन) से जानकारी को जोड़ना पड़ता है, और किन खंडों को रिट्रीव किया गया इस पर निर्भर करते हुए, मॉडल के पास पूरी तस्वीर हो भी सकती है और नहीं भी।
आप परिणामों के साथ क्या करते हैं यह इस पर निर्भर करता है कि आप क्या पाते हैं। कुछ श्रेणियों के प्रश्नों पर कम विश्वसनीयता आम तौर पर दो में से किसी एक बात की ओर इशारा करती है: या तो रिट्रीवर गलत खंड ला रहा है (रिट्रीवल समस्या), या जेनरेटर दिए गए संदर्भ से आगे जा रहा है (जनरेशन समस्या)।
उत्तर के साथ प्राप्त संदर्भ को देखने से पता चलता है कि आप किससे जूझ रहे हैं। दूसरी ओर कम प्रासंगिकता स्कोर आमतौर पर यह दर्शाते हैं कि सिस्टम प्रॉम्प्ट को ट्यूनिंग की जरूरत है, या प्राप्त संदर्भ इतना विषयांतर है कि मॉडल के पास काम करने के लिए कुछ उपयोगी नहीं है।
अपने डिप्लॉयमेंट पाइपलाइन का हिस्सा बनाकर मूल्यांकनों को चलाने के संचालन पक्ष के लिए, LLMOps Concepts कोर्स इन्फ्रास्ट्रक्चर और वर्कफ़्लो पैटर्न कवर करता है।
कस्टम जज फ़ंक्शन लिखना काम करता है, लेकिन प्रोडक्शन उपयोग के लिए, आप शायद एक ऐसे फ़्रेमवर्क को चाहेंगे जो बोयलरप्लेट संभाले। DeepEval परिपक्व विकल्पों में से है, और यह अच्छी तरह परखे गए मैट्रिक इम्प्लीमेंटेशन के साथ आता है जो सबसे आम मूल्यांकन मानदंडों को कवर करते हैं।
from deepeval import evaluate
from deepeval.test_case import LLMTestCase
from deepeval.metrics import FaithfulnessMetric, AnswerRelevancyMetric

# Configure metrics
faithfulness_metric = FaithfulnessMetric(
    threshold=0.7,
    model="gpt-4o",
    include_reason=True
)

relevance_metric = AnswerRelevancyMetric(
    threshold=0.7,
    model="gpt-4o",
    include_reason=True
)

# Create test cases from our RAG results
test_cases = []
for result in eval_results:
    test_case = LLMTestCase(
        input=result["question"],
        actual_output=result["answer"],
        retrieval_context=[result["context"]]
    )
    test_cases.append(test_case)

# Run evaluation
evaluate(
    test_cases=test_cases,
    metrics=[faithfulness_metric, relevance_metric]
)
DeepEval से आपको क्या मिलता है जो अपने दम पर बनाना थकाऊ है:
प्रत्येक मैट्रिक एक self-explanation भी जनरेट करता है, यानी हर स्कोर के साथ जज के तर्क का लिखा हुआ विश्लेषण आता है, जिसे आप तब निरीक्षण कर सकते हैं जब कुछ गलत लगे।
DeepEval की पूरी क्षमताओं पर गहराई से देखने के लिए, Evaluate LLMs Effectively Using DeepEval देखें।
LLM जज से नंबर वापस पाना सीधा है। उन नंबरों को आपकी टीम के लिए वास्तव में मायने रखने लायक बनाना, जितनी लोग शुरुआत में उम्मीद करते हैं उससे अधिक सावधानी मांगता है।
DeepEval के अलावा, इस बिंदु पर चुनने के लिए कई फ़्रेमवर्क्स हैं, और परिदृश्य बढ़ता जा रहा है। यहाँ एक व्यावहारिक तुलना है कि प्रात्येक कहाँ सबसे अच्छा फ़िट होता है:
|
फ़्रेमवर्क |
सर्वोत्तम उपयोग |
LLM जज समर्थन |
RAG-विशिष्ट मेट्रिक्स |
इंटीग्रेशन |
|
DeepEval |
पूर्ण मूल्यांकन सूट, CI/CD इंटीग्रेशन |
हाँ, self-explanatory स्कोर के साथ |
Faithfulness, contextual precision/recall, relevancy |
pytest, LangChain |
|
RAGAS |
विशेष रूप से RAG पाइपलाइन मूल्यांकन |
हाँ |
Faithfulness, answer relevance, context precision, context recall |
LangChain, LlamaIndex |
|
MLflow |
मूल्यांकन सहित प्रयोग ट्रैकिंग |
हाँ (बिल्ट-इन; DeepEval/RAGAS के साथ संयोजन में भी) |
थर्ड-पार्टी इंटीग्रेशन के माध्यम से |
MLflow इकोसिस्टम |
|
Evidently |
प्रोडक्शन मॉनिटरिंग और ड्रिफ्ट डिटेक्शन |
हाँ, सतत ट्रैकिंग के साथ |
कस्टम इवैलुएटर्स के माध्यम से |
मॉनिटरिंग डैशबोर्ड्स |
|
LangSmith |
LangChain-नेटिव ट्रेसिंग और मूल्यांकन |
हाँ |
कस्टम इवैलुएटर्स के माध्यम से |
LangChain |
RAG सिस्टम्स के लिए, चार मेट्रिक्स आमतौर पर अधिकांश ज़रूरतें कवर कर देते हैं।
आप इन्हें साथ में चलाना चाहेंगे क्योंकि ऊँचे और नीचले स्कोर के अलग-अलग संयोजन अलग-अलग मूल कारणों की ओर इशारा करते हैं।
प्रत्येक संयोजन बताता है कि समाधान के लिए कहाँ देखना है।
MLflow में मूल्यांकन ट्रैकिंग के साथ हैंड्स-ऑन अभ्यास के लिए, Evaluating LLMs with MLflow इंटीग्रेशन से गुज़रता है।
प्रोडक्शन डिप्लॉयमेंट, नोटबुक में मूल्यांकन चलाने से अधिक सोच मांगता है, और पैमाने पर जो व्यावहारिक मुद्दे आते हैं वे पाँच बकेट्स में आते हैं जिनका सामना करने लायक है, इससे पहले कि आप इस दृष्टिकोण पर प्रतिबद्ध हों।
एंड-टू-एंड LLM वर्कफ़्लोज़ को ऑपरेशनलाइज़ करने पर और अधिक के लिए, Associate AI Engineer for Data Scientists ट्रैक पूरा डिप्लॉयमेंट चित्र कवर करता है।
LLM-as-a-judge एक व्यावहारिक जरूरत को पूरा करता है जिसे न तो पारंपरिक स्वचालित मैट्रिक्स और न ही मानव समीक्षा अपने आप बड़े पैमाने पर कवर कर सकती हैं। स्वचालित मैट्रिक्स LLM एप्लिकेशंस के लिए वास्तव में मायने रखने वाली बातों को चूक जाते हैं; दूसरी ओर, मानव मूल्यांकन वही पकड़ते हैं जो मायने रखता है, लेकिन प्रोडक्शन सिस्टम की मात्रा के साथ तालमेल नहीं बिठा पाते।
बीच में बैठा एक LLM जज आपको आउटपुट गुणवत्ता की निरंतर निगरानी करने का ऐसा तरीका देता है जिसमें वह बारीकी होती है जो साधारण मैट्रिक्स नहीं दे सकते।
हमने इस ट्यूटोरियल में एक पूरी पाइपलाइन बनाई: एक छोटे नॉलेज बेस वाला RAG सिस्टम, अलग-अलग विफलता मोड ट्रिगर करने के लिए डिज़ाइन किए गए परीक्षण प्रश्न, सत्यता और प्रासंगिकता के लिए कस्टम मूल्यांकन जज, और DeepEval का उपयोग करते हुए फ़्रेमवर्क-आधारित तरीका, जो प्रोडक्शन के क़रीब है।
यदि इस सब से एक बात ले जानी हो, तो वह है कि रूपरेखा ही सबकुछ है। इसलिए आपको प्रत्येक स्कोर स्तर के लिए स्पष्ट उदाहरणों के साथ विशिष्ट, ठोस मूल्यांकन मानदंड लिखने में समय निवेश करना चाहिए। एक अच्छी तरह से डिज़ाइन की गई रूपरेखा, औसत दर्जे के मॉडल के साथ, हमेशा एक अस्पष्ट रूपरेखा और सबसे सक्षम मॉडल के संयोजन को पछाड़ देगी।
यदि आप यहीं से आगे बनाना चाहते हैं:
AI इंजीनियरिंग कोर्सेज़
लर्निंग पाथ
कोर्स
कोर्स