

为 LLM 评估设置 MLflow
在使用 MLflow 评估 LLM 之前,我们需要正确设置平台。这包括安装 MLflow、可选地配置用于远程日志记录的跟踪服务器,并确保我们的环境可以管理实验并跟踪结果。
下面看看如何操作。
安装 MLflow
1. 确认已安装 Python:
首先,我们需要确保机器上已安装 Python。MLflow 兼容 Python 3.6 及以上版本(注意 Python 3.8 已弃用,建议使用 Python >= 3.9)。我们可以通过以下命令检查 Python 版本:
python --version2. 创建虚拟环境(可选但推荐):
在用 MLFlow 跟踪实验时,使用虚拟环境是一个良好实践,尤其在 Mac OS X 上。我们可以使用 venv 或 virtualenv 创建环境。
python -m venv mlflow-env激活虚拟环境:
在 Windows 上:
mlflow-env\Scripts\activate在 Mac/Linux 上:
source mlflow-env/bin/activate3. 使用 pip 安装 MLflow:
在激活虚拟环境(如使用)后,我们可以通过 pip 安装 MLflow:
pip install mlflow4. 安装其他依赖:
MLflow 有一些可选依赖可增强功能。如果需要使用 MLflow 的模型服务能力,需要安装 gunicorn。
pip install gunicorn如果我们使用 TensorFlow 或 PyTorch 等库,可能需要安装相应的 MLflow 集成:
pip install mlflow[extras]4. 验证安装:
接着,我们需要确认 MLflow 是否安装成功,可通过检查其版本:
mlflow --version设置 MLflow 跟踪服务器(可选)
如果我们在协作环境中工作,或需要进行远程日志记录,就应设置一台MLflow 跟踪服务器。这样可以将实验的跟踪与管理集中化。
1. 运行跟踪服务器:
我们可以通过指定后端存储和制品位置来启动 MLflow 服务器。
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlruns-
--backend-store-uri指定实验数据的存储位置。我们可以使用任意数据库系统(PostgreSQL、MySQL 等)。 -
--default-artifact-root指定制品(如模型文件)的存储目录。
2. 配置跟踪服务器:
我们需要确保 MLflow 客户端被配置为向该跟踪服务器写入日志。可以设置 MLFLOW_TRACKING_URI 环境变量指向我们的服务器。
export MLFLOW_TRACKING_URI=http://localhost:50003. 访问跟踪 UI:
现在,我们可以打开浏览器并访问 http://localhost:5000 以进入 MLflow UI。该界面允许我们查看实验、比较结果并管理 MLflow 项目,稍后我们会演示。
加载与评估 LLM
在 MLflow 设置就绪后,接下来就是加载与评估 LLM 的核心任务。我们将看看如何选择预训练 LLM,使用不同库加载它,并准备评估数据集来衡量模型性能。
选择预训练 LLM
在选择预训练 LLM 时,诸如 Hugging Face Transformers 的库提供了丰富选项。例如,我们可以加载预训练模型,如用于文本生成的 GPT,或用于文本分类等任务的 BERT。
1. 安装 Hugging Face Transformers
首先,我们确保安装了 Hugging Face Transformers 库。可以使用 pip 实现。
pip install transformers2. 加载预训练模型与分词器
现在,我们使用 transformers 库加载 BERT 模型,包括模型与分词器,两者都是处理文本与生成预测所必需的。
from transformers import (
BertForSequenceClassification,
BertTokenizer
)
# Load pre-trained model and tokenizer
model_name = "textattack/bert-base-uncased-yelp-polarity"
tokenizer = BertTokenizer.from_pretrained(model_name)
model = BertForSequenceClassification.from_pretrained(model_name)当我们处理的文本数据主要包含大小写字母,但不需要模型区分大小写时,可以使用 bert-base-uncased 模型。
准备评估数据集
要评估一款 LLM,我们需要与被评估任务相匹配的合适数据集。下面看看如何为 情感分析 准备一个基于文本的评估数据集:
1. 加载或创建并预处理数据集
我们的数据可以存储在多个位置:本地磁盘、GitHub 仓库,或 Hugging Face Hub(一个收录社区整理与热门研究数据集的大型仓库)。
在本教程中,我们将使用一个用于情感分析的大型影评数据集,名为 IMDB。我们将使用 datasets 库来加载该预构建数据集:
安装 datasets 库:
pip install datasets加载数据集:
from datasets import load_dataset
# Load the dataset IMDb for sentiment analysis
dataset = load_dataset("imdb")2. 为情感分析进行预处理
我们将使用先前加载的 BERT 分词器来对数据集进行情感分析的预处理。
def preprocess_function(examples):
return tokenizer(examples['text'], padding="max_length", truncation=True)
tokenized_datasets = dataset.map(preprocess_function, batched=True)使用 MLflow 运行 LLM 评估并记录指标
现在我们的 LLM 已加载、评估数据集已就绪,是时候运行评估并记录指标了。
跟踪实验元数据
1. 导入 MLflow 并启动新实验
要用 MLflow 跟踪实验,我们首先需要启动一个新实验并记录相关元数据,如模型名称、版本与评估参数。
import mlflow
import mlflow.pytorch
# Start a new experiment
mlflow.set_experiment("LLM_Evaluation")
with mlflow.start_run() as run:
# Log experiment metadata
mlflow.log_param("model_name", "bert")
mlflow.log_param("model_version", "v1.0")
mlflow.log_param("evaluation_task", "sentiment_analysis")2. 记录评估参数
现在我们可以记录与评估过程相关的任何参数,例如评估数据集大小或评估期间使用的特定配置。
with mlflow.start_run() as run:
mlflow.log_param("dataset_size", len(dataset['test']))记录评估指标
在使用模型完成训练并生成相应预测后,我们可以对 LLM 进行评估,并记录反映其性能的各项指标。
情感分析是一个分类问题,因此我们可以使用准确率和 F1 分数等指标评估模型。对于文本生成任务,常用指标包括 BLEU 分数或困惑度。
from sklearn.metrics import accuracy_score, f1_score
# Assuming y_true and y_pred are true labels and model predictions
accuracy = accuracy_score(y_true, y_pred)
f1 = f1_score(y_true, y_pred, average='weighted')
with mlflow.start_run() as run:
mlflow.log_metric("accuracy", accuracy)
mlflow.log_metric("f1_score", f1)使用 MLflow 比较 LLM 表现
当通过 MLflow 跟踪了多次评估运行后,比较它们的表现对于确定最佳模型与配置至关重要。
下面了解如何跟踪多次运行,并使用 MLflow 的 UI 有效地可视化与比较结果。
跟踪多次运行
首先,我们需要在同一实验内或跨不同实验跟踪多次运行,以比较不同 LLM 版本的表现。
1. 记录多次运行
我们可以在单个实验下记录多次运行,对每个想要评估的模型或配置启动一次新运行。
models = [("bert-base-cased", "v1.0"), ("bert-base-uncased", "v1.0")]
y_pred_dict = {
"bert-base-cased": y_pred_case,
"bert-base-uncased": y_pred_uncase
}
for model_name, model_version in models:
with mlflow.start_run() as run:
# Log model and version
mlflow.log_param("model_name", model_name)
mlflow.log_param("model_version", model_version)
# Perform evaluation and log metrics
y_pred = y_pred_dict[model_name]
accuracy = accuracy_score(y_true, y_pred)
f1 = f1_score(y_true, y_pred, average='weighted')
mlflow.log_metric("accuracy", accuracy)
mlflow.log_metric("f1_score", f1)2. 使用不同模型跟踪实验
假设我们想要评估不同类型的模型。为此,我们可以使用 MLFlow 创建一个实验并将这些模型一同记录。
在 MLFlow 中进行模型记录与对机器学习模型做版本控制类似。记录模型与环境细节可以保证可复现性。
首先,我们将设置一个实验。然后,在每个独立的 MLFlow 运行中记录各模型,包括运行 ID 与制品路径。
# Create an experiments for the different models
mlflow.set_experiment("sentiment_analysis_comparison")
model_names = ["bert-base-cased", "bert-base-uncased"]
run_ids = []
artifact_paths = []
for model, name in zip([betcased, bertuncased], model_names):
with mlflow.start_run(run_name=f"log_model_{name}"):
artifact_path = f"models/{name}"
mlflow.pyfunc.log_model(
artifact_path=artifact_path,
python_model=model,
)
run_ids.append(mlflow.active_run().info.run_id)
artifact_paths.append(artifact_path)现在,我们可以评估这些模型并记录结果。MLflow 提供了 mlflow.evaluate() API 来帮助评估我们的 LLM。
for i in len(model_names):
with mlflow.start_run(run_id=run_ids[i]):
# reopen the run with the stored run ID
evaluation_results = mlflow.evaluate(
model=f"runs:/{run_ids[i]}/{artifact_paths[i]}",
model_type="text",
data=dataset['test'],
)可视化与比较结果
在将不同的指标与模型记录到 MLFlow 后,我们就可以进行比较了。我们可以使用 MLflow 友好的用户界面来可视化并比较不同运行的评估指标。为此,如尚未运行,需要先启动 MLflow 服务器
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlruns然后我们打开浏览器并导航至 http://localhost:5000 以访问 MLflow UI。在 MLflow UI 中,前往“Experiments(实验)”页面查看所有实验。点击实验名称即可看到与之相关的运行列表。
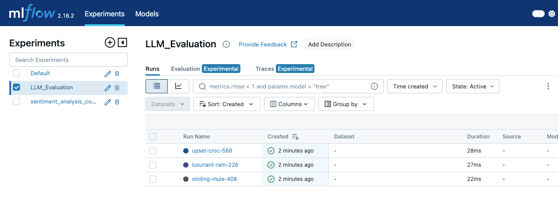
MLFLow 界面显示 Experiments 选项卡,可查看不同运行与日志事件——图片由作者提供。
在一个实验中,我们可以通过选择多个运行来并排比较它们的指标。
UI 允许我们查看如准确率、F1 分数等指标的可视化表示。我们还可以使用 MLflow 的内置可视化功能生成图表,以进行更细致的比较。
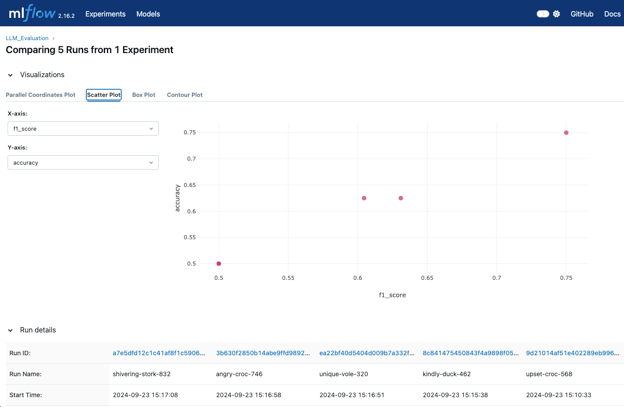
MLFlow 可视化能展示不同运行被记录的情况,便于比较不同指标——图片由作者提供。
MLflow UI 为每次运行提供详细的图表与日志。我们可以利用这些日志与可视化来判断基于已记录指标,哪个模型或配置的表现最佳。
使用 MLflow 进行 LLM 评估的高级技巧
为了进行更深入、更全面的 LLM 评估,MLflow 提供了可增强跟踪与分析的高级技巧。我们将回顾如何记录模型制品以进行全面跟踪,并利用 MLflow 进行超参数调优,以优化 LLM 性能。
记录模型制品
记录模型制品对于保存与分析实验细节非常重要。制品能够提供模型性能的完整画像,并有助于结果复现。
我们可以记录的制品包括:
- 模型权重:可使用适合对应框架的格式保存并记录模型权重(如 scikit-learn 的
joblib或 TensorFlow 的SavedModel格式)。 - 评估结果:可以记录准确率、精确率、召回率、F1 分数和混淆矩阵等指标,并将其保存为 CSV 或 JSON 以便访问。
- 生成的输出:如果模型会生成输出(如预测或生成的图像),也可以将其作为制品记录。这些可以包括文件、图表或可视化内容,有助于理解模型表现。
示例如下:
import matplotlib.pyplot as plt
from sklearn.metrics import ConfusionMatrixDisplay
with mlflow.start_run() as run:
# Log the model
mlflow.pytorch.save_model(model, "model")
# Log the model weights
joblib.dump(model, "model_weights.pkl")
mlflow.log_artifact("model", artifact_path="model")
# Log the confusion matrix as image
confusion_matrix = pd.DataFrame(confusion_matrix(y_test, predictions))
cm = ConfusionMatrixDisplay(confusion_matrix=cm)
plt.savefig("confusion_matrix.png")
mlflow.log_artifact("confusion_matrix.png")
# Generate predictions
outputs = dataset['test']
outputs['prediction'] = model.predict(dataset['test'])
with open("generated_outputs.txt", "w") as f:
for output in outputs:
f.write(output + "\n")
# Log the file
mlflow.log_artifact("generated_outputs.txt")使用 MLflow 进行超参数调优
超参数调优是优化 LLM 性能的关键环节。在实验中,我们可以使用 MLflow 记录不同的超参数配置,从而比较各种设置的效果并找到最优配置。
from transformers import Trainer, TrainingArguments
def train_and_log_model(model, lr, bs):
training_args = TrainingArguments(
output_dir='./results',
num_train_epochs=3,
per_device_train_batch_size=batch_size,
per_device_eval_batch_size=batch_size,
learning_rate=learning_rate,
evaluation_strategy="epoch")
trainer = Trainer(model=model,
args=training_args,
train_dataset=(X_train, y_train)
eval_dataset=(X_test, y_test))
with mlflow.start_run() as run:
# Log hyperparameters
mlflow.log_param("learning_rate", lr)
mlflow.log_param("batch_size", bs)
trainer.train()
eval_result = trainer.evaluate()
mlflow.log_metric("eval_accuracy",
eval_result['eval_accuracy'])
hyperparameter_grid = [{"learning_rate": 5e-5, "batch_size": 8},
{"learning_rate": 3e-5, "batch_size": 16}]
for params in hyperparameter_grid:
train_and_log_model(params["learning_rate"],
params["batch_size"])MLflow 的另一大优势是可以与 Optuna 或 Ray Tune 等超参数优化库配合使用,实现调优过程的自动化。
使用 MLflow 评估 LLM 的最佳实践
准确评估 LLM 不仅仅是运行测试与记录指标,还需要制订策略以确保一致性、准确性与高效性。采用最佳实践可以提升评估过程的可靠性与有效性。
使用稳定且具代表性的数据集是实现有效评估的首要因素之一。确保评估数据集稳定且能代表 LLM 设计执行的任务,我们就能在不同时间与不同模型或版本之间进行有意义的比较。如果数据集发生变化,就很难判断性能变化是源自模型还是数据集本身。
不仅是数据集本身,我们对其进行预处理的方式同样至关重要。我们需要对所有评估数据集应用相同的预处理步骤,以确保结果可比。这包括分词、归一化以及对特殊情况的处理。一致的预处理可以确保模型性能的差异不是由数据处理方式不同所致。
如上所示,利用 MLflow 的模型注册表进行版本控制有助于我们跟踪不同版本的 LLM。这便于比较模型性能,并在需要时回滚到先前版本。我们应记录所有细节,并追踪对模型所做的更改,包括架构、超参数或训练数据的修改。
最后,将评估过程自动化并集成到持续集成/持续部署(CI/CD)流水线中,可以帮助我们确保每当有更新时模型都能得到一致且及时的评估。我们应设置定期评估,周期性地衡量模型性能。这有助于监控模型漂移,并确保模型在一段时间内持续满足性能标准。
结语
要有效评估 LLM,需要结构化、系统化的方法,而 MLflow 正好提供了支持这一流程的框架。
在本教程中,我们安装了 MLflow 并设置了跟踪服务器。随后,我们通过记录重要指标来评估 LLM,跟踪多次运行进行比较,并利用 MLflow 的 UI 有效地可视化与分析这些比较。
如果您想进一步提升对 MLflow 的掌握,欢迎查看我们的 Introduction to MLflow 课程!
FAQs
什么是 MLFlow,以及如何用于评估语言模型?
MLFlow 是一个开源平台,用于管理机器学习生命周期,包括实验、可复现性与部署。它提供用于跟踪指标、参数与模型的工具,从而更轻松地高效评估 LLM。
如何安装 MLflow?
可通过 pip 使用命令 pip install mlflow 进行安装。您还需要确保环境中具备所用机器学习框架所需的依赖。
如何在 MLFlow 中可视化评估结果?
MLFlow 提供内置工具来可视化随时间变化的指标与性能。可以利用 MLFlow UI 比较不同运行、可视化趋势,并创建信息丰富的图表以获得更深入洞察。
MLflow 如何处理 LLM 的超参数调优?
MLflow 允许您记录不同的超参数配置及其对应指标,从而轻松比较各种设置对模型性能的影响。
使用 MLFlow 评估 LLM 时应遵循哪些最佳实践?
一些最佳实践包括一致地记录参数与指标、标准化预处理、跟踪模型版本、自动化评估,并定期监控性能,以确保使用 MLflow 对 LLM 进行有效评估。
MLflow 能与 LLM 开发中的其他工具(如 TensorBoard 或 Hugging Face)集成吗?
可以。MLflow 能与 TensorBoard 等工具集成以进行额外的指标可视化,或与 Hugging Face 库集成以实现无缝的模型加载与评估。您可以配置 MLflow 来记录这些工具的指标与参数,并与 MLflow 管理的其他实验一并跟踪。
MLflow 如何帮助长期管理 LLM 应用中的数据漂移?
MLflow 的跟踪服务器可以随时间记录与监控指标,便于检测模型漂移——即因数据或环境演化导致的性能变化。通过在 MLflow 中设置定期评估,您可以周期性分析这些指标,并判断 LLM 是否需要重新训练或其他调整。
我可以用 MLflow 比较基于不同数据集训练的 LLM 吗?
当然可以。MLflow 允许您跟踪每次实验,其中包括所用数据集的信息。通过为每次运行标注数据集名称与相关配置,您可以在 MLflow UI 中比较基于不同数据集训练的模型,更轻松地为特定任务找到最佳数据集。
MLflow 是否支持 LLM 的多 GPU 或分布式训练?
尽管 MLflow 本身不处理分布式训练,但它可以与分布式训练框架(如 Horovod 或 PyTorch 的 DDP)配合使用,在分布式环境中记录参数、指标与制品。MLflow 仅记录分布式运行的结果,确保捕获每种配置的细节。
我可以用 MLflow 将微调后的 LLM 与基础模型分别做版本控制吗?
是的,MLflow 的模型注册表允许您管理不同版本的模型,包括微调后的 LLM。您可以将每个微调模型作为同一实验或项目下的独立版本进行标注与记录。这样便于跟踪、比较,并在需要时回退到特定的微调版本。

作者
Maria Eugenia Inzaugarat
大型语言模型(LLM)在机器学习模型开发中变得至关重要,尤其是在增强自然语言处理算法能力方面。从聊天机器人到内容生成器,这些模型正在改变我们与技术互动的方式。
然而,随着 LLM 的数量和复杂度不断增长,评估其性能就显得更加重要。如果缺少合适且准确的评估,我们很难判断模型是否按预期工作,或需要进行调整。
这正是 MLflow 大显身手的地方。MLflow 是一款开源工具,旨在简化机器学习实验的管理。它帮助我们跟踪不同实验的结果、管理模型,并让一切井然有序!
在本教程中,我们将探讨 MLflow 在增强 LLM 工作流中的作用。我将带您完成其安装与配置,并演示如何在 LLM 实验中记录指标和跟踪参数。最后,我们将看看 MLflow 如何支持高效的模型管理与部署。
什么是 MLflow?
MLflow 是一个开源平台,用于管理端到端的机器学习生命周期。它提供一系列工具,以简化机器学习模型的开发、跟踪与部署流程。
无论我们是在做一个小型项目,还是在用大模型管理复杂实验,MLflow 都能帮助我们保持有序与高效。
在机器学习生命周期中使用 MLflow 的一些优势包括:
使用 MLflow 的模型开发生命周期。图片来源:MLflow 文档。
MLflow 旨在让机器学习项目管理更加顺畅透明。对于像 LLM 这样复杂的模型,这一点尤为有用,我们马上就会看到。
为何用 MLflow 评估 LLM?
使用 MLflow 评估 LLM 有多项好处,例如跟踪模型版本、记录评估指标,并在不同维度上比较性能。
下面我们来详细看看这些优势。
跟踪模型版本
LLM 的开发涉及频繁的迭代与改进。每个新版本都会带来细微的增强或行为变化。MLflow 通过系统地跟踪模型版本来管理这些不同迭代。借助这一功能,我们能够重现实验结果、有效比较不同版本,并清晰地维护模型演进历史。
假设我们在尝试不同的微调技术;MLflow 可以帮助我们管理并回顾每个版本的结果,更容易识别哪次迭代表现最佳。
由于 MLflow 会完整记录每次实验及其相关结果,我们可以自信地分享研究,确保他人能够精确复现我们的结果。
如果我们的项目需要尝试不同的 LLM 架构或训练方法论,MLflow 的跟踪功能会让记录与共享我们的工作变得更容易。
记录评估指标
评估 LLM需要监控多种指标,如准确率、困惑度、F1 分数等。
MLflow 的日志功能允许我们高效、有序地记录这些指标。分析这些指标能帮助我们全面了解模型的性能表现。
例如,我们可能想比较不同超参数或训练数据集对模型性能指标的影响。借助 MLflow,我们可以记录并可视化这些指标,从而提炼可操作的洞察。
当模型在真实应用中部署和使用时,可能会出现模型漂移,即由于数据或环境变化导致性能下降。我们可以利用 MLflow 通过随时间跟踪模型性能来监控并管理模型漂移。
我们可以设置定期评估,并用 MLflow 记录与分析性能指标的变化,从而实时做出可执行的决策。
跨模型与超参数比较性能
MLflow 的一大优势是能够简化全面的模型比较。通过存储不同实验的详细记录,MLflow 使我们可以将多种 LLM 与超参数配置的性能并排比较。
找到合适的超参数往往决定了 LLM 开发的成败。
想象我们正在微调一款 LLM,并希望评估不同超参数设置的影响。使用 MLFlow,我们可以记录并比较不同学习率、批大小或 dropout 率的结果,找出表现最佳的配置,从而优化模型开发流程。
MLflow 的模型注册表与跟踪功能在评估用于部署的多个 LLM 时尤为有用。
假设我们有多个语言模型版本,正考虑用于生产环境。MLflow 可以帮助我们记录各模型的性能指标,进行对比,并基于实证而非仅凭直觉做出明智决策。
既然我们已经更加了解 MLflow 及其优势,让我们动手实践吧!