

课程
使用 LangChain 的 Retrieval Augmented Generation (RAG)
3 小时
21.2K
实践并学习路径你的进步。
使用 Google 继续检索增强生成(RAG)是当前 AI 领域最令人兴奋的技术之一。它将从海量数据集中检索真实信息的精准性,与大型语言模型的推理能力结合起来。结果如何?不仅准确,而且高度相关的回答。这也是 RAG 能为从聊天机器人、搜索引擎到个性化内容等各种应用提供动力的原因。
但问题在于:做出一个原型只是成功的一半。真正的挑战在于部署——也就是把您的想法变成一个可靠、可扩展的产品。
在本文中,我将向您展示如何使用LangChain 和 FastAPI 构建并部署 RAG 系统。您将学会如何从可运行的原型,迈向面向真实用户的全规模应用。
让我们开始吧!
在我们的另一篇指南中有详细介绍,检索增强生成(RAG)是自然语言处理中的一种相当先进的方法,能够显著提升语言模型的能力。
RAG 并非只依赖模型已有的知识,而是进一步在生成回答前,从外部来源引入新的相关信息。
其工作流程如下:当用户提出问题时,系统不会只依赖模型预训练获得的数据。它会先外出检索一个庞大的文档或数据源集合,提取最相关的片段,然后将其喂给语言模型。借助模型的内在知识与新检索到的信息,模型能够生成更准确、更新、更贴切的回答。
RAG 融合了检索与生成,因此回答不仅“聪明”,还以真实、客观的信息为依据。这使它非常适合用于问答、聊天机器人,甚至是需要事实准确与上下文理解的内容生成。
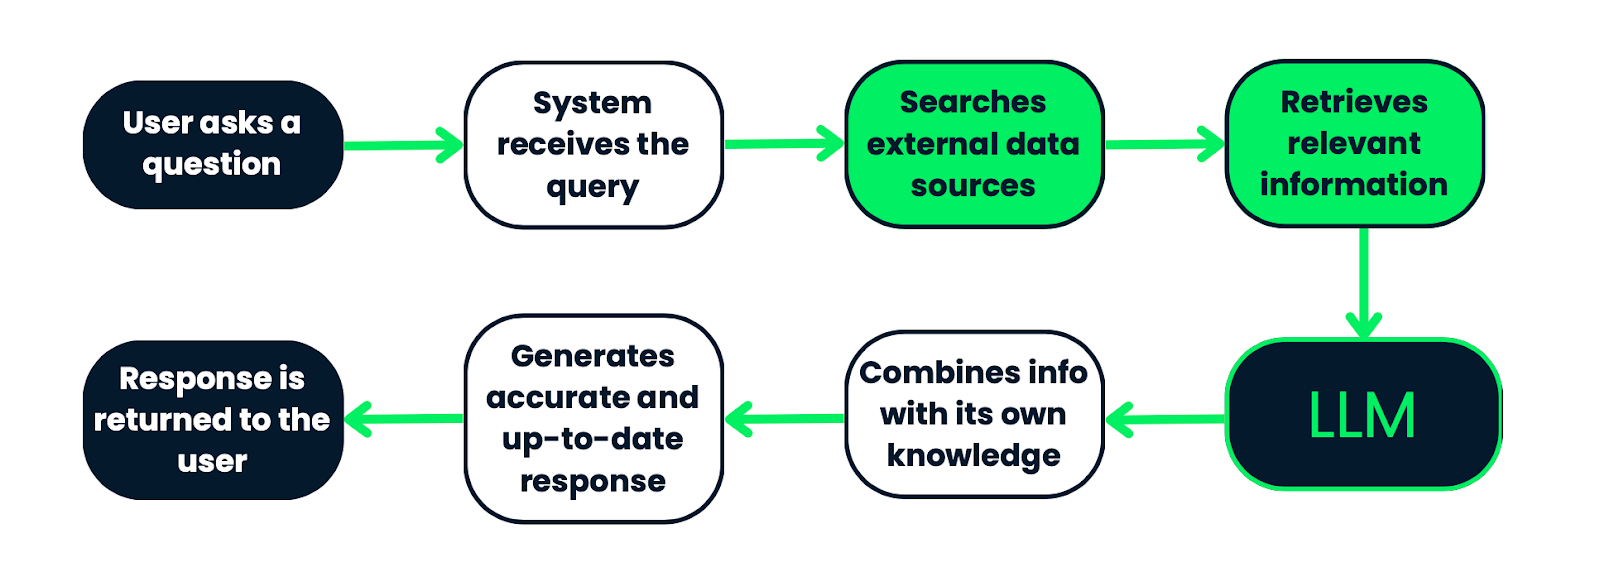
RAG 系统的工作流程。它始于用户查询,系统据此在外部数据源中搜索相关信息。检索到的信息随后被输入到 LLM 中,LLM 将其与自身的预先知识结合,生成准确且最新的回答。最后,回答返回给用户。该过程确保输出基于事实且符合上下文。
在构建 RAG 系统时,有几个必不可少的部分:文档加载器、文本切分、索引、检索模型和生成模型。我们来逐一拆解:
第一步是准备数据。这正是文档加载器、文本切分与索引要完成的工作:
这些是 RAG 系统的核心。它们负责在已建立索引的数据中挖掘您所需的信息。
精彩之处在这里。相关数据检索完成后,生成模型接手并产出最终回答。
|
组件 |
描述 |
|
文档加载器 |
从文本文件、PDF 或数据库等来源导入数据,并将信息转换为系统可用的格式。 |
|
文本切分 |
将已加载的数据切分为更小片段,便于在语言模型限制内进行检索与处理。 |
|
索引 |
将切分后的数据组织为向量表示,以便快速高效地搜索,找到与查询相关的信息。 |
|
向量存储 |
专门存储向量表示的数据库,利用向量相似度搜索,根据查询检索最相关的信息。 |
|
检索器 |
搜索组件,将查询转换为向量,检索向量存储,并为下一步获取最相关的文本块。 |
|
语言模型 |
结合检索数据与内部知识,生成连贯且符合语境的回答。 |
|
上下文化回答生成 |
将用户问题与检索数据结合,生成既回答问题又融入相关信息的详细回复。 |
在构建 RAG 系统之前,需要先正确设置开发环境。您需要准备:
python --versionpython3 -m venv ragenv
source ragenv/bin/activate # For Linux/Mac
ragenv\Scripts\activate # For Windows安装依赖:现在使用 pip 安装所需的包。
pip install fastapi uvicorn langchain langchain-community openai langchain-openai faiss-cpu|
FastAPI |
Uvicorn |
LangChain |
OpenAI API |
|
用于构建 API 的现代 Web 框架。 |
用于服务您的 FastAPI 应用的 ASGI 服务器。 |
驱动 RAG 系统的核心库。 |
用于生成回答的 GPT 模型。 |
专业提示:请创建 requirements.txt 文件来指定项目所需的包。如果您使用: pip freeze > requirements.txt
该命令会生成包含所有已安装包及其版本的 requirements.txt 文件,便于部署或与他人共享同一环境。
添加您的 OpenAI API 密钥:若要在 RAG 系统中集成 OpenAI 语言模型,您需要提供 OpenAI API 密钥:
OPENAI_API_KEY=your-openai-api-keypip install python-dotenvfrom dotenv import load_dotenv
import os
load_dotenv()
openai_api_key = os.getenv("OPENAI_API_KEY")现在,您的 OpenAI API 密钥已从环境中安全加载,可以开始在 RAG 系统中使用了!
PostgreSQL 与 PGVector(可选):如果您计划使用 PGVector 存储向量,请确保在您的机器上安装并配置 PostgreSQL。您也可以使用 FAISS(本文将使用)或 LangChain 支持的其他向量数据库。
Docker(可选):Docker 可以帮助将应用容器化,确保跨环境一致部署。如果打算使用 Docker,请同时在本机安装好。
构建 RAG 系统的第一步是准备系统用于检索相关信息的数据。这包括将文档加载进系统、对其进行处理,并确保其以便于索引和检索的格式存在。
LangChain 提供多种文档加载器来处理不同的数据源,如文本文件、PDF 或网页。您可以用这些加载器将文档引入系统。
我对北极熊很着迷,因此我决定上传以下文本文件(my_document.txt),内容如下:“Polar Bears: The Arctic Giants
Polar bears (Ursus maritimus) are the largest land carnivores on Earth, and they’ve adapted perfectly to life in the extreme cold of the Arctic. Known for their thick white fur, which helps them blend into the snowy landscape, polar bears are powerful hunters, relying on sea ice to hunt seals, their primary source of food.
What’s fascinating about polar bears is their incredible adaptations to their environment. Beneath that thick fur is a layer of fat that can be up to 4.5 inches thick, providing insulation and energy reserves during the harsh winter months. Their large paws help them tread across both ice and open water, making them strong swimmers—able to cover great distances in search of food or new territory.
Unfortunately, polar bears are facing serious threats from climate change. As the Arctic warms, sea ice is melting earlier in the year and forming later, reducing the time polar bears have to hunt seals. Without enough food, many bears struggle to survive, and their population numbers are dwindling in some areas.
Polar bears play a crucial role in maintaining the health of the Arctic ecosystem, and their plight serves as a powerful reminder of the broader impacts of climate change on the world’s wildlife. Conservation efforts are underway to protect their habitat and ensure these majestic creatures continue to thrive in the wild.”
from langchain_community.document_loaders import TextLoader
loader = TextLoader('data/my_document.txt')
documents = loader.load()
这里加载的是一个简单的文本文件,作为教学示例,但您可以添加任意类型的文档!例如,您可以添加组织的内部文档。现在 documents 变量持有文件内容,已准备好进行处理。
大型文档通常会被拆分为更小的片段以便于索引和检索。这个过程非常关键,因为更小的片段更易于语言模型处理,也能实现更精确的检索。您可以在我们的指南《AI 和 RAG 的分块策略》中了解更多。
from langchain.text_splitter import RecursiveCharacterTextSplitter
splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
document_chunks = splitter.split_documents(documents)
在此,文本被切分为 500 个字符的片段,片段之间重叠 50 个字符。该重叠有助于在检索过程中保持跨片段的上下文。
数据准备完成后,下一步是为高效检索建立索引。索引涉及将文本片段转换为向量嵌入,并存储到向量存储中。
LangChain 支持使用多种模型创建向量嵌入,例如 OpenAI 或 HuggingFace 模型。这些嵌入表示文本片段的语义含义,使之适用于相似度搜索。
简单来说,嵌入就是把文本(如文档中的一段话)转换成一组数字,便于 AI 模型理解。这些数字(向量)以一种更易于系统处理的方式表达文本含义。
from langchain_openai.embeddings import OpenAIEmbeddings
embeddings = OpenAIEmbeddings()我们使用OpenAI 的嵌入来完成该转换。首先引入 OpenAI 的嵌入工具,然后对其进行初始化以备使用。
生成嵌入后,下一步是将其存储在如PGVector、FAISS 或 LangChain 支持的其他向量存储中。这样在发起查询时即可快速而准确地检索相关文档。
from langchain_community.vectorstores import FAISS
vector_store = FAISS.from_documents(document_chunks, embeddings)本例中我们使用FAISS,这是一款为大规模向量搜索而设计的优秀工具。FAISS 能够非常快速地找到最相似的向量。
也就是说:我们从 LangChain 引入 FAISS,并用它创建一个所谓的向量存储。它就像一个专门为存放和检索向量而优化的数据库。
这种设置的妙处在于,后续检索时,FAISS 能在所有向量中进行搜索,找到与特定查询最相似的那些,并返回对应的文档片段。
数据索引完成后,您就可以实现检索组件,它负责基于用户查询获取相关信息。
现在我们来设置一个检索器。它会在已建立索引的文档中寻找与用户查询最相关的内容。
好处在于,您并非进行“随机”搜索,而是借助嵌入进行“语义”搜索,因此返回的结果与用户问题在语义上更为接近。来看这行代码:
retriever = vector_store.as_retriever(
	 search_type="similarity",
	 search_kwargs={"k": 5}
	)
首先,我们把向量存储转换为检索器。您已经用 FAISS 建好了装满文档嵌入的向量存储,现在我们告诉它:“当用户提问时,用它来搜索。”
接着是 search_type,这是关键所在。检索器可以用不同方式搜索,这里可选项有多种。相似度搜索是检索的“基本功”,它会找出与查询在语义上最接近的文档。
当您指定 "search_type='similarity'" 时,就是在告诉检索器:“根据我们生成的嵌入,找出与查询最相似的文档。”
通过 search_kwargs={"k": 5},您可以进行微调。k 值决定了从向量存储取回多少文档。本例 k=5 表示“给我返回 5 条最相关的文档”。
这非常有用,因为它能减少噪声。相比于得到一堆“可能相关”的结果,您只会获取最重要的信息片段。
在这部分代码中,我们用 LangChain 搭建 RAG 系统的核心引擎。您已经有了一个检索器,它能基于查询返回相关文档。
现在我们加入 LLM,并用它来根据检索到的文档实际生成回答。
from langchain_openai import OpenAI  # Updated import
from langchain.chains import RetrievalQA
这里我们导入两个关键元素:
llm = OpenAI(openai_api_key=openai_api_key)这行代码使用您的 OpenAI API 密钥初始化 LLM。可以将其视为为系统装上“头脑”——它会读取文本、理解并生成回答。
qa_chain = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=retriever
)
精彩的部分来了。我们在设置 QA Chain,它将一切串联起来。RetrievalQA.from_chain_type() 会创建一个问答链,也就是“把检索器与 LLM 结合起来,使系统能够基于检索到的文档回答问题”。
随后,我们告诉该链使用刚初始化的 OpenAI LLM 来生成答案。然后再连接之前构建的检索器,由它根据用户查询找到相关文档。
接着设置 chain_type="stuff":这里的 “stuff” 是什么?它其实是 LangChain 中的一种链类型。“stuff” 的含义是把所有相关的检索文档都加载到 LLM 中,让它基于全部内容生成回答。
这就像把一堆笔记扔到 LLM 桌上说:“给你这些信息,请用它们来回答问题。”
当然也有其他链类型(如 “map_reduce” 或 “refine”),但“stuff” 最简单直接。
query = "Are polar bears in danger?"
response = qa_chain.invoke({"query": query})
此处我们真正向系统发问并获得回答。invoke() 方法会触发整个流水线。
它接收您的查询,将其交给检索器以获取相关文档,然后将文档传给 LLM 生成最终回复。
print(response)最后打印由 LLM 生成的回答。系统会基于检索到的文档,输出一个完整、信息充分的答案,并打印出来。
最终脚本如下:
from dotenv import load_dotenv
import os
from langchain_community.document_loaders import TextLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai.embeddings import OpenAIEmbeddings
from langchain_community.vectorstores import FAISS
from langchain.chains import RetrievalQA
from langchain_openai import OpenAI

# Load environment variables
load_dotenv()
openai_api_key = os.getenv("OPENAI_API_KEY")

# Load the document
loader = TextLoader('data/my_document.txt')
documents = loader.load()

# Split the document into chunks
splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
document_chunks = splitter.split_documents(documents)

# Initialize embeddings with OpenAI API key
embeddings = OpenAIEmbeddings(openai_api_key=openai_api_key)

# FAISS expects document objects and the embedding model
vector_store = FAISS.from_documents(document_chunks, embeddings)

# Use the vector store's retriever
retriever = vector_store.as_retriever()

# Initialize the LLM (using OpenAI)
llm = OpenAI(openai_api_key=openai_api_key)

# Set up the retrieval-based QA chain
qa_chain = RetrievalQA.from_chain_type(
   llm=llm,
   chain_type="stuff",
   retriever=retriever
)

# Example query
query = "Are polar bears in danger?"
response = qa_chain.invoke({"query": query})

# Print the response
print(response)现在是时候构建一个与 RAG 系统交互的 API 了。但为什么部署时这一步必不可少?
想象一下,您一路跟着教程走,如今已经拥有一个针对您文档和需求量身打造的优秀 RAG 系统——它能检索相关信息、处理查询并生成智能回复。但您如何让用户或其他系统真正与之交互呢?
FastAPI 就是您的“中间人”。它为用户或应用提供一种简单而结构化的方式来向您的 RAG 系统提问并获取答案。
FastAPI 具备异步与高性能特性。这意味着它可以同时处理大量请求而不致变慢,这对于可能需要检索大量数据或执行复杂查询的 AI 系统尤为重要。
本节将修改先前脚本并创建更多文件,确保您的 RAG 系统可访问、可扩展,并能应对真实世界的流量。我们先创建用于处理进入 RAG 系统请求的路由。
在工作目录中新建 main.py 文件。这是 FastAPI 应用的入口。它将作为 FastAPI 的“大脑”——汇集所有 API 路由、依赖以及 RAG 系统。
from fastapi import FastAPI
from endpoints import router
app = FastAPI()
app.include_router(router)
这是一套相当简洁的设置,但很清晰。我们在此创建一个 FastAPI 实例,然后从另一个文件(稍后会创建)引入所有路由(即 API 路径)。
现在就把一切串起来。我们将编写一个函数,使当用户提交查询时,您的 RAG 系统能够实际运行。
async def get_rag_response(query: str):该函数使用 async 声明,表示它是异步的。也就是说,在等待响应期间它还能处理其他任务。
这对检索型系统尤其有用,因为检索文档或请求 LLM 可能需要一些时间。借此,FastAPI 可以在其后台处理的同时响应其他请求。
retriever = setup_rag_system()这里我们调用 setup_rag_system() 函数,正如先前所述,它会初始化整个检索管线。这意味着:
该检索器会根据用户查询负责拉取最相关的文本片段。
当用户提问时,检索器会遍历向量存储中的所有文档,基于查询取回最相关的内容。
retrieved_docs = retriever.get_relevant_documents(query)此 invoke(query) 方法会拉取这些相关文档。其背后机制是将查询与嵌入向量进行匹配,并按相似度取回最优匹配。
拿到相关文档后,我们需要为 LLM 格式化它们。
context = "\n".join([doc.page_content for doc in retrieved_docs])此处我们将所有检索到的文档内容合并为一个字符串。这很重要,因为 LLM 期待输入一个干净的文本块,而不是一堆分散的片段。
我们使用 Python 的 join() 将文档片段拼接成一个连贯的信息块。每个文档的内容保存在 doc.page_content 字段中,我们用换行符(\n)连接。
现在来为 LLM 构建提示(prompt)。
prompt = [f"Use the following information to answer the question:\n\n{context}\n\nQuestion: {query}"]该提示以一种能引导 LLM 使用检索信息回答用户问题的方式进行结构化。
现在是生成回答的时刻。
generated_response = llm.generate(prompt) # Pass as a list of strings此处,OpenAI 模型将根据提示,结合问题与相关文档,生成具备上下文意识的回答。
最后,我们将生成的回答返回给调用方(无论是用户、前端应用还是其他系统)。
return generated_response该回答是完整、具备上下文且可直接用于真实应用的。
总之,该函数完成了完整的检索与生成循环。流程回顾如下:
1. 设置检索器以查找相关文档。
2. 基于查询拉取这些文档。
3. 为 LLM 准备由这些文档组成的上下文。
4. LLM 使用上下文生成最终回答。
5. 将回答返回给用户。
from dotenv import load_dotenv
import os

from langchain_community.document_loaders import TextLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_openai.embeddings import OpenAIEmbeddings
from langchain_community.vectorstores import FAISS
from langchain_openai import OpenAI

# Load environment variables
load_dotenv()
openai_api_key = os.getenv("OPENAI_API_KEY")

# Initialize the LLM (using OpenAI)
llm = OpenAI(openai_api_key=openai_api_key)

# Function to set up the RAG system
def setup_rag_system():
   # Load the document
   loader = TextLoader('data/my_document.txt')
   documents = loader.load()

   # Split the document into chunks
   splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
   document_chunks = splitter.split_documents(documents)

   # Initialize embeddings with OpenAI API key
   embeddings = OpenAIEmbeddings(openai_api_key=openai_api_key)

   # Create FAISS vector store from document chunks and embeddings
   vector_store = FAISS.from_documents(document_chunks, embeddings)

   # Return the retriever for document retrieval with specified search_type
   retriever = vector_store.as_retriever(
       search_type="similarity",  # or "mmr" or "similarity_score_threshold"
       search_kwargs={"k": 5}  # Adjust the number of results if needed
   )
   return retriever

# Function to get the response from the RAG system
async def get_rag_response(query: str):
   retriever = setup_rag_system()

   # Retrieve the relevant documents using 'get_relevant_documents' method
   retrieved_docs = retriever.get_relevant_documents(query)

   # Prepare the input for the LLM: Combine the query and the retrieved documents into a single string
   context = "\n".join([doc.page_content for doc in retrieved_docs])

   # LLM expects a list of strings (prompts), so we create one by combining the query with the retrieved context
   prompt = [f"Use the following information to answer the question:\n\n{context}\n\nQuestion: {query}"]

   # Generate the final response using the language model (LLM)
   generated_response = llm.generate(prompt)

return generated_responseendpoints.py 中定义 API 路由接下来创建 endpoints.py 文件。我们将在其中定义用户与 RAG 系统交互时调用的路径。
from fastapi import APIRouter, HTTPException
from rag import get_rag_response
router = APIRouter()
@router.get("/query/")
async def query_rag_system(query: str):
    try:
        # Pass the query string to your RAG system and return the response
        response = await get_rag_response(query)
        return {"query": query, "response": response}
    except Exception as e:
        raise HTTPException(status_code=500, detail=str(e))
我们创建一个 APIRouter 来管理 API 路由。定义了接收查询字符串的 **GET** 请求端点 /query/。它调用 rag.py 中的 get_rag_response 函数,后者处理整个 RAG 流水线(文档检索 + 语言生成)。如果出现任何问题,我们会抛出带详细信息的 HTTP 500 错误。
完成上述设置后,您就可以使用 Uvicorn 运行 FastAPI 应用了。它是让用户访问您的 API 的 Web 服务器。
在终端执行:
uvicorn app.main:app --reloadapp.main:app 告诉 Uvicorn 去 main.py 文件中寻找 app 实例,--reload 则在您修改代码时启用自动重载。
服务器启动后,在浏览器打开 http://127.0.0.1:8000/docs。FastAPI 会自动生成 API 的 Swagger UI 文档,您可以直接在浏览器中进行测试!
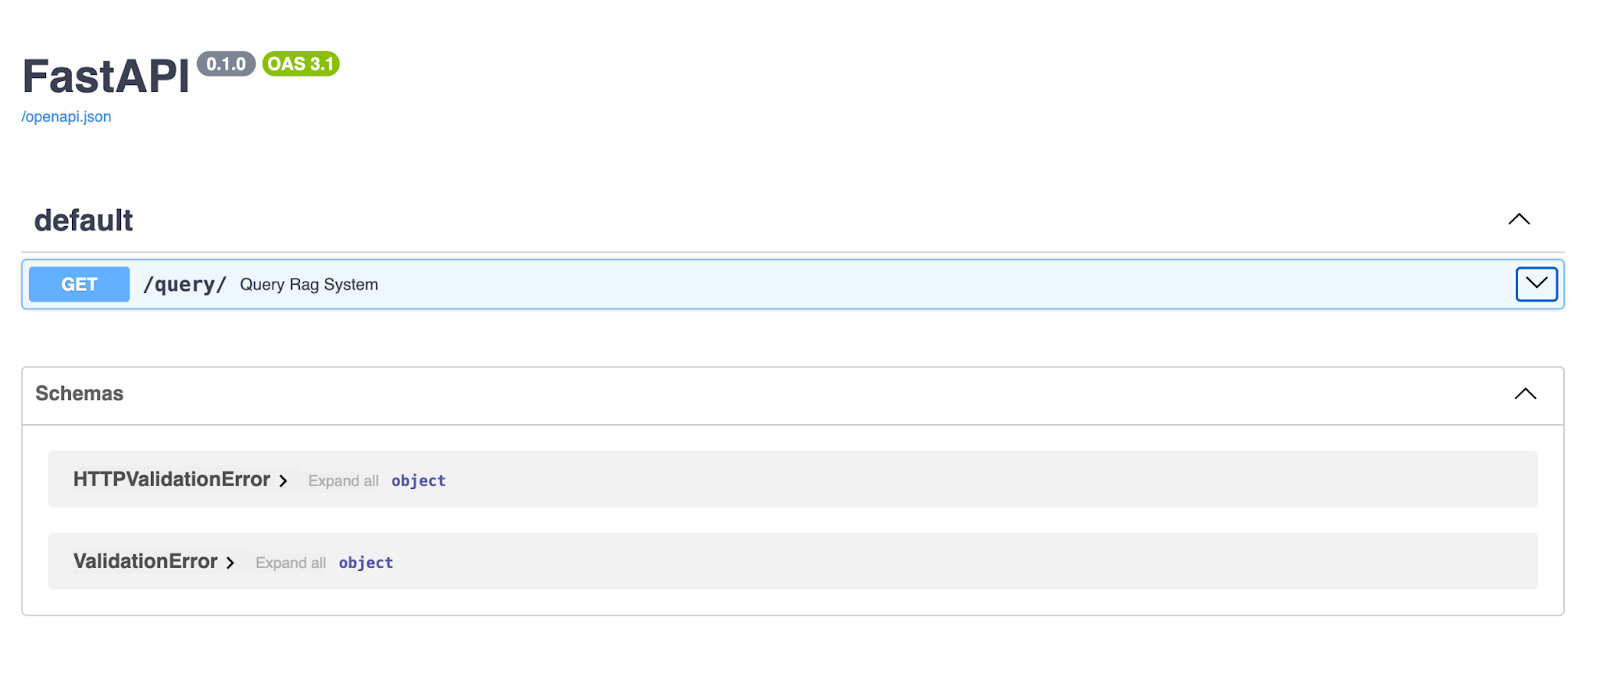
FastAPI 的 Swagger UI 提供了简洁的交互界面,便于探索与测试 API 端点。这里,/query/ 端点允许用户输入查询字符串,并接收由 RAG 流水线生成的回答。
在 FastAPI 服务器运行的情况下,前往浏览器,或使用 Postman、Curl 向 /query/ 端点发起 GET 请求。
在浏览器的 Swagger 中:
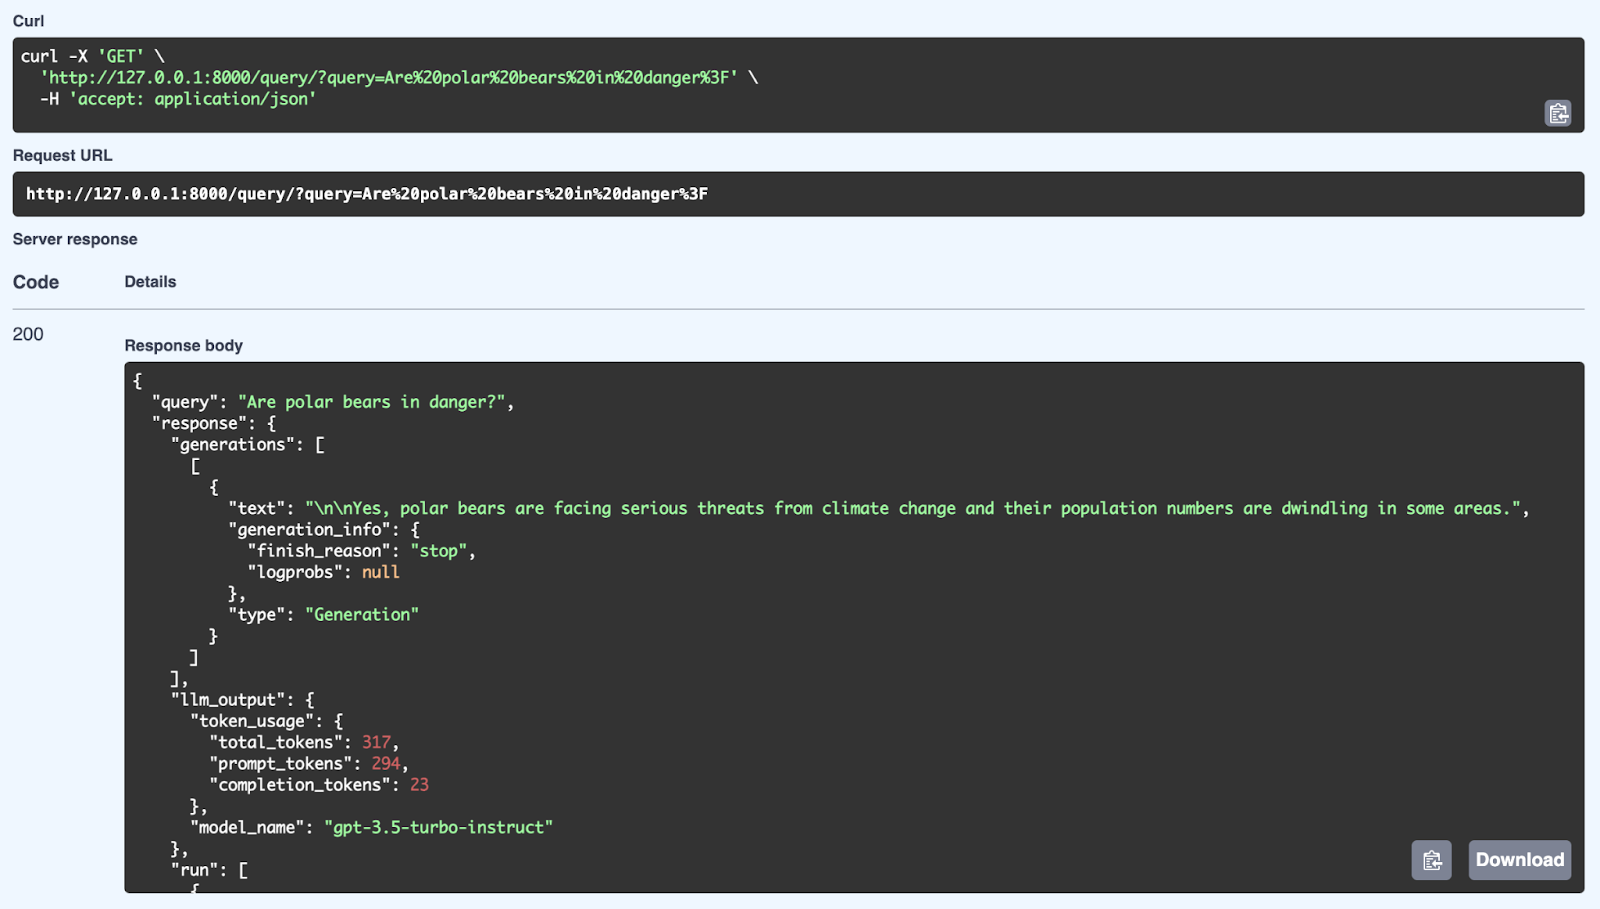
这里我们看到使用查询 “Are polar bears in danger?” 得到的 RAG 系统成功响应。系统从知识库检索相关信息,并使用 GPT-3.5 Turbo-Instruct 模型生成连贯回答。响应不仅包含结论(是的,北极熊正面临气候变化的严重威胁,且部分地区种群数量在下降),还包含诸如令牌用量和所用模型等元数据。该 API 通过 FastAPI 将检索与生成机制结合,提供结构清晰、具备上下文的答案。
接下来聊聊 FastAPI 中异步处理的优势,以及它为何能在应对真实世界 API 请求时发挥巨大作用。
您的 RAG 系统已经运行:API 接收问题、从知识库检索相关信息,并用语言模型生成回复。
如果整个流程是同步的,系统需要一个任务完成后才能继续下一个。例如,在检索文档期间,它无法处理新的请求。
|
非阻塞 I/O |
性能提升 |
更佳用户体验 |
|
异步函数让服务器可以同时处理多个请求,而不是等一个完成再处理下一个。 |
对于从向量存储检索文档或生成文本等任务,异步处理可确保 API 在高负载下也能高效运行。 |
客户端获得更快响应,即使在高并发情况下,API 也保持灵敏。 |
接下来说说部署策略——这是将 RAG 系统从原型转变为可实际运行产品的关键步骤。目标是确保系统被正确打包、部署并具备可扩展性,从而能应对真实用户场景。
首先是Docker。Docker 就像一个魔法盒子,把您的 RAG 系统所需的一切——代码、依赖、配置——都打包在一个整洁的容器里。
这样无论部署到哪里,应用的行为都完全一致。即使运行在不同环境中,也无需担心“只在我机器上能跑”的问题。
您需要创建一个 Dockerfile,它是一组指令,告诉 Docker 如何设置应用环境、安装依赖并启动运行。完成后,您可以基于它构建 Docker 镜像,并在容器中运行应用。高效、可复现且极具可移植性。
当系统打包完毕并准备就绪,您很可能希望将其部署到云端。这样可以在全球范围内访问您的 RAG 系统。同时,云端能提供可扩展性、可靠性,并能接入其他云服务以增强系统能力。
我们来看几个更常用的云平台,包括 Azure 与 Google Cloud:
AWS 提供诸如 Elastic Beanstalk 之类的工具,部署非常便捷。您基本上把 Docker 容器交给它,AWS 会负责扩缩容、负载均衡与监控。如果需要更强控制力,可以使用 Amazon ECS,在服务器集群上运行 Docker 容器,并按需弹性扩缩。
Heroku 也是简化部署的选择之一。您只需推送代码,Heroku 会替您处理基础设施。如果您不想过多涉及云资源管理的细节,这是个不错的选择。
Azure 提供 Azure App Service,便于部署与管理您的 RAG 系统,并内置自动扩缩容、负载均衡与持续部署支持。
若需更灵活的控制,您可使用 Azure Kubernetes Service(AKS)在规模上管理 Docker 容器,确保系统能够应对高流量,并按需动态调整资源。
GCP 提供 Google Cloud Run,这是一个全托管的平台,可根据流量自动扩缩容器部署。
如果您希望对基础设施有更多掌控,可以选择 Google Kubernetes Engine(GKE),它能够在多节点上管理与扩缩 Docker 容器,并与谷歌的 AI 与机器学习 API 深度集成。
各平台各有所长,取决于您是更偏好简便自动化,还是对部署进行更细粒度的控制。
本文带您走过使用 LangChain 与 FastAPI 构建 RAG 系统的全过程。RAG 系统是自然语言处理的一大进步,因为它能够引入外部信息,使 AI 生成更准确、更相关且更具上下文意识的回复。
借助 LangChain,我们有了一个稳健的框架,涵盖从文档加载、文本切分、创建嵌入,到基于用户查询进行信息检索的完整流程。
随后,FastAPI 提供了快速、面向异步的 Web 框架,帮助我们将 RAG 系统以可扩展的 API 形式部署。
二者结合,使我们更容易构建能够处理复杂查询、给出精准答案并带来更佳用户体验的 AI 应用。
现在,是时候将所学应用到您的项目中了。
想象这些可能性:查询公司内部知识库、自动化文档审阅流程,或打造面向客户支持的智能聊天机器人。
别忘了——扩展空间很大!您可以尝试使用 POST 请求传递更复杂的数据结构,甚至探索通过 WebSocket 实现实时交互。
我鼓励您更深入地探索、动手实验,看看它能带您走到哪里。这只是使用 LangChain、FastAPI 与现代 AI 工具的一个起点!以下是我推荐的资源:
Top DataCamp Courses
课程
课程
实践并学习路径你的进步。
使用 Google 继续