

DeepEval 入门
本教程将使用 Kaggle 作为编码环境。首先,新建一个笔记本。
我们还将使用 OpenAI API。请先创建一个 API 密钥。然后,使用 Kaggle 的“Secrets”功能为 OpenAI API 密钥配置环境变量。
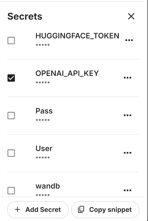
随后,使用 pip 命令安装 DeepEval 和 BitsandBytes Python 库:
%%capture
%pip install -U deepeval
%pip install -U bitsandbytes从 Secrets 加载 OpenAI API 密钥:
import os
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_value_0 = user_secrets.get_secret("OPENAI_API_KEY")
os.environ['OPENAI_API_KEY'] = secret_value_0使用 Jupyter Notebook 的魔法命令写入以下 Python 文件。
test_relevancy.py 文件定义了一个测试函数,使用 GPT-4o 模型评估 LLM 输出的相关性。它通过将模型对给定输入的响应与检索上下文进行对比,确保输出与所提供的信息一致。
%%file test_relevancy.py
from deepeval import assert_test
from deepeval.test_case import LLMTestCase
from deepeval.metrics import AnswerRelevancyMetric
def test_relevancy():
relevancy_metric = AnswerRelevancyMetric(threshold=0.5, model="gpt-4o")
test_case_1 = LLMTestCase(
input="Can I return these shoes after 30 days?",
actual_output="Unfortunately, returns are only accepted within 30 days of purchase.",
retrieval_context=[
"All customers are eligible for a 30-day full refund at no extra cost.",
"Returns are only accepted within 30 days of purchase.",
],
)
assert_test(test_case_1, [relevancy_metric])在终端中运行相关性测试:
!deepeval test run test_relevancy.py以下测试结果显示,该 LLM 测试用例成功通过,并获得了 1.0 的完美相关性得分,说明模型响应完全相关。
评估在 3.04 秒内完成,预计令牌总成本为 0.0027425 美元:
Evaluating 1 test case(s) in parallel: |█|100% (1/1) [Time Taken: 00:03, 3.00s/
.Running teardown with pytest sessionfinish...
============================= slowest 10 durations =============================
3.03s call test_relevancy.py::test_relevancy
(2 durations < 0.005s hidden. Use -vv to show these durations.)
1 passed, 2 warnings in 3.04s
Test Results
┏━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━┳━━━━━━━━┳━━━━━━━━━━━━━━━━━┓
┃ ┃ ┃ ┃ ┃ Overall Success ┃
┃ Test case ┃ Metric ┃ Score ┃ Status ┃ Rate ┃
┡━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━╇━━━━━━━━╇━━━━━━━━━━━━━━━━━┩
│ test_relevancy │ │ │ │ 100.0% │
│ │ Answer │ 1.0 │ PASSED │ │
│ │ Relevancy │ (threshold=0.... │ │ │
│ │ │ evaluation │ │ │
│ │ │ model=gpt-4o, │ │ │
│ │ │ reason=The │ │ │
│ │ │ score is 1.00 │ │ │
│ │ │ because the │ │ │
│ │ │ response was │ │ │
│ │ │ perfectly │ │ │
│ │ │ relevant and │ │ │
│ │ │ addressed the │ │ │
│ │ │ question │ │ │
│ │ │ directly │ │ │
│ │ │ without any │ │ │
│ │ │ irrelevant │ │ │
│ │ │ information. │ │ │
│ │ │ Great job!, │ │ │
│ │ │ error=None) │ │ │
└────────────────┴─────────────────┴────────────────┴────────┴─────────────────┘
Total estimated evaluation tokens cost: 0.0027425 USD
✓ Tests finished 🎉! Run 'deepeval login' to save and analyze evaluation results
on Confident AI.
‼️ Friendly reminder 😇: You can also run evaluations with ALL of deepeval's
metrics directly on Confident AI instead.您也可以参考 Hugging Face 生态,通过 HumanEval:用于评估 LLM 代码生成能力的基准 指南来评测 LLM。
在 G-Eval 指标上测试 LLM
G-Eval 是一个使用思维链(CoT)推理、基于自定义标准评估 LLM 输出的框架。作为 DeepEval 最灵活的指标,G-Eval 几乎可以以类人的准确度处理任何用例,是评估 LLM 表现的关键工具。
本节我们将使用 G-Eval 指标评估一组 LLM 响应数据集。
1. 配置 G-Eval 指标
我们将创建 G-eval 指标,并提供自定义指令,以测试模型在事实矛盾、遗漏惩罚上表现,并聚焦核心观点,同时允许使用含糊语言或存在不同观点:
from deepeval.metrics import GEval
from deepeval.test_case import LLMTestCaseParams
correctness_metric = GEval(
name="Correctness",
model="gpt-4o",
evaluation_params=[
LLMTestCaseParams.EXPECTED_OUTPUT,
LLMTestCaseParams.ACTUAL_OUTPUT],
evaluation_steps=[
"Check whether the facts in 'actual output' contradicts any facts in 'expected output'",
"You should also lightly penalize omission of detail, and focus on the main idea",
"Vague language, or contradicting OPINIONS, are OK"
],
)2. 创建评估用例
围绕不同主题创建三个 LLM 测试用例。每个用例包含一个输入提示、一个实际生成的输出和一个期望输出。GPT-4o 模型将对其进行对比,并在最后生成详细结果:
from deepeval.test_case import LLMTestCase
from deepeval.dataset import EvaluationDataset
first_test_case = LLMTestCase(input="What are the main causes of deforestation?",
actual_output="The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.",
expected_output="The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.")
second_test_case = LLMTestCase(input="Define the term 'artificial intelligence'.",
actual_output="Artificial intelligence is the simulation of human intelligence by machines.",
expected_output="Artificial intelligence refers to the simulation of human intelligence in machines that are programmed to think and learn like humans, including tasks such as problem-solving, decision-making, and language understanding.")
third_test_case = LLMTestCase(input="List the primary colors.",
actual_output="The primary colors are green, orange, and purple.",
expected_output="The primary colors are red, blue, and yellow.")3. 构建评估数据集
将三个测试用例合并为评估数据集:
test_cases = [first_test_case, second_test_case, third_test_case]
dataset = EvaluationDataset(test_cases=test_cases)4. 运行 G-Eval 指标
在数据集上运行 G-Eval 评估测试:
evaluation_output = dataset.evaluate([correctness_metric])输出:
每个测试的结果包含指标摘要、测试用例,以及整体指标通过情况。
Evaluating 3 test case(s) in parallel: |██████████|100% (3/3) [Time Taken: 00:02, 1.08test case/s]
======================================================================
Metrics Summary
- ✅ Correctness (GEval) (score: 1.0, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The actual output matches the expected output exactly with no contradictions or omissions., error: None)
For test case:
- input: What are the main causes of deforestation?
- actual output: The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.
- expected output: The main causes of deforestation include agricultural expansion, logging, infrastructure development, and urbanization.
- context: None
- retrieval context: None
======================================================================
Metrics Summary
- ✅ Correctness (GEval) (score: 0.7, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The main idea of AI as the simulation of human intelligence is present, but details like problem-solving, decision-making, and language understanding are omitted., error: None)
For test case:
- input: Define the term 'artificial intelligence'.
- actual output: Artificial intelligence is the simulation of human intelligence by machines.
- expected output: Artificial intelligence refers to the simulation of human intelligence in machines that are programmed to think and learn like humans, including tasks such as problem-solving, decision-making, and language understanding.
- context: None
- retrieval context: None
======================================================================
Metrics Summary
- ❌ Correctness (GEval) (score: 0.01681606382274469, threshold: 0.5, strict: False, evaluation model: gpt-4o, reason: The actual output directly contradicts the expected output by listing green, orange, and purple as primary colors instead of red, blue, and yellow., error: None)
For test case:
- input: List the primary colors.
- actual output: The primary colors are green, orange, and purple.
- expected output: The primary colors are red, blue, and yellow.
- context: None
- retrieval context: None
======================================================================
Overall Metric Pass Rates
Correctness (GEval): 66.67% pass rate
======================================================================想用常用工具 MLflow 评估 LLM?请参阅使用 MLflow 评估 LLM 教程。
5. 分析测试用例结果
使用 G-Eval 指标对三个测试用例的评估达到了 66.67% 的通过率:一个完全匹配、一个因细节缺失为部分匹配、一个因直接矛盾而失败。这既体现了模型在事实准确性上的优势,也暴露了其在处理细节或细微差异时的局限。
对 Qwen 2.5 进行 MMLU 基准评测
MMLU(Massive Multitask Language Understanding,大规模多任务语言理解)是用于通过多项选择题评估大语言模型的广泛采用的基准。它涵盖数学、历史、法律与伦理等 57 个多元学科,是对 LLM 知识与推理能力的全面检验。凭借广泛的学科覆盖与高质量题目,MMLU 已成为评估 LLM 表现的标准之一。
我们将更进一步,在 MMLU 数据集上评估自定义 LLM(Qwen 2.5 7B)。该数据集包含输入提示与结果(A、B、C、D)。最终将依据答对题目的数量计算准确率百分比。
1. 创建自定义 LLM 模型类
我们将定义一个名为 QwenModel 的自定义类,继承自 DeepEvalBaseLLM,以便使用语言模型与分词器生成响应。
我们的目标是基于给定提示生成两个 token 的短输出。此外,我们将管理设备分配,并处理输入提示与输出文本的预处理。
from deepeval.models.base_model import DeepEvalBaseLLM
import torch, logging
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
class QwenModel(DeepEvalBaseLLM):
def __init__(self, model, tokenizer):
self.model = model
self.tokenizer = tokenizer
self.device = "cuda"
def load_model(self):
return self.model
def generate(self, prompt: str) -> str:
prompt = prompt.replace("Output 'A', 'B', 'C', or 'D'. Full answer not needed.","")
model_inputs = self.tokenizer([prompt], return_tensors="pt").to(self.device)
generated_ids = self.model.generate(
**model_inputs,
max_new_tokens=2,
do_sample=True,
pad_token_id=self.tokenizer.eos_token_id
)
prompt_length = len(model_inputs[0])
generated_tokens = generated_ids[0][prompt_length:]
clean_output = tokenizer.decode(generated_tokens, skip_special_tokens=True).strip()
return clean_output.replace(".","")
async def a_generate(self, prompt: str) -> str:
return self.generate(prompt)
def get_model_name(self):
return "Qwen2.5 7B"2. 加载模型与分词器
我们将创建两个函数,从本地直接加载 LLM 模型与分词器。以 8 bit 加载模型,并为同一模型初始化分词器,设置填充与特殊 token 配置:
def load_model(model_name: str):
quant_config = BitsAndBytesConfig(
load_in_8bit=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_compute_dtype=torch.float16,
bnb_4bit_use_double_quant=False
)
model = AutoModelForCausalLM.from_pretrained(
model_name,
quantization_config=quant_config,
device_map="auto"
)
model.config.use_cache = False
model.config.pretraining_tp = 1
return model
def load_tokenizer(model_name):
tokenizer = AutoTokenizer.from_pretrained(model_name, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
return tokenizer3. 构建自定义 LLM
通过“+ Add Input”按钮,将 Qwen 2.4 7b instruct 模型添加到 Kaggle 笔记本。
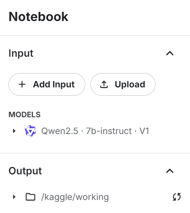
直接使用该模型来加载模型与分词器,然后将其传入自定义 LLM 类,创建一个 LLM 响应生成器:
# Load model and tokenizer
qwen_model_name = "/kaggle/input/qwen2.5/transformers/7b-instruct/1"
model = load_model(qwen_model_name)
tokenizer = load_tokenizer(qwen_model_name)
custom_model = QwenModel(model, tokenizer)4. 测试自定义 LLM
在生成基准结果前,先测试自定义 LLM:
# Test model generation
prompt = """
The following are multiple choice questions (with answers) about abstract algebra.
Find all c in Z_3 such that Z_3[x]/(x^2 + c) is a field.
A. 0
B. 1
C. 2
D. 3
Answer:"""
print(custom_model.generate(prompt))我们向 LLM 提供了数据集中的一个示例提示,它准确地以一个字母作答。
C5. 运行 MMLU 基准评测
现在我们将加载 MMLU 基准,定义任务,然后在自定义模型上运行评测:
from deepeval.benchmarks import MMLU
from deepeval.benchmarks.tasks import MMLUTask
# Define benchmark with specific tasks and shots
benchmark = MMLU(
tasks=[MMLUTask.HIGH_SCHOOL_COMPUTER_SCIENCE, MMLUTask.ASTRONOMY],
n_shots=5
)
benchmark.evaluate(model=custom_model, batch_size=5)我们获得了出色的结果,准确率达 83%!
Processing astronomy: 100%|██████████| 152/152 [01:51<00:00, 1.36it/s]
MMLU Task Accuracy (task=astronomy): 0.8157894736842105
Overall MMLU Accuracy: 0.8293650793650794让我们查看各个任务的结果:
benchmark.task_scores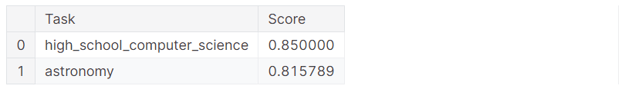
您也可以查看完整结果,了解哪些样本答对、哪些失败,从而获得对模型表现的更细粒度分析。
benchmark.predictions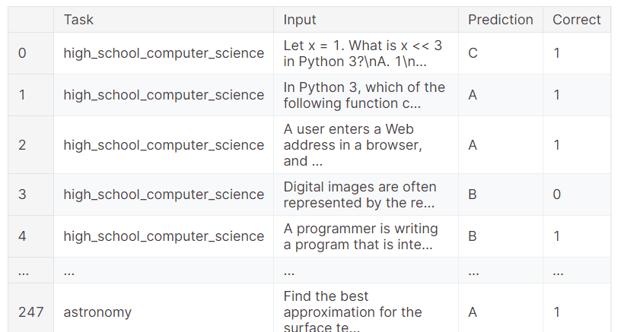
如果在运行上述代码时遇到任何问题,请参阅 Evaluating LLMs with DeepEval Kaggle 笔记本。它包含代码来源、数据集及评估结果。
结语
评估语言模型颇具挑战,尤其是在生产环境中。有时,简单的评估指标并不足够。务必运行一套基准与测试,从多项任务与功能维度评估您的 LLM 表现,以获得全面认识并明确改进空间。
在本教程中,我们在 Kaggle 笔记本中配置了 DeepEval,并进行了类似 Pytest 的 LLM 测试。随后,我们基于自定义指令构建了 G-Eval,并在评估数据集上运行。最后,我们将 Qwen 2.5 7B 模型与 MMLU 基准对照测试,分析其在高中计算机科学与天文学任务上的表现。
下一步,建议您探索 LLMOps 的工具与方法论,学习如何将 LLM 便捷地部署到生产环境。欲了解更多,请考虑学习 LLMOps Concepts 课程。

作为一名持证的数据科学家,我热衷于利用前沿技术打造创新的机器学习应用。凭借在语音识别、数据分析与报告、MLOps、对话式人工智能以及自然语言处理方面的扎实背景,我不断打磨构建智能系统的能力,力求带来切实影响。除技术专长外,我也擅长沟通,能够将复杂概念提炼为清晰、简明的表述。因此,我成为数据科学领域备受关注的博主,与不断壮大的数据专业人士社区分享洞见与实践经验。目前,我专注于内容创作与编辑,借助大语言模型打造有力且吸引人的内容,帮助企业与个人更好地发挥数据价值。
在机器学习生态中,能够有效从多种属性维度测试大语言模型(LLM)的评估框架并不多。随着 LLM 开发的指数级增长,跨各类任务评估其表现,并分析其优势、劣势与局限性,已变得至关重要。
DeepEval 作为一套全面且可靠的解决方案,应运而生。它提供了一个在多维度(如准确性、推理能力、一致性与伦理对齐)上测试 LLM 的强大框架。
在本教程中,您将学习如何设置 DeepEval,并创建类似 Pytest 的相关性测试。随后,您将使用 G-eval 指标测试 LLM 输出,并在 Qwen 2.5 模型上运行 MMLU 基准评测。本教程面向具备技术背景、想要更好理解 DeepEval 生态的初学者,内容简明易上手。
如果您刚接触 LLM,强烈建议先学习 Master Large Language Models (LLMs) Concepts 课程,打好基础。
认识 DeepEval
DeepEval 是一个专为大语言模型设计的开源评估框架,帮助开发者高效构建、改进、测试并监控基于 LLM 的应用。它通过允许用户像使用 Pytest 对传统软件进行测试那样,为模型编写“单元测试”,从而简化 LLM 输出的评估流程。
DeepEval 提供了广泛的功能,确保评估的全面性,包括 14 项有研究支撑的 LLM 评估指标、合成数据集生成、LLM 基准、红队测试,以及生产环境的实时评估。借助这些功能,DeepEval 不仅简化了测试流程,也提升了 LLM 驱动应用的安全性和可靠性。
阅读 LLM Evaluation 博文,了解如何使用关键指标、方法论与最佳实践来评估大语言模型。