
课程
Large Language Models (LLMs) 概念
2 小时
112K
新的 AI 模型几乎每周都有发布:Gemini 3, Claude Opus 4.5,GPT-5.2,Mistral Large 3。每次发布都会附带一串基准分数,并宣称在某些方面“最佳”。问题在于:大多数人并不清楚这些数字意味着什么,或该如何比较。
大型语言模型(LLM)基准测试是用来衡量模型在特定任务上表现的标准化测验,范围从广泛知识测验到复杂的编程挑战、再到多步推理问题。理解每个基准到底测量什么,能帮助您突破市场营销话术,选到真正契合实际需求的模型。
本指南将拆解主要的基准类别,说明去哪里查当前排名,并演示如何运行您自己的评估。读完之后,您就能读懂排行榜,并据此为您的用例选择合适的 AI。
若想深入了解 LLM 的底层工作原理,欢迎查看我们的 LLMs Concepts 课程。
LLM 基准测试是衡量语言模型处理某类任务能力的标准化测验。对每个参与测试的模型都会使用同样的问题与评分准则。
模型发布公告中的数字来自少数几个流行测试。每个分数代表的含义不同,且没有任何单一基准能给出完整图景。
基准测试之所以重要,主要有三点:
比较模型:当 OpenAI 发布 GPT-5.2,Anthropic 同月推出 Claude Opus 4.5 时,基准测试为我们提供共同的比较基线。否则,我们只能被迫接受各家公司基于断章取义案例的“夺冠”说法。
跟踪进展:在一段时间内重复运行同一基准,您就能看到模型是否真的在进步。MMLU 分数从 2022 年的 70% 跃升至 2025 年的 90% 以上。
发现短板:某个模型也许能轻松应对常识问答,却在多步数学上“卡壳”。基准测试会暴露这类弱点。
基准分数反映的不仅是“智商”。排行榜上的数字受到多种因素影响。
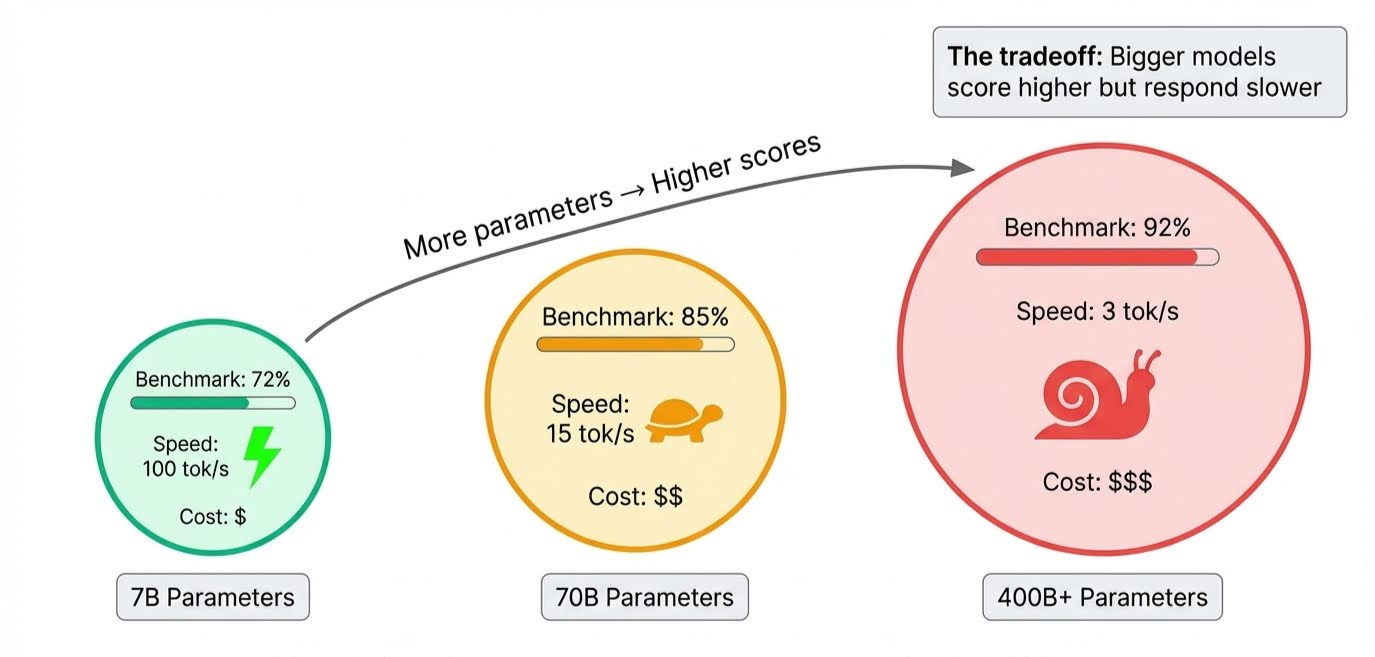
模型规模是显而易见的一项。参数存储着模型学到的一切,尖端模型往往拥有数千亿参数。参数越多,模型越能处理复杂推理并把握更多细微差别,分数也就越高。
这种权衡会在推理时显现——也就是模型实际生成回答的阶段:所有这些参数需要按序“点亮”,因此更大的模型更慢。某个模型也许能在所有基准中名列前茅,却要数秒才能给出回答。
训练时长更为棘手。对训练数据的一次完整遍历称为一个epoch。epoch 太少,模型学得不够,分数上不去;太多,则可能开始“背题”,而不是学习可迁移到新问题的模式。这就是过拟合,基准设计者会通过加入模型训练时不可能见过的问题来专门“抓”这种情况。
如今在用的基准多达数十个,按其实际测试内容分组会更有帮助。
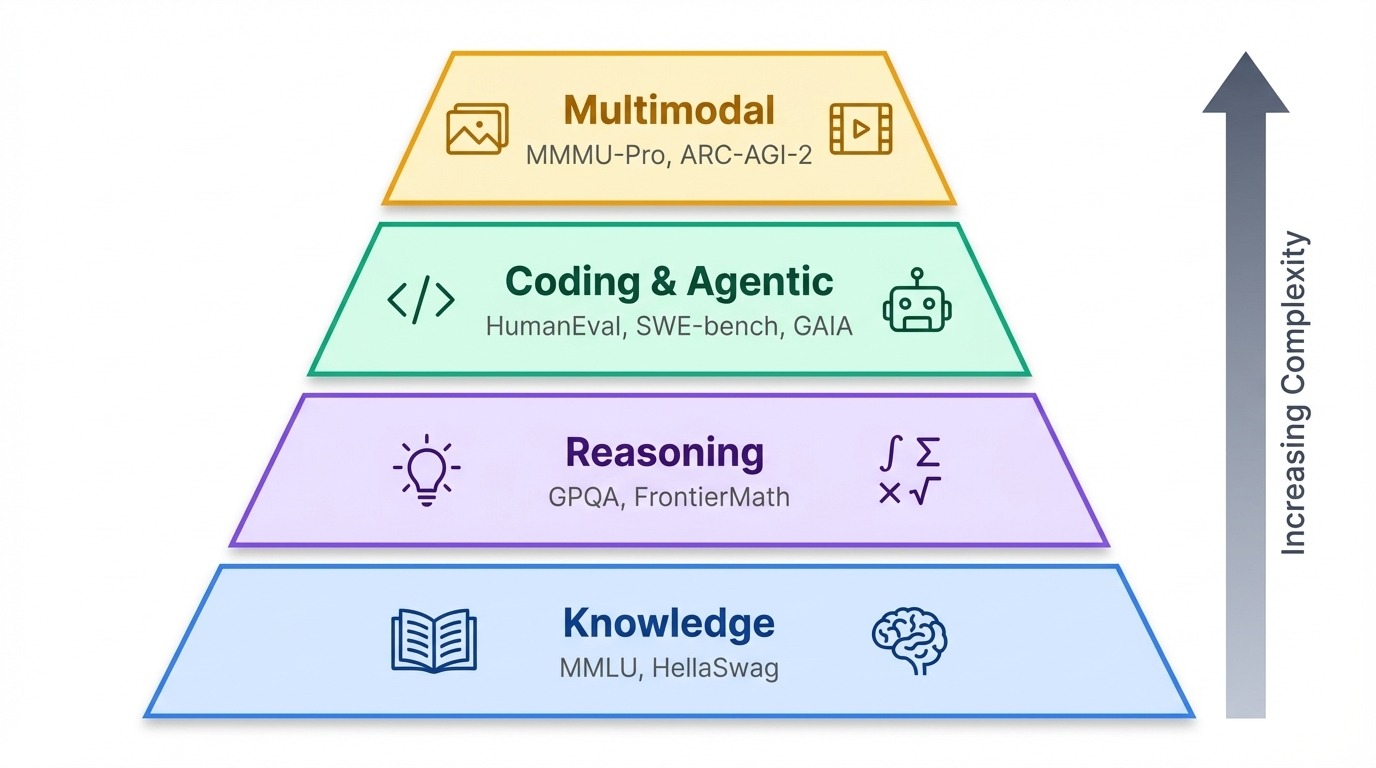
基准大致可分为一个层级结构。底层是知识测试,检查模型“知道什么”。其上是推理基准,考察“怎么想”。顶层是具身代理与多模态测试,用来衡量 AI 能否在现实世界中执行任务,或处理超越文本的信息。
MMLU(大规模多任务语言理解)涵盖 57 门学科,从高中到职业级别,主题从抽象代数到世界宗教不等。多年来,它一直是通用知识的“首选”测试,但如今尖端模型普遍高于 88%,已难以区分高下。
这种“饱和”推动研究者转向更难的测试。GPQA(研究生级、对搜索引擎“免疫”的问答)包含生物、物理和化学 448 道题,由领域专家专门设计为不可通过搜索直接得到答案。
该基准设有三档难度,Diamond 为最难。即便可无限制上网,非专家得分也只有 34%——仅比四选一随机猜测的期望值高 9%。截至 2025 年 12 月,Gemini 3 Pro 以 92.6% 领跑 GPQA Diamond。
OpenAI 的GDPval(“国内生产总值计价”的)基准衡量的则是另一件事:真实世界的工作产出。它覆盖价值 3 万亿美元年经济活动的 44 个职业,不再考多选题,而是要求模型产出可交付物,如法律意见书、演示文稿与工程规格说明。最新发布的GPT-5.2 在此方面居于领先。
HellaSwag 通过呈现日常场景并让模型选择最合理的下一句,来考察常识推理。比如:某人做饭时伸手拿起平底锅。接下来最可能发生什么?
错误选项是专门写来“骗过”AI 的:它们在统计上与上下文契合,但描述的是不可能发生的结果(锅漂走了、炉子变成了猫)。人类能拿到 95.6%,因为我们知道厨房如何运作。模型容易被“带偏”,因为它预测的是可能出现的词,而非可能发生的事件。
最新的基准进一步提升了难度:
FrontierMath 收录研究数学家从未发表过的问题,即便最强的模型得分也低于 20%。
Humanity's Last Exam 汇编了 2,500 道专家级问题,旨在让猜测无从下手。
MathArena 选用 2025 年数学竞赛试题,确保与训练数据零重叠。
HumanEval 是经典的编程测试:包含 164 道 Python 题,模型需根据文档字符串编写函数,并以单元测试通过与否打分。当前多数尖端模型得分超过 85%,因此研究者提出了更难的变体,如HumanEval+,采用更严格的测试用例。
SWE-bench (软件工程基准)超越了孤立函数层面。它将模型“投放”到真实的 GitHub 仓库,要求修复实际缺陷。模型必须在代码库中导航、理解问题并产出可用补丁。
SWE-bench Verified 是原始 SWE-bench 的一个更小、精心策选的子集,仅保留由人类工程师审核过的高质量任务。截止 2025 年 12 月,Claude Opus 4.5 首次在 SWE-bench Verified 上突破 80%(80.9%)。
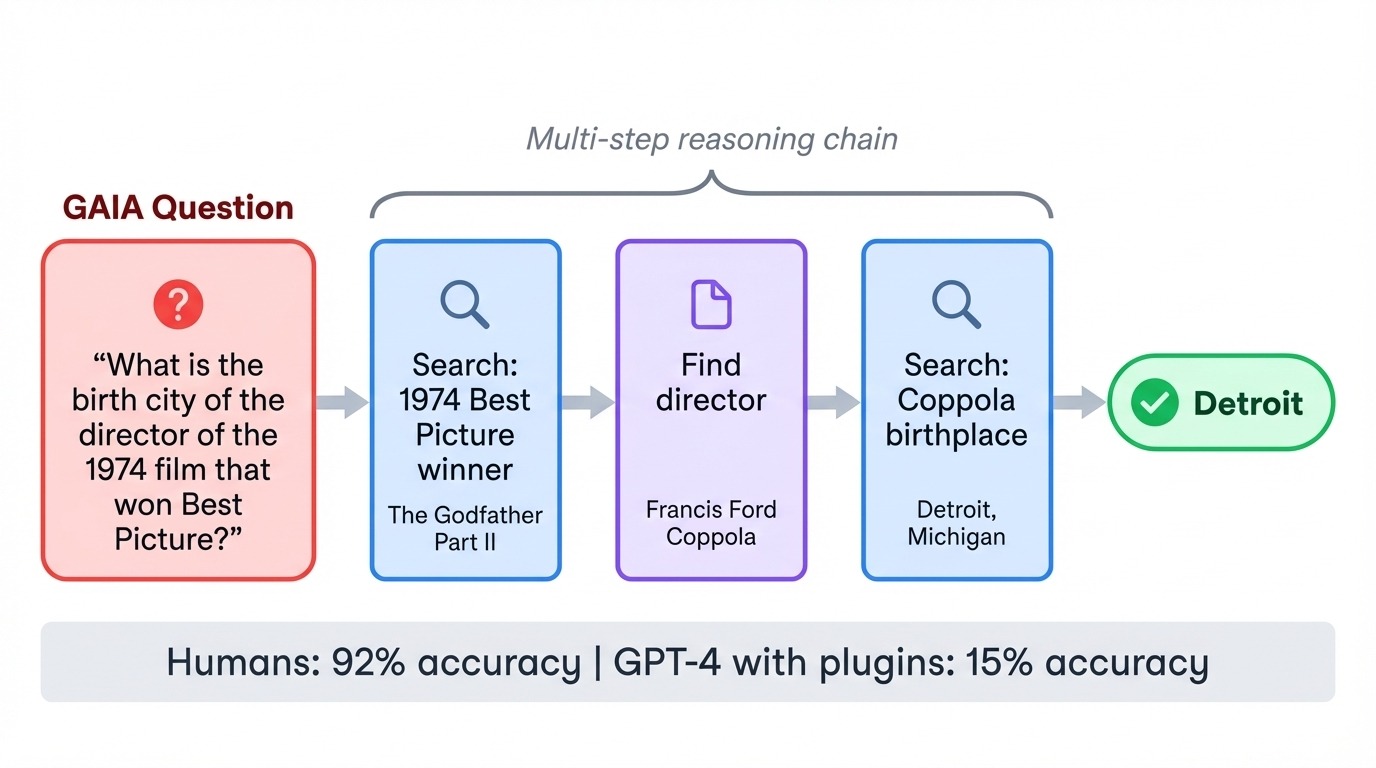
GAIA (通用 AI 助手)颠倒了常见的难度关系。其 466 个任务对人类而言几乎不费吹灰之力(92% 准确率),却对 AI 极具挑战。GPT-4 首次携插件挑战 GAIA 时仅得 15%。每个任务都需要将多个步骤串联起来:搜索网页、阅读文档、进行计算并综合答案。
一个典型问题可能会询问某部 1970 年代电影导演的出生城市,模型需要先确定影片、找到导演,再查询其生平细节。该基准考察模型能否协调使用工具,并在不“丢线”的情况下执行多步计划。
最后,WebArena 将模型部署在自托管的网页环境中,要求其通过与真实浏览器界面交互来完成订机票、管理内容系统、浏览电商网站等任务。
仅限文本的基准正在错过一个不断拓展的前沿。MMMU-Pro(大规模跨学科多模态理解与推理)通过在图片中直接嵌入问题来测试视觉推理,迫使模型同时读取并解释视觉信息。
该基准会过滤掉纯文本模型亦可作答的问题,以确保“视觉”确实至关重要。Gemini 3 Pro 以 81% 领跑此项。
有些基准将视觉推理提升到新的层次。
MathVista 例如,将视觉感知与数学推理结合。问题包括解读函数图、阅读科学图表、根据示意图解几何。Video-MMMU 则拓展到时间维度上的理解,测试模型能否跨视频帧而非单张图像来推理因果与序列。
ARC-AGI-2 仍是 AI 尚未攻克的基准。每道题都会给出若干输入-输出网格示例,要求模型归纳变换规则,并将其应用到新输入上。
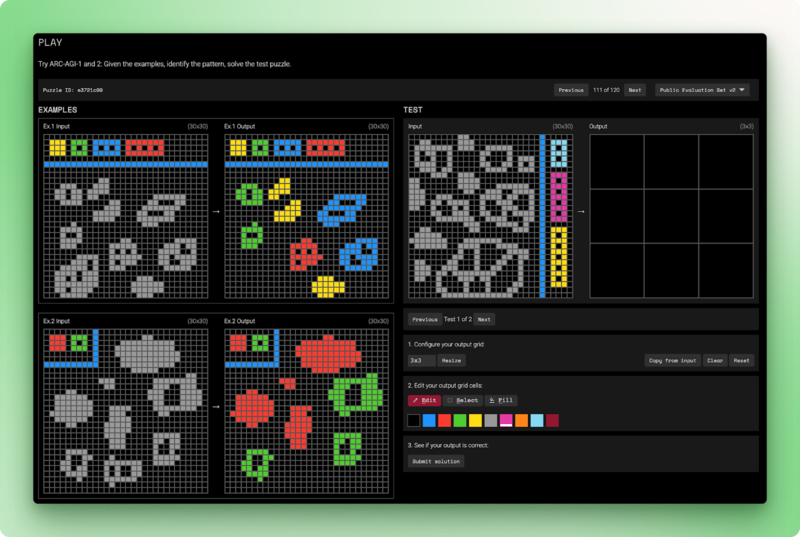
人类通常不超过两次尝试即可解出。纯语言模型得分为 0%。最佳的混合系统可达 54%,但每题成本高达 30 美元。ARC-AGI-2 测试的是流体智力:从第一性原理进行推理,而非匹配训练中见过的模式。
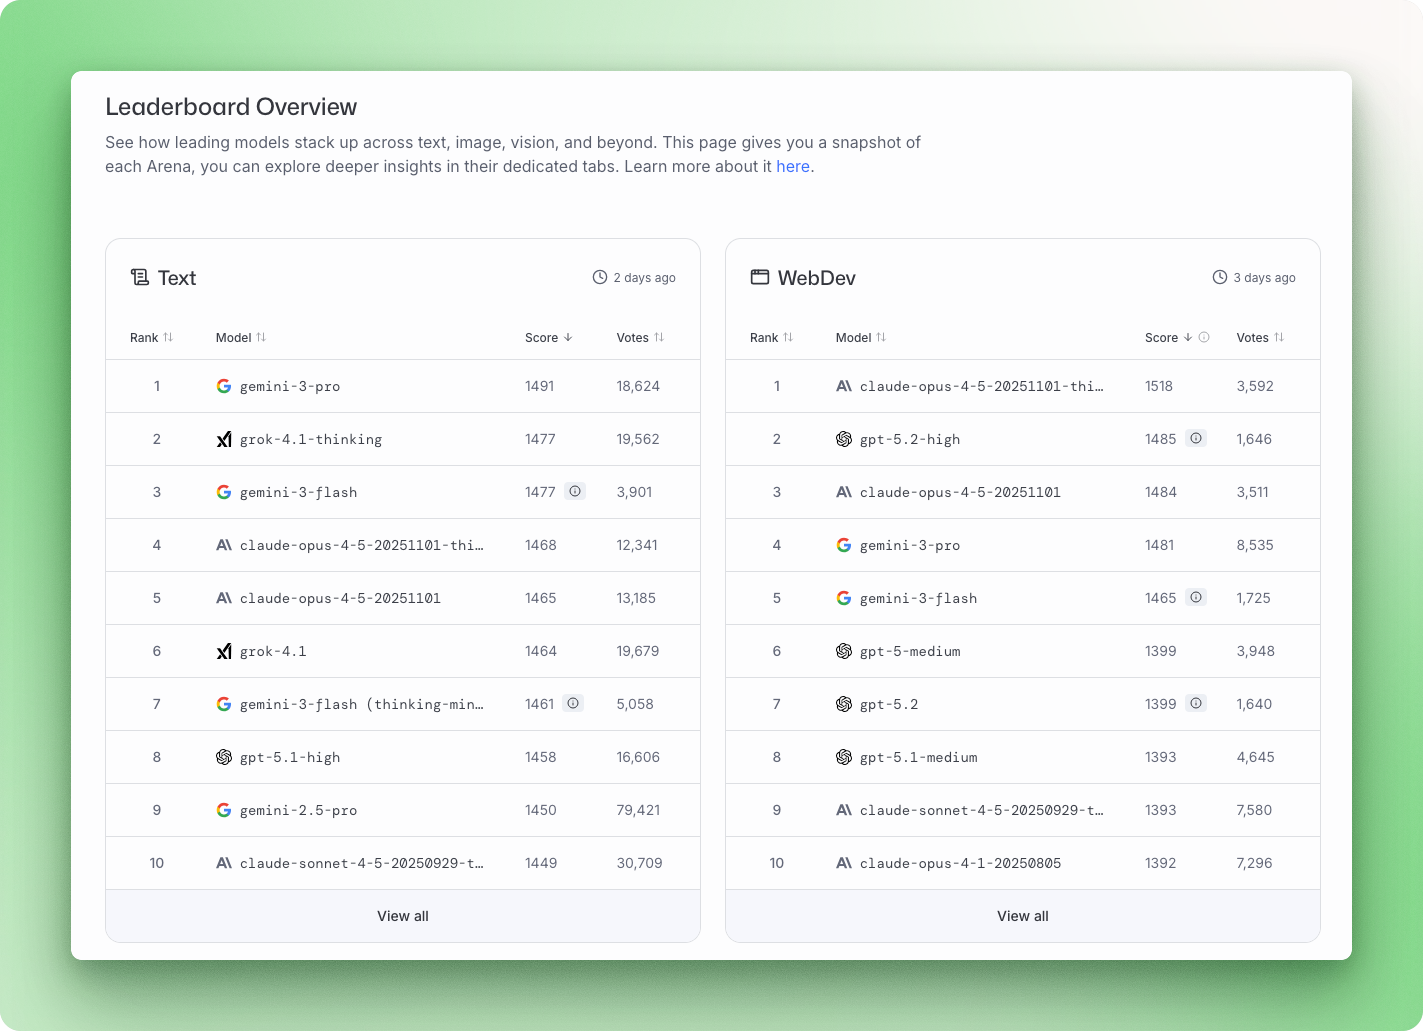
基准会产出分数,但排行榜决定如何呈现它们。不同平台侧重的因素不同:人类偏好、开源透明度,或多维度评估。您该看哪个榜,取决于您关心测量什么。
LMArena(LMSYS Chatbot Arena)采用与自动化基准不同的方法。它不按评分标准给答案打分,而是让人类从两个匿名模型的输出中选择更优者。用户提交一个提示,会收到两个匿名模型的回答,并为自己更喜欢的那一个投票。投票结束前,模型身份保持隐藏,避免品牌偏见影响选择。
该平台使用 Bradley-Terry 统计模型将超过 500 万次成对投票转换为排名。截止 2025 年 12 月,Gemini 3 Pro 以 1501 位居 Arena 总榜首位,其后是 Grok 4.1(1483),再是 Claude Opus 4.5 与 GPT-5.2。
LMArena 捕捉到传统基准容易错过的要点:回答“看起来”是否真的有用。代价在于,冗长且自信的回答有时会赢得选票,即便更短、更准确的答案也在其中。
Hugging Face 的 Open LLM Leaderboard 专注于开源模型,并使用 EleutherAI Evaluation Harness 运行标准化测试。2024 年 6 月发布的第 2 版引入了更难的基准,因为尖端模型已“打满”原有测试套件。
当前测试组包含 GPQA、MATH Level 5 和 MMLU-PRO,采用归一化计分:0 表示随机水平,100 表示满分。顶尖开源模型包括 Qwen3、Llama 3.3 70B 和 DeepSeek V3.1,它们的表现已与闭源领跑者相当接近。
Stanford HELM(语言模型的整体评估)不仅衡量结果是否准确。每个模型在每个场景下会从七个维度进行评估:准确性、校准、鲁棒性、公平性、偏见、毒性与效率。
该框架覆盖 42 个场景,并明确跟踪模型在哪些地方失败,而不仅仅是成功之处。HELM 还运行独立的安全排行榜,评估暴力、欺诈、骚扰等风险。截至 2025 年 12 月,Claude 3.5 Sonnet 在综合安全分上位居第一。
没有任何一家公司能在所有方面“通吃”。然而,一旦您交叉参考几个排行榜,规律便会浮现。
Google 的 Gemini 系列在多模态与科学推理方面占优。Gemini 3 Pro 以 91.9% 领跑 GPQA Diamond,并位居 Arena 总榜首位。Anthropic 的 Claude 系列在编程与安全方面表现突出。Claude Opus 4.5 以 80.9% 保持 SWE-bench Verified 纪录,Claude 3.5 Sonnet 领跑 HELM Safety。
OpenAI 的 GPT 系列依旧是强大的通才,在大多数基准上均具竞争力,且鲜有明显短板。Meta 的 Llama 系列证明开源在许多任务上可与闭源匹敌,Llama 3.3 70B 的输出可与更大规模的专有系统分庭抗礼。
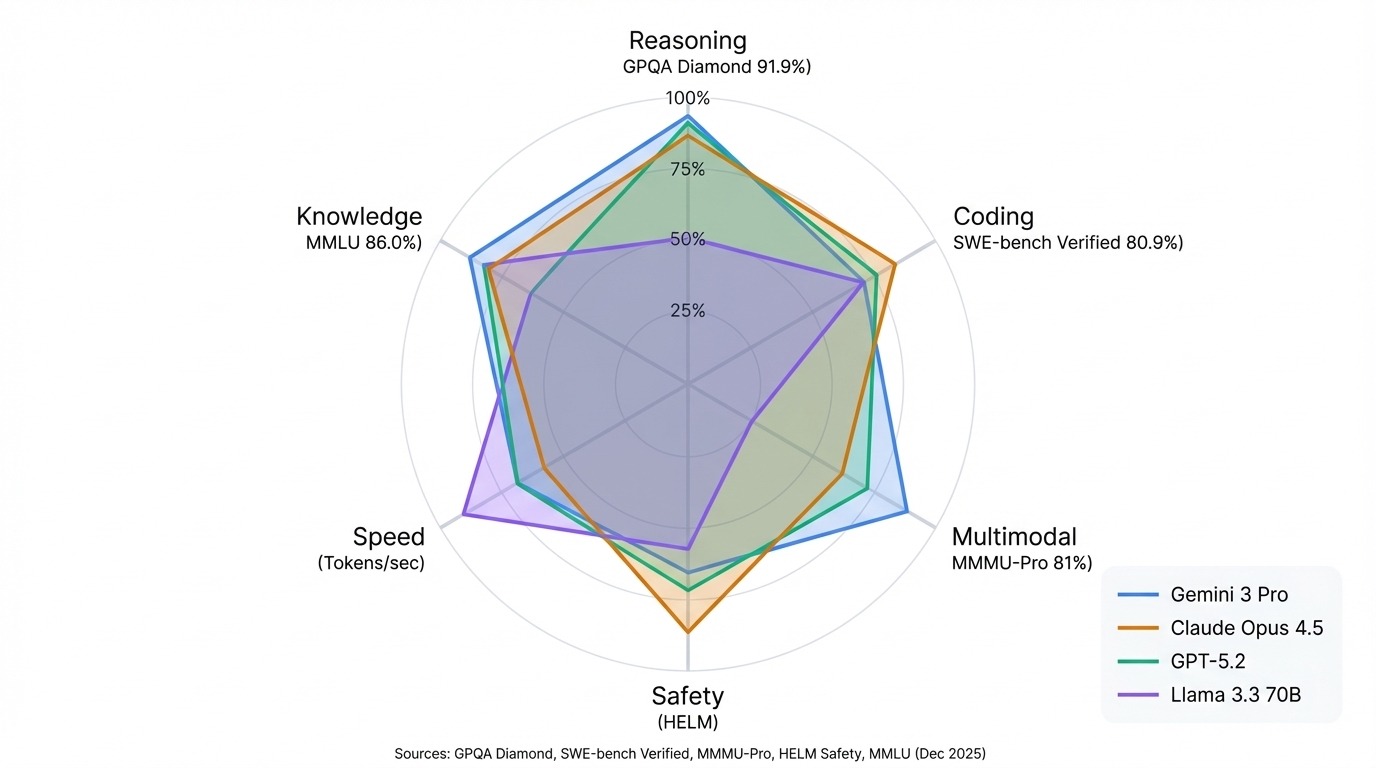
最重要的规律:将排行榜与您的用例“对号入座”。Arena 反映对话质量;HELM 体现可靠性与安全性;Hugging Face 跟踪您能自行运行的模型。一个模型在某榜单登顶,可能在另一个榜单中仅列中游——这并非排名“有问题”,而是不同测试在衡量不同的东西。
排行榜告诉您模型在标准化测试中的对比,但有时您需要更契合自身场景的答案。
比如,您可能在为既有硬件挑选开源模型,或核验一个微调模型并未丢失通用推理能力。还有些情况下,标准基准根本不覆盖您的领域。
在这些情形下,您都可以考虑亲自为 LLM 做基准评估。下面我将展示如何操作,以及需要注意什么。
这套 EleutherAI LM Evaluation Harness 是在本地运行评估的行业标准。它为 Hugging Face Open LLM Leaderboard 提供支持,并兼容 60 余种基准。
它的工作方式与大多数人平时和聊天机器人互动不同。它并不只是与模型“聊天”,而是进行更为确定性的数学分析。
对于多选题(如 MMLU 或 ARC 常见的设问方式),该工具不会让模型输出“A”“B”“C”或“D”。相反,它会为每个选项分别构造提示,并询问模型各自的可能性。拥有最高对数似然的选项将被视为模型的选择。
其他基准需要生成式方法,模型需给出完整文本回答。生成完成后,工具会使用正则表达式(regex)解析输出,提取用来与答案键比对的具体值。
下面来看看如何运行您的第一个 LLM 评估。
您可以使用 pip 安装评估工具:
pip install lm-eval在运行完整评估之前,先用小样本测试一下流水线。--limit 标志将基准限制在指定数量的样本。以下示例使用 HellaSwag 基准测试 Qwen2.5-1.5B-Instruct,这是一款无需高端 GPU、可在多数硬件上运行的小模型:
lm_eval --model hf \
	--model_args pretrained=Qwen/Qwen2.5-1.5B-Instruct \
	--tasks hellaswag \
	--device mps \
	--batch_size 4 \
--limit 10|
Tasks |
Version |
Filter |
n-shot |
Metric |
|
Value |
|
Stderr |
|
hellaswag |
1 |
none |
0 |
acc |
↑ |
0.3 |
± |
0.1528 |
|
none |
0 |
acc_norm |
↑ |
0.4 |
± |
0.1633 |
输出显示两个准确率指标:acc 为原始准确率,acc_norm 则校正了模型对短或长补全的偏好。此外还报告了标准误差,样本量越大该值越小。我们首次仅用 10 个样本测试,较高的 Stderr(0.15)意味着这些分数只是粗略估计。
移除 --limit 以运行完整基准。要一次运行多个基准,请用逗号分隔列出:
lm_eval --model hf \
	--model_args pretrained=Qwen/Qwen2.5-1.5B-Instruct \
	--tasks hellaswag,mmlu,arc_easy \
	--device mps \
	--batch_size 8 \
	--output_path ./results
根据您的硬件设置 --device:Apple 芯片用 mps,NVIDIA GPU 用 cuda:0,或退而求其次用 cpu。完整 MMLU 在现代 GPU 上需要 1–2 小时;较小的基准如 HellaSwag 则数分钟即可完成。
若要测试延迟与吞吐, Ollama 可在本地运行模型,并在不同量化级别下报告每秒 token 数。7B 模型在 V100 上可能超过每秒 100 个 token,而 70B 模型会降至个位数。
为 LLM 做基准评估时,有几条最佳实践需要牢记。
第一且最重要的是,务必确保模型在训练中没有见过评估题目。否则,您测到的只是过拟合,而非模型的推理能力(正如开头所述)。在这种情况下,基准分数将失去意义。
为了获得可复现的结果,应尽量降低模型输出的随机性。将温度设为 0 有助于优先保证准确性而非创造性。
该评估工具为每个基准都内置了标准化的少样本提示。请使用这些提示,而不要自行撰写,因为微小的措辞变化就会对分数产生超出预期的影响。然而,对于特定领域的工作,您应始终在投入生产前,基于领域内的真实样例构建一个小型测试集。
标准基准擅长核对事实,却难以衡量细微之处。对于摘要或创作等开放式任务,“LLM 充当裁判”会使用更强的模型来评判另一个模型输出的有用性与准确性。
裁判通常会拿到评分量表,并被要求给出数值评分(如 1–10 分),或进行成对比较,判断两个答案哪个更好。尽管并不完美,这类判断与人类偏好的一致率约为 80–85%。因此,LLM-as-a-judge 是昂贵的人类评审的一种可扩展替代方案。
AI 评估的演进速度与模型本身一样快。随着 MMLU 等基准趋于饱和,研究者正构建更难的测试,着重考察推理深度而非记忆性知识。FrontierMath 和 Humanity's Last Exam 就代表了这一新难度前沿,即便最强模型也仍在挣扎。
更广泛的信号指向同一方向:更多训练算力、更聪明的算法,以及能跟上进步步伐的基准套件。多模态测试正扩展我们对模型的要求,从读懂图表到理解视频序列。
但结论依然简单:没有任何一个分数能讲清全部。某个模型也许领跑 Arena,却在 SWE-bench 上落后;顶尖的编程模型也可能在安全性上仅居中游。请将基准与您的实际需求对齐:推理、代码生成、视觉理解,或原始速度。这才是唯一重要的比较。
若想在基准评估之上更进一步,学习自行构建与微调 LLM,请查看我们的Developing Large Language Models 技能路径。