

课程
Excel 数据分析
3 小时
155.3K
实践并学习路径你的进步。
使用 Google 继续不平等几乎影响生活的方方面面:收入、财富、健康、教育,甚至生态系统中的资源分配。但我们究竟如何衡量它?我发现最有力的不平等可视化工具之一就是洛伦兹曲线。
尽管它常用于衡量收入不平等,洛伦兹曲线并非只属于经济学家。随着时间演进,它已成为一项多用途工具,被用于研究医疗差异、生物多样性,甚至在机器学习中评估预测模型的公平性。对于数据科学家来说,它是讲述数据集中不平等故事的好方式。
在本教程中,我将向您展示洛伦兹曲线的工作原理。我们将讨论如何使用 Python 基于您的数据集创建它,并学习如何将其用于您的项目中。无论您对量化收入不平等、分析客户细分,还是研究资源配置感兴趣,洛伦兹曲线都能帮助您用简单的可视化来传达这些复杂概念。
洛伦兹曲线由经济学家 Max O. Lorenz 于 1905 年提出。其方法是将某一资源的实际分配与一个假想的完全平等线(即人人拥有同等数量的直线)进行比较。曲线离这条完全平等线越远,该资源分配中的不平等就越高。
洛伦兹曲线的结构很简单。x 轴绘制群体的累计占比,从最贫穷的个体开始,直到最富有的个体。y 轴展示被衡量资源的累计占比。
接下来,我们需要加入完全平等线,即从左下角到右上角的一条对角线。这条线代表我们关注的资源在人人之间平均分配的情形。
洛伦兹曲线本身展示资源的实际分配。曲线向远离完全平等线的方向弯曲得越厉害,代表的不平等就越大。
如果洛伦兹曲线接近完全平等的对角线,说明资源分配较为均匀。例如,在一个社会中,底部 50% 的人口大致拥有 50% 的收入,那么洛伦兹曲线会更靠近对角线。这种较平缓的曲线表明不平等程度较低。
相反,如果曲线大幅远离对角线,则表示高度不平等。比如,底部 50% 的人口仅拥有 10% 的收入,而前 10% 拥有其余全部。
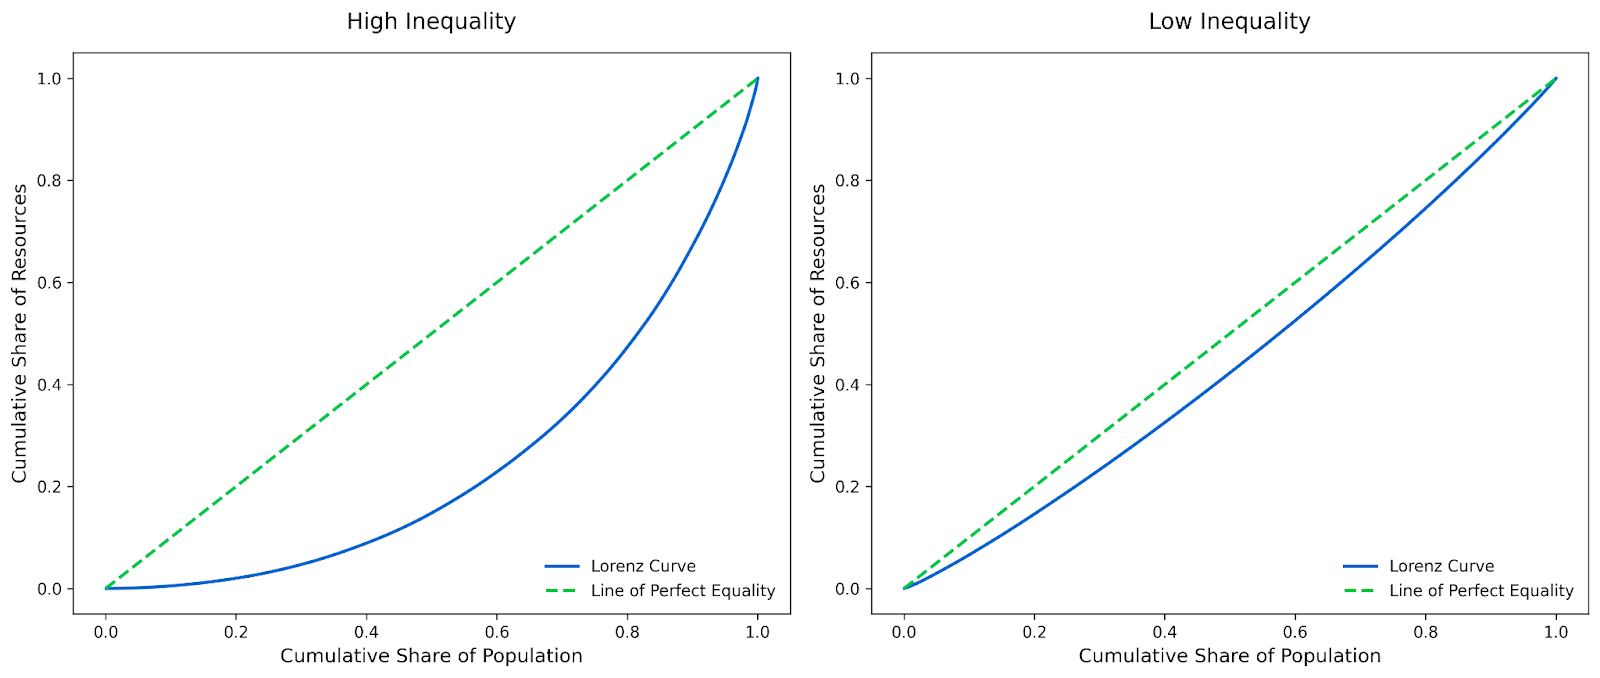
让我们用一个简单示例一起构建洛伦兹曲线。假设我们正在分析一个小型群体的收入分配。
第一步是将数据按升序整理。在这个例子中,假设我们有 5 位个体的收入值:$20、$30、$50、$80、$100。
我们将这些值从小到大排序。这样可以确保后续计算的累计百分比有意义。以下是排序后的表格:
| 个体 | 收入 ($) |
|---|---|
| 1 | 120 |
| 2 | 230 |
| 3 | 350 |
| 4 | 480 |
| 5 | 5100 |
接下来,我们计算群体(x 轴)与收入(y 轴)的累计百分比。
以下是加入累计百分比后的更新表格:
| 个体 | 收入 ($) | 累计人口 (%) | 累计收入 (%) |
|---|---|---|---|
| 120 | 20 | 20% | 7.14% |
| 230 | 30 | 40% | 17.86% |
| 350 | 50 | 60% | 35.71% |
| 480 | 80 | 80% | 64.29% |
| 5100 | 100 | 100% | 100% |
现在我们已有累计百分比,可以将其绘制到图表上。
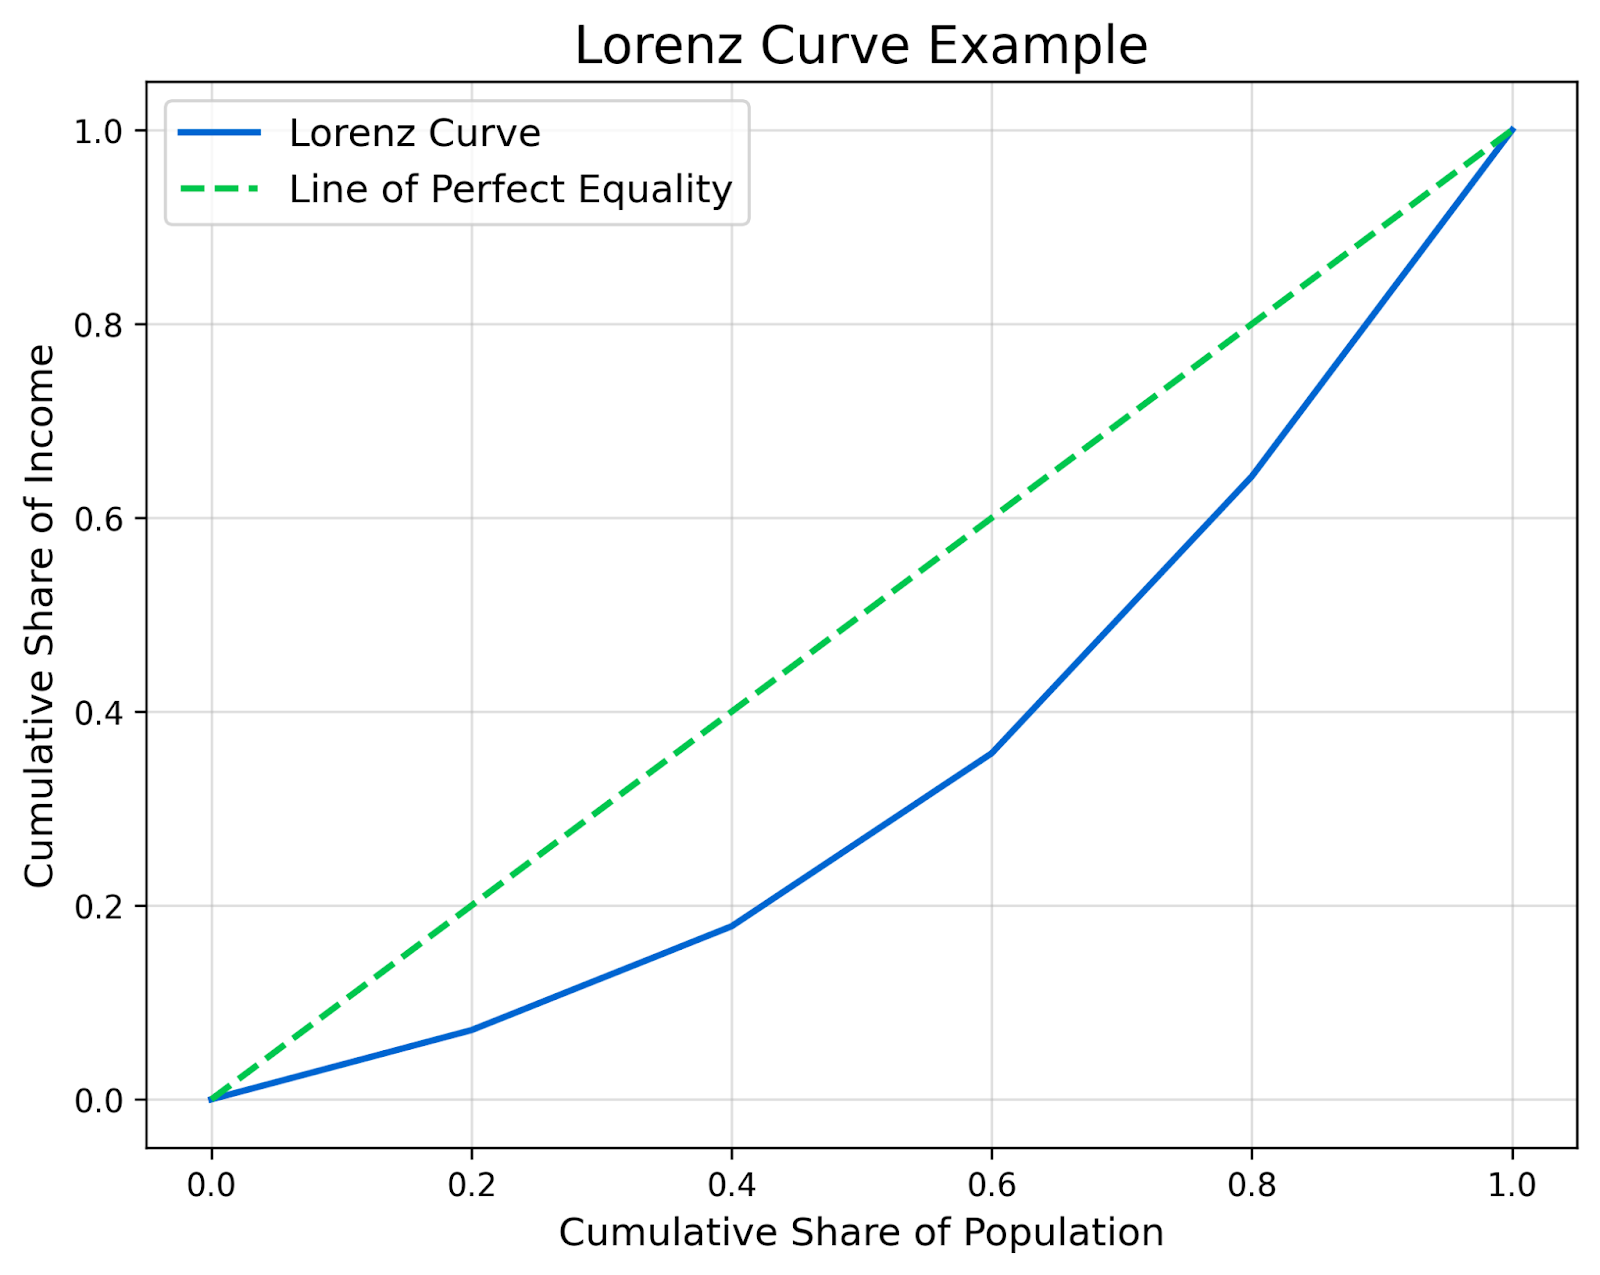
x 轴代表群体的累计占比,y 轴代表收入的累计占比。表格中的每一行对应图上的一个点。将这些点连线形成洛伦兹曲线,然后添加完全平等线。
最终得到的洛伦兹曲线展示了该群体的实际收入分配。曲线越远离对角线,不平等越严重。正如本例所示,曲线明显下凹,因为底部 20% 的人口仅拥有 7.14% 的收入。
要构建准确的洛伦兹曲线,您需要满足若干关键标准的高质量数据。数据的质量与结构将直接影响结果的准确性与可靠性。
首先,样本量至关重要。小数据集可能导致误导性结果,因为它们无法反映群体不平等的完整范围。我们这里的例子仅使用了 5 个个体,样本量远远不足。该曲线本应用于整个人群。更大的数据集能更可靠、更具代表性地反映不平等,从而让您的洛伦兹曲线更准确。
粒度也很重要,因为数据越细致,洛伦兹曲线就越精确。比如,以个体或家庭为单位的收入能比以县域总收入更好地揭示群体不平等。后者这种汇总数据可能隐藏大量不公平。
与大多数分析一样,不完整数据是常见问题,会显著扭曲洛伦兹曲线。缺失值会在累计百分比中造成空白,进而导致结果不准确。在构建曲线之前,请确保数据集尽可能完整,并仔细考虑如何处理缺失数据。如果您不确定该如何处理缺失数据,请查看我们非常有帮助的用 Python 处理缺失数据课程。
既然我们已经掌握了基础,接下来看看如何将洛伦兹曲线作为一种讲故事的工具,应用到收入数据之外的场景。
在这个例子中,我们将分析犯罪数据,了解城市中不同社区的报案分布不均。这将展示洛伦兹曲线如何应用于公共政策等领域。
我们将使用芝加哥警察局犯罪数据库的真实世界数据集,线上可免费获取。您可以从芝加哥数据门户下载。该数据集包含芝加哥犯罪报案的详细信息,包括犯罪类型、地点与日期。
下面我们将逐步完成数据清洗、计算洛伦兹曲线,并用 Python 进行可视化。如果您是 Python 新手,我推荐我们的Python 入门课程,快速上手这门语言。
首先,让我们安装本示例所需的所有库:
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt下面的代码会从芝加哥数据门户下载 CSV 格式的数据集,并使用 pandas 加载到 Python 中。
# Load the dataset
url = "<https://data.cityofchicago.org/resource/ijzp-q8t2.csv?$limit=100000>"  # Limit to 100,000 rows for simplicity
data = pd.read_csv(url)该数据集包含社区区域(或街区)的列。我们将按此列分组,计算每个社区的报案总数。
# Group by community area and count the number of crimes
crime_counts = data.groupby("community_area").size().reset_index(name="crime_count")

# Drop rows with missing community area values
crime_counts = crime_counts.dropna()

# Sort by crime count
crime_counts = crime_counts.sort_values(by="crime_count").reset_index(drop=True)

# Display the aggregated data
print(crime_counts.head())
Output:
community_area crime_count
0 47.0 102
1 9.0 102
2 12.0 195
3 74.0 212
4 37.0 246要构建洛伦兹曲线,我们需要计算社区的累计百分比与犯罪的累计百分比。
# Calculate cumulative percentages
crime_counts["cumulative_crime"] = crime_counts["crime_count"].cumsum()
crime_counts["cumulative_crime_percentage"] = crime_counts["cumulative_crime"] / crime_counts["crime_count"].sum()
crime_counts["cumulative_population_percentage"] = (np.arange(1, len(crime_counts) + 1)) / len(crime_counts)

# Display the updated data
print(crime_counts.head())
Output:
community_area crime_count cumulative_crime cumulative_crime_percentage \\
0 47.0 102 102 0.00102
1 9.0 102 204 0.00204
2 12.0 195 399 0.00399
3 74.0 212 611 0.00611
4 37.0 246 857 0.00857
cumulative_population_percentage
0 0.012987
1 0.025974
2 0.038961
3 0.051948
4 0.064935 现在我们已有累计百分比,可以绘制洛伦兹曲线。x 轴表示社区的累计占比,y 轴表示犯罪的累计占比。为增添地域特色,我们将借鉴芝加哥熊队的配色来绘图。
# Example data for cumulative percentages
# x represents the cumulative share of neighborhoods
# y represents the cumulative share of crimes
x = np.linspace(0, 1, 100)  # Replace with actual data
y = x**2  # Replace with actual data

# Chicago Bears-inspired colors
blue = "#0065D1"  # Lighter blue for the Lorenz curve
orange = "#FF5A1F"  # Bright orange for the line of perfect equality

# Create the plot
plt.figure(figsize=(8, 6))

# Plot the Lorenz curve
# This curve shows the inequality in crime distribution across neighborhoods
plt.plot(x, y, label="Lorenz Curve", color=blue, linewidth=2)

# Plot the line of perfect equality
# This line represents a hypothetical scenario where crimes are evenly distributed
plt.plot([0, 1], [0, 1], label="Line of Perfect Equality", color=orange, linestyle="--", linewidth=2)

# Add a title to explain what the graph represents
plt.title("Lorenz Curve of Crime Distribution Across Chicago Neighborhoods", fontsize=16, color="black", pad=15)

# Label the x-axis to show what the horizontal axis represents
plt.xlabel("Cumulative Share of Neighborhoods", fontsize=12, color="black", labelpad=10)

# Label the y-axis to show what the vertical axis represents
plt.ylabel("Cumulative Share of Crimes", fontsize=12, color="black", labelpad=10)

# Add a legend to explain the two lines
plt.legend(fontsize=12, loc="lower right", frameon=False)

# Remove the grid for a cleaner look
plt.grid(False)

# Set the background color to white for a professional appearance
plt.gca().set_facecolor("white")

# Remove the top and right borders of the graph for a minimalist design
plt.gca().spines["top"].set_visible(False)
plt.gca().spines["right"].set_visible(False)

# Save the plot as a PNG file
# This saves the graph as an image file for sharing or embedding in reports
plt.savefig("lorenz_curve_crime.png", dpi=300, bbox_inches="tight")

# Display the plot
plt.show()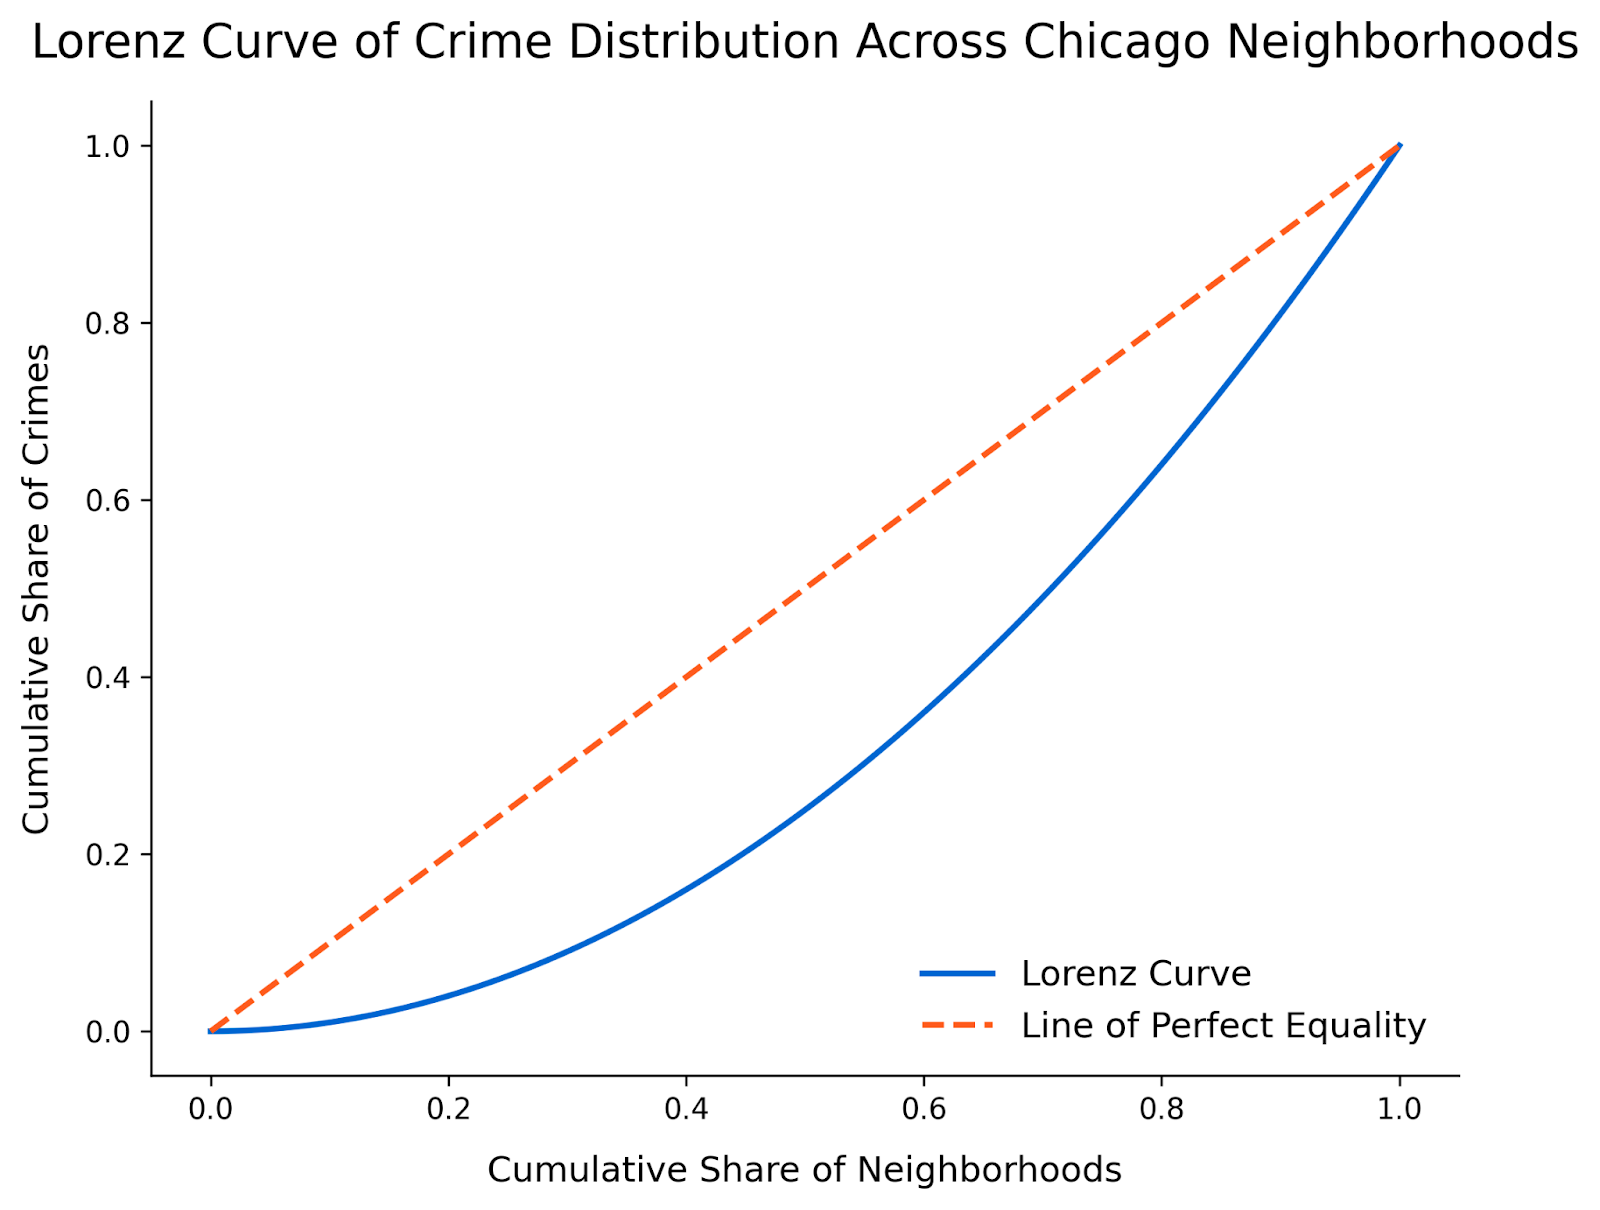
最后,我们需要解读该图。此洛伦兹曲线揭示了芝加哥各社区犯罪分布存在显著不平等。曲线明显远离完全平等线,表明少数社区占据了大多数报案。
看起来,前 50% 的社区贡献了不到 20% 的总犯罪,而其余社区承担了大部分犯罪负担。该可视化突出了其他类型图表未必显现的不平等模式。下一步可以识别高犯罪社区以启动干预措施,或识别低犯罪社区以了解哪些威慑措施有效。
该示例展示了如何将洛伦兹曲线应用于收入之外的领域,讲述关于不平等的有力故事。通过分析犯罪数据,我们可以揭示为公共政策与城市规划提供参考的不平等模式。尝试将此方法应用到其他数据集,如医疗可及性、教育成果或环境数据,以全新而有意义的方式探索不平等。
基尼系数直接由洛伦兹曲线推导而来。它测量洛伦兹曲线与完全平等线之间的面积。面积越大表示不平等越高,面积越小则表示更接近平等。基尼系数范围为 0 到 1,其中 0 表示完全平等(人人拥有相同资源),1 表示极端不平等(资源全部集中于一人)。
采用何种度量取决于您的目标。洛伦兹曲线展示不平等的形状,而基尼系数为其提供一个数字化摘要。如果您关注单一人群内部的不平等程度,洛伦兹曲线能提供更多细节。然而,如果您要在多个群体间进行比较,直接比较各自的洛伦兹曲线可能繁琐,此时基尼系数或许更合适。若想深入了解基尼系数,请参阅我的理解基尼系数教程。
此外,需要指出的是,洛伦兹曲线或许更为灵活,因为它可应用于多种数据类型,包括收入、犯罪、医疗可及性或生物多样性,并可用于跨时间或跨群体对分布进行比较。基尼系数同样可用于这些比较,但它更常被用于衡量收入不平等,这可能会让部分受众带有偏见。根据我的经验,相比单独给出一个数字,人们在解读图表时往往偏见更少。
| 特性 | 洛伦兹曲线 | 基尼系数 |
|---|---|---|
| 目的 | 展示资源在群体中的分配 | 将不平等汇总为单一数值 |
| 类型 | 可视化表示 | 数字化表示 |
| 解读 | 曲线形状指示不平等程度 | 取值范围从 0(完全平等)到 1(极端不平等) |
| 用例 | 比较分布、识别模式并传达发现 | 比较不同数据集或群体之间的不平等水平 |
| 灵活性 | 可应用于各种数据集(如收入、犯罪、生物多样性) | 主要用于收入或财富不平等 |
| 可操作性 | 帮助识别可进行针对性干预的具体不平等领域 | 为宏观比较提供高层摘要 |
上述比较突出了洛伦兹曲线与基尼系数如何相辅相成。洛伦兹曲线为单一群体提供更详尽、直观的视角,而基尼系数则提供简明的摘要,便于跨群体比较。
洛伦兹曲线是一种多用途工具,已广泛应用于诸多领域。让我们看看其中一些最具影响力的应用。
和任何方法一样,洛伦兹曲线有其优点与不足。
洛伦兹曲线往往需要相当细致的数据,才能产出有意义的结果。汇总或不完整的数据集有时会导致不准确的结论。比如,若收入数据排除了小费等非正式收入,可能会低估不平等。
同时,样本量也要足够大,以确保形成平滑曲线而非锯齿线,您可以在第一幅图中看到这种差异。依旧如常,务必确保数据尽可能完整。当然,您还应仔细校验数据并记录所有假设,以确保透明与可靠。
洛伦兹曲线也无法捕捉多维不平等。它聚焦于单一变量,如收入或财富,无法体现组合效应。不过,若您确实希望衡量多维不平等,还有其他工具可用,如多维贫困指数。
在我看来,洛伦兹曲线最大的优势是能以直观的可视化呈现不平等,让人一目了然。通过将曲线与完全平等线对比,群体内部的差距会立刻显现。它是一种视觉化的讲述工具,让技术与非技术受众都能读懂不平等数据。
其多样性也是另一大优势。洛伦兹曲线可广泛应用于经济、公共卫生、生态与机器学习等领域,这种灵活性使其具有普遍价值。
洛伦兹曲线是一种多用途的叙事工具,有助于展示与理解不平等。如果您对这类可视化感兴趣,或许也会喜欢阅读几何平均数:衡量增长与复利。或者,如果您想进一步学习金融,欢迎查看我们的Python 金融入门课程以及Python 应用金融技能路径。
在 DataCamp 学习 Excel
课程
课程
实践并学习路径你的进步。
使用 Google 继续