
{count, plural, one {Corso} other {Corsi}}
Analisi dei dati in Excel
{hours} ore
154.2K
La disuguaglianza è un tema che tocca quasi ogni aspetto della vita: reddito, ricchezza, salute, istruzione e persino il modo in cui le risorse sono distribuite negli ecosistemi. Ma come si misura davvero? Uno degli strumenti più efficaci che ho trovato per visualizzare la disuguaglianza è la curva di Lorenz.
Sebbene sia comunemente usata per misurare la disuguaglianza di reddito, la curva di Lorenz non è solo per gli economisti. Nel tempo è diventata uno strumento versatile, utilizzato per esaminare le disparità sanitarie, studiare la biodiversità e persino nel machine learning per valutare l’equità dei modelli predittivi. Per i data scientist è un ottimo modo per raccontare una storia sulla disuguaglianza presente in un dataset.
In questo tutorial ti mostrerò come funziona la curva di Lorenz. Vedremo come crearla con il tuo dataset, usando Python, e imparerai a utilizzarla nei tuoi progetti. Se ti interessa quantificare la disuguaglianza di reddito, analizzare la segmentazione dei clienti o investigare l’allocazione delle risorse, la curva di Lorenz può aiutarti a comunicare queste idee complesse con una visualizzazione semplice.
La curva di Lorenz fu introdotta nel 1905 dall’economista Max O. Lorenz. Funziona confrontando la distribuzione reale di una risorsa con una linea ipotetica di perfetta eguaglianza (una linea in cui tutti hanno la stessa quantità). Quanto più la curva si allontana dalla linea di perfetta eguaglianza, tanto maggiore è la disuguaglianza nella distribuzione di quella particolare risorsa.
La curva di Lorenz ha una struttura semplice. Sull’asse x si traccia la quota cumulativa della popolazione, iniziando dall’individuo più povero fino ad arrivare al più ricco. L’asse y mostra la quota cumulativa della risorsa misurata.
Poi bisogna aggiungere la linea di perfetta eguaglianza, una diagonale che va dall’angolo in basso a sinistra a quello in alto a destra. Questa linea rappresenta uno scenario in cui tutti hanno una quota uguale della risorsa che ci interessa.
La curva di Lorenz vera e propria mostra la distribuzione reale della risorsa. Quanto più la curva si incurva lontano dalla linea di perfetta eguaglianza, tanto maggiore è la disuguaglianza che rappresenta.
Se la curva di Lorenz è vicina alla diagonale di perfetta eguaglianza, significa che la risorsa è distribuita in modo abbastanza uniforme. Per esempio, in una società in cui il 50% più povero della popolazione ha circa il 50% del reddito, la curva di Lorenz sarà più vicina alla diagonale. Questa curva poco profonda indica bassa disuguaglianza.
Al contrario, se la curva si allontana molto dalla diagonale, indica alta disuguaglianza. Ciò può accadere, ad esempio, se il 50% più povero della popolazione possiede solo il 10% del reddito mentre il 10% più ricco ha tutto il resto.
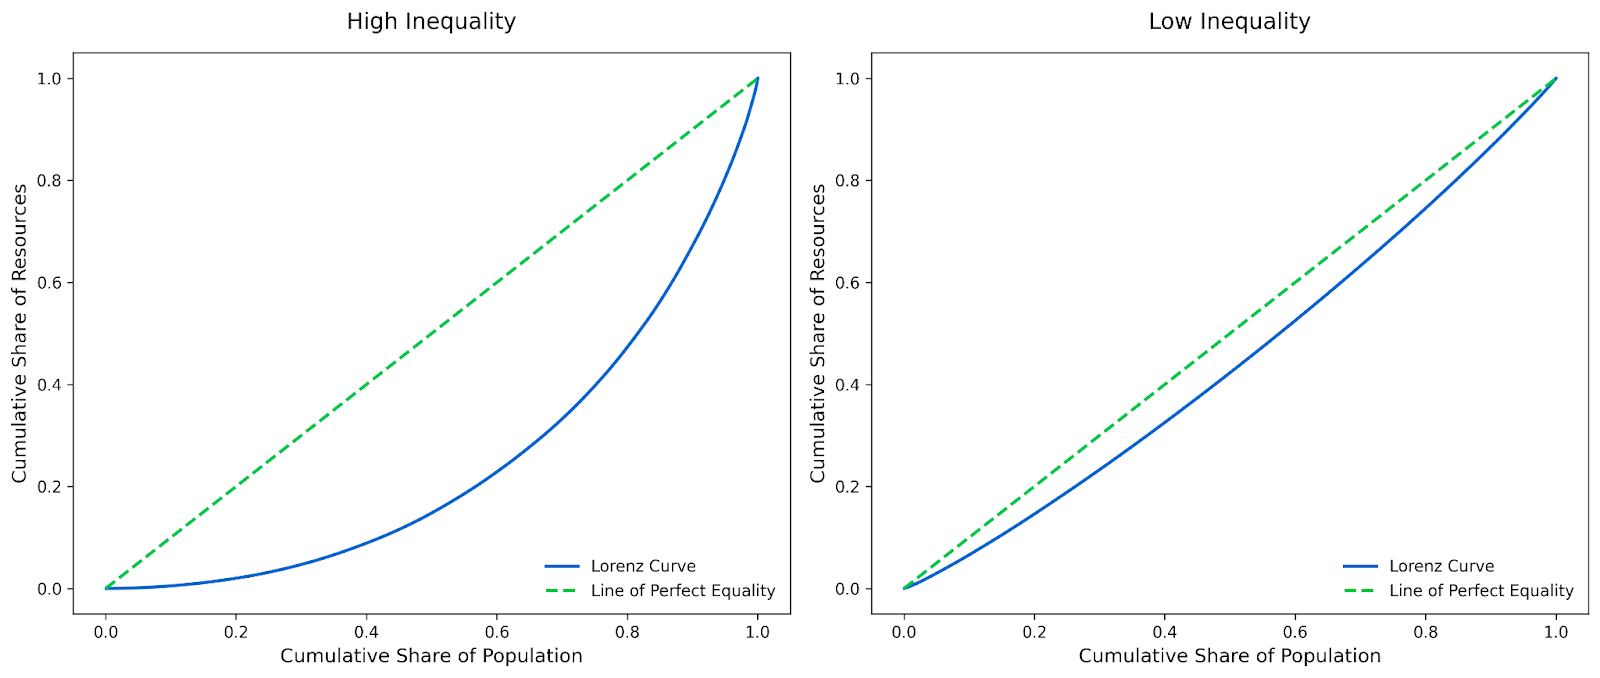
Vediamo insieme come costruire una curva di Lorenz con un esempio semplice. Immagina di analizzare la distribuzione del reddito in una piccola popolazione.
Il primo passo è organizzare i dati in ordine crescente. Per questo esempio, supponiamo di avere i seguenti valori di reddito per cinque individui in una popolazione: $20, $30, $50, $80, $100.
Ordineremo questi valori dal più piccolo al più grande. Questo garantisce che le percentuali cumulative che calcoleremo dopo abbiano senso. Ecco la tabella ordinata:
| Individuo | Reddito ($) |
|---|---|
| 1 | 120 |
| 2 | 230 |
| 3 | 350 |
| 4 | 480 |
| 5 | 5100 |
Successivamente, calcoliamo le percentuali cumulative sia per la popolazione (asse x) sia per il reddito (asse y).
Ecco la tabella aggiornata con le percentuali cumulative:
| Individuo | Reddito ($) | Popolazione cumulativa (%) | Reddito cumulativo (%) |
|---|---|---|---|
| 120 | 20 | 20% | 7,14% |
| 230 | 30 | 40% | 17,86% |
| 350 | 50 | 60% | 35,71% |
| 480 | 80 | 80% | 64,29% |
| 5100 | 100 | 100% | 100% |
Ora che abbiamo le percentuali cumulative, possiamo tracciarle su un grafico.
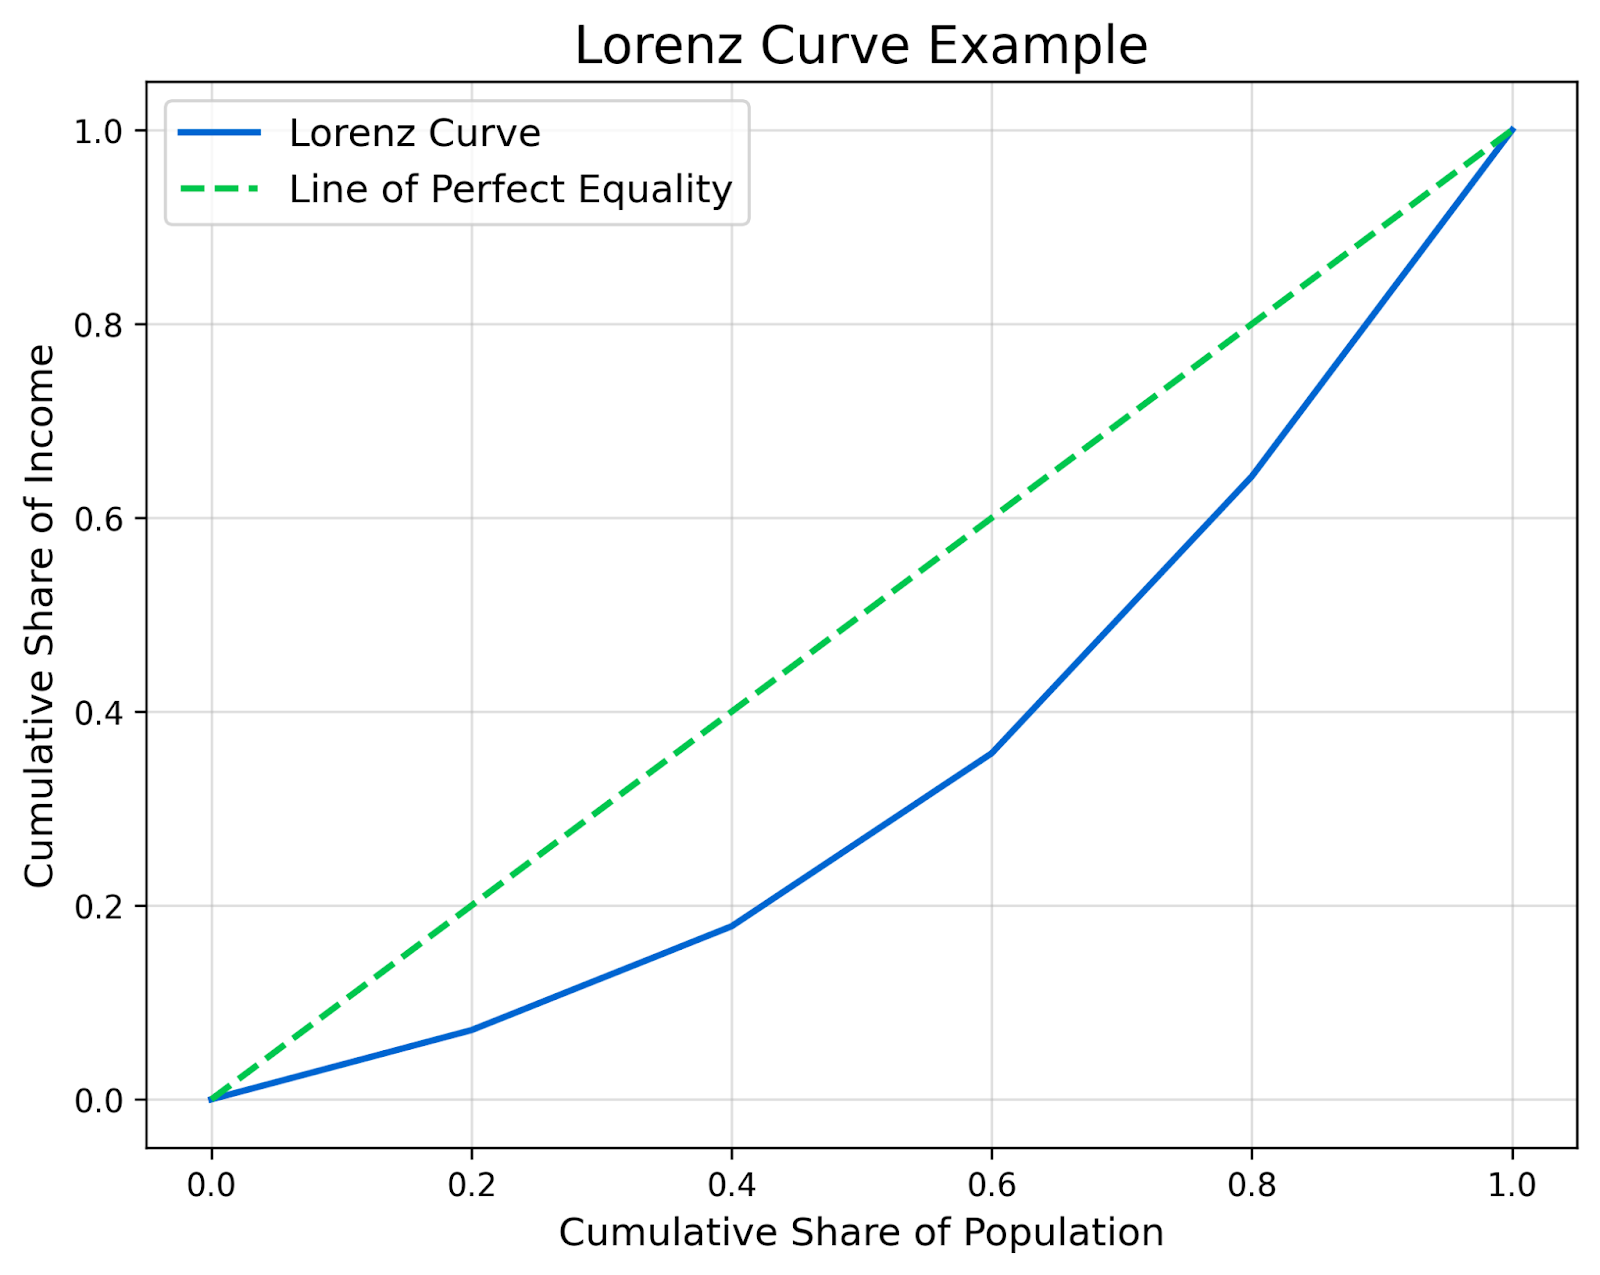
L’asse x rappresenta la quota cumulativa della popolazione e l’asse y rappresenta la quota cumulativa del reddito. Ogni riga della tabella corrisponde a un punto sul grafico. Una volta posizionati i punti, collegali per formare la curva di Lorenz. Poi aggiungi la linea di perfetta eguaglianza.
La curva di Lorenz risultante mostra la distribuzione reale del reddito in questa popolazione. Quanto più la curva si discosta dalla diagonale, tanto maggiore è la disuguaglianza. Come puoi vedere in questo esempio, la curva si incurva sensibilmente perché il 20% inferiore della popolazione detiene solo il 7,14% del reddito.
Per costruire una curva di Lorenz accurata, ti serviranno dati di alta qualità che soddisfino alcuni criteri chiave. La qualità e la struttura dei tuoi dati influiscono direttamente su accuratezza e affidabilità dei risultati.
Innanzitutto, la dimensione del campione è fondamentale. Dataset piccoli possono portare a risultati fuorvianti, perché potrebbero non catturare l’intero spettro della disuguaglianza in una popolazione. Il nostro esempio qui utilizza un dataset troppo piccolo di sole 5 persone. Questa curva è pensata per intere popolazioni. Dataset più grandi offrono un quadro più affidabile e rappresentativo della disuguaglianza, rendendo la tua curva di Lorenz più accurata.
Anche la granularità è importante, perché più i tuoi dati sono dettagliati, più precisa sarà la curva di Lorenz. Per esempio, il reddito di individui o famiglie ti darà un’idea migliore della disuguaglianza in una popolazione rispetto al reddito di intere contee. Quest’ultimo tipo di dataset può nascondere molte iniquità.
Come nella maggior parte delle analisi, i dati incompleti sono un problema comune che può distorcere sensibilmente la curva di Lorenz. I valori mancanti creano lacune nelle percentuali cumulative, portando a risultati inaccurati. Prima di costruire la tua curva, assicurati che il dataset sia il più completo possibile e valuta con attenzione come gestire i dati mancanti. Se non sei sicuro di come gestirli, dai un’occhiata al nostro utilissimo corso Dealing with Missing Data in Python.
Ora che abbiamo visto le basi, esploriamo come la curva di Lorenz possa essere usata come strumento di storytelling oltre i soli dati sul reddito.
In questo esempio analizzeremo i dati sui crimini per capire la disuguaglianza nella distribuzione dei reati denunciati tra i quartieri di una città. Questo mostrerà come la curva di Lorenz possa essere applicata a campi come le politiche pubbliche.
Useremo un dataset reale dal database dei crimini del Chicago Police Department, disponibile gratuitamente online. Puoi scaricare il dataset dal Chicago Data Portal. Questo dataset contiene informazioni dettagliate sui crimini denunciati a Chicago, inclusi tipo di reato, posizione e data.
Qui sotto vedremo i passaggi per pulire i dati, calcolare la curva di Lorenz e visualizzarla con Python. Se sei nuovo a Python, ti consiglio il nostro corso Introduction to Python per imparare rapidamente il linguaggio.
Per prima cosa, installiamo tutte le librerie necessarie per questo esempio:
import pandas as pd
import numpy as np
import matplotlib.pyplot as pltIl codice seguente scarica il dataset dal Chicago Data Portal come file CSV e lo carica in Python usando pandas.
# Load the dataset
url = "<https://data.cityofchicago.org/resource/ijzp-q8t2.csv?$limit=100000>"  # Limit to 100,000 rows for simplicity
data = pd.read_csv(url)Questo dataset contiene una colonna per le community areas, ovvero i quartieri. Raggrupperemo i dati per questa colonna per calcolare il numero totale di reati denunciati in ciascun quartiere.
# Group by community area and count the number of crimes
crime_counts = data.groupby("community_area").size().reset_index(name="crime_count")

# Drop rows with missing community area values
crime_counts = crime_counts.dropna()

# Sort by crime count
crime_counts = crime_counts.sort_values(by="crime_count").reset_index(drop=True)

# Display the aggregated data
print(crime_counts.head())
Output:
community_area crime_count
0 47.0 102
1 9.0 102
2 12.0 195
3 74.0 212
4 37.0 246Per costruire la curva di Lorenz, dobbiamo calcolare la percentuale cumulativa dei quartieri e la percentuale cumulativa dei reati.
# Calculate cumulative percentages
crime_counts["cumulative_crime"] = crime_counts["crime_count"].cumsum()
crime_counts["cumulative_crime_percentage"] = crime_counts["cumulative_crime"] / crime_counts["crime_count"].sum()
crime_counts["cumulative_population_percentage"] = (np.arange(1, len(crime_counts) + 1)) / len(crime_counts)

# Display the updated data
print(crime_counts.head())
Output:
community_area crime_count cumulative_crime cumulative_crime_percentage \\
0 47.0 102 102 0.00102
1 9.0 102 204 0.00204
2 12.0 195 399 0.00399
3 74.0 212 611 0.00611
4 37.0 246 857 0.00857
cumulative_population_percentage
0 0.012987
1 0.025974
2 0.038961
3 0.051948
4 0.064935 Ora che abbiamo le percentuali cumulative, possiamo tracciare la curva di Lorenz. L’asse x rappresenta la quota cumulativa dei quartieri, e l’asse y rappresenta la quota cumulativa dei reati. Per un tocco locale, useremo come ispirazione per il grafico i colori dei Chicago Bears.
# Example data for cumulative percentages
# x represents the cumulative share of neighborhoods
# y represents the cumulative share of crimes
x = np.linspace(0, 1, 100)  # Replace with actual data
y = x**2  # Replace with actual data

# Chicago Bears-inspired colors
blue = "#0065D1"  # Lighter blue for the Lorenz curve
orange = "#FF5A1F"  # Bright orange for the line of perfect equality

# Create the plot
plt.figure(figsize=(8, 6))

# Plot the Lorenz curve
# This curve shows the inequality in crime distribution across neighborhoods
plt.plot(x, y, label="Lorenz Curve", color=blue, linewidth=2)

# Plot the line of perfect equality
# This line represents a hypothetical scenario where crimes are evenly distributed
plt.plot([0, 1], [0, 1], label="Line of Perfect Equality", color=orange, linestyle="--", linewidth=2)

# Add a title to explain what the graph represents
plt.title("Lorenz Curve of Crime Distribution Across Chicago Neighborhoods", fontsize=16, color="black", pad=15)

# Label the x-axis to show what the horizontal axis represents
plt.xlabel("Cumulative Share of Neighborhoods", fontsize=12, color="black", labelpad=10)

# Label the y-axis to show what the vertical axis represents
plt.ylabel("Cumulative Share of Crimes", fontsize=12, color="black", labelpad=10)

# Add a legend to explain the two lines
plt.legend(fontsize=12, loc="lower right", frameon=False)

# Remove the grid for a cleaner look
plt.grid(False)

# Set the background color to white for a professional appearance
plt.gca().set_facecolor("white")

# Remove the top and right borders of the graph for a minimalist design
plt.gca().spines["top"].set_visible(False)
plt.gca().spines["right"].set_visible(False)

# Save the plot as a PNG file
# This saves the graph as an image file for sharing or embedding in reports
plt.savefig("lorenz_curve_crime.png", dpi=300, bbox_inches="tight")

# Display the plot
plt.show()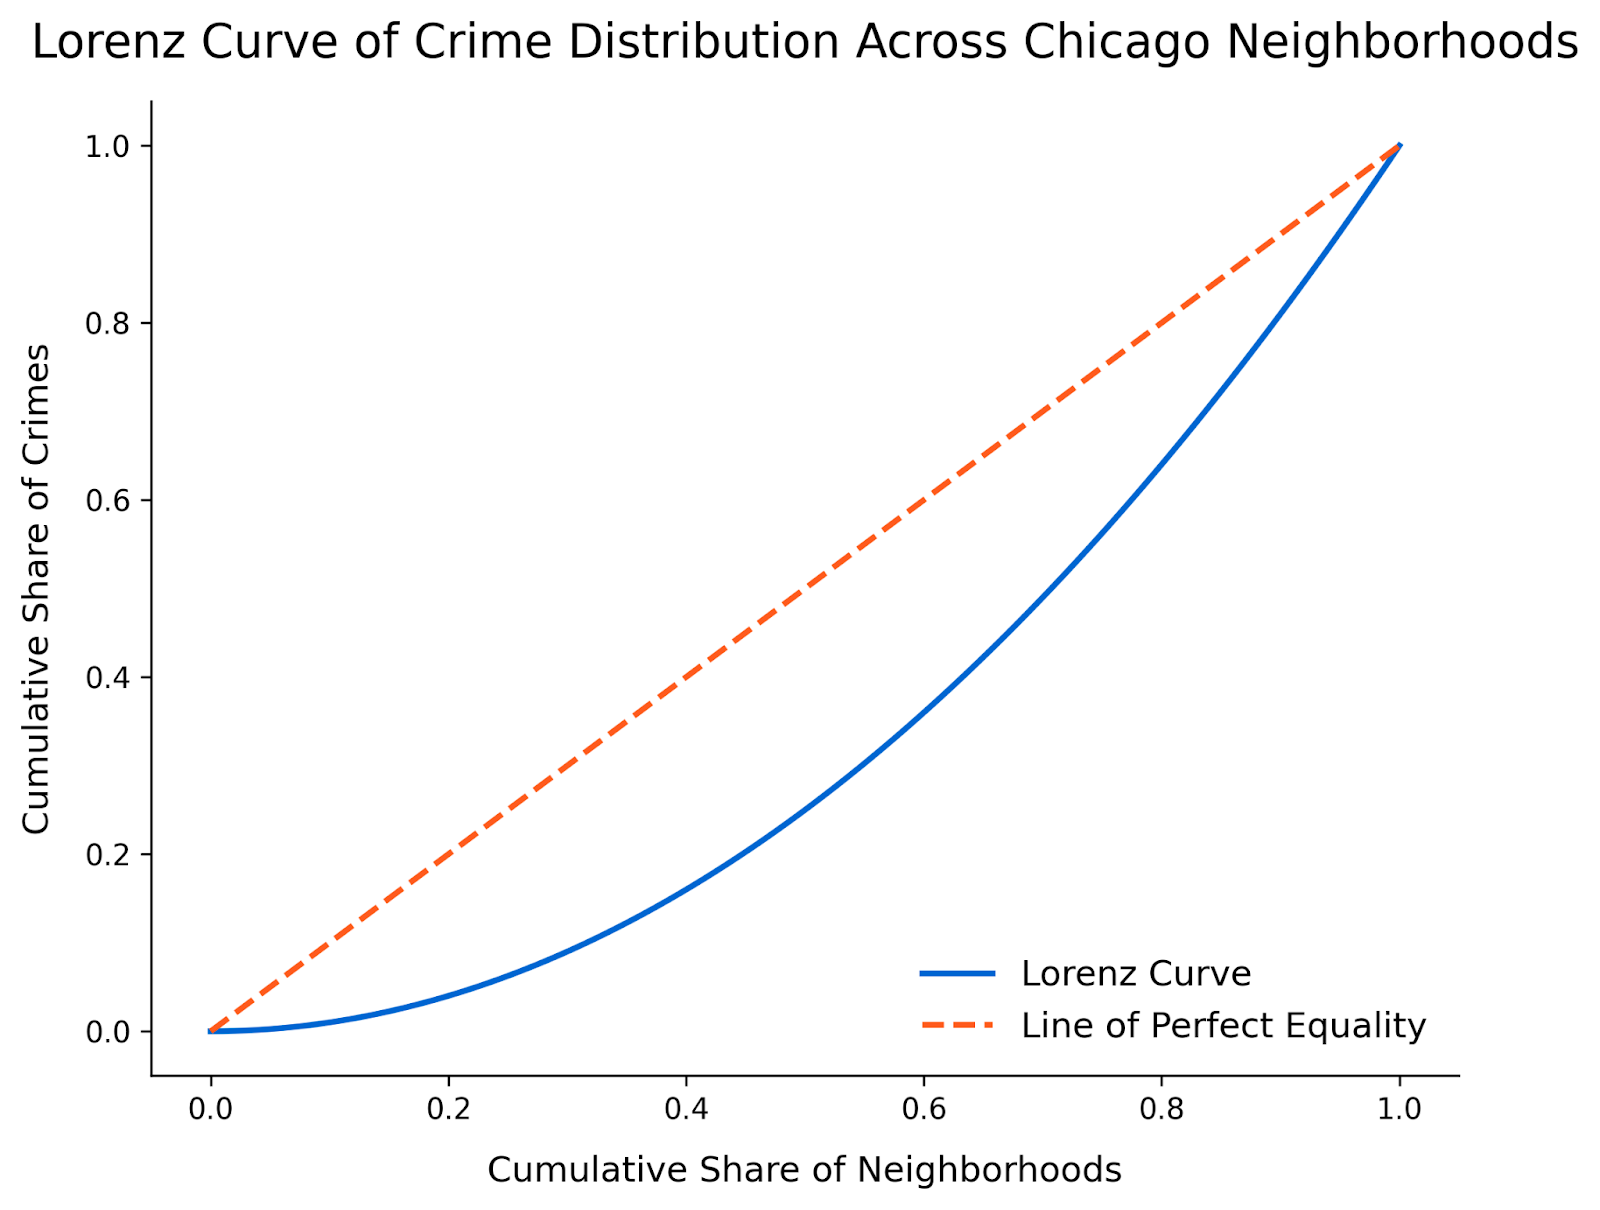
Infine, dobbiamo interpretare il grafico. Questa curva di Lorenz rivela una marcata disuguaglianza nella distribuzione dei reati tra i quartieri di Chicago. La curva si allontana in modo significativo dalla linea di perfetta eguaglianza, mostrando che una piccola frazione di quartieri concentra la maggior parte dei reati denunciati.
Sembra che il primo 50% dei quartieri contribuisca a meno del 20% dei reati totali, mentre i restanti quartieri sopportano la maggior parte del carico criminale. Questa visualizzazione evidenzia schemi di disuguaglianza che potrebbero non essere così evidenti in altri tipi di grafici. Il passo successivo può essere identificare i quartieri con criminalità più alta per avviare misure di mitigazione, o individuare quelli con meno reati per capire quali deterrenti stanno funzionando.
Questo esempio dimostra come la curva di Lorenz possa essere applicata oltre i dati sul reddito per raccontare storie efficaci sulla disuguaglianza in altri ambiti. Analizzando i dati sui crimini, possiamo scoprire pattern di disuguaglianza che informano le decisioni di policy pubblica e di pianificazione urbana. Prova ad applicare questo metodo ad altri dataset, come l’accesso all’assistenza sanitaria, gli esiti educativi o i dati ambientali per esplorare la disuguaglianza in modi nuovi e significativi.
Il coefficiente di Gini è derivato direttamente dalla curva di Lorenz. Misura l’area tra la curva di Lorenz e la linea di perfetta eguaglianza. Un’area maggiore indica maggiore disuguaglianza, mentre un’area più piccola suggerisce più eguaglianza. Il coefficiente di Gini varia tra 0 e 1, dove 0 rappresenta la perfetta eguaglianza (tutti hanno risorse uguali) e 1 rappresenta la disuguaglianza estrema (un singolo individuo detiene tutte le risorse).
La misura da usare dipende dai tuoi obiettivi. La curva di Lorenz mostra la forma della disuguaglianza, mentre il coefficiente di Gini ne fornisce un riassunto numerico. Se stai guardando la quantità di disuguaglianza all’interno di una sola popolazione, la curva di Lorenz offrirà più dettagli. Tuttavia, se stai confrontando molte popolazioni tra loro, mettere a confronto le curve di Lorenz di ciascuna può essere scomodo, quindi il coefficiente di Gini può essere più adatto. Per approfondire il coefficiente di Gini, dai un’occhiata al mio tutorial Understanding the Gini Coefficient.
Va anche detto che la curva di Lorenz è forse più flessibile, perché può essere applicata a vari tipi di dati, inclusi reddito, criminalità, accesso alle cure o biodiversità, ed è usata per confrontare distribuzioni nel tempo o tra gruppi. Anche il coefficiente di Gini può essere usato per questi confronti, ma è noto soprattutto per misurare la disuguaglianza di reddito. Questo può creare un bias per alcuni lettori. Per esperienza, le persone tendono ad avere meno pregiudizi quando interpretano grafici rispetto a quando ricevono un numero.
| Caratteristica | Curva di Lorenz | Coefficiente di Gini |
|---|---|---|
| Scopo | Mostra la distribuzione delle risorse in una popolazione | Riassume la disuguaglianza in un singolo valore |
| Tipo | Rappresentazione visiva | Rappresentazione numerica |
| Interpretazione | La forma della curva indica il grado di disuguaglianza | Valore compreso tra 0 (perfetta eguaglianza) e 1 (disuguaglianza estrema) |
| Casi d’uso | Confrontare distribuzioni, identificare pattern e comunicare i risultati | Confrontare i livelli di disuguaglianza tra dataset o popolazioni |
| Flessibilità | Può essere applicata a vari dataset (ad es. reddito, criminalità, biodiversità) | Usata principalmente per la disuguaglianza di reddito o ricchezza |
| Azionabilità | Aiuta a identificare aree specifiche di disuguaglianza per interventi mirati | Fornisce un riassunto di alto livello per confronti generali |
Il confronto sopra mette in evidenza come la curva di Lorenz e il coefficiente di Gini si completino a vicenda. La curva di Lorenz offre una prospettiva più dettagliata e visiva per una popolazione, mentre il coefficiente di Gini fornisce un riassunto conciso che può essere usato per confrontare diverse popolazioni.
La curva di Lorenz è uno strumento versatile che è stato applicato in un’ampia gamma di campi. Vediamo alcune delle sue applicazioni più rilevanti.
Come ogni metodo, la curva di Lorenz ha punti di forza e di debolezza.
La curva di Lorenz richiede spesso dati piuttosto granulari per produrre risultati significativi. Dataset aggregati o incompleti possono talvolta portare a conclusioni inaccurate. Per esempio, dati sul reddito che escludono guadagni informali, come le mance, possono sottostimare la disuguaglianza.
È anche importante avere un campione sufficientemente ampio per ottenere una curva, anziché una linea frastagliata, come puoi vedere nella prima figura. Come sempre, è fondamentale assicurarsi che i dati siano il più completi possibile. E, naturalmente, dovresti validare con cura i dati e documentare ogni assunzione fatta per garantire trasparenza e affidabilità.
La curva di Lorenz non cattura nemmeno la disuguaglianza multidimensionale. Si concentra su una singola variabile, come reddito o ricchezza, e non tiene conto di effetti combinati. Tuttavia, se vuoi misurare la disuguaglianza multidimensionale, ci sono altri strumenti che puoi usare, come il Multidimensional Poverty Index.
Il vantaggio più grande della curva di Lorenz, secondo me, è che fornisce una rappresentazione visiva intuitiva della disuguaglianza, facile da capire a colpo d’occhio. Confrontando la curva con la linea di perfetta eguaglianza, le disparità all’interno di una popolazione diventano subito evidenti. È uno strumento di visual storytelling che rende i dati sulla disuguaglianza accessibili sia a pubblici tecnici che non tecnici.
La sua versatilità è l’altro grande vantaggio. La curva di Lorenz può essere applicata in vari campi, dall’economia e sanità pubblica all’ecologia e al machine learning. Questa flessibilità la rende ampiamente utile.
La curva di Lorenz è uno strumento di storytelling versatile, utile per mostrare e comprendere la disuguaglianza. Se questo tipo di visualizzazione ti interessa, potresti apprezzare la lettura di Geometric Mean: A Measure for Growth and Compounding. Oppure, se vuoi saperne di più sulla finanza, ti invito a dare un’occhiata al nostro corso Introduction to Python for Finance e al nostro skill track Applied Finance in Python.
Impara Excel con DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min



