

设置 Metaflow
Metaflow 建议用户在新项目中安装 Python 3,而非 Python 2.7。文档指出,“相比已弃用的 Python 2.7,Python 3 错误更少,且支持更好。”
接下来,创建一个虚拟环境来管理项目依赖。运行以下命令:
python -m venv venv
source venv/bin/activate这会创建并激活一个虚拟环境。激活后,您即可安装 Metaflow。
Metaflow 可作为 Python 包在 MacOS 与 Linux 上使用。 您可以从 Metaflow Github 仓库或 PyPi 安装最新版本,运行以下命令:
pip install metaflow遗憾的是,在撰写本文时,Metaflow 尚未为 Windows 用户提供原生支持。不过,Windows 10 用户可以通过 WSL(Windows Subsystem for Linux)安装 Metaflow,在 Windows 系统中运行 Linux 环境。请查看 文档获取在 Windows 10 上安装 Metaflow 的分步指南。
AWS 集成(可选)
Metaflow 可与 AWS 无缝集成,这使用户能够利用云基础设施扩展其工作流。要集成 AWS,您需要配置 AWS 凭证。
注意: 以下步骤假设您已拥有 AWS 账户并安装了 AWS CLI。更多详情请遵循 AWS 文档的说明。
- 首先,通过以下命令安装 AWS CLI:
pip install awscli- 运行以下命令配置 AWS:
aws configure随后系统会提示您输入 AWS Access Key ID 和 Secret Access Key——这是 AWS CLI 用于向 AWS 进行请求认证的凭证。您可能还会被提示输入区域与输出格式。
输入完这些信息后,就大功告成!Metaflow 将自动使用您的 AWS 凭证来运行工作流。
使用 Metaflow 构建您的第一个工作流
现在 Metaflow 已完成设置,是时候构建您的第一个工作流了。本节将带您了解如何创建一个 flow、运行它,以及理解 Metaflow 中任务与步骤的组织方式。
完成本节后,您将拥有一个可处理数据并执行简单操作的工作流。开始吧!
Metaflow flow 概览
Metaflow 采用数据流范式,它将程序表示为一个有向运算图。这种方法非常适合构建数据处理管道,尤其是在机器学习中。
在 Metaflow 中,这个运算图被称为flow。一个 flow 由一系列任务构成,并拆分为多个步骤。请注意,每个步骤都可视为图中的一个节点,步骤之间的转换则充当图的边。
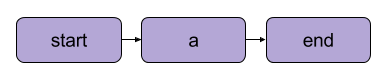
Metaflow 的基础线性转换 | 来源: Metaflow 文档
Metaflow 中 flow 有一些结构性规则。例如,每个 flow 必须包含start 步骤和end 步骤。一次 flow 的执行称为run,它从 start 步骤开始,若无错误地到达 end 步骤即视为成功。
至于 start 与 end 之间发生什么,完全由您决定——下一节将展示具体示例。
编写您的第一个 flow
这里有一个简单的 flow 供您上手。注意:可在 DataLab 中运行。
from metaflow import FlowSpec, step
class MyFirstFlow(FlowSpec):
@step
def start(self):
print("Starting the flow!")
self.data = [1, 2, 3, 4, 5] # Example dataset
self.next(self.process_data)
@step
def process_data(self):
self.processed_data = [x * 2 for x in self.data] # Simple data processing
print("Processed data:", self.processed_data)
self.next(self.end)
@step
def end(self):
print("Flow is complete!")
if __name__ == '__main__':
MyFirstFlow()在该 flow 中:
start()步骤初始化工作流并定义数据集。process_data()步骤将数据中每个元素加倍进行处理。end()步骤完成 flow。
每个步骤都使用 @step 装饰器,您可以通过 self.next() 来定义步骤之间的衔接顺序。
运行您的 flow
编写完成后,将其保存为 my_first_flow.py。在命令行中使用以下命令运行:
py -m my_first_flow.py runMetaflow 2.12 新增了一项功能,可在笔记本中开发与执行 flow。
要在指定单元格中执行 flow,您只需在同一单元格的最后一行添加一行 NBRunner 代码。例如:
from metaflow import FlowSpec, step, NBRunner
class MyFirstFlow(FlowSpec):
@step
def start(self):
print("Starting the flow!")
self.data = [1, 2, 3, 4, 5] # Example dataset
self.next(self.process_data)
@step
def process_data(self):
self.processed_data = [x * 2 for x in self.data] # Simple data processing
print("Processed data:", self.processed_data)
self.next(self.end)
@step
def end(self):
print("Flow is complete!")
run = NBRunner(MyFirstFlow).nbrun()如果您遇到以下错误:
“Metaflow could not determine your user name based on environment variables ($USERNAME etc.)”
请在执行 Metaflow 之前,将以下内容添加到您的代码中:
import os
if os.environ.get("USERNAME") is None:
os.environ["USERNAME"] = "googlecolab"无论哪种方式,Metaflow 都会按步执行 flow。也就是说,它会在终端逐步显示每个步骤的输出,如下所示:
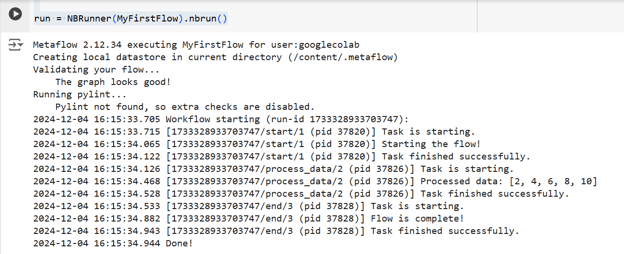
上述代码的输出 | 来源: 作者自制图片
Metaflow 的核心概念
理解 Metaflow 的核心概念对于构建高效、可扩展的数据工作流至关重要。本节将介绍三个基础概念:
- 步骤与分支
- 数据制品(artifacts)
- 版本控制
这些要素构成了 Metaflow 结构与执行工作流的骨架,使您能够轻松管理复杂流程。
步骤与分支
我们在前文已简要提到步骤,此处为清晰起见再次回顾。理解 Metaflow 工作流最重要的一点是:它围绕步骤构建。
步骤代表工作流中的每个独立任务。换言之,每个步骤执行特定操作(例如:数据加载、处理、建模等)。
我们在“编写您的第一个 flow”中构建的是线性流程。除了顺序步骤外,Metaflow 还允许用户对工作流进行分支。分支工作流可通过创建多条执行路径来并行运行多个任务。
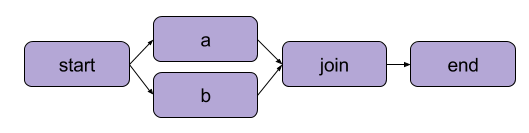
分支示例 | 来源:Metaflow 文档
分支的主要收益在于性能。分支意味着 Metaflow 可以在多核 CPU 或云端实例上并行执行不同步骤。
以下是代码层面的分支示例:
from metaflow import FlowSpec, step, NBRunner
class BranchFlow(FlowSpec):
@step
def start(self):
print("Starting the flow!")
self.data = [1, 2, 3, 4, 5] # Example dataset
self.next(self.split)
@step
def split(self):
self.next(self.branch1, self.branch2)
@step
def branch1(self):
# Code for branch 1
print("This is branch 1")
self.next(self.join)
@step
def branch2(self):
# Code for branch 2
print("This is branch 2")
self.next(self.join)
@step
def join(self, inputs):
# Merging branches back
print("Branches joined.")
self.next(self.end)
@step
def end(self):
print("Flow is complete!")
run = NBRunner(BranchFlow).nbrun()|
💡要点:分支让用户可以设计复杂工作流,同时并行处理多个任务。 |
数据制品(artifacts)
数据制品(artifacts)是允许您在工作流步骤之间存储与传递数据的变量。制品会将某一步骤的输出持久化到下一步——这就是后续步骤获取数据的方式。
本质上,当您在 Metaflow 类的某个步骤中将数据赋值给 self 时,您就是将其保存为一个制品,之后 flow 中的任意其他步骤都可以访问它(见代码注释)。
class ArtifactFlow(FlowSpec):
@step
def start(self):
# Step 1: Initializing data
print("Starting the flow!")
self.data = [1, 2, 3, 4, 5] # Example dataset saved as an artifact
self.next(self.process_data)
@step
def process_data(self):
# Step 2: Processing the data from the 'start' step
self.processed_data = [x * 2 for x in self.data] # Processing artifact data
print("Processed data:", self.processed_data)
self.next(self.save_results)
@step
def save_results(self):
# Step 3: Saving the processed data artifact
self.results = sum(self.processed_data) # Saving final result as an artifact
print("Sum of processed data:", self.results)
self.next(self.end)
@step
def end(self):
# Final step
print("Flow is complete!")
print(f"Final result: {self.results}") # Accessing artifact in final step为何制品是 Metaflow 的核心概念?因为它们有多种用途:
- 自动管理数据流,无需手动加载与存储数据。
- 支持持久化(下节详述),意味着可使用 Client API 进行后续分析、用 Cards 可视化,并在不同 flow 之间复用。
- 在本地与云环境间保持一致性,免去显式数据传输。
- 允许在故障前检查数据,并在修复错误后恢复执行。
版本控制与持久化
Metaflow 会自动处理工作流的版本控制。也就是说,每次执行 flow 都会被追踪为一次独立的 run。每个 run 都有自己的版本,便于您审查和复现实验。
Metaflow 通过为每次 run 分配唯一标识符,并保留该次执行的数据与制品来实现这一点。这种持久化确保 run 之间不会丢失数据。您可以轻松回溯并检查历史工作流,必要时重新运行特定步骤。结果是,调试与迭代开发更加高效,同时可重复性维护也更为简化。
实践示例:训练机器学习模型
在本节中,我将带您使用 Metaflow 训练一个机器学习模型。您将学习如何:
- 定义一个加载数据的工作流
- 训练机器学习模型
- 跟踪结果
完成后,您将更好地理解如何使用 Metaflow 高效构建与运行机器学习工作流。开始吧!
首先,我们将创建一个基础 flow 来加载数据集、执行训练并输出模型结果。
注意:代码可在 DataLab 中运行。
from metaflow import FlowSpec, step, Parameter, NBRunner
class TrainModelFlow(FlowSpec):
@step
def start(self):
# Load and split the dataset
print("Loading data...")
self.data = [1, 2, 3, 4, 5] # Replace with actual data loading logic
self.labels = [0, 1, 0, 1, 0] # Replace with labels
self.next(self.train_model)
@step
def train_model(self):
# Training a simple model (e.g., linear regression)
print("Training the model...")
self.model = sum(self.data) / len(self.data) # Replace with actual model training
print(f"Model output: {self.model}")
self.next(self.end)
@step
def end(self):
# Final step
print("Training complete. Model ready for deployment!")f在这段代码中,我们定义了三个步骤:
start():加载并划分数据集。在真实场景中,您会从实际来源(如文件或数据库)加载数据。train_model():模拟训练模型。此处用简单的平均值计算代替实际的机器学习算法,您可将其替换为任意所需的训练代码。end():标记 flow 结束,并表示模型已准备好部署。
定义好 flow 后,您可以使用以下命令运行:
run = NBRunner(TrainModelFlow)
run.nbrun()请注意,该代码仅适用于笔记本环境(所有代码需在同一单元格中)。
若要以脚本方式运行此代码,请移除 NBRunner 命令,并在脚本末尾添加以下内容并保存(例如“metaflow_ml_model.py”):
if __name__ == "__main__":
TrainModelFlow()然后,在命令行中运行以下命令以执行脚本:
py -m metaflow_ml_model.py Metaflow 会自动跟踪每次 run,并可通过Metaflow UI 可视化结果。
使用 Metaflow 的最佳实践
那么,如何最大化利用 Metaflow 的特性?以下最佳实践可帮助您在优化工作流的同时实现这一目标:
从小型 flow 开始
如果您刚接触 Metaflow,请从简单的工作流入手,以熟悉其 API。小步起步有助于理解框架的工作方式,并在尝试更复杂项目之前建立信心。此方法能降低学习曲线,并确保打好坚实基础。
使用 Metaflow 的 UI 进行调试
Metaflow 包含一个强大的用户界面,对于调试与跟踪工作流非常有帮助。使用 UI 监控运行情况、检查各步骤输出,并定位可能出现的问题。可视化数据与日志能让您更容易在 flow 执行过程中发现并修复问题。
借助 AWS 实现可扩展性
初次安装 Metaflow 时,它在本地模式下运行。在该模式中,制品与元数据保存在本地目录,计算通过本地进程执行。此设置适合个人使用,但如果您的项目涉及协作或大规模数据,建议将 Metaflow 配置为使用 AWS 以获得更好的可扩展性。好消息是,Metaflow 与 AWS 的集成非常出色。
结语
在本教程中,我们从安装入手,带您逐步构建第一个数据科学工作流,并介绍了核心概念,例如定义步骤、使用数据制品在步骤间传递数据,以及通过版本控制追踪并复现实验。我们还通过一个训练机器学习模型的实践示例,演示了如何定义、运行并监控工作流。最后,我们分享了一些最佳实践,帮助您充分利用 Metaflow。
若想继续学习 MLOps,请查看以下资源:

Metaflow 是一个用于构建和管理数据工作流的强大框架。在本教程中,您将学习如何开始使用它。我们将重点介绍:
读完本文,您将具备高效简化并扩展工作流所需的技能!
什么是 Metaflow?
来源: Why Metaflow?
Metaflow 是一个旨在帮助管理数据科学项目的 Python 框架。该工具最初由 Netflix 开发,帮助数据科学家和机器学习工程师提升生产力。它通过简化复杂任务(如工作流编排)来实现这一目标,从而确保流程自始至终顺畅运行。
Metaflow 的关键功能包括自动数据版本控制,可追踪您工作流的变更,以及对可扩展工作流的支持,帮助用户处理更大的数据集与更复杂的任务。
Metaflow 的另一优势是易于与 AWS 集成。这意味着用户可以利用云端资源进行存储与计算。此外,其友好的 Python API 让新手与有经验的用户都能轻松上手。
让我们开始设置吧。