
Corso
Machine Learning end-to-end
4 ore
17K
Metaflow è un potente framework per creare e gestire workflow di dati. In questo tutorial imparerai come iniziare. In particolare, toccheremo:
Alla fine dell'articolo avrai le competenze necessarie per ottimizzare e scalare i tuoi workflow in modo efficiente!
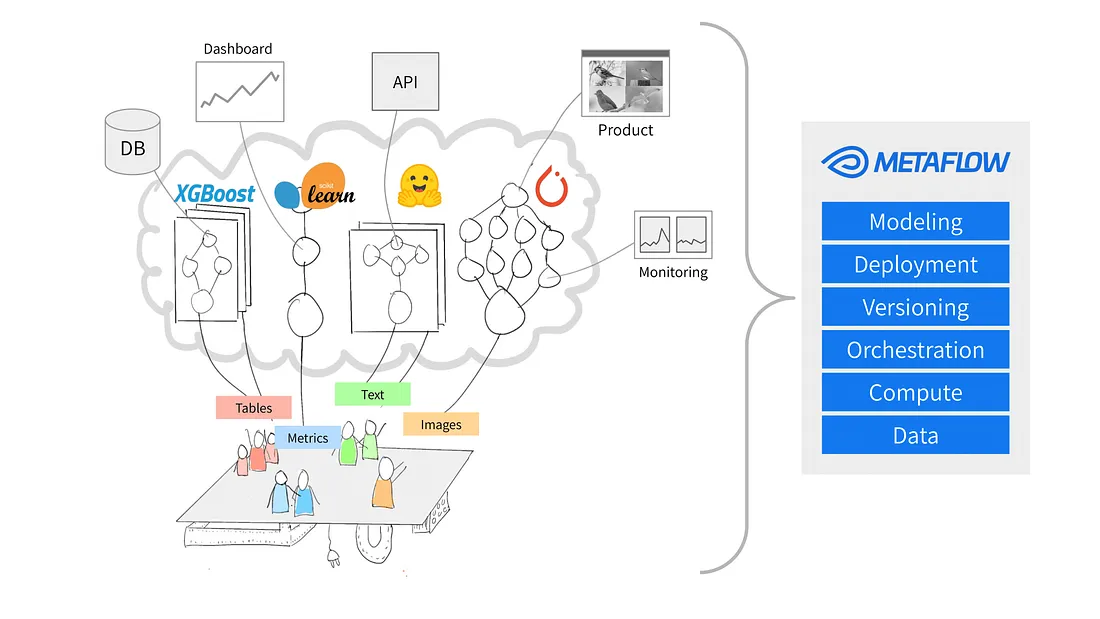
Fonte: Perché Metaflow?
Metaflow è un framework Python progettato per aiutare a gestire progetti di data science. Netflix ha inizialmente sviluppato lo strumento per aiutare data scientist e machine learning engineer a essere più produttivi. Raggiunge questo obiettivo semplificando attività complesse, come l'orchestrazione dei workflow, che garantisce che i processi si svolgano senza intoppi dall'inizio alla fine.
Le funzionalità chiave di Metaflow includono il versionamento automatico dei dati, che tiene traccia delle modifiche ai tuoi workflow, e il supporto per workflow scalabili, che consente di gestire dataset più grandi e attività più complesse.
Un altro vantaggio di Metaflow è l'integrazione semplice con AWS. Ciò significa che gli utenti possono sfruttare le risorse cloud per archiviazione e potenza di calcolo. Inoltre, la sua API Python intuitiva lo rende accessibile sia ai principianti sia agli utenti esperti.
Iniziamo a configurarlo.
Metaflow consiglia di installare Python 3 invece di Python 2.7 per i nuovi progetti. La documentazione afferma che “Python 3 ha meno bug ed è meglio supportato rispetto al deprecato Python 2.7”.
Il passo successivo è creare un ambiente virtuale per gestire le dipendenze del progetto. Esegui il seguente comando per farlo:
python -m venv venv
source venv/bin/activate
Questo creerà e attiverà un ambiente virtuale. Una volta attivato, sei pronto per installare Metaflow.
Metaflow è disponibile come pacchetto Python per MacOS e Linux. L'ultima versione può essere installata dal repository Github di Metaflow o da PyPi eseguendo il seguente comando:
pip install metaflowPurtroppo, al momento della stesura, Metaflow non offre supporto nativo per gli utenti Windows. Tuttavia, chi ha Windows 10 può utilizzare WSL (Windows Subsystem for Linux) per installare Metaflow, che consente di eseguire un ambiente Linux all'interno del sistema operativo Windows. Consulta la documentazione per una guida passo passo all'installazione di Metaflow su Windows 10.
Metaflow offre un'integrazione senza soluzione di continuità con AWS, che consente agli utenti di scalare i propri workflow utilizzando l'infrastruttura cloud. Per integrare AWS, dovrai configurare le tue credenziali AWS.
Nota: Questi passaggi presuppongono che tu abbia già un account AWS e AWS CLI installato. Per maggiori dettagli, segui le istruzioni della documentazione AWS.
pip install awscliaws configureDa qui, ti verrà chiesto di inserire il tuo AWS Access Key ID e Secret Access Key—sono semplicemente le credenziali che l'AWS CLI usa per autenticare le tue richieste ad AWS. Nota che potresti anche dover inserire la tua regione e il formato di output.
Una volta inseriti questi dettagli, voilà! Metaflow userà automaticamente le tue credenziali AWS per eseguire i workflow.
Ora che Metaflow è configurato, è il momento di creare il tuo primo workflow. In questa sezione ti guiderò attraverso le basi per creare un flow, eseguirlo e capire come sono organizzati task e step in Metaflow.
Alla fine di questa sezione avrai un workflow che elabora dati ed esegue operazioni semplici. Andiamo!
Metaflow usa il paradigma dataflow, che rappresenta un programma come un grafo orientato di operazioni. Questo approccio è ideale per costruire pipeline di elaborazione dei dati, specialmente nel machine learning.
In Metaflow, il grafo delle operazioni è chiamato flow. Un flow è costituito da una serie di task suddivisi in step. Nota che ogni step può essere considerato un'operazione rappresentata come un nodo, con le transizioni tra step che fungono da archi del grafo.
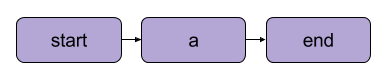
Una transizione lineare di base in Metaflow | Fonte: Documentazione Metaflow
Ci sono alcune regole strutturali per i flow in Metaflow. Ad esempio, ogni flow deve includere uno step di start e uno step di end. Quando un flow viene eseguito, chiamato run, inizia con lo step di start ed è considerato riuscito se raggiunge lo step di end senza errori.
Ciò che accade tra gli step di start ed end dipende interamente da te – come vedrai nel prossimo segmento.
Ecco un flow semplice per iniziare. Nota: il codice può essere eseguito in DataLab.
from metaflow import FlowSpec, step

class MyFirstFlow(FlowSpec):
    @step
    def start(self):
        print("Starting the flow!")
        self.data = [1, 2, 3, 4, 5]  # Example dataset
        self.next(self.process_data)
    @step
    def process_data(self):
        self.processed_data = [x * 2 for x in self.data]  # Simple data processing
        print("Processed data:", self.processed_data)
        self.next(self.end)
    @step
    def end(self):
        print("Flow is complete!")

if __name__ == '__main__':
    MyFirstFlow()
In questo flow:
start() inizializza il workflow e definisce un dataset.process_data() elabora i dati raddoppiando ogni elemento.end() completa il flow.Ogni step usa il decorator @step e definisci la sequenza del flow usando self.next() per collegare gli step.
Dopo aver scritto il flow, salvalo come my_first_flow.py. Eseguilo dalla riga di comando usando:
py -m my_first_flow.py runIn Metaflow 2.12 è stata aggiunta una nuova funzionalità che consente di sviluppare ed eseguire i flow nei notebook.
Per eseguire un flow in una cella definita, ti basta aggiungere la one-liner NBRunner sull'ultima riga della stessa cella. Ad esempio:
from metaflow import FlowSpec, step, NBRunner

class MyFirstFlow(FlowSpec):
    @step
    def start(self):
        print("Starting the flow!")
        self.data = [1, 2, 3, 4, 5]  # Example dataset
        self.next(self.process_data)
    @step
    def process_data(self):
        self.processed_data = [x * 2 for x in self.data]  # Simple data processing
        print("Processed data:", self.processed_data)
        self.next(self.end)
    @step
    def end(self):
        print("Flow is complete!")

run = NBRunner(MyFirstFlow).nbrun()
Se ottieni il seguente errore:
“Metaflow could not determine your user name based on environment variables ($USERNAME etc.)”
Aggiungi quanto segue al tuo codice prima dell'esecuzione di Metaflow:
import os
if os.environ.get("USERNAME") is None:
    os.environ["USERNAME"] = "googlecolab"
In entrambi i casi, Metaflow eseguirà il flow passo dopo passo. In particolare, mostrerà l'output di ogni step nel terminale come segue:
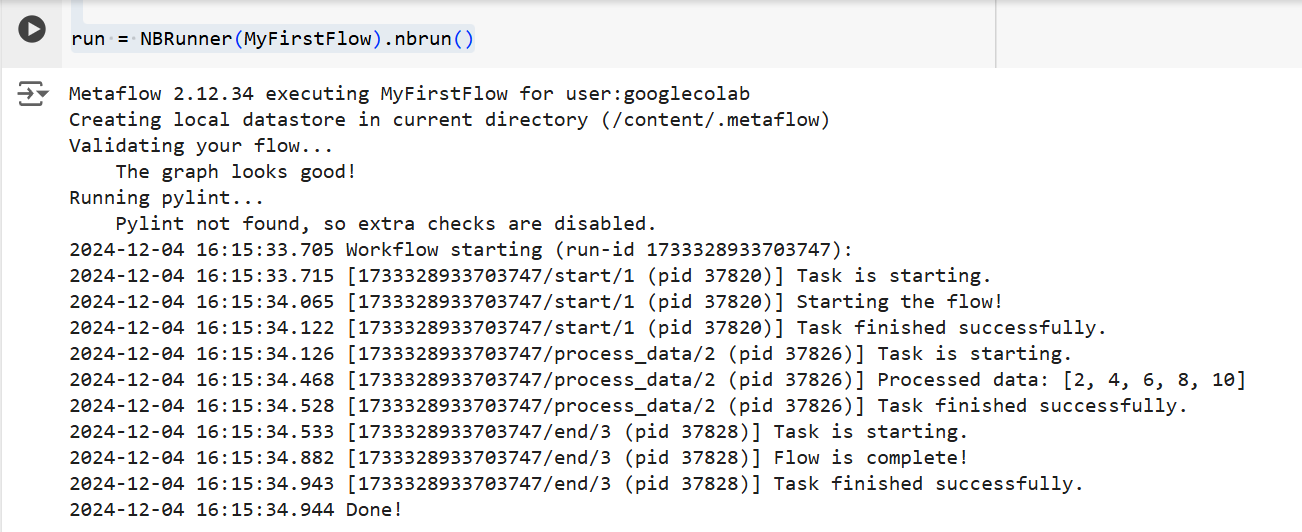
L'output del codice sopra | Fonte: Immagine dell'autore
Capire i concetti fondamentali di Metaflow è essenziale per creare workflow di dati efficienti e scalabili. In questa sezione tratterò tre concetti fondamentali:
Questi elementi costituiscono l'ossatura della struttura e dell'esecuzione dei workflow in Metaflow, permettendoti di gestire facilmente processi complessi.
Abbiamo accennato brevemente agli step in precedenza, ma per chiarezza li riprendiamo. La cosa più importante da capire dei workflow Metaflow è che sono costruiti attorno agli step.
Gli step rappresentano ciascun singolo task all'interno di un workflow. In altre parole, ogni step esegue un'operazione specifica (ad esempio, caricamento dati, elaborazione, modellazione, ecc.).
L'esempio creato sopra in “Scrivere il tuo primo flow” era una trasformazione lineare. Oltre agli step sequenziali, Metaflow consente anche di ramificare i workflow. I workflow ramificati ti permettono di eseguire più task in parallelo creando percorsi separati per l'esecuzione.
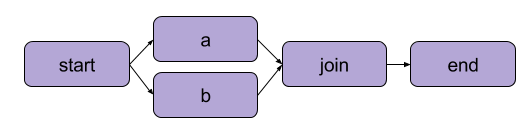
Un esempio di branching | Fonte: Documentazione Metaflow
Il principale vantaggio di una ramificazione è la performance. Il branching consente a Metaflow di eseguire vari step su più core CPU o istanze nel cloud.
Ecco come appare una ramificazione nel codice:
from metaflow import FlowSpec, step, NBRunner

class BranchFlow(FlowSpec):
    @step
    def start(self):
        print("Starting the flow!")
        self.data = [1, 2, 3, 4, 5]  # Example dataset
        self.next(self.split)
    @step
    def split(self):
        self.next(self.branch1, self.branch2)

    @step
    def branch1(self):
        # Code for branch 1
        print("This is branch 1")
        self.next(self.join)

    @step
    def branch2(self):
        # Code for branch 2
        print("This is branch 2")
        self.next(self.join)

    @step
    def join(self, inputs):
        # Merging branches back
        print("Branches joined.")
        self.next(self.end)

    @step
    def end(self):
        print("Flow is complete!")

run = NBRunner(BranchFlow).nbrun()|
💡TL;DR: Il branching consente di progettare workflow complessi che possono elaborare più task contemporaneamente. |
Gli artifact di dati sono variabili che ti permettono di archiviare e passare dati tra gli step di un workflow. Questi artifact persistono l'output di uno step a quello successivo—è così che i dati sono resi disponibili per gli step successivi.
In pratica, quando assegni dati a self all'interno di uno step in una classe Metaflow, li salvi come artifact, che possono poi essere accessibili da qualsiasi altro step nel flow (vedi i commenti nel codice).
class ArtifactFlow(FlowSpec):
    @step
    def start(self):
        # Step 1: Initializing data
        print("Starting the flow!")
        self.data = [1, 2, 3, 4, 5]  # Example dataset saved as an artifact
        self.next(self.process_data)
    @step
    def process_data(self):
        # Step 2: Processing the data from the 'start' step
        self.processed_data = [x * 2 for x in self.data]  # Processing artifact data
        print("Processed data:", self.processed_data)
        self.next(self.save_results)
    @step
    def save_results(self):
        # Step 3: Saving the processed data artifact
        self.results = sum(self.processed_data)  # Saving final result as an artifact
        print("Sum of processed data:", self.results)
        self.next(self.end)
    @step
    def end(self):
        # Final step
        print("Flow is complete!")
        print(f"Final result: {self.results}")  # Accessing artifact in final step
Perché gli artifact sono un concetto chiave di Metaflow? Perché hanno diversi utilizzi:
Metaflow gestisce automaticamente il versioning dei tuoi workflow. Ciò significa che ogni volta che un flow viene eseguito, viene tracciato come una run unica. In altre parole, ogni run ha la sua versione, permettendoti di rivedere e riprodurre facilmente le run passate.
Metaflow lo fa assegnando identificatori univoci a ciascuna run e preservando i dati e gli artifact di quell'esecuzione. Questa persistenza garantisce che nessun dato venga perso tra le run. I workflow passati possono essere facilmente rivisitati e ispezionati e specifici step possono essere rieseguiti se necessario. Di conseguenza, il debugging e lo sviluppo iterativo sono molto più efficienti e mantenere la riproducibilità è semplificato.
In questa sezione, ti guiderò nell'uso di Metaflow per addestrare un modello di machine learning. Imparerai a:
Alla fine, avrai una migliore comprensione di come usare Metaflow per strutturare ed eseguire workflow di machine learning in modo efficiente. Andiamo!
Per cominciare, creeremo un flow di base che carica un dataset, esegue il training e produce i risultati del modello.
Nota: il codice può essere eseguito in DataLab.
from metaflow import FlowSpec, step, Parameter, NBRunner

class TrainModelFlow(FlowSpec):
    @step
    def start(self):
        # Load and split the dataset
        print("Loading data...")
        self.data = [1, 2, 3, 4, 5]  # Replace with actual data loading logic
        self.labels = [0, 1, 0, 1, 0]  # Replace with labels
        self.next(self.train_model)

    @step
    def train_model(self):
        # Training a simple model (e.g., linear regression)
        print("Training the model...")
        self.model = sum(self.data) / len(self.data)  # Replace with actual model training
        print(f"Model output: {self.model}")
        self.next(self.end)

    @step
    def end(self):
        # Final step
        print("Training complete. Model ready for deployment!")f
In questo codice definiamo tre step:
start(): Carica e suddivide il dataset. In uno scenario reale, caricheresti i dati da una fonte effettiva (ad esempio, un file o un database).train_model(): Simula l'addestramento di un modello. Qui viene calcolata una semplice media al posto di un vero algoritmo di machine learning, ma puoi sostituire questo passaggio con qualsiasi codice di training ti serva.end(): Segna la fine del flow e indica che il modello è pronto per la messa in produzione.Una volta definito il flow, puoi eseguirlo con il seguente comando:
run = NBRunner(TrainModelFlow)
run.nbrun()
Nota che questo codice funziona solo nei notebook (tutto il codice deve essere in un'unica cella).
Se vuoi eseguire questo codice come script, rimuovi i comandi NBRunner e aggiungi quanto segue alla fine del tuo script, quindi salvalo (ad es., “metaflow_ml_model.py”):
if __name__ == "__main__":
    TrainModelFlow()
Quindi, per eseguire lo script, vai sulla riga di comando ed esegui il seguente comando:
py -m metaflow_ml_model.py Metaflow traccia automaticamente ogni run e ti consente di visualizzare i risultati tramite la Metaflow UI.
Quindi, come possiamo sfruttare al massimo le funzionalità di Metaflow? Ecco alcune best practice che possono aiutarti a riuscirci ottimizzando al contempo i tuoi workflow:
Se sei alle prime armi con Metaflow, inizia con workflow semplici per familiarizzare con la sua API. Partire in piccolo ti aiuterà a capire come funziona il framework e a costruire fiducia nelle sue capacità prima di passare a progetti più complessi. Questo approccio riduce la curva di apprendimento e assicura basi solide.
Metaflow include una potente interfaccia utente che può essere estremamente utile per il debugging e il tracciamento dei tuoi workflow. Usa la UI per monitorare le run, controllare gli output dei singoli step e individuare eventuali problemi. Visualizzare i tuoi dati e i log rende più semplice identificare e risolvere i problemi durante l'esecuzione del flow.
Quando installi per la prima volta Metaflow, funziona in modalità locale. In questa modalità, artifact e metadati vengono salvati in una directory locale e le computazioni sono eseguite con processi locali. Questa configurazione funziona bene per uso personale, ma se il tuo progetto prevede collaborazione o dataset di grandi dimensioni, è consigliabile configurare Metaflow per utilizzare AWS per una migliore scalabilità. La buona notizia è che Metaflow offre un'ottima integrazione con AWS.
In questo tutorial, abbiamo visto come iniziare con Metaflow, dall'installazione alla creazione del tuo primo workflow di data science. Abbiamo coperto i concetti chiave, come la definizione degli step, l'uso degli artifact per passare i dati tra gli step e il versioning per tracciare e riprodurre le run. Abbiamo anche percorso un esempio pratico di addestramento di un modello di machine learning, che ha mostrato come definire, eseguire e monitorare il tuo workflow. Infine, abbiamo toccato alcune best practice per aiutarti a ottenere il massimo da Metaflow.
Per continuare ad approfondire l'MLOps, dai un'occhiata alle seguenti risorse:
Approfondisci Python e il machine learning con questi corsi!
Corso
Corso
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



