
Last chance! 50% off DataCamp Premium
Sale ends in
Metaflow डेटा वर्कफ़्लो बनाने और प्रबंधित करने के लिए एक शक्तिशाली फ़्रेमवर्क है। इस ट्यूटोरियल में, आप सीखेंगे कि इसकी शुरुआत कैसे करें। खास तौर पर, हम इन विषयों पर चर्चा करेंगे:
इस लेख के अंत तक, आपके पास अपने वर्कफ़्लोज़ को कुशलतापूर्वक सुव्यवस्थित करने और स्केल करने के लिए आवश्यक कौशल होंगे!
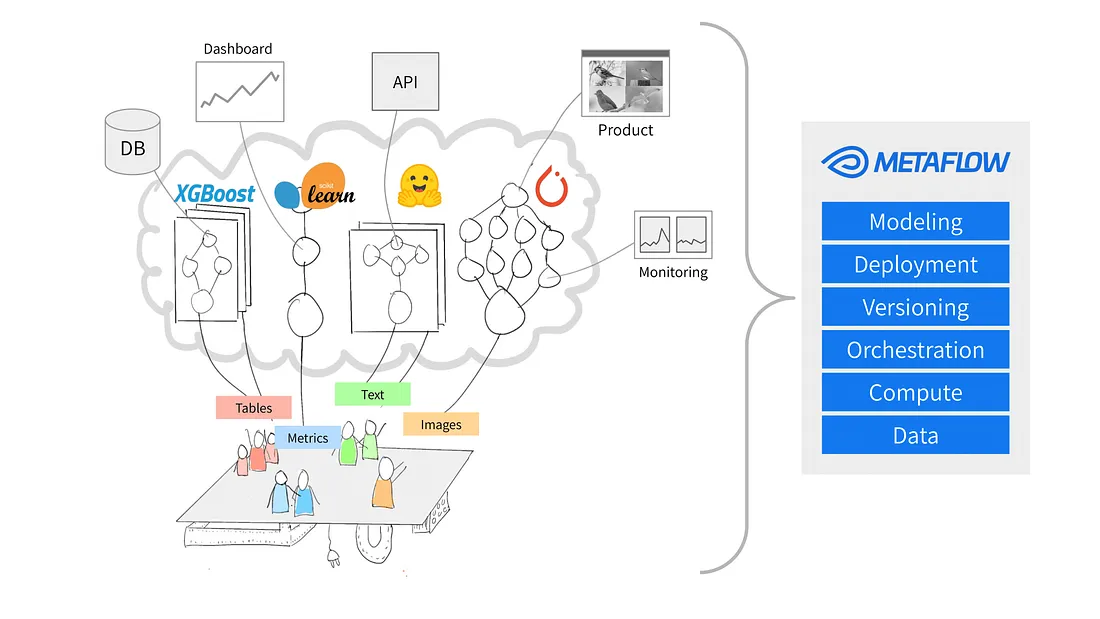
स्रोत: Why Metaflow?
Metaflow एक Python फ़्रेमवर्क है जिसे डेटा साइंस प्रोजेक्ट्स प्रबंधित करने में मदद के लिए डिज़ाइन किया गया है। Netflix ने इसे शुरू में डेटा साइंटिस्ट्स और मशीन लर्निंग इंजीनियरों की उत्पादकता बढ़ाने के लिए विकसित किया था। यह इस उद्देश्य को जटिल कार्यों को सरल बनाकर हासिल करता है, जैसे वर्कफ़्लो ऑर्केस्ट्रेशन, जो सुनिश्चित करता है कि प्रक्रियाएँ शुरू से अंत तक सुचारू रूप से चलें।
Metaflow की प्रमुख विशेषताओं में ऑटोमैटिक डेटा वर्ज़निंग शामिल है, जो आपके वर्कफ़्लोज़ में हुए बदलावों को ट्रैक करती है, और स्केलेबल वर्कफ़्लोज़ का समर्थन, जो उपयोगकर्ताओं को बड़े डेटासेट और अधिक जटिल कार्यों को संभालने में सक्षम बनाता है।
Metaflow का एक और लाभ यह है कि यह AWS के साथ आसानी से इंटीग्रेट हो जाता है। इसका मतलब है कि उपयोगकर्ता स्टोरेज और कंप्यूटिंग पावर के लिए क्लाउड संसाधनों का लाभ उठा सकते हैं। साथ ही, इसका उपयोगकर्ता-अनुकूल Python API इसे शुरुआती और अनुभवी दोनों उपयोगकर्ताओं के लिए सुलभ बनाता है।
आइए इसे सेटअप करना शुरू करें।
Metaflow सुझाव देता है कि नए प्रोजेक्ट्स के लिए उपयोगकर्ता Python 2.7 के बजाय Python 3 इंस्टॉल करें। डॉक्युमेंटेशन बताता है कि “Python 3 में कम बग हैं और यह अप्रचलित Python 2.7 की तुलना में बेहतर सपोर्टेड है।”
अगला कदम आपके प्रोजेक्ट निर्भरताएँ प्रबंधित करने के लिए एक वर्चुअल एन्वायरमेंट बनाना है। ऐसा करने के लिए निम्न कमांड चलाएँ:
python -m venv venv
source venv/bin/activate
यह एक वर्चुअल एन्वायरमेंट बनाएगा और सक्रिय करेगा। एक बार सक्रिय होने के बाद, आप Metaflow इंस्टॉल करने के लिए तैयार हैं।
Metaflow MacOS और Linux के लिए एक Python पैकेज के रूप में उपलब्ध है। इसका नवीनतम संस्करण Metaflow Github रिपॉज़िटरी या PyPi से निम्न कमांड चलाकर इंस्टॉल किया जा सकता है:
pip install metaflowदुर्भाग्यवश, लिखते समय Metaflow Windows उपयोगकर्ताओं के लिए नेटिव सपोर्ट प्रदान नहीं करता। हालाँकि, Windows 10 वाले उपयोगकर्ता WSL (Windows Subsystem for Linux) का उपयोग करके Metaflow इंस्टॉल कर सकते हैं, जो उन्हें अपने Windows ऑपरेटिंग सिस्टम के अंदर Linux एन्वायरमेंट चलाने में सक्षम बनाता है। Check करें डॉक्युमेंटेशन में Windows 10 पर Metaflow इंस्टॉल करने के चरण-दर-चरण निर्देशों के लिए।
Metaflow AWS के साथ सहज इंटीग्रेशन प्रदान करता है, जो उपयोगकर्ताओं को क्लाउड इन्फ्रास्ट्रक्चर का उपयोग करके अपने वर्कफ़्लोज़ स्केल करने की अनुमति देता है। AWS को इंटीग्रेट करने के लिए, आपको अपने AWS क्रेडेंशियल्स सेटअप करने होंगे।
नोट: ये चरण मानते हैं कि आपके पास पहले से एक AWS खाता और AWS CLI इंस्टॉल है। अधिक विवरण के लिए, AWS डॉक्युमेंटेशन के निर्देशों का पालन करें।
pip install awscliaws configureइसके बाद, आपको अपना AWS Access Key ID और Secret Access Key दर्ज करने के लिए कहा जाएगा—ये बस वे क्रेडेंशियल्स हैं जिनका उपयोग AWS CLI आपके AWS अनुरोधों को प्रमाणित करने के लिए करता है। ध्यान दें कि आपसे अपनी रीजन और आउटपुट फ़ॉर्मेट दर्ज करने के लिए भी कहा जा सकता है।
इन विवरणों को दर्ज करने के बाद, हो गया! Metaflow आपके वर्कफ़्लोज़ चलाने के लिए स्वतः आपके AWS क्रेडेंशियल्स का उपयोग करेगा।
अब जब Metaflow सेटअप हो चुका है, तो अपना पहला वर्कफ़्लो बनाने का समय है। इस सेक्शन में, मैं आपको फ्लो बनाने, उसे चलाने, और Metaflow में टास्क्स व स्टेप्स कैसे संगठित होते हैं, इसकी बुनियादी बातें बताऊँगा।
इस सेक्शन के अंत तक, आपके पास एक ऐसा वर्कफ़्लो होगा जो डेटा प्रोसेस करता है और सरल ऑपरेशंस करता है। चलिए शुरू करें!
Metaflow डेटाफ्लो पैराडाइम का उपयोग करता है, जो किसी प्रोग्राम को ऑपरेशंस के निर्देशित ग्राफ़ के रूप में दर्शाता है। यह तरीका डेटा प्रोसेसिंग पाइपलाइनों के निर्माण के लिए आदर्श है, विशेषकर मशीन लर्निंग में।
Metaflow में, ऑपरेशंस के ग्राफ़ को फ्लो कहा जाता है। एक फ्लो कई टास्क्स की श्रृंखला होती है जो स्टेप्स में विभाजित होती है। ध्यान दें कि प्रत्येक स्टेप को एक नोड के रूप में दर्शाए गए ऑपरेशन की तरह माना जा सकता है, जहाँ स्टेप्स के बीच ट्रांज़िशन ग्राफ़ की एजेज़ की तरह कार्य करते हैं।
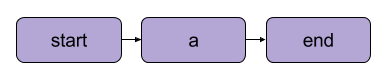
Metaflow का एक बुनियादी रैखिक ट्रांज़िशन | स्रोत: Metaflow डॉक्युमेंटेशन
Metaflow में फ्लोज़ के लिए कुछ संरचनात्मक नियम हैं। उदाहरण के लिए, प्रत्येक फ्लो में एक start स्टेप और एक end स्टेप शामिल होना चाहिए। जब कोई फ्लो निष्पादित होता है, जिसे run कहा जाता है, तो यह start स्टेप से शुरू होता है और यदि यह बिना त्रुटियों के end स्टेप तक पहुँचता है, तो इसे सफल माना जाता है।
start और end स्टेप्स के बीच क्या होता है, यह पूरी तरह आप पर निर्भर है — जैसा कि आप अगले भाग में देखेंगे।
शुरू करने के लिए यहाँ एक सरल फ्लो है। नोट: यह कोड DataLab में चलाया जा सकता है।
from metaflow import FlowSpec, step

class MyFirstFlow(FlowSpec):
    @step
    def start(self):
        print("Starting the flow!")
        self.data = [1, 2, 3, 4, 5]  # Example dataset
        self.next(self.process_data)
    @step
    def process_data(self):
        self.processed_data = [x * 2 for x in self.data]  # Simple data processing
        print("Processed data:", self.processed_data)
        self.next(self.end)
    @step
    def end(self):
        print("Flow is complete!")

if __name__ == '__main__':
    MyFirstFlow()
इस फ्लो में:
start() स्टेप वर्कफ़्लो को इनिशियलाइज़ करता है और एक डेटासेट परिभाषित करता है।process_data() स्टेप डेटा को प्रत्येक तत्व को दोगुना करके प्रोसेस करता है।end() स्टेप फ्लो को पूरा करता है।प्रत्येक स्टेप @step डेकोरेटर का उपयोग करता है, और आप self.next() का उपयोग करके स्टेप्स को जोड़ते हुए फ्लो अनुक्रम परिभाषित करते हैं।
अपना फ्लो लिखने के बाद, इसे my_first_flow.py के रूप में सहेजें। कमांड लाइन से इसे इस तरह चलाएँ:
py -m my_first_flow.py runMetaflow 2.12 में एक नया फीचर जोड़ा गया है जो उपयोगकर्ताओं को नोटबुक्स में फ्लोज़ विकसित और निष्पादित करने में सक्षम बनाता है।
किसी परिभाषित सेल में फ्लो निष्पादित करने के लिए, आपको बस उसी सेल की आखिरी लाइन में NBRunner की एक-लाइनर जोड़नी होगी। उदाहरण के लिए:
from metaflow import FlowSpec, step, NBRunner

class MyFirstFlow(FlowSpec):
    @step
    def start(self):
        print("Starting the flow!")
        self.data = [1, 2, 3, 4, 5]  # Example dataset
        self.next(self.process_data)
    @step
    def process_data(self):
        self.processed_data = [x * 2 for x in self.data]  # Simple data processing
        print("Processed data:", self.processed_data)
        self.next(self.end)
    @step
    def end(self):
        print("Flow is complete!")

run = NBRunner(MyFirstFlow).nbrun()
यदि आपको निम्न त्रुटि मिलती है:
“Metaflow could not determine your user name based on environment variables ($USERNAME etc.)”
Metaflow के निष्पादन से पहले अपने कोड में निम्न जोड़ें:
import os
if os.environ.get("USERNAME") is None:
    os.environ["USERNAME"] = "googlecolab"
दोनों स्थितियों में, Metaflow फ्लो को स्टेप-दर-स्टेप निष्पादित करेगा। यानी, यह टर्मिनल में प्रत्येक स्टेप का आउटपुट निम्नानुसार दिखाएगा:
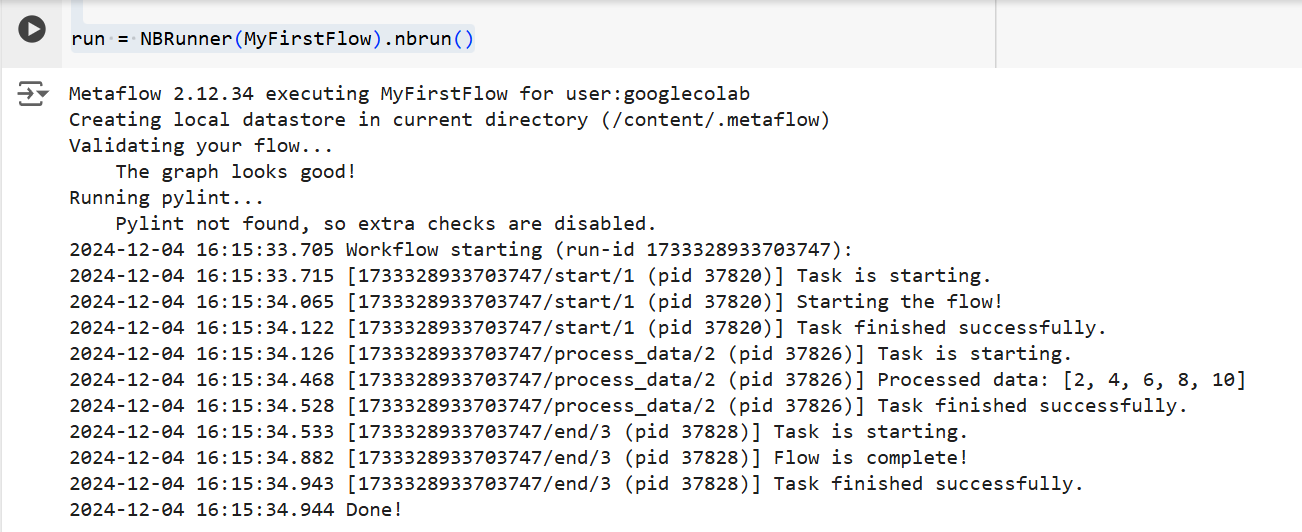
ऊपर दिए गए कोड का आउटपुट | स्रोत: लेखक द्वारा छवि
Metaflow की मुख्य अवधारणाओं को समझना कुशल और स्केलेबल डेटा वर्कफ़्लोज़ बनाने के लिए आवश्यक है। इस सेक्शन में, मैं तीन बुनियादी अवधारणाएँ कवर करूँगा:
ये तत्व Metaflow की संरचना और वर्कफ़्लोज़ के निष्पादन की रीढ़ बनाते हैं, जो आपको जटिल प्रक्रियाओं को आसानी से प्रबंधित करने में सक्षम बनाते हैं।
हमने लेख में पहले स्टेप्स पर संक्षेप में बात की थी, लेकिन स्पष्टता के लिए, हम उन्हें फिर से देखेंगे। Metaflow वर्कफ़्लोज़ के बारे में सबसे महत्वपूर्ण बात यह समझना है कि वे स्टेप्स के इर्द-गिर्द बने होते हैं।
स्टेप्स वर्कफ़्लो के भीतर प्रत्येक व्यक्तिगत टास्क का प्रतिनिधित्व करते हैं। दूसरे शब्दों में, हर स्टेप एक विशिष्ट ऑपरेशन करता है (जैसे डेटा लोडिंग, प्रोसेसिंग, मॉडलिंग, आदि)।
हमने ऊपर “अपना पहला फ्लो लिखना” में जो उदाहरण बनाया था, वह एक रैखिक ट्रांसफ़ॉर्मेशन था। क्रमिक स्टेप्स के अलावा, Metaflow उपयोगकर्ताओं को वर्कफ़्लोज़ को ब्रांच करने में भी सक्षम बनाता है। ब्रांच वर्कफ़्लोज़ निष्पादन के लिए अलग-अलग पथ बनाकर एक साथ कई टास्क्स चलाने की अनुमति देते हैं।
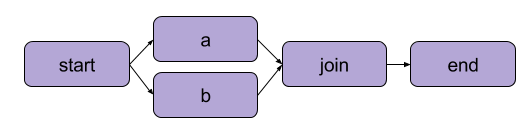
ब्रांचिंग का एक उदाहरण | स्रोत: Metaflow डॉक्युमेंटेशन
ब्रांच का मुख्य लाभ प्रदर्शन है। ब्रांचिंग का मतलब है कि Metaflow कई CPU कोर्स या क्लाउड इंस्टेंसेज़ पर विभिन्न स्टेप्स निष्पादित कर सकता है।
कोड में ब्रांच इस तरह दिखेगा:
from metaflow import FlowSpec, step, NBRunner

class BranchFlow(FlowSpec):
    @step
    def start(self):
        print("Starting the flow!")
        self.data = [1, 2, 3, 4, 5]  # Example dataset
        self.next(self.split)
    @step
    def split(self):
        self.next(self.branch1, self.branch2)

    @step
    def branch1(self):
        # Code for branch 1
        print("This is branch 1")
        self.next(self.join)

    @step
    def branch2(self):
        # Code for branch 2
        print("This is branch 2")
        self.next(self.join)

    @step
    def join(self, inputs):
        # Merging branches back
        print("Branches joined.")
        self.next(self.end)

    @step
    def end(self):
        print("Flow is complete!")

run = NBRunner(BranchFlow).nbrun()|
💡TLDR: ब्रांचिंग उपयोगकर्ताओं को जटिल वर्कफ़्लो डिज़ाइन करने देती है जो एक साथ कई टास्क्स प्रोसेस कर सकते हैं। |
डेटा आर्टिफ़ैक्ट्स वे वेरिएबल्स हैं जो आपको वर्कफ़्लो में स्टेप्स के बीच डेटा स्टोर और पास करने की अनुमति देते हैं। ये आर्टिफ़ैक्ट्स एक स्टेप के आउटपुट को अगले में बनाए रखते हैं—यही तरीका है जिससे बाद के स्टेप्स के लिए डेटा उपलब्ध होता है।
मूलतः, जब आप किसी Metaflow क्लास के भीतर किसी स्टेप में डेटा को self को असाइन करते हैं, तो आप उसे एक आर्टिफ़ैक्ट के रूप में सेव करते हैं, जिसे फ्लो के किसी भी अन्य स्टेप द्वारा एक्सेस किया जा सकता है (कोड में टिप्पणियाँ देखें)।
class ArtifactFlow(FlowSpec):
    @step
    def start(self):
        # Step 1: Initializing data
        print("Starting the flow!")
        self.data = [1, 2, 3, 4, 5]  # Example dataset saved as an artifact
        self.next(self.process_data)
    @step
    def process_data(self):
        # Step 2: Processing the data from the 'start' step
        self.processed_data = [x * 2 for x in self.data]  # Processing artifact data
        print("Processed data:", self.processed_data)
        self.next(self.save_results)
    @step
    def save_results(self):
        # Step 3: Saving the processed data artifact
        self.results = sum(self.processed_data)  # Saving final result as an artifact
        print("Sum of processed data:", self.results)
        self.next(self.end)
    @step
    def end(self):
        # Final step
        print("Flow is complete!")
        print(f"Final result: {self.results}")  # Accessing artifact in final step
आर्टिफ़ैक्ट्स Metaflow की मुख्य अवधारणा क्यों हैं? क्योंकि उनके कई उपयोग हैं:
Metaflow आपके वर्कफ़्लोज़ के लिए स्वतः वर्ज़निंग संभालता है। यानी हर बार जब कोई फ्लो निष्पादित होता है, तो उसे एक यूनिक रन के रूप में ट्रैक किया जाता है। दूसरे शब्दों में, प्रत्येक रन का अपना वर्ज़न होता है, जिससे आप आसानी से पुराने रनों की समीक्षा और पुनरुत्पादन कर सकते हैं।
Metaflow यह प्रत्येक रन को यूनिक आइडेंटिफ़ायर असाइन करके और उस निष्पादन के डेटा व आर्टिफ़ैक्ट्स को संरक्षित करके करता है। यह परसिस्टेंस सुनिश्चित करता है कि रनों के बीच कोई डेटा न खोए। पिछले वर्कफ़्लोज़ को आसानी से फिर से देखा और जाँचा जा सकता है, और आवश्यकता होने पर विशिष्ट स्टेप्स को फिर से चलाया जा सकता है। परिणामस्वरूप, डीबगिंग और इटरेटिव डेवलपमेंट अधिक कुशल हो जाते हैं, और पुनरुत्पादन बनाए रखना सरल हो जाता है।
इस सेक्शन में, मैं आपको Metaflow का उपयोग करके एक मशीन लर्निंग मॉडल ट्रेन करने के माध्यम से मार्गदर्शन करूँगा। आप सीखेंगे कि:
अंत तक, आपको यह बेहतर समझ होगी कि Metaflow का उपयोग करके मशीन लर्निंग वर्कफ़्लोज़ को प्रभावी ढंग से कैसे संरचित और चलाया जाए। चलिए शुरू करें!
शुरू करने के लिए, हम एक बुनियादी फ्लो बनाएँगे जो एक डेटासेट लोड करता है, प्रशिक्षण करता है, और मॉडल के परिणाम आउटपुट करता है।
नोट: यह कोड DataLab में चलाया जा सकता है।
from metaflow import FlowSpec, step, Parameter, NBRunner

class TrainModelFlow(FlowSpec):
    @step
    def start(self):
        # Load and split the dataset
        print("Loading data...")
        self.data = [1, 2, 3, 4, 5]  # Replace with actual data loading logic
        self.labels = [0, 1, 0, 1, 0]  # Replace with labels
        self.next(self.train_model)

    @step
    def train_model(self):
        # Training a simple model (e.g., linear regression)
        print("Training the model...")
        self.model = sum(self.data) / len(self.data)  # Replace with actual model training
        print(f"Model output: {self.model}")
        self.next(self.end)

    @step
    def end(self):
        # Final step
        print("Training complete. Model ready for deployment!")f
इस कोड में, हम तीन स्टेप्स परिभाषित करते हैं:
start(): डेटासेट लोड और स्प्लिट करता है। वास्तविक दुनिया के परिदृश्य में, आप डेटा को किसी वास्तविक स्रोत (जैसे फ़ाइल या डेटाबेस) से लोड करेंगे।train_model(): किसी मॉडल के प्रशिक्षण का सिमुलेशन करता है। यहाँ वास्तविक मशीन लर्निंग एल्गोरिदम के बजाय एक सरल एवरेज कैलकुलेशन किया गया है, लेकिन आप इसे अपनी आवश्यकता के अनुसार किसी भी प्रशिक्षण कोड से बदल सकते हैं।end(): फ्लो के अंत को चिह्नित करता है और संकेत देता है कि मॉडल डिप्लॉयमेंट के लिए तैयार है।एक बार जब आपने फ्लो परिभाषित कर लिया हो, तो आप निम्न कमांड का उपयोग करके इसे चला सकते हैं:
run = NBRunner(TrainModelFlow)
run.nbrun()
ध्यान दें कि यह कोड केवल नोटबुक्स में काम करता है (सारा कोड एक ही सेल में होना चाहिए)।
यदि आप इस कोड को स्क्रिप्ट के रूप में चलाना चाहते हैं, तो NBRunner कमांड्स हटाएँ और अपनी स्क्रिप्ट के अंत में निम्न जोड़ें, और इसे सहेजें (जैसे, “metaflow_ml_model.py”):
if __name__ == "__main__":
    TrainModelFlow()
फिर स्क्रिप्ट चलाने के लिए, कमांड लाइन पर जाएँ और निम्न कमांड चलाएँ:
py -m metaflow_ml_model.py Metaflow स्वचालित रूप से प्रत्येक रन को ट्रैक करता है और आपको परिणामों को Metaflow UI के माध्यम से विज़ुअलाइज़ करने देता है।
तो, हम Metaflow की विशेषताओं का अधिकतम लाभ कैसे उठाएँ? यहाँ कुछ सर्वोत्तम तरीके हैं जो आपको यह उपलब्धि हासिल करने में मदद कर सकते हैं और साथ ही आपके वर्कफ़्लोज़ को अनुकूलित कर सकते हैं:
यदि आप Metaflow में नए हैं, तो इसके API से परिचित होने के लिए सरल वर्कफ़्लोज़ से शुरुआत करें। छोटे से शुरू करने से आप समझ पाएँगे कि फ़्रेमवर्क कैसे काम करता है और अधिक जटिल प्रोजेक्ट्स पर जाने से पहले इसकी क्षमताओं में आत्मविश्वास बनाएँगे। यह तरीका सीखने की वक्र को कम करता है और सुनिश्चित करता है कि आपकी बुनियाद मज़बूत हो।
Metaflow में एक शक्तिशाली यूज़र इंटरफ़ेस शामिल है जो आपके वर्कफ़्लोज़ को डीबग और ट्रैक करने में अत्यंत सहायक हो सकता है। UI का उपयोग रनों की निगरानी करने, व्यक्तिगत स्टेप्स के आउटपुट चेक करने, और किसी भी संभावित समस्या की पहचान करने के लिए करें। अपने डेटा और लॉग्स को विज़ुअलाइज़ करना आपके फ्लो के निष्पादन के दौरान समस्याओं की पहचान और समाधान करना आसान बनाता है।
जब आप पहली बार Metaflow इंस्टॉल करते हैं, तो यह लोकल मोड में काम करता है। इस मोड में, आर्टिफ़ैक्ट्स और मेटाडेटा एक लोकल डायरेक्टरी में सेव होते हैं, और कंप्यूटेशंस लोकल प्रोसेसेज़ का उपयोग करके चलाए जाते हैं। यह सेटअप व्यक्तिगत उपयोग के लिए अच्छा काम करता है, लेकिन यदि आपका प्रोजेक्ट सहयोग या बड़े डेटासेट शामिल करता है, तो बेहतर स्केलेबिलिटी के लिए Metaflow को AWS उपयोग करने के लिए कॉन्फ़िगर करना उचित है। अच्छी बात यह है कि Metaflow AWS के साथ उत्कृष्ट इंटीग्रेशन प्रदान करता है।
इस ट्यूटोरियल में, हमने Metaflow के साथ शुरुआत करना सीखा—इंस्टॉलेशन से लेकर अपना पहला डेटा साइंस वर्कफ़्लो बनाने तक। हमने मुख्य अवधारणाएँ कवर कीं, जैसे स्टेप्स को परिभाषित करना, स्टेप्स के बीच डेटा पास करने के लिए डेटा आर्टिफ़ैक्ट्स का उपयोग करना, और रनों को ट्रैक व पुनरुत्पादित करने के लिए वर्ज़निंग। हमने एक व्यावहारिक उदाहरण के माध्यम से एक मशीन लर्निंग मॉडल को ट्रेन करना भी देखा, जिसने यह दिखाया कि अपने वर्कफ़्लो को कैसे परिभाषित, चलाएँ और मॉनिटर करें। अंत में, हमने Metaflow का अधिकतम लाभ उठाने में मदद करने के लिए कुछ सर्वोत्तम तरीकों पर भी चर्चा की।
MLOps की अपनी लर्निंग जारी रखने के लिए, निम्न संसाधन देखें:
इन कोर्सेज़ के साथ Python और मशीन लर्निंग के बारे में और जानें!
कोर्स
कोर्स
कोर्स
