
Cursus
End-to-End Machine Learning
4 uur
17K
Metaflow is een krachtig framework voor het bouwen en beheren van dataworkflows. In deze tutorial leer je hoe je aan de slag gaat. We staan stil bij:
Aan het einde van dit artikel beschik je over de benodigde skills om je workflows efficiënt te stroomlijnen en op te schalen!
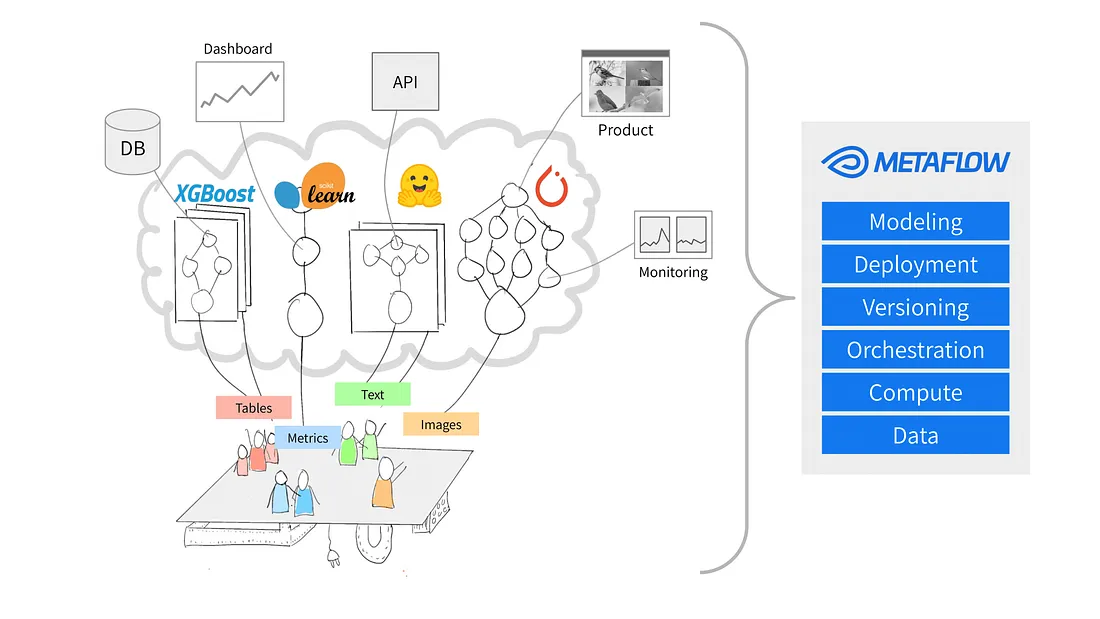
Bron: Why Metaflow?
Metaflow is een Python-framework dat is ontworpen om data science-projecten te beheren. Netflix ontwikkelde de tool oorspronkelijk om data scientists en machine learning-engineers productiever te maken. Het bereikt dit doel door complexe taken te vereenvoudigen, zoals workflow-orkestratie, zodat processen van begin tot eind soepel verlopen.
Belangrijke functies van Metaflow zijn onder meer automatische dataversiebeheer, waarmee wijzigingen in je workflows worden bijgehouden, en ondersteuning voor schaalbare workflows, zodat je grotere datasets en complexere taken aankan.
Een ander voordeel van Metaflow is de eenvoudige integratie met AWS. Dit betekent dat je cloudresources kunt benutten voor opslag en rekenkracht. Bovendien maakt de gebruiksvriendelijke Python-API het toegankelijk voor zowel beginners als ervaren gebruikers.
Laten we beginnen met de installatie.
Metaflow raadt aan om voor nieuwe projecten Python 3 te installeren in plaats van Python 2.7. De documentatie geeft aan dat “Python 3 minder bugs heeft en beter wordt ondersteund dan het verouderde Python 2.7.”
De volgende stap is het maken van een virtuele omgeving om je projectafhankelijkheden te beheren. Voer hiervoor de volgende opdracht uit:
python -m venv venv
source venv/bin/activate
Dit maakt en activeert een virtuele omgeving. Zodra deze is geactiveerd, kun je Metaflow installeren.
Metaflow is beschikbaar als Python-pakket voor macOS en Linux. De nieuwste versie kan worden geïnstalleerd via de Metaflow Github-repository of PyPi met de volgende opdracht:
pip install metaflowHelaas biedt Metaflow op het moment van schrijven geen native ondersteuning voor Windows-gebruikers. Gebruikers met Windows 10 kunnen echter WSL (Windows Subsystem for Linux) gebruiken om Metaflow te installeren, zodat ze een Linux-omgeving binnen hun Windows-besturingssysteem kunnen draaien. Bekijk de documentatie voor een stapsgewijze handleiding voor het installeren van Metaflow op Windows 10.
Metaflow biedt naadloze integratie met AWS, waardoor gebruikers hun workflows kunnen opschalen met cloudinfrastructuur. Om AWS te integreren, moet je je AWS-referenties instellen.
Let op: Deze stappen gaan ervan uit dat je al een AWS-account en de AWS CLI hebt geïnstalleerd. Voor meer details, volg de instructies in de AWS-documentatie.
pip install awscliaws configureVanaf hier word je gevraagd je AWS Access Key ID en Secret Access Key in te voeren—dit zijn simpelweg de inloggegevens die de AWS CLI gebruikt om je verzoeken bij AWS te verifiëren. Mogelijk wordt je ook gevraagd je regio en uitvoerformaat op te geven.
Zodra je deze gegevens hebt ingevoerd, voilà! Metaflow gebruikt automatisch je AWS-referenties om workflows uit te voeren.
Nu Metaflow is ingesteld, is het tijd om je eerste workflow te bouwen. In deze sectie neem ik je mee door de basis van het maken van een flow, het uitvoeren ervan en hoe taken en stappen in Metaflow zijn georganiseerd.
Aan het einde van deze sectie heb je een workflow die data verwerkt en eenvoudige bewerkingen uitvoert. Let’s go!
Metaflow gebruikt het dataflow-paradigma, dat een programma weergeeft als een gerichte graaf van bewerkingen. Deze aanpak is ideaal voor het bouwen van dataverwerkingspijplijnen, vooral in machine learning.
In Metaflow wordt de graaf van bewerkingen een flow genoemd. Een flow bestaat uit een reeks taken die zijn opgedeeld in stappen. Elke stap kun je zien als een bewerking die wordt weergegeven als een knooppunt, waarbij de overgangen tussen stappen fungeren als de randen van de graaf.
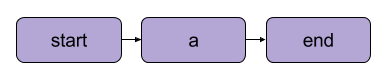
Een basis lineaire overgang in Metaflow | Bron: Metaflow-documentatie
Er zijn een paar structurele regels voor flows in Metaflow. Zo moet elke flow een start-stap en een end-stap bevatten. Wanneer een flow wordt uitgevoerd, oftewel een run, begint deze met de start-stap en is deze geslaagd als de end-stap zonder fouten wordt bereikt.
Wat er tussen de start- en end-stappen gebeurt, is helemaal aan jou—zoals je in het volgende onderdeel zult zien.
Hier is een eenvoudige flow om mee te beginnen. Let op: de code kan worden uitgevoerd in DataLab.
from metaflow import FlowSpec, step

class MyFirstFlow(FlowSpec):
    @step
    def start(self):
        print("Starting the flow!")
        self.data = [1, 2, 3, 4, 5]  # Example dataset
        self.next(self.process_data)
    @step
    def process_data(self):
        self.processed_data = [x * 2 for x in self.data]  # Simple data processing
        print("Processed data:", self.processed_data)
        self.next(self.end)
    @step
    def end(self):
        print("Flow is complete!")

if __name__ == '__main__':
    MyFirstFlow()
In deze flow:
start() initialiseert de workflow en definieert een dataset.process_data() verwerkt de data door elk element te verdubbelen.end() rondt de flow af.Elke stap gebruikt de decorator @step, en je definieert de volgorde met self.next() om de stappen te verbinden.
Sla je flow na het schrijven op als my_first_flow.py. Voer hem uit vanaf de command line met:
py -m my_first_flow.py runIn Metaflow 2.12 is een nieuwe functie toegevoegd waarmee je flows kunt ontwikkelen en uitvoeren in notebooks.
Om een flow in een bepaalde cel uit te voeren, hoef je alleen de one-liner NBRunner toe te voegen op de laatste regel van dezelfde cel. Bijvoorbeeld:
from metaflow import FlowSpec, step, NBRunner

class MyFirstFlow(FlowSpec):
    @step
    def start(self):
        print("Starting the flow!")
        self.data = [1, 2, 3, 4, 5]  # Example dataset
        self.next(self.process_data)
    @step
    def process_data(self):
        self.processed_data = [x * 2 for x in self.data]  # Simple data processing
        print("Processed data:", self.processed_data)
        self.next(self.end)
    @step
    def end(self):
        print("Flow is complete!")

run = NBRunner(MyFirstFlow).nbrun()
Krijg je de volgende foutmelding:
“Metaflow could not determine your user name based on environment variables ($USERNAME etc.)”
Voeg dan het volgende toe aan je code vóór de uitvoering van Metaflow:
import os
if os.environ.get("USERNAME") is None:
    os.environ["USERNAME"] = "googlecolab"
In beide gevallen voert Metaflow de flow stap-voor-stap uit. Het toont telkens de output van elke stap in de terminal, zoals hieronder:
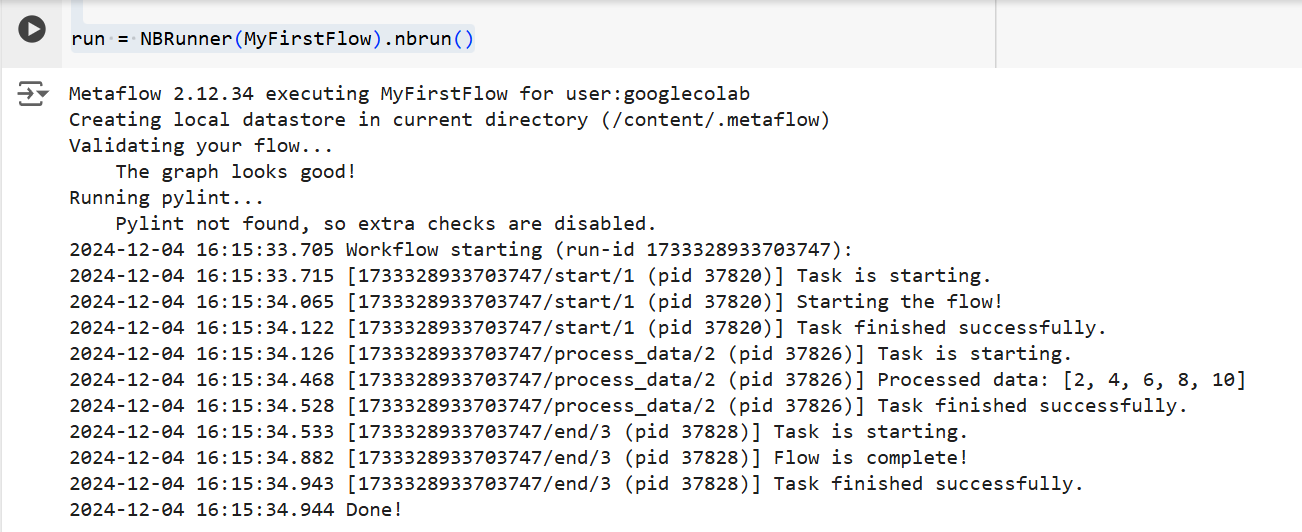
De output van de code hierboven | Bron: Afbeelding door de auteur
Inzicht in de kernconcepten van Metaflow is essentieel voor het bouwen van efficiënte en schaalbare dataworkflows. In deze sectie behandel ik drie fundamentele concepten:
Deze elementen vormen de ruggengraat van Metaflow’s structuur en uitvoering van workflows, zodat je makkelijk complexe processen kunt beheren.
We hebben het eerder kort gehad over stappen, maar voor de duidelijkheid komen we er nog even op terug. Het belangrijkste om te begrijpen over Metaflow-workflows is dat ze rond stappen zijn opgebouwd.
Stappen vertegenwoordigen elke afzonderlijke taak binnen een workflow. Met andere woorden: elke stap voert een specifieke bewerking uit (bijv. data laden, verwerken, modelleren, enz.).
Het voorbeeld hierboven in “Je eerste flow schrijven” was een lineaire transformatie. Naast sequentiële stappen kun je in Metaflow ook workflows vertakken. Met vertakkingen kun je meerdere taken parallel uitvoeren door aparte paden voor uitvoering te maken.
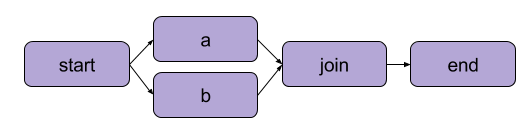
Een voorbeeld van vertakken | Bron: Metaflow-documentatie
Het grootste voordeel van een vertakking is performance. Hierdoor kan Metaflow verschillende stappen uitvoeren over meerdere CPU-cores of instances in de cloud.
Zo ziet een vertakking er in code uit:
from metaflow import FlowSpec, step, NBRunner

class BranchFlow(FlowSpec):
    @step
    def start(self):
        print("Starting the flow!")
        self.data = [1, 2, 3, 4, 5]  # Example dataset
        self.next(self.split)
    @step
    def split(self):
        self.next(self.branch1, self.branch2)

    @step
    def branch1(self):
        # Code for branch 1
        print("This is branch 1")
        self.next(self.join)

    @step
    def branch2(self):
        # Code for branch 2
        print("This is branch 2")
        self.next(self.join)

    @step
    def join(self, inputs):
        # Merging branches back
        print("Branches joined.")
        self.next(self.end)

    @step
    def end(self):
        print("Flow is complete!")

run = NBRunner(BranchFlow).nbrun()|
💡TLDR: met vertakken kun je complexe workflows ontwerpen die meerdere taken gelijktijdig verwerken. |
Data-artifacts zijn variabelen waarmee je data kunt opslaan en doorgeven tussen stappen in een workflow. Deze artifacts bewaren de output van de ene stap voor de volgende—zo wordt data beschikbaar gemaakt voor daaropvolgende stappen.
Kortom: wanneer je data toewijst aan self binnen een stap in een Metaflow-klasse, sla je die op als een artifact. Dat artifact kan vervolgens door elke andere stap in de flow worden gebruikt (zie de comments in de code).
class ArtifactFlow(FlowSpec):
    @step
    def start(self):
        # Step 1: Initializing data
        print("Starting the flow!")
        self.data = [1, 2, 3, 4, 5]  # Example dataset saved as an artifact
        self.next(self.process_data)
    @step
    def process_data(self):
        # Step 2: Processing the data from the 'start' step
        self.processed_data = [x * 2 for x in self.data]  # Processing artifact data
        print("Processed data:", self.processed_data)
        self.next(self.save_results)
    @step
    def save_results(self):
        # Step 3: Saving the processed data artifact
        self.results = sum(self.processed_data)  # Saving final result as an artifact
        print("Sum of processed data:", self.results)
        self.next(self.end)
    @step
    def end(self):
        # Final step
        print("Flow is complete!")
        print(f"Final result: {self.results}")  # Accessing artifact in final step
Waarom zijn artifacts een kernconcept van Metaflow? Omdat ze meerdere toepassingen hebben:
Metaflow regelt automatisch het versiebeheer voor je workflows. Dit betekent dat elke keer dat een flow wordt uitgevoerd, dit wordt bijgehouden als een unieke run. Met andere woorden: elke run heeft een eigen versie, zodat je eerdere runs eenvoudig kunt bekijken en reproduceren.
Metaflow doet dit door unieke identifiers toe te wijzen aan elke run en de data en artifacts van die uitvoering te bewaren. Dankzij deze persistentie gaat er geen data verloren tussen runs. Eerdere workflows zijn eenvoudig te herbekijken en te inspecteren, en specifieke stappen kunnen indien nodig opnieuw worden uitgevoerd. Hierdoor verlopen debuggen en iteratieve ontwikkeling veel efficiënter en blijft reproduceerbaarheid eenvoudig te behouden.
In deze sectie laat ik je zien hoe je Metaflow gebruikt om een machine learning-model te trainen. Je leert hoe je:
Aan het einde begrijp je beter hoe je Metaflow gebruikt om machine learning-workflows efficiënt te structureren en uit te voeren. Let’s go!
We beginnen met een basisflow die een dataset laadt, traint en de resultaten van het model uitgeeft.
Let op: de code kan in DataLab worden uitgevoerd.
from metaflow import FlowSpec, step, Parameter, NBRunner

class TrainModelFlow(FlowSpec):
    @step
    def start(self):
        # Load and split the dataset
        print("Loading data...")
        self.data = [1, 2, 3, 4, 5]  # Replace with actual data loading logic
        self.labels = [0, 1, 0, 1, 0]  # Replace with labels
        self.next(self.train_model)

    @step
    def train_model(self):
        # Training a simple model (e.g., linear regression)
        print("Training the model...")
        self.model = sum(self.data) / len(self.data)  # Replace with actual model training
        print(f"Model output: {self.model}")
        self.next(self.end)

    @step
    def end(self):
        # Final step
        print("Training complete. Model ready for deployment!")f
In deze code definiëren we drie stappen:
start(): Laadt en splitst de dataset. In een echte toepassing laad je data uit een werkelijke bron (bijv. een bestand of database).train_model(): Simuleert het trainen van een model. Hier wordt een eenvoudig gemiddelde berekend in plaats van een echt machine learning-algoritme, maar je kunt dit vervangen door elke trainingscode die je nodig hebt.end(): Markeert het einde van de flow en geeft aan dat het model klaar is voor deployment.Zodra je de flow hebt gedefinieerd, kun je deze uitvoeren met de volgende opdracht:
run = NBRunner(TrainModelFlow)
run.nbrun()
Let op: deze code werkt alleen in notebooks (alle code moet in één cel staan).
Als je deze code als script wilt uitvoeren, verwijder dan de NBRunner-commando’s en voeg het volgende toe aan het einde van je script, en sla het op (bijv. “metaflow_ml_model.py”):
if __name__ == "__main__":
    TrainModelFlow()
Voer vervolgens op de command line de volgende opdracht uit om het script te starten:
py -m metaflow_ml_model.py Metaflow houdt elke run automatisch bij en laat je resultaten visualiseren via de Metaflow UI.
Hoe haal je het meeste uit de functies van Metaflow? Hier zijn een paar best practices die je daarbij helpen en je workflows tegelijk optimaliseren:
Als je nieuw bent met Metaflow, begin dan met eenvoudige workflows om vertrouwd te raken met de API. Klein beginnen helpt je begrijpen hoe het framework werkt en geeft vertrouwen voordat je aan complexere projecten begint. Deze aanpak verkleint de leercurve en zorgt voor een stevige basis.
Metaflow bevat een krachtige user interface die heel nuttig kan zijn voor het debuggen en volgen van je workflows. Gebruik de UI om runs te monitoren, de outputs van individuele stappen te bekijken en eventuele problemen te identificeren. Door je data en logs te visualiseren, kun je tijdens de uitvoering van je flow sneller problemen vinden en oplossen.
Wanneer je Metaflow voor het eerst installeert, werkt het in local mode. In deze modus worden artifacts en metadata lokaal opgeslagen en worden berekeningen uitgevoerd met lokale processen. Dit werkt prima voor persoonlijk gebruik, maar als je project samenwerking of grote datasets omvat, is het aan te raden Metaflow te configureren voor AWS voor betere schaalbaarheid. Het mooie is dat Metaflow uitstekende integratie met AWS biedt.
In deze tutorial hebben we bekeken hoe je aan de slag gaat met Metaflow, van installatie tot het bouwen van je eerste data science-workflow. We hebben de kernconcepten behandeld, zoals het definiëren van stappen, data-artifacts gebruiken om data tussen stappen door te geven, en versiebeheer om runs te volgen en te reproduceren. We hebben ook een praktisch voorbeeld doorgenomen van het trainen van een machine learning-model, waarmee we hebben laten zien hoe je je workflow definieert, uitvoert en monitort. Tot slot hebben we enkele best practices besproken om het meeste uit Metaflow te halen.
Wil je verder leren over MLOps? Bekijk dan de volgende resources:
Leer meer over Python en machine learning met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

