过滤是 PySpark 中的基础操作,对于快速细化大型数据集、聚焦相关信息至关重要。有效使用 PySpark 过滤可以提升中级数据工程师、数据科学家和开发者在大数据处理中的工作流效率。
本文将介绍 PySpark 过滤的基础与高级技巧,给出提升性能的优化策略,并涵盖适用于真实场景的实用用例。
本教程默认您具备一定的 PySpark 基础,不过您也可以在我们的 PySpark 入门教程 中了解 PySpark 是什么以及如何使用。
什么是 PySpark 过滤操作?
正如我们的 2025 年从零学习 PySpark 指南中提到的,PySpark 以其易用性和高效性而广泛应用于数据科学。它通过内置函数如 filter() 和 where() 提供了高效过滤数据集的简便方式。这些函数帮助数据专业人士从 DataFrame 中筛选满足特定条件的行。
过滤在数据预处理、分析与管道优化中至关重要。它允许您在早期就排除无关或错误记录,从而节省时间、降低成本,并改善后续分析或建模任务。
尽管使用起来简单,但在分布式环境中应用过滤可能会带来挑战,例如性能瓶颈、低效或复杂的过滤条件,以及对缺失或不完整数据处理不当。
理解 Spark 过滤对于在数据工程面试中脱颖而出至关重要。
使用我们的 30+ 大数据面试题精选教程,从数据存储、分布式计算等基础概念到机器学习与安全等高级主题,系统掌握大数据面试中的核心话题与问题。
PySpark 过滤基础
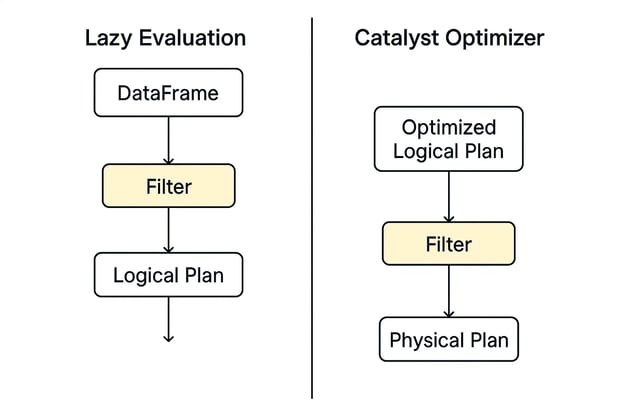
在 PySpark 中,过滤运行于其基于 Apache Spark 的分布式执行模型之上。当您应用过滤(例如使用 .filter() 或 .where())时,PySpark 并不会立刻扫描数据,而是构建一个逻辑查询计划,描述您希望执行的转换。
两个核心概念会显著影响 PySpark 的过滤效率:
惰性求值
PySpark 不会立即执行过滤命令;它会构建逻辑查询计划,并将执行推迟到明确触发为止。这种模型使 PySpark 能够在数据管道中更灵活地优化操作。
Catalyst 优化器
Spark 中的这一优化引擎会评估逻辑计划(包括过滤),并自动找出执行它们的最快、最高效方式。
当开始执行时,经过过滤的数据会在各个工作节点上并行处理(使用 RDD 或 DataFrame)。每个分区独立应用过滤,使其对大型数据集具备良好的可扩展性。
您可以在我们的 PySpark 速查表:Python 下的 Spark 教程中了解更多关于 RDD 的信息。
PySpark 过滤核心语法
基于条件过滤数据十分直观。您可以使用列表达式或类 SQL 的字符串来提供条件。
1. 列表达式
使用 DataFrame 的列对象和运算符来定义条件:
filtered_data = df.filter(df.age > 25)技术支持
2. 类 SQL 字符串
将条件写为 SQL 风格的字符串:
filtered_data_2 = df.filter("age > 25")技术支持
或者,您也可以以相同方式使用 where() 函数:
filtered_data_3 = df.where(df.age > 25)
filtered_data_4 = df.where("age > 25")技术支持
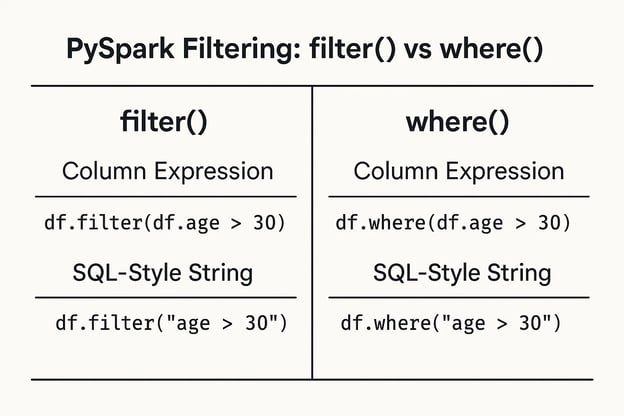
以上写法都有效且产生相同结果。选择哪种通常取决于个人偏好,或在您的具体语境中哪种风格更易读。
想进一步了解在 PySpark 中使用 SQL 语法,请查看我们的 Python 中的 Spark SQL 入门 课程。
PySpark 过滤技巧与应用
接下来我们来探索多种过滤方法及其实际用例。
关系过滤
您可以使用关系运算符(如大于 >、小于 <、等于 == 等)来基于数值或分类型阈值筛选数据:
greater_than_df = df.filter(df.salary > 50000)
category_match_df = df.filter(df.country == 'France')技术支持
逻辑过滤
要将多个条件组合到一个过滤中,可以使用逻辑运算符 AND &、OR | 和 NOT ~ 来为复杂需求创建简洁表达式:
combined_df = df.filter((df.age > 25) & (df.city == 'New York'))技术支持
高级过滤函数
PySpark 提供了用于特定场景的高级函数。我们来看看其中一些。
成员测试: 使用 isin 从预定义集合中过滤值:
selected_countries_df = df.filter(df.country.isin('Japan', 'Brazil', 'India'))技术支持
模式匹配: 使用 like 进行简单匹配,使用 rlike 进行正则匹配:
name_filter_df = df.filter(df.name.like('A%'))
regex_filter_df = df.filter(df.name.rlike('^[A-Z][a-z]+技术支持
范围过滤: 使用便捷方法 between 进行过滤:
range_df = df.filter(df.age.between(25, 35))技术支持
空值检查:通过显式检查空值来优雅地处理缺失值:
valid_email_df = df.filter(df.email.isNotNull())技术支持
过滤复杂数据类型
组织中常常使用嵌套或结构化数据。PySpark 过滤可处理嵌套字段和数组。对于结构化数据(struct),可以轻松过滤嵌套字段:
city_df = df.filter(df.address.city == 'Boston')技术支持
对于以数组形式存储的数据,可以使用内置函数 array_contains:
from pyspark.sql.functions import array_contains

skill_df = df.filter(array_contains(df.skills, 'Python'))技术支持
提升 PySpark 过滤效率的优化技术
本节将介绍增强 PySpark 过滤操作性能的策略。
谓词下推
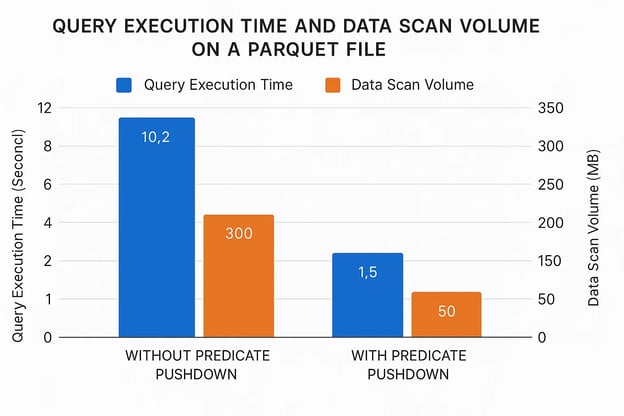
谓词下推是将过滤条件尽可能贴近数据存储层。这意味着 PySpark 在初始阶段读取更少数据,从而提升性能。
例如:
df = spark.read.parquet("s3://your-bucket/sales_data/")
filtered_df = df.filter(df.product_category == "Electronics")
filtered_df.explain(True)技术支持
在上述示例中,我们在常规列上应用过滤。通常,Spark 会先加载整个数据集再在内存中过滤,但由于 Parquet 支持谓词下推,Spark 可以将过滤条件直接传递给 Parquet 读取器。
Spark 不再读取所有行并逐行检查 product_category,而是只读取 product_category = 'Electronics' 的行。这节省了磁盘 I/O 和内存,加快处理速度。
explain 会打印物理查询计划,准确展示 Spark 在执行期间的计划动作。
如果应用了谓词下推,您会看到类似如下内容:
PushedFilters: [EqualTo(product_category,Electronics)]技术支持
这表明 Spark 将过滤下推到了文件扫描层,而不是在加载数据后再应用。
谓词下推是 Spark 工具箱中最强大的优化之一,它可以:
- 减少从磁盘读取的数据量。
- 加速查询执行。
- 降低内存占用与网络 I/O。
通过清晰地编写过滤条件,并将数据存储为 Parquet 等格式,您可以让 Spark 在底层自动优化执行。
在 PySpark 中进行连接(join)时,性能优化同样关键。通过我们的 PySpark 连接:优化大数据连接性能教程,学习如何优化连接、减少洗牌、处理数据倾斜,并在大数据管道与机器学习工作流中提升性能。
分区裁剪
当数据按相关字段(例如日期)进行分区时,PySpark 可以避免加载不必要的分区。有效的分区裁剪能够显著减少数据扫描量与执行时间。
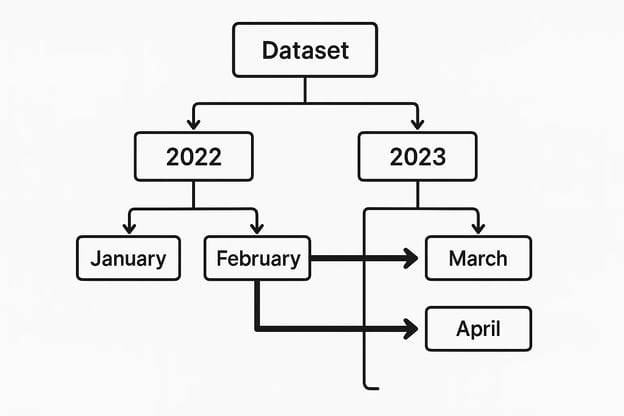
假设我们有一个按 year 和 month 分区的 Parquet 数据集,存储在 s3://your-bucket/events_data/。
每个分区类似如下:
events_data/year=2023/month=01/
events_data/year=2023/month=02/

...

events_data/year=2024/month=01/技术支持
在 PySpark 中,分区裁剪的示例如下:
df = spark.read.parquet("s3://your-bucket/events_data/")
filtered_df = df.filter((df.year == 2023) & (df.month == 6))
filtered_df.explain(True)技术支持
year 和 month 是分区列,使 Spark 的 Catalyst 优化器能够裁剪所有不相关的分区。
缓存与持久化
在分析工作流中,过滤后的结果经常会被多次使用。通过缓存将过滤结果临时存入内存可避免重复计算,但应谨慎使用以节约资源。
recent_users_df = df.filter(df.registration_date >= '2022-01-01')

recent_users_df.cache()技术支持
高级过滤策略与用例
现在我们来探讨一些需要应用高级过滤技术的复杂场景。
基于时间的过滤
在处理时间序列数据时,经常需要精确的时间过滤。要在特定时间范围内过滤数据非常直接:
time_df = df.filter((df.date >= '2023-08-01') & (df.date < '2023-09-01'))技术支持
上述条件会选出 2023 年 8 月的所有记录。该条件同时适用于 DateType 和 TimestampType 列。
对于更深入的时间序列分析(如计算滚动指标或识别趋势),可以将时间过滤与窗口函数结合使用。例如,您可以先过滤一个日期范围,然后应用移动平均或在每天内对事件进行排序:
from pyspark.sql.window import Window
from pyspark.sql.functions import avg
window_spec = Window.partitionBy("date").orderBy("timestamp").rowsBetween(-2, 0)
df_filtered = df.filter((df.date >= '2023-08-01') & (df.date < '2023-09-01'))
df_with_avg = df_filtered.withColumn("rolling_avg", avg("value").over(window_spec))技术支持
该示例按时间戳排序,在每天内计算 3 行窗口的滚动平均。将时间过滤与窗口函数结合,可对基于时间的分析实现精细控制。
流式数据中的过滤
对实时数据流进行过滤具有独特挑战。与批处理不同,数据是无界且持续到达的。这要求在数据到达时即时应用过滤,并谨慎处理延迟到达的事件以确保结果准确。
PySpark 的 Structured Streaming 提供了直观工具,可高效过滤流式数据并管理时间相关问题。您可以像对静态 DataFrame 一样应用过滤,同时通过水位线(watermark)控制在最终确定结果前系统等待迟到数据的时间。
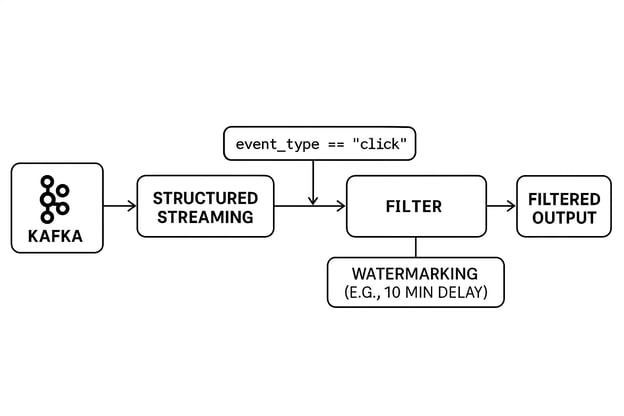
示例如下:
from pyspark.sql import SparkSession
from pyspark.sql.functions import col
from pyspark.sql.types import StructType, StringType, TimestampType
spark = SparkSession.builder.appName("RealTimeFiltering").getOrCreate()
schema = StructType() \
.add("user_id", StringType()) \
.add("event_type", StringType()) \
.add("event_time", TimestampType())
streaming_df = spark.readStream \
.format("kafka") \
.option("kafka.bootstrap.servers", "localhost:9092") \
.option("subscribe", "user_events") \
.load() \
.selectExpr("CAST(value AS STRING) as json") \
.selectExpr("from_json(json, 'user_id STRING, event_type STRING, event_time TIMESTAMP') as data") \
.select("data.*")
filtered_df = streaming_df.filter(col("event_type") == "click")
filtered_with_watermark = filtered_df \
.withWatermark("event_time", "10 minutes")
query = filtered_with_watermark.writeStream \
.outputMode("append") \
.format("console") \
.start()
query.awaitTermination()技术支持
在该示例中:
- 实时过滤通过
.filter(col("event_type") == "click") 完成。
- Structured Streaming 持续处理来自 Kafka 的数据。
- 水位线
(withWatermark(...)) 确保在时间窗口内(本例为 10 分钟)处理延迟到达的事件。
将实时过滤与水位线结合,即使在网络延迟或事件不规律的情况下,也能构建可靠的流式应用。
机器学习数据准备
在机器学习管道中,有效的过滤在预处理阶段尤为关键。它不仅用于去除噪声,还用于选择与模型训练最相关的特征。过滤有助于消除离群值、丢弃缺失或无效记录,并仅保留能提供有意义信号的属性。
这种“两步走”的方法——清洗数据与筛选关键特征——能显著提升模型的性能与可靠性,详见我们的 使用 PySpark 清洗数据 课程。否则,模型可能会被不相关的输入所干扰,或被劣质数据所扭曲。
我们的 使用 PySpark 处理大数据 课程对 PySpark 中的机器学习有更详细的介绍。
最佳实践与常见挑战
本节将探讨在使用 PySpark 过滤数据时的最佳实践与常见挑战。
性能调优清单
以下是一些提升过滤效率的实用建议:
1. 尽可能在处理早期进行过滤。
2. 限制所选列的数量以减少数据洗牌。
3. 优先使用 PySpark 的内置过滤函数,而非自定义 UDF(用户自定义函数)。
常见陷阱
请避免以下常见问题:
1. 复杂或不必要嵌套的过滤条件会损害优化器性能
过于复杂的过滤表达式会阻碍 Spark 的 Catalyst 优化器。例如,串联大量 OR 条件或深度嵌套的逻辑语句会使逻辑计划复杂化,导致次优执行。在涉及多个相等性检查的场景中,考虑使用 isin(),或与较小的 DataFrame 执行连接以利用广播连接,这对大型数据集更高效。
2. 过度缓存且使用不当可能导致内存问题
虽然缓存有利于复用 DataFrame,但不加选择地缓存会耗尽集群内存。在未评估复用价值的情况下缓存大型或大量 DataFrame,可能导致内存溢出错误。务必仅缓存会被多次复用的 DataFrame,并在不再需要时及时取消持久化。
3. 忽视数据分布倾斜会降低过滤速度
数据倾斜指某些键对应的数据量不成比例地巨大,可能造成性能瓶颈。对倾斜键执行连接或聚合会导致任务执行时间不均。可以采用加盐(为键添加随机前缀)、自定义分区,或使用 Spark 的自适应查询执行(AQE)等技术来缓解这些问题。
结论
在 PySpark 中,恰当的过滤对高效数据处理至关重要。它能简化分析工作流、节省计算资源,并让后续分析结果更为清晰。结合 PySpark 简洁而强大的过滤方法,与谓词下推、分区裁剪和选择性缓存等优化策略,能显著增强您的数据工程实践。持续应用这些技术,可确保数据管道稳健且易维护。
如需进一步探索 PySpark,请查看我们的 Spark 深度课程,包括:


过滤是 PySpark 中的基础操作,对于快速细化大型数据集、聚焦相关信息至关重要。有效使用 PySpark 过滤可以提升中级数据工程师、数据科学家和开发者在大数据处理中的工作流效率。
本文将介绍 PySpark 过滤的基础与高级技巧,给出提升性能的优化策略,并涵盖适用于真实场景的实用用例。
本教程默认您具备一定的 PySpark 基础,不过您也可以在我们的 PySpark 入门教程 中了解 PySpark 是什么以及如何使用。
什么是 PySpark 过滤操作?
正如我们的 2025 年从零学习 PySpark 指南中提到的,PySpark 以其易用性和高效性而广泛应用于数据科学。它通过内置函数如
filter()和where()提供了高效过滤数据集的简便方式。这些函数帮助数据专业人士从 DataFrame 中筛选满足特定条件的行。过滤在数据预处理、分析与管道优化中至关重要。它允许您在早期就排除无关或错误记录,从而节省时间、降低成本,并改善后续分析或建模任务。
尽管使用起来简单,但在分布式环境中应用过滤可能会带来挑战,例如性能瓶颈、低效或复杂的过滤条件,以及对缺失或不完整数据处理不当。
理解 Spark 过滤对于在数据工程面试中脱颖而出至关重要。
使用我们的 30+ 大数据面试题精选教程,从数据存储、分布式计算等基础概念到机器学习与安全等高级主题,系统掌握大数据面试中的核心话题与问题。
PySpark 过滤基础
在 PySpark 中,过滤运行于其基于 Apache Spark 的分布式执行模型之上。当您应用过滤(例如使用
.filter()或.where())时,PySpark 并不会立刻扫描数据,而是构建一个逻辑查询计划,描述您希望执行的转换。两个核心概念会显著影响 PySpark 的过滤效率:
惰性求值
PySpark 不会立即执行过滤命令;它会构建逻辑查询计划,并将执行推迟到明确触发为止。这种模型使 PySpark 能够在数据管道中更灵活地优化操作。
Catalyst 优化器
Spark 中的这一优化引擎会评估逻辑计划(包括过滤),并自动找出执行它们的最快、最高效方式。
当开始执行时,经过过滤的数据会在各个工作节点上并行处理(使用 RDD 或 DataFrame)。每个分区独立应用过滤,使其对大型数据集具备良好的可扩展性。
您可以在我们的 PySpark 速查表:Python 下的 Spark 教程中了解更多关于 RDD 的信息。
PySpark 过滤核心语法
基于条件过滤数据十分直观。您可以使用列表达式或类 SQL 的字符串来提供条件。
1. 列表达式
使用 DataFrame 的列对象和运算符来定义条件:
2. 类 SQL 字符串
将条件写为 SQL 风格的字符串:
或者,您也可以以相同方式使用
where()函数:以上写法都有效且产生相同结果。选择哪种通常取决于个人偏好,或在您的具体语境中哪种风格更易读。
想进一步了解在 PySpark 中使用 SQL 语法,请查看我们的 Python 中的 Spark SQL 入门 课程。
PySpark 过滤技巧与应用
接下来我们来探索多种过滤方法及其实际用例。
关系过滤
您可以使用关系运算符(如大于
>、小于<、等于==等)来基于数值或分类型阈值筛选数据:逻辑过滤
要将多个条件组合到一个过滤中,可以使用逻辑运算符 AND
&、OR|和 NOT~来为复杂需求创建简洁表达式:高级过滤函数
PySpark 提供了用于特定场景的高级函数。我们来看看其中一些。
成员测试: 使用
isin从预定义集合中过滤值:模式匹配: 使用
like进行简单匹配,使用rlike进行正则匹配:范围过滤: 使用便捷方法
between进行过滤:空值检查:通过显式检查空值来优雅地处理缺失值:
过滤复杂数据类型
组织中常常使用嵌套或结构化数据。PySpark 过滤可处理嵌套字段和数组。对于结构化数据(struct),可以轻松过滤嵌套字段:
对于以数组形式存储的数据,可以使用内置函数
array_contains:提升 PySpark 过滤效率的优化技术
本节将介绍增强 PySpark 过滤操作性能的策略。
谓词下推
谓词下推是将过滤条件尽可能贴近数据存储层。这意味着 PySpark 在初始阶段读取更少数据,从而提升性能。
例如:
在上述示例中,我们在常规列上应用过滤。通常,Spark 会先加载整个数据集再在内存中过滤,但由于 Parquet 支持谓词下推,Spark 可以将过滤条件直接传递给 Parquet 读取器。
Spark 不再读取所有行并逐行检查
product_category,而是只读取product_category = 'Electronics'的行。这节省了磁盘 I/O 和内存,加快处理速度。explain会打印物理查询计划,准确展示 Spark 在执行期间的计划动作。如果应用了谓词下推,您会看到类似如下内容:
这表明 Spark 将过滤下推到了文件扫描层,而不是在加载数据后再应用。
谓词下推是 Spark 工具箱中最强大的优化之一,它可以:
通过清晰地编写过滤条件,并将数据存储为 Parquet 等格式,您可以让 Spark 在底层自动优化执行。
在 PySpark 中进行连接(join)时,性能优化同样关键。通过我们的 PySpark 连接:优化大数据连接性能教程,学习如何优化连接、减少洗牌、处理数据倾斜,并在大数据管道与机器学习工作流中提升性能。
分区裁剪
当数据按相关字段(例如日期)进行分区时,PySpark 可以避免加载不必要的分区。有效的分区裁剪能够显著减少数据扫描量与执行时间。
假设我们有一个按
year和month分区的 Parquet 数据集,存储在s3://your-bucket/events_data/。每个分区类似如下:
在 PySpark 中,分区裁剪的示例如下:
year和month是分区列,使 Spark 的 Catalyst 优化器能够裁剪所有不相关的分区。缓存与持久化
在分析工作流中,过滤后的结果经常会被多次使用。通过缓存将过滤结果临时存入内存可避免重复计算,但应谨慎使用以节约资源。
高级过滤策略与用例
现在我们来探讨一些需要应用高级过滤技术的复杂场景。
基于时间的过滤
在处理时间序列数据时,经常需要精确的时间过滤。要在特定时间范围内过滤数据非常直接:
上述条件会选出 2023 年 8 月的所有记录。该条件同时适用于
DateType和TimestampType列。对于更深入的时间序列分析(如计算滚动指标或识别趋势),可以将时间过滤与窗口函数结合使用。例如,您可以先过滤一个日期范围,然后应用移动平均或在每天内对事件进行排序:
该示例按时间戳排序,在每天内计算 3 行窗口的滚动平均。将时间过滤与窗口函数结合,可对基于时间的分析实现精细控制。
流式数据中的过滤
对实时数据流进行过滤具有独特挑战。与批处理不同,数据是无界且持续到达的。这要求在数据到达时即时应用过滤,并谨慎处理延迟到达的事件以确保结果准确。
PySpark 的 Structured Streaming 提供了直观工具,可高效过滤流式数据并管理时间相关问题。您可以像对静态 DataFrame 一样应用过滤,同时通过水位线(watermark)控制在最终确定结果前系统等待迟到数据的时间。
示例如下:
在该示例中:
.filter(col("event_type") == "click")完成。(withWatermark(...))确保在时间窗口内(本例为 10 分钟)处理延迟到达的事件。将实时过滤与水位线结合,即使在网络延迟或事件不规律的情况下,也能构建可靠的流式应用。
机器学习数据准备
在机器学习管道中,有效的过滤在预处理阶段尤为关键。它不仅用于去除噪声,还用于选择与模型训练最相关的特征。过滤有助于消除离群值、丢弃缺失或无效记录,并仅保留能提供有意义信号的属性。
这种“两步走”的方法——清洗数据与筛选关键特征——能显著提升模型的性能与可靠性,详见我们的 使用 PySpark 清洗数据 课程。否则,模型可能会被不相关的输入所干扰,或被劣质数据所扭曲。
我们的 使用 PySpark 处理大数据 课程对 PySpark 中的机器学习有更详细的介绍。
最佳实践与常见挑战
本节将探讨在使用 PySpark 过滤数据时的最佳实践与常见挑战。
性能调优清单
以下是一些提升过滤效率的实用建议:
1. 尽可能在处理早期进行过滤。
2. 限制所选列的数量以减少数据洗牌。
3. 优先使用 PySpark 的内置过滤函数,而非自定义 UDF(用户自定义函数)。
常见陷阱
请避免以下常见问题:
1. 复杂或不必要嵌套的过滤条件会损害优化器性能
过于复杂的过滤表达式会阻碍 Spark 的 Catalyst 优化器。例如,串联大量
OR条件或深度嵌套的逻辑语句会使逻辑计划复杂化,导致次优执行。在涉及多个相等性检查的场景中,考虑使用isin(),或与较小的 DataFrame 执行连接以利用广播连接,这对大型数据集更高效。2. 过度缓存且使用不当可能导致内存问题
虽然缓存有利于复用 DataFrame,但不加选择地缓存会耗尽集群内存。在未评估复用价值的情况下缓存大型或大量 DataFrame,可能导致内存溢出错误。务必仅缓存会被多次复用的 DataFrame,并在不再需要时及时取消持久化。
3. 忽视数据分布倾斜会降低过滤速度
数据倾斜指某些键对应的数据量不成比例地巨大,可能造成性能瓶颈。对倾斜键执行连接或聚合会导致任务执行时间不均。可以采用加盐(为键添加随机前缀)、自定义分区,或使用 Spark 的自适应查询执行(AQE)等技术来缓解这些问题。
结论
在 PySpark 中,恰当的过滤对高效数据处理至关重要。它能简化分析工作流、节省计算资源,并让后续分析结果更为清晰。结合 PySpark 简洁而强大的过滤方法,与谓词下推、分区裁剪和选择性缓存等优化策略,能显著增强您的数据工程实践。持续应用这些技术,可确保数据管道稳健且易维护。
如需进一步探索 PySpark,请查看我们的 Spark 深度课程,包括: