

什么是 PySpark?
PySpark 是 Apache Spark 的 Python API。您的 Python 代码描述所需的转换,而运行在 Java 虚拟机(JVM)上的 Spark 引擎会在集群中规划并执行它们。您无需编写 Scala 或 Java,即可获得 Spark 的分布式执行能力。
数据科学家使用 PySpark 来清洗与聚合大型数据集,数据工程师用它构建 ETL 流水线,二者都使用 pyspark.ml 在无法放入单机的数据上训练模型。如果您多数工作目前在 pandas 中完成,DataFrame API 会让您感到很熟悉。
何时用 PySpark 而不是 pandas
当数据超出单机规模时,PySpark 的优势才会显现;在此之下,pandas 通常更快,因为它没有 JVM 启动与任务调度的开销。
| 特性 | pandas | PySpark |
|---|---|---|
| 数据规模 | 受限于单机内存 | 受限于集群的总内存与磁盘 |
| 执行方式 | 立即执行,主要为单核 | 惰性执行,可在多核或多机并行 |
| 启动开销 | 无 | 启动 JVM 与 SparkSession 需数秒 |
| 流式数据 | 不支持 | Structured Streaming |
| 机器学习 | scikit-learn 生态 | pyspark.ml(分布式) |
| 容错性 | 无;崩溃会丢失工作进度 | 丢失的分区可根据血缘重算 |
我的经验法则:如果数据能在内存中游刃有余地放下,且作业在一台笔记本上即可完成,就继续用 pandas。当您开始与内存错误抗争,或该作业最终需要在集群或 Databricks 等平台上运行时,切换到 PySpark。
如何安装 PySpark
PySpark 可通过 PyPI 用一条 pip 命令安装,并打包了 Spark 运行时,因此本地开发无需单独下载 Spark 或 Hadoop。在运行前,请检查两个先决条件。
先决条件
根据官方安装指南,PySpark 4.3 需要:
- Python 3.11 或更高版本。PySpark 4.3 放弃了对 Python 3.10 的支持;如果需要升级,请参阅我们的 Python 环境设置指南。
- Java 17 或更高版本(Spark 4.3 可运行在 Java 17、21 与 25 上),并将
JAVA_HOME环境变量指向该安装路径。我们的 Java 安装指南涵盖各操作系统。
可在终端中检查二者:
python3 --version # Python 3.11 或更高
java -version # openjdk version "17" 或更高如果您在 DataLab 或 Databricks 中工作,PySpark 已预装,可直接跳到数据集部分。
使用 pip 安装 PySpark
我建议使用虚拟环境,避免 PySpark 的依赖与其他项目冲突:
python3 -m venv pyspark-env
source pyspark-env/bin/activate
pip install "pyspark[sql]" "pandas<3"
python3 -c "import pyspark; print(pyspark.__version__)"4.3.0在 Windows 上,使用 python 代替 python3,并通过 pyspark-env\Scripts\activate 激活环境。[sql] 额外项会添加 pandas、PyArrow 与 NumPy,供 PySpark 在 toPandas() 与 pandas UDF 中使用。我固定 pandas<3,因为 PySpark 4.3 会提示其尚未完全支持 pandas 3.0。
两类错误占据了大多数首次运行失败的原因:
JAVA_GATEWAY_EXITED或 "Unable to locate a Java Runtime":缺少 Java 或未设置JAVA_HOME。PYTHON_VERSION_MISMATCH:Spark 的工作进程拾取了与您脚本不同的 Python。将PYSPARK_PYTHON设置为您环境中的解释器,例如export PYSPARK_PYTHON=$(which python)。
有关不同操作系统(含 Windows)的步骤,请参阅我们的 PySpark 安装指南。
获取数据集
示例使用的是一个来自英国线上零售商的 541,909 条交易的电商数据集,覆盖 2010 年 12 月至 2011 年 12 月。每行代表一张发票中的一条商品明细,共 8 列:
InvoiceNo:发票号(以 "C" 开头表示取消)StockCode与Description:产品编码与名称Quantity与UnitPrice:购买数量与单价(英镑)InvoiceDate:购买的日期与时间CustomerID:客户标识(部分行缺失)Country:客户所在国家
您可以从 DataLab 数据集页面下载为 datacamp_ecommerce.csv。该数据来自 UCI 机器学习库的 Online Retail 数据集,因此也可以从公开源重建同一文件(需要 pip install openpyxl):
import io
import urllib.request
import zipfile
import pandas as pd
url = "https://archive.ics.uci.edu/static/public/352/online+retail.zip"
with urllib.request.urlopen(url) as response:
archive = zipfile.ZipFile(io.BytesIO(response.read()))
retail = pd.read_excel(
archive.open("Online Retail.xlsx"),
dtype={"InvoiceNo": str, "StockCode": str, "CustomerID": "Int64"},
)
# Match the DataLab file's date format, e.g. 12/1/10 8:26
retail["InvoiceDate"] = retail["InvoiceDate"].map(
lambda ts: f"{ts.month}/{ts.day}/{ts:%y} {ts.hour}:{ts:%M}"
)
retail.to_csv("datacamp_ecommerce.csv", index=False)读取 23 MB 的 Excel 文件大约需要一分钟。将 CSV 保存在您将运行其余代码的文件夹中。
创建 SparkSession
SparkSession 是每个 PySpark 程序的入口:它将您的 Python 代码与 Spark 引擎连接起来,并创建 DataFrame。通常每个应用创建一个,通过构建器模式:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("PySparkTutorial").getOrCreate()
print(spark.version)4.3.0getOrCreate() 会在已有会话时返回该会话,因此在笔记本中重复调用也是安全的。从普通 Python 进程启动时,Spark 以本地模式(local[*])运行,使用您机器上的每个 CPU 内核作为工作线程,并在 http://localhost:4040 提供 Spark UI 以观察作业。完成后,调用 spark.stop() 释放资源。
加载电商数据集
会话启动后,我们就可以将 CSV 读取为 DataFrame。我传入显式 schema,而不是使用 inferSchema=True,后者会额外扫描一遍整个文件来猜测列类型:
import pyspark.sql.functions as F
schema = """
InvoiceNo STRING, StockCode STRING, Description STRING, Quantity INT,
InvoiceDate STRING, UnitPrice DOUBLE, CustomerID INT, Country STRING
"""
orders = spark.read.csv(
"datacamp_ecommerce.csv", header=True, schema=schema, escape='"'
)
orders = orders.withColumn("InvoiceDate", F.to_timestamp("InvoiceDate", "M/d/yy H:mm"))
orders.printSchema()root
|-- InvoiceNo: string (nullable = true)
|-- StockCode: string (nullable = true)
|-- Description: string (nullable = true)
|-- Quantity: integer (nullable = true)
|-- InvoiceDate: timestamp (nullable = true)
|-- UnitPrice: double (nullable = true)
|-- CustomerID: integer (nullable = true)
|-- Country: string (nullable = true)以上代码片段有两个要点:
escape='"'处理包含双引号的商品名,例如RECORD FRAME 7"" SINGLE SIZE。Spark 的默认转义字符是反斜杠。- 日期模式
M/d/yy H:mm匹配如12/1/10 8:26这样的值。自 Spark 4.0 起,默认启用 ANSI SQL 模式,因此to_timestamp()在遇到与模式不匹配的值时会抛出CANNOT_PARSE_TIMESTAMP错误。如果您更希望坏行得到NULL,可使用F.try_to_timestamp()。
查看前几行并计数:
orders.show(5, truncate=False)
print(orders.count())+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|InvoiceNo|StockCode|Description |Quantity|InvoiceDate |UnitPrice|CustomerID|Country |
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
|536365 |85123A |WHITE HANGING HEART T-LIGHT HOLDER |6 |2010-12-01 08:26:00|2.55 |17850 |United Kingdom|
|536365 |71053 |WHITE METAL LANTERN |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84406B |CREAM CUPID HEARTS COAT HANGER |8 |2010-12-01 08:26:00|2.75 |17850 |United Kingdom|
|536365 |84029G |KNITTED UNION FLAG HOT WATER BOTTLE|6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
|536365 |84029E |RED WOOLLY HOTTIE WHITE HEART. |6 |2010-12-01 08:26:00|3.39 |17850 |United Kingdom|
+---------+---------+-----------------------------------+--------+-------------------+---------+----------+--------------+
only showing top 5 rows
541909关于更多读取选项,如多文件、分隔符与损坏记录,请参阅我们的 PySpark 读取 CSV 教程。
RDD 与 DataFrame
RDD 与 DataFrame 是 PySpark 表示分布式数据的两种方式,而对于几乎所有新代码,DataFrame 是正确选择。
| 抽象 | 是什么 | 适用场景 |
|---|---|---|
| RDD(弹性分布式数据集) | 低层级、不可变的任意 Python 对象集合,按分区切分 | 非结构化数据,或当您需要对分区进行精细控制时 |
| DataFrame | 具有命名与类型化列的分布式表,类似 pandas DataFrame | 分析、SQL 查询、ETL 与机器学习 |
下面是同一聚合(每个国家的总数量)用两种方式编写:
sales = [("United Kingdom", 6), ("France", 24), ("United Kingdom", 8)]
# RDD:使用 Python 函数编写逻辑
rdd = spark.sparkContext.parallelize(sales)
print(rdd.reduceByKey(lambda a, b: a + b).collect())
# DataFrame:声明想要的结果,Spark 规划计算方式
sales_df = spark.createDataFrame(sales, ["country", "quantity"])
sales_df.groupBy("country").sum("quantity").show()[('France', 24), ('United Kingdom', 14)]
+--------------+-------------+
| country|sum(quantity)|
+--------------+-------------+
|United Kingdom| 14|
| France| 24|
+--------------+-------------+RDD 版本会在 Python 工作进程中运行您的 lambda。DataFrame 版本会经过 Spark 的 Catalyst 优化器,它会将查询改写为高效的计划并在 JVM 内执行,因此通常无需调优就更快。本文其余部分将使用 DataFrame。
惰性求值:转换与动作
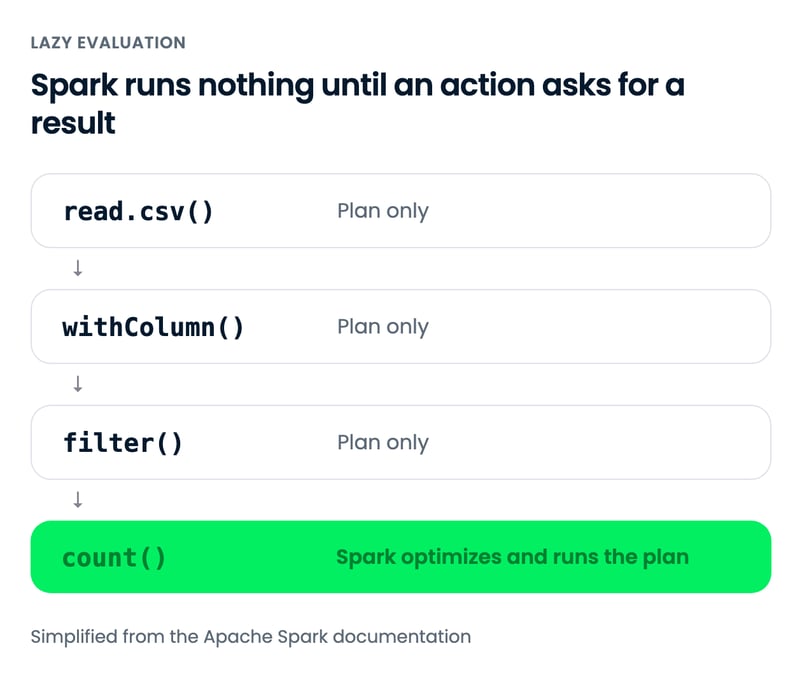
惰性求值意味着 Spark 在您调用转换时并不会执行;它会将步骤记录到计划中,直到某个动作请求结果时才运行整个计划。
| 转换(Transformations) | 动作(Actions) | |
|---|---|---|
| 作用 | 描述一个新的 DataFrame | 返回结果或写出数据 |
| 何时运行 | 自身不会运行 | 立即运行,触发所有待处理的转换 |
| 示例 | select()、filter()、withColumn()、groupBy()、join() | show()、count()、collect()、toPandas()、write |
下面的过滤会立即返回,即使数据集有超过 50 万行,因为此时尚未读取任何内容。真正启动作业的是 count():
uk_orders = orders.filter(F.col("Country") == "United Kingdom") # 转换:尚未启动作业
print(uk_orders.count()) # 动作:Spark 现在开始读文件495478等到动作再执行让 Spark 能一次性优化整条链。explain() 会打印它选择的物理计划(此处做了裁剪):
uk_orders.explain()== Physical Plan ==
*(1) Project [InvoiceNo#0, StockCode#1, ...]
+- *(1) Filter (isnotnull(Country#7) AND (Country#7 = United Kingdom))
+- FileScan csv [...] PushedFilters: [IsNotNull(Country), EqualTo(Country,United Kingdom)], ...PushedFilters 表示 Spark 将国家过滤下推到文件扫描阶段,因此在读取 CSV 时就会丢弃其他国家的行。一个实际影响是:转换中的数据错误(例如在 ANSI 模式下日期解析失败)只会在后续某个动作运行时才暴露,通常会相隔几行代码。
常见 DataFrame 操作
多数 PySpark 代码由五个 DataFrame 操作链式组成:select()、filter()、withColumn()、groupBy() 与 join()。每个操作都会返回一个新的 DataFrame,因此可以任意顺序串联。
使用 select() 选择列
select() 返回仅包含所命名列的 DataFrame:
orders.select("InvoiceNo", "Description", "Quantity", "UnitPrice").show(3, truncate=False)+---------+----------------------------------+--------+---------+
|InvoiceNo|Description |Quantity|UnitPrice|
+---------+----------------------------------+--------+---------+
|536365 |WHITE HANGING HEART T-LIGHT HOLDER|6 |2.55 |
|536365 |WHITE METAL LANTERN |6 |3.39 |
|536365 |CREAM CUPID HEARTS COAT HANGER |8 |2.75 |
+---------+----------------------------------+--------+---------+
only showing top 3 rows使用 filter() 过滤行
filter() 保留满足条件的行。该数据集混合了销售与取消(发票号以 "C" 开头)、负数量以及缺少客户的行,因此我只保留有效销售:
sales_only = orders.filter(
(F.col("Quantity") > 0)
& (F.col("UnitPrice") > 0)
& F.col("CustomerID").isNotNull()
& ~F.col("InvoiceNo").startswith("C")
)
print(sales_only.count())397884用 &(与)、|(或)与 ~(非)组合条件,并为每个条件加括号,因为 Python 的运算符优先级会让 & 先于 > 计算。更多模式请参阅我们的 PySpark 过滤教程。
使用 withColumn() 添加列
withColumn() 会添加一列,或替换同名列。下面计算每条明细的金额:
sales_only = sales_only.withColumn("TotalAmount", F.round(F.col("Quantity") * F.col("UnitPrice"), 2))
sales_only.select("InvoiceNo", "Quantity", "UnitPrice", "TotalAmount").show(3)+---------+--------+---------+-----------+
|InvoiceNo|Quantity|UnitPrice|TotalAmount|
+---------+--------+---------+-----------+
| 536365| 6| 2.55| 15.3|
| 536365| 6| 3.39| 20.34|
| 536365| 8| 2.75| 22.0|
+---------+--------+---------+-----------+
only showing top 3 rows关于用 F.when() 创建条件列,请参阅我们的 PySpark withColumn() 教程。
用 groupBy() 与 agg() 聚合
groupBy() 按一个或多个列分组,agg() 则对每个组计算一个或多个汇总。哪些国家带来最多收入?
country_revenue = (
sales_only.groupBy("Country")
.agg(
F.count_distinct("CustomerID").alias("customers"),
F.round(F.sum("TotalAmount"), 2).alias("revenue"),
)
.orderBy(F.desc("revenue"))
)
country_revenue.show(5)+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+
only showing top 5 rows如预期,英国(UK)占据主导。更有意思的是荷兰与爱尔兰(标注为 EIRE):9 与 3 位客户的消费超过了德国的 94 位,暗示批发客户的存在。
注意我将函数模块以 F 导入,而非使用 from pyspark.sql.functions import *,后者会遮蔽 Python 内置的 sum()、min() 与 max()。自 PySpark 4.0 起,通配导入也不再暴露旧的驼峰命名 countDistinct。
更多聚合内容请参阅我们的 PySpark groupBy 教程。
使用 join() 连接 DataFrame
join() 基于共享键合并两个 DataFrame。为了为每个国家标注区域,我将连接一个故意漏掉 Australia 的小型对照表:
regions = spark.createDataFrame(
[("United Kingdom", "UK"), ("Netherlands", "EU"), ("EIRE", "EU"),
("Germany", "EU"), ("France", "EU")],
["Country", "region"],
)
country_revenue.join(regions, on="Country", how="left").orderBy(F.desc("revenue")).show(6)+--------------+---------+----------+------+
| Country|customers| revenue|region|
+--------------+---------+----------+------+
|United Kingdom| 3920|7308391.55| UK|
| Netherlands| 9| 285446.34| EU|
| EIRE| 3| 265545.9| EU|
| Germany| 94| 228867.14| EU|
| France| 87| 209024.05| EU|
| Australia| 9| 138521.31| NULL|
+--------------+---------+----------+------+
only showing top 6 rows左连接会保留左侧 DataFrame 的所有行,并用 NULL 填充缺失匹配,因此 Australia 仍在结果中。内连接(how="inner",默认)则会将其丢弃。我们的 PySpark 连接教程比较了所有连接类型及其性能。
PySpark 中的 Spark SQL
通过将 DataFrame 注册为临时视图,Spark SQL 允许您用标准 SQL 查询它。下面的查询复现了 groupBy 小节中的国家收入表:
sales_only.createOrReplaceTempView("sales")
spark.sql("""
SELECT Country,
COUNT(DISTINCT CustomerID) AS customers,
ROUND(SUM(TotalAmount), 2) AS revenue
FROM sales
GROUP BY Country
ORDER BY revenue DESC
LIMIT 5
""").show()+--------------+---------+----------+
| Country|customers| revenue|
+--------------+---------+----------+
|United Kingdom| 3920|7308391.55|
| Netherlands| 9| 285446.34|
| EIRE| 3| 265545.9|
| Germany| 94| 228867.14|
| France| 87| 209024.05|
+--------------+---------+----------+两种写法都会编译为相同的优化计划,因此没有谁更快。当我写较长的聚合且读者是分析师时,我更偏向 SQL;当我需要在查询前后配合 Python 逻辑(例如在循环中构建过滤条件)时,我会使用 DataFrame API。spark.sql() 返回的是 DataFrame,因此可以自由混用二者。
临时视图会在 SparkSession 停止时失效。
PySpark 机器学习:K-Means 示例
PySpark 的 pyspark.ml 模块基于 DataFrame 训练模型,而 Pipeline 则将特征处理与模型串联为一个可拟合与复用的对象。为演示这一点,我将基于最近一次购买、购买频次与消费金额(RFM)进行 K-Means 聚类,对零售商的客户进行细分,这是标准的营销细分方法:
- Recency(最近度):距离客户上次购买的天数
- Frequency(频次):不同发票的数量
- Monetary(金额):总消费金额
用 groupBy() 构建 RFM 特征
在清洗后的 sales_only DataFrame 上做一次 groupBy() 就能得到这三个特征。最近度以数据中最后一张发票的次日为基准计算:
snapshot = sales_only.agg(F.date_add(F.max("InvoiceDate"), 1)).first()[0]
rfm = sales_only.groupBy("CustomerID").agg(
F.datediff(F.lit(snapshot), F.max("InvoiceDate")).alias("recency"),
F.count_distinct("InvoiceNo").alias("frequency"),
F.round(F.sum("TotalAmount"), 2).alias("monetary"),
)
rfm.describe("recency", "frequency", "monetary").show()+-------+------------------+-----------------+------------------+
|summary| recency| frequency| monetary|
+-------+------------------+-----------------+------------------+
| count| 4338| 4338| 4338|
| mean| 93.05947441217151|4.272014753342554|2054.2664591977896|
| stddev|100.01226424171826|7.697997826095038| 8989.230441421178|
| min| 1| 1| 3.75|
| max| 374| 209| 280206.02|
+-------+------------------+-----------------+------------------+看看 monetary 列:平均约 £2,054,标准差是其四倍以上,最大值超过 £280,000。K-Means 使用欧氏距离,少数大额客户会主导聚类。先对各特征取对数能压缩这种长尾。
在 Pipeline 中缩放与聚类
该 Pipeline 包含 3 个阶段:VectorAssembler 将特征打包到 pyspark.ml 模型所需的单个向量列中,StandardScaler 将它们置于同一量纲,KMeans 进行聚类。我对 k = 2 到 6 进行拟合,并用轮廓系数打分,取值范围为 -1 到 1,越高表示簇分离越好:
from pyspark.ml import Pipeline
from pyspark.ml.clustering import KMeans
from pyspark.ml.evaluation import ClusteringEvaluator
from pyspark.ml.feature import StandardScaler, VectorAssembler
rfm_log = rfm.select(
"CustomerID",
"recency", "frequency", "monetary",
F.log1p("recency").alias("log_recency"),
F.log1p("frequency").alias("log_frequency"),
F.log1p("monetary").alias("log_monetary"),
).cache()
assembler = VectorAssembler(
inputCols=["log_recency", "log_frequency", "log_monetary"], outputCol="features_raw"
)
scaler = StandardScaler(
inputCol="features_raw", outputCol="features", withMean=True, withStd=True
)
evaluator = ClusteringEvaluator(featuresCol="features", metricName="silhouette")
for k in range(2, 7):
kmeans = KMeans(featuresCol="features", k=k, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
score = evaluator.evaluate(model.transform(rfm_log))
print(f"k={k} silhouette={score:.3f}")k=2 silhouette=0.624
k=3 silhouette=0.502
k=4 silhouette=0.502
k=5 silhouette=0.478
k=6 silhouette=0.470.cache() 将 rfm_log 保存在内存中,因为循环中的每次拟合与评估都会再次读取它;否则 Spark 会在每次拟合时从 CSV 重新计算 RFM 表。
选择 k 并解读细分
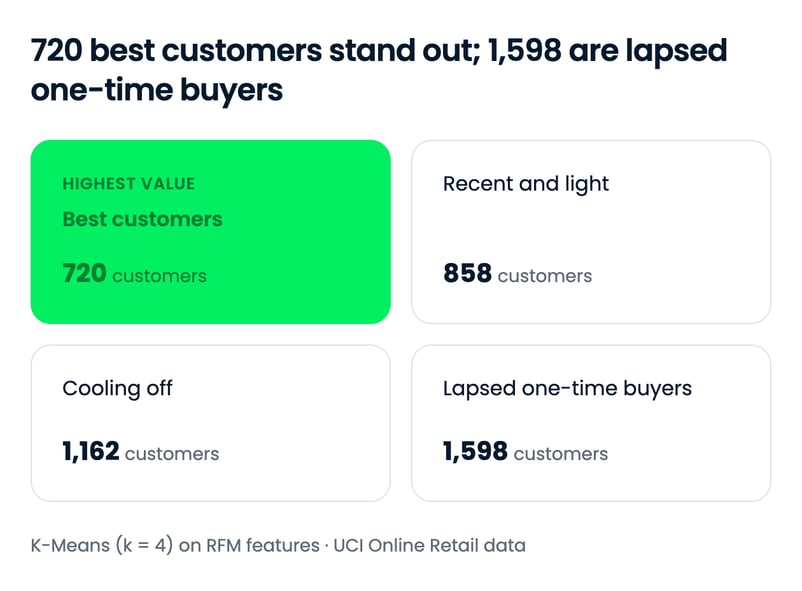
轮廓系数在 k = 2 时达到峰值,但 2 个细分主要是将活跃客户与流失客户分开,这对市场团队的可操作性较低。k = 4 与 k = 3 得分相同,但它将活跃客户进一步拆分为大额客户与新客户,因此我选择 k = 4,并对各簇做画像:
kmeans = KMeans(featuresCol="features", k=4, seed=42)
model = Pipeline(stages=[assembler, scaler, kmeans]).fit(rfm_log)
segments = model.transform(rfm_log)
(segments.groupBy("prediction")
.agg(
F.count("*").alias("customers"),
F.round(F.avg("recency"), 1).alias("avg_recency"),
F.round(F.avg("frequency"), 1).alias("avg_frequency"),
F.round(F.avg("monetary"), 1).alias("avg_monetary"),
)
.orderBy("prediction")
.show())+----------+---------+-----------+-------------+------------+
|prediction|customers|avg_recency|avg_frequency|avg_monetary|
+----------+---------+-----------+-------------+------------+
| 0| 1598| 181.2| 1.3| 326.2|
| 1| 720| 13.2| 13.7| 8072.7|
| 2| 1162| 77.1| 3.9| 1765.2|
| 3| 858| 17.4| 2.3| 613.7|
+----------+---------+-----------+-------------+------------+四个细分的解读很清晰:
- 簇 1,最佳客户(720):平均在近两周内有购买,约 14 笔订单,人均消费超过 £8,000。留存与忠诚度优惠应投放于此。
- 簇 3,近期但轻度(858):近三周内活跃,但仅约 2 笔订单。许多可能是值得培育到第 2、3 单的新客户。
- 簇 2,冷却中(1,162):中等消费,但距离上次购买约 11 周。挽回活动在这里成功概率最高。
- 簇 0,流失的一次性购买者(1,598):多为单笔订单,约 £326,约 6 个月前。体量最大、价值最低。
簇号只是任意标签,换一个随机种子可能会重新编号,因此在命名之前务必先画像。若想了解 K-Means 如何选择中心点,请参阅我们的 k-means 聚类入门;pyspark.ml API 参考列出了所有模型与转换器。我们的 Machine Learning with PySpark 课程涵盖分类、回归及基于 Pipeline 的模型调优。
结语
PySpark 的核心要点是:用 SparkSession 起步,几乎所有工作都用 DataFrame,转换是惰性的,只有在动作需要结果时才会运行,且每个查询既可用 Python 也可用 SQL 编写。本文所有内容都在笔记本本地模式下运行,同样的代码无需修改即可在集群上运行。
一个 541,909 行的文件并不需要集群,pandas 也能胜任。这是刻意为之,因为在可检查的数据上更容易养成处理大数据时重要的习惯(显式 schema、尽早过滤、缓存复用的数据、查看 explain())。
接下来,您可根据目标选择这些最佳路径:
- 用练习巩固 DataFrame API:Introduction to PySpark
- 处理凌乱的真实世界数据:Cleaning Data with PySpark
- 随手查语法:我们的 PySpark 速查表
- 准备求职面试:Top PySpark interview questions
如果您想更进一步,推荐我们的 Big Data with PySpark 学习路径,依次覆盖数据管理、特征工程、机器学习流水线与推荐系统。团队用户可选 DataCamp for Business 获取数据工程岗位的学习路径。
PySpark 常见问答
学习 PySpark 的先决条件是什么?
PySpark 4.3 需要 Python 3.11 或更高版本与 Java 17 或更高版本(Spark 4.3 可运行在 Java 17、21 与 25 上),并将 JAVA_HOME 指向您的 Java 安装路径。您应熟悉基础 Python;有 pandas DataFrame 经验更佳,因为 PySpark 的 DataFrame API 与其理念相近。您不需要具备分布式系统的先验经验。
PySpark 比 pandas 更快吗?
对于小数据,并不更快。pandas 在进程内运行且无启动开销,而 PySpark 需要数秒启动 JVM 并调度任务,因此当数据能舒适地放入内存时,pandas 通常更占优。一旦工作负载超出单机内存或 CPU,PySpark 就更快,因为它可在多核或集群节点之间并行处理分区。
PySpark 中的 RDD 与 DataFrame 有何区别?
RDD(弹性分布式数据集)是 PySpark 的低层结构:可分布的任意 Python 对象集合,您用自己的函数处理。DataFrame 则将数据组织为具名、类型化的列,类似 pandas DataFrame,Spark 的 Catalyst 优化器会将 DataFrame 查询转成高效的执行计划。新代码几乎都应使用 DataFrame,仅在处理非结构化数据或需要精细分区控制时使用 RDD。
如何在 Jupyter Notebook 中运行 PySpark?
安装 Java 17 或更高版本,然后在笔记本对应的环境中运行 pip install "pyspark[sql]"。在首个单元格中创建 SparkSession:
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("MyNotebook").getOrCreate()如果您希望跳过本地安装,DataLab 与 Databricks 笔记本已预装 PySpark。
何时应使用 PySpark 而不是 pandas?
当您的数据无法放入单机内存、作业需要在集群或 Databricks 等平台上运行,或当您在构建会超出笔记本规模的流水线时,请使用 PySpark。对于能放入内存的探索性分析,pandas 更简单且即开即用。在本地编写的 PySpark 代码可不加修改地在集群上运行,因此若规模扩张在所难免,起步就用 PySpark 是合理的。
PySpark 的惰性求值是什么?
惰性求值意味着在调用 filter() 或 withColumn() 等转换时,PySpark 并不会立即执行。它会将这些步骤记录到计划中,只有当某个动作(如 count()、show() 或 write)需要结果时才会运行该计划。等待执行让 Spark 能优化整条链,例如将过滤下推到文件扫描阶段。
如何在 PySpark 中运行 SQL 查询?
用 df.createOrReplaceTempView("sales") 将 DataFrame 注册为临时视图,然后通过 spark.sql("SELECT ... FROM sales") 查询。结果是常规 DataFrame,因此您可以自由混用 SQL 与 DataFrame 代码。二者会编译为同一优化计划,因此没有谁更快。
运行 PySpark 需要 Hadoop 吗?
不需要。pip install pyspark 已包含 Spark 运行时,可在本地模式下运行,无需 Hadoop。只有在从 HDFS 读取或在 YARN 集群上运行 Spark 时才需要 Hadoop 组件。
Natassha 是一名在数据科学与营销交汇处工作的数据顾问。她相信,明智地使用数据,能够为个人和组织带来巨大的增长。作为一名自学成才的数据从业者,Natassha 热衷于撰写文章,帮助有志于数据科学的人士进入该行业。她在个人博客以及外部平台发表的文章,平均每月获得 20 万次浏览。
PySpark 是 Apache Spark 的 Python API。您在 Python 中编写 DataFrame 代码或 SQL,Spark 会将工作拆分到笔记本电脑上的每个 CPU 内核,或集群中的每台机器上。当数据集不再适合在 pandas 中舒适处理,或者相同的作业稍后需要在集群上运行且不想重写代码时,我就会用它。
在本篇 PySpark 教程中,我将安装 PySpark 4.3,创建一个 SparkSession,并解释最容易让新手困惑的两个概念:RDD 与 DataFrame,以及惰性求值。随后我们将在一个包含 541,909 行的电商数据集上,动手完成日常高频操作(select、filter、groupBy、join 和 Spark SQL),最后使用
pyspark.mlPipeline API 构建一个 K-Means 客户细分模型。如果您希望在教程旁配合练习,我们的 Introduction to PySpark 课程覆盖了相同内容。若想要更长的学习规划,请参阅我们的指南 How to Learn PySpark From Scratch。
要点速览
pip install "pyspark[sql]"安装;PySpark 4.3 需要 Python 3.11+ 和 Java 17+。SparkSession开始,默认 API 是 DataFrame(而非 RDD)。count()或show()等动作之前不会真正执行。pyspark.mlPipeline 可将特征处理与模型(如 K-Means)串联为一个对象。什么是 Apache Spark?
Apache Spark 是一个开源的分布式数据处理引擎。它将数据集切分为分区,在集群中并行处理,并在步骤之间将中间结果保存在内存中,而非落盘。
这种内存优先的设计是 Spark 取代 Hadoop MapReduce 处理大多数批处理任务的主要原因(我们在 Hadoop vs Spark 中进行了比较)。Spark 源于 2009 年 UC Berkeley AMPLab,2014 年成为 Apache 顶级项目,并于 2026 年 10 月 30 日发布 4.3 版本。
一个引擎通过内置库覆盖多种工作负载:
pyspark.ml):分布式机器学习关于驱动程序、集群管理器与执行器如何分工的更详细说明,请参阅我们的 Apache Spark 架构指南。