PySpark 是 Apache Spark 的 Python API,旨在跨集群进行并行与分布式数据处理。为您的需求选择正确的连接(join)操作会影响作业速度、资源消耗以及整体成败。
处理大型数据集往往意味着需要整合来自多个来源的数据。高效地将这些信息结合起来,对于准确分析和获取有意义的洞见至关重要。PySpark 的连接提供了基于共享键将不同数据集合并的强大方式。
然而,当面对分布式集群中包含数百万甚至数十亿记录的海量数据集时,低效的连接会严重影响数据处理的速度与可靠性。
您是否经历过在大规模数据上连接变慢甚至失败的情况?如果是,这份指南适合您。它将帮助中级数据科学家、开发者和工程师在执行 PySpark 连接时更娴熟、更有信心。
如果您想通过动手练习熟悉 PySpark,欢迎查看我们的PySpark 大数据技能路径。
什么是 PySpark 连接?
正如您会在我们的PySpark 零基础入门博文中看到的,PySpark 的一大特性是能够合并大型数据集。PySpark 连接操作对于基于共享列合并大型数据集至关重要,可在规模化场景下实现高效的数据集成、对比与分析。
它们在大数据处理中发挥关键作用,帮助发掘关联关系,并从分布式数据源中提取有意义的洞见。
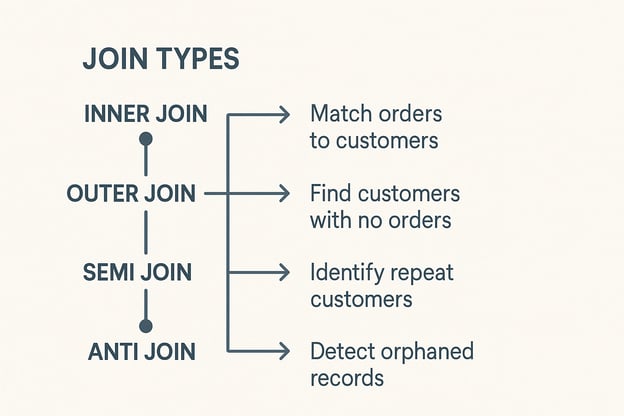
PySpark 提供多种连接类型,如内连接、外连接、左连接和右连接、半连接以及反连接,各自适用于不同的分析目的。
不过,在大型数据集上进行连接会带来挑战,例如数据倾斜、shuffle 开销以及内存受限,因此为性能与准确性选择合适的连接策略至关重要。
PySpark 连接的基础
理解 PySpark 的内部运作机制对于高效连接大型数据集至关重要,正如我们在PySpark 入门课程中所展示的。本节将概述 PySpark 执行连接的概念框架及其优化器的作用。
概念框架
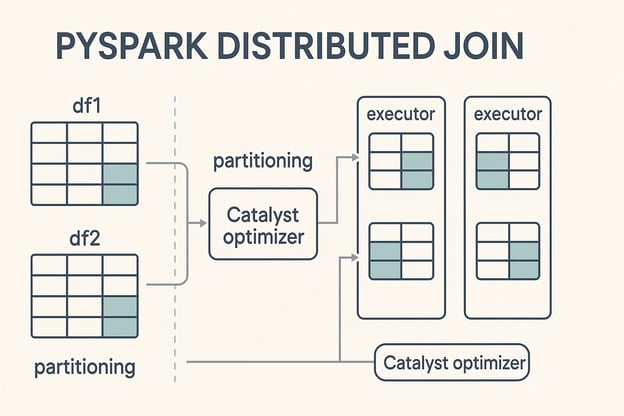
PySpark 在分布式计算环境中执行连接,这意味着它会将大型数据集拆分为更小的分区,并在集群中的多台机器上并行处理。当触发连接(join)时,PySpark 会将工作分发到这些节点上,力求计算负载均衡,从而加速执行并避免瓶颈。
这一过程的核心是 Catalyst,即 Spark 功能强大的查询优化引擎。Catalyst 决定连接操作的执行方式:选择分区策略、识别何时需要数据 shuffle,并应用诸如谓词下推与广播连接等性能优化。这种自动化优化确保了高效执行,而无需开发者进行繁琐的手动调优。
核心连接语法
在 PySpark 中执行连接,需要遵循简明的语法,指定DataFrame、连接条件以及要执行的连接类型。
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName("PySpark Joins Example").getOrCreate()
joined_df = df1.join(df2, on="key", how="inner")技术支持
在此示例中:
df1 和 df2 是要进行连接的DataFrame。df1.key == df2.key 是连接条件,用于确定如何匹配每个 DataFrame 的行。inner' specifies the join type, which could also be left, right,, outer, semi, or anti` depending on the desired result.
请参阅我们的PySpark 入门教程,获取如何安装 PySpark 并无错误地运行上述连接的步骤。
PySpark 连接类型与应用
PySpark 包含多种连接方式,各自适用于不同的数据任务。理解这些差异有助于您做出明智选择。
内连接
内连接在两侧均存在匹配键时合并两份 DataFrame 的行。没有匹配键的行将被排除。这是 PySpark 中最常见且默认的连接类型。
典型用例如下:
- 将客户订单与客户画像匹配,以支持准确的分析报告。
- 精确对比不同来源的数据集。
外连接
PySpark 支持左外、右外和全外连接。
左外连接返回左侧 DataFrame 的所有行,以及右侧 DataFrame 中匹配的行。若右侧无匹配键,则右侧列以 null 填充。
使用场景:
右外连接与左外连接逻辑相反。它返回右侧 DataFrame 的所有行以及左侧匹配的行,左侧无匹配的列以 null 填充。
示例场景:
全外连接返回两个 DataFrame 中的所有可用行,并对不匹配的条目以 null 填充。它有助于发现两个数据集之间的不一致或数据缺口。
特种连接:半连接与反连接
半连接与反连接用于特定目的:
半连接仅返回左侧 DataFrame 中在右侧存在匹配键的行。它不会添加右侧 DataFrame 的列,也避免重复,因此非常适合存在性检查。
用例示例:
反连接返回左侧 DataFrame 中在右侧没有匹配键的行。
用例示例:
交叉连接通过将一个 DataFrame 的每一行与另一个 DataFrame 的每一行配对来生成数据。除非明确需要,否则应避免交叉连接,因为它会急剧扩张数据量。
在如下特定场景中谨慎使用:
高效 PySpark 连接的优化技术
大规模连接需要细致调优。请考虑以下技术:
广播连接策略
广播连接通过将较小的 DataFrame 复制到所有节点,从而消除代价高昂的 shuffle,以提升性能。
语法示例:
from pyspark.sql.functions import broadcast

joined_df = large_df.join(broadcast(small_df), "id", "inner")技术支持
注意系统的内存限制;对过大的 DataFrame 进行广播并不会有效。
缓解数据倾斜的技术
数据倾斜意味着数据在分区间分布不均,会造成瓶颈。降低倾斜的技术包括:
- 键加盐:为严重倾斜的连接键附加随机前缀,以实现更均衡的分布。
- 感知倾斜的分区:Spark 会自动在分区间平衡数据,从源头上主动管理倾斜。
分区策略
PySpark 中连接性能的效率高度依赖于将 shuffle 开销最小化。shuffle 发生于为满足连接条件而需要跨节点移动数据时。降低此开销的有效方式之一是对待连接的 DataFrame 进行分区对齐。
分区最佳实践
请牢记以下最佳实践:
- 使用与连接条件相同的列对两个 DataFrame 进行分区,以最小化不必要的数据移动。
- 避免倾斜列:不要按少数占优值的列进行分区,因为这会导致各节点之间的工作负载不均衡。
- 明智使用
repartition() 或 broadcast():对于可实现均匀分布的大型数据集使用 repartition(),而对于显著更小的表使用 broadcast() 以完全避免 shuffle。
- 监控数据规模与分布:了解数据的底层特性(例如连接键的基数与频率分布)有助于选择更均衡的分区策略。
高级 PySpark 连接策略与用例
针对更苛刻的场景,PySpark 提供了专门机制,实现更高效率:
范围连接
范围连接用于基于数值或时间条件进行匹配,而非精确相等。在涉及时间序列数据的场景中很常见,如日志分析、事件跟踪或 IoT 传感器流。
高效范围连接的最佳实践包括:
- 最小化 shuffle 开销:合理分区对于避免昂贵的数据移动至关重要。执行范围连接时,可考虑按时间窗口或与用例相关的数值区间进行分区。
- 在分区内排序数据:在执行连接前,按范围键(如时间戳)对数据排序可以提升性能,尤其是在使用
rangeBetween 或 between 等操作时。
- 避免宽范围扫描:尽可能缩小连接范围,以减少比较数量并缩短执行时间。
- 利用分桶或窗口函数:这些方法有助于减少 shuffle,并在处理大型数据集与重叠范围时实现更好的对齐。
示例用例如下:
- 将营销活动数据与客户交互按时间窗口对齐。
- 合并按顺序采集的 IoT 或传感器数据,以进行异常检测或趋势分析。
流式连接
对流式数据进行连接由于其连续且常常不可预测的特性,带来了独特挑战。关键问题包括延迟到达的事件、乱序数据,以及需要随时间高效管理状态。
PySpark 通过水位线(watermarks)来应对这些挑战,它定义了系统在丢弃延迟数据前应等待的阈值。通过在事件时间列上设置水位线,PySpark 可以高效管理延迟数据并优化资源使用。
在连接两个流式来源,或将流与静态数据集连接时,水位线尤为有用,有助于在实时数据管道中同时保持性能与一致性。
机器学习(ML)特征连接
连接在机器学习模型的数据准备中至关重要,例如在使用 Spark MLlib 构建模型时。将这些特征整合进单一、统一的数据集,对准确的模型训练与评估至关重要。
在实时系统中实现高效特征连接的策略包括:
- 对小型、静态特征表使用广播连接,以最小化 shuffle,加速实时数据富化。
- 预聚合特征(使用窗口函数或分组操作)再进行连接,以减少在途数据量。
- 在连接实时流时利用水位线与事件时间对齐,以确保特征更新及时且相关。
- 持久化中间连接结果,对经常复用的特征避免在下游任务中重复计算。
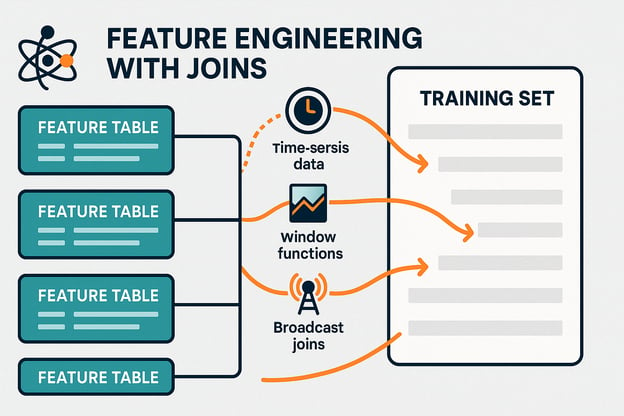
通过高效管理这些连接,PySpark 使实时特征工程成为可能,同时支持在线学习系统与最新的批量训练管道。
您可以通过我们的PySpark 机器学习课程,学习如何使用决策树、逻辑回归、线性回归、集成方法与管道在 Apache Spark 上进行预测。
最佳实践与常见挑战
在分布式计算中进行连接操作,需要持续关注以避免潜在问题。
高效的连接操作可以显著提升整个管道的速度与资源利用率。以下是应遵循的关键做法:
- 连接前过滤:在执行连接前移除不相关的行并丢弃未使用的列。这将减少在集群间进行 shuffle 的数据量。
- 合理的连接顺序:优先连接较小或可广播的表,以最小化中间数据规模并避免不必要的计算。
- 内存与资源管理:通过 Spark UI 或日志监控任务执行,以检测倾斜或瓶颈。确保分区策略与集群资源相匹配,避免单个节点过载。
- 明智地重分区:使用
repartition() 或 coalesce() 调整分区大小,以实现更均衡的并行处理。
应避免的反模式
连接逻辑中的小失误也可能导致重大的性能或数据准确性问题。以下是常见陷阱:
- 不正确或含糊的连接条件:定义不佳的连接条件会导致错误匹配或重复行。务必核实连接键的准确性、在必要时的唯一性,以及数据类型是否匹配。
- 无意的交叉连接:交叉连接会将一侧的每一行与另一侧的每一行相乘,往往导致数据量爆炸。仅在明确需要且清楚输出规模时使用。
- 对大型 DataFrame 强制广播连接:广播大表会占用内存并拖慢性能。让 PySpark 决策,或仅在 DataFrame 很小且能轻松装入内存时手动广播。
- 忽视数据倾斜:若一个或多个连接键高度倾斜,可能会压垮少数分区。尽早检测倾斜,并考虑加盐或替代策略。
即便结构良好的连接也可能遇到性能或执行问题。
以下是常见问题及其应对方法:
- 执行缓慢:通常由数据倾斜或分区不均导致。检查连接键是否高度重复,并考虑重分区或加盐以更均匀地分布数据。
- 连接失败或意外错误:通常由于数据类型不匹配或连接键包含 null。确保连接双方使用相同数据类型,并进行适当的 null 处理。
- 内存溢出错误:可能发生在未进行过滤就连接大型数据集,或对大表强制使用广播连接时。尽早过滤,并仅广播小而静态的 DataFrame。
结语
PySpark 连接是大规模数据处理的基石,能够在海量数据集上实现强大而高效的分析。正确使用时,它们能揭示有意义的关系,推动更深入的洞见与更明智的决策。
尽管性能调优会带来诸如处理数据倾斜或优化分区等挑战,但掌握这些方面是构建健壮数据管道的关键。
无论您是在连接实时流,还是为机器学习整合特征,优化连接策略都能显著提升执行速度、资源效率与分析精度。
想要更深入地探索,请学习使用 PySpark 进行大数据处理,并通过我们的PySpark 大数据基础技能路径,迈向数据工程专家之路。


PySpark 是 Apache Spark 的 Python API,旨在跨集群进行并行与分布式数据处理。为您的需求选择正确的连接(join)操作会影响作业速度、资源消耗以及整体成败。
处理大型数据集往往意味着需要整合来自多个来源的数据。高效地将这些信息结合起来,对于准确分析和获取有意义的洞见至关重要。PySpark 的连接提供了基于共享键将不同数据集合并的强大方式。
然而,当面对分布式集群中包含数百万甚至数十亿记录的海量数据集时,低效的连接会严重影响数据处理的速度与可靠性。
您是否经历过在大规模数据上连接变慢甚至失败的情况?如果是,这份指南适合您。它将帮助中级数据科学家、开发者和工程师在执行 PySpark 连接时更娴熟、更有信心。
如果您想通过动手练习熟悉 PySpark,欢迎查看我们的PySpark 大数据技能路径。
什么是 PySpark 连接?
正如您会在我们的PySpark 零基础入门博文中看到的,PySpark 的一大特性是能够合并大型数据集。PySpark 连接操作对于基于共享列合并大型数据集至关重要,可在规模化场景下实现高效的数据集成、对比与分析。
它们在大数据处理中发挥关键作用,帮助发掘关联关系,并从分布式数据源中提取有意义的洞见。
PySpark 提供多种连接类型,如内连接、外连接、左连接和右连接、半连接以及反连接,各自适用于不同的分析目的。
不过,在大型数据集上进行连接会带来挑战,例如数据倾斜、shuffle 开销以及内存受限,因此为性能与准确性选择合适的连接策略至关重要。
PySpark 连接的基础
理解 PySpark 的内部运作机制对于高效连接大型数据集至关重要,正如我们在PySpark 入门课程中所展示的。本节将概述 PySpark 执行连接的概念框架及其优化器的作用。
概念框架
PySpark 在分布式计算环境中执行连接,这意味着它会将大型数据集拆分为更小的分区,并在集群中的多台机器上并行处理。当触发连接(join)时,PySpark 会将工作分发到这些节点上,力求计算负载均衡,从而加速执行并避免瓶颈。
这一过程的核心是 Catalyst,即 Spark 功能强大的查询优化引擎。Catalyst 决定连接操作的执行方式:选择分区策略、识别何时需要数据 shuffle,并应用诸如谓词下推与广播连接等性能优化。这种自动化优化确保了高效执行,而无需开发者进行繁琐的手动调优。
核心连接语法
在 PySpark 中执行连接,需要遵循简明的语法,指定DataFrame、连接条件以及要执行的连接类型。
在此示例中:
df1和df2是要进行连接的DataFrame。df1.key==df2.key是连接条件,用于确定如何匹配每个 DataFrame 的行。inner' specifies the join type, which could also beleft,right,,outer,semi, oranti` depending on the desired result.请参阅我们的PySpark 入门教程,获取如何安装 PySpark 并无错误地运行上述连接的步骤。
PySpark 连接类型与应用
PySpark 包含多种连接方式,各自适用于不同的数据任务。理解这些差异有助于您做出明智选择。
内连接
内连接在两侧均存在匹配键时合并两份 DataFrame 的行。没有匹配键的行将被排除。这是 PySpark 中最常见且默认的连接类型。
典型用例如下:
外连接
PySpark 支持左外、右外和全外连接。
左外连接返回左侧 DataFrame 的所有行,以及右侧 DataFrame 中匹配的行。若右侧无匹配键,则右侧列以 null 填充。
使用场景:
右外连接与左外连接逻辑相反。它返回右侧 DataFrame 的所有行以及左侧匹配的行,左侧无匹配的列以 null 填充。
示例场景:
全外连接返回两个 DataFrame 中的所有可用行,并对不匹配的条目以 null 填充。它有助于发现两个数据集之间的不一致或数据缺口。
特种连接:半连接与反连接
半连接与反连接用于特定目的:
半连接仅返回左侧 DataFrame 中在右侧存在匹配键的行。它不会添加右侧 DataFrame 的列,也避免重复,因此非常适合存在性检查。
用例示例:
反连接返回左侧 DataFrame 中在右侧没有匹配键的行。
用例示例:
交叉连接通过将一个 DataFrame 的每一行与另一个 DataFrame 的每一行配对来生成数据。除非明确需要,否则应避免交叉连接,因为它会急剧扩张数据量。
在如下特定场景中谨慎使用:
高效 PySpark 连接的优化技术
大规模连接需要细致调优。请考虑以下技术:
广播连接策略
广播连接通过将较小的 DataFrame 复制到所有节点,从而消除代价高昂的 shuffle,以提升性能。
语法示例:
注意系统的内存限制;对过大的 DataFrame 进行广播并不会有效。
缓解数据倾斜的技术
数据倾斜意味着数据在分区间分布不均,会造成瓶颈。降低倾斜的技术包括:
分区策略
PySpark 中连接性能的效率高度依赖于将 shuffle 开销最小化。shuffle 发生于为满足连接条件而需要跨节点移动数据时。降低此开销的有效方式之一是对待连接的 DataFrame 进行分区对齐。
分区最佳实践
请牢记以下最佳实践:
repartition()或broadcast():对于可实现均匀分布的大型数据集使用repartition(),而对于显著更小的表使用broadcast()以完全避免 shuffle。高级 PySpark 连接策略与用例
针对更苛刻的场景,PySpark 提供了专门机制,实现更高效率:
范围连接
范围连接用于基于数值或时间条件进行匹配,而非精确相等。在涉及时间序列数据的场景中很常见,如日志分析、事件跟踪或 IoT 传感器流。
高效范围连接的最佳实践包括:
rangeBetween或between等操作时。示例用例如下:
流式连接
对流式数据进行连接由于其连续且常常不可预测的特性,带来了独特挑战。关键问题包括延迟到达的事件、乱序数据,以及需要随时间高效管理状态。
PySpark 通过水位线(watermarks)来应对这些挑战,它定义了系统在丢弃延迟数据前应等待的阈值。通过在事件时间列上设置水位线,PySpark 可以高效管理延迟数据并优化资源使用。
在连接两个流式来源,或将流与静态数据集连接时,水位线尤为有用,有助于在实时数据管道中同时保持性能与一致性。
机器学习(ML)特征连接
连接在机器学习模型的数据准备中至关重要,例如在使用 Spark MLlib 构建模型时。将这些特征整合进单一、统一的数据集,对准确的模型训练与评估至关重要。
在实时系统中实现高效特征连接的策略包括:
通过高效管理这些连接,PySpark 使实时特征工程成为可能,同时支持在线学习系统与最新的批量训练管道。
您可以通过我们的PySpark 机器学习课程,学习如何使用决策树、逻辑回归、线性回归、集成方法与管道在 Apache Spark 上进行预测。
最佳实践与常见挑战
在分布式计算中进行连接操作,需要持续关注以避免潜在问题。
高效的连接操作可以显著提升整个管道的速度与资源利用率。以下是应遵循的关键做法:
repartition()或coalesce()调整分区大小,以实现更均衡的并行处理。应避免的反模式
连接逻辑中的小失误也可能导致重大的性能或数据准确性问题。以下是常见陷阱:
即便结构良好的连接也可能遇到性能或执行问题。
以下是常见问题及其应对方法:
结语
PySpark 连接是大规模数据处理的基石,能够在海量数据集上实现强大而高效的分析。正确使用时,它们能揭示有意义的关系,推动更深入的洞见与更明智的决策。
尽管性能调优会带来诸如处理数据倾斜或优化分区等挑战,但掌握这些方面是构建健壮数据管道的关键。
无论您是在连接实时流,还是为机器学习整合特征,优化连接策略都能显著提升执行速度、资源效率与分析精度。
想要更深入地探索,请学习使用 PySpark 进行大数据处理,并通过我们的PySpark 大数据基础技能路径,迈向数据工程专家之路。