
什么是 PySpark?
PySpark 是两项强大技术的结合:Python 与 Apache Spark。
Python 是软件开发中使用最广泛的编程语言之一,尤其在数据科学与机器学习领域,主要得益于其易用且简洁的语法。
另一方面,Apache Spark 是一个能够处理海量非结构化数据的框架。Spark 由 Scala 构建,这门语言能够让我们对其有更多掌控。然而,Scala 并不是数据从业者中流行的编程语言,因此 PySpark 被创造出来以弥合这一差距。
PySpark 提供了与 Spark 交互的 API 与友好的用户界面。它借助 Python 的简洁与灵活性,让大数据处理走向更广泛的受众。
PySpark 为何受欢迎?
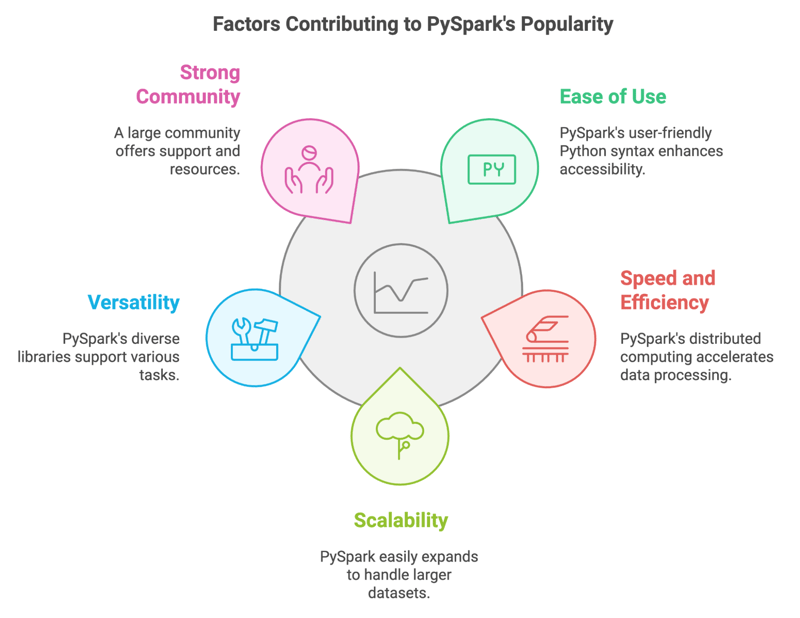
近年来,PySpark 已成为数据从业者处理海量数据的重要工具。其流行可以用以下关键因素来解释:
- 易用性: PySpark 使用熟悉的 Python 语法,使之对我们这样的数据从业者更易上手。
- 速度与效率: 通过将计算分布到机器集群,PySpark 能高速处理海量数据集。
- 可扩展性: PySpark 能适应不断增长的数据量,我们可以通过增加计算资源来扩展应用。
- 多功能性: 它提供了广泛的库生态,涵盖从数据处理到机器学习的不同任务。
- 强大的社区: 当我们遇到问题与挑战时,可以依靠庞大而活跃的社区提供支持与资源。
PySpark 还允许我们利用既有的 Python 技能与库。我们可以轻松将其与 Pandas 与 Scikit-learn 等流行工具集成,并可使用多种数据源。
PySpark 的主要特性
PySpark 专为大数据 与机器学习开发而生。那么,哪些特性让它成为处理海量数据的强力工具?让我们来看一看:
- 弹性分布式数据集(RDD):这是 PySpark 背后的基础数据结构。得益于 RDD,数据转换、过滤与聚合 都可以并行完成。
- DataFrame 与 SQL: 在 PySpark 中,DataFrame 是构建于 RDD 之上的更高层抽象。我们可以结合 Spark SQL 与查询来进行数据处理与分析。
- 机器学习库:借助 PySpark 的 MLlib 库,我们可以为分类、回归等任务构建并使用可扩展的机器学习模型。
- 支持多种数据格式:PySpark 提供库与 API 来读取、写入与处理多种格式的数据,如 CSV、JSON、Parquet、Avro 等。
- 容错性:PySpark 会跟踪每个 RDD。如果某个节点在执行期间发生故障,PySpark 会利用追踪信息重建丢失的 RDD 分区,从而大幅降低数据丢失风险。
- 内存中处理:PySpark 将中间数据存储在内存中,减少磁盘操作,从而提升数据处理性能。
- 流式与实时处理:我们可以利用 Spark Streaming 组件处理实时数据流并开展准实时分析。
为什么学习 PySpark 如此有用?
数据体量只增不减。如今,数据整理、数据分析与机器学习任务都涉及处理海量数据。我们需要能够高效、及时处理数据的强大工具,PySpark 正是其中之一。
PySpark 的应用场景多样
我们已经提到 PySpark 的优势,下面来看看几个具体示例,了解您可以在哪里用到它们:
- 数据 ETL。 PySpark 在高效数据清洗与转换方面的能力,可用于制造与物流中的传感器数据与生产日志处理。
- 机器学习。 借助 MLlib 库,可在电商中开发与部署个性化推荐、客户细分、销量预测等模型。
- 图计算。 通过 PySpark 的 GraphFrames 来分析社交网络,理解用户间的关系。
- 流式处理。 PySpark 的 Structured Streaming API 支持对金融交易进行实时处理以检测欺诈。
- SQL 数据处理。 PySpark 的 SQL 接口让医疗研究者和分析师更易查询与分析大型基因组数据集。
PySpark 技能有市场需求
随着数据科学与机器学习的发展以及可用数据的增长,具备数据处理能力的专业人士需求旺盛。根据《2024 年数据与 AI 素养现状报告》,80% 的领导者重视数据分析与数据处理技能。
学习 PySpark 可以开启广泛的职业机会。Indeed 上超过 800 条职位,从数据工程师到数据科学家,都强调在数据相关岗位的招聘信息中对 PySpark 熟练度的需求。
2026 年如何从零开始学习 PySpark
如果按照方法论系统学习 PySpark,成功的概率会更高。接下来聚焦几个可用于您学习旅程的原则。
1. 明确您学习 PySpark 的原因
在钻研技术细节之前,先明确您学习 PySpark 的动机。问问自己:
- 我的职业目标是什么?
- PySpark 是否是您在当前岗位晋升或获得理想职位所需的技能?
- 如果掌握 PySpark,您期望会打开哪些机会之门?
- 我在尝试解决哪些问题?
- 您是否在处理当前工具无法应对的大型数据集时遇到困难?
- 您是否需要执行复杂的数据转换或构建高级的机器学习模型?
- 我的兴趣是什么?
- 搭建可扩展的数据管道这一想法是否令您兴奋?
- 您是否对大数据及其挖掘洞察的潜力感兴趣?
- 我是否有需要 PySpark 能力的特定项目?
- 您是否在做涉及大规模数据处理或分析的个人项目?
- 您的公司是否在即将开展的项目中需要 PySpark 专长?
2. 从 PySpark 基础开始
在明确目标后,掌握 PySpark 的基础并理解其工作原理。
Python 基础
由于 PySpark 构建于 Python 之上,您在使用 PySpark 前必须熟悉 Python。应能自如使用变量与函数,同时建议熟悉如 Pandas 之类的数据处理库。DataCamp 的Python 入门课程与Pandas 数据处理可帮助您快速上手。
安装 PySpark 并学习基础
要开始使用,您需要安装 PySpark。您可以通过 pip 或 Conda 安装,从官网下载,或直接使用DataLab 在浏览器中体验 PySpark。
如果您需要完整的安装说明,请查看这篇关于如何在 Windows、Mac 与 Linux 上安装 PySpark的指南。
PySpark DataFrame
您应首先学习 PySpark DataFrame 的工作方式。它们是 PySpark 高速高效的关键原因之一。了解如何创建、转换(map 与 filter)并操作它们。教程如何开始使用 PySpark将帮助您掌握这些概念。
3. 掌握 PySpark 进阶技能
当您对基础内容已经熟悉,是时候探索 PySpark 的中级技能了。
Spark SQL
PySpark 的一大优势是其具备类 SQL 的查询能力,能够读取与操作 DataFrame、执行聚合与窗口函数。在幕后,PySpark 使用 Spark SQL。此Python 中 Spark SQL 入门课程可以帮助您掌握此技能。
数据整理与转换
处理数据意味着要熟练进行清洗、转换与分析前的准备工作。这包括处理缺失值、管理不同数据类型,以及使用 PySpark 执行聚合。参与DataCamp 的 PySpark 数据清洗课程以获得实战经验并掌握这些技能。
使用 MLlib 进行机器学习
借助 MLlib 库,PySpark 也可用于开发与部署机器学习模型。您应学习使用该库进行特征工程、模型评估与超参数调优。DataCamp 的使用 PySpark 进行机器学习课程提供了全面介绍。
4. 通过实践学习 PySpark
参加课程并练习 PySpark 相关习题是熟悉这项技术的绝佳方式。但要想真正熟练,您需要解决具有挑战性、能提升技能的问题,类似于真实项目中会遇到的那些。从简单的数据分析任务起步,再逐步迈向更复杂的挑战。
以下是练习技能的一些方式:
- 参与网络研讨会与跟学编程。 查看即将举办的 DataCamp 网络研讨会与线上活动,跟随 PySpark 教程与示例代码学习。这将有助于巩固概念并熟悉编码模式。
- 独立开发项目。 找到您感兴趣的数据集,应用 PySpark 技能进行分析。这可以是从分析社交媒体趋势到探索金融市场数据的任何主题。
- 参与开源项目。 在 GitHub 等平台上为 PySpark 项目做贡献,积累与他人协作和参与真实项目的经验。
- 搭建个人博客。 记录您的 PySpark 项目,分享见解,并通过创建个人博客为 PySpark 社区做出贡献。
5. 打造项目作品集
随着 PySpark 学习之旅的推进,您会完成不同的项目。为了向潜在雇主展示您的 PySpark 技能与经验,建议将其整理为作品集。作品集应反映您的技能与兴趣,并针对您所青睐的职业或行业进行定制。
尽量让项目具有原创性,并展示您的问题解决能力。包含能体现您在 PySpark 各方面熟练度的项目,例如数据整理、机器学习和数据可视化。为项目撰写文档,提供背景、方法、代码与结果。您可以使用DataLab,这是一款在线 IDE,可用于编写代码、协作分析数据并分享见解。
以下是两个您可以实践的 PySpark 项目:
6. 不断挑战自我
学习 PySpark 是一段持续的旅程。技术在不断演进,新特性与应用层出不穷,PySpark 也不例外。
当您掌握了基础之后,可以寻找更具挑战性的任务与项目,如性能优化或 GraphX。聚焦您的目标,并在与职业目标和兴趣相关的领域深入专精。
及时了解新进展并学习如何将其应用于当前项目。坚持练习、主动寻求新挑战与新机遇,并以从错误中学习的心态前行。
让我们回顾一下制定成功 PySpark 学习计划的步骤:
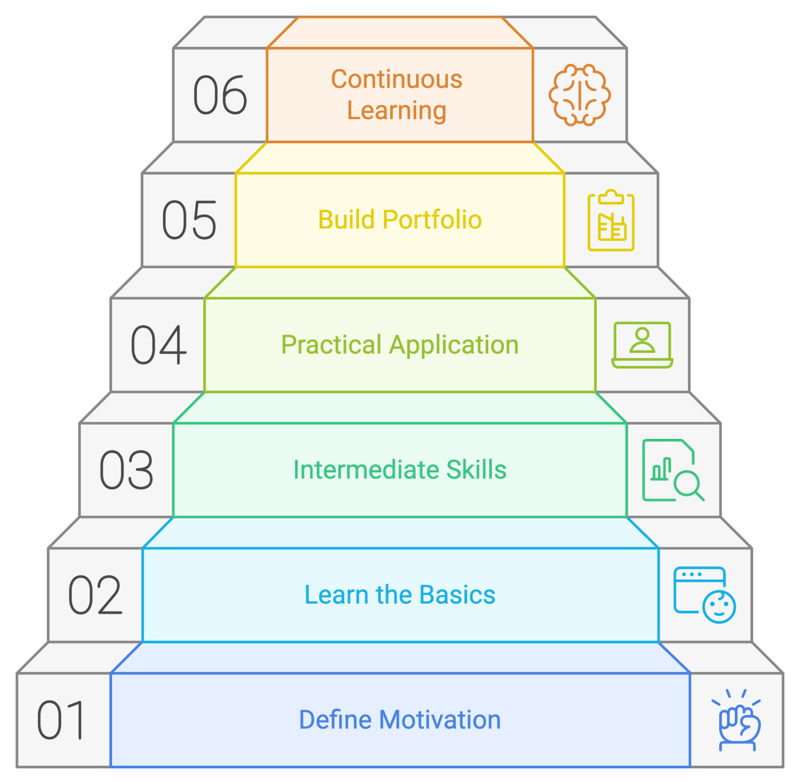
PySpark 学习计划示例
尽管每个人都有自己的学习方式,但在学习新工具时,制定一个计划或遵循一份指南总是好主意。我们为刚开始学习 PySpark 的您提供了一份潜在学习计划,指明应将时间与精力聚焦在哪里。
第 1 个月:PySpark 基础
- 核心概念。安装 PySpark 并探索其语法。理解 Apache Spark 的核心概念、架构,以及其如何实现分布式数据处理。
- PySpark 基础。 学习搭建 PySpark 环境、创建 SparkContext 与 SparkSession,并探索 RDD 与 DataFrame 等基础数据结构。
- 数据处理。掌握 PySpark 进行数据处理的基本操作,包括过滤、排序、分组、聚合与连接数据集。您可以完成使用 PySpark 清洗订单项目。
第 2 个月:用于数据分析与 SQL 的 PySpark
- 处理不同数据格式:学习在 PySpark 中读取与写入 CSV、JSON、Parquet、Avro 等多种数据格式。
- Spark SQL。 学习使用Spark SQL 以熟悉的 SQL 语法查询与分析数据。探索 DataFrame、Dataset 与 SQL 函数等概念。
- 数据可视化与特征工程:在 PySpark 中结合 Matplotlib 与 Seaborn 等库探索可视化技术,从数据中获取洞察。通过PySpark 特征工程课程学习数据整理与特征工程。
第 3–4 个月:用于机器学习与高级主题的 PySpark
- MLlib 入门:从 PySpark 的 MLlib 机器学习库开始。探索分类、回归与聚类等基础算法。您可以学习使用 PySpark 进行机器学习课程。
- 构建机器学习流水线。学习在 PySpark 中构建与部署机器学习流水线,以高效完成模型训练与评估。
- 开发项目。着手开发一个需求预测模型。
- 高级概念。 探索优化 PySpark 应用的技巧,包括数据分区、缓存与性能调优。
学习 PySpark 的五个建议
我想您现在已经准备好投入 PySpark 学习,并上手一个大型数据集来练习新技能了。但在此之前,请先看看这些能帮助您更顺利迈向 PySpark 熟练之路的建议。
1. 收窄学习范围
PySpark 是一款用途广泛的工具。为保持专注并实现目标,您应明确自己的兴趣方向:是专注数据分析、数据工程,还是机器学习?聚焦式的学习路径有助于您在所选方向中吸收与 PySpark 最相关的知识与要点。
2. 频繁且持续地练习
坚持是掌握任何新技能的关键。请为 PySpark 练习预留固定时间,即便每天只花很短时间也可以。您不必每天攻克复杂概念,可以复习已学内容或重做一个简单练习进行重构。规律练习将强化对概念的理解,并提升运用它们的信心。
3. 做真实项目
这是关键建议之一,您会在本指南中多次看到。练习习题有助于建立信心,但将 PySpark 技能用于真实项目才是让您脱颖而出的关键。寻找您感兴趣的数据集,使用 PySpark 进行分析、提取洞察并解决问题。
从简单的项目与问题入手,逐步挑战更复杂的任务。可以简单到读取并清洗一个真实数据集,然后编写复杂查询执行聚合,甚至预测房价。
4. 参与社区
协作式学习往往更高效。分享您的经验并向他人学习,可以加速进步并带来宝贵见解。
为交流知识、想法与问题,您可以加入一些与 PySpark 相关的群组,并参加线下聚会与会议。Databricks 社区(由 Spark 创始人创立的公司)拥有活跃的论坛,您可以在其中参与讨论并就 PySpark 提问。此外,Databricks 主办的 Spark Summit 是规模最大的 Spark 大会。
5. 允许自己犯错
与其他技术一样,学习 PySpark 是一个迭代过程,而从错误中学习是其中至关重要的一环。不要害怕尝试与实验,尝试不同方法并从失误中吸取经验。试用不同函数与聚合方式,进行子查询或嵌套查询,感受 PySpark 带来的快速响应。
学习 PySpark 的最佳途径
下面介绍几种高效学习 PySpark 的方法。
参加在线课程
在线课程让您能够以自己的节奏学习 PySpark。DataCamp 为各个水平提供 PySpark 课程,组成用 PySpark 学大数据学习路径。课程内容涵盖从入门概念到机器学习主题,并以实操练习为设计核心。
以下是部分与 PySpark 相关的 DataCamp 课程:
跟随在线教程
教程是学习 PySpark 的另一种好方式,尤其是当您还是新手时。教程包含逐步指导,帮助您完成特定任务或理解某些概念。入门建议参考以下教程:
查看 PySpark 速查表
当您需要快速参考 PySpark 相关主题时,速查表非常有用。以下是两份实用速查表:
完成 PySpark 项目
学习 PySpark 必须动手实践。通过完成项目所遇到的挑战,您将有机会应用所学全部技能。随着任务日益复杂,您需要寻找解决方案并研究新方法以达成目标,从而快速提升 PySpark 专业度。
在 DataCamp 上查找可实践的 PySpark 项目。这些项目能让您在 PySpark 的加持下应用数据处理技能与机器学习建模:
通过书籍深入了解 PySpark
书籍是学习 PySpark 的极佳资源。它们提供专家的深入见解与知识,并配有代码片段和解释。以下是一些最受欢迎的 PySpark 书籍:
与 PySpark 相关的职业
对 PySpark 技能的需求已在多种数据相关岗位上增长,从数据分析师到大数据工程师。如果您正准备面试,可以参考这些 PySpark 面试问题以备战
大数据工程师
作为一名大数据工程师,您是大数据解决方案的架构师,负责设计、构建与维护处理海量数据集的基础设施。您将依靠 PySpark 创建可扩展的数据管道,确保高效的数据摄取、处理与存储。
您需要对分布式计算与云平台有深入理解,并具备数据仓库与 ETL 流程的专业知识。
- 关键技能:
- 精通 Python 与 PySpark、Java 与 Scala
- 理解数据结构与算法
- 精通 SQL 与 NoSQL
- 擅长 ETL 流程与数据管道构建
- 理解分布式系统
- 常用工具:
- Apache Spark、Hadoop 生态
- 数据仓库工具(如 Snowflake、Redshift 或 BigQuery)
- 云平台(如 AWS、GCP、Databricks)
- 工作流编排工具(如 Apache Airflow、Apache Kafka)
数据科学家
作为数据科学家,您将借助 PySpark 的能力进行数据整理与处理,并开发与部署机器学习模型。您的统计学知识与编程技能将帮助您构建模型,为决策过程提供支持。
- 关键技能:
- 精通 Python、PySpark 与 SQL
- 理解机器学习与 AI 概念
- 精通统计分析、定量分析与预测建模
- 数据可视化与报告技巧
- 良好的沟通与展示能力
- 常用工具:
- 数据分析工具(如 pandas、NumPy)
- 机器学习库(如 Scikit-learn)
- 数据可视化工具(如 Matplotlib、Tableau)
- 大数据框架(如 Airflow、Spark)
- 命令行工具(如 Git、Bash)
机器学习工程师
作为机器学习工程师,您将使用 PySpark 进行数据准备、模型构建,并完成训练与部署。
- 关键技能:
- 精通 Python、PySpark 与 SQL
- 深刻理解机器学习算法
- 了解深度学习框架
- 理解数据结构、数据建模与软件架构
- 常用工具:
- 机器学习库与算法(如 Scikit-learn、TensorFlow)
- 数据科学库(如 Pandas、NumPy)
- 云平台(如 AWS、Google Cloud Platform)
- 版本控制系统(如 Git)
- 深度学习框架(如 TensorFlow、Keras、PyTorch)
数据分析师
作为数据分析师,您将使用 PySpark 探索与分析大型数据集,识别趋势,并通过报告与可视化传达发现。
- 关键技能:
- 精通 Python、PySpark 与 SQL
- 扎实的统计分析知识
- 具备商业智能工具经验(如 Tableau、Power BI)
- 理解数据采集与数据清洗技术
- 常用工具:
- 数据分析工具(如 pandas、NumPy)
- 商业智能数据工具(如 Tableau、Power BI)
- SQL 数据库(如 MySQL、PostgreSQL)
|
角色 |
您要做什么 |
关键技能 |
使用工具 |
|
大数据工程师 |
设计、构建并维护处理海量数据集的基础设施。 |
Python、PySpark、Java 与 Scala,数据结构,SQL 与 NoSQL,ETL,分布式系统 |
Apache Spark、Hadoop、数据仓库工具、云平台、工作流编排工具 |
|
数据科学家 |
发掘隐含模式并从数据中提取有价值的洞察。运用统计知识与编程技能构建模型,助力决策制定。 |
Python、PySpark、SQL、机器学习、AI 概念、统计分析、预测建模、数据可视化、有效沟通 |
Pandas、NumPy、Scikit-learn、Keras、Matplotlib、plotly、Airflow、Spark、Git |
|
机器学习工程师 |
设计、开发并部署机器学习系统,利用公司数据进行预测。 |
Python、PySpark 与 SQL,机器学习算法,深度学习,数据结构,数据建模与软件架构 |
Scikit-learn、TensorFlow、Keras、PyTorch、Pandas、NumPy、AWS、Google Cloud Platform、Git |
|
数据分析师 |
连接原始数据与可执行的业务洞察之桥梁。通过报告与可视化传达发现。 |
Python、PySpark 与 SQL,统计分析,数据可视化,数据采集与数据清洗技术 |
Pandas、NumPy、Tableau、PowerBI、MySQL、PostgreSQL。 |
如何寻找使用 PySpark 的工作或 PySpark 相关岗位
在开启使用 PySpark 的职业生涯时,学位可能是很大的助力,但并非唯一途径。如今,越来越多的专业人士通过转行等替代路径进入数据相关岗位。只要有投入、持续学习与积极主动的态度,您就能拿下理想的 PySpark 相关工作。
持续了解行业动态
紧跟 PySpark 的最新进展。在社交媒体上关注活跃于 PySpark 领域的意见领袖,阅读与 PySpark 相关的博客,并收听相关播客。
PySpark 由Matei Zaharia 开发,他同时担任Databricks 的 CTO,Databricks 是构建在 Apache Spark 之上的平台。关注这些渠道,您将获得热门话题、新兴技术与 PySpark 未来方向的洞察。
您也应关注行业活动,无论是 DataCamp 的网络研讨会、数据科学与 AI 会议,还是社交活动。
打造作品集
您需要从其他候选人中脱颖而出。其中一个好方法是构建一个强有力的作品集,展示您的技能与已完成的项目。通过解决真实世界的问题,您可以给招聘经理留下良好印象。
您的作品集应包含多样化的项目,体现您在 PySpark 及其多种应用方面的专长。请查看这篇关于如何打造出色数据科学作品集的指南。
制作一份有效的简历
近年来,越来越多人转向数据科学与数据相关岗位。招聘经理需要审阅数百份简历并甄别优秀候选人。同时,许多公司会使用求职者跟踪系统(ATS)对简历进行自动筛选,淘汰不符合特定标准的简历。因此,您应当制作一份优秀简历,同时打动 ATS 与招聘人员。
准备面试
如果您被招聘经理注意到,或您的高质量简历通过了筛选流程,接下来就该为技术面试做准备了。为此,您可以查看这篇关于PySpark 面试常见问题的文章。
结语
学习 PySpark 可以为您开启更好的机会与职业前景。学习之路是值得的,但需要坚持与实践。通过使用这款工具大胆尝试并解决挑战,您可以加速学习过程,并在求职时拥有可展示的真实案例。
FAQs
PySpark 的主要特性有哪些?
PySpark 提供友好的 Python API 以充分利用 Spark,实现对大型数据集的高速与可扩展处理,并支持 SQL、机器学习与流处理。
为何对 PySpark 技能的需求在增长?
PySpark 的易用性、可扩展性与在大数据处理和机器学习方面的多用途性,正推动这些技能的需求增长。
学习 PySpark 应关注哪些要点?
聚焦 Python 基础、Spark 的核心概念与数据处理技巧,并探索如 Spark SQL 与 MLlib 等高级主题。
有哪些学习 PySpark 的途径?
参加在线课程与教程、动手处理真实数据集、使用速查表,并通过书籍系统学习 PySpark。
哪些岗位会使用 PySpark?
使用 PySpark 的岗位包括:大数据工程师、机器学习工程师、数据科学家与数据分析师。

作者
Maria Eugenia Inzaugarat
据估计,每天会产生约328.77 百万 TB的数据。每一次点击和购买都会生成数据,借助合适的工具,这些数据可以被处理为有意义的洞察和预测。
然而,我们需要高性能的库来帮助处理如此规模的数据,这正是PySpark 大显身手的地方。
在本指南中,我们将探讨如何从零开始学习 PySpark。我会帮助您制定学习计划,分享高效学习的最佳技巧,并提供有用的资源,助您找到需要 PySpark 技能的职位。