课程
Python 统计学入门
4 小时
200.6K
Python 的 list 是一种有序序列,可以包含重复值。某些 Python 应用可能需要仅包含唯一元素的列表。移除列表中重复项有多种技术可用。
正确的解决方案取决于移除重复项后,应用是否需要保留列表中各项的顺序。本文介绍的方案在可读性与复杂度上有所差异,其中一些依赖第三方模块中的函数。
在介绍如何从列表移除重复项之前,先澄清重复值的含义通常很有用。一般来说,当两个对象的值相等时,就被视为重复。在 Python 中,当两个对象具有相同的值时,等号运算符 == 会返回 True。不同数据类型的对象也可能相等:
print(10.0 == 10)
print(1 == True)
True
True浮点数 10.0 与整数 10 相等,整数 1 与布尔值 True 也相等。在大多数场景下,这些值会被视为重复。
某些 Python 数据结构会强制唯一性。set(集合) 是只包含唯一元素的容器:
print({10, 10.0})
print({10.0, 10})
print({1, True, 1.0})
{10}
{10.0}
{1}这段代码使用大括号 {} 语法创建了三个集合。每个集合都包含彼此相等的对象。如果将不同数据类型但相等的对象加入集合,只有第一个对象会被保留。
Python 还要求字典的键唯一:
print({10: "Integer 10", 10.0: "Float 10"})
print({True: "Boolean True", 1: "Integer 1"})
{10: 'Float 10'}
{True: 'Integer 1'}上述字典包含相等的键。只有第一个键会被保留。不过,其对应的值会被与相等键最后添加的值替换。因此,在第一个示例中,被保留的键是整数 10,但其值是字符串 "Float 10"。在第二个示例中,与 1 相等的键 True 关联的值是 "Integer 1"。
由于集合和字典要求元素或键唯一,它们在本文所述的若干解决方案中发挥了作用。
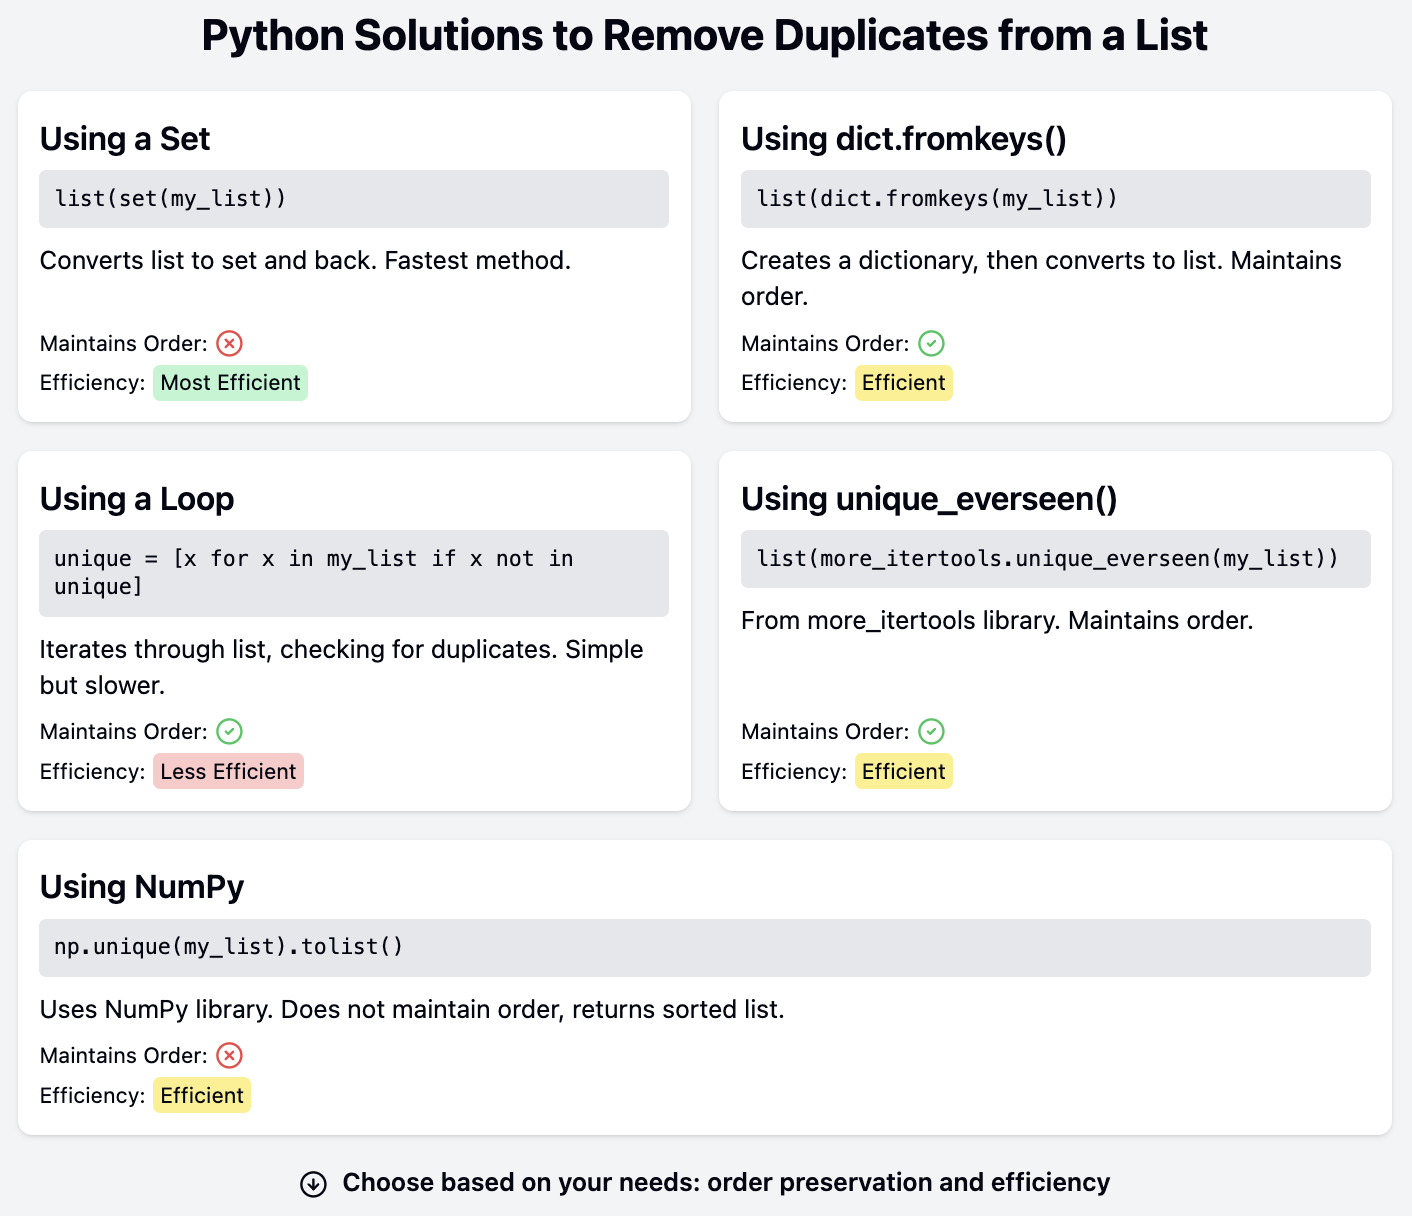
最简单的方式是将列表转换为集合,再将集合转换回列表。集合只能包含唯一值,因此在加入集合时会丢弃重复项:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
print(list(set(names)))
['Mark', 'Bob', 'Kate', 'James', 'Sarah']使用该技术移除重复项需要的步骤如下:
在原始列表中,James 和 Kate 各出现两次,但在最终列表中只出现一次。
但是,集合是无序的容器,集合中的项不保留原顺序。请注意,最终列表中的名字顺序与原列表并不一致。由于集合中的元素顺序没有保证,相同的代码在再次运行或在不同的 Python 解释器上运行时,可能产生不同的顺序。
当可以接受丢失列表项的顺序信息时,此方案是理想选择。但如果必须保留元素顺序,就需要其他方法。
字典键与集合类似,必须唯一。字典可以有重复的值,但不能有重复的键。
在 Python 3.6 之前,字典不保证元素顺序。然而,由于 Python 3.6 中对字典实现的更改,字典现在会保留插入顺序。在 Python 3.6 中这只是实现细节,但在 Python 3.7 中成为语言规范的一部分。
dict.fromkeys() 函数可从可迭代对象创建字典。该可迭代对象的元素会成为新字典的键:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
print(dict.fromkeys(names))
{'James': None, 'Bob': None, 'Mark': None, 'Kate': None, 'Sarah': None}由于字典键必须唯一,创建字典时会丢弃重复值。若使用 Python 3.7 或更高版本,键的顺序保证与列表中项的顺序一致。所有键默认值为 None。不过我们并不需要这些值,因为可以将该字典再转换回列表:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
print(list(dict.fromkeys(names)))
['James', 'Bob', 'Mark', 'Kate', 'Sarah']当将字典转换为列表时,只会使用键。此技术将原列表转换为一个不含重复项且保留原始顺序的新列表。
本文前半部分给出的选项涵盖了从列表移除重复项的两种情形:
dict.fromkeys() 来保留顺序。在大多数情况下,这两个选项很可能是最佳方案。不过,还有其他技术可用于移除列表中的重复项。
一种直接的做法是遍历原列表,并将新项添加到新列表中:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
unique_names = []
for name in names:
    if name not in unique_names:
        unique_names.append(name)
print(unique_names)
['James', 'Bob', 'Mark', 'Kate', 'Sarah']新列表 unique_names 在 for 循环之前初始化为空列表。如果某项尚未在新列表中,则将其添加。由于 for 循环按顺序遍历列表,此版本会保留原列表中各项的顺序。
对于大型列表,此方案可能效率较低。考虑一个由随机数构成的更长列表。我们可以将该方案的性能与使用 dict.fromkeys() 的版本进行比较:
import random
import timeit
data = [random.randint(0, 100) for _ in range(100)]
use_fromkeys = "unique_data = list(dict.fromkeys(data))"
use_for_loop = """unique_data = []
for item in data:
    if item not in unique_data:
        unique_data.append(item)"""
from_keys_time = timeit.timeit(use_fromkeys, globals=globals())
for_loop_time = timeit.timeit(use_for_loop, globals=globals())
print(f"Time for 'dict.fromkeys()' version: {from_keys_time:0.2f}s")
print(f"Time for loop version: {for_loop_time:0.2f}s")
Time for 'dict.fromkeys()' version: 2.26s
Time for loop version: 17.88s同名模块中的 timeit() 函数用于计时一段语句的执行时间。语句以字符串形式传递给 timeit.timeit()。输出显示,for 循环版本明显慢于使用 dict.fromkeys()。不同计算机和环境下的执行时间会有所差异,但 dict.fromkeys() 选项通常都会快得多。
上一节中的 for 循环无法直接转换为列表推导式,因为 if 语句需要检查某项是否已添加到新列表。若要使用列表推导式,需要一个额外的数据结构。可以使用集合来跟踪已经添加到列表中的项:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
items = set()
unique_names = [name for name in names if not (name in items or items.add(name))]
print(unique_names)
['James', 'Bob', 'Mark', 'Kate', 'Sarah']本文为完整性展示此方案,但与 dict.fromkeys() 相比,该选项的可读性较差,且并无性能提升。
如果名称已在集合 items 中,列表推导式括号内的表达式会计算为 True。由于 or 会短路求值,当第一个操作数为 True 时,or 之后的表达式不会被求值。括号内表达式为 True,因此 if 条件为 False,该名称不会添加到 unique_names。
当名称不在集合 items 中时,or 之后的表达式会被求值,并将该名称加入集合。但 .add() 方法返回的是 None,其真假值为假。此时 if 条件为 True,名称也会被添加到列表 unique_names 中。
一些第三方模块提供了移除重复项的工具。第三方库 more_itertools 包含 unique_everseen(),它返回一个 迭代器,可在保留顺序的同时产出唯一元素。
可以在终端使用 pip 或其他包管理器安装 more_itertools:
$ pip install more_itertools现在我们可以使用 more_itertools.unique_everseen() 来移除列表中的重复项:
import more_itertools
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
unique_names = list(more_itertools.unique_everseen(names))
print(unique_names)
['James', 'Bob', 'Mark', 'Kate', 'Sarah']由于 unique_everseen() 返回的是迭代器,其输出需要转换为列表。
另一款流行的第三方库是 NumPy,它同样提供了移除重复项的解决方案。NumPy 可以通过 pip 或其他包管理器安装:
$ pip install numpyNumPy 的 unique() 函数会返回一个包含其参数中唯一元素的 NumPy 数组。该数组可以通过 NumPy 的 .tolist() 转换为列表:
import numpy as np
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
unique_names = np.unique(names).tolist()
print(unique_names)
['Bob', 'James', 'Kate', 'Mark', 'Sarah']不过需要注意,NumPy 的 unique() 不会保留原有顺序,而是返回排序后的项。另一款流行的第三方库 Pandas 也有类似的 unique() 函数,但会保留元素顺序。当代码库中已在使用这些库时,NumPy 和 Pandas 的方案很理想;仅为移除列表重复项而额外安装导入它们,就没那么必要了。
dict.fromkeys() 比使用集合更好吗?在大多数情况下,本文介绍的前两种方案是最佳选择:
dict.fromkeys() 由列表创建字典,并将其转换回列表。使用字典可以保留元素顺序。但如果不需要顺序,使用集合效率更高,并能带来性能提升。
可以使用 timeit 来量化性能差异:
import random
import timeit
data = [random.randint(0, 100) for _ in range(100)]
use_fromkeys = "unique_data = list(dict.fromkeys(data))"
use_set = "unique_data = list(set(data))"
from_keys_time = timeit.timeit(use_fromkeys, globals=globals())
set_time = timeit.timeit(use_set, globals=globals())
print(f"Time for 'dict.fromkeys()' version: {from_keys_time:0.2f}s")
print(f"Time for set version: {set_time:0.2f}s")
Time for 'dict.fromkeys()' version: 2.08s
Time for set version: 1.05s使用集合从列表中移除重复项大约比使用字典快一倍。
Python 及其第三方库提供了多种从列表移除重复项的选项。
您可以通过以下博文继续学习 Python:
通过这些课程学习 Python!
课程
课程
课程