

在线运行和编辑此教程中的代码
运行代码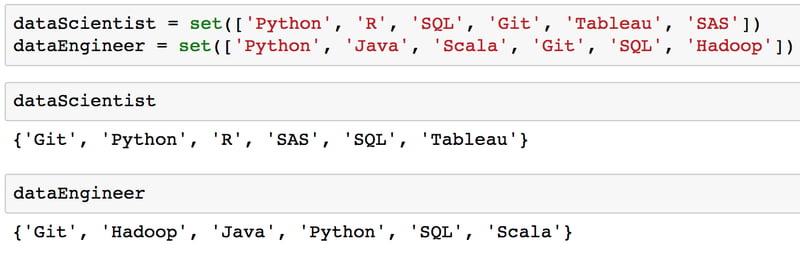
如果您查看上面 dataScientist 和 dataEngineer 变量的输出,会注意到集合中的值并非按添加顺序排列。这是因为集合是无序的。
包含值的集合也可以使用花括号进行初始化。
dataScientist = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
dataEngineer = {'Python', 'Java', 'Scala', 'Git', 'SQL', 'Hadoop'}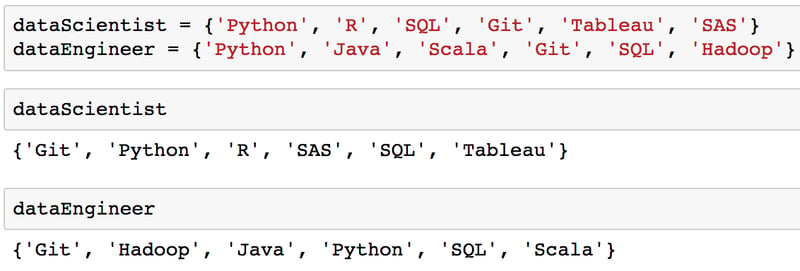
请注意,花括号只能用于初始化包含值的集合。下图展示了不带值使用花括号是初始化字典的一种方式,而不是集合。
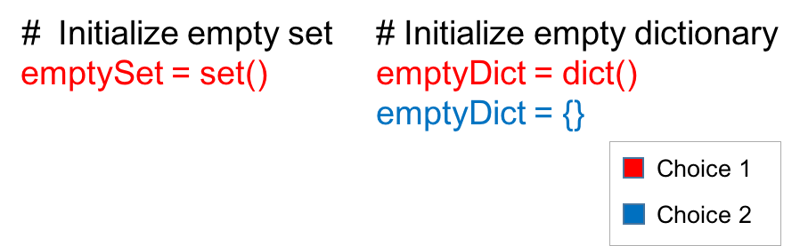
向 Python 集合添加与移除值
要向集合添加或移除值,首先要初始化一个集合。
# Initialize set with values
graphicDesigner = {'InDesign', 'Photoshop', 'Acrobat', 'Premiere', 'Bridge'}向 Python 集合添加值
您可以使用 add 方法向集合添加一个值。
graphicDesigner.add('Illustrator')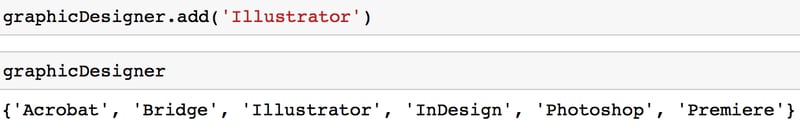
需要特别注意,您只能向集合添加不可变的值(如字符串或元组)。例如,如果尝试向集合添加列表,就会得到 TypeError。
graphicDesigner.add(['Powerpoint', 'Blender'])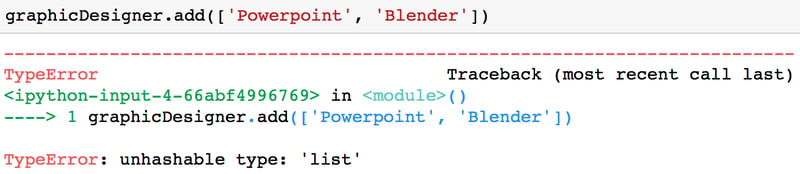
从 Python 集合移除值
有几种方式可以从集合中移除一个值。
方式 1:使用 remove 方法从集合中移除一个值。
graphicDesigner.remove('Illustrator')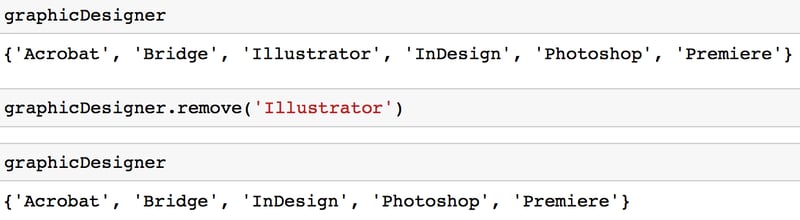
这种方法的缺点是,如果尝试移除一个不在集合中的值,会触发 KeyError。
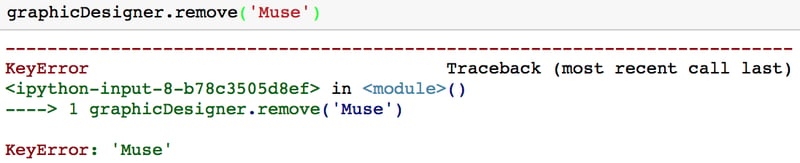
方式 2:使用 discard 方法从集合中移除一个值。
graphicDesigner.discard('Premiere')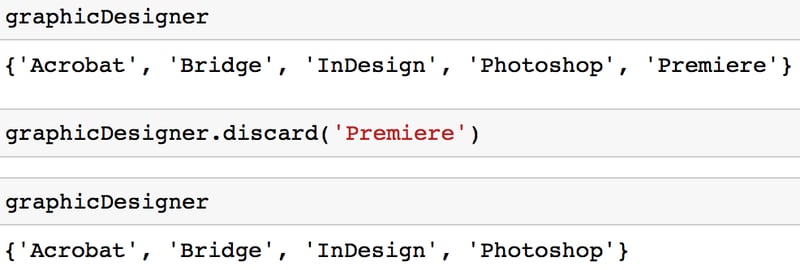
与 remove 方法相比,这种方式的优点在于,如果尝试移除的值不在集合中,不会触发 KeyError。如果您熟悉字典,您可能会发现它与字典的 get 方法有些类似。
方式 3:还可以使用 pop 方法移除并返回集合中的一个任意值。
graphicDesigner.pop()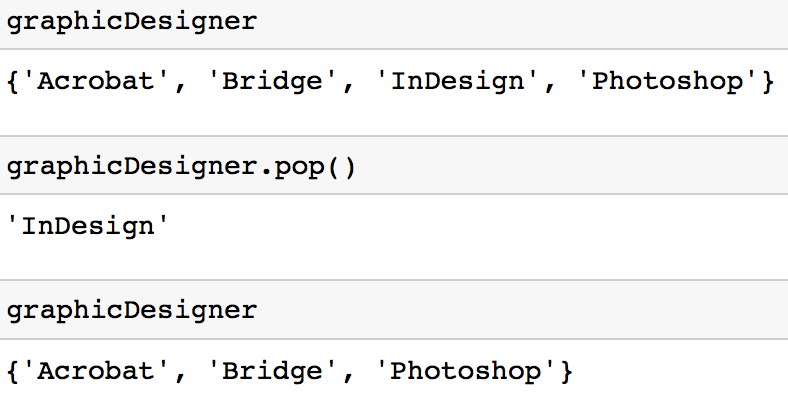
需要注意的是,如果集合为空,该方法会引发 KeyError。
从 Python 集合移除所有值
您可以使用 clear 方法移除集合中的所有值。
graphicDesigner.clear()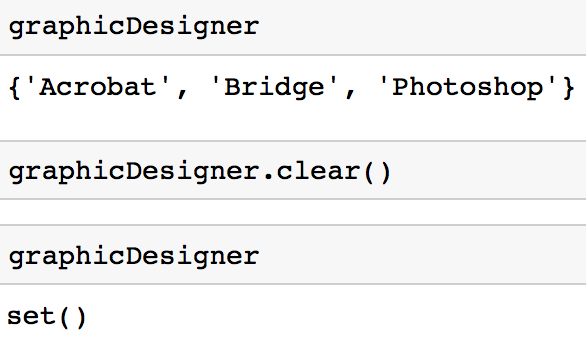
更新 Python 集合中的值
update 方法将一个集合中的元素添加到另一个集合。它需要一个参数,可以是集合、列表、元组或字典。.update() 方法会自动把其他数据类型转换为集合并添加进去。
在示例中,我们初始化了三个集合,并使用 update 函数先将 set2 的元素添加到 set1,然后再将 set3 的元素添加到 set1。
# Initialize 3 sets
set1 = set([7, 10, 11, 13])
set2 = set([11, 8, 9, 12, 14, 15])
set3 = {'d', 'f', 'h'}
# Update set1 with set2
set1.update(set2)
print(set1)
# Update set1 with set3
set1.update(set3)
print(set1)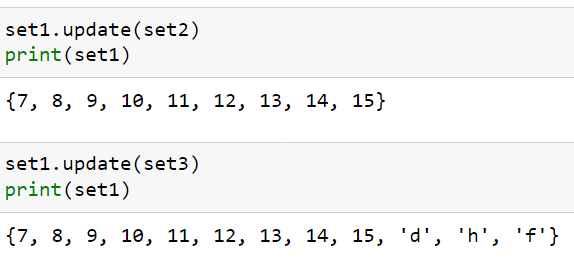
遍历 Python 集合
与许多标准的 Python 数据类型一样,集合也可以被遍历。
# Initialize a set
dataScientist = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
for skill in dataScientist:
print(skill)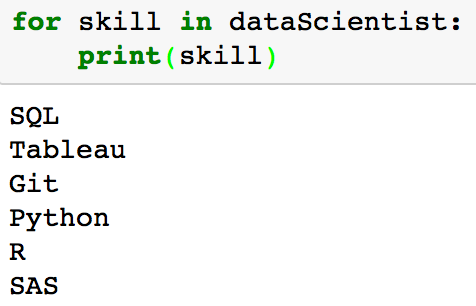
如果您查看打印 dataScientist 中各个值的输出,会注意到集合中的值并非按添加顺序打印。这是因为集合是无序的。
将 Python 集合转换为有序值
本教程一直强调集合是无序的。如果您需要以有序形式获取集合中的值,可以使用 sorted 函数,它会输出一个有序的列表。
type(sorted(dataScientist))
下面的代码将集合 dataScientist 中的值按字母倒序(此处为 Z-A)输出。
sorted(dataScientist, reverse = True)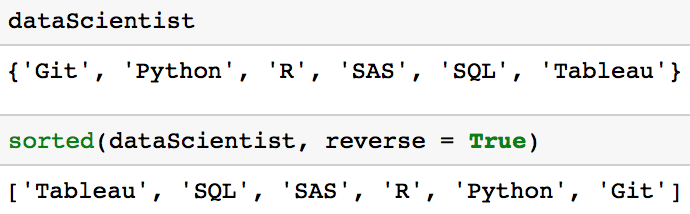
在 Python 中从列表去重
本节部分内容此前已在教程最常见的 18 个 Python 列表问题中探讨过,但需要强调的是,集合是从列表中去重的最快方式。为说明这一点,我们来比较两种方法的性能差异。
方法 1:使用集合对列表去重。
print(list(set([1, 2, 3, 1, 7])))方法 2:使用列表推导对列表去重(如果您想复习列表推导,请参阅此教程)。
def remove_duplicates(original):
unique = []
[unique.append(n) for n in original if n not in unique]
return(unique)
print(remove_duplicates([1, 2, 3, 1, 7]))可以使用 timeit 库来衡量两种方法的性能差异,它可以对您的 Python 代码计时。下面的代码将每种方法运行 10000 次,并输出总耗时(秒)。
import timeit
# Approach 1: Execution time
print(timeit.timeit('list(set([1, 2, 3, 1, 7]))', number=10000))
# Approach 2: Execution time
print(timeit.timeit('remove_duplicates([1, 2, 3, 1, 7])', globals=globals(), number=10000))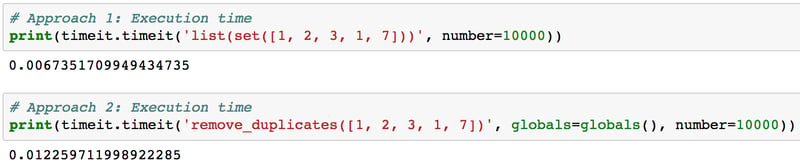
比较两种方法可以看出,使用集合去重更高效。尽管时间差看起来很小,但如果列表非常大,就能为您节省大量时间。
Python 集合运算
在 Python 中,集合的常见用法之一是计算并集、交集、差集和对称差等标准数学运算。下图展示了在两个集合 A 和 B 上的一些标准数学运算。每个维恩图中红色部分表示给定集合运算的结果集合。
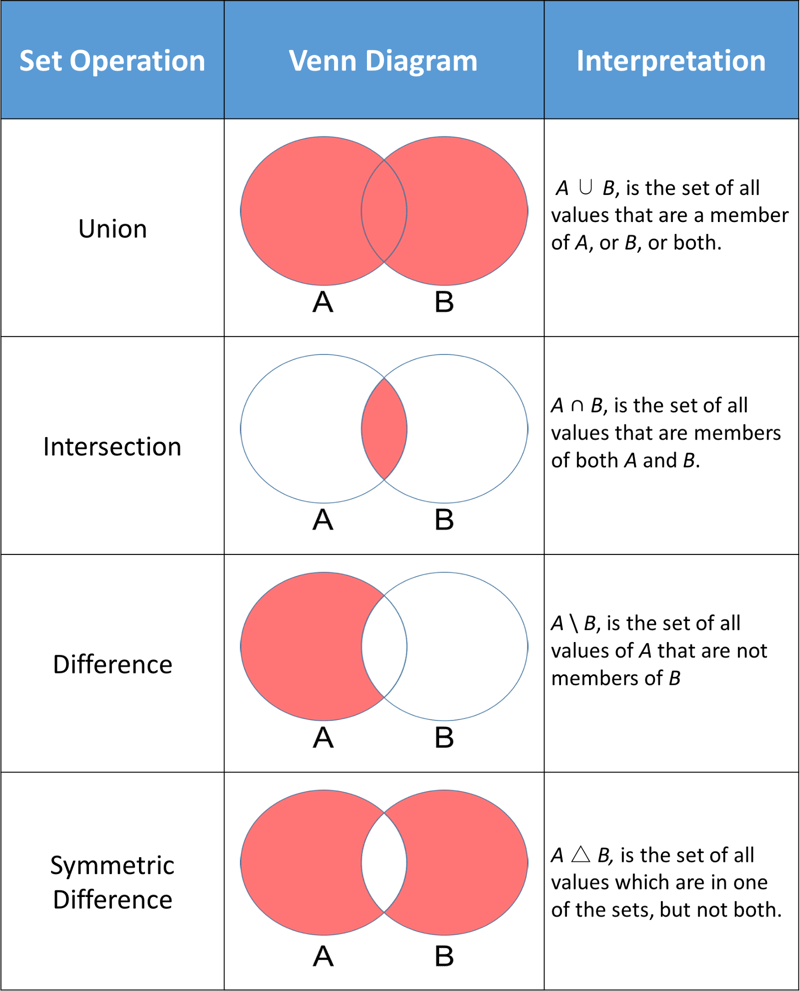
Python 集合提供了用于执行这些数学运算的方法,同时也有能得到等效结果的运算符。
在探讨这些方法之前,我们先初始化两个集合 dataScientist 和 dataEngineer。
dataScientist = set(['Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'])
dataEngineer = set(['Python', 'Java', 'Scala', 'Git', 'SQL', 'Hadoop'])union
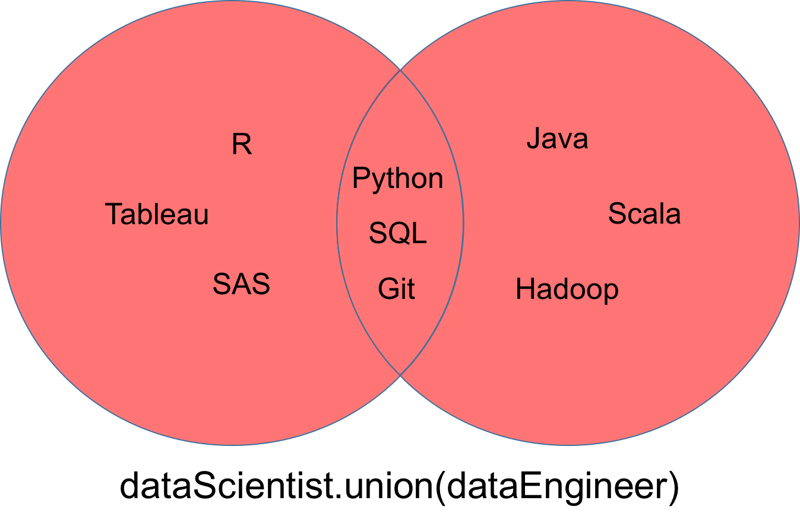
并集,记作 dataScientist ∪ dataEngineer,是所有属于 dataScientist、dataEngineer 或二者皆属的值所组成的集合。您可以使用 union 方法找出两个集合中的所有唯一值。
# set built-in function union
dataScientist.union(dataEngineer)
# Equivalent Result
dataScientist | dataEngineer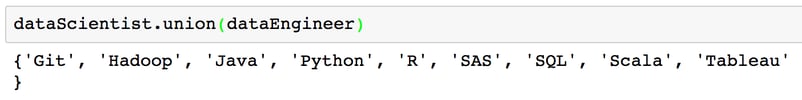
并集返回的集合可视化为下图维恩图中的红色部分。
intersection
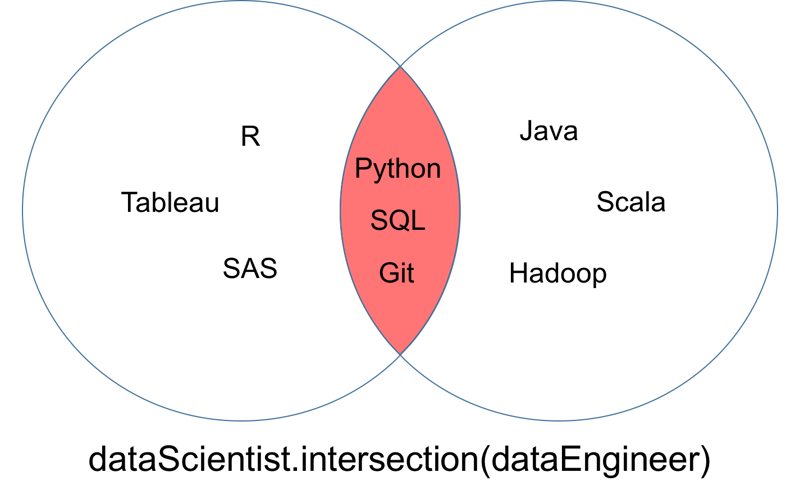
两个集合 dataScientist 和 dataEngineer 的交集,记作 dataScientist ∩ dataEngineer,是所有同时属于 dataScientist 和 dataEngineer 的值所组成的集合。
# Intersection operation
dataScientist.intersection(dataEngineer)
# Equivalent Result
dataScientist & dataEngineer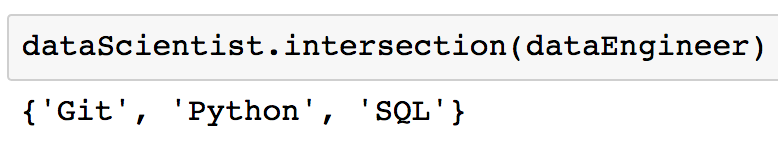
交集返回的集合可视化为下图维恩图中的红色部分。
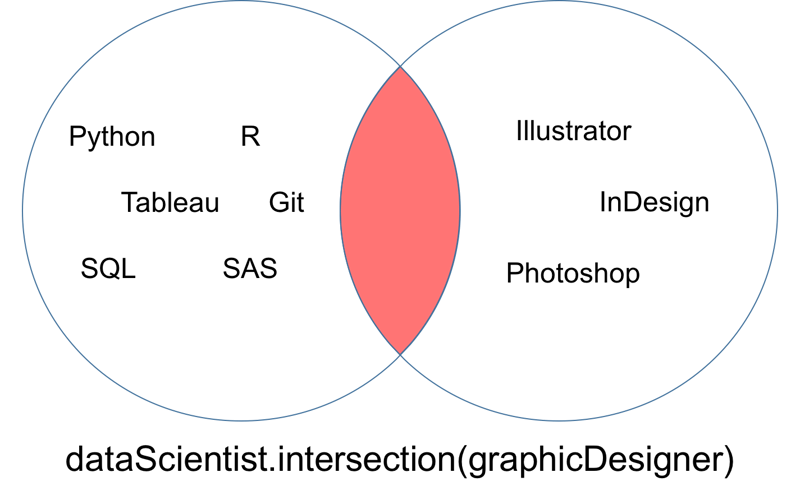
您可能会遇到需要确保两个集合没有共同元素的情况。换句话说,您希望两个集合的交集为空。这两个集合称为互斥集合(不相交集合)。您可以使用 isdisjoint 方法测试集合是否互斥。
# Initialize a set
graphicDesigner = {'Illustrator', 'InDesign', 'Photoshop'}
# These sets have elements in common so it would return False
dataScientist.isdisjoint(dataEngineer)
# These sets have no elements in common so it would return True
dataScientist.isdisjoint(graphicDesigner)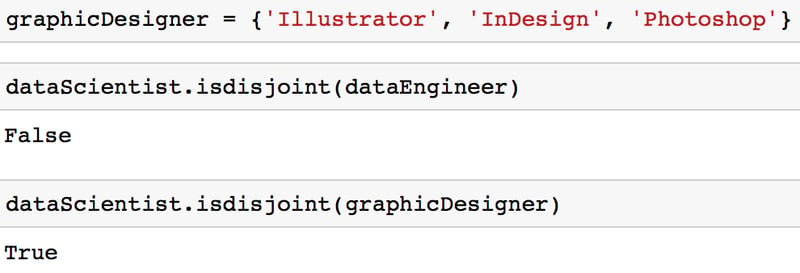
从下方维恩图的交集可以看出,互斥的 dataScientist 与 graphicDesigner 并无共同元素。
Difference
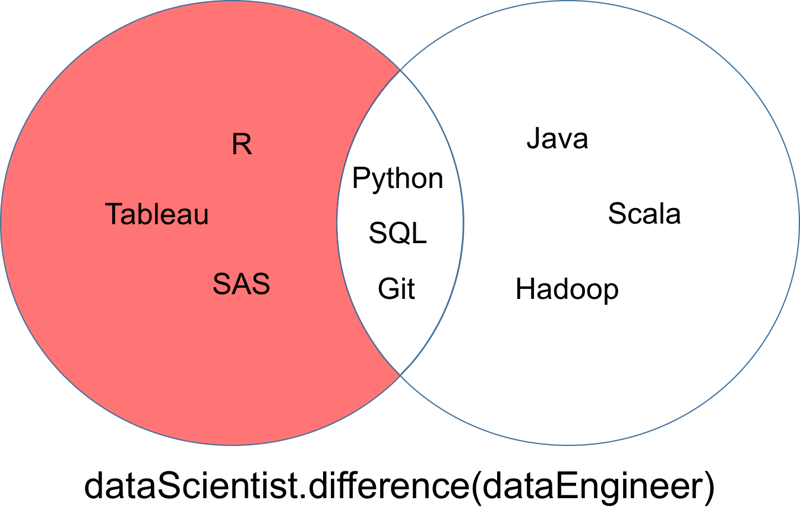
两个集合 dataScientist 和 dataEngineer 的差集,记作 dataScientist \ dataEngineer,是所有属于 dataScientist 且不属于 dataEngineer 的值所组成的集合。
# Difference Operation
dataScientist.difference(dataEngineer)
# Equivalent Result
dataScientist - dataEngineer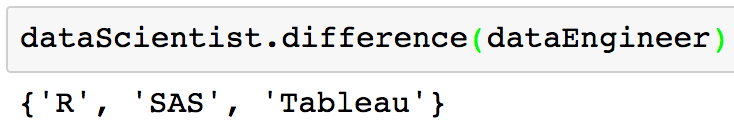
差集返回的集合可视化为下图维恩图中的红色部分。
Symmetric Difference
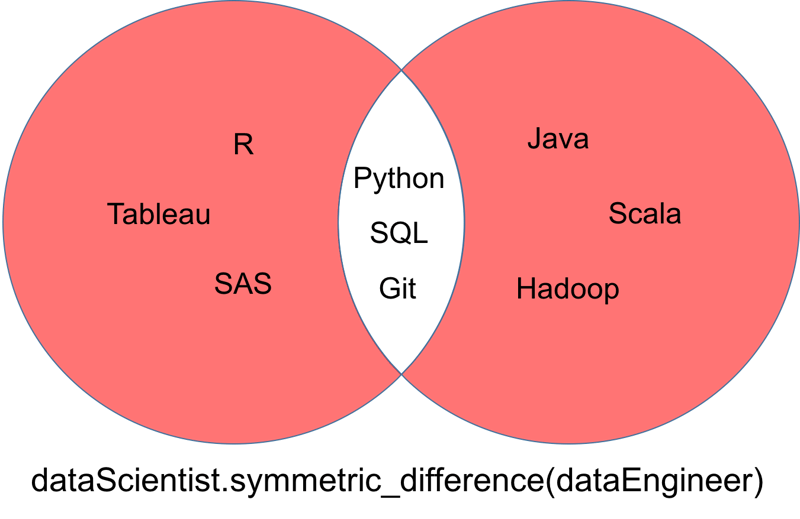
两个集合 dataScientist 和 dataEngineer 的对称差,记作 dataScientist △ dataEngineer,是只属于二者之一、但不同时属于二者的值所组成的集合。
# Symmetric Difference Operation
dataScientist.symmetric_difference(dataEngineer)
# Equivalent Result
dataScientist ^ dataEngineer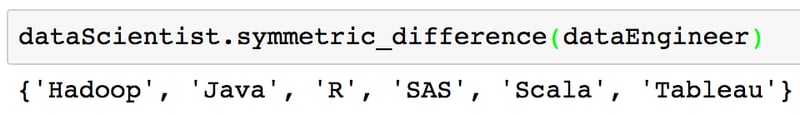
对称差返回的集合可视化为下图维恩图中的红色部分。
集合推导式
您可能已经学过列表推导式、字典推导式以及生成器推导式。Python 也有集合推导式。集合推导式与它们非常相似。Python 中的集合推导式可以按如下方式构造:
{skill for skill in ['SQL', 'SQL', 'PYTHON', 'PYTHON']}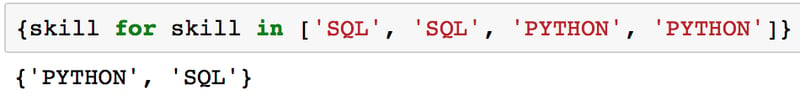
上述输出是一个包含 2 个值的集合,因为集合不允许同一元素出现多次。
使用集合推导式的理念,是让您能像手工做数学一样,用代码表达和推理。
{skill for skill in ['GIT', 'PYTHON', 'SQL'] if skill not in {'GIT', 'PYTHON', 'JAVA'}}上面的代码与您之前学到的差集类似,只是写法稍有不同。
成员测试
成员测试用于检查某个特定元素是否包含在一个序列中,例如字符串、列表、元组或集合。使用 Python 集合的主要优势之一是,它们针对成员测试高度优化。比如,相比列表,集合进行成员测试要高效得多。如果您有计算机科学背景,这是因为集合中成员测试的平均时间复杂度为 O(1),而列表为 O(n)。
下面的代码展示了使用列表进行成员测试。
# Initialize a list
possibleList = ['Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS', 'Java', 'Spark', 'Scala']
# Membership test
'Python' in possibleList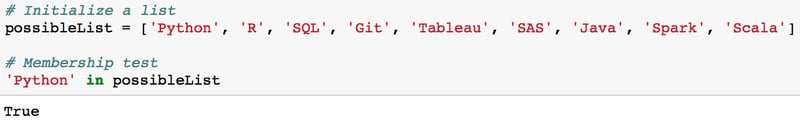
集合也可以进行类似的操作。集合只是碰巧更高效。
# Initialize a set
possibleSet = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS', 'Java', 'Spark', 'Scala'}
# Membership test
'Python' in possibleSet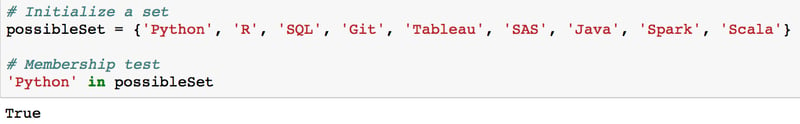
由于 possibleSet 是一个集合,且值 'Python' 是 possibleSet 的一个元素,可记作 'Python' ∈ possibleSet。
如果有一个不在集合中的值,比如 'Fortran',则可记作 'Fortran' ∉ possibleSet。
子集
理解成员关系的一个实际应用是子集。
首先初始化两个集合。
possibleSkills = {'Python', 'R', 'SQL', 'Git', 'Tableau', 'SAS'}
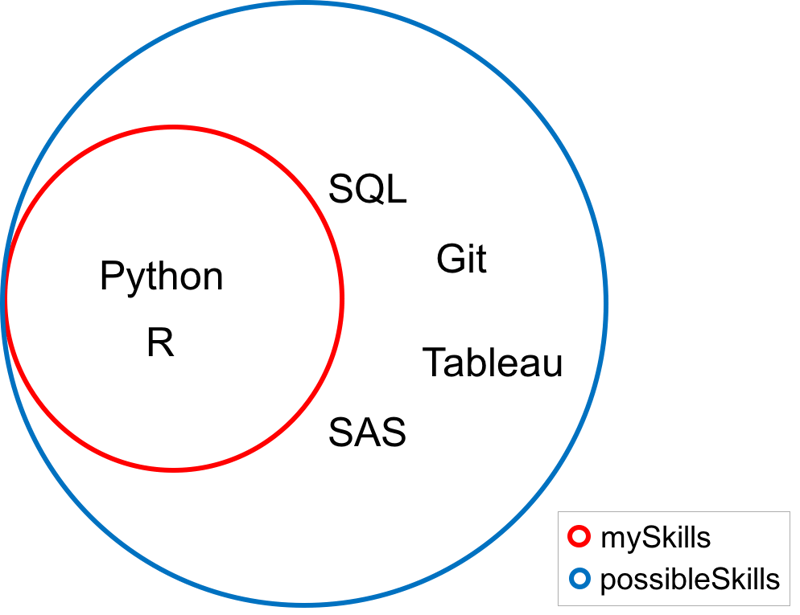
mySkills = {'Python', 'R'}如果集合 mySkills 的每个值也是集合 possibleSkills 的值,那么称 mySkills 是 possibleSkills 的子集,数学上记作 mySkills ⊆ possibleSkills。
您可以使用 issubset 方法检查一个集合是否为另一个的子集。
mySkills.issubset(possibleSkills)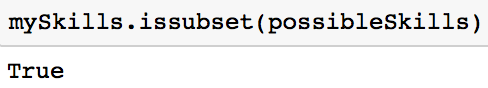
由于在该例中方法返回 True,说明它是子集。如下方维恩图所示,mySkills 的每个值也都是 possibleSkills 的值。
Frozenset(冻结集合)
您或许见过嵌套列表和元组。
# Nested Lists and Tuples
nestedLists = [['the', 12], ['to', 11], ['of', 9], ['and', 7], ['that', 6]]
nestedTuples = (('the', 12), ('to', 11), ('of', 9), ('and', 7), ('that', 6))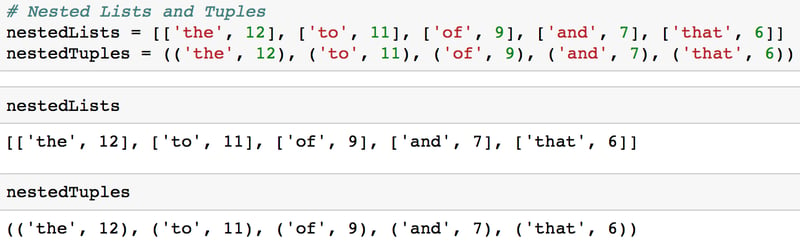
嵌套集合的问题在于,通常不能有嵌套的 Python 集合,因为集合不能包含可变的值(包括集合)。
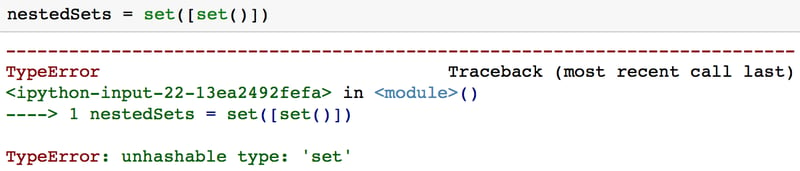
在这种情况下,您可以使用 frozenset。frozenset 与集合非常相似,不同之处在于 frozenset 是不可变的。
您可以使用 frozenset() 创建一个 frozenset。
# Initialize a frozenset
immutableSet = frozenset()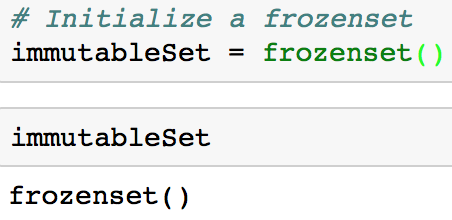
如果利用 frozenset,您就可以按下面的代码创建一个嵌套集合。
nestedSets = set([frozenset()])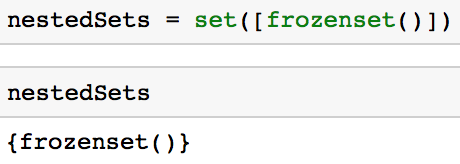
需要牢记的是,frozenset 的一个主要缺点是由于其不可变,意味着您无法添加或移除其中的值。
结语
Python 集合非常适合高效地从列表等集合类型中去重,并执行并集、交集等常见数学运算。人们常见的挑战之一是何时使用不同的数据类型。例如,如果您不确定何时应使用字典而非集合,建议您试试 DataCamp 的每日练习模式。如果您对本教程有任何问题或想法,欢迎在下方评论区留言或通过Twitter联系。
Python 集合 vs 列表与元组
列表和元组是 Python 的标准数据类型,用于按序存储值。集合也是一种标准数据类型,也用于存储值。主要区别在于,集合与列表或元组不同,不能包含相同元素的多个出现,并且存储的是无序的值。
Python 集合的优势
由于集合不允许同一元素出现多次,它非常适合高效地从列表或元组中去重,以及执行并集、交集等常见数学运算。
如果您想提升 Python 技能,或者您是初学者,务必看看 DataCamp 上的Python 程序员职业路径。
话不多说,让我们开始吧。
如何在 Python 中创建集合
集合是一个可变的、由不同(唯一)且不可变的值组成的无序集合。
您可以使用 set() 初始化一个空集合。
要用值初始化集合,可以将列表传给 set()。