{count, plural, one {Corso} other {Corsi}}
Introduzione alla statistica in Python
{hours} ore
199.6K
In Python una list è una sequenza ordinata che può contenere valori duplicati. Alcune applicazioni Python possono richiedere una lista che contenga solo elementi unici. Esistono diverse tecniche per rimuovere i duplicati da una lista in Python.
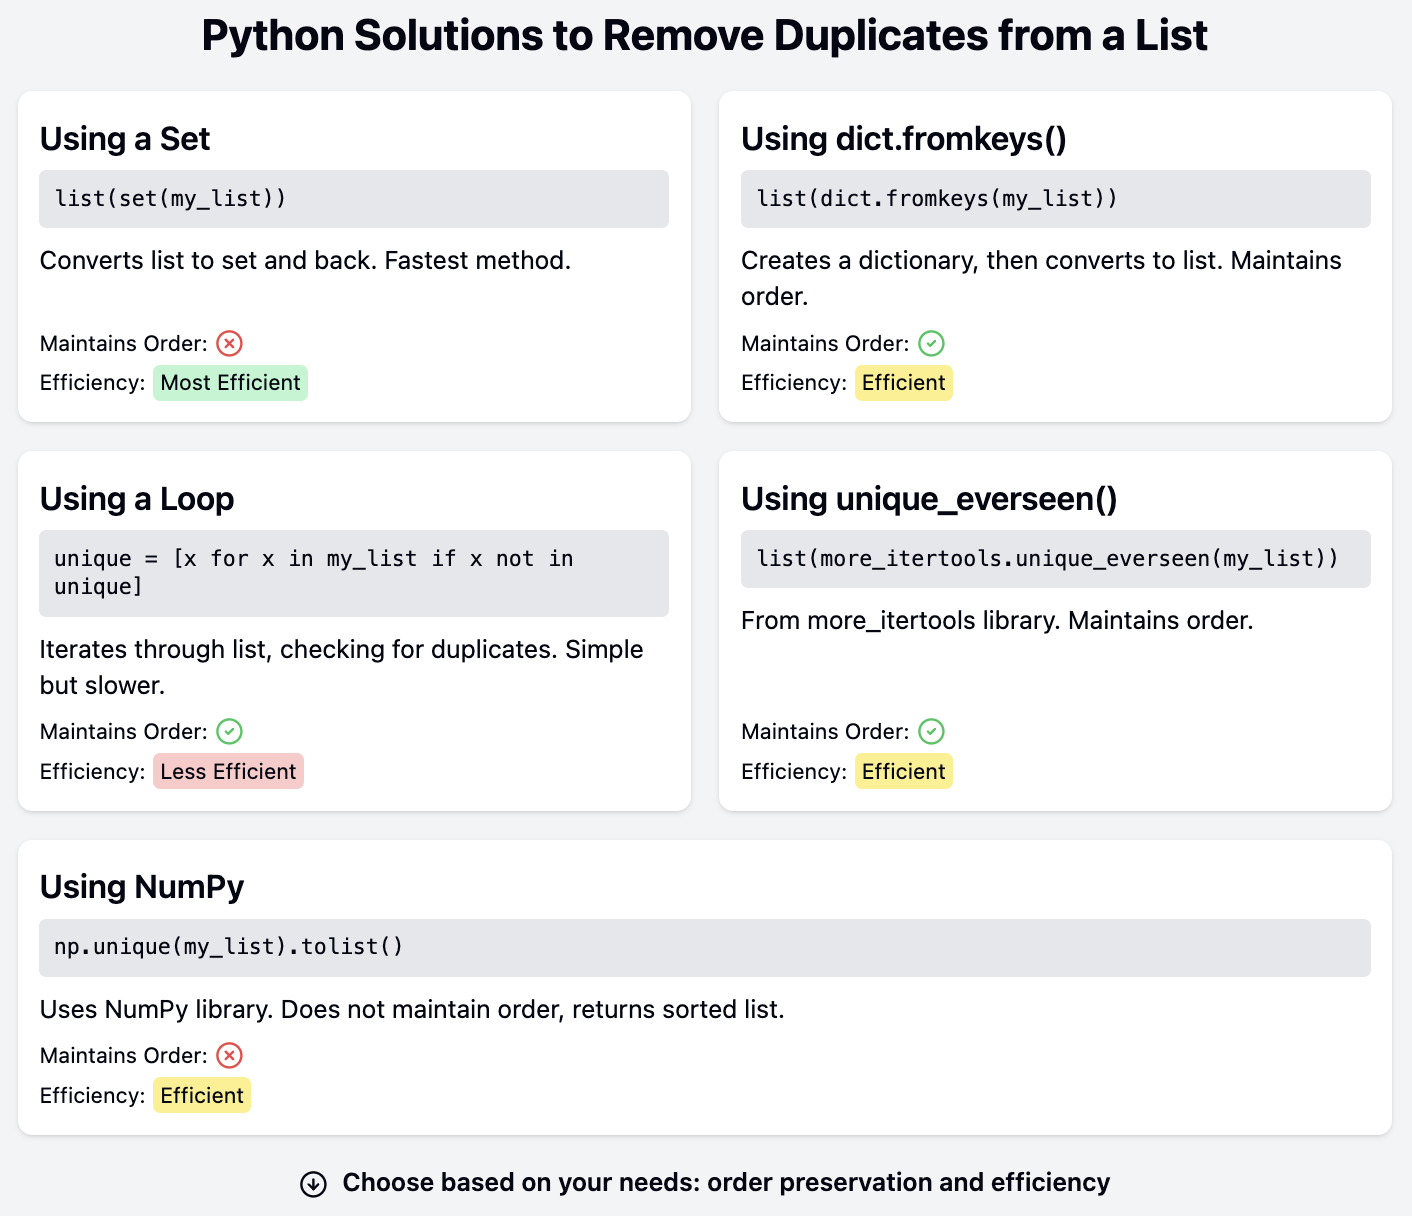
La soluzione giusta dipende dal fatto che l'applicazione debba mantenere l'ordine degli elementi della lista una volta rimossi i duplicati. Le soluzioni presentate in questo tutorial variano anche per leggibilità e complessità, e alcune si basano su funzioni presenti in moduli di terze parti.
È utile chiarire cosa intendiamo per valori duplicati prima di presentare le soluzioni per rimuoverli da una lista. In generale, due oggetti sono considerati duplicati quando i loro valori sono uguali. In Python, l'operatore di uguaglianza == restituisce True quando due oggetti hanno lo stesso valore. Oggetti di tipi diversi possono essere uguali:
print(10.0 == 10)
print(1 == True)
True
TrueIl float 10.0 e l'intero 10 sono uguali, e anche l'intero 1 e il booleano True sono uguali. Nella maggior parte degli scenari, questi valori sono considerati duplicati.
Alcune strutture dati di Python impongono l'unicità dei valori. Un set è una collezione che contiene solo elementi unici:
print({10, 10.0})
print({10.0, 10})
print({1, True, 1.0})
{10}
{10.0}
{1}Questo codice crea tre set usando la notazione con le parentesi graffe {}. Ogni set contiene oggetti che sono uguali tra loro. Se si aggiungono a un set oggetti uguali ma di tipi diversi, viene incluso solo il primo oggetto.
Python richiede anche che le chiavi di un dictionary siano uniche:
print({10: "Integer 10", 10.0: "Float 10"})
print({True: "Boolean True", 1: "Integer 1"})
{10: 'Float 10'}
{True: 'Integer 1'}I dizionari in questo codice contengono chiavi uguali. Solo la prima chiave viene mantenuta. Tuttavia, il suo valore viene sostituito dall'ultimo valore aggiunto al dizionario associato a una chiave uguale. Pertanto, nel primo esempio, la chiave mantenuta è l'intero 10, ma il suo valore è la stringa "Float 10". Nel secondo esempio, la chiave True, che è uguale a 1, è associata al valore "Integer 1".
Set e dizionari giocano un ruolo in diverse soluzioni di questo tutorial grazie al loro vincolo di unicità degli elementi o delle chiavi.
La tecnica più semplice per rimuovere i duplicati da una lista è convertire la lista in un set e poi di nuovo in una lista. Un set può contenere solo valori unici. Pertanto, i duplicati vengono scartati quando si aggiungono al set:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
print(list(set(names)))
['Mark', 'Bob', 'Kate', 'James', 'Sarah']Vediamo i passaggi necessari per rimuovere i duplicati da una lista usando questa tecnica:
James e Kate compaiono due volte nella lista originale ma solo una volta nella lista finale.
Tuttavia, i set sono collezioni non ordinate. L'ordine degli elementi in un set non è mantenuto. Nota come i nomi nella lista finale non siano nello stesso ordine in cui appaiono nella lista originale. Lo stesso codice può produrre un ordine diverso se eseguito di nuovo o con un interprete Python diverso, poiché non c'è garanzia sull'ordine degli elementi in un set.
Questa soluzione è ideale quando è accettabile perdere informazioni sull'ordine degli elementi nella lista. Se invece l'ordine deve essere conservato, servono altre soluzioni.
Le chiavi di un dizionario sono simili ai set perché devono essere uniche. Un dizionario può avere valori duplicati ma non chiavi duplicate.
Prima di Python 3.6, i dizionari non mantenevano l'ordine dei loro elementi. Tuttavia, come effetto collaterale di modifiche all'implementazione dei dizionari in Python 3.6, i dizionari ora mantengono l'ordine di inserimento. Questo era solo un dettaglio d'implementazione in Python 3.6 ma è diventato parte formale del linguaggio in Python 3.7.
La funzione dict.fromkeys() crea un dizionario a partire da un iterabile. Gli elementi dell'iterabile diventano le chiavi del nuovo dizionario:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
print(dict.fromkeys(names))
{'James': None, 'Bob': None, 'Mark': None, 'Kate': None, 'Sarah': None}Poiché le chiavi in un dizionario sono uniche, i valori duplicati vengono eliminati durante la creazione del dizionario. Le chiavi sono garantite nello stesso ordine degli elementi nella lista se usi Python 3.7 o successivo. Tutte le chiavi hanno per default il valore None. Tuttavia, i valori non servono in questo caso, perché questo dizionario può essere convertito di nuovo in lista:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
print(list(dict.fromkeys(names)))
['James', 'Bob', 'Mark', 'Kate', 'Sarah']Quando si converte un dizionario in una lista, vengono usate solo le chiavi. Questa tecnica trasforma la lista originale in una nuova lista senza duplicati e con l'ordine originale mantenuto.
Le opzioni presentate nella prima parte di questo tutorial coprono i due scenari in cui è necessario rimuovere i duplicati da una lista:
dict.fromkeys() per mantenere l'ordine degli elementi.Queste due opzioni sono probabilmente le soluzioni migliori nella maggior parte dei casi. Tuttavia, esistono altre tecniche per rimuovere i duplicati da una lista.
Un'opzione semplice è iterare sulla lista originale e aggiungere gli elementi nuovi a una lista nuova:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
unique_names = []
for name in names:
    if name not in unique_names:
        unique_names.append(name)
print(unique_names)
['James', 'Bob', 'Mark', 'Kate', 'Sarah']La nuova lista unique_names viene inizializzata come lista vuota prima del ciclo for. Un elemento viene aggiunto a questa nuova lista se non è già presente. Questa versione mantiene l'ordine degli elementi della lista originale, poiché il ciclo for itera sulla lista in ordine.
Questa soluzione può essere inefficiente per liste grandi. Considera una lista più lunga composta da numeri casuali. Possiamo confrontare le prestazioni di questa soluzione con la versione che usa dict.fromkeys():
import random
import timeit
data = [random.randint(0, 100) for _ in range(100)]
use_fromkeys = "unique_data = list(dict.fromkeys(data))"
use_for_loop = """unique_data = []
for item in data:
    if item not in unique_data:
        unique_data.append(item)"""
from_keys_time = timeit.timeit(use_fromkeys, globals=globals())
for_loop_time = timeit.timeit(use_for_loop, globals=globals())
print(f"Time for 'dict.fromkeys()' version: {from_keys_time:0.2f}s")
print(f"Time for loop version: {for_loop_time:0.2f}s")
Time for 'dict.fromkeys()' version: 2.26s
Time for loop version: 17.88sLa funzione timeit() nel modulo omonimo misura il tempo di esecuzione di un'istruzione. Le istruzioni vengono passate a timeit.timeit() come stringhe. L'output mostra che la versione con il ciclo for è significativamente più lenta rispetto all'uso di dict.fromkeys(). I tempi di esecuzione varieranno su computer e configurazioni diversi, ma l'opzione dict.fromkeys() sarà sempre significativamente più veloce.
Il ciclo for nella sezione precedente non può essere convertito in una list comprehension perché l'istruzione if verifica se un elemento è già stato aggiunto alla nuova lista. Per usare una list comprehension è necessaria una struttura dati separata. Si può usare un set per tenere traccia degli elementi già aggiunti alla lista:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
items = set()
unique_names = [name for name in names if not (name in items or items.add(name))]
print(unique_names)
['James', 'Bob', 'Mark', 'Kate', 'Sarah']Questo tutorial mostra questa soluzione per completezza, ma questa opzione manca di leggibilità e non offre miglioramenti prestazionali rispetto a dict.fromkeys().
Se il nome è già presente nel set items, l'espressione tra parentesi nella list comprehension viene valutata come True. L'espressione dopo la parola chiave or non viene valutata quando il primo operando è True, poiché or interrompe la valutazione. Poiché l'espressione tra parentesi è True, la clausola if è False e il nome non viene aggiunto a unique_names.
Quando il nome non è nel set items, viene valutata l'espressione dopo la parola chiave or e il nome viene aggiunto al set. Tuttavia, il metodo .add() restituisce None, che è falsy. La clausola if ora è True e il nome viene aggiunto anche alla lista unique_names.
Diversi moduli di terze parti includono strumenti per rimuovere i duplicati. La libreria di terze parti more_itertools include unique_everseen(), che restituisce un iteratore che produce elementi unici preservandone l'ordine.
La libreria more_itertools può essere installata nel terminale usando pip o altri gestori di pacchetti:
$ pip install more_itertoolsOra possiamo usare more_itertools.unique_everseen() per rimuovere i duplicati da una lista:
import more_itertools
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
unique_names = list(more_itertools.unique_everseen(names))
print(unique_names)
['James', 'Bob', 'Mark', 'Kate', 'Sarah']Poiché unique_everseen() restituisce un iteratore, il suo output viene convertito in lista.
Un'altra libreria di terze parti molto popolare è NumPy, che offre anch'essa una soluzione per rimuovere i duplicati. NumPy può essere installato usando pip o altri gestori di pacchetti:
$ pip install numpyLa funzione unique() di NumPy restituisce un array NumPy con gli elementi unici del suo argomento. Questo array NumPy può essere convertito in lista usando .tolist() di NumPy:
import numpy as np
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
unique_names = np.unique(names).tolist()
print(unique_names)
['Bob', 'James', 'Kate', 'Mark', 'Sarah']Tieni però presente che unique() di NumPy non preserva l'ordine degli elementi. Restituisce invece gli elementi ordinati. Un'altra libreria di terze parti molto popolare, Pandas, ha anch'essa una funzione unique() che funziona in modo simile ma preserva l'ordine degli elementi. Le soluzioni con NumPy e Pandas sono ideali quando queste librerie sono già usate nel codebase e non devono essere installate e importate solo per rimuovere duplicati da una lista.
dict.fromkeys() migliore dell'uso di un set?Nella maggior parte dei casi, le opzioni migliori sono le prime due presentate in questo tutorial:
dict.fromkeys() e riconvertirlo in una lista.Usare un dizionario preserva l'ordine degli elementi. Tuttavia, usare un set è più efficiente e può offrire miglioramenti prestazionali se l'ordine degli elementi non è necessario.
Il miglioramento prestazionale può essere quantificato usando timeit:
import random
import timeit
data = [random.randint(0, 100) for _ in range(100)]
use_fromkeys = "unique_data = list(dict.fromkeys(data))"
use_set = "unique_data = list(set(data))"
from_keys_time = timeit.timeit(use_fromkeys, globals=globals())
set_time = timeit.timeit(use_set, globals=globals())
print(f"Time for 'dict.fromkeys()' version: {from_keys_time:0.2f}s")
print(f"Time for set version: {set_time:0.2f}s")
Time for 'dict.fromkeys()' version: 2.08s
Time for set version: 1.05sRimuovere i duplicati da una lista usando un set è circa due volte più veloce che usare un dizionario.
Python e le sue librerie di terze parti offrono diverse opzioni per rimuovere i duplicati da una lista.
Puoi continuare a imparare Python con questi post del blog:
Impara Python con questi corsi!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



