Kursus
Pengantar Statistika di Python
4 jam
199.1K
Sebuah list di Python adalah urutan berindeks yang dapat berisi nilai duplikat. Beberapa aplikasi Python mungkin memerlukan list yang hanya berisi elemen unik. Ada beberapa teknik untuk menghapus duplikasi dari list di Python.
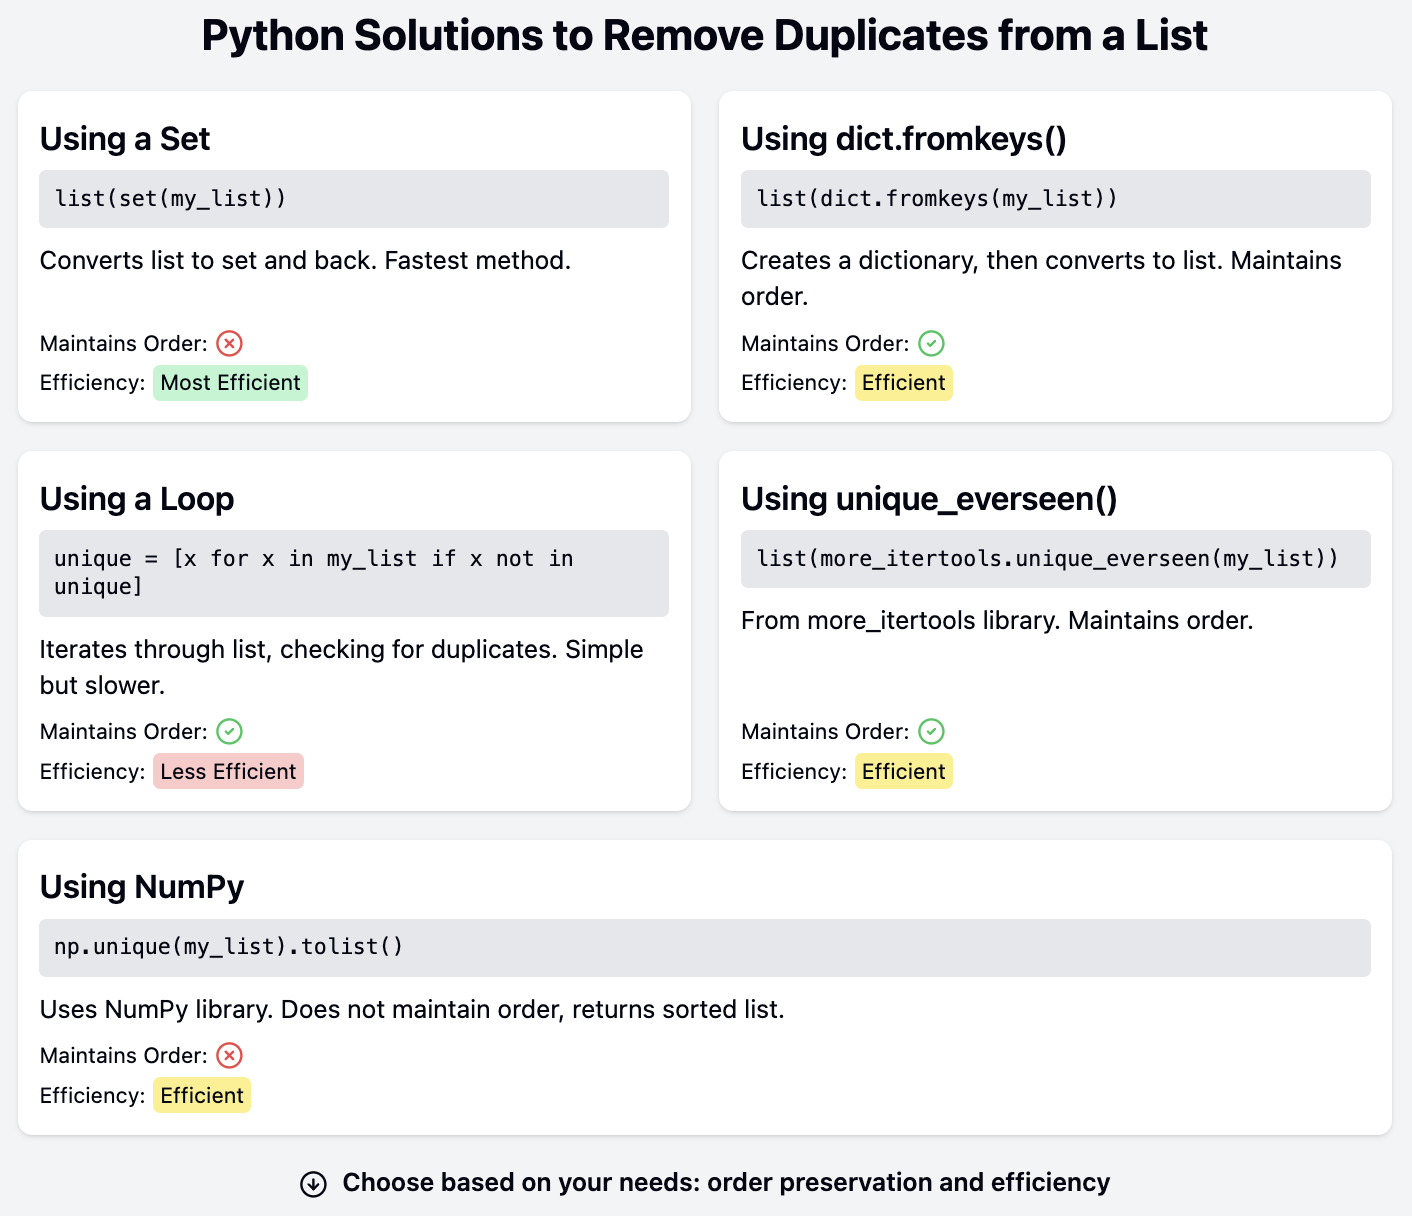
Solusi yang tepat bergantung pada apakah aplikasi perlu mempertahankan urutan item dalam list setelah duplikat dihapus. Solusi yang disajikan dalam tutorial ini juga bervariasi dari sisi keterbacaan dan kompleksitas, dan beberapa bergantung pada fungsi dalam modul pihak ketiga.
Ada baiknya memperjelas apa yang dimaksud dengan nilai duplikat sebelum memaparkan solusi untuk menghapusnya dari list. Dua objek umumnya dianggap duplikat ketika nilainya sama. Di Python, operator kesetaraan == mengembalikan True ketika dua objek memiliki nilai yang sama. Objek dengan tipe data berbeda bisa saja setara:
print(10.0 == 10)
print(1 == True)
True
TrueFloat 10.0 dan integer 10 setara, dan integer 1 serta Boolean True juga setara. Dalam sebagian besar skenario, nilai-nilai ini dianggap duplikat.
Beberapa struktur data Python menerapkan keunikan nilai. Sebuah set adalah koleksi yang hanya berisi elemen unik:
print({10, 10.0})
print({10.0, 10})
print({1, True, 1.0})
{10}
{10.0}
{1}Kode ini membuat tiga set menggunakan notasi kurung kurawal {}. Setiap set berisi objek-objek yang setara satu sama lain. Jika objek setara dari tipe data yang berbeda ditambahkan ke set, hanya objek pertama yang disertakan.
Python juga mewajibkan kunci pada dictionary bersifat unik:
print({10: "Integer 10", 10.0: "Float 10"})
print({True: "Boolean True", 1: "Integer 1"})
{10: 'Float 10'}
{True: 'Integer 1'}Dictionary dalam kode ini berisi kunci-kunci yang setara. Hanya kunci pertama yang dipertahankan. Namun, nilainya digantikan oleh nilai terakhir yang ditambahkan ke dictionary dengan kunci yang setara. Oleh karena itu, pada contoh pertama, kunci yang dipertahankan adalah integer 10, tetapi nilainya adalah string "Float 10". Pada contoh kedua, kunci True, yang setara dengan 1, diasosiasikan dengan nilai "Integer 1".
Set dan dictionary berperan dalam beberapa solusi di tutorial ini karena persyaratan mereka terhadap elemen atau kunci yang unik.
Teknik paling sederhana untuk menghapus duplikasi dari list adalah mengonversi list menjadi set dan kembali ke list. Set hanya dapat berisi nilai unik. Oleh karena itu, duplikasi akan dibuang ketika ditambahkan ke set:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
print(list(set(names)))
['Mark', 'Bob', 'Kate', 'James', 'Sarah']Mari kita lihat langkah-langkah yang diperlukan untuk menghapus duplikasi dari list menggunakan teknik ini:
James dan Kate muncul dua kali dalam list asli tetapi hanya sekali dalam list akhir.
Namun, set adalah koleksi yang tidak berurutan. Urutan item dalam set tidak dipertahankan. Perhatikan bagaimana nama dalam list akhir tidak dalam urutan yang sama seperti di list asli. Kode yang sama dapat menghasilkan urutan berbeda saat dijalankan lagi atau saat menggunakan interpreter Python yang berbeda karena tidak ada jaminan urutan elemen dalam set.
Solusi ini ideal ketika kehilangan informasi tentang urutan item dalam list dapat diterima. Namun, kita memerlukan solusi lain jika urutan elemen harus dipertahankan.
Kunci dictionary mirip dengan set karena harus unik. Sebuah dictionary dapat memiliki nilai yang duplikat tetapi tidak kunci yang duplikat.
Sebelum Python 3.6, dictionary tidak mempertahankan urutan elemennya. Namun, sebagai efek samping dari perubahan pada implementasi dictionary di Python 3.6, kini dictionary mempertahankan urutan saat item ditambahkan. Ini awalnya hanya detail implementasi di Python 3.6 tetapi menjadi bagian resmi bahasa pada Python 3.7.
Fungsi dict.fromkeys() membuat dictionary dari sebuah iterable. Elemen-elemen iterable menjadi kunci pada dictionary baru:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
print(dict.fromkeys(names))
{'James': None, 'Bob': None, 'Mark': None, 'Kate': None, 'Sarah': None}Karena kunci dalam dictionary bersifat unik, nilai duplikat dibuang saat membuat dictionary. Kunci dijamin memiliki urutan yang sama dengan item dalam list jika menggunakan Python 3.7 atau yang lebih baru. Semua kunci memiliki nilai None secara bawaan. Namun, nilai-nilai ini tidak diperlukan karena dictionary ini dapat dikonversi kembali menjadi list:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
print(list(dict.fromkeys(names)))
['James', 'Bob', 'Mark', 'Kate', 'Sarah']Saat mengonversi dictionary menjadi list, hanya kuncinya yang digunakan. Teknik ini mengonversi list asli menjadi list baru tanpa duplikasi dan dengan urutan item asli tetap dipertahankan.
Opsi yang disajikan pada bagian pertama tutorial ini mencakup dua skenario ketika duplikasi perlu dihapus dari list:
dict.fromkeys() untuk mempertahankan urutan item.Kedua opsi ini kemungkinan besar menjadi solusi terbaik dalam sebagian besar situasi. Namun, ada teknik lain untuk menghapus duplikasi dari list.
Opsi sederhana adalah melakukan iterasi melalui list asli dan menambahkan item baru ke list baru:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
unique_names = []
for name in names:
    if name not in unique_names:
        unique_names.append(name)
print(unique_names)
['James', 'Bob', 'Mark', 'Kate', 'Sarah']List baru unique_names diinisialisasi sebagai list kosong sebelum loop for. Sebuah item ditambahkan ke list baru ini jika belum ada di dalamnya. Versi ini mempertahankan urutan item dalam list asli karena loop for melakukan iterasi melalui list secara berurutan.
Solusi ini bisa tidak efisien untuk list berukuran besar. Pertimbangkan list yang lebih panjang yang terdiri dari angka acak. Kita dapat membandingkan performa solusi ini dengan versi yang menggunakan dict.fromkeys():
import random
import timeit
data = [random.randint(0, 100) for _ in range(100)]
use_fromkeys = "unique_data = list(dict.fromkeys(data))"
use_for_loop = """unique_data = []
for item in data:
    if item not in unique_data:
        unique_data.append(item)"""
from_keys_time = timeit.timeit(use_fromkeys, globals=globals())
for_loop_time = timeit.timeit(use_for_loop, globals=globals())
print(f"Time for 'dict.fromkeys()' version: {from_keys_time:0.2f}s")
print(f"Time for loop version: {for_loop_time:0.2f}s")
Time for 'dict.fromkeys()' version: 2.26s
Time for loop version: 17.88sFungsi timeit() dalam modul dengan nama yang sama mengukur waktu eksekusi sebuah pernyataan. Pernyataan tersebut diteruskan ke timeit.timeit() sebagai string. Output menunjukkan bahwa versi dengan loop for jauh lebih lambat dibandingkan menggunakan dict.fromkeys(). Waktu eksekusi akan bervariasi pada komputer dan pengaturan yang berbeda, tetapi opsi dict.fromkeys() hampir selalu jauh lebih cepat.
Loop for pada bagian sebelumnya tidak dapat diubah menjadi list comprehension karena pernyataan if memeriksa apakah sebuah item sudah ditambahkan ke list baru. Diperlukan struktur data terpisah untuk menggunakan list comprehension. Sebuah set dapat digunakan untuk melacak item yang sudah ditambahkan ke list:
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
items = set()
unique_names = [name for name in names if not (name in items or items.add(name))]
print(unique_names)
['James', 'Bob', 'Mark', 'Kate', 'Sarah']Tutorial ini menampilkan solusi ini demi kelengkapan, tetapi opsi ini kurang mudah dibaca dan tidak menawarkan peningkatan performa dibandingkan menggunakan dict.fromkeys().
Jika nama sudah ada dalam set items, ekspresi dalam tanda kurung pada list comprehension bernilai True. Ekspresi setelah kata kunci or tidak dievaluasi ketika operan pertama bernilai True karena or melakukan short-circuit pada evaluasi. Karena ekspresi dalam tanda kurung bernilai True, klausa if bernilai False, dan nama tidak ditambahkan ke unique_names.
Ketika nama belum ada dalam set items, ekspresi setelah kata kunci or dievaluasi, dan menambahkan nama ke set. Namun, metode .add() mengembalikan None, yang bersifat falsy. Klausa if kini bernilai True, dan nama juga ditambahkan ke list unique_names.
Sejumlah modul pihak ketiga memiliki alat untuk menghapus duplikasi. Pustaka pihak ketiga more_itertools menyertakan unique_everseen(), yang mengembalikan sebuah iterator yang menghasilkan elemen unik sambil mempertahankan urutannya.
Pustaka more_itertools dapat dipasang di terminal menggunakan pip atau pengelola paket lainnya:
$ pip install more_itertoolsSekarang kita dapat menggunakan more_itertools.unique_everseen() untuk menghapus duplikasi dari list:
import more_itertools
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
unique_names = list(more_itertools.unique_everseen(names))
print(unique_names)
['James', 'Bob', 'Mark', 'Kate', 'Sarah']Karena unique_everseen() mengembalikan sebuah iterator, keluarannya dikonversi menjadi list.
Pustaka pihak ketiga populer lainnya adalah NumPy, yang juga menawarkan solusi untuk menghapus duplikasi. NumPy dapat dipasang menggunakan pip atau pengelola paket lainnya:
$ pip install numpyFungsi unique() milik NumPy mengembalikan sebuah array NumPy dengan elemen unik dari argumennya. Array NumPy ini dapat diubah menjadi list menggunakan .tolist() milik NumPy:
import numpy as np
names = ["James", "Bob", "James", "Mark", "Kate", "Sarah", "Kate"]
unique_names = np.unique(names).tolist()
print(unique_names)
['Bob', 'James', 'Kate', 'Mark', 'Sarah']Namun, perhatikan bahwa unique() milik NumPy tidak mempertahankan urutan item. Sebaliknya, fungsi ini mengembalikan item yang sudah diurutkan. Pustaka pihak ketiga populer lainnya, Pandas, juga memiliki fungsi unique() yang bekerja serupa tetapi mempertahankan urutan item. Solusi NumPy dan Pandas ideal ketika pustaka-pustaka ini sudah digunakan dalam codebase dan tidak perlu dipasang serta diimpor hanya untuk menghapus duplikasi dari list.
dict.fromkeys() Lebih Baik daripada Menggunakan Set?Dalam banyak kasus, opsi terbaik adalah dua yang pertama disajikan dalam tutorial ini:
dict.fromkeys() dan konversi kembali menjadi list.Menggunakan dictionary mempertahankan urutan item. Namun, menggunakan set lebih efisien dan dapat memberikan peningkatan performa jika urutan item tidak diperlukan.
Peningkatan performa dapat diukur menggunakan timeit:
import random
import timeit
data = [random.randint(0, 100) for _ in range(100)]
use_fromkeys = "unique_data = list(dict.fromkeys(data))"
use_set = "unique_data = list(set(data))"
from_keys_time = timeit.timeit(use_fromkeys, globals=globals())
set_time = timeit.timeit(use_set, globals=globals())
print(f"Time for 'dict.fromkeys()' version: {from_keys_time:0.2f}s")
print(f"Time for set version: {set_time:0.2f}s")
Time for 'dict.fromkeys()' version: 2.08s
Time for set version: 1.05sMenghapus duplikasi dari list menggunakan set kira-kira dua kali lebih cepat dibandingkan menggunakan dictionary.
Python dan pustaka pihak ketiganya menawarkan beberapa opsi untuk menghapus duplikasi dari list.
Anda dapat terus belajar Python dengan postingan blog berikut:
Pelajari Python dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt




