课程
Python 金融入门
4 小时
108.1K
实践并学习路径你的进步。
使用 Google 继续从历史上看,10 月是股市波动性最大的月份,但这是持久的信号,还是数据中的噪声?
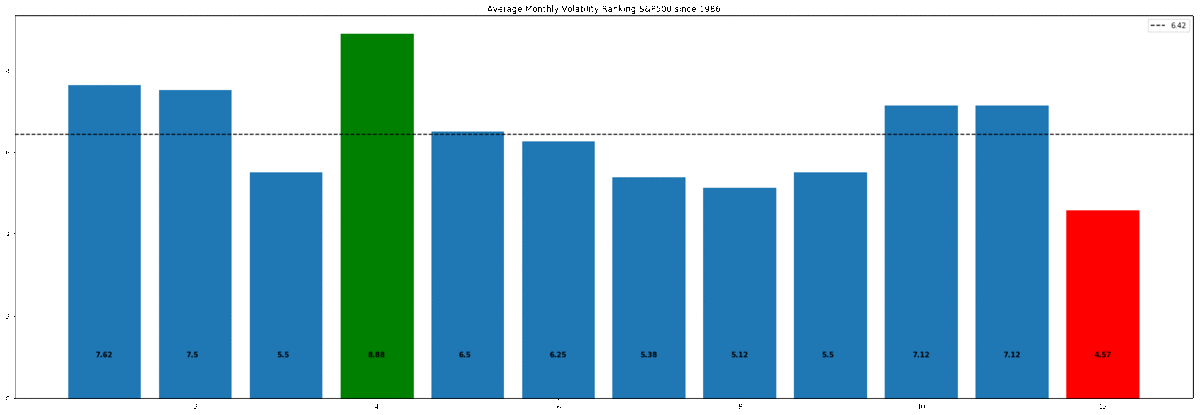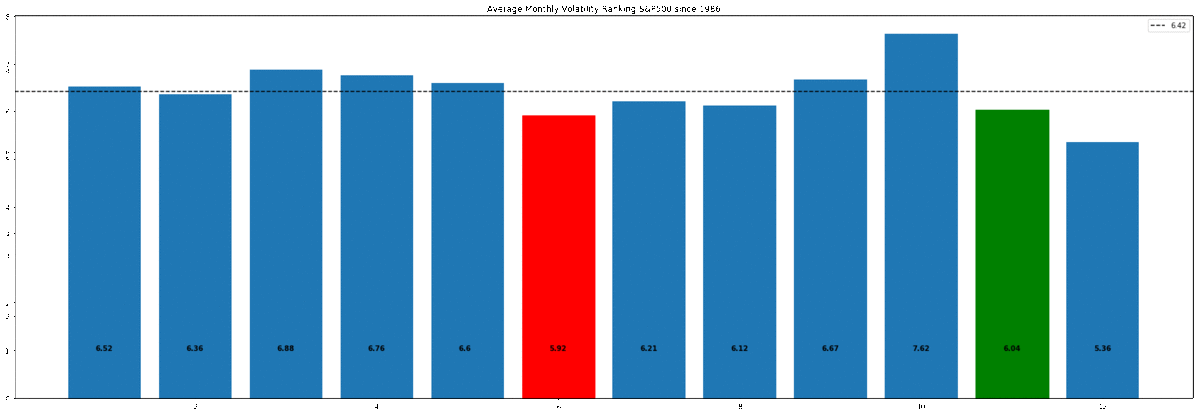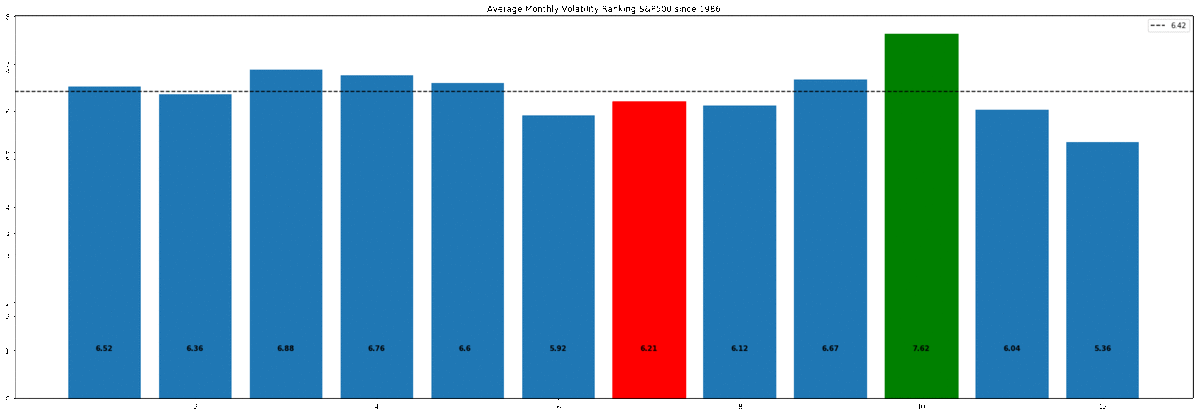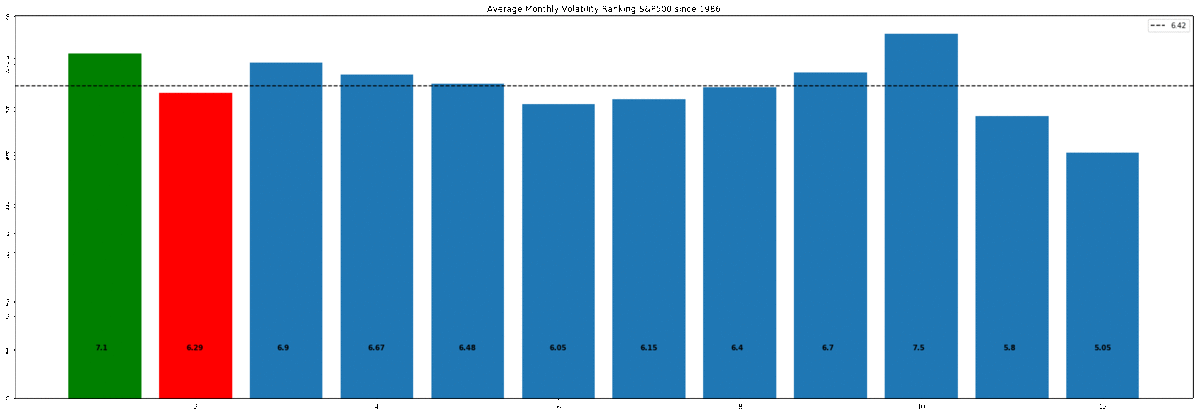
"在过去 32 年中,10 月的平均波动性在标普 500 指数中最高,而 12 月最低"。
在本教程中,我们将使用 Python 完整走一遍分析与检验流程,以判断这一现象在统计上是否显著。
我们将使用 pandas 的时间序列功能(如 Resample)将原始股价数据整理成更具表现力的格式。
接着,我们将学习如何在 Python 中使用模拟来进行假设检验,避免繁琐的公式计算。
最后,我们将讨论统计分析中的一个重大问题——多重比较偏差,学习应对方法,并用 matplotlib 直观展示“p-值作假(p-Hacking)”的影响。
本次分析将使用标普 500 的日度数据,具体而言,我们使用 1986 到 2018 年的日收盘价(这一数据意外地难找,因此我已将其公开提供)。
本文的灵感来自 Winton 的研究,我们将在这里复现,不过我们使用的是 32 年数据,而他们使用了 87 年数据。
要回答“某些月份出现的极端波动是否确实显著、因而更可能持续”这一问题,我们需要将 32 年的价格数据转换为能反映我们所研究现象的格式。
我们选择的格式是平均月度波动性排名(AMVR)。
下面的代码展示了如何把原始价格数据转为该格式。让我们开始吧!
先进行常规导入。(matplotlib.patches 让我们可以控制直方图中单个柱子的样式)
#standard imports
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches
%matplotlib inline
一个好用的小技巧,可让图表在 Jupyter 笔记本中全宽显示:
#resize charts to fit screen if using Jupyter Notebook
plt.rcParams['figure.figsize']=[15,5]
这个可选——试试看会发生什么!
#plt.xkcd()
使用 read_csv 方法导入数据,它接收一个路径,这里是数据的 URL。我们还指定使用 date 作为索引,并尽可能自动解析日期。
#Daily S&P500 data from 1986==>
url = "https://raw.githubusercontent.com/Patrick-David/Stocks_Significance_PHacking/master/spx.csv"
df = pd.read_csv(url,index_col='date', parse_dates=True)

#view raw S&P500 data
df.head()
| close | |
|---|---|
| date | |
| 1986-01-02 | 209.59 |
| 1986-01-03 | 210.88 |
| 1986-01-06 | 210.65 |
| 1986-01-07 | 213.80 |
| 1986-01-08 | 207.97 |
这给出了标普 500(SPX)的原始未复权收盘价。现在我们需要将原始价格转换为日度百分比收益。为此有两种方式:
在本教程中,我们使用方法 2,因为对于这种规模(8000 多个值)的数据,pandas 可以瞬时完成计算。我们还会清理数据,丢弃第一个因为没有前一日而为 NaN 的值。pct_change() 有一个可选参数 periods 用于改变位移周期,我们保持默认的 1。
#To model returns we will use daily % change
daily_ret = df['close'].pct_change()
#drop the 1st value - nan
daily_ret.dropna(inplace=True)
#daily %change
daily_ret.head()
date
1986-01-03    0.006155
1986-01-06   -0.001091
1986-01-07    0.014954
1986-01-08   -0.027268
1986-01-09   -0.008944
Name: close, dtype: float64
下一步是将这些日度百分比变化转换为“月度年化波动率”。下面第一行代码展示了只用一行就能完成这一转换。这就是 Pandas 的强大之处!不过我们还是按步骤拆解一下:
1. 为得到 mnthly_annu,我们先对日度收益使用 resample 方法。Resample 允许我们改变数据周期频率。它接收一个“频率偏移字符串”,简单说就是一个代表目标频率的字母,包括:
我们希望把日度收益采样成月度,因此传入参数 'M'。
2. 接着要决定如何得到新的月度数值,比如可以对日度值求和、相乘等。对我们的分析而言,我们需要波动性的度量,标准差很合适,因此我们对重采样后的数据使用 std(),得到月度波动率。
3. 最后一步是对该数值进行年化。我们只需乘以 12 的平方根,12 是一年中的月数。这样就得到所需的月度年化波动率。
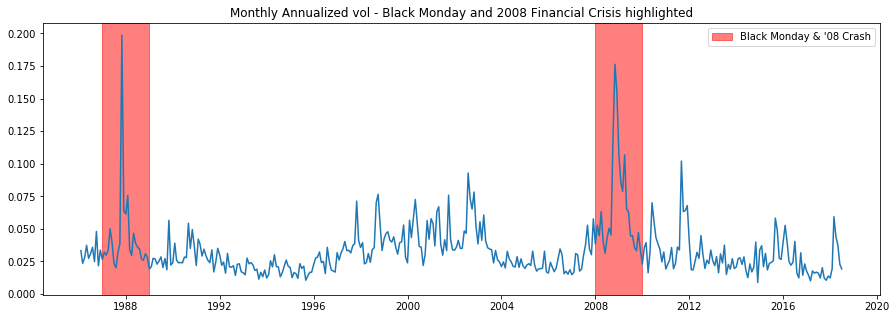
数据分析的最佳实践是在分析过程中持续可视化数据。让我们看看年化波动率数据。
下图清晰显示了主要市场事件,例如“黑色星期一”和 2008 年金融危机。matplotlib 的 axvspan 方法可以添加竖向标记(水平对应的方法是 axhspan)。它接收 xmin 与 xmax 参数来指定矩形的宽度。因为 x 轴是日期时间索引,我们可以直接传入想要高亮的年份。alpha 参数调节色块的透明度,以便仍能看到下方的曲线。
mpatches 属性让我们可以自定义图例框。我们先用颜色、alpha 和文本定义 labs 变量,再把它传给 plt.legend 的 handles 参数来渲染图例。
#use pandas to resample returns per month and take Standard Dev as measure of Volatility
#then annualize by multiplying by sqrt of number of periods (12)
mnthly_annu = daily_ret.resample('M').std()* np.sqrt(12)

print(mnthly_annu.head())
#we can see major market events show up in the volatility
plt.plot(mnthly_annu)
plt.axvspan('1987','1989',color='r',alpha=.5)
plt.axvspan('2008','2010',color='r',alpha=.5)
plt.title('Monthly Annualized vol - Black Monday and 2008 Financial Crisis highlighted')
labs = mpatches.Patch(color='red',alpha=.5, label="Black Monday & '08 Crash")
plt.legend(handles=[labs])
date
1986-01-31    0.033317
1986-02-28    0.023585
1986-03-31    0.027961
1986-04-30    0.037426
1986-05-31    0.027412
Freq: M, Name: close, dtype: float64

<matplotlib.legend.Legend at 0x280b1ee6908>
我们已经见识了 pandas 的一个强大方法 resample。现在再用另一个方法 groupby。我们需要从月度年化波动率值出发,得到目标 AMVR 指标。同样,只需几行代码。
1. 首先,对 mnthly_annu 使用 groupby 方法。groupby 需要一个参数来指定如何分组,可以是函数,也可以是一个序列。这里传入 mnthly_annu.index.year,即 mnthly_annu 数据的日期时间索引的年份属性。这会按 32 个年份将每年的月度波动率值分组。
2. 然后使用 rank 方法按升序为数据排序。
3. 最后,再做一次类似操作:对月份分组并对所有年份取平均。这样就得到最终的 AMVR 值!
#for each year rank each month based on volatility lowest=1 Highest=12
ranked = mnthly_annu.groupby(mnthly_annu.index.year).rank()

#average the ranks over all years for each month
final = ranked.groupby(ranked.index.month).mean()

final.describe()
count    12.000000
mean      6.450521
std       0.627458
min       5.218750
25%       6.031013
50%       6.491004
75%       6.704545
max       7.531250
Name: close, dtype: float64
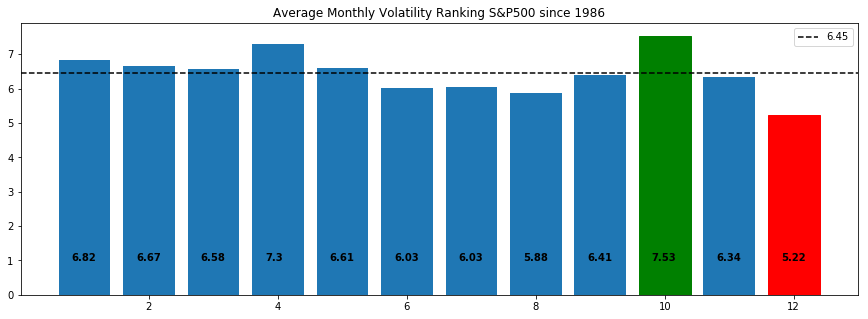
这就得到了最终的平均月度波动性排名。从数值上我们可以看到,10 月(October)最高,12 月(December)最低。
#the final average results over 32 years
final
date
1     6.818182
2     6.666667
3     6.575758
4     7.303030
5     6.606061
6     6.030303
7     6.031250
8     5.875000
9     6.406250
10    7.531250
11    6.343750
12    5.218750
Name: close, dtype: float64
为数据选择合适的可视化很重要,因为我们希望用最有冲击力的图表来讲述数据的故事。在本分析中,我们希望清晰显示波动性最高与最低的月份。为此我们将使用 matplotlib 的柱状图,并通过标注与配色来增强效果。
1. 通过对 b_plot(b_plot[9])进行索引,我们可以设置颜色以突出最高与最低值。
2. 要把 AMVR 数值添加到对应的柱子上,我们遍历每个 AMVR 值(final 变量)并将结果四舍五入到小数点后两位。i 和 v 分别代表 final 的索引与数值,因此 i 的范围是 1–12,value 是四舍五入后的 AMVR 值。我们在 plt.text() 中使用这些变量。plt.text() 的第一个参数是标签的 x 轴位置,因此我们为每个柱传入 i,并加上 0.8 使其居中。第二个参数是 final 值的字符串。
3. 为显示均值,我们使用 axhline,并通过 label 参数在右上角添加图例。只需传入 y 轴的均值并设置样式。
这为我们正在研究的现象提供了目前为止最好的可视化。可以清楚看到 10 月最为波动而 12 月最不波动。更重要的是,我们也能看到 12 月在绝对意义上更为“极端”。这对下一节的分析很关键。
#plot results for ranked s&p 500 volatility
#clearly October has the highest AMVR
#and December has the lowest
#mean of 6.45 is plotted

b_plot = plt.bar(x=final.index,height=final)
b_plot[9].set_color('g')
b_plot[11].set_color('r')
for i,v in enumerate(round(final,2)):
    plt.text(i+.8,1,str(v), color='black', fontweight='bold')
plt.axhline(final.mean(),ls='--',color='k',label=round(final.mean(),2))
plt.title('Average Monthly Volatility Ranking S&P500 since 1986')

plt.legend()
plt.show()
数据就绪,现在进入假设检验……
假设检验是数据科学中最基础的技术之一,但同时也常被视为最令人生畏、最易被误解的主题。其根源在于传统统计入门课的教学方式:
“做一个 t 检验,是单侧还是双侧?选择合适的检验统计量,比如 Welch t 检验,计算自由度,计算 t 值,在表中查临界值,将临界值与 t 统计量比较……”
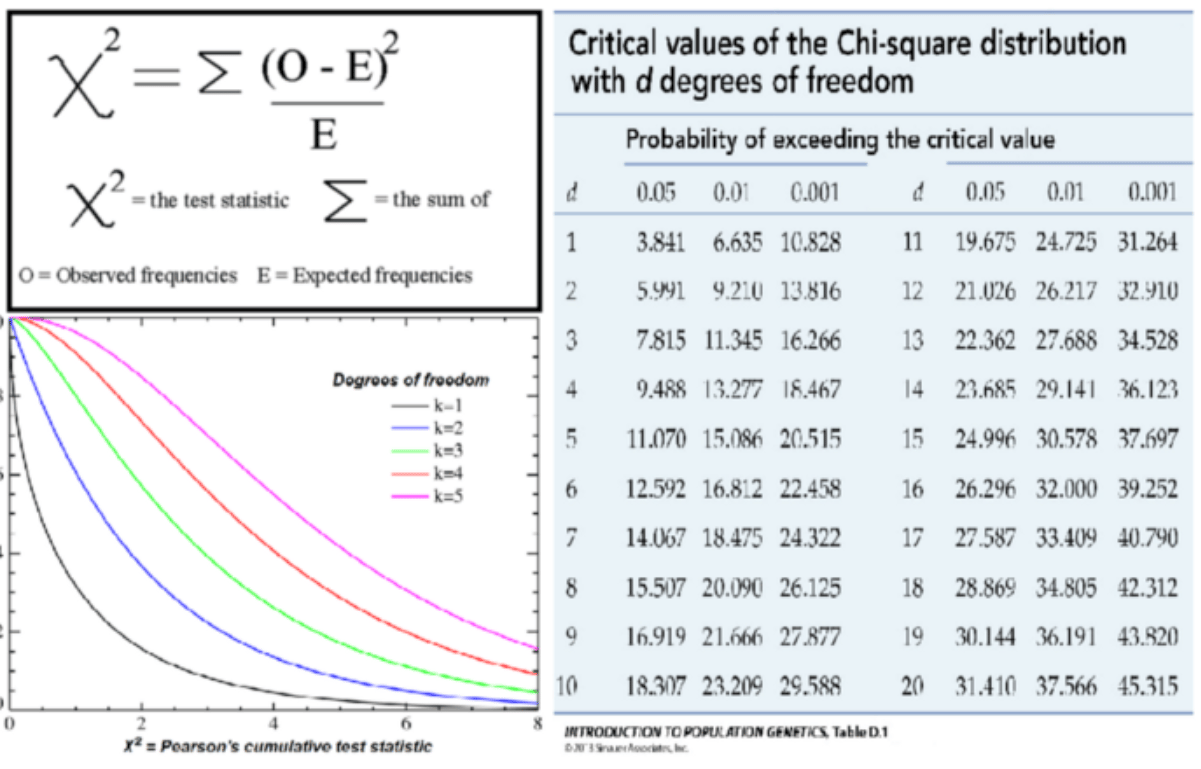
难怪大家会对做什么检验、如何实施感到困惑。然而,所有这些经典统计技术都是在计算能力极其有限的时代发展出来的,本质只是为计算 p 值提供的解析封闭解,仅此而已!但它们还带来了另一个麻烦:由于严格且有时不透明的假设,必须为具体情境挑对公式。
但别灰心!
有更好的方法:模拟。
要理解模拟如何帮到我们,先回顾一下什么是“假设检验”:
我们希望检验“数据中观察到的效应是否真实,还是仅仅可能由偶然造成”,为此我们需要:
这就是三步走的假设检验!无论我们检验什么现象,问题始终如一:“观察到的效应是真实的,还是偶然的?”
“只有一种检验!”Allen Downey 的这篇优秀博文有更多细节
模拟的真正威力在于,我们必须通过代码显式地陈述模型假设。而经典方法在其假设上往往是“黑箱”。
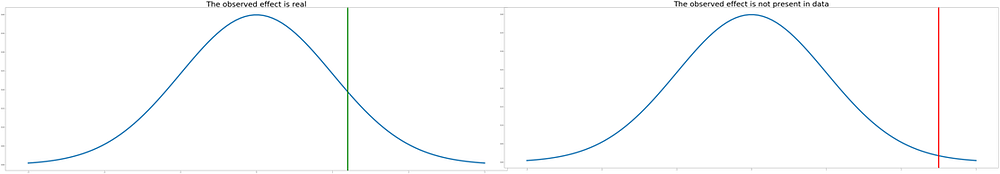
下例说明:左图显示真实数据及其观察效应出现的一定概率(绿色)。右图是我们模拟的原假设数据,并记录何时“偶然”出现观察效应(红色)。这就是假设检验的基础:在原假设数据中看到观察效应的概率是多少。
假设检验中最关键的是明确我们试图回答的问题。在这里我们问:
“最极端的数值可能是偶然出现的吗?”
我们将最极端的数值定义为距均值的 AMVR 绝对偏差的最大值。这个问题构成了我们的原假设。
在我们的数据里,最极端的是 12 月(1.23),而不是 10 月(1.08),因为我们看的是相对均值的绝对偏差最大,而不只是最高波动性。
1. 要得到绝对偏差,只需用每个值减去均值并取绝对值 abs()。
2. 使用 sort_values() 方法可以将结果从小到大排序。然后选出最大的两个值,即 10 月和 12 月。
#take abs value move from the mean
#we see Dec and Oct are the biggest abs moves

fin = abs(final - final.mean())
print(fin.sort_values())
Oct_value = fin[10]
Dec_value = fin[12]
print('Extreme Dec value:', Dec_value)
print('Extreme Oct value:', Oct_value)
date
9     0.044271
11    0.106771
3     0.125237
5     0.155540
2     0.216146
1     0.367661
7     0.419271
6     0.420218
8     0.575521
4     0.852509
10    1.080729
12    1.231771
Name: close, dtype: float64
Extreme Dec value: 1.231770833333333
Extreme Oct value: 1.080729166666667
明确问题后,我们需要构建“原假设模型”。
有几种选择:
抽样是个大话题,我们将聚焦于一种技术:置换或洗牌。
为了得到期望的原假设模型,我们需要构建一个不含季节性的数据集。如果原假设为真,即数据没有季节性,观察到的效应只是偶然,那么每个月(Jan、Feb 等)的标签就没有意义,因此我们可以反复打乱数据,去构建经典统计所称的“原假设下检验统计量的抽样分布”。这将使观察到的现象(极端的 12 月值)对所有月份等可能,这正是我们的原假设模型所需。
为展示现代计算能力下模拟技术的强大,例子中的代码实际对日度价格数据进行置换,这需要更多算力,但在现代 CPU 上仍能在数秒内完成。
注意:在我们的场景中,打乱日度或月度标签都能得到期望的原假设数据集。
Shuffle 'date' label to create null dataset

学习抽样的优秀资源:Julian Simon。
注意:我们的检验构造方式等价于“经典”方法中的双侧检验,如 Welch t 检验或 ANOVA,因为我们关心的是最极端的值,无论高于还是低于均值。
这些决策都是设计选择,而我们之所以有这种自由,是因为原假设模型就是模型!这意味着我们可以按需设定其参数,关键在于非常清楚地知道自己要回答什么问题。
我们希望使用 Python 进行大量模拟来创建原假设数据集。为实现这一点,我们将模拟 1000 组 12 个 AMVR,每次都置换“日期”标签以构建抽样分布。该代码的输出会在 p-hacking 一节展示。
1. 首先定义一些容器来存储结果:我们将使用一个 pd.DataFrame() 和一个简单的数组 []。
2. 然后定义计数器置零,开始一个 1000 次循环来创建模拟数据。
3. 循环内第一行取前文的原始日度收益,使用 pandas 的 sample() 方法。它会从日度收益数据中随机抽取给定次数的数据。我们的数据点数量是 8191(32 年 × 每年 252 个交易日)。我们还用 reset_index() 去掉索引,以便稍后添加新索引。之所以这样做,是因为原始日期索引会随数据一起被打乱,而我们只想“打乱”数据本身。
4. 下一行通过把 daily_ret_shuffle 的索引赋值为与原始数据等长的 pd.bdate_range 来添加新的日期索引。我们使用 bdate_range 而非 date_range,因为我们只要工作日(周一至周五 5 天),而不是每周 7 天。
5. 现在生成了“洗牌”后的数据,我们对其执行与前面相同的数据整理步骤,以构建 AMVR 值。接下来的 3 行代码就是做这个。
6. 有了模拟的 AMVR 值后,我们需要把它们追加到存储全部 1000 次模拟结果的数据框中。pd.concat 会将当前数据框与后续数据框按顺序拼接。我们选择 axis=1,以得到按列拼接的数据。
7. maxi_month 变量仅存储每次模拟中的最大值(我们稍后在分析中会用到)。
8. 由于我们的分析需要 AMVR 的绝对偏差,接下来三行代码把所有 1000 次 AMVR 结果展平成一个大数组,然后计算总体均值、用单个值减去该均值,最后取绝对值。
9. 对“仅取最高值”的数据也做相同处理。注意:这里我们使用了列表而非数据框,因此可以用列表推导式来计算每个最高值的 abs(AMVR)。
至此,我们已经拥有完成分析所需的全部数据:既有原始观测,也有新模拟出的数据集。
#as our Null is that no seasonality exists or alternatively that the month does not matter in terms of AMVR,
#we can shuffle 'date' labels
#for simplicity, we will shuffle the 'daily' return data, which has the same effect as shuffling 'month' labels

#generate null data

new_df_sim = pd.DataFrame()
highest_only = []

count=0
n=1000
for i in range(n):
    #sample same size as dataset, drop timestamp
    daily_ret_shuffle = daily_ret.sample(8191).reset_index(drop=True)
    #add new timestamp to shuffled data
    daily_ret_shuffle.index = (pd.bdate_range(start='1986-1-3',periods=8191))

    #then follow same data wrangling as before...
    mnthly_annu = daily_ret_shuffle.resample('M').std()* np.sqrt(12)

    ranked = mnthly_annu.groupby(mnthly_annu.index.year).rank()
    sim_final = ranked.groupby(ranked.index.month).mean()
    #add each of 1000 sims into df
    new_df_sim = pd.concat([new_df_sim,sim_final],axis=1)

    #also record just highest AMVR for each year (we will use this later for p-hacking explanation)
    maxi_month = max(sim_final)
    highest_only.append(maxi_month)

#calculate absolute deviation in AMVR from the mean
all_months = new_df_sim.values.flatten()
mu_all_months = all_months.mean()
abs_all_months = abs(all_months-mu_all_months)

#calculate absolute deviation in highest only AMVR from the mean
mu_highest = np.mean(highest_only)
abs_highest = [abs(x - mu_all_months) for x in highest_only]
有意思的部分来了。我们已经构建了待检验的假设,通过打乱数据的“日期”标签生成了模拟数据。现在要执行假设检验,计算在原假设(无季节性)为真的前提下,观察到像 12 月这样显著的结果的概率。
在动手之前,先设定预期。
在 5% 显著性水平下,看到“至少一个”显著结果的概率是多少?
= 1 - p(不显著)
= 1 - (1–0.05)¹²
= 0.46
因此,46% 的概率会看到至少一个月份出现显著结果,前提是原假设为真。
现在再问,对每一次单独的检验(将 12 个月各自的 AMVR 绝对偏差与均值比较),在我们的随机、无季节性数据中应期望看到多少个显著值?
12 × 0.05 = 0.6
因此,在 0.05 的显著性水平下,我们应期望的假阳性数为0.6。换言之,对于每次(基于原假设数据)比较全部 12 个月 AMVR 与均值的检验,平均会有 0.6 个月显示显著。(显然一次试验不可能少于 1 个月,但在反复试验中数学期望会趋近这个数)。
我们一直强调要清楚自己在问什么问题。上述预期的问题在于,我们假定自己是在针对 12 个月一起检验显著性!这就是为何看到至少一个假阳性的概率高达 46%。
这就是多重比较偏差的例子:我们扩大了搜索空间,从而提高了发现显著性的可能性。这会带来问题,因为我们可以滥用这一现象,择取模型参数以得到“想要的” p 值。
这正是 p-值作假的本质
为说明 p-hacking 的影响以及如何降低多重性,我们需要理解下面两个问题之间细微却重要的区别:
模拟的妙处在于其简单。下面的代码就足以计算回答第一个问题所需的 p 值。我们只需统计数据集中所有 12000 个 AMVR 偏差值(12 个月 × 1000 次试验)中有多少个大于观察到的 12 月值。我们得到一个4.4% 的 p 值,接近我们有些任意的 5% 阈值,但仍然显著。
#count number of months in sim data where ave-vol-rank is >= Dec
#Note: we are using Dec not Oct, as Dec has highest absolute deviation from the mean
count=0
for i in abs_all_months:
    if i> Dec_value:
        count+=1
ans = count/len(abs_all_months)
print('p-value:', ans )
p-value: 0.04425
要回答第二个问题并避免多重性,我们不再与 12000 个 AMVR 偏差值的分布比较,而只考虑每次试验(1000 次)中绝对 AMVR 的最高值。这给出一个23% 的 p 值,很显然不显著!
#same again but just considering highest AMVR for each of 100 trials
count=0
for i in abs_highest:
    if i> Dec_value:
        count+=1
ans = count/len(abs_highest)
print('p-value:', ans )
p-value: 0.236
现在我们得到了最终结果,让我们绘制这些分布,直观展示 p-hacking 的影响及本次分析的结果:
1. 首先用 np.quantile() 找到 5% 显著性水平,我们会在下方图中用 axvline 画出。
2. 接着定义四个子图。plt.subplots 返回 fig(画布)和 ax1、ax2、ax3、ax4(四个子图句柄)。
3. 图 1 显示第一列。我们对 abs_all_months 绘制柱状直方图(type='bar')。下方图设置 cumulative='True',得到 CDF 而非 PDF。bins 定义柱子数量,对本数据而言 30 合适。随后用已学方法美化图表,如 axvline 绘制显著性阈值和观测值。
abs_all_months_95 = np.quantile(abs_all_months,.95)
abs_highest_95 = np.quantile(abs_highest,.95)

fig, ((ax1,ax2),(ax3,ax4)) = plt.subplots(2,2,sharex='col',figsize=(20,20))

#plot 1
ax1.hist(abs_all_months,histtype='bar',color='#42a5f5')
ax1.set_title('AMVR all months',fontsize=30)
ax1.set_ylabel('Frequency',fontsize=20)
ax3.hist(abs_all_months,density=1,histtype='bar',cumulative=True,bins=30,color='#42a5f5')
ax3.set_ylabel('Cumulative probability',fontsize=20)
ax1.axvline(Dec_value,color='b',label='Dec Result',lw=10)
ax3.axvline(Dec_value,color='b',lw=10)
ax3.axvline(abs_all_months_95,color='r',ls='--',label='5% Sig level',lw=10)

#plot2
ax2.hist(abs_highest,histtype='bar',color='g')
ax2.set_title('AMVR highest only',fontsize=30)
ax2.axvline(Dec_value,color='b',lw=10)
ax4.hist(abs_highest,density=1,histtype='bar',cumulative=True,bins=30,color='g')
ax4.axvline(Dec_value,color='b',lw=10)
ax4.axvline(abs_highest_95,color='r',ls='--',lw=10)

ax1.legend(fontsize=15)
ax3.legend(fontsize=15)
<matplotlib.legend.Legend at 0x280b4eb0b00>
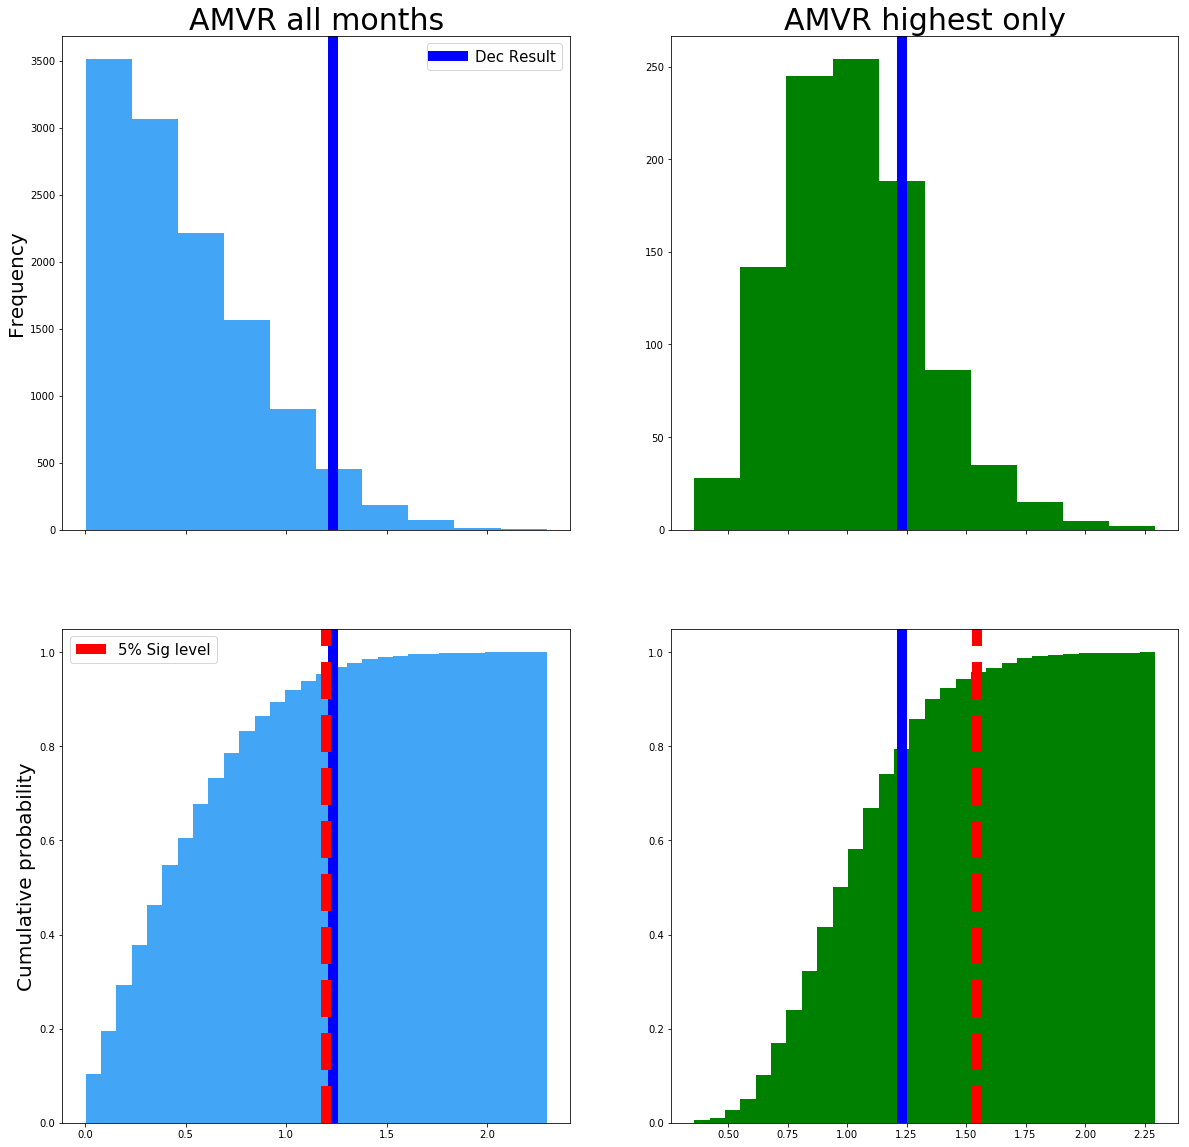
左侧列对应问题 1,右侧列对应问题 2。上排是概率分布,下排是 CDF。红色虚线是我们任意设定的 5% 显著性水平。蓝线是原始的极端 12 月 AMVR 值 1.23。
左图显示在 5% 水平下原始 12 月值是显著的,但只是勉强!然而,当我们考虑多重比较偏差后,右图中的显著性阈值从约 1.2(绝对 AMVR)上移到了约 1.6(见红线)。
在考虑多重比较偏差后,我们的 12 月值 1.23 不再显著!
通过聚焦具体问题并避免多重比较偏差,我们避免了对模型进行 p-值作假,从而避免在没有显著性的情况下“造出”显著结果。
若想进一步探索 p-hacking 及其如何被滥用于讲述某种“故事”,请查看 FiveThirtyEight 的这个优秀交互应用。
作者注:我们的结果与最初的 Winton 研究略有不同,部分原因是数据集不同(32 年 vs. 87 年),且他们关注的是 10 月,而我们是 12 月。此外,他们使用了未披露的方法来生成“模拟数据”,而我们通过代码显式说明了生成方法。我们在整个工作中做出了一些建模假设,同样都已显式呈现并可在代码中看到。这些设计与建模选择是科学过程的一部分,只要明确呈现,分析就有其价值。
如果您想进一步学习 Python 在金融中的应用,请参加 DataCamp 的 Intro to Python for Finance 课程,并查看 Python For Finance Tutorial: Algorithmic Trading。
关注我的 twitter.com/pdquant 获取更多内容!
深入学习 Python
课程
课程
实践并学习路径你的进步。
使用 Google 继续