Curso
Introducción a Python para finanzas
4 h
106.6K
Octubre es, históricamente, el mes más volátil para las acciones, pero ¿es una señal persistente o solo ruido en los datos?
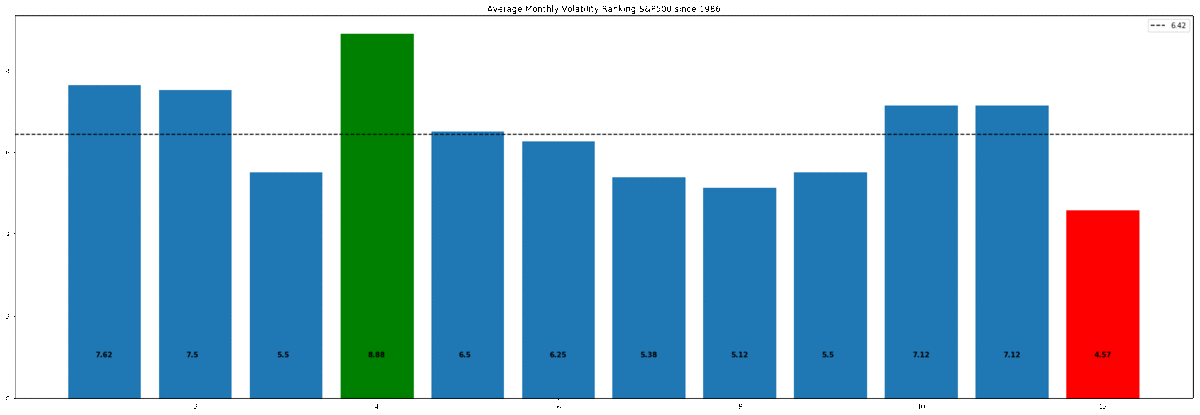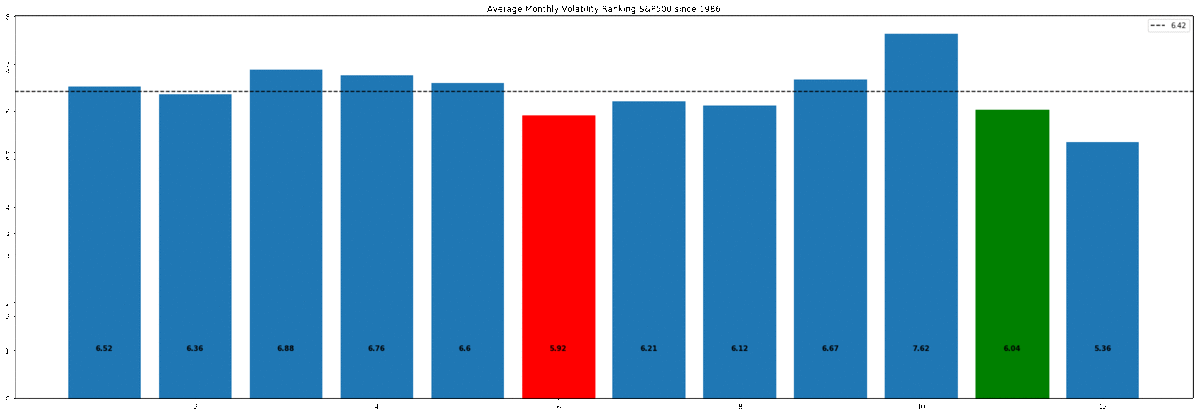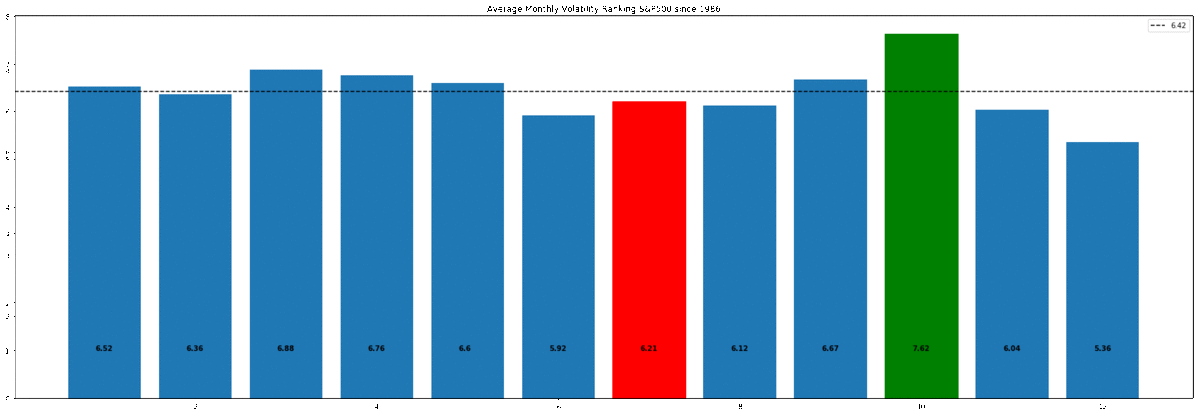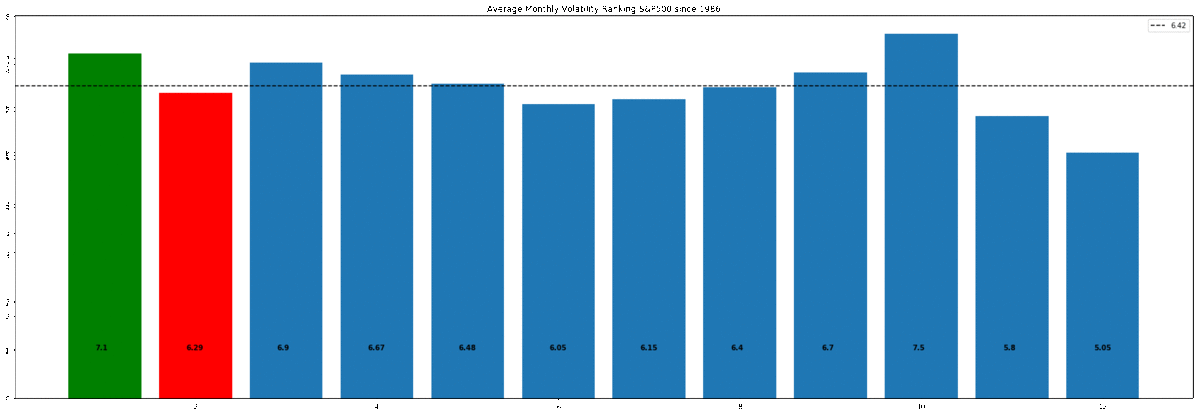
"En los últimos 32 años, octubre ha sido el mes más volátil de media para el S&P500 y diciembre el menos volátil".
En este tutorial usaremos Python para recorrer un análisis completo y poner a prueba este fenómeno, y así determinar si es estadísticamente significativo o no.
Utilizaremos la funcionalidad de series temporales de pandas, como Resample, para transformar precios bursátiles en bruto a un formato que dé vida a los datos.
Veremos cómo realizar contrastes de hipótesis mediante simulación en Python en lugar de fórmulas engorrosas.
Por último, hablaremos de un problema clave del análisis estadístico, el sesgo por comparaciones múltiples, aprenderemos a corregirlo y mostraremos visualmente con matplotlib el efecto del "p-hacking".
Usaremos datos diarios del S&P500 para este análisis; en concreto, los precios de cierre diarios en bruto desde 1986 hasta 2018 (que, sorprendentemente, no son fáciles de encontrar, así que los he dejado disponibles públicamente).
La inspiración de este post viene de Winton, que reproduciremos aquí, aunque con 32 años de datos frente a sus 87.
Para responder si la volatilidad extrema observada en ciertos meses es realmente significativa y por tanto probable que continúe, necesitamos transformar nuestros 32 años de precios en un formato que refleje el fenómeno que investigamos.
El formato elegido será el de los rankings medios de volatilidad mensual (AMVR).
El siguiente código muestra cómo llevamos los precios en bruto a este formato. ¡Vamos al lío!
Primero, las importaciones estándar (matplotlib.patches nos da control para estilizar barras individuales dentro de un histograma).
#standard imports
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib.patches as mpatches
%matplotlib inline
Un truco útil para que los gráficos ocupen todo el ancho en Jupyter notebooks:
#resize charts to fit screen if using Jupyter Notebook
plt.rcParams['figure.figsize']=[15,5]
Este es opcional: pruébalo y verás qué pasa.
#plt.xkcd()
Importamos los datos con read_csv, que recibe una ruta, en nuestro caso la URL. También indicamos que use "date" como índice y que analice automáticamente las fechas a partir del texto dado, lo mejor que pueda.
#Daily S&P500 data from 1986==>
url = "https://raw.githubusercontent.com/Patrick-David/Stocks_Significance_PHacking/master/spx.csv"
df = pd.read_csv(url,index_col='date', parse_dates=True)

#view raw S&P500 data
df.head()
| close | |
|---|---|
| date | |
| 1986-01-02 | 209.59 |
| 1986-01-03 | 210.88 |
| 1986-01-06 | 210.65 |
| 1986-01-07 | 213.80 |
| 1986-01-08 | 207.97 |
Esto nos da los precios de cierre sin ajustar del S&P500 (SPX). Ahora tenemos que convertir estos precios en rendimientos diarios en %. Para ello, hay dos opciones:
Para nuestro propósito, usaremos el método 2, ya que pandas puede calcularlo al instante en un conjunto de este tamaño (más de 8000 valores). También limpiaremos los datos eliminando el primer valor, que es 'NaN' porque no hay variación respecto al día anterior. pct_change() acepta un parámetro opcional 'periods' que cambia el desfase; lo dejamos por defecto en uno.
#To model returns we will use daily % change
daily_ret = df['close'].pct_change()
#drop the 1st value - nan
daily_ret.dropna(inplace=True)
#daily %change
daily_ret.head()
date
1986-01-03    0.006155
1986-01-06   -0.001091
1986-01-07    0.014954
1986-01-08   -0.027268
1986-01-09   -0.008944
Name: close, dtype: float64
El siguiente paso es transformar estos cambios diarios en % en "volatilidad mensual anualizada". La primera línea de código de abajo muestra que podemos hacerlo en una sola línea. ¡Ese es el poder de pandas! Pero desgranemos cada paso.
1. Para obtener mnthly_annu usamos primero el método 'resample' sobre los rendimientos diarios. Resample nos permite cambiar la frecuencia temporal de los datos. Acepta una 'cadena de desplazamiento de frecuencia', o dicho simple, una letra que corresponde a la nueva frecuencia deseada. Entre ellas:
Como queremos pasar de rendimientos diarios a mensuales, pasamos 'M' como parámetro.
2. Lo siguiente es decidir cómo llegar a esa cifra mensual: podríamos sumar, multiplicar, etc. Para nuestro análisis queremos una medida de volatilidad y la desviación estándar funciona bien, así que encadenamos std() al resampleo para obtener la volatilidad mensual.
3. El último paso es anualizar esta cifra. Basta con multiplicar por la raíz cuadrada de 12, siendo 12 el número de periodos (meses) en un año. Así obtenemos los valores de volatilidad mensual anualizada que necesitamos.
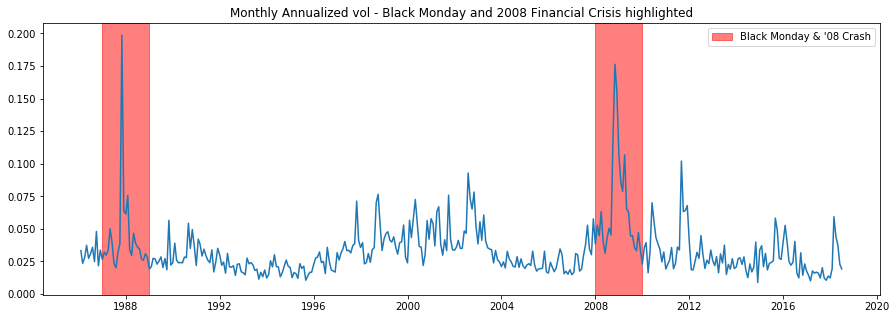
La buena práctica en análisis de datos es visualizar a medida que avanzamos. Veamos entonces nuestra volatilidad anualizada.
El gráfico siguiente muestra eventos de mercado clave, como el Lunes Negro y la crisis financiera de 2008. El método 'axvspan' de matplotlib permite añadir franjas verticales (axhspan es el análogo horizontal); recibe 'xmin' y 'xmax' para definir el ancho del rectángulo. Como el eje x es un índice datetime, podemos pasar los años a resaltar. El parámetro alpha ajusta la transparencia para seguir viendo la gráfica debajo.
El atributo mpatches permite crear una leyenda personalizada. Primero definimos la variable 'labs' con color, alpha y texto, y luego la pasamos al parámetro 'handles' en plt.legend para dibujarla.
#use pandas to resample returns per month and take Standard Dev as measure of Volatility
#then annualize by multiplying by sqrt of number of periods (12)
mnthly_annu = daily_ret.resample('M').std()* np.sqrt(12)

print(mnthly_annu.head())
#we can see major market events show up in the volatility
plt.plot(mnthly_annu)
plt.axvspan('1987','1989',color='r',alpha=.5)
plt.axvspan('2008','2010',color='r',alpha=.5)
plt.title('Monthly Annualized vol - Black Monday and 2008 Financial Crisis highlighted')
labs = mpatches.Patch(color='red',alpha=.5, label="Black Monday & '08 Crash")
plt.legend(handles=[labs])
date
1986-01-31    0.033317
1986-02-28    0.023585
1986-03-31    0.027961
1986-04-30    0.037426
1986-05-31    0.027412
Freq: M, Name: close, dtype: float64

<matplotlib.legend.Legend at 0x280b1ee6908>
Ya hemos visto uno de los métodos potentes de pandas, resample. Ahora usemos otro, groupby. Debemos pasar de los valores de volatilidad mensual anualizada a nuestro AMVR. De nuevo, lo logramos en pocas líneas.
1. Aplicamos 'groupby' a mnthly_annu. Groupby necesita un parámetro que especifique cómo agrupar. Puede ser una función o, como en nuestro caso, una Series. Pasamos 'mnthly_annu.index.year', simplemente el atributo año del índice datetime de mnthly_annu. Esto agrupa la volatilidad mensual para cada uno de los 32 años del conjunto.
2. Después aplicamos el método rank, que ordena los datos en orden ascendente.
3. Por último, repetimos y promediamos sobre todos los años para cada mes. ¡Esto nos da los AMVR finales!
#for each year rank each month based on volatility lowest=1 Highest=12
ranked = mnthly_annu.groupby(mnthly_annu.index.year).rank()

#average the ranks over all years for each month
final = ranked.groupby(ranked.index.month).mean()

final.describe()
count    12.000000
mean      6.450521
std       0.627458
min       5.218750
25%       6.031013
50%       6.491004
75%       6.704545
max       7.531250
Name: close, dtype: float64
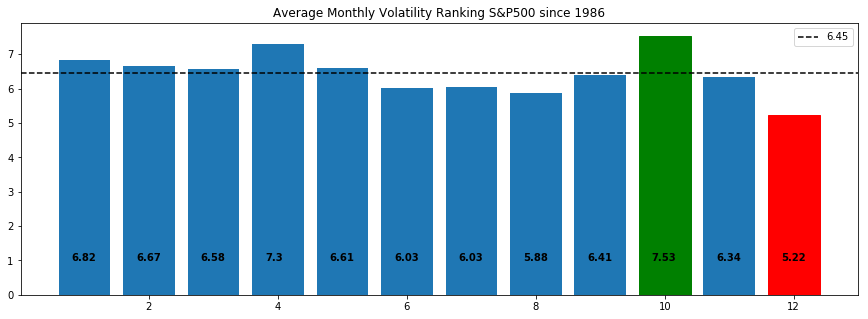
Esto devuelve nuestros rankings medios de volatilidad mensual. Numéricamente vemos que el mes 10 (octubre) es el más alto y el 12 (diciembre) el más bajo.
#the final average results over 32 years
final
date
1     6.818182
2     6.666667
3     6.575758
4     7.303030
5     6.606061
6     6.030303
7     6.031250
8     5.875000
9     6.406250
10    7.531250
11    6.343750
12    5.218750
Name: close, dtype: float64
Elegir la visualización adecuada es clave para contar la historia de los datos. Aquí queremos mostrar claramente la mayor y la menor volatilidad. Usaremos un gráfico de barras de matplotlib y anotaremos y colorearemos para maximizar el impacto.
1. Indexando b_plot (b_plot[9]) con la barra deseada, podemos establecer el color para resaltar los valores máximo y mínimo.
2. Para añadir los valores AMVR a su barra, recorremos con enumerate cada valor ('final') y redondeamos a 2 decimales. 'i' y 'v' representan el índice y el valor de 'final'; 'i' irá de 1 a 12 y 'v' es el AMVR redondeado. Usamos estas variables en plt.text(). El primer parámetro es la posición en el eje x, pasamos 'i' y lo desplazamos 0.8 para centrar. El segundo es la cadena con el valor.
3. Para mostrar la media, usamos axhline y el parámetro 'label' para añadir una leyenda arriba a la derecha. Pasa el valor en y (la media) y estiliza.
Este es el mejor visual del fenómeno: octubre ha sido el mes más volátil y diciembre el menos. Importante: diciembre es el valor más "extremo" en términos absolutos. Esto será relevante en la siguiente sección.
#plot results for ranked s&p 500 volatility
#clearly October has the highest AMVR
#and December has the lowest
#mean of 6.45 is plotted

b_plot = plt.bar(x=final.index,height=final)
b_plot[9].set_color('g')
b_plot[11].set_color('r')
for i,v in enumerate(round(final,2)):
    plt.text(i+.8,1,str(v), color='black', fontweight='bold')
plt.axhline(final.mean(),ls='--',color='k',label=round(final.mean(),2))
plt.title('Average Monthly Volatility Ranking S&P500 since 1986')

plt.legend()
plt.show()
Ya tenemos los datos; pasemos a las pruebas de hipótesis…
El contraste de hipótesis es una de las técnicas fundamentales de la ciencia de datos, pero a menudo intimida y se malinterpreta. En gran parte por cómo se enseña en Estadística 101, donde nos dicen:
"realiza una t de Student, ¿es unilateral o bilateral? Elige un estadístico de prueba como la t de Welch, calcula los grados de libertad, calcula la t, busca el valor crítico en una tabla, compáralo con tu estadístico t…"
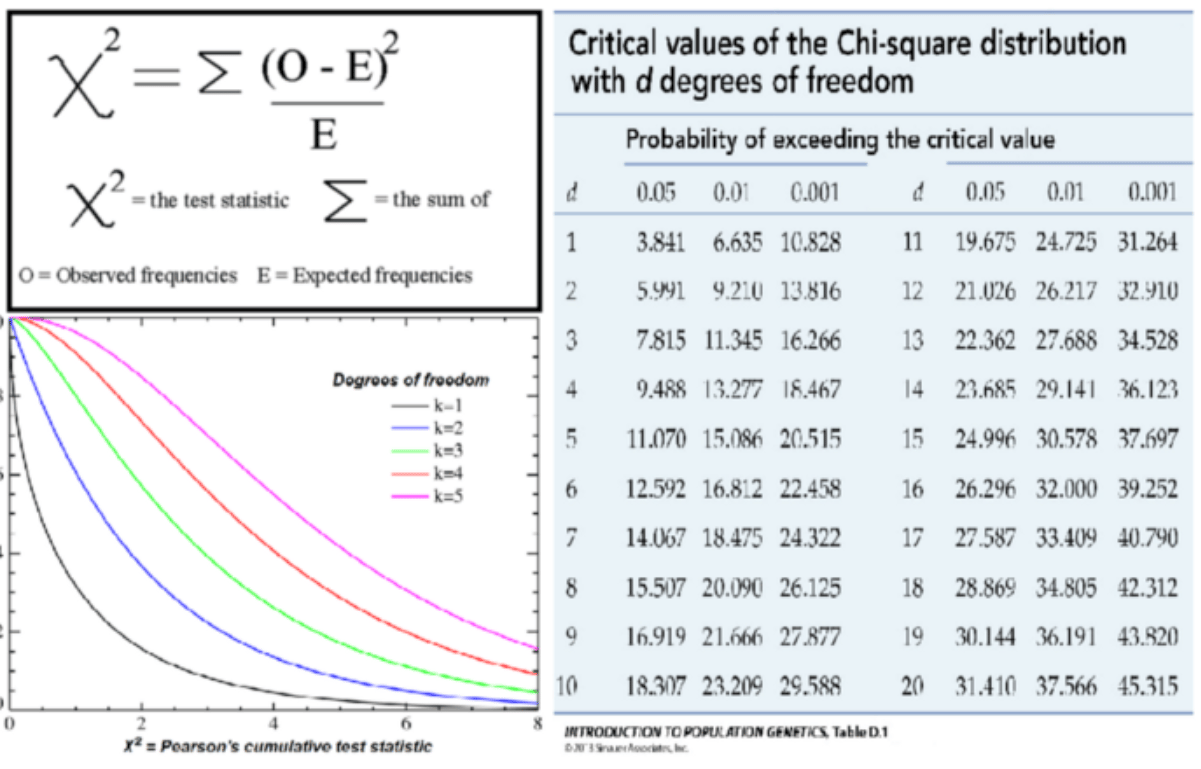
Normal que esto genere confusión sobre qué prueba hacer y cómo. Sin embargo, todas estas técnicas clásicas se desarrollaron cuando apenas teníamos capacidad de cómputo y no eran más que soluciones analíticas cerradas para calcular un p-valor, ¡nada más! Con el añadido de tener que elegir la fórmula adecuada según el caso, por sus supuestos restrictivos y, a veces, opacos.
Pero, ¡alegrémonos!
Hay una forma mejor: la simulación.
Para entender cómo ayuda, recordemos qué es un contraste de hipótesis:
Queremos comprobar "si el efecto observado en nuestros datos es real o podría darse simplemente por azar" y, para ello, hacemos lo siguiente:
¡Ese es el contraste de hipótesis en 3 pasos! Da igual el fenómeno: la pregunta siempre es la misma: "¿el efecto observado es real o se debe al azar?"
There is only one test! Este gran post de Allen Downey profundiza en el contraste de hipótesis
La gran ventaja de la simulación es que debemos hacer explícitos los supuestos del modelo mediante código. En cambio, las técnicas clásicas pueden ser una caja negra respecto a sus supuestos.
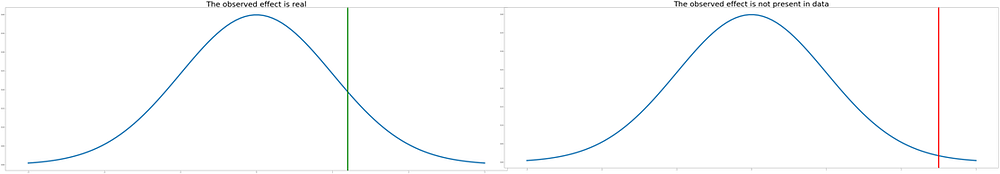
Ejemplo: el gráfico de la izquierda muestra los datos reales y el efecto observado con cierta probabilidad (verde). El de la derecha es nuestro dato nulo simulado con los casos en que el efecto observado aparece por azar (rojo). Esta es la base de un contraste: cuál es la probabilidad de ver el efecto observado en los datos nulos.
La parte más crítica es tener clara la pregunta que queremos responder. En nuestro caso preguntamos:
"¿Podría el valor más extremo darse por azar?"
Definimos valor más extremo como la mayor desviación absoluta del AMVR respecto a la media. Esta pregunta define nuestra hipótesis nula.
En nuestros datos, el valor más extremo es el de diciembre (1,23), no el de octubre (1,08), porque miramos la desviación absoluta más significativa respecto a la media, no simplemente la mayor volatilidad.
1. Para obtener la desviación absoluta, restamos cada valor de la media y aplicamos abs().
2. Con sort_values() ordenamos de menor a mayor y seleccionamos los 2 mayores, oct. y dic.
#take abs value move from the mean
#we see Dec and Oct are the biggest abs moves

fin = abs(final - final.mean())
print(fin.sort_values())
Oct_value = fin[10]
Dec_value = fin[12]
print('Extreme Dec value:', Dec_value)
print('Extreme Oct value:', Oct_value)
date
9     0.044271
11    0.106771
3     0.125237
5     0.155540
2     0.216146
1     0.367661
7     0.419271
6     0.420218
8     0.575521
4     0.852509
10    1.080729
12    1.231771
Name: close, dtype: float64
Extreme Dec value: 1.231770833333333
Extreme Oct value: 1.080729166666667
Ya sabemos qué pregunta hacemos; ahora debemos construir nuestro 'modelo nulo'.
Tenemos varias opciones:
El muestreo es un tema amplio, pero nos centraremos en una técnica: la permutación o barajado.
Para obtener el modelo nulo queremos un conjunto sin estacionalidad. Si la nula es cierta, no hay estacionalidad y el efecto observado se debe al azar, entonces las etiquetas de cada mes (ene, feb, etc.) son irrelevantes y podemos barajar los datos repetidamente para construir lo que la estadística clásica llamaría la 'distribución muestral del estadístico bajo la hipótesis nula'. Así conseguimos que el fenómeno observado (el diciembre extremo) sea igual de probable para todos los meses, justo lo que requiere nuestro modelo nulo.
Para demostrar el poder de la simulación con la computación actual, el código de este ejemplo permutará los datos diarios, lo que requiere más cálculo, y aun así termina en segundos en una CPU moderna.
Nota: barajar las etiquetas diarias o las mensuales nos da el conjunto nulo deseado en este caso.
Shuffle 'date' label to create null dataset

Un gran recurso para aprender muestreo es Julian Simon.
Nota: Tal y como está construido nuestro test, equivale a una prueba bilateral con métodos 'clásicos' (t de Welch, ANOVA, etc.), porque nos interesa el valor más extremo, por encima o por debajo de la media.
Estas decisiones son de diseño, y tenemos esa libertad porque el modelo nulo es eso, ¡un modelo! Podemos especificar sus parámetros; la clave es tener clarísima la pregunta que queremos responder.
Queremos usar Python para simular muchos datos y crear el conjunto nulo. Simularemos 1000 sets de 12 AMVR, permutando las etiquetas 'date' cada vez para construir la distribución muestral. El resultado aparece más abajo, en la sección de p-hacking.
1. Primero definimos contenedores para los resultados: un pd.DataFrame() y un array [ ].
2. Definimos un contador a cero y lanzamos un bucle de 1000 iteraciones para crear los datos simulados.
3. La primera línea dentro del bucle toma los rendimientos diarios originales y usa sample() de pandas. Muestra aleatoriamente tantas veces como datos tenemos. En nuestro caso, 8191 puntos (252 días hábiles por 32 años). Eliminamos el índice con reset_index() para poder añadir uno nuevo. Lo necesitamos porque el índice fecha original se baraja con los datos, y queremos 'barajar' solo los datos.
4. La siguiente línea añade un nuevo índice de fechas reasignando el índice de daily_ret_shuffle con un pd.bdate_range de la misma longitud. Usamos bdate_range en lugar de date_range porque queremos días hábiles (5, de lunes a viernes).
5. Con los datos 'barajados', repetimos el mismo procesamiento inicial para construir los AMVR. Eso hacen las siguientes 3 líneas.
6. Con los AMVR simulados, los añadimos a un dataframe que guardará las 1000 ejecuciones. pd.concat une cada nuevo dataframe al final. Elegimos axis 1, para columnas de datos.
7. maxi_month almacena solo el valor más alto de cada simulación (lo usaremos después para explicar el p-hacking).
8. Como nuestro análisis requiere valores absolutos de AMVR, las siguientes 3 líneas toman las 1000 ejecuciones y las aplanan en un único array. Calculamos la media, restamos los valores individuales y tomamos el valor absoluto.
9. Hacemos lo mismo para los "solo máximos". Nota: aquí usamos una lista en vez de un dataframe, lo que nos permite usar una list comprehension para calcular abs(AMVR) de cada máximo.
Ahora tenemos todos los datos para completar el análisis: observaciones originales y datos simulados.
#as our Null is that no seasonality exists or alternatively that the month does not matter in terms of AMVR,
#we can shuffle 'date' labels
#for simplicity, we will shuffle the 'daily' return data, which has the same effect as shuffling 'month' labels

#generate null data

new_df_sim = pd.DataFrame()
highest_only = []

count=0
n=1000
for i in range(n):
    #sample same size as dataset, drop timestamp
    daily_ret_shuffle = daily_ret.sample(8191).reset_index(drop=True)
    #add new timestamp to shuffled data
    daily_ret_shuffle.index = (pd.bdate_range(start='1986-1-3',periods=8191))

    #then follow same data wrangling as before...
    mnthly_annu = daily_ret_shuffle.resample('M').std()* np.sqrt(12)

    ranked = mnthly_annu.groupby(mnthly_annu.index.year).rank()
    sim_final = ranked.groupby(ranked.index.month).mean()
    #add each of 1000 sims into df
    new_df_sim = pd.concat([new_df_sim,sim_final],axis=1)

    #also record just highest AMVR for each year (we will use this later for p-hacking explanation)
    maxi_month = max(sim_final)
    highest_only.append(maxi_month)

#calculate absolute deviation in AMVR from the mean
all_months = new_df_sim.values.flatten()
mu_all_months = all_months.mean()
abs_all_months = abs(all_months-mu_all_months)

#calculate absolute deviation in highest only AMVR from the mean
mu_highest = np.mean(highest_only)
abs_highest = [abs(x - mu_all_months) for x in highest_only]
Aquí viene lo interesante. Hemos planteado una hipótesis, hemos generado datos simulados barajando las etiquetas de 'fecha' y ahora necesitamos realizar el contraste para hallar la probabilidad de observar un resultado tan significativo como el de diciembre dado que la nula (sin estacionalidad) es cierta.
Antes de hacer la prueba, fijemos expectativas.
¿Cuál es la probabilidad de ver al menos un resultado significativo con un nivel del 5%?
= 1 - p(no significativo)
= 1 - (1–0.05)¹²
= 0,46
es decir, hay un 46% de probabilidad de ver al menos un mes con un resultado significativo, suponiendo que la nula sea cierta.
Ahora preguntemos, para cada prueba individual (comparando el AMVR absoluto de cada uno de los 12 meses con la media) ¿cuántos valores significativos deberíamos esperar en nuestros datos aleatorios sin estacionalidad?
12 x 0,05 = 0,6
Así que, con un nivel del 5%, esperamos una tasa de falsos positivos de 0,6. En otras palabras, por cada test (con los datos nulos) comparando los 12 meses con la media, 0,6 meses mostrarán un resultado significativo. (obviamente no podemos tener menos de 1 mes mostrando resultado, pero en repetición la media tenderá a ese número).
Hemos insistido en tener clara la pregunta que queremos responder. El problema con estas expectativas es que hemos supuesto que probamos significancia contra los 12 meses. Por eso la probabilidad de ver al menos un falso positivo es tan alta, 46%.
Esto es un ejemplo de sesgo por comparaciones múltiples, donde ampliamos el espacio de búsqueda y aumentamos la probabilidad de encontrar un resultado significativo. Es un problema porque podemos abusar de ello para seleccionar parámetros que nos den el p-valor 'deseado'.
Esta es la esencia del p-hacking
Para ilustrar el efecto del p-hacking y cómo reducir la multiplicidad, debemos entender la diferencia, sutil pero importante, entre estas dos preguntas:
La belleza de la simulación está en su sencillez. El siguiente código basta para calcular el p-valor y responder a la primera pregunta. Simplemente contamos cuántos valores de nuestro conjunto usando las 12000 desviaciones de AMVR (12 meses x 1000 ensayos) superan el valor observado de diciembre. Obtenemos un p-valor del 4,4%, cerca de nuestro arbitrario 5%, pero significativo al fin y al cabo.
#count number of months in sim data where ave-vol-rank is >= Dec
#Note: we are using Dec not Oct, as Dec has highest absolute deviation from the mean
count=0
for i in abs_all_months:
    if i> Dec_value:
        count+=1
ans = count/len(abs_all_months)
print('p-value:', ans )
p-value: 0.04425
Para responder a la segunda pregunta y evitar la multiplicidad, en vez de comparar con la distribución hecha con las 12000 desviaciones, solo consideramos el valor más alto de cada uno de los 1000 ensayos de AMVR absolutos. Esto da un p-valor del 23%, claramente no significativo.
#same again but just considering highest AMVR for each of 100 trials
count=0
for i in abs_highest:
    if i> Dec_value:
        count+=1
ans = count/len(abs_highest)
print('p-value:', ans )
p-value: 0.236
Con los resultados finales, representemos estas distribuciones para mostrar el efecto del p-hacking y las conclusiones de nuestro análisis:
1. Primero usamos np.quantile() para hallar el nivel de significación del 5% y lo trazamos con axvline en los gráficos inferiores.
2. Después definimos 4 subgráficos. plt.subplots devuelve 'fig' = la figura y 'ax1,ax2,ax3,ax4' = cada subgráfico.
3. El gráfico 1 muestra la primera columna. Definimos un histograma de 'abs_all_months' con type='bar'. En los gráficos inferiores configuramos cumulative='True' para obtener la cdf en lugar de la pdf. Bins define el número de barras; 30 es razonable. Luego formateamos con axvline para la significación y el valor observado.
abs_all_months_95 = np.quantile(abs_all_months,.95)
abs_highest_95 = np.quantile(abs_highest,.95)

fig, ((ax1,ax2),(ax3,ax4)) = plt.subplots(2,2,sharex='col',figsize=(20,20))

#plot 1
ax1.hist(abs_all_months,histtype='bar',color='#42a5f5')
ax1.set_title('AMVR all months',fontsize=30)
ax1.set_ylabel('Frequency',fontsize=20)
ax3.hist(abs_all_months,density=1,histtype='bar',cumulative=True,bins=30,color='#42a5f5')
ax3.set_ylabel('Cumulative probability',fontsize=20)
ax1.axvline(Dec_value,color='b',label='Dec Result',lw=10)
ax3.axvline(Dec_value,color='b',lw=10)
ax3.axvline(abs_all_months_95,color='r',ls='--',label='5% Sig level',lw=10)

#plot2
ax2.hist(abs_highest,histtype='bar',color='g')
ax2.set_title('AMVR highest only',fontsize=30)
ax2.axvline(Dec_value,color='b',lw=10)
ax4.hist(abs_highest,density=1,histtype='bar',cumulative=True,bins=30,color='g')
ax4.axvline(Dec_value,color='b',lw=10)
ax4.axvline(abs_highest_95,color='r',ls='--',lw=10)

ax1.legend(fontsize=15)
ax3.legend(fontsize=15)
<matplotlib.legend.Legend at 0x280b4eb0b00>
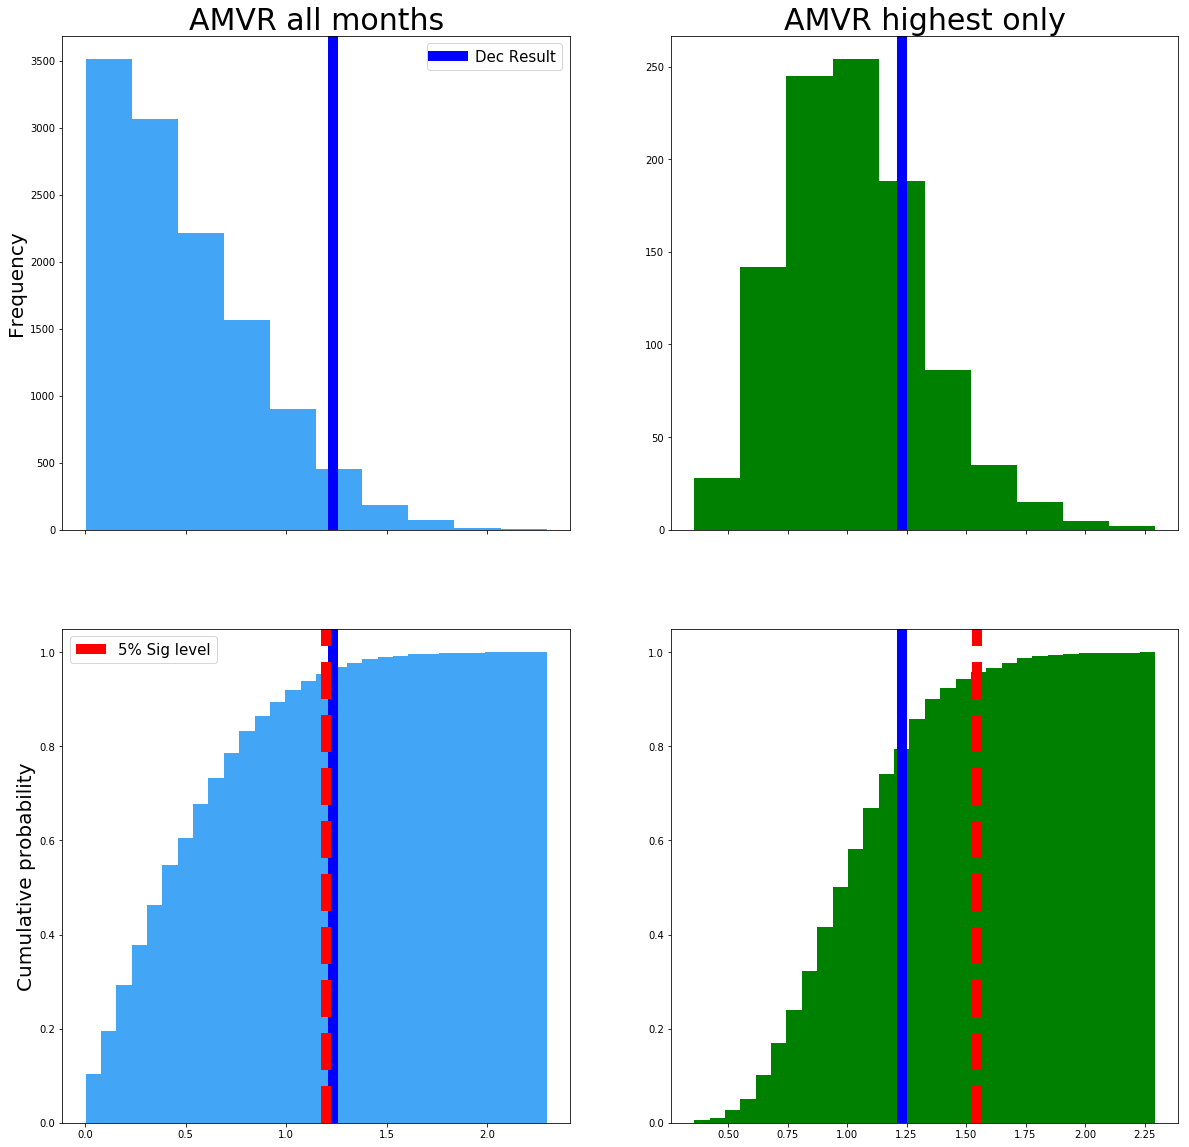
La columna izquierda responde a la pregunta 1 y la derecha a la 2. La fila superior son las distribuciones de probabilidad y la inferior las CDF. La línea roja discontinua es el nivel de significación del 5% que fijamos arbitrariamente. La azul es el AMVR extremo original de diciembre (1,23).
El gráfico izquierdo muestra que el valor de diciembre es significativo al 5%, por poco. Sin embargo, al tener en cuenta el sesgo por comparaciones múltiples, en el gráfico derecho el umbral de significación sube de alrededor de 1,2 (AMVR abs.) a cerca de 1,6 (ver la línea roja).
Al corregir el sesgo por comparaciones múltiples, nuestro valor de diciembre (1,23) deja de ser significativo.
Al considerar la pregunta específica que queremos responder y evitar el sesgo por comparaciones múltiples, hemos evitado hacer p-hacking y evitar mostrar un resultado significativo cuando no lo es.
Para explorar más el p-hacking y cómo se puede usar para contar una historia sesgada con los datos, echa un vistazo a esta app interactiva de FiveThirtyEight
Notas del autor: Nuestros resultados difieren ligeramente de la investigación original de Winton, en parte por tener un conjunto algo distinto (32 años vs. 87) y porque ellos señalan octubre como el mes de interés, mientras que a nosotros nos sale diciembre. Además, utilizaron un método no revelado para sus 'datos simulados', mientras que nosotros hemos explicitado, mediante código, nuestra metodología. Hemos hecho ciertos supuestos de modelado a lo largo del trabajo; de nuevo, se han hecho explícitos y pueden verse en el código. Estas decisiones forman parte del proceso científico; mientras sean explícitas, el análisis tiene validez.
Si quieres aprender más sobre finanzas con Python, haz el curso de DataCamp Intro to Python for Finance y echa un vistazo al Python For Finance Tutorial: Algorithmic Trading.
Sígueme en twitter.com/pdquant para más.
Más sobre Python
Curso
Curso
Curso
Tutorial
Karlijn Willems
15 min
Tutorial
DataCamp Team
7 min
Tutorial
Joleen Bothma
9 min
Tutorial
Elena Kosourova
8 min
Tutorial
Kurtis Pykes
11 min
Tutorial
Abid Ali Awan
15 min



